Catatan penulis: Migrasi dari Gemini 3.8 Flash ke Hydrogen memerlukan penyesuaian SDK dan konteks, parameter thinking, konfigurasi sampling, cache, serta manajemen signature pada pemanggilan tool multi-turn.
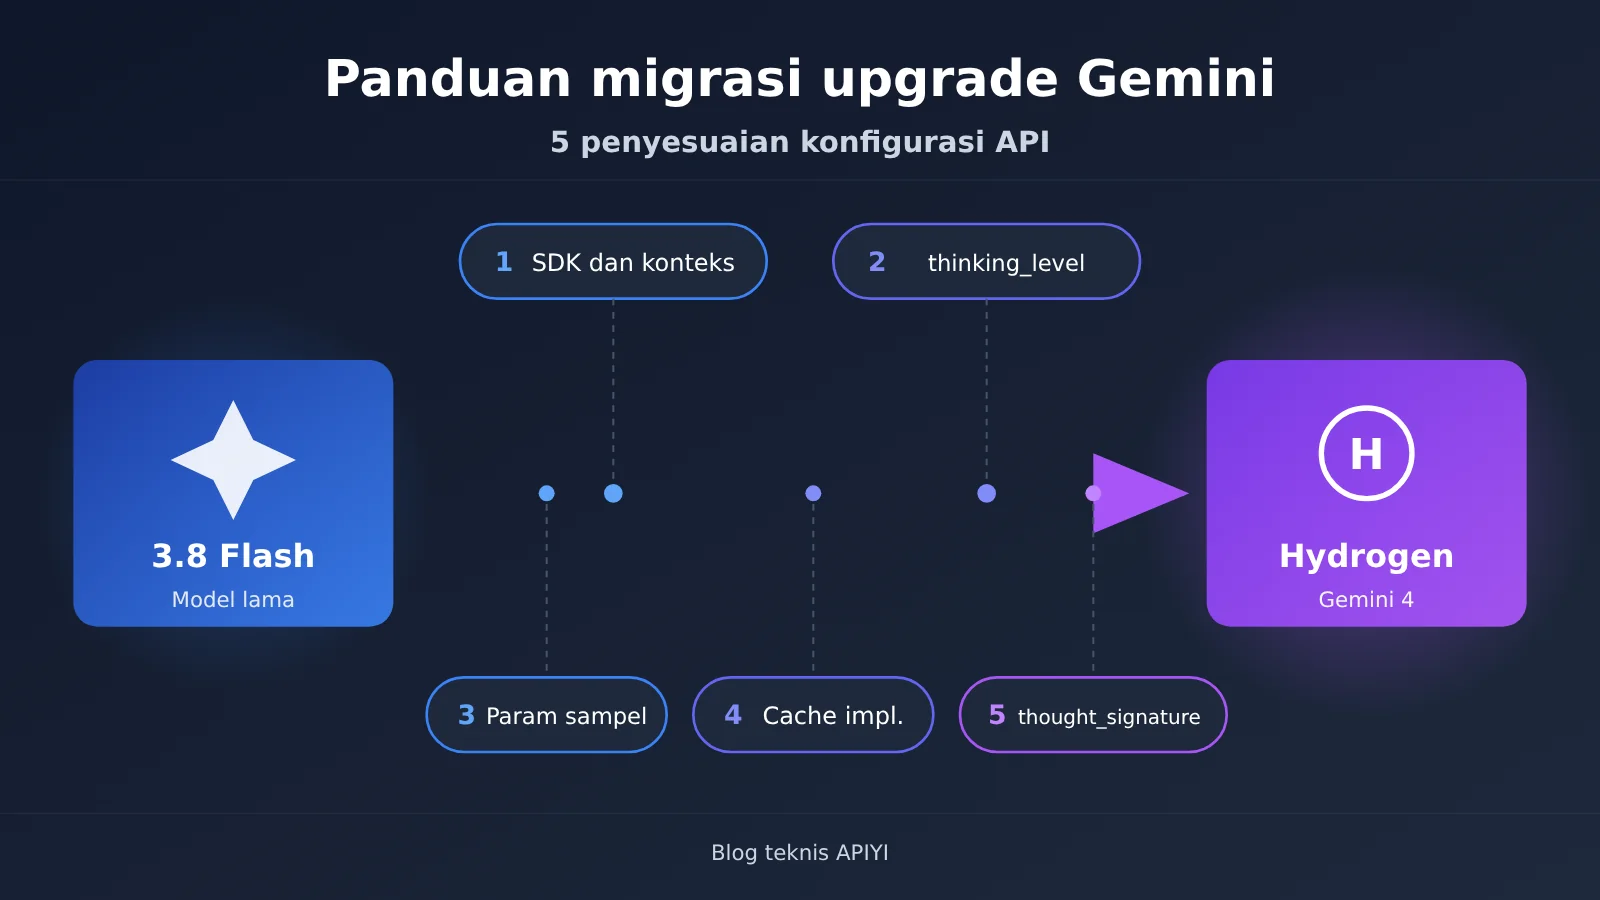
Google resmi merilis Gemini 4 Hydrogen pada 12 November 2026 dengan ID model API gemini-4-hydrogen, diposisikan untuk pemrograman sehari-hari dan eksekusi AI Agent. Reaksi pertama banyak tim adalah mengganti nama model di kode lalu langsung deploy, dan hasilnya justru HTTP 400, parameter yang tidak berfungsi, error pada pemanggilan tool multi-turn, serta output panjang yang terpotong. Artikel ini merangkum 5 konfigurasi API yang wajib disesuaikan saat upgrade dari Gemini 3.8 Flash ke Hydrogen, yang masing-masing dibahas dengan alur “perilaku lama → perilaku baru → cara memperbaiki → dampak umum”.
Ini bukan sekadar mengulang pengumuman rilis. Nama parameter, nilai yang valid, nomor versi SDK, dan tipe error dalam artikel ini bersumber dari panduan migrasi resmi Google Cloud dan dokumen spesifikasi model, sementara ulasan pihak ketiga dan masukan komunitas akan diberi label sumber tersendiri.
Nilai inti: setelah membaca artikel ini, Anda bisa memakai checklist untuk mengubah satu per satu kode pemanggilan Gemini 3.8 Flash yang ada saat ini, sehingga bisnis Agent dan pemrosesan batch Anda bisa bermigrasi ke Hydrogen dengan mulus.
5 Istilah yang Wajib Diketahui Saat Migrasi ke Hydrogen
Sebelum mulai mengubah kode, samakan dulu pemahaman tentang beberapa konsep yang sering muncul di panduan migrasi:
- thinking_level: parameter level pemikiran yang mengontrol kedalaman penalaran model. Hydrogen memakainya untuk menggantikan
thinking_budgetlama, dengan level valid Low, Medium, High, XHigh. - thought_signature: signature terkait pemikiran yang dikembalikan model dalam respons. Pada percakapan multi-giliran dan pemanggilan alat, signature ini harus dipertahankan apa adanya dan dikirim balik; jika tidak, model tidak bisa melanjutkan status penalaran sebelumnya.
- continuation_token: token kelanjutan untuk menyambung generasi segmen berikutnya dari output panjang. Setelah satu segmen output mencapai batas, Anda bisa memakainya untuk melanjutkan generasi.
- cache implisit: platform secara otomatis menggunakan kembali prefix input yang memenuhi syarat; bagian yang memenuhi syarat dan digunakan kembali akan ditagih dengan harga cache, tanpa perlu developer membuat objek cache secara manual.
- jendela konteks: rentang informasi yang dapat ditampung model dalam satu pemrosesan. Input, output, pemikiran, dan pemanggilan alat Hydrogen bersama-sama memakai kuota terpadu 1,048,576 token.
1. Mengapa Upgrade ke Hydrogen Tidak Cukup Hanya Mengganti ID Model
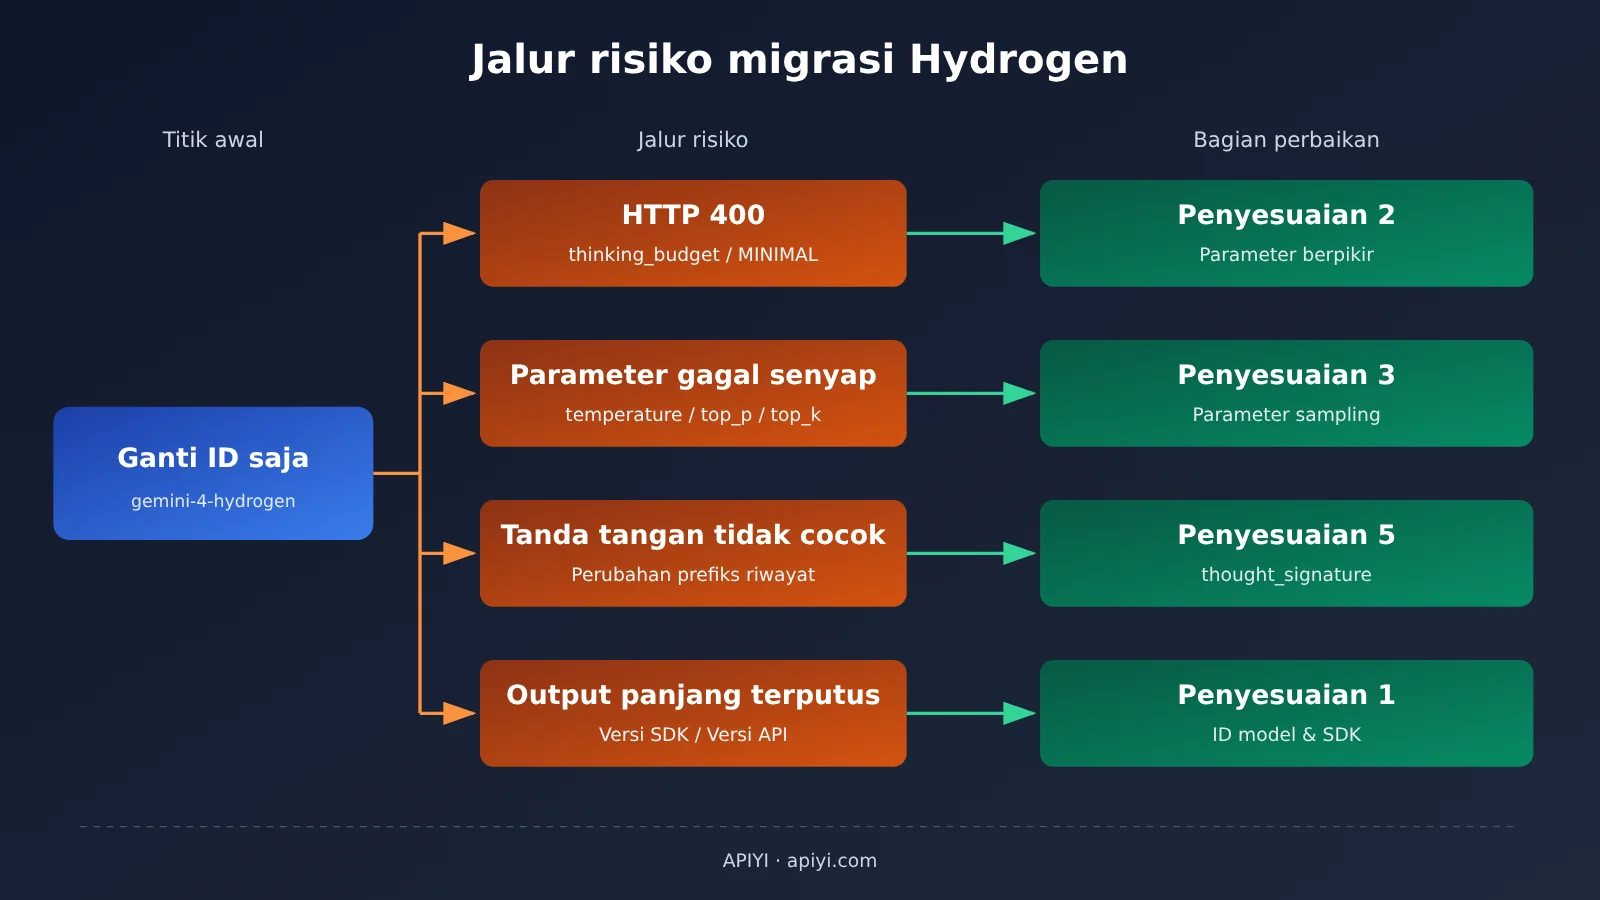
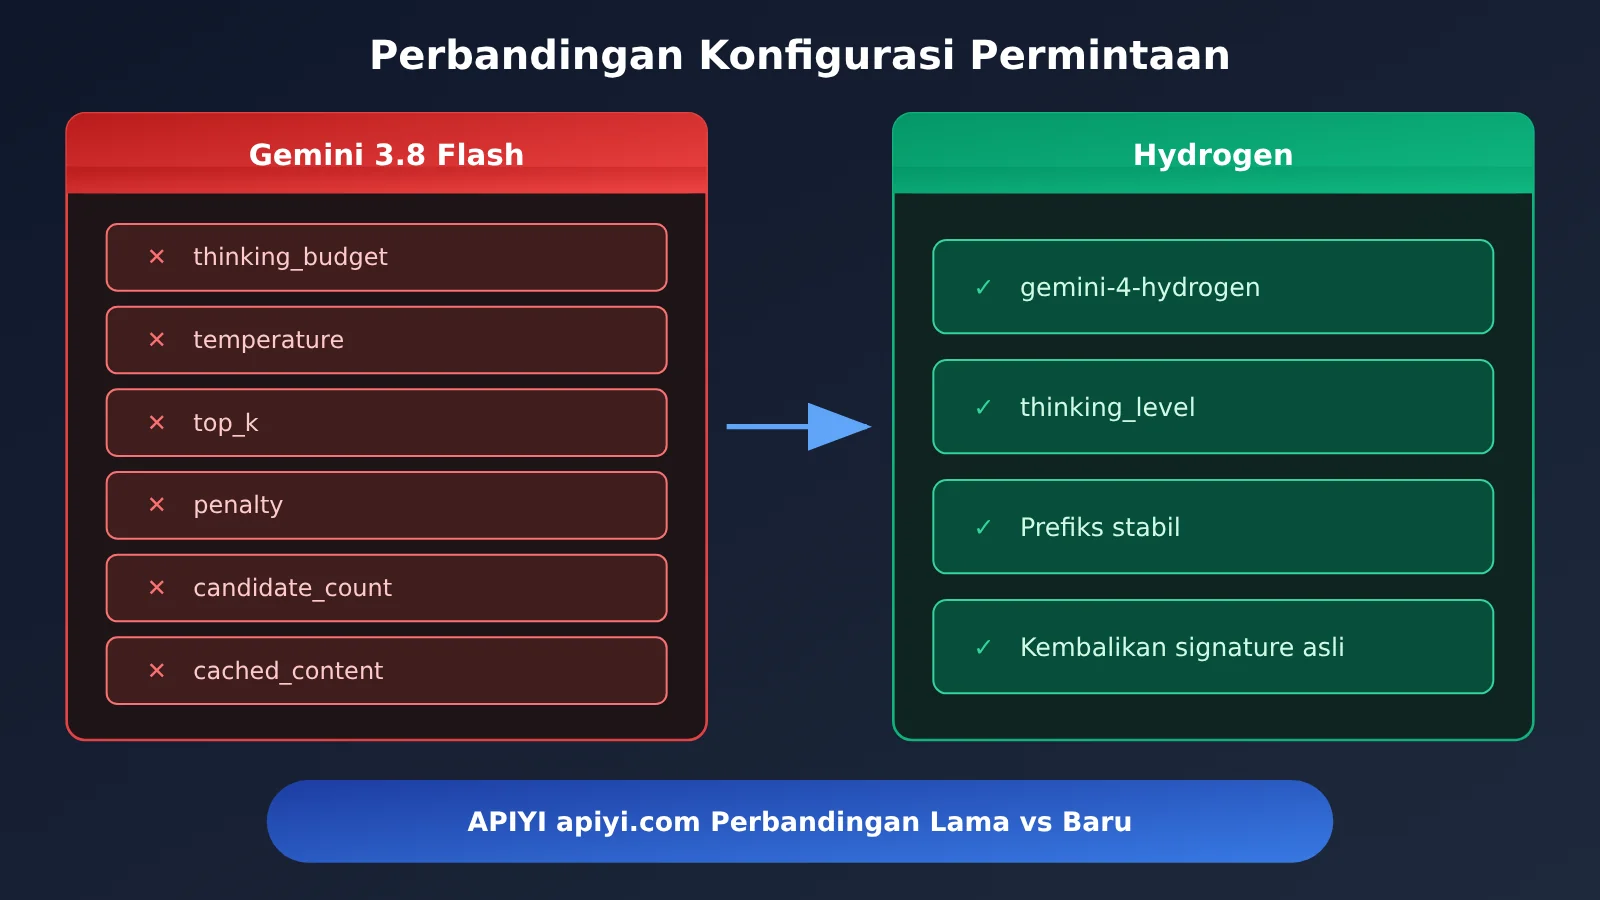
Gemini 3.8 Flash dan Hydrogen meskipun sama-sama bagian dari keluarga Gemini, perilaku API-nya punya banyak ketidakcocokan. Menurut panduan migrasi resmi, thinking_budget dan level pemikiran MINIMAL tidak didukung di Hydrogen, dan permintaan akan langsung mengembalikan HTTP 400; sedangkan parameter sampling seperti temperature, top_p, top_k tidak menghasilkan error, hanya diabaikan secara diam-diam. Masalah tipe pertama bisa terlihat saat fase pengujian, sedangkan tipe kedua bisa membuat Anda mengira “parameter masih berlaku”.
Dua jenis risiko lainnya lebih tersembunyi. Pertama, manajemen signature untuk pemanggilan alat multi-giliran lebih ketat; setelah percakapan historis dikompresi atau dipangkas, signature yang tidak cocok dengan prefix bisa memicu HTTP 400. Kedua, level pemikiran default naik dari Medium ke High; jika tidak diatur secara eksplisit, permintaan yang sama akan menghabiskan lebih banyak token pemikiran dan latensinya juga lebih panjang. Tabel berikut merangkum lima penyesuaian:
| Item penyesuaian | Perilaku lama (3.8 Flash) | Perilaku baru (Hydrogen) | Konsekuensi jika tidak diubah |
|---|---|---|---|
| ID Model, SDK, dan Konteks | ID model lama, SDK versi lama masih bisa dipakai | gemini-4-hydrogen, kelanjutan output panjang punya syarat versi minimum SDK |
Output panjang terputus, kelanjutan tidak tersedia |
| Parameter pemikiran | thinking_budget, default Medium |
thinking_level, default High |
HTTP 400, atau biaya dan latensi naik |
| Parameter sampling dan generasi | temperature, top_p, top_k, dll. dapat diatur | Nilai tetap, kustomisasi diabaikan; sebagian field perlu dihapus | Gaya output tidak terkendali, sebagian validasi permintaan gagal |
| Cache | Mendukung cache eksplisit cached_content |
Hanya mendukung cache implisit, ambang 4,096 token | Referensi cache tidak berlaku, estimasi biaya menyimpang |
| thought_signature | Aturan signature relatif longgar | Pemanggilan paralel dan perubahan prefix memiliki aturan ketat | Agen multi-giliran error atau penalaran terputus |
Kedua, Penyesuaian Pertama: ID Model, Versi SDK, dan Batasan Konteks Hydrogen
Perilaku lama → Perilaku baru: Di era 3.8 Flash, sebagian besar proyek tidak terlalu sensitif terhadap versi SDK. Setelah migrasi ke Hydrogen, ID model harus diubah menjadi gemini-4-hydrogen; jika membutuhkan output yang sangat panjang, versi SDK menjadi syarat wajib. Versi minimum yang tercantum dalam panduan migrasi resmi Google adalah sebagai berikut:
| Bahasa Pemrograman | Kelanjutan Otomatis GenerateContent | Kelanjutan Otomatis Interactions API |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | Tidak dicantumkan terpisah oleh pihak resmi | >= 1.77.0 |
| Java | Tidak dicantumkan terpisah oleh pihak resmi | >= 1.80.0 |
Cara Memodifikasi Konteks dan Output Panjang Hydrogen
Kuota 1,048,576 token Hydrogen bersifat terpadu — input, konteks historis, Token pemikiran, Token terkait pemanggilan alat, dan output akhir semuanya dikurangkan dari satu kolam yang sama. Artinya, Anda tidak bisa memasukkan 1 juta token terlebih dahulu lalu menghasilkan 1 juta token tambahan. Untuk Agent yang menganalisis dokumen panjang, Anda perlu secara aktif menyisakan ruang untuk pemikiran dan pemanggilan alat di sisi input.
Batas atas pembuatan satu segmen di front-end biasanya 65,536 token. Jika melebihi panjang tersebut, ada tiga cara yang bisa dipilih: menggunakan kelanjutan otomatis dari SDK yang didukung, mengatur background=true di Interactions API untuk pembuatan panjang di latar belakang, atau memelihara sendiri continuation_token dan menggabungkan per segmen. Perlu diperhatikan secara khusus, dokumentasi pengantar resmi menyatakan bahwa kelanjutan output panjang saat ini memerlukan API v1beta1, sedangkan v1 di Agent Platform tidak mendukung fitur ini.
Dampak umum: Bisnis yang menghasilkan laporan panjang dan file kode panjang secara batch paling mudah terkena masalah. Disarankan untuk meningkatkan versi SDK terlebih dahulu, lalu mengganti versi API ke v1beta1, dan terakhir melakukan uji regresi dengan satu permintaan yang melebihi 65,536 token.
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
3. Penyesuaian Kedua: thinking_budget Hydrogen Diubah Menjadi thinking_level
Perilaku lama: 3.8 Flash menggunakan thinking_budget untuk mengontrol panjang proses berpikir berdasarkan jumlah Token, dan masih bisa memilih level MINIMAL; level default-nya adalah Medium.
Perilaku baru: Hydrogen hanya menerima thinking_level, dengan nilai yang valid Low, Medium, High, dan XHigh, default-nya High. Jika tetap mengirimkan thinking_budget atau MINIMAL, API akan mengembalikan HTTP 400. Saran penggunaan resmi untuk masing-masing level: Low untuk klasifikasi, Medium untuk pemrograman rutin, High untuk Agent multi-langkah, dan XHigh untuk penalaran mendalam yang kompleks.
Lembaga pihak ketiga Artificial Analysis menyelesaikan evaluasi independen untuk keempat level pada 12 November (Intelligence Index v5.0.1), yang dapat membantu memahami perbedaan antarlevel. Waktu dan biaya pada tabel berikut adalah rata-rata dari tugas evaluasi terstandarisasi, bukan biaya aktual untuk satu percakapan biasa pengguna:
| Level berpikir | Skenario yang disarankan resmi | Indeks kecerdasan (AA) | Rata-rata waktu evaluasi | Rata-rata biaya evaluasi |
|---|---|---|---|---|
| Low | Klasifikasi, ekstraksi sederhana | 27 | 1,3 menit | $0.29 |
| Medium | Pemrograman rutin | 41 | 3,7 menit | $0.80 |
| High (default) | Agent multi-langkah | 51 | 8,3 menit | $1.87 |
| XHigh | Penalaran mendalam yang kompleks | 54 | 13,5 menit | $3.16 |
Dari data tersebut, High lebih tinggi 10 poin daripada Medium, sedangkan XHigh hanya 3 poin lebih tinggi daripada High, tetapi biaya evaluasinya naik dari $1.87 menjadi $3.16. Ini menunjukkan bahwa level tertinggi belum tentu paling hemat; kemampuan dengan nama model yang sama juga bisa sangat berbeda di level yang berbeda.
Contoh perubahan thinking_level Hydrogen
Contoh berikut menggunakan sintaks SDK Google Gen AI resmi. Untuk penulisan huruf besar/kecil nilai enum, ikuti definisi tipe pada versi SDK yang Anda pasang:
from google import genai
from google.genai import types

client = genai.Client()

# Penulisan lama (3.8 Flash): akan mengembalikan HTTP 400 di Hydrogen
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# Penulisan baru: pilih Medium untuk tugas pemrograman rutin
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# Pilih High untuk Agent multi-langkah (juga nilai default, sebaiknya ditulis eksplisit)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修复这个函数中的空指针问题:...",
    config=coding_config,
)
print(resp.text)
Dampak umum: karena Token thinking ditagihkan dengan harga output, proyek yang tidak mengatur level secara eksplisit akan otomatis jatuh ke High setelah migrasi, sehingga tagihan dan latensi meningkat. Sebaiknya petakan rentang thinking_budget lama ke level: anggaran yang lebih kecil ke Low atau Medium, anggaran yang lebih besar ke High.
四、Penyesuaian Ketiga: Membersihkan Parameter Generasi yang Tidak Berlaku Lagi di Hydrogen
Perilaku lama: 3.8 Flash memungkinkan penyesuaian randomness output melalui temperature, top_p, dan top_k, serta mendukung parameter penalti dan output multi-kandidat.
Perilaku baru: Suhu bawaan Hydrogen adalah 1.0 dan nilai kustom tidak berlaku, top_p dipatok pada 0.95, top_k dipatok pada 64, dan ketiga parameter ini akan diabaikan jika tetap dikirim. Daftar migrasi resmi juga mewajibkan penanganan field berikut:
| Field atau Perilaku | Persyaratan Migrasi Hydrogen | Petunjuk Troubleshooting |
|---|---|---|
| temperature / top_p / top_k | Nilai kustom diabaikan | Tidak memunculkan error, gaya harus dikendalikan lewat petunjuk |
| frequency_penalty / presence_penalty | Hapus | Berpatokan pada error aktual; menghapus semuanya adalah cara paling aman |
| candidate_count > 1 | Hapus pengaturan multi-kandidat | Jika butuh keberagaman, ubah menjadi beberapa permintaan terpisah |
| riwayat giliran model yang di-prefill | Hapus | Tidak bisa lagi “memberi awalan untuk model” sebagai cara memandu format |
| cached_content | Tidak lagi mereferensikan cache eksplisit | Lihat Penyesuaian Keempat |
| thinking_budget | Ganti ke thinking_level yang valid | Mengembalikan HTTP 400 |
Pihak resmi secara khusus mengingatkan bahwa sebagian parameter lama hanya diabaikan, sementara yang lain menyebabkan validasi permintaan gagal. Karena itu, logika troubleshooting tidak bisa disamaratakan: saat menemui 400, prioritaskan memeriksa thinking_budget, MINIMAL, dan field yang harus dihapus; jika gaya output tidak sesuai ekspektasi, periksa apakah masih bergantung pada parameter suhu.
Konfigurasi Permintaan Hydrogen yang Sudah Disederhanakan
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # konten stabil diletakkan di depan, membantu cache implisit
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # output terstruktur tetap didukung
    max_output_tokens=8192,
)
Dampak umum: Proyek yang sebelumnya mengandalkan suhu rendah untuk memastikan output JSON stabil sebaiknya beralih ke kemampuan output terstruktur; proyek yang mengandalkan giliran model yang di-prefill untuk mengendalikan format perlu menuliskan persyaratan format ke dalam system prompt.
Lima, Penyesuaian Keempat: Cache eksplisit Hydrogen diubah menjadi cache implisit
Perilaku lama: Pada 3.8 Flash, pengembang dapat terlebih dahulu membuat objek cache, lalu mereferensikannya dalam permintaan melalui cached_content="cachedContents/xxx".
Perilaku baru: Hydrogen tidak mendukung cache konteks eksplisit, hanya mendukung cache implisit, dan mengaktifkan mekanisme cache implisit yang persisten secara default. Panjang prefiks minimum untuk cache turun dari 6.144 token pada 3.8 Flash menjadi 4.096 token, sehingga petunjuk sistem publik dan materi pengetahuan tetap yang relatif pendek pun lebih mudah terkena cache hit.
Cara mengubah: Hapus semua pemanggilan caches.create dan referensi cached_content, lalu optimalkan urutan penyusunan petunjuk. Google menyarankan untuk menempatkan konten publik yang stabil di bagian depan input, dan menempatkan pertanyaan pengguna yang berubah setiap kali di bagian akhir:
- Petunjuk sistem dan penetapan peran (hampir tidak berubah)
- Basis pengetahuan publik, dokumentasi API, standar kode (perubahan frekuensi rendah)
- Riwayat percakapan (ditambahkan per putaran)
- Pertanyaan pengguna saat ini (berubah setiap kali)
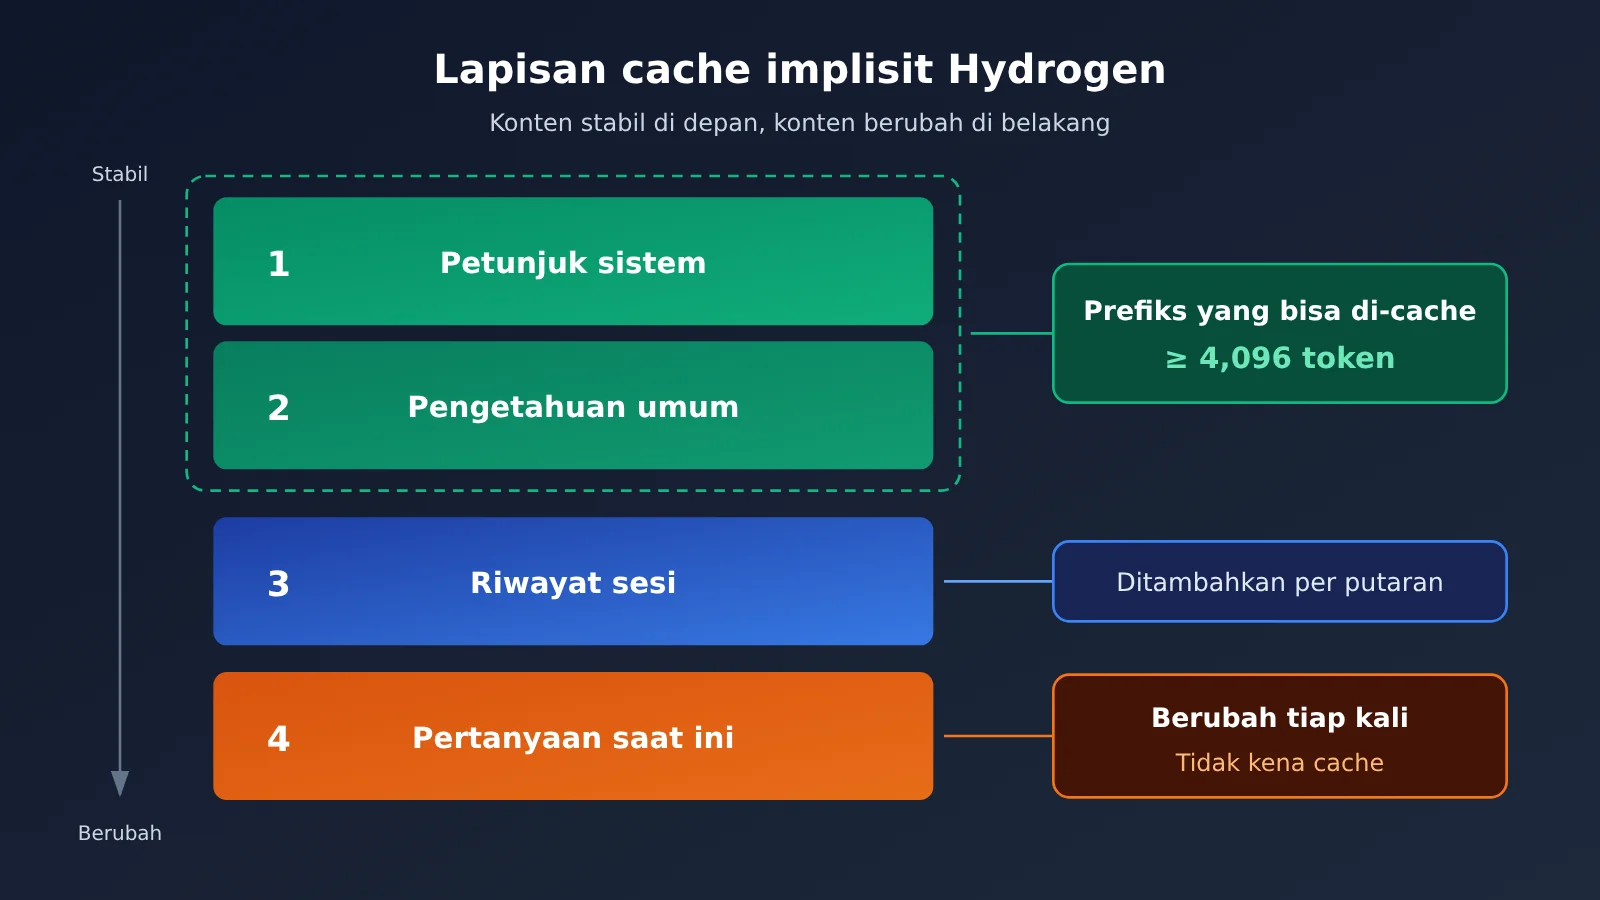
Dampak tipikal: Dari sisi harga, menurut halaman harga resmi Google AI Studio (tanggal verifikasi 13 November 2026, satuan dolar AS per juta token), input yang mengenai cache implisit untuk pemanggilan standar Hydrogen adalah $0,075, sedangkan mode Batch dan Flex adalah $0,0375, jauh lebih rendah daripada input standar sebesar $1,50. Jika variabel dinamis (stempel waktu, ID pengguna, dan sebagainya) disisipkan di awal petunjuk, prefiks akan berbeda setiap kali, sehingga cache tidak dapat terkena.
6. Penyesuaian 5: Menjaga thought_signature dengan benar di Hydrogen
Perilaku lama: Pada 3.8 Flash, banyak framework Agent membangun ulang riwayat percakapan sendiri dan hanya mempertahankan teks serta hasil pemanggilan tool. Akibatnya, hilangnya signature sering kali tidak menimbulkan dampak yang terlihat.
Perilaku baru: Percakapan multi-putaran di Hydrogen perlu mempertahankan signature dari semua bagian terkait sebelumnya, termasuk signature yang dibawa oleh bagian teks final. Panduan migrasi resmi menetapkan aturan berikut untuk pemanggilan tool paralel:
- Beberapa
functionCallparalel harus berada dalam pesan model yang sama; thought_signaturehanya diletakkan pada bagianfunctionCallparalel pertama;functionResponseberikutnya harus dikembalikan sesuai ID pemanggilan, nama, dan urutan yang bersesuaian;- Saat model yang sama menggunakan kembali signature, jika prefiks riwayat berubah, secara default model dapat mengembalikan HTTP 400.
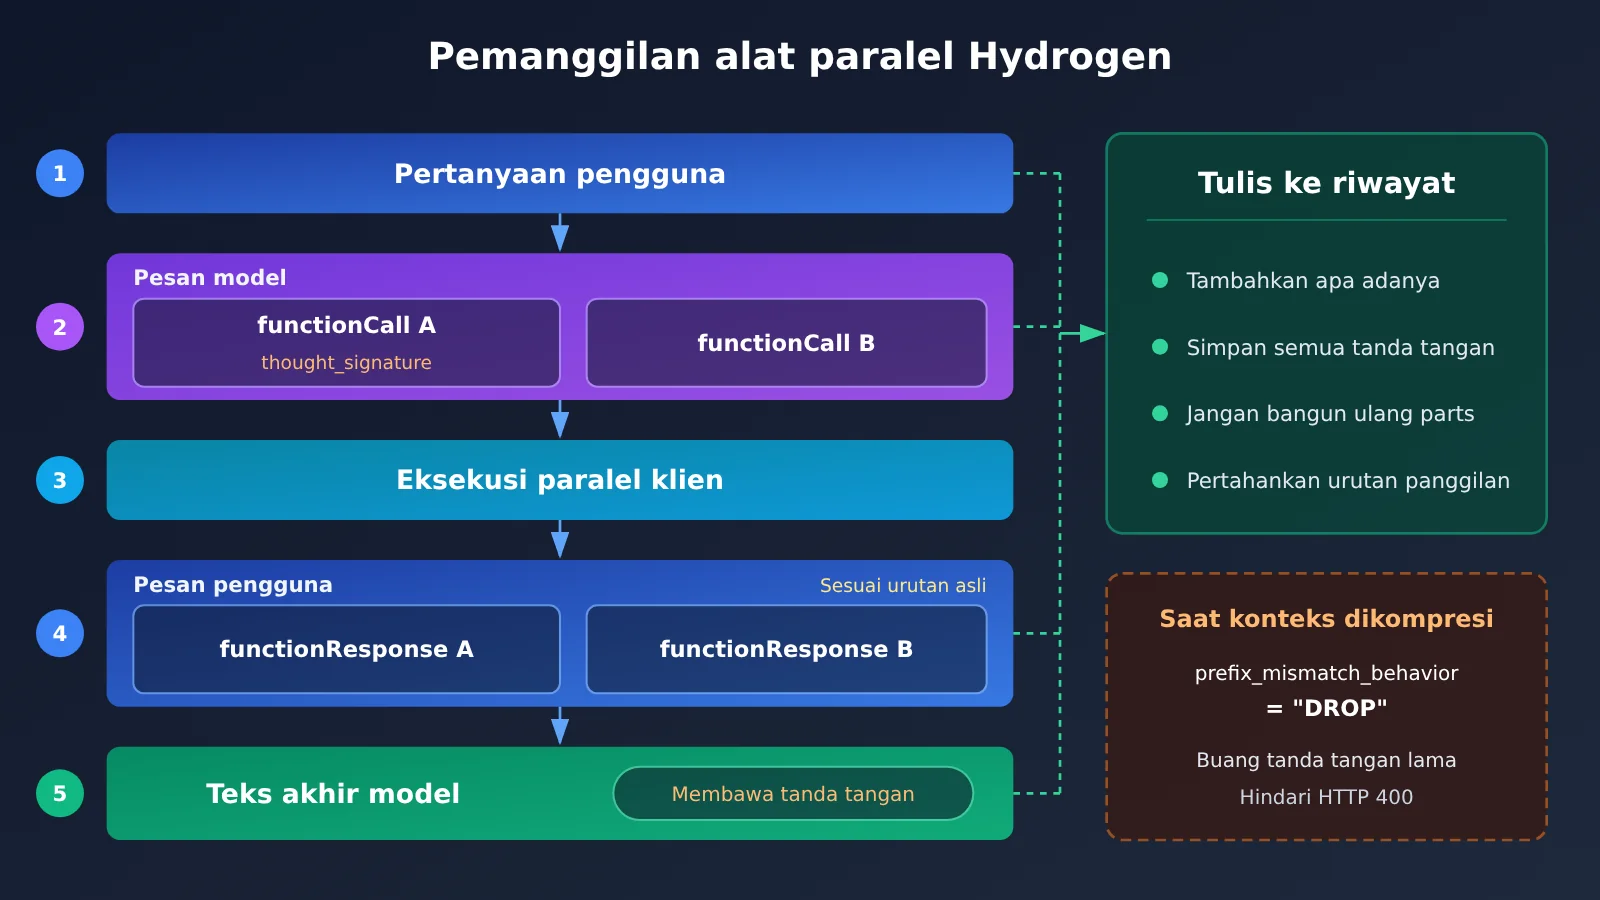
Cara memperbaiki pemeliharaan signature di Hydrogen
Cara paling aman adalah tidak membangun ulang parts secara manual, melainkan menambahkan objek content yang dikembalikan model ke riwayat apa adanya:
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # simpan apa adanya; signature ikut terjaga

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # pertahankan urutan yang sama dengan functionCall
]
history.append(types.Content(role="user", parts=responses))
Untuk Agent yang mengompresi atau memangkas riwayat (misalnya sliding window atau penggantian dengan ringkasan), prefiks riwayat pasti berubah. Dalam kondisi ini, Anda dapat mengonfigurasi prefix_mismatch_behavior="DROP" sesuai panduan migrasi agar model membuang signature lama saat prefiks tidak cocok, bukan mengembalikan error. Untuk lokasi persis field ini di dalam request, silakan mengacu pada panduan migrasi resmi.
Dampak umum: Agent Harness buatan sendiri, asisten coding yang mencari file secara paralel, dan bot percakapan panjang dengan kompresi konteks paling terdampak. Sebaiknya tulis tes integrasi khusus untuk pengembalian signature.
7. Daftar Periksa Migrasi Hydrogen dan Contoh Pemanggilan Minimal
| Item Pemeriksaan | Sebelum migrasi (3.8 Flash) | Setelah migrasi (Hydrogen) | Selesai |
|---|---|---|---|
| ID Model | ID model lama | gemini-4-hydrogen |
☐ |
| SDK | Versi apa pun | Python >= 2.34.0, JS >= 2.32.0 (Interactions) | ☐ |
| Versi API | v1 | Gunakan v1beta1 saat memerlukan kelanjutan output panjang | ☐ |
| Parameter thinking | thinking_budget / MINIMAL | thinking_level ditetapkan secara eksplisit | ☐ |
| Parameter generasi | temperature dan lainnya dapat disesuaikan | Hapus penalty, candidate_count, dan putaran prefill | ☐ |
| Cache | cached_content | Letakkan konten stabil di awal, prefiks ≥ 4,096 token | ☐ |
| Pemanggilan tool | Membangun ulang riwayat sendiri | Pertahankan signature apa adanya, respons paralel dikembalikan sesuai urutan | ☐ |
| Penanganan kesalahan | Retry umum | Bedakan error validasi HTTP 400 dengan pengabaian senyap | ☐ |
Verifikasi cepat melalui antarmuka kompatibel OpenAI
Jika kode bisnis tim Anda dibangun di atas OpenAI SDK, Anda dapat lebih dulu memverifikasi kualitas output Hydrogen melalui antarmuka kompatibel, lalu memutuskan apakah akan bermigrasi ke SDK native. Apakah model tersedia dan parameter mana yang dapat diteruskan, mengacu pada daftar model dan dokumentasi platform:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
Lihat kode implementasi lengkap (termasuk pemanggilan tool dan retensi riwayat)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu, memudahkan perbandingan model lama dan baru
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # Petunjuk sistem yang stabil diletakkan paling awal agar lebih mudah terkena cache implisit
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # Seluruh pesan assistant ditulis kembali ke riwayat apa adanya, tanpa memangkas field di dalamnya
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # Kembalikan hasil satu per satu sesuai urutan asli tool_calls
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 Saran memulai cepat: Selama migrasi, sebaiknya pertahankan 3.8 Flash sebagai grup kontrol, lalu jalankan model lama dan baru secara bersamaan dengan kumpulan permintaan nyata yang sama. Melalui APIYI apiyi.com, satu kunci API dapat digunakan untuk memanggil kedua model sekaligus. Pengguna baru mendapat kuota pengujian gratis, cocok untuk membandingkan dengan trafik kecil terlebih dahulu sebelum beralih sepenuhnya.
FAQ (Pertanyaan yang Sering Diajukan)
Q1: Apa itu Gemini 4 Hydrogen?
Gemini 4 Hydrogen adalah model yang dirilis Google DeepMind pada 12 November 2026, dengan ID API `gemini-4-hydrogen`. Model ini diadaptasi dari Gemini 4 Carbon dan menekankan kecepatan, pemrograman sehari-hari, pemanggilan berbagai tool, serta eksekusi tugas otomatis. Hydrogen dapat digunakan secara mandiri atau berperan sebagai eksekutor maupun validator dalam sistem multi-model.
Q2: Seberapa besar perbedaan kemampuan Hydrogen dan Gemini 3.8 Flash?
Berdasarkan data resmi yang dipublikasikan Google, Hydrogen mencetak 57.0% pada Terminal-Bench 4.1, sedangkan 3.8 Flash 18.2%; dalam kondisi pengujian yang sama, penyelesaian tugas sekitar 2.5 kali lebih cepat. Hasil pengujian resmi atau mitra ini tidak dapat langsung digeneralisasikan ke seluruh tugas aktual.
Q3: Apakah biaya akan turun setelah migrasi ke Hydrogen?
Tidak selalu. Menurut halaman harga resmi Google AI Studio (tanggal verifikasi 13 November 2026), pemanggilan standar Hydrogen dikenai biaya input $1.50 dan output $7.50 (USD per juta token), sedangkan 3.8 Flash sebelum 31 Desember 2026 adalah $0.75 / $3.75, lalu mulai 1 Januari 2027 disesuaikan menjadi $1.50 / $7.50. Harga satuan saat ini dua kali lipat harga 3.8 Flash; total biaya bergantung pada panjang pemikiran, jumlah percobaan ulang, dan efisiensi penyelesaian tugas.
Q4: Proyek mana yang paling perlu diprioritaskan untuk pemeriksaan kompatibilitas?
Utamanya mencakup beberapa kategori berikut:
– **Agent yang memanggil banyak tool secara paralel**: posisi signature dan urutan respons paling rawan bermasalah;
– **Sistem percakapan panjang dengan kompresi konteks**: perlu menangani masalah ketidakcocokan prefix;
– **Pembuatan laporan panjang dan kode panjang**: perlu meningkatkan SDK dan beralih ke v1beta1;
– **Sistem batch yang bergantung pada cache eksplisit untuk mengendalikan biaya**: perlu beralih ke strategi cache implisit.
Q5: Bagaimana cara membandingkan model lama dan baru dengan cepat melalui API?
Pendekatan yang disarankan:
1. Kunjungi APIYI apiyi.com untuk mendaftar akun dan mendapatkan kunci API;
2. Gunakan contoh kompatibel OpenAI di artikel ini, lalu atur `model` ke ID model lama dan baru secara terpisah;
3. Bandingkan kualitas output, latensi, dan penggunaan token dengan kumpulan permintaan bisnis yang sama.
Antarmuka terpadu menghindari pemeliharaan autentikasi dan kode permintaan secara terpisah untuk kedua model.
Q6: Apa saja batasan Hydrogen yang diketahui?
Kartu model resmi menyebutkan: model masih dapat menghasilkan halusinasi; tingkat pemikiran tinggi secara signifikan meningkatkan waktu dan biaya, kadang terjadi latensi atau timeout; pengetahuan dibatasi hingga Maret 2026; dibandingkan 3.8 Flash, indikator penolakan yang tidak wajar memburuk sebesar 5.57 poin persentase. Selain itu, Hydrogen tidak mendukung Live API dan Fine-tuning. Dalam umpan balik awal komunitas, sejumlah pengguna juga melaporkan adanya eksekusi berlebihan pada tugas Agent, yang merupakan pengalaman individual.
Q7: Bagaimana mengendalikan risiko biaya pada awal migrasi?
Disarankan untuk terlebih dahulu mengatur `thinking_level=”medium”` secara eksplisit untuk menjalankan baseline, kemudian aktifkan High secara terpisah untuk Agent multi-langkah; sekaligus periksa rasio cache hit implisit dan proporsi token pemikiran. Jika ingin penagihan sesuai penggunaan dan melihat pemakaian multi-model secara terpusat, Anda juga dapat menggunakan tagihan terpadu APIYI apiyi.com untuk perbandingan.
Poin Penting Migrasi Hydrogen
- Bukan sekadar ganti nama: Mengubah ID model menjadi
gemini-4-hydrogenhanyalah langkah pertama; ada empat konfigurasi lain yang perlu disesuaikan bersamaan. - SDK jadi syarat wajib: Kelanjutan keluaran panjang membutuhkan Python >= 2.34.0, JS >= 2.32.0 (Interactions API), dan menggunakan v1beta1.
- Parameter thinking ganti generasi:
thinking_budgetdanMINIMALakan mengembalikan HTTP 400, dan level default kini menjadi High. - Parameter sampling tidak berlaku lagi: temperature, top_p, top_k diabaikan; penalty, multi-kandidat, dan putaran prefill perlu dihapus.
- Cache bergantung pada struktur: Cache eksplisit dihapus; prefix stabil harus mencapai 4,096 tokens agar implicit cache bisa terpicu.
- Signature harus lengkap: Signature pemanggilan paralel hanya ada di functionCall pertama, respons dikembalikan sesuai urutan, dan riwayat yang dipadatkan bisa diatur ke DROP.
- Bandingkan dulu sebelum beralih: Lewat APIYI apiyi.com, pakai Key yang sama untuk memanggil model lama dan baru; validasi dengan trafik kecil sebelum migrasi penuh.
Ringkasan
Poin utama upgrade dari Gemini 3.8 Flash ke Hydrogen:
- Lapisan dasar: Perbarui ID model dan SDK, pahami kuota terpadu 1,048,576 tokens dan batas keluaran 65,536 tokens per segmen;
- Lapisan parameter: Ganti
thinking_budgetdenganthinking_level, bersihkan field sampling dan generasi yang sudah tidak berlaku; - Lapisan state: Rancang ulang struktur prompt agar implicit cache terpicu, lalu pertahankan dan kembalikan
thought_signatureapa adanya.
Disarankan untuk mengikuti checklist pada artikel ini dan melakukan perubahan item per item, menulis regression test untuk tool calling dan keluaran panjang, kemudian mengalihkan trafik nyata ke model baru. Cara cepat untuk membandingkan hasil model lama dan baru adalah lewat APIYI apiyi.com; platform ini menyediakan antarmuka yang kompatibel dengan OpenAI serta kuota uji gratis untuk pengguna baru.
📚 Referensi
- Panduan Migrasi Pengembang Gemini 4 Hydrogen: perubahan kompatibilitas dan daftar periksa migrasi resmi
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Keterangan: sumber utama untuk detail seperti versi SDK minimum, aturan signature, dan prefix_mismatch_behavior
-
Pengenalan Gemini 4 dan Perbandingan Perbedaan Migrasi: penjelasan output panjang dan versi API
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
Keterangan: menjelaskan bahwa fitur penyambungan (continuation) memerlukan API v1beta1
-
Spesifikasi Model Google Cloud Hydrogen: tabel dukungan konteks, parameter, dan fitur
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Keterangan: nilai tetap temperature, top_p, top_k serta status dukungan caching
-
Blog Rilis Resmi Google: pengumuman rilis Gemini 4 Hydrogen
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Keterangan: posisi produk dan data perbandingan resmi dengan 3.8 Flash
-
Halaman Harga Google AI Studio: harga API resmi
- Tautan:
aistudio.google.com/docs/pricing -
Keterangan: harga standar, Batch, Flex, Priority, dan cache hit
-
Pengujian Independen Artificial Analysis: evaluasi empat tingkat penalaran (thinking level)
- Tautan:
artificialanalysis.ai/models/gemini-4-hydrogen -
Keterangan: indeks kecerdasan pihak ketiga, serta data waktu dan biaya pengujian
-
Kartu Model Google DeepMind: kemampuan, keterbatasan, dan evaluasi keamanan
- Tautan:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Keterangan: keterbatasan yang diketahui dan evaluasi lintas model resmi
Penulis: Tim Teknis APIYI
Diskusi teknis: Jika Anda menemui masalah kompatibilitas selama proses migrasi, silakan berdiskusi dengan kami melalui situs resmi APIYI. Untuk materi integrasi lainnya, Anda dapat merujuk ke pusat dokumentasi docs.apiyi.com