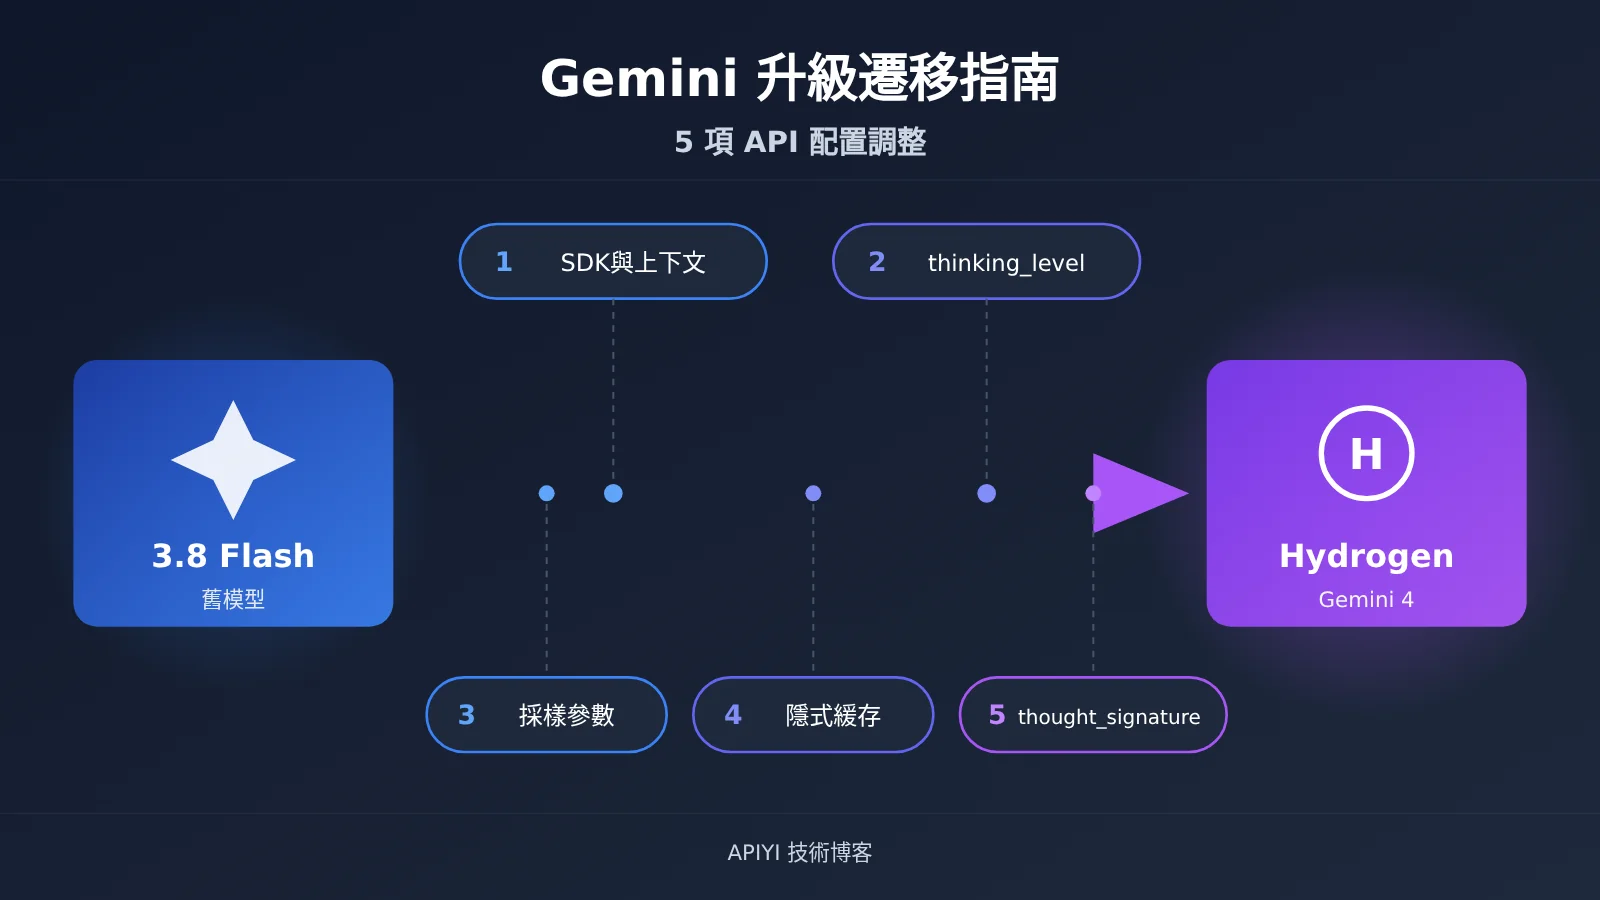
作者注:從 Gemini 3.8 Flash 遷移到 Hydrogen,需要同時調整 SDK 與上下文、思考參數、採樣配置、緩存,以及多輪工具調用的簽名管理。
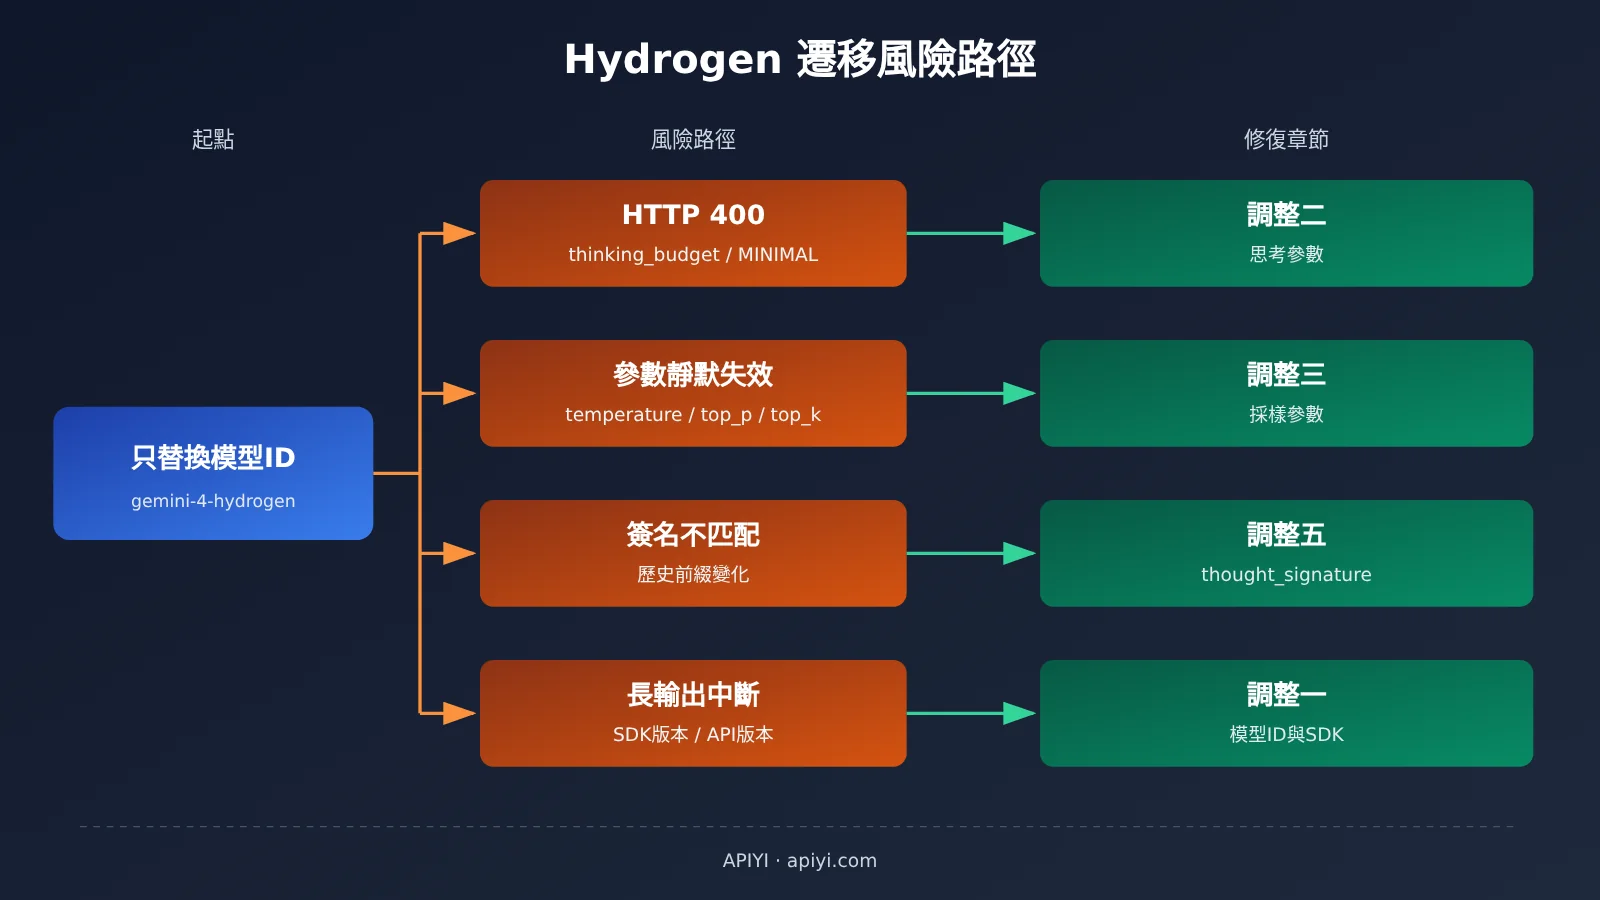
Google 於 2026 年 11 月 12 日正式發佈 Gemini 4 Hydrogen,API 模型 ID 爲 gemini-4-hydrogen,定位是日常編程與 AI Agent 執行。很多團隊的第一反應是把代碼裏的模型名替換掉就上線,結果遇到的是 HTTP 400、參數不起作用、多輪工具調用報錯和長輸出被截斷。本文梳理 Gemini 3.8 Flash 升級到 Hydrogen 必須調整的 5 項 API 配置,每一項都按“舊行爲 → 新行爲 → 修改方法 → 典型影響”的順序展開。
這不是一篇發佈會複述。文中的參數名、合法值、SDK 版本號和錯誤類型均來自 Google Cloud 官方遷移指南與模型規格文檔,第三方評測和社區反饋會單獨標註來源。
核心價值:讀完本文,你可以拿着一份檢查清單逐項修改現有的 Gemini 3.8 Flash 調用代碼,把 Agent 和批處理業務平穩遷移到 Hydrogen。
Hydrogen 遷移必須瞭解的 5 個術語
在動手修改之前,先統一幾個在遷移指南中反覆出現的概念:
- thinking_level:控制模型推理深度的思考等級參數。Hydrogen 用它取代了舊的
thinking_budget,合法檔位爲 Low、Medium、High、XHigh。 - thought_signature:模型在響應中返回的思考關聯簽名。多輪對話和工具調用時必須原樣保留並回傳,否則模型無法銜接之前的推理狀態。
- continuation_token:用於銜接長輸出下一段生成的續寫標記。單段輸出達到上限後,可以憑它繼續生成。
- 隱式緩存:平臺自動複用滿足條件的輸入前綴,命中部分按緩存價格計費,無需開發者手動創建緩存對象。
- 上下文窗口:單次模型處理可容納的信息範圍。Hydrogen 的輸入、輸出、思考和工具調用共同佔用 1,048,576 tokens 的統一額度。
一、升級 Hydrogen 爲什麼不能只換模型 ID
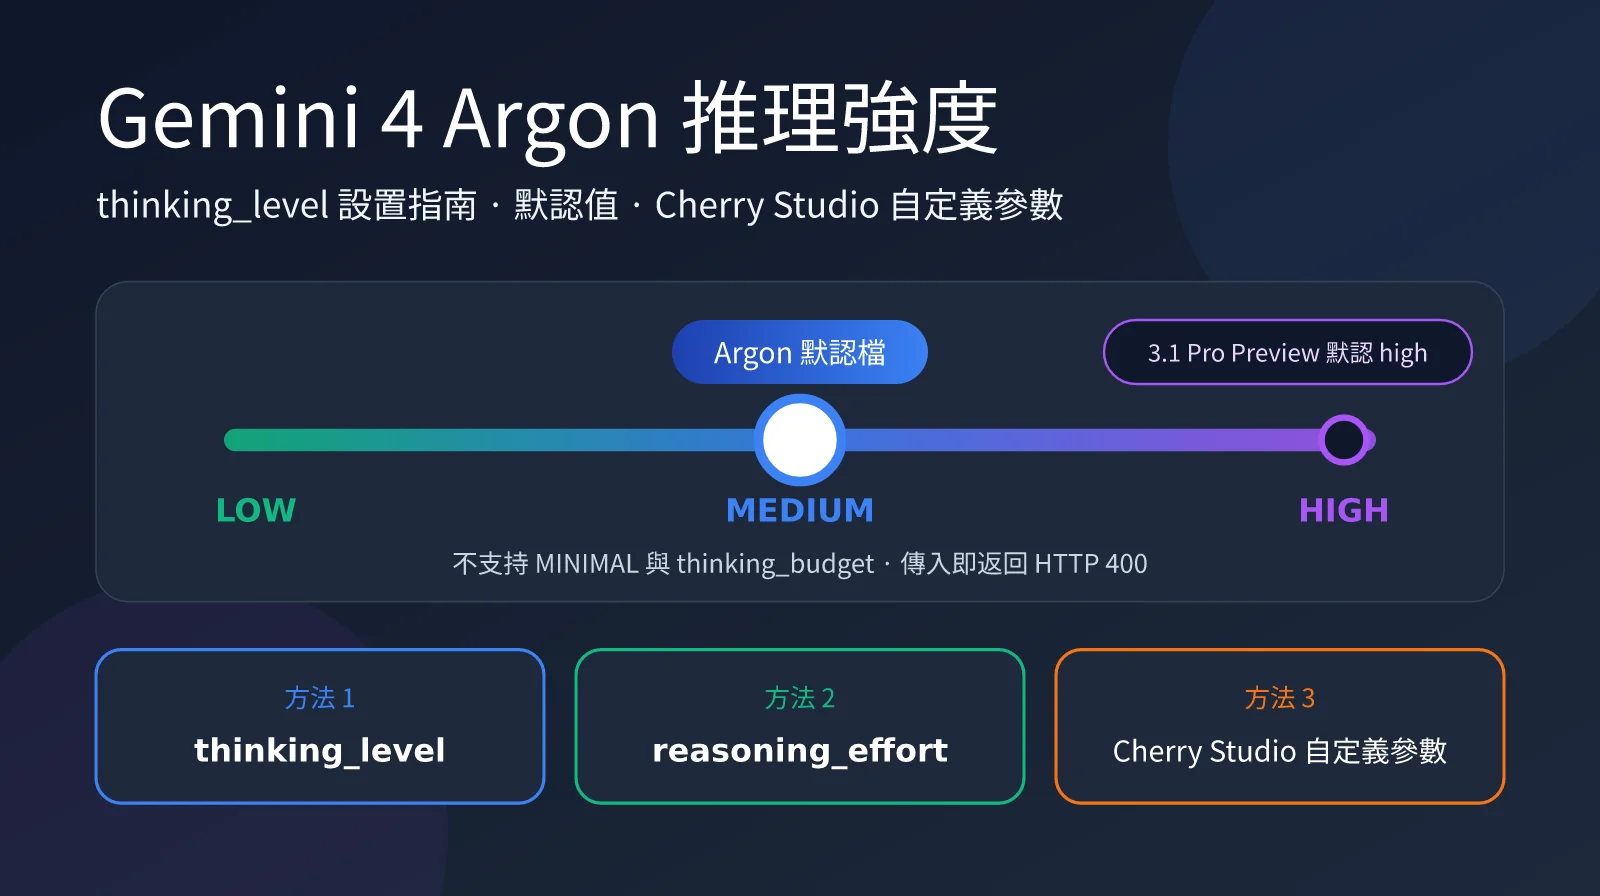
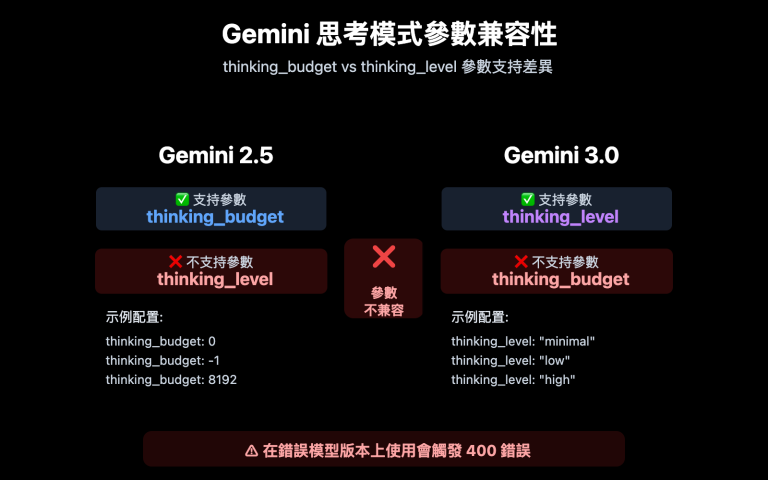
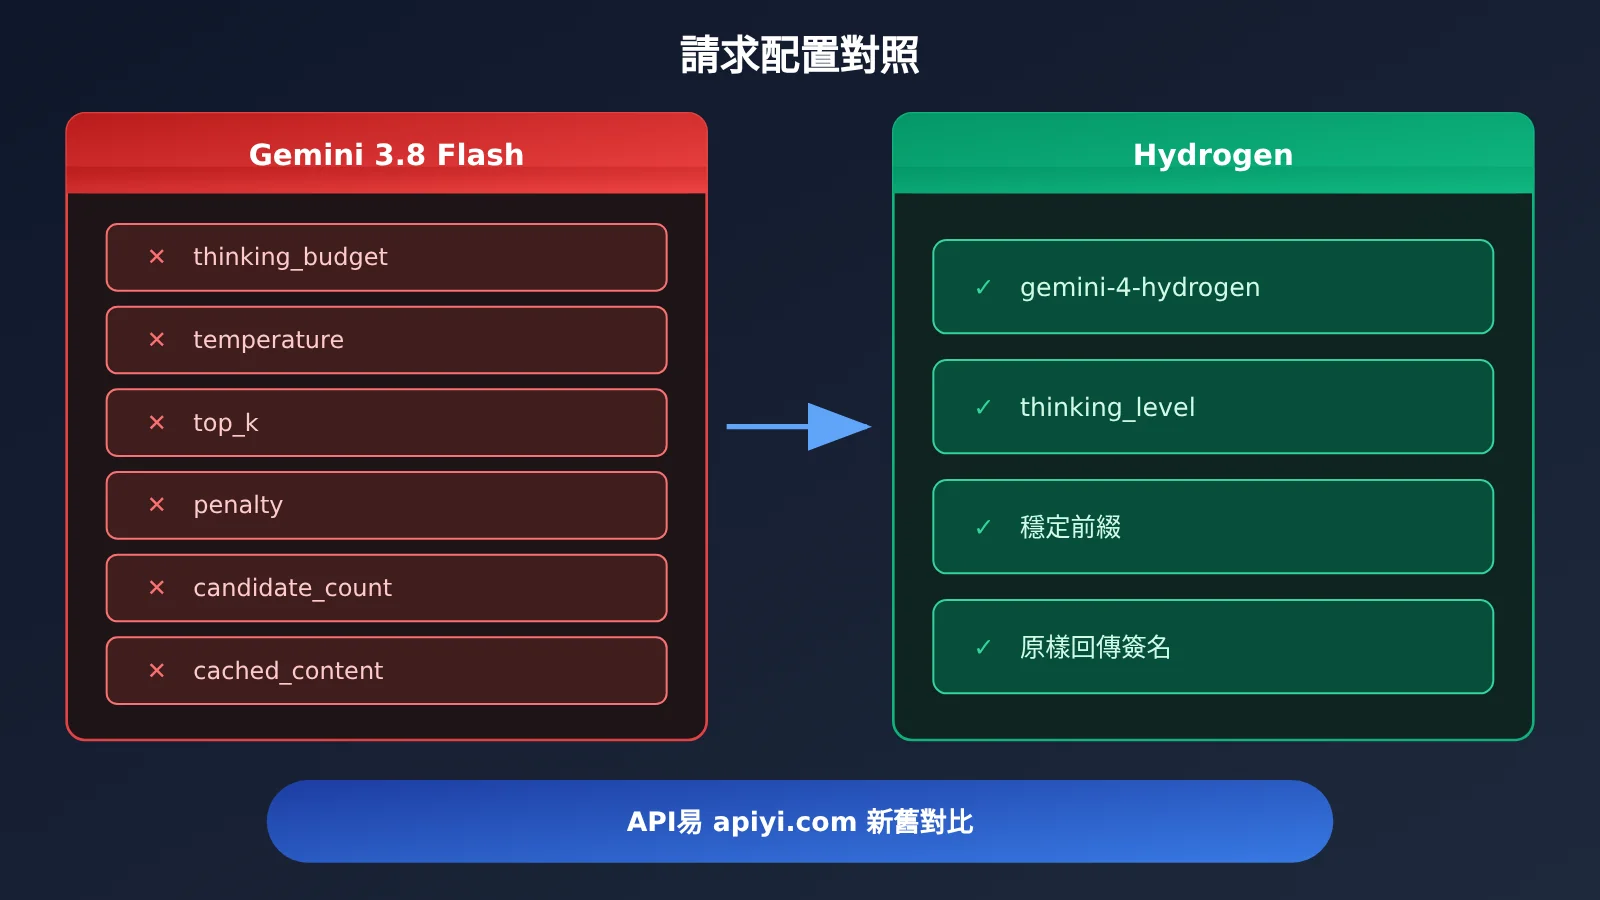
Gemini 3.8 Flash 和 Hydrogen 雖然同屬 Gemini 家族,但 API 行爲有不少不兼容之處。按照官方遷移指南,thinking_budget 和 MINIMAL 思考檔位在 Hydrogen 上不受支持,請求會直接返回 HTTP 400;而 temperature、top_p、top_k 這類採樣參數不會報錯,只是被靜默忽略。前一類問題在測試階段就能暴露,後一類則可能讓你誤以爲“參數還在生效”。
另外兩類風險更隱蔽。一是多輪工具調用的簽名管理更嚴格,歷史對話被壓縮或裁剪後,簽名與前綴不匹配就可能觸發 HTTP 400。二是默認思考檔位從 Medium 提到 High,如果不顯式設置,同樣的請求會消耗更多思考 Token、延遲也更長。下表是五項調整的概覽:
| 調整項 | 舊行爲(3.8 Flash) | 新行爲(Hydrogen) | 不改的後果 |
|---|---|---|---|
| 模型 ID、SDK 與上下文 | 舊模型 ID,舊版 SDK 可用 | gemini-4-hydrogen,長輸出續寫有 SDK 最低版本要求 |
長輸出中斷、續寫不可用 |
| 思考參數 | thinking_budget,默認 Medium |
thinking_level,默認 High |
HTTP 400,或成本與延遲上升 |
| 採樣與生成參數 | temperature、top_p、top_k 等可調 | 固定值,自定義被忽略;部分字段需移除 | 輸出風格不可控,部分請求校驗失敗 |
| 緩存 | 支持顯式緩存 cached_content |
僅支持隱式緩存,門檻 4,096 tokens | 緩存引用失效,成本估算偏差 |
| thought_signature | 簽名規則相對寬鬆 | 並行調用、前綴變化有嚴格規則 | 多輪 Agent 報錯或推理斷裂 |
二、調整一:Hydrogen 的模型 ID、SDK 版本與上下文限制
舊行爲 → 新行爲:在 3.8 Flash 時代,多數項目對 SDK 版本不敏感。遷移到 Hydrogen 後,模型 ID 要改爲 gemini-4-hydrogen;如果需要超長輸出,SDK 版本就成了硬性條件。Google 官方遷移指南給出的最低版本如下:
| 開發語言 | GenerateContent 自動續寫 | Interactions API 自動續寫 |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | 官方未單列 | >= 1.77.0 |
| Java | 官方未單列 | >= 1.80.0 |
Hydrogen 上下文與長輸出的修改方法
Hydrogen 的 1,048,576 tokens 是統一額度,輸入與歷史上下文、思考 Token、工具調用相關 Token、最終輸出都從這一個池子里扣除。也就是說,不能先輸入 100 萬 tokens 再額外輸出 100 萬 tokens。對於長文檔分析類 Agent,需要在輸入側主動預留思考和工具調用的空間。
單段前臺生成的上限通常爲 65,536 tokens。超過這個長度時有三種方式可選:使用受支持 SDK 的自動續寫、在 Interactions API 中設置 background=true 進行後臺長生成,或者自行維護 continuation_token 逐段拼接。需要特別注意的是,官方入門文檔說明長輸出續寫目前需要使用 v1beta1 API,Agent Platform 的 v1 不支持這一功能。
典型影響:批量生成長報告、長代碼文件的業務最容易踩坑。建議先升級 SDK,再把 API 版本切到 v1beta1,最後用一條超過 65,536 tokens 的請求做迴歸測試。
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
三、調整二:Hydrogen 的 thinking_budget 改爲 thinking_level
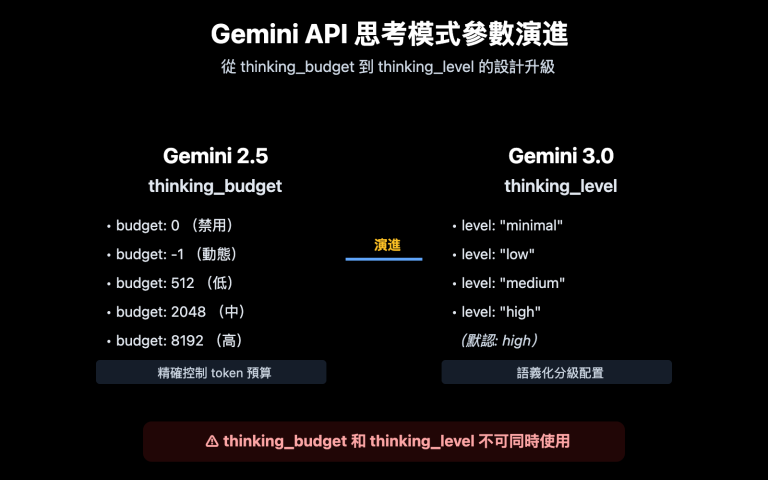
舊行爲:3.8 Flash 使用 thinking_budget 以 Token 數量控制思考長度,還可以選擇 MINIMAL 檔位,默認檔位爲 Medium。
新行爲:Hydrogen 只接受 thinking_level,合法值爲 Low、Medium、High、XHigh 四檔,默認爲 High。繼續傳入 thinking_budget 或 MINIMAL 會返回 HTTP 400。官方建議的用途分別是:Low 用於分類,Medium 用於常規編程,High 用於多步驟 Agent,XHigh 用於複雜深度推理。
第三方機構 Artificial Analysis 在 11 月 12 日完成了四檔獨立測評(Intelligence Index v5.0.1),可以幫助理解檔位差異。下表中的耗時和成本是其標準化評測任務的平均值,不代表普通用戶單條對話的實際開銷:
| 思考檔位 | 官方建議場景 | 智能指數(AA) | 評測平均耗時 | 評測平均成本 |
|---|---|---|---|---|
| Low | 分類、簡單抽取 | 27 | 1.3 分鐘 | $0.29 |
| Medium | 常規編程 | 41 | 3.7 分鐘 | $0.80 |
| High(默認) | 多步驟 Agent | 51 | 8.3 分鐘 | $1.87 |
| XHigh | 複雜深度推理 | 54 | 13.5 分鐘 | $3.16 |
從數據看,High 比 Medium 高出 10 分,而 XHigh 比 High 只多 3 分,評測成本卻從 1.87 美元升到 3.16 美元。這說明最高檔位未必最划算,同一模型名稱在不同檔位下的能力差異也很大。
Hydrogen thinking_level 修改示例
以下示例採用官方 Google Gen AI SDK 語法。枚舉值的大小寫寫法請以所安裝 SDK 版本的類型定義爲準:
from google import genai
from google.genai import types

client = genai.Client()

# 舊寫法(3.8 Flash):會在 Hydrogen 上返回 HTTP 400
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# 新寫法:常規編程任務選 Medium
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# 多步驟 Agent 選 High(也是默認值,建議顯式寫出)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修復這個函數中的空指針問題:...",
    config=coding_config,
)
print(resp.text)
典型影響:由於思考 Token 按輸出價格計費,不顯式設置檔位的項目在遷移後會自動落到 High,賬單和延遲都會上升。建議把舊的 thinking_budget 區間映射爲檔位:較小預算對應 Low 或 Medium,較大預算對應 High。
四、調整三:清理 Hydrogen 中失效的生成參數
舊行爲:3.8 Flash 允許通過 temperature、top_p、top_k 調節輸出隨機性,也支持懲罰參數和多候選輸出。
新行爲:Hydrogen 的默認溫度爲 1.0 且自定義不生效,top_p 固定爲 0.95,top_k 固定爲 64,這三個參數傳入後會被忽略。官方遷移清單還要求處理以下字段:
| 字段或行爲 | Hydrogen 遷移要求 | 排障提示 |
|---|---|---|
| temperature / top_p / top_k | 自定義值被忽略 | 不報錯,需靠提示詞控制風格 |
| frequency_penalty / presence_penalty | 移除 | 以實際報錯爲準,統一刪除最穩妥 |
| candidate_count > 1 | 移除多候選設置 | 需要多樣性時改爲多次請求 |
| 預填充的 model 歷史輪次 | 移除 | 不能再用“替模型起頭”的方式引導格式 |
| cached_content | 不再引用顯式緩存 | 見調整四 |
| thinking_budget | 改用合法的 thinking_level | 返回 HTTP 400 |
官方特別提醒,部分舊參數只是被忽略,另一些則會導致請求驗證失敗。因此排障邏輯不能一刀切:遇到 400 時優先檢查 thinking_budget、MINIMAL 和需移除的字段;輸出風格與預期不符時,再檢查是否還依賴溫度參數。
Hydrogen 簡化後的請求配置
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # 穩定內容放前面,利於隱式緩存
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # 結構化輸出仍受支持
    max_output_tokens=8192,
)
典型影響:過去依賴低溫度保證 JSON 穩定輸出的項目,應改用結構化輸出能力;依賴預填充 model 輪次控制格式的項目,需要把格式要求寫進系統提示詞。
五、調整四:Hydrogen 顯式緩存改爲隱式緩存
舊行爲:在 3.8 Flash 上,開發者可以先創建緩存對象,再在請求裏通過 cached_content="cachedContents/xxx" 引用。
新行爲:Hydrogen 不支持顯式上下文緩存,只支持隱式緩存,並默認啓用持久化的隱式緩存機制。緩存的最小前綴長度從 3.8 Flash 的 6,144 tokens 降到 4,096 tokens,相對較短的公共系統提示詞和固定知識材料也更容易命中。
修改方法:刪除所有 caches.create 調用和 cached_content 引用,轉而優化提示詞的拼接順序。Google 建議把穩定的公共內容放在輸入前部,把每次變化的用戶問題放在末尾:
- 系統提示詞與角色設定(幾乎不變)
- 公共知識庫、API 文檔、代碼規範(低頻變化)
- 會話歷史(逐輪追加)
- 當前用戶問題(每次變化)
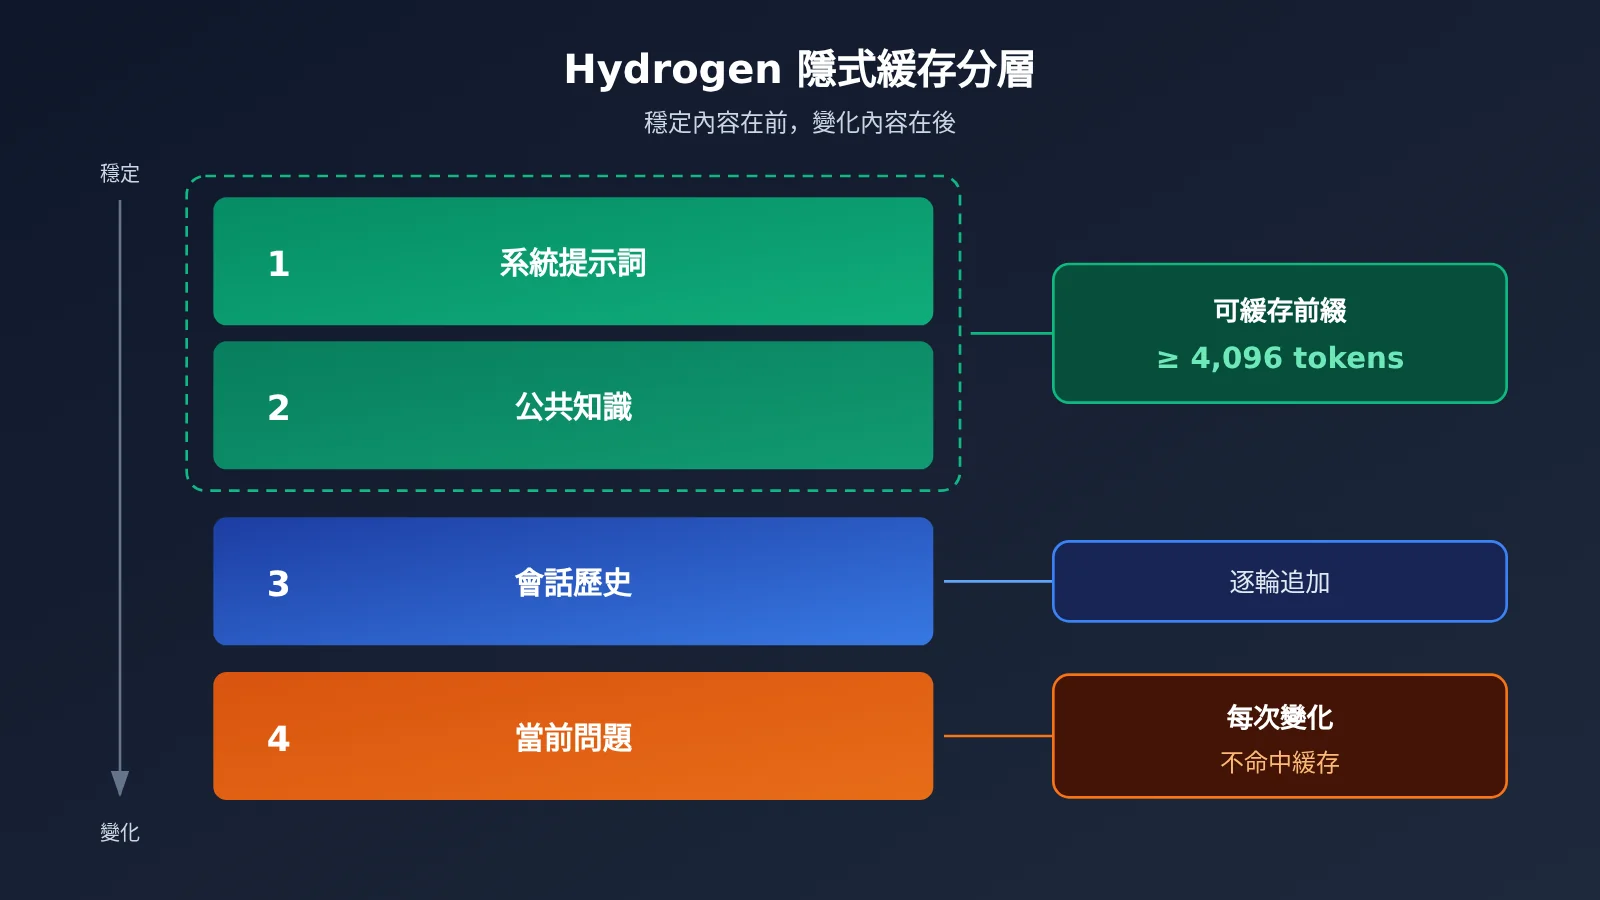
典型影響:價格方面,根據 Google AI Studio 官方價格頁(覈驗日期 2026 年 11 月 13 日,單位爲美元每百萬 tokens),Hydrogen 標準調用的隱式緩存命中輸入爲 $0.075,Batch 和 Flex 模式爲 $0.0375,遠低於標準輸入的 $1.50。如果把動態變量(時間戳、用戶 ID 等)插到提示詞開頭,前綴每次都不同,緩存就無法命中。
六、調整五:在 Hydrogen 中正確維護 thought_signature
舊行爲:在 3.8 Flash 上,不少 Agent 框架會自行重建對話歷史,只保留文本和工具調用結果,簽名丟失往往沒有明顯影響。
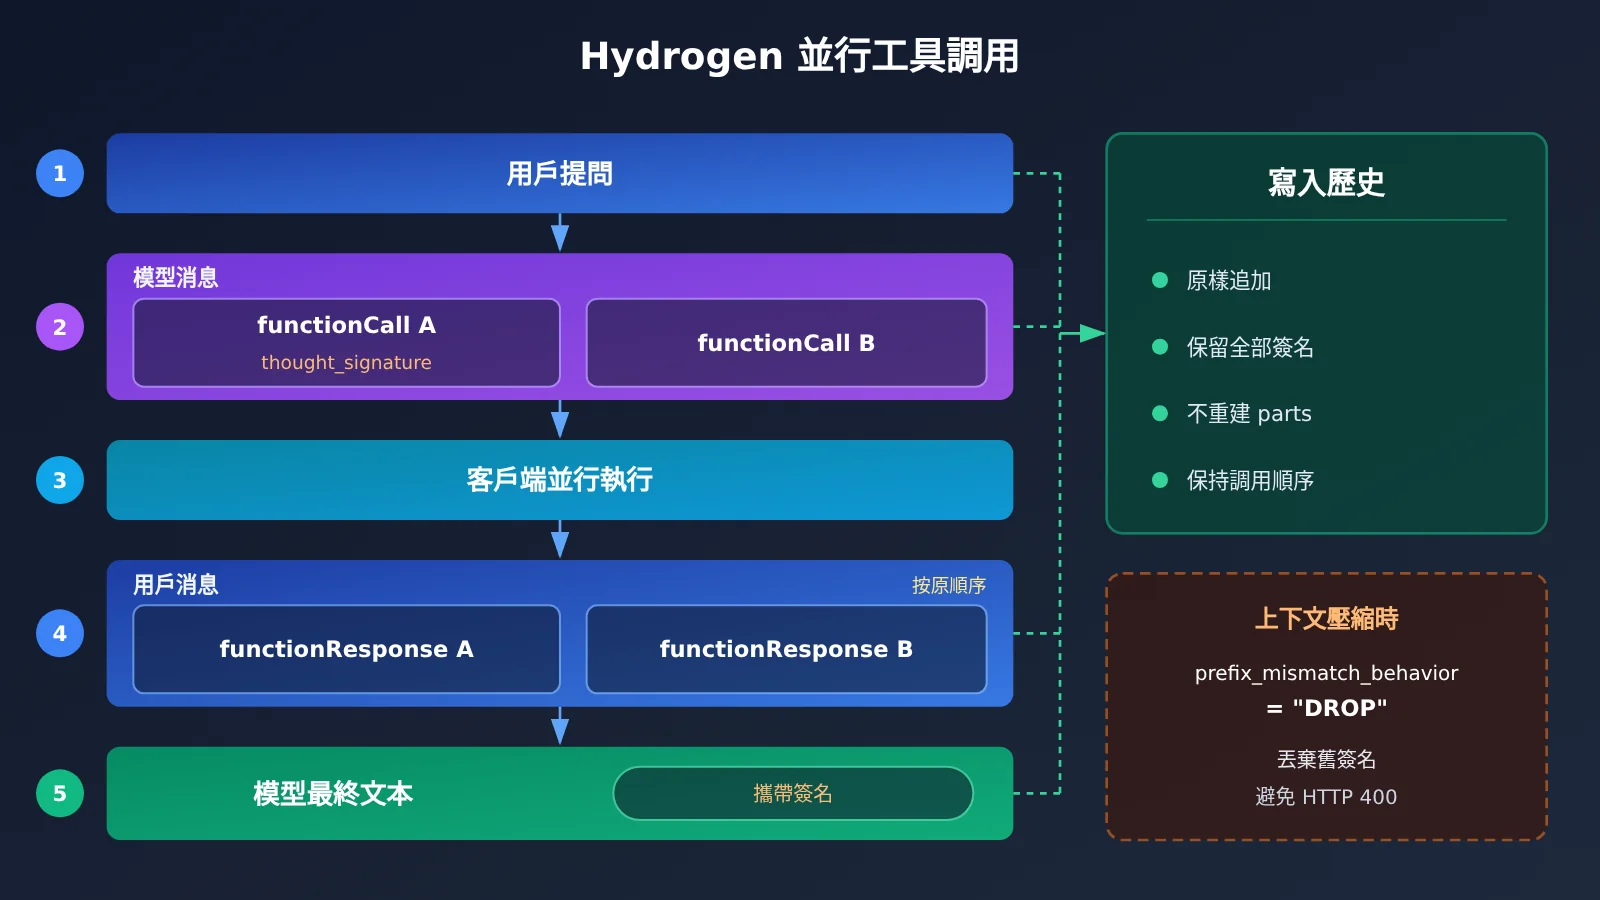
新行爲:Hydrogen 的多輪對話需要保留此前所有相關部分的簽名,包括最終文本部分攜帶的簽名。官方遷移指南對並行工具調用的規定如下:
- 多個並行
functionCall必須處於同一個模型消息中; thought_signature只放在首個並行functionCall部分;- 後續
functionResponse必須按照對應的調用 ID、名稱和順序返回; - 同一模型複用簽名時,如果歷史前綴發生變化,默認可能返回 HTTP 400。
Hydrogen 簽名維護的修改方法
最穩妥的做法是不手動重建 parts,而是把模型返回的 content 對象原樣追加到歷史裏:
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # 原樣保留,簽名隨之保留

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # 保持與 functionCall 相同的順序
]
history.append(types.Content(role="user", parts=responses))
對於會壓縮或裁剪歷史的 Agent(例如滑動窗口、摘要替換),歷史前綴必然發生變化。此時可以按遷移指南配置 prefix_mismatch_behavior="DROP",讓模型在前綴不匹配時丟棄舊簽名而不是報錯。該字段在請求中的具體位置請以官方遷移指南爲準。
典型影響:自研 Agent Harness、並行檢索文件的編碼助手,以及帶上下文壓縮的長會話機器人受影響最大,建議爲簽名回傳單獨編寫集成測試。
七、Hydrogen 遷移檢查清單與最小調用示例
| 檢查項 | 遷移前(3.8 Flash) | 遷移後(Hydrogen) | 完成 |
|---|---|---|---|
| 模型 ID | 舊模型 ID | gemini-4-hydrogen |
☐ |
| SDK | 任意版本 | Python >= 2.34.0,JS >= 2.32.0(Interactions) | ☐ |
| API 版本 | v1 | 需長輸出續寫時使用 v1beta1 | ☐ |
| 思考參數 | thinking_budget / MINIMAL | thinking_level 顯式設置 | ☐ |
| 生成參數 | temperature 等可調 | 刪除 penalty、candidate_count、預填充輪次 | ☐ |
| 緩存 | cached_content | 穩定內容前置,前綴 ≥ 4,096 tokens | ☐ |
| 工具調用 | 自行重建歷史 | 原樣保留簽名,並行響應按序返回 | ☐ |
| 錯誤處理 | 通用重試 | 區分 HTTP 400 校驗錯誤與靜默忽略 | ☐ |
通過 OpenAI 兼容接口快速驗證
如果團隊的業務代碼基於 OpenAI SDK,可以先通過兼容接口快速驗證 Hydrogen 的輸出質量,再決定是否改造爲原生 SDK。模型是否上架及可透傳的參數,以平臺模型列表和文檔爲準:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 寫一個帶重試的 HTTP 請求函數"}],
)
print(resp.choices[0].message.content)
查看完整實現代碼(含工具調用與歷史保留)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 統一接口,便於新舊模型對比
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "讀取倉庫中的文件內容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代碼修復助手。只修改與問題相關的代碼。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # 穩定的系統提示放在最前,利於隱式緩存命中
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # 整條 assistant 消息原樣寫回歷史,不裁剪其中的字段
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # 按 tool_calls 的原始順序逐一返回結果
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "達到最大步數,任務未完成"

if __name__ == "__main__":
    print(run_agent("檢查 utils.py 中的 parse_date 函數是否有時區問題"))
🚀 快速上手建議:遷移期間建議保留 3.8 Flash 作爲對照組,用同一批真實請求同時跑新舊模型。通過 API易 apiyi.com 可以用一個 API Key 同時調用兩個模型,新用戶有免費測試額度,適合先做小流量對比再全量切換。
常見問題 FAQ
Q1:什麼是 Gemini 4 Hydrogen?
Gemini 4 Hydrogen 是 Google DeepMind 於 2026 年 11 月 12 日發佈的模型,API ID 爲 `gemini-4-hydrogen`。它由 Gemini 4 Carbon 適配而來,側重速度、日常編程、多工具調用和自動化任務執行,可單獨使用,也可在多模型系統中擔任執行者或驗證者。
Q2:Hydrogen 和 Gemini 3.8 Flash 的能力差別有多大?
根據 Google 官方公佈的數據,Hydrogen 在 Terminal-Bench 4.1 上爲 57.0%,3.8 Flash 爲 18.2%;相同測試條件下任務完成速度約快 2.5 倍。這些是官方或合作伙伴的測試結果,不能直接外推到所有實際任務。
Q3:遷移到 Hydrogen 後成本會降低嗎?
不一定。根據 Google AI Studio 官方價格頁(覈驗日期 2026 年 11 月 13 日),Hydrogen 標準調用爲輸入 $1.50、輸出 $7.50(美元每百萬 tokens),而 3.8 Flash 在 2026 年 12 月 31 日前爲 $0.75 / $3.75,2027 年 1 月 1 日起調整爲 $1.50 / $7.50。單價目前是 3.8 Flash 的兩倍,總成本取決於思考長度、重試次數和任務完成效率。
Q4:哪些項目最需要優先排查兼容性?
主要包括以下幾類:
– **多工具並行調用的 Agent**:簽名位置和響應順序最容易出錯;
– **帶上下文壓縮的長會話系統**:需要處理前綴不匹配問題;
– **長報告與長代碼生成**:需要升級 SDK 並切換到 v1beta1;
– **依賴顯式緩存控制成本的批處理系統**:需要改爲隱式緩存策略。
Q5:如何通過 API 快速對比新舊模型?
推薦的做法是:
1. 訪問 API易 apiyi.com 註冊賬號並獲取 API Key;
2. 使用本文的 OpenAI 兼容示例,把 `model` 分別設爲新舊模型 ID;
3. 用同一批業務請求比較輸出質量、延遲和 Token 用量。
統一接口可以避免爲兩個模型分別維護鑑權和請求代碼。
Q6:Hydrogen 有哪些已知限制?
官方模型卡指出:仍可能產生幻覺;高思考檔位耗時和成本明顯增加,偶有延遲或超時;知識截止於 2026 年 3 月;相比 3.8 Flash,不合理拒答指標惡化 5.57 個百分點。此外,Hydrogen 不支持 Live API 和 Fine-tuning。社區早期反饋中也有用戶報告 Agent 任務存在過度執行的情況,屬於個體體驗。
Q7:遷移初期如何控制費用風險?
建議先顯式設置 `thinking_level=”medium”` 跑基線,再針對多步驟 Agent 單獨開啓 High;同時檢查隱式緩存命中率和思考 Token 佔比。如果希望按量計費、集中查看多模型用量,也可以藉助 API易 apiyi.com 的統一賬單做對比。
Hydrogen 遷移核心要點 Key Takeaways
- 不只是換名字:模型 ID 改爲
gemini-4-hydrogen只是第一步,另有四項配置需同步調整。 - SDK 是硬門檻:長輸出續寫要求 Python >= 2.34.0、JS >= 2.32.0(Interactions API),並使用 v1beta1。
- 思考參數換代:
thinking_budget和MINIMAL會返回 HTTP 400,默認檔位已變爲 High。 - 採樣參數失效:temperature、top_p、top_k 被忽略,penalty、多候選和預填充輪次需移除。
- 緩存靠結構:顯式緩存取消,穩定前綴達到 4,096 tokens 才能命中隱式緩存。
- 簽名必須完整:並行調用簽名只在首個 functionCall,響應按序返回,壓縮歷史可設 DROP。
- 先對比再切換:通過 API易 apiyi.com 用同一 Key 調用新舊模型,小流量驗證後再全量遷移。
總結
從 Gemini 3.8 Flash 升級到 Hydrogen 的核心要點:
- 基礎層:更新模型 ID 與 SDK,理解 1,048,576 tokens 的統一額度和單段 65,536 tokens 的輸出上限;
- 參數層:用
thinking_level替代thinking_budget,清理失效的採樣與生成字段; - 狀態層:重新設計提示詞結構以命中隱式緩存,原樣保留並回傳
thought_signature。
建議按本文的檢查清單逐項改造,併爲工具調用和長輸出編寫回歸測試,再把真實流量切到新模型。推薦通過 API易 apiyi.com 快速完成新舊模型的效果對比,平臺提供 OpenAI 兼容接口和新用戶免費測試額度。
📚 參考資料
- Gemini 4 Hydrogen 開發者遷移指南:官方兼容性變化與遷移清單
- 鏈接:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
說明: SDK 最低版本、簽名規則、prefix_mismatch_behavior 等細節的一手來源
-
Gemini 4 入門及遷移差異對照:長輸出與 API 版本說明
- 鏈接:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
說明: 說明續寫功能需使用 v1beta1 API
-
Google Cloud Hydrogen 模型規格:上下文、參數與功能支持表
- 鏈接:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
說明: 溫度、top_p、top_k 固定值與緩存支持情況
-
Google 官方發佈博客:Gemini 4 Hydrogen 發佈公告
- 鏈接:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
說明: 產品定位、與 3.8 Flash 的官方對比數據
-
Google AI Studio 價格頁:官方 API 價格
- 鏈接:
aistudio.google.com/docs/pricing -
說明: 標準、Batch、Flex、Priority 及緩存命中價格
-
Artificial Analysis 獨立測評:四檔思考等級評測
- 鏈接:
artificialanalysis.ai/models/gemini-4-hydrogen -
說明: 第三方智能指數、評測耗時與成本數據
-
Google DeepMind 模型卡:能力、侷限與安全評估
- 鏈接:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - 說明: 已知限制與官方跨模型評測
作者:API易 技術團隊
技術交流:遷移過程中遇到兼容性問題,歡迎通過 API易 官網與我們交流,更多接入資料可查閱 docs.apiyi.com 文檔中心