작성자 주석: Gemini 3.8 Flash에서 Hydrogen으로 마이그레이션하려면 SDK와 컨텍스트, 사고 파라미터, 샘플링 설정, 캐시, 그리고 다중 턴 도구 호출의 시그니처 관리를 함께 조정해야 해요.
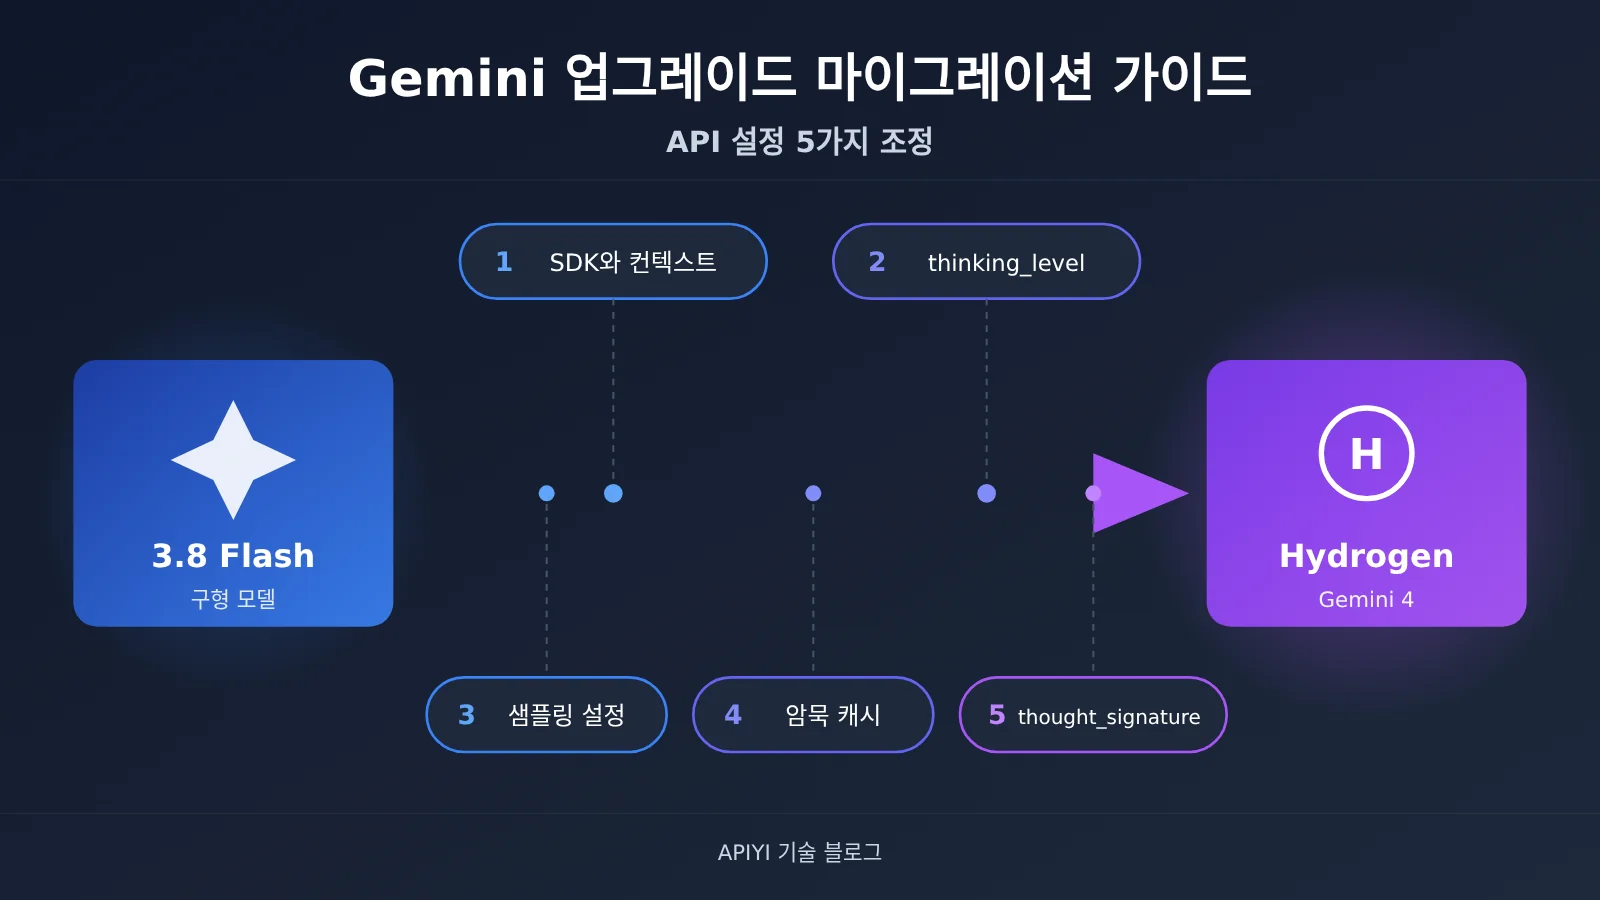
Google은 2026년 11월 12일 Gemini 4 Hydrogen을 공식 출시했어요. API 모델 ID는 gemini-4-hydrogen이고, 일상적인 프로그래밍과 AI 에이전트 실행을 겨냥한 모델이에요. 많은 팀이 가장 먼저 하는 일은 코드에 있는 모델 이름만 바꿔서 배포하는 건데, 그러면 HTTP 400, 파라미터가 적용되지 않는 문제, 다중 턴 도구 호출 오류, 긴 출력이 잘리는 문제를 만나게 돼요. 이 글에서는 Gemini 3.8 Flash에서 Hydrogen으로 업그레이드할 때 반드시 조정해야 하는 5가지 API 설정을 정리해요. 각 항목은 “기존 동작 → 새 동작 → 수정 방법 → 대표적인 영향” 순서로 설명할게요.
이 글은 출시 발표를 그대로 옮긴 글이 아니에요. 본문에 나오는 파라미터 이름, 허용 값, SDK 버전 번호, 오류 유형은 모두 Google Cloud 공식 마이그레이션 가이드와 모델 사양 문서에서 가져왔고, 서드파티 평가와 커뮤니티 피드백은 출처를 따로 표기해요.
핵심 가치: 이 글을 다 읽고 나면 체크리스트를 들고 기존 Gemini 3.8 Flash 호출 코드를 항목별로 수정하면서 에이전트와 배치 처리 업무를 Hydrogen으로 매끄럽게 옮길 수 있어요.
Hydrogen 마이그레이션 전 반드시 알아야 할 5가지 용어
코드를 직접 수정하기 전에, 마이그레이션 가이드에서 반복적으로 등장하는 개념 몇 가지를 먼저 정리해 볼게요.
- thinking_level: 모델 추론 깊이를 제어하는 사고 레벨 파라미터예요. Hydrogen에서는 기존
thinking_budget을 대체하며, 허용되는 단계는 Low, Medium, High, XHigh예요. - thought_signature: 모델이 응답에서 반환하는 사고 연관 시그니처예요. 멀티턴 대화와 도구 호출 시에는 반드시 그대로 유지해 되돌려 보내야 하며, 그렇지 않으면 모델이 이전 추론 상태를 이어가지 못해요.
- continuation_token: 긴 출력의 다음 구간 생성을 이어붙이는 데 쓰는 이어쓰기 토큰이에요. 한 구간 출력이 한도에 도달하면 이 토큰으로 계속 생성할 수 있어요.
- 암시적 캐시: 플랫폼이 조건을 충족하는 입력 프리픽스를 자동으로 재사용하고, 적중된 부분은 캐시 가격으로 과금하는 방식이에요. 개발자가 직접 캐시 객체를 만들 필요는 없어요.
- 컨텍스트 윈도우: 한 번의 모델 처리에 담을 수 있는 정보 범위예요. Hydrogen에서는 입력, 출력, 사고, 도구 호출이 모두 합쳐 1,048,576 tokens의 통합 한도를 공유해요.
1. Hydrogen 업그레이드, 모델 ID만 바꾸면 안 되는 이유
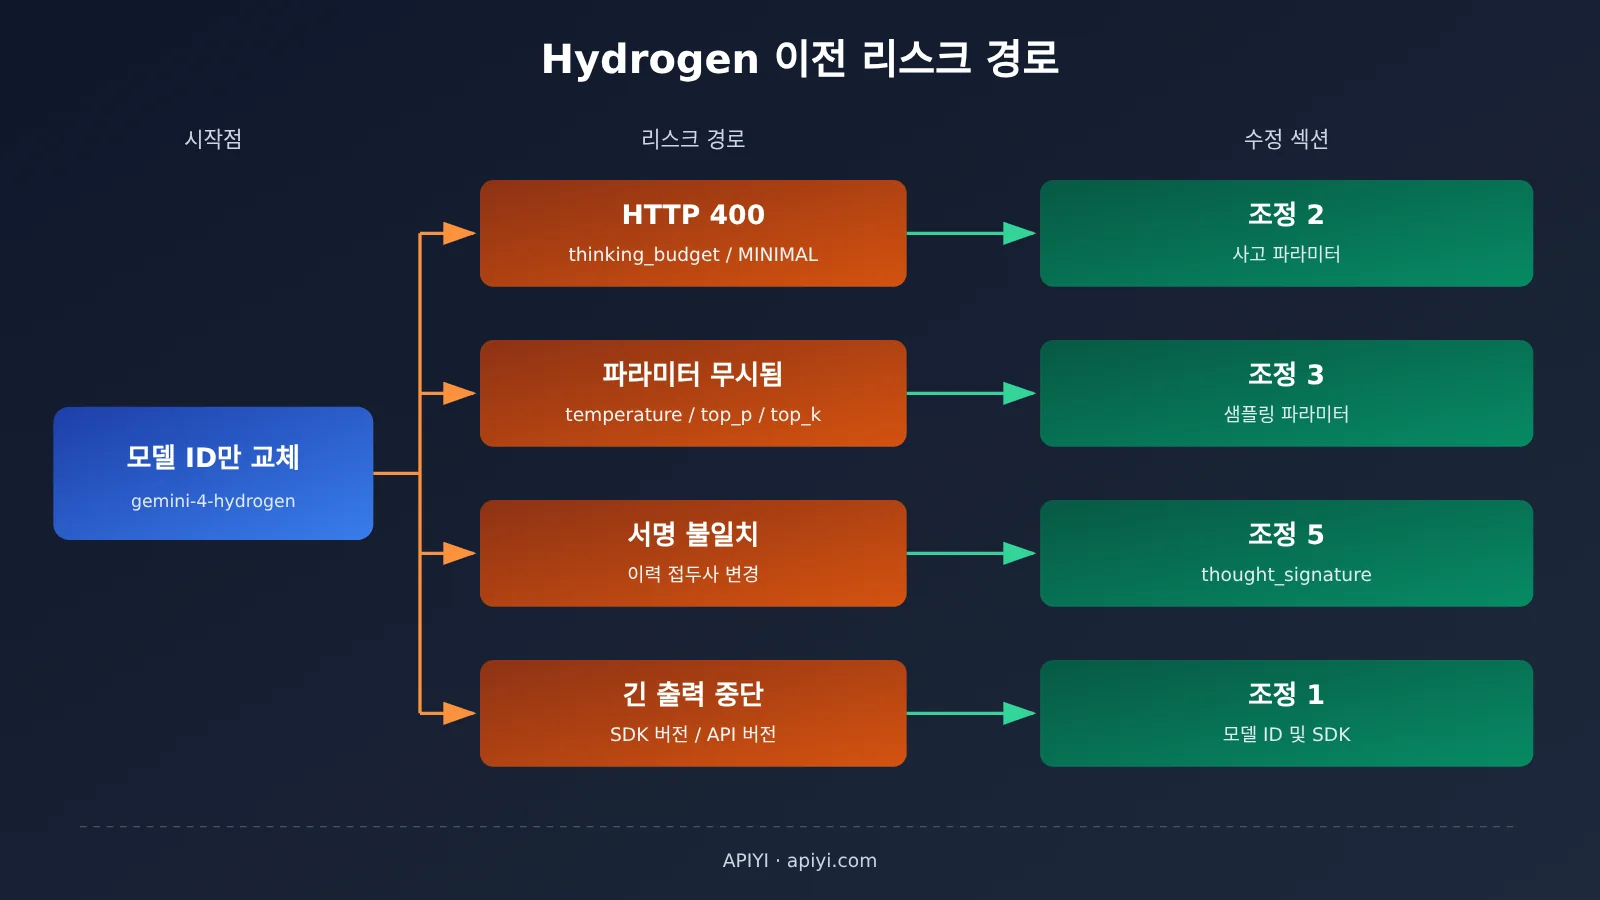
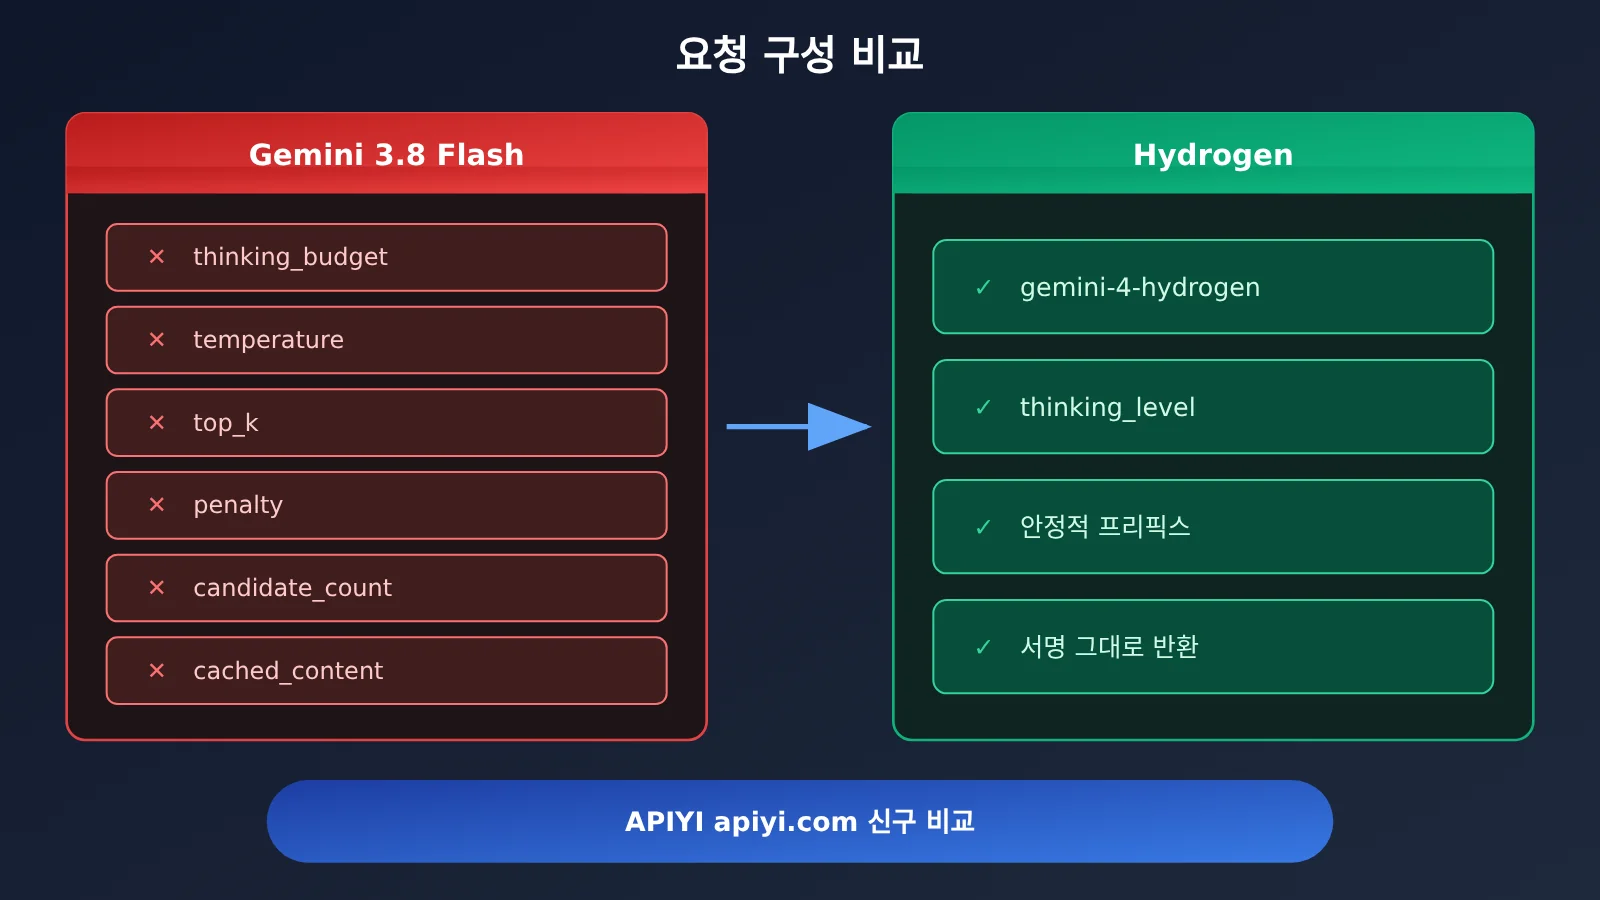
Gemini 3.8 Flash와 Hydrogen은 같은 Gemini 패밀리에 속하지만, API 동작에는 호환되지 않는 부분이 적지 않아요. 공식 마이그레이션 가이드에 따르면 thinking_budget과 MINIMAL 사고 단계는 Hydrogen에서 지원되지 않아 요청이 곧바로 HTTP 400을 반환해요. 반면 temperature, top_p, top_k 같은 샘플링 파라미터는 에러가 나지 않고 조용히 무시되기만 하죠. 전자는 테스트 단계에서 바로 드러나지만, 후자는 “파라미터가 아직 적용되고 있다”고 착각하게 만들 수 있어요.
더 은밀한 리스크도 두 가지 있어요. 첫째, 멀티턴 도구 호출의 시그니처 관리가 더 엄격해졌어요. 히스토리 대화가 압축되거나 잘려나가면 시그니처와 프리픽스가 맞지 않아 HTTP 400이 발생할 수 있죠. 둘째, 기본 사고 단계가 Medium에서 High로 올라갔어요. 명시적으로 설정하지 않으면 같은 요청이 더 많은 사고 토큰을 소모하고 지연도 길어져요. 아래 표는 다섯 가지 조정 항목을 한눈에 정리한 거예요.
| 조정 항목 | 기존 동작 (3.8 Flash) | 새 동작 (Hydrogen) | 변경하지 않으면 생기는 결과 |
|---|---|---|---|
| 모델 ID, SDK, 컨텍스트 | 기존 모델 ID, 구버전 SDK 사용 가능 | gemini-4-hydrogen, 긴 출력 이어쓰기에는 SDK 최소 버전 요구 |
긴 출력 중단, 이어쓰기 불가 |
| 사고 파라미터 | thinking_budget, 기본 Medium |
thinking_level, 기본 High |
HTTP 400, 또는 비용과 지연 증가 |
| 샘플링 및 생성 파라미터 | temperature, top_p, top_k 등 조정 가능 | 고정값이라 커스텀 설정은 무시됨, 일부 필드는 제거 필요 | 출력 스타일 제어 불가, 일부 요청 검증 실패 |
| 캐시 | 명시적 캐시 cached_content 지원 |
암시적 캐시만 지원, 최소 4,096 tokens | 캐시 참조 무효화, 비용 추정 오차 |
| thought_signature | 시그니처 규칙이 상대적으로 관대 | 병렬 호출, 프리픽스 변경에 엄격한 규칙 적용 | 멀티턴 Agent 오류 또는 추론 단절 |
2. 변경 사항 1: Hydrogen의 모델 ID, SDK 버전, 컨텍스트 제한
기존 동작 → 새로운 동작: 3.8 Flash 시대에는 대부분의 프로젝트가 SDK 버전에 민감하지 않았습니다. Hydrogen으로 마이그레이션하면 모델 ID를 gemini-4-hydrogen으로 변경해야 하고, 초장문 출력이 필요하다면 SDK 버전이 필수 조건이 됩니다. Google 공식 마이그레이션 가이드에서 제시한 최소 버전은 다음과 같습니다.
| 개발 언어 | GenerateContent 자동 이어쓰기 | Interactions API 자동 이어쓰기 |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | 공식 문서에 별도 표기 없음 | >= 1.77.0 |
| Java | 공식 문서에 별도 표기 없음 | >= 1.80.0 |
Hydrogen 컨텍스트와 장문 출력 수정 방법
Hydrogen의 1,048,576 tokens는 통합 할당량입니다. 입력과 과거 컨텍스트, 사고 토큰, 도구 호출 관련 토큰, 최종 출력까지 모두 이 하나의 풀에서 차감됩니다. 즉, 100만 토큰을 입력한 뒤 추가로 100만 토큰을 출력할 수는 없습니다. 장문 문서 분석형 에이전트라면 입력 측에서 사고와 도구 호출 공간을 미리 확보해야 합니다.
단일 포그라운드 생성의 상한은 보통 65,536 tokens입니다. 이 길이를 초과할 때는 세 가지 방법을 선택할 수 있습니다. 지원되는 SDK의 자동 이어쓰기를 사용하거나, Interactions API에서 background=true를 설정해 백그라운드 장문 생성을 수행하거나, continuation_token을 직접 관리하며 구간별로 이어 붙이는 방법입니다. 특히 주의할 점은 공식 입문 문서에서 장문 출력 이어쓰기가 현재 v1beta1 API를 사용해야 하며 Agent Platform의 v1은 이 기능을 지원하지 않는다고 명시하고 있다는 것입니다.
대표적 영향: 배치로 장문 보고서나 긴 코드 파일을 생성하는 업무가 가장 함정에 빠지기 쉽습니다. SDK를 먼저 업그레이드한 뒤 API 버전을 v1beta1로 전환하고, 마지막으로 65,536 tokens를 초과하는 요청으로 회귀 테스트를 하는 것을 권장합니다.
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
3. 조정 2: Hydrogen의 thinking_budget을 thinking_level로 변경
기존 동작: 3.8 Flash는 thinking_budget을 사용해 토큰 수로 사고 길이를 제어했고, MINIMAL 단계도 선택할 수 있었으며 기본 단계는 Medium이었습니다.
새 동작: Hydrogen은 이제 thinking_level만 허용하며, 유효한 값은 Low, Medium, High, XHigh의 네 단계입니다. 기본값은 High입니다. 계속해서 thinking_budget 또는 MINIMAL을 전달하면 HTTP 400이 반환됩니다. 공식 권장 용도는 각각 다음과 같습니다. Low는 분류, Medium은 일반 코딩, High는 다단계 에이전트, XHigh는 복잡한 심층 추론에 사용합니다.
외부 기관인 Artificial Analysis가 11월 12일에 네 단계에 대한 독립 평가(Intelligence Index v5.0.1)를 완료했으며, 이를 통해 단계별 차이를 이해하는 데 도움을 받을 수 있습니다. 아래 표의 소요 시간과 비용은 표준화된 평가 작업의 평균값이며, 일반 사용자가 단일 대화에서 실제로 부담하는 비용을 의미하지는 않습니다.
| 사고 단계 | 공식 권장 시나리오 | 지능 지수(AA) | 평가 평균 소요 시간 | 평가 평균 비용 |
|---|---|---|---|---|
| Low | 분류, 단순 추출 | 27 | 1.3분 | $0.29 |
| Medium | 일반 코딩 | 41 | 3.7분 | $0.80 |
| High(기본값) | 다단계 에이전트 | 51 | 8.3분 | $1.87 |
| XHigh | 복잡한 심층 추론 | 54 | 13.5분 | $3.16 |
데이터를 보면 High는 Medium보다 10점 높지만, XHigh는 High보다 3점 높을 뿐이며 평가 비용은 1.87달러에서 3.16달러로 증가합니다. 이는 최고 단계가 반드시 가장 경제적이라는 보장은 없으며, 같은 모델 이름이라도 단계에 따라 능력 차이가 크다는 점을 보여줍니다.
Hydrogen thinking_level 수정 예시
아래 예시는 공식 Google Gen AI SDK 문법을 사용합니다. 열거형 값의 대소문자 표기는 설치된 SDK 버전의 타입 정의를 기준으로 하세요.
from google import genai
from google.genai import types

client = genai.Client()

# 기존 방식(3.8 Flash): Hydrogen에서 HTTP 400을 반환합니다.
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# 새 방식: 일반 코딩 작업에는 Medium을 선택합니다.
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# 다단계 에이전트에는 High를 선택합니다(기본값이기도 하므로 명시적으로 적어 두는 것이 좋습니다).
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修复这个函数中的空指针问题:...",
    config=coding_config,
)
print(resp.text)
대표적인 영향: 사고 토큰은 출력 가격으로 과금되므로, 단계를 명시하지 않은 프로젝트는 마이그레이션 후 자동으로 High로 설정되어 청구 비용과 지연 시간이 모두 증가합니다. 기존 thinking_budget 구간을 단계로 매핑하는 것이 좋습니다. 작은 예산은 Low 또는 Medium, 큰 예산은 High에 대응합니다.
4. 세 번째 조정: Hydrogen에서 무효화된 생성 파라미터 정리
기존 동작: 3.8 Flash는 temperature, top_p, top_k로 출력의 무작위성을 조절할 수 있었고, 페널티 파라미터와 다중 후보 출력도 지원했어요.
새로운 동작: Hydrogen의 기본 온도는 1.0이며 사용자 지정 값이 적용되지 않고, top_p는 0.95로 고정, top_k는 64로 고정돼요. 이 세 파라미터는 전달해도 무시돼요. 공식 마이그레이션 체크리스트에서는 다음 필드도 함께 처리하도록 요구해요.
| 필드 또는 동작 | Hydrogen 마이그레이션 요구 사항 | 문제 해결 팁 |
|---|---|---|
| temperature / top_p / top_k | 사용자 지정 값 무시됨 | 오류는 나지 않으므로 프롬프트로 스타일을 제어해야 해요 |
| frequency_penalty / presence_penalty | 제거 | 실제 오류 메시지를 기준으로 판단하되, 일괄 삭제가 가장 안전해요 |
| candidate_count > 1 | 다중 후보 설정 제거 | 다양성이 필요하면 여러 번 요청하는 방식으로 바꿔요 |
| 미리 채운 model 히스토리 턴 | 제거 | 더 이상 “모델의 말머리를 대신 시작”하는 방식으로 형식을 유도할 수 없어요 |
| cached_content | 명시적 캐시를 더 이상 참조하지 않음 | 조정 4를 참고하세요 |
| thinking_budget | 합법적인 thinking_level로 변경 | HTTP 400이 반환돼요 |
공식 문서에서는 일부 구 파라미터는 그저 무시될 뿐이고, 또 다른 파라미터는 요청 검증 자체를 실패시킨다고 특히 강조해요. 그래서 문제 해결 로직을 한 가지 기준으로 처리하면 안 돼요. 400이 발생하면 thinking_budget, MINIMAL, 그리고 제거해야 할 필드를 우선 확인하고, 출력 스타일이 기대와 다르면 temperature 파라미터에 아직 의존하고 있는지 다시 점검해야 해요.
Hydrogen에서 단순화된 요청 구성
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # 안정적인 내용을 앞에 배치해 암시적 캐시에 유리하게
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # 구조화 출력은 여전히 지원됨
    max_output_tokens=8192,
)
대표적인 영향: 과거 낮은 temperature에 의존해 JSON 출력의 안정성을 보장하던 프로젝트는 구조화 출력 기능으로 전환해야 하고, 미리 채운 model 턴으로 형식을 제어하던 프로젝트는 형식 요구 사항을 시스템 프롬프트에 작성해야 해요.
5. 조정 4: Hydrogen의 명시적 캐시를 암시적 캐시로 전환
기존 동작: 3.8 Flash에서는 개발자가 먼저 캐시 객체를 생성한 뒤, 요청에서 cached_content="cachedContents/xxx"로 참조할 수 있었어요.
새 동작: Hydrogen은 명시적 컨텍스트 캐시를 지원하지 않고 암시적 캐시만 지원하며, 영구적인 암시적 캐시 메커니즘이 기본 활성화돼요. 캐시 가능한 최소 프리픽스 길이가 3.8 Flash의 6,144 tokens에서 4,096 tokens로 낮아져서, 상대적으로 짧은 공통 시스템 프롬프트나 고정 지식 자료도 더 쉽게 적중될 수 있어요.
수정 방법: 모든 caches.create 호출과 cached_content 참조를 삭제하고, 대신 프롬프트의 결합 순서를 최적화하세요. Google은 안정적인 공통 내용을 입력 앞부분에, 매번 바뀌는 사용자 질문을 끝부분에 배치할 것을 권장해요:
- 시스템 프롬프트와 역할 설정 (거의 변하지 않음)
- 공통 지식 베이스, API 문서, 코드 규범 (변화 빈도 낮음)
- 대화 기록 (턴마다 추가)
- 현재 사용자 질문 (매번 변화)
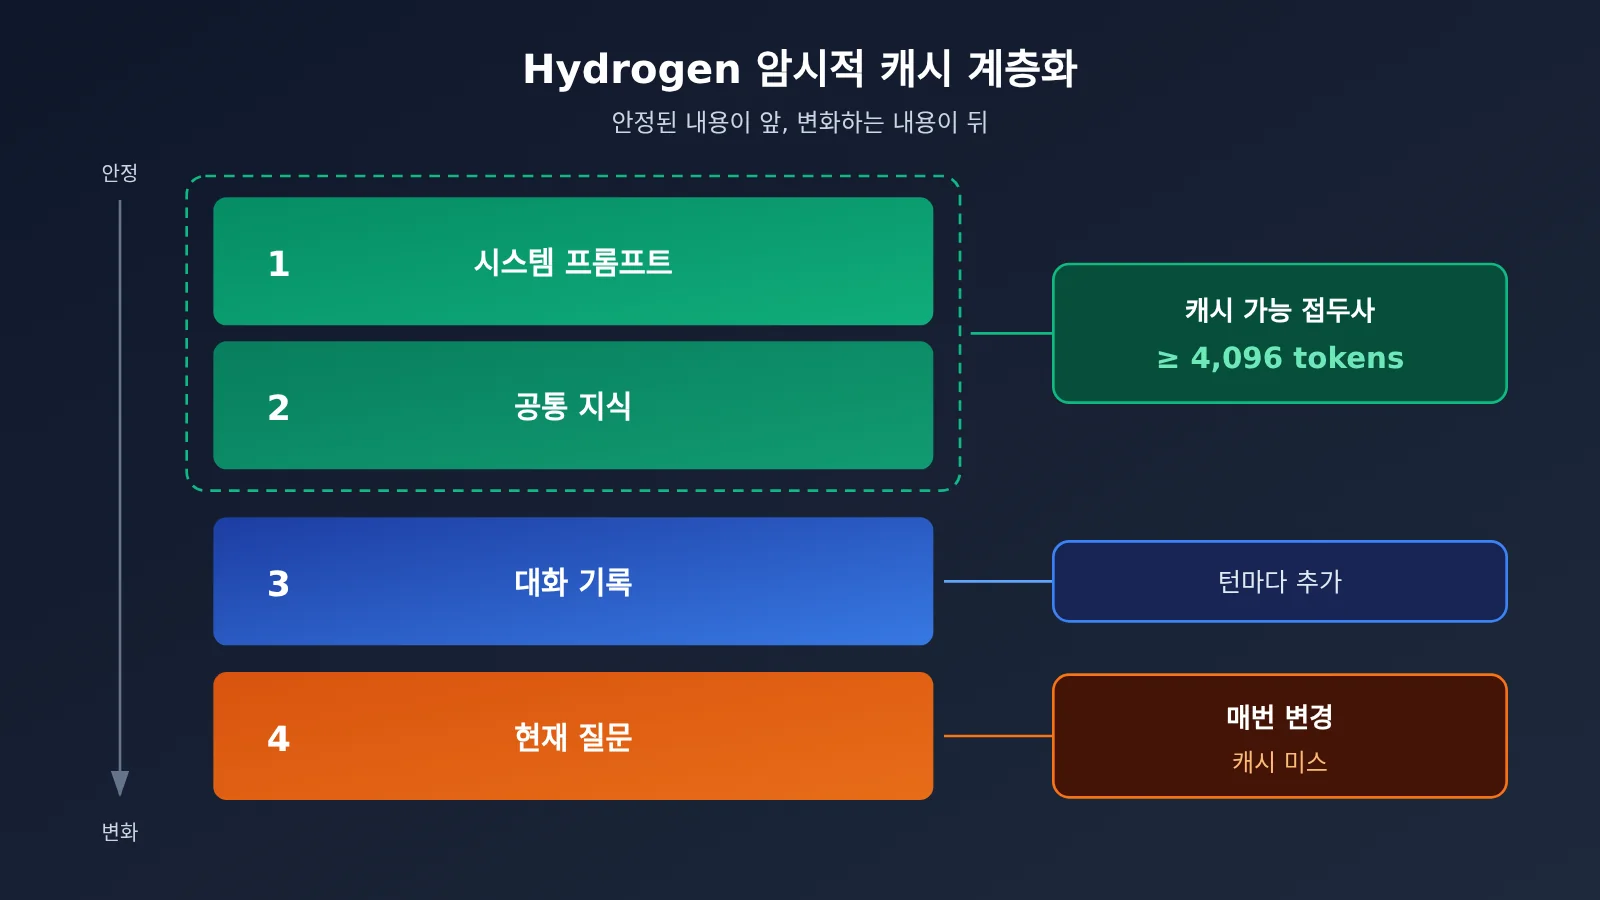
전형적인 영향: 가격 측면에서, Google AI Studio 공식 가격 페이지(확인 날짜 2026년 11월 13일, 단위는 백만 tokens당 달러)에 따르면 Hydrogen 표준 호출의 암시적 캐시 적중 입력은 $0.075이고, Batch 및 Flex 모드는 $0.0375로, 표준 입력의 $1.50보다 훨씬 낮아요. 타임스탬프, 사용자 ID 같은 동적 변수를 프롬프트 맨 앞에 삽입하면 프리픽스가 매번 달라져서 캐시가 적중되지 않아요.
6. 다섯 번째 조정: Hydrogen에서 thought_signature를 올바르게 유지하기
기존 동작: 3.8 Flash에서는 많은 에이전트 프레임워크가 대화 기록을 스스로 재구성하면서 텍스트와 도구 호출 결과만 남겨 두었기 때문에, 서명이 사라져도 눈에 띄는 영향이 거의 없었어요.
새 동작: Hydrogen의 멀티턴 대화에서는 이전의 모든 관련 파트가 지닌 서명을 보존해야 하며, 여기에는 최종 텍스트 파트가 지닌 서명도 포함돼요. 공식 마이그레이션 가이드의 병렬 도구 호출 규정은 다음과 같아요.
- 여러 개의 병렬
functionCall은 반드시 같은 모델 메시지 안에 있어야 해요. thought_signature는 첫 번째 병렬functionCall파트에만 넣어요.- 이후의
functionResponse는 대응하는 호출 ID, 이름, 순서에 맞춰 반환해야 해요. - 같은 모델에서 서명을 재사용할 때 히스토리 프리픽스가 바뀌면 기본적으로 HTTP 400이 반환될 수 있어요.
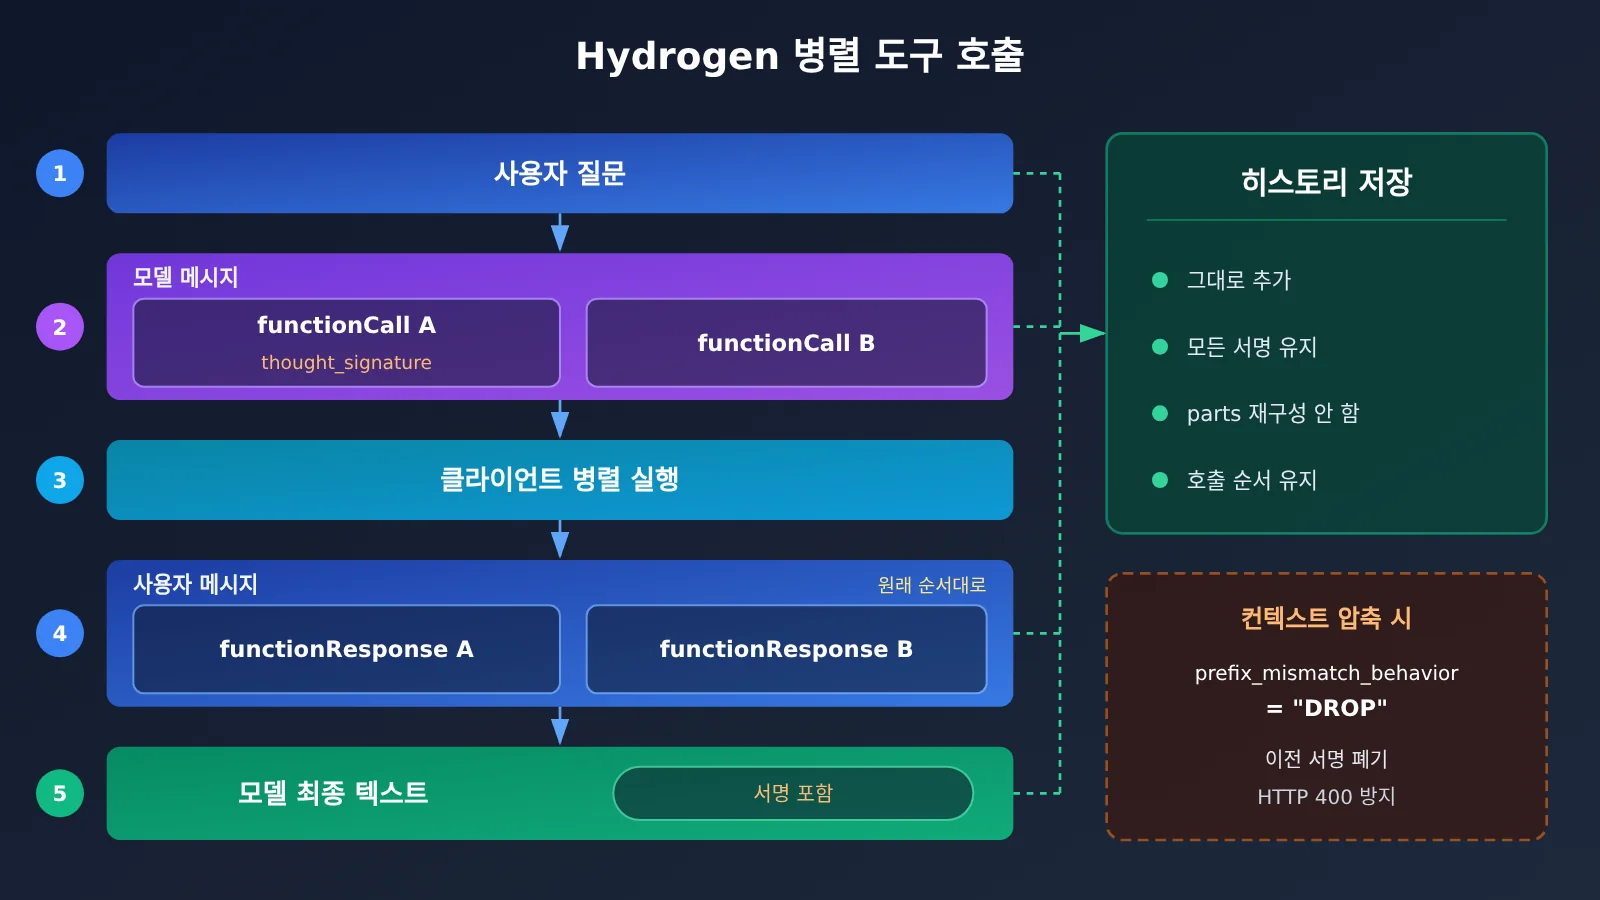
Hydrogen에서 서명을 유지하는 수정 방법
가장 안전한 방법은 parts를 직접 재구성하지 않고, 모델이 반환한 content 객체를 그대로 히스토리에 추가하는 거예요.
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # 원본 그대로 보존하면 서명도 함께 보존돼요

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # functionCall과 동일한 순서를 유지
]
history.append(types.Content(role="user", parts=responses))
히스토리를 압축하거나 잘라내는 에이전트(예: 슬라이딩 윈도우, 요약 대체)라면 히스토리 프리픽스가 어쩔 수 없이 바뀌게 돼요. 이때는 마이그레이션 가이드에 따라 prefix_mismatch_behavior="DROP"을 설정하면, 모델이 프리픽스 불일치 시 오류를 내는 대신 기존 서명을 버리도록 할 수 있어요. 이 필드가 요청 안에서 정확히 어느 위치에 있는지는 공식 마이그레이션 가이드를 기준으로 확인해 주세요.
대표적인 영향: 자체 개발한 Agent Harness, 파일을 병렬로 검색하는 코딩 어시스턴트, 컨텍스트 압축이 있는 장기 대화 봇이 가장 큰 영향을 받으며, 서명 전달을 위한 통합 테스트를 별도로 작성하는 걸 권장해요.
7. Hydrogen 마이그레이션 체크리스트와 최소 호출 예시
| 점검 항목 | 마이그레이션 전(3.8 Flash) | 마이그레이션 후(Hydrogen) | 완료 |
|---|---|---|---|
| 모델 ID | 구 모델 ID | gemini-4-hydrogen |
☐ |
| SDK | 임의 버전 | Python >= 2.34.0, JS >= 2.32.0(Interactions) | ☐ |
| API 버전 | v1 | 긴 출력 이어쓰기가 필요할 때 v1beta1 사용 | ☐ |
| 사고 파라미터 | thinking_budget / MINIMAL | thinking_level 명시적 설정 | ☐ |
| 생성 파라미터 | temperature 등 조정 가능 | penalty, candidate_count, 사전 채움 라운드 삭제 | ☐ |
| 캐싱 | cached_content | 안정적 콘텐츠를 앞에 배치, 접두사 ≥ 4,096 tokens | ☐ |
| 도구 호출 | 히스토리 직접 재구성 | 서명을 원본 그대로 보존, 병렬 응답은 순서대로 반환 | ☐ |
| 오류 처리 | 범용 재시도 | HTTP 400 검증 오류와 조용한 무시 구분 | ☐ |
OpenAI 호환 인터페이스로 빠르게 검증하기
팀의 비즈니스 코드가 OpenAI SDK를 기반으로 하고 있다면, 먼저 호환 인터페이스로 Hydrogen의 출력 품질을 빠르게 확인한 뒤 네이티브 SDK로 전환할지 결정할 수 있어요. 모델이 목록에 노출되는지와 전달 가능한 파라미터는 플랫폼의 모델 목록 및 문서를 기준으로 확인해 주세요.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
전체 구현 코드 보기(도구 호출 및 히스토리 보존 포함)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 통합 인터페이스로 신모델과 구모델을 쉽게 비교
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # 안정적인 시스템 프롬프트를 맨 앞에 두어 암시적 캐시 적중에 유리하게 함
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # assistant 메시지 전체를 그대로 히스토리에 기록하고 내부 필드를 잘라내지 않음
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # tool_calls의 원래 순서대로 결과를 하나씩 반환
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 빠른 시작 팁: 마이그레이션 기간에는 3.8 Flash를 대조군으로 남겨 두고, 동일한 실제 요청 세트로 신모델과 구모델을 동시에 실행해 보세요. APIYI apiyi.com을 통해 하나의 API 키로 두 모델을 동시에 호출할 수 있고, 신규 사용자에게는 무료 테스트 크레딧이 제공되니 소규모 트래픽으로 비교한 뒤 전체 전환하기에 적합해요.
자주 묻는 질문 FAQ
Q1: Gemini 4 Hydrogen은 무엇인가요?
Gemini 4 Hydrogen은 Google DeepMind가 2026년 11월 12일에 출시한 모델로, API ID는 `gemini-4-hydrogen`입니다. Gemini 4 Carbon을 기반으로 적응된 모델이며, 속도, 일상적인 프로그래밍, 다중 도구 호출, 자동화 작업 실행에 중점을 둡니다. 단독으로 사용할 수도 있고, 다중 모델 시스템에서 실행자 또는 검증자 역할을 맡을 수도 있습니다.
Q2: Hydrogen과 Gemini 3.8 Flash의 능력 차이는 얼마나 되나요?
Google 공식 발표 데이터에 따르면 Hydrogen은 Terminal-Bench 4.1에서 57.0%, 3.8 Flash는 18.2%를 기록했습니다. 동일한 테스트 조건에서 작업 완료 속도는 약 2.5배 빠릅니다. 이는 공식 또는 파트너사 테스트 결과이며, 모든 실제 작업에 그대로 적용된다고 볼 수는 없습니다.
Q3: Hydrogen으로 마이그레이션하면 비용이 줄어드나요?
반드시 그렇지는 않습니다. Google AI Studio 공식 가격 페이지(확인일 2026년 11월 13일)에 따르면 Hydrogen의 표준 호출은 입력 $1.50, 출력 $7.50(백만 tokens당 미국 달러)이며, 3.8 Flash는 2026년 12월 31일까지 $0.75 / $3.75, 2027년 1월 1일부터 $1.50 / $7.50로 조정됩니다. 단가는 현재 3.8 Flash의 두 배이며, 총비용은 사고 길이, 재시도 횟수, 작업 완료 효율에 따라 달라집니다.
Q4: 어떤 프로젝트에서 호환성을 가장 먼저 점검해야 하나요?
주로 다음 몇 가지 유형입니다:
– **다중 도구 병렬 호출 Agent**: 서명 위치와 응답 순서에서 가장 오류가 나기 쉽습니다;
– **컨텍스트 압축이 있는 장세션 시스템**: 접두사 불일치 문제를 처리해야 합니다;
– **긴 보고서 및 긴 코드 생성**: SDK를 업그레이드하고 v1beta1로 전환해야 합니다;
– **명시적 캐시로 비용을 제어하는 배치 시스템**: 암시적 캐시 전략으로 바꿔야 합니다.
Q5: API로 신구 모델을 빠르게 비교하려면 어떻게 하나요?
권장 방법은 다음과 같습니다:
1. APIYI apiyi.com에 접속해 계정을 등록하고 API 키를 발급받습니다;
2. 본문의 OpenAI 호환 예제를 사용해 `model`을 각각 신구 모델 ID로 설정합니다;
3. 동일한 배치의 비즈니스 요청으로 출력 품질, 지연 시간, Token 사용량을 비교합니다.
통일된 인터페이스를 사용하면 두 모델에 대해 각각 인증과 요청 코드를 유지할 필요가 없습니다.
Q6: Hydrogen의 알려진 제한 사항은 무엇인가요?
공식 모델 카드에 따르면: 여전히 환각을 생성할 수 있습니다; 높은 사고 단계에서는 소요 시간과 비용이 눈에 띄게 증가하며, 때때로 지연이나 타임아웃이 발생합니다; 지식 컷오프는 2026년 3월입니다; 3.8 Flash에 비해 부당한 거절 지표가 5.57%포인트 악화되었습니다. 또한 Hydrogen은 Live API와 Fine-tuning을 지원하지 않습니다. 커뮤니티 초기 피드백에서도 일부 사용자가 Agent 작업에서 과잉 실행이 있다고 보고했으며, 이는 개인적 경험에 해당합니다.
Q7: 마이그레이션 초기에 비용 리스크를 어떻게 관리하나요?
먼저 `thinking_level=”medium”`을 명시적으로 설정해 베이스라인을 실행하고, 다단계 Agent에 대해서만 별도로 High를 켜는 것을 권장합니다. 동시에 암시적 캐시 적중률과 사고 Token 비중을 확인하세요. 사용량 기반 과금과 여러 모델의 사용량을 한곳에서 보고 싶다면 APIYI apiyi.com의 통합 청구를 활용해 비교할 수도 있습니다.
Hydrogen 마이그레이션 핵심 포인트
- 이름만 바꾸는 게 아니에요: 모델 ID를
gemini-4-hydrogen으로 바꾸는 건 첫 단계일 뿐이고, 추가로 네 가지 설정을 함께 조정해야 해요. - SDK가 필수 조건이에요: 긴 출력 이어쓰기에는 Python >= 2.34.0, JS >= 2.32.0(Interactions API)이 필요하고, v1beta1을 사용해야 해요.
- 사고 파라미터가 세대 교체됐어요:
thinking_budget과MINIMAL은 HTTP 400을 반환하고, 기본 단계는 High로 바뀌었어요. - 샘플링 파라미터가 무효화됐어요: temperature, top_p, top_k는 무시되고, penalty, 다중 후보, 프리필(prefill) 라운드는 제거해야 해요.
- 캐시는 구조로 잡아요: 명시적 캐시가 사라졌고, 안정적인 접두사가 4,096 tokens에 도달해야 암시적 캐시가 적중돼요.
- 서명은 완전해야 해요: 병렬 호출 서명은 첫 번째 functionCall에만 붙고, 응답은 순서대로 반환되며, 압축된 히스토리는 DROP으로 설정할 수 있어요.
- 먼저 비교하고 나서 전환하세요: APIYI apiyi.com을 통해 같은 Key로 신·구 모델을 호출하고, 소량 트래픽으로 검증한 뒤 전체 마이그레이션하세요.
정리
Gemini 3.8 Flash에서 Hydrogen으로 업그레이드할 때의 핵심은 다음과 같아요.
- 기본 계층: 모델 ID와 SDK를 업데이트하고, 1,048,576 tokens의 통합 할당량과 단일 세그먼트 65,536 tokens의 출력 상한을 이해하세요.
- 파라미터 계층:
thinking_budget대신thinking_level을 쓰고, 무효화된 샘플링·생성 필드를 정리하세요. - 상태 계층: 암시적 캐시가 적중하도록 프롬프트 구조를 다시 설계하고,
thought_signature는 그대로 유지해 다시 전달하세요.
이 문서의 체크리스트를 따라 항목별로 개조하고, 도구 호출과 긴 출력에 대한 회귀 테스트를 작성한 뒤 실제 트래픽을 새 모델로 전환하는 걸 권해요. APIYI apiyi.com을 통해 신·구 모델의 효과 비교를 빠르게 끝내는 것도 추천드려요. 플랫폼은 OpenAI 호환 인터페이스와 신규 사용자 무료 테스트 크레딧을 제공해요.
📚 참고 자료
- Gemini 4 Hydrogen 개발자 마이그레이션 가이드: 공식 호환성 변경 사항 및 마이그레이션 체크리스트
- 링크:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
설명: SDK 최소 버전, 서명 규칙, prefix_mismatch_behavior 등 세부 사항의 1차 출처
-
Gemini 4 시작하기 및 마이그레이션 차이 비교: 긴 출력과 API 버전 설명
- 링크:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
설명: 이어쓰기 기능을 사용하려면 v1beta1 API를 써야 한다는 점을 설명
-
Google Cloud Hydrogen 모델 사양: 컨텍스트, 파라미터 및 기능 지원 표
- 링크:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
설명: temperature, top_p, top_k 고정값과 캐싱 지원 현황
-
Google 공식 발표 블로그: Gemini 4 Hydrogen 출시 공지
- 링크:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
설명: 제품 포지셔닝, 3.8 Flash와의 공식 비교 데이터
-
Google AI Studio 가격 페이지: 공식 API 가격
- 링크:
aistudio.google.com/docs/pricing -
설명: 표준, Batch, Flex, Priority 및 캐시 적중 가격
-
Artificial Analysis 독립 평가: 네 단계 사고 등급 평가
- 링크:
artificialanalysis.ai/models/gemini-4-hydrogen -
설명: 제3자 지능 지수, 평가 소요 시간 및 비용 데이터
-
Google DeepMind 모델 카드: 능력, 한계 및 안전성 평가
- 링크:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - 설명: 알려진 제한 사항과 공식 교차 모델 평가
작성자: APIYI 기술 팀
기술 교류: 마이그레이션 과정에서 호환성 문제가 발생하면 APIYI 공식 웹사이트를 통해 저희와 이야기 나눠 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.