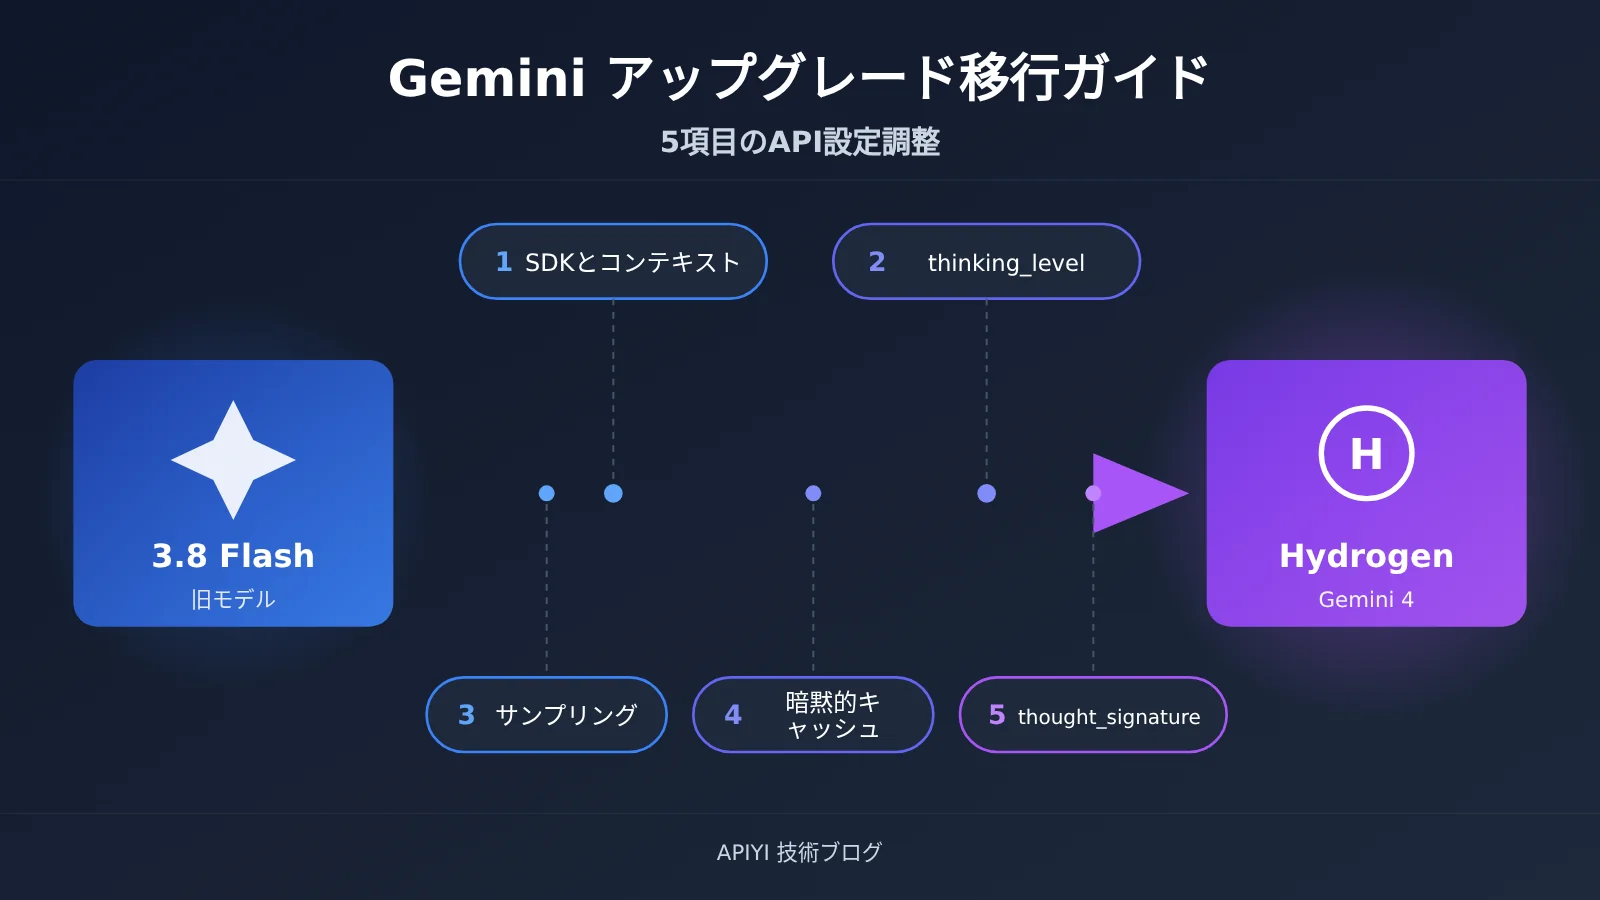
著者注:Gemini 3.8 Flash から Hydrogen への移行では、SDK とコンテキスト、思考パラメータ、サンプリング設定、キャッシュ、そしてマルチターンのツール呼び出しにおける署名管理を同時に調整する必要があります。
Google は 2026年11月12日に Gemini 4 Hydrogen を正式リリースしました。API モデル ID は gemini-4-hydrogen で、日常的なプログラミングと AIエージェントの実行を想定したモデルです。多くのチームはまずコード内のモデル名を置き換えるだけで本番投入しようとしますが、その結果として HTTP 400、パラメータが効かない、マルチターンのツール呼び出しエラー、長い出力の切り捨てに遭遇します。本記事では、Gemini 3.8 Flash から Hydrogen へアップグレードする際に必ず調整すべき 5 つの API 設定を整理し、各項目を「旧動作 → 新動作 → 修正方法 → 典型的な影響」の順で解説します。
これは発表会の再掲ではありません。本文中のパラメータ名、有効値、SDK バージョン、エラー種別は、Google Cloud の公式移行ガイドとモデル仕様書に基づいています。サードパーティの評価やコミュニティのフィードバックは、出典を別途明記します。
本記事の価値:読み終えれば、チェックリストに沿って既存の Gemini 3.8 Flash 呼び出しコードを項目ごとに修正し、AIエージェントとバッチ処理を Hydrogen へスムーズに移行できます。
Hydrogen移行で必ず押さえたい5つの用語
作業を始める前に、移行ガイドで繰り返し登場する概念を整理しておきましょう。
- thinking_level:モデルの推論の深さを制御する思考レベルのパラメータです。Hydrogen では旧来の
thinking_budgetに代わるもので、有効な段階は Low、Medium、High、XHigh です。 - thought_signature:モデルがレスポンスで返す思考関連の署名です。マルチターンの会話やツール呼び出しでは、必ずそのまま保持して返送する必要があります。そうしないと、モデルは以前の推論状態を引き継げません。
- continuation_token:長い出力の次のセグメント生成をつなぐための続き書き用トークンです。1セグメントの出力が上限に達した後、これを使って生成を続けられます。
- 暗黙的キャッシュ:条件を満たす入力プレフィックスをプラットフォームが自動的に再利用する仕組みです。ヒットした部分はキャッシュ価格で課金され、開発者が手動でキャッシュオブジェクトを作成する必要はありません。
- コンテキストウィンドウ:1回のモデル処理で扱える情報の範囲です。Hydrogen では入力・出力・思考・ツール呼び出しが合計 1,048,576 tokens の統一枠を共有します。
1. HydrogenのアップグレードがモデルIDの差し替えだけでは済まない理由
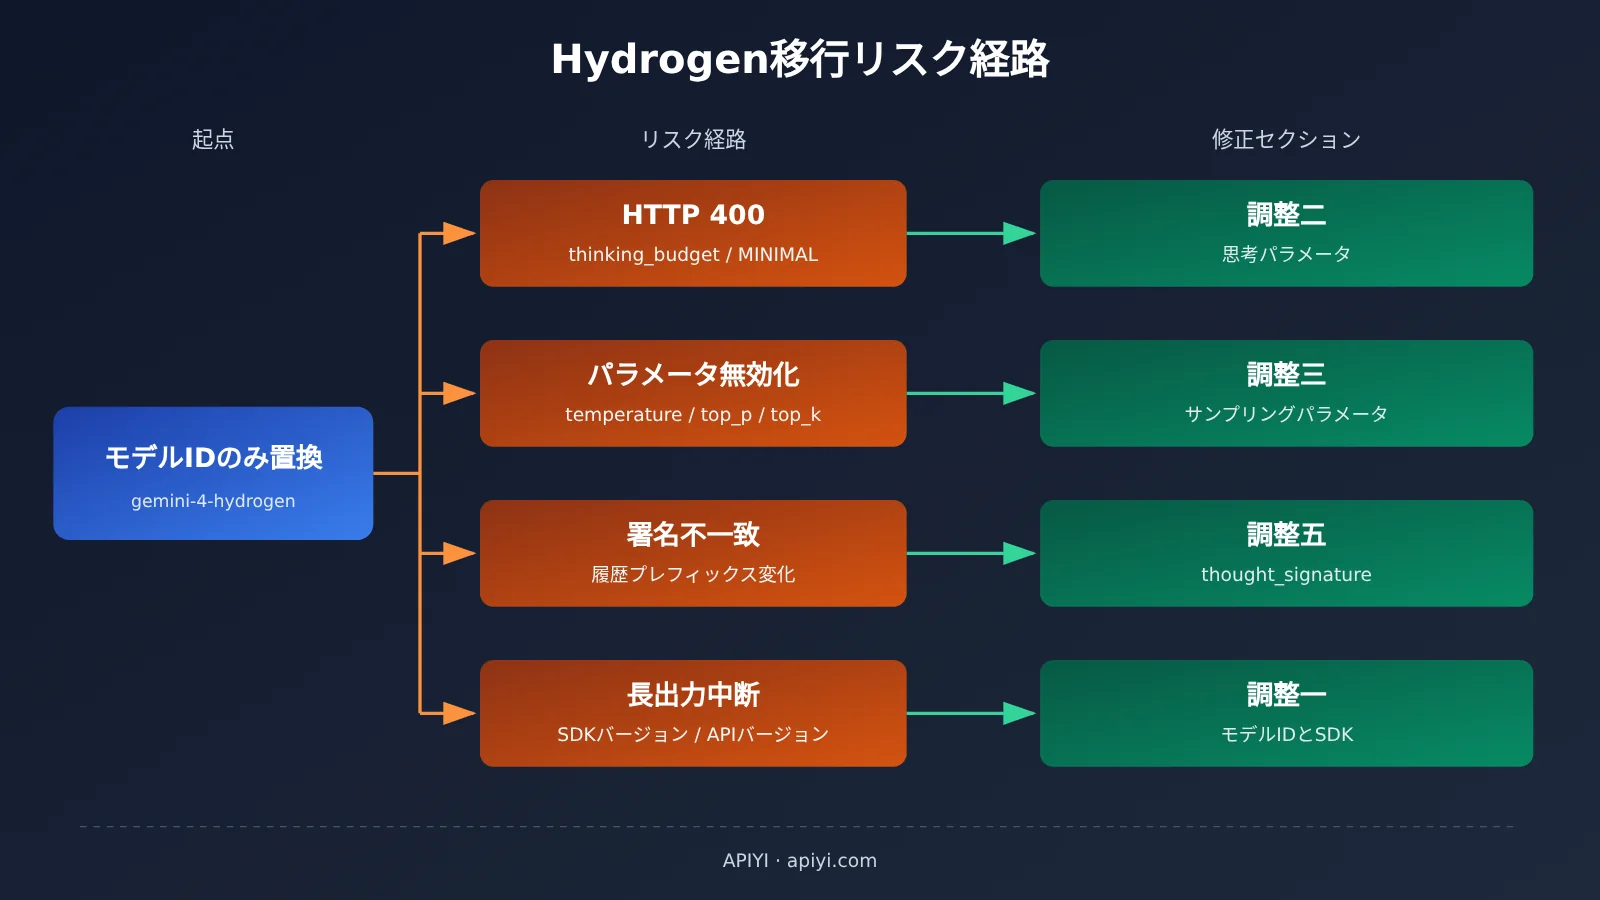
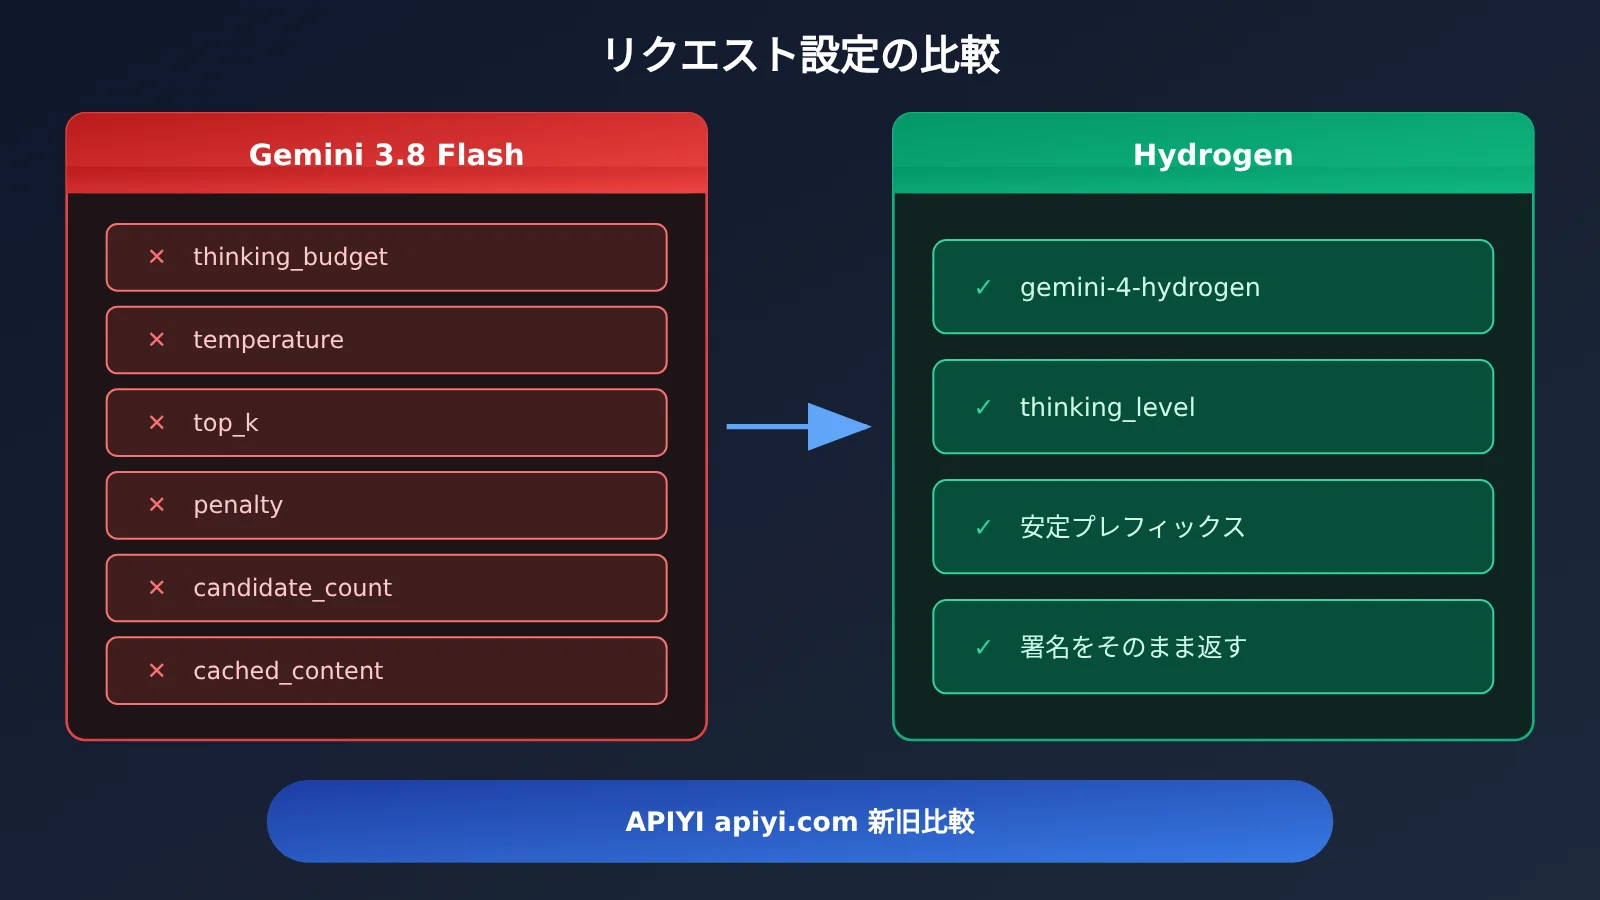
Gemini 3.8 Flash と Hydrogen は同じ Gemini ファミリーに属していますが、API の挙動には互換性のない点が少なくありません。公式の移行ガイドによると、thinking_budget と MINIMAL の思考レベルは Hydrogen ではサポートされず、リクエストはそのまま HTTP 400 を返します。一方、temperature、top_p、top_k といったサンプリングパラメータはエラーにならず、黙って無視されるだけです。前者はテスト段階で気づけますが、後者は「パラメータがまだ効いている」と誤解させる可能性があります。
さらに見落としやすいリスクが2つあります。1つはマルチターンのツール呼び出しで署名の管理がより厳格になったことです。過去の会話が圧縮やトリミングを受けると、署名とプレフィックスが一致せず HTTP 400 が発生することがあります。もう1つは、デフォルトの思考レベルが Medium から High に引き上げられたことです。明示的に設定しない場合、同じリクエストでも思考トークンをより多く消費し、レイテンシも長くなります。以下の表が5つの調整項目の概要です。
| 調整項目 | 旧挙動(3.8 Flash) | 新挙動(Hydrogen) | 変更しない場合の影響 |
|---|---|---|---|
| モデルID、SDK、コンテキスト | 旧モデルID、旧バージョンのSDKが利用可能 | gemini-4-hydrogen、長出力の続き書きにはSDKの最低バージョン要件あり |
長出力が途切れる、続き書きが使えない |
| 思考パラメータ | thinking_budget、デフォルトは Medium |
thinking_level、デフォルトは High |
HTTP 400、またはコストとレイテンシの増加 |
| サンプリングと生成パラメータ | temperature、top_p、top_k などを調整可能 | 固定値でカスタム設定は無視される。一部フィールドは削除が必要 | 出力スタイルを制御できず、一部リクエストは検証エラーになる |
| キャッシュ | 明示的キャッシュ cached_content をサポート |
暗黙的キャッシュのみ、しきい値は 4,096 tokens | キャッシュ参照が無効化され、コスト見積もりにずれが生じる |
| thought_signature | 署名ルールは比較的緩やか | 並列呼び出しやプレフィックスの変化に厳格なルール | マルチターンのエージェントでエラーや推論の断絶が発生 |
二、調整1:Hydrogen のモデルID、SDKバージョン、コンテキスト制限
従来の動作 → 新しい動作:3.8 Flash の時代には、ほとんどのプロジェクトが SDK のバージョンにさほど敏感ではありませんでした。Hydrogen へ移行すると、モデルIDを gemini-4-hydrogen に変更する必要があり、超長い出力が必要な場合は SDK のバージョンが必須条件になります。Google 公式の移行ガイドで示されている最低バージョンは次のとおりです。
| 開発言語 | GenerateContent の自動継続 | Interactions API の自動継続 |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | 公式に個別記載なし | >= 1.77.0 |
| Java | 公式に個別記載なし | >= 1.80.0 |
Hydrogen のコンテキストと長い出力を変更する方法
Hydrogen の 1,048,576 トークンは共通の割り当てであり、入力と履歴コンテキスト、思考トークン、ツール呼び出しに関連するトークン、最終出力のすべてがこの1つの枠から差し引かれます。つまり、100万トークンを入力したうえで、さらに100万トークンを追加出力することはできません。長文ドキュメント分析系の Agent では、入力側で思考とツール呼び出しのための余裕をあらかじめ確保しておく必要があります。
1回のフォアグラウンド生成の上限は通常 65,536 トークンです。この長さを超える場合、3つの方法から選択できます。対応 SDK の自動継続を使う、Interactions API で background=true を設定してバックグラウンドで長い生成を行う、あるいは自前で continuation_token を管理して逐次的に連結する、という方法です。特に注意すべき点として、公式の入門ドキュメントでは、長い出力の継続には現在 v1beta1 API が必要であり、Agent Platform の v1 ではこの機能がサポートされていないと説明されています。
典型的な影響:長いレポートや長いコードファイルをバッチ生成する業務が最もつまずきやすいポイントです。まず SDK をアップグレードし、次に API バージョンを v1beta1 に切り替え、最後に 65,536 トークンを超えるリクエストで回帰テストを行うことをおすすめします。
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
三、調整2:Hydrogen の thinking_budget を thinking_level に変更
従来の動作:3.8 Flash では thinking_budget を使ってトークン数で思考の長さを制御していました。さらに MINIMAL というレベルも選択でき、デフォルトは Medium でした。
新しい動作:Hydrogen は thinking_level のみを受け付け、有効な値は Low、Medium、High、XHigh の4段階で、デフォルトは High です。引き続き thinking_budget や MINIMAL を渡すと HTTP 400 が返されます。公式が推奨する用途はそれぞれ、Low は分類、Medium は通常のコーディング、High は多段階エージェント、XHigh は複雑な深い推論です。
第三者機関の Artificial Analysis は11月12日に4段階の独立評価(Intelligence Index v5.0.1)を完了しており、この結果から各段階の違いを理解できます。下表の所要時間とコストは標準化された評価タスクの平均値であり、一般ユーザーの1回の会話における実際のコストを表すものではありません:
| 思考レベル | 公式推奨シーン | インテリジェンス指数(AA) | 評価の平均所要時間 | 評価の平均コスト |
|---|---|---|---|---|
| Low | 分類、単純な抽出 | 27 | 1.3 分 | $0.29 |
| Medium | 通常のコーディング | 41 | 3.7 分 | $0.80 |
| High(デフォルト) | 多段階エージェント | 51 | 8.3 分 | $1.87 |
| XHigh | 複雑な深い推論 | 54 | 13.5 分 | $3.16 |
データを見ると、High は Medium より10ポイント高い一方、XHigh は High よりわずか3ポイント高いだけで、評価コストは1.87ドルから3.16ドルへと上昇しています。つまり最高レベルが必ずしも最もコスト効率が良いとは限らず、同じモデル名でもレベルによって能力差が大きいということです。
Hydrogen thinking_level の変更例
以下の例は公式の Google Gen AI SDK の構文を使用しています。列挙値の大文字・小文字の書き方は、インストールされている SDK バージョンの型定義に従ってください:
from google import genai
from google.genai import types

client = genai.Client()

# 旧記法(3.8 Flash):Hydrogen では HTTP 400 を返します
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# 新記法:通常のコーディングタスクでは Medium を選択
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# 多段階エージェントでは High を選択(デフォルト値でもあり、明示的に書くことを推奨)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="この関数のヌルポインタ問題を修正してください:...",
    config=coding_config,
)
print(resp.text)
典型的な影響:思考トークンは出力価格で課金されるため、レベルを明示的に設定していないプロジェクトは移行後に自動的に High にフォールバックし、請求額とレイテンシがどちらも増加します。古い thinking_budget の範囲をレベルにマッピングすることをおすすめします。小さな予算は Low または Medium、大きな予算は High に対応させます。
4. 調整3:Hydrogen で無効になった生成パラメータを整理する
従来の動作:3.8 Flash では temperature、top_p、top_k を使って出力のランダム性を調整でき、ペナルティパラメータや複数候補の出力にも対応していました。
新しい動作:Hydrogen のデフォルト温度は 1.0 でカスタム値は反映されず、top_p は 0.95、top_k は 64 に固定されています。これら 3 つのパラメータを渡しても無視されます。公式の移行チェックリストでは、次のフィールドへの対応も求められています。
| フィールドまたは動作 | Hydrogen の移行要件 | トラブルシューティングのヒント |
|---|---|---|
| temperature / top_p / top_k | カスタム値は無視される | エラーは出ないため、プロンプトでスタイルを制御する必要がある |
| frequency_penalty / presence_penalty | 削除 | 実際のエラーを基準に判断し、一律に削除するのが最も安全 |
| candidate_count > 1 | 複数候補の設定を削除 | 多様性が必要な場合は複数回のリクエストに変更する |
| プリフィルされた model の履歴ターン | 削除 | 「モデルの代わりに書き出しを行う」形でフォーマットを誘導する方法は使えなくなる |
| cached_content | 明示的キャッシュを参照しなくなる | 調整4を参照 |
| thinking_budget | 正しい thinking_level に変更する | HTTP 400 が返る |
公式ドキュメントでは特に、一部の旧パラメータは無視されるだけだが、別のパラメータはリクエスト検証エラーを引き起こすと注意を促しています。そのためトラブルシューティングのロジックを一律に扱うことはできません。400 が発生した場合は thinking_budget、MINIMAL、そして削除が必要なフィールドを優先的に確認しましょう。出力スタイルが期待と異なる場合は、温度パラメータにまだ依存していないかを確認します。
Hydrogen で簡略化したリクエスト設定
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # 安定した内容を先頭に置くと暗黙的キャッシュに有利
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # 構造化出力は引き続きサポートされる
    max_output_tokens=8192,
)
典型的な影響:これまで低い温度に頼って JSON の安定した出力を保証していたプロジェクトは、構造化出力の機能に切り替えるべきです。また、プリフィルされた model のターンでフォーマットを制御していたプロジェクトは、フォーマット要件をシステムプロンプトに記述する必要があります。
五、調整4:Hydrogen の明示的キャッシュを暗黙的キャッシュへ変更
以前の動作:3.8 Flash では、開発者はまずキャッシュオブジェクトを作成し、その後リクエスト内で cached_content="cachedContents/xxx" を参照できました。
新しい動作:Hydrogen は明示的なコンテキストキャッシュをサポートせず、暗黙的キャッシュのみをサポートします。さらに、永続的な暗黙的キャッシュの仕組みがデフォルトで有効になります。キャッシュの最小プレフィックス長は 3.8 Flash の 6,144トークンから 4,096トークンに下がり、比較的短い共通システムプロンプトや固定の知識素材でもヒットしやすくなりました。
変更方法:caches.create の呼び出しと cached_content の参照をすべて削除し、代わりにプロンプトの組み立て順序を最適化します。Google は、安定した共通コンテンツを入力の前半に置き、毎回変化するユーザーの質問を末尾に置くことを推奨しています:
- システムプロンプトと役割設定(ほぼ不変)
- 共通ナレッジベース、API ドキュメント、コード規約(低頻度で変化)
- 会話履歴(ターンごとに追加)
- 現在のユーザーの質問(毎回変化)
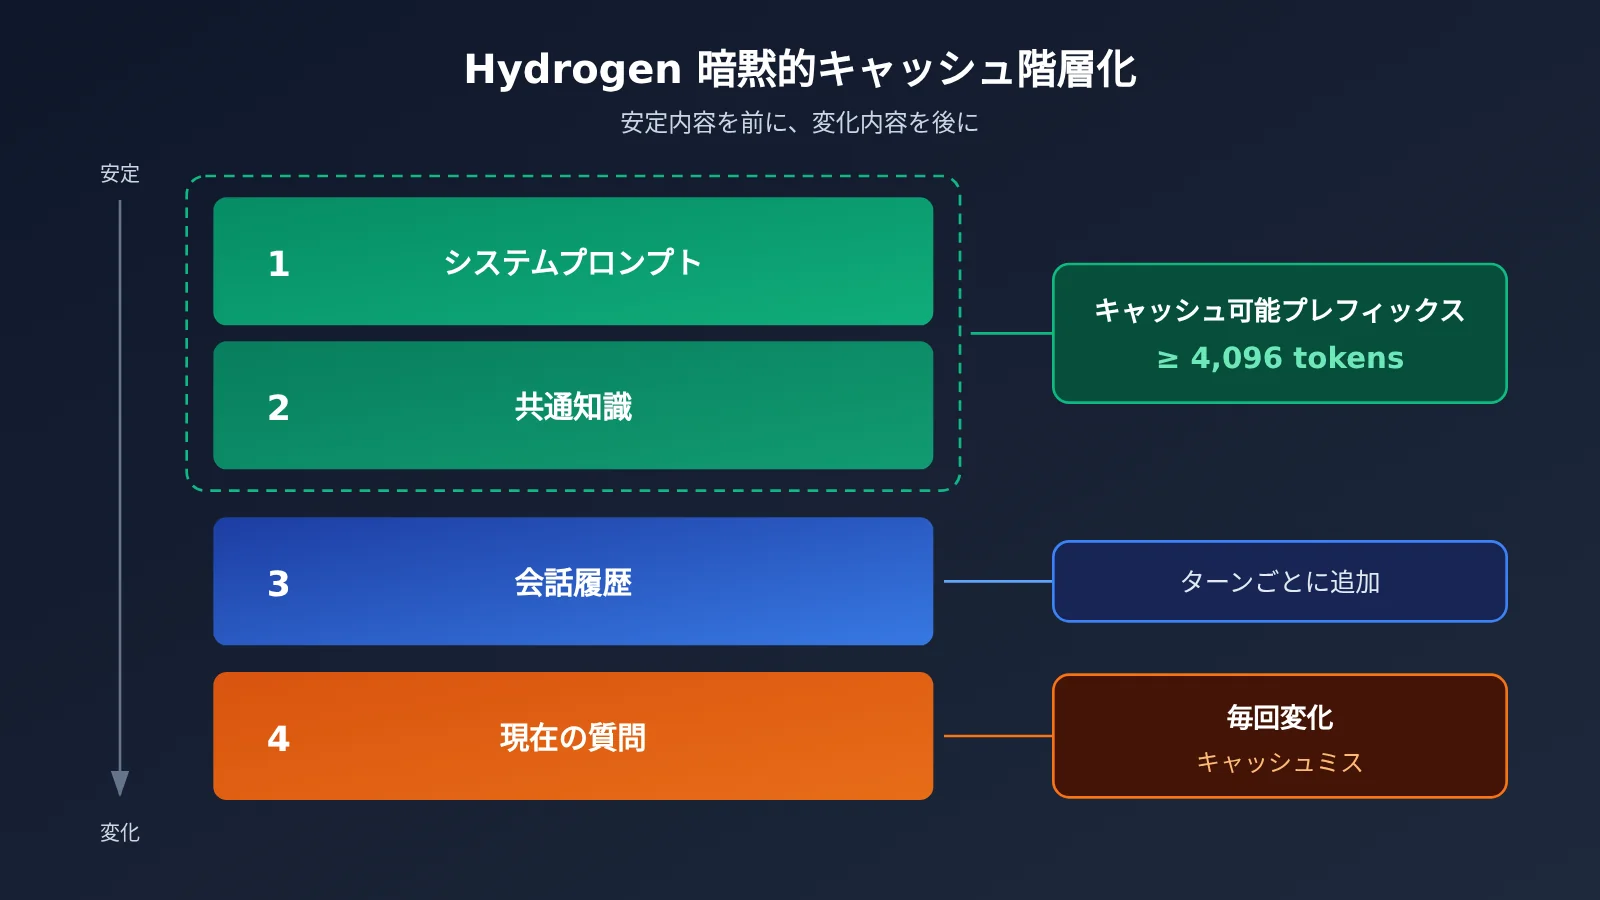
典型的な影響:価格面では、Google AI Studio の公式価格ページ(確認日:2026年11月13日、単位は100万トークンあたりの米ドル)によると、Hydrogen の標準呼び出しでは、暗黙的キャッシュがヒットした入力は $0.075、Batch および Flex モードでは $0.0375 で、標準入力の $1.50 を大きく下回ります。タイムスタンプやユーザー ID などの動的変数をプロンプトの先頭に挿入すると、プレフィックスが毎回異なるため、キャッシュにヒットしません。
六、調整5:Hydrogen で thought_signature を正しく維持する
従来の動作:3.8 Flash では、多くの Agent フレームワークが会話履歴を独自に再構築し、テキストとツール呼び出しの結果だけを保持していました。そのため、署名が失われても目立った影響が出ることはほとんどありませんでした。
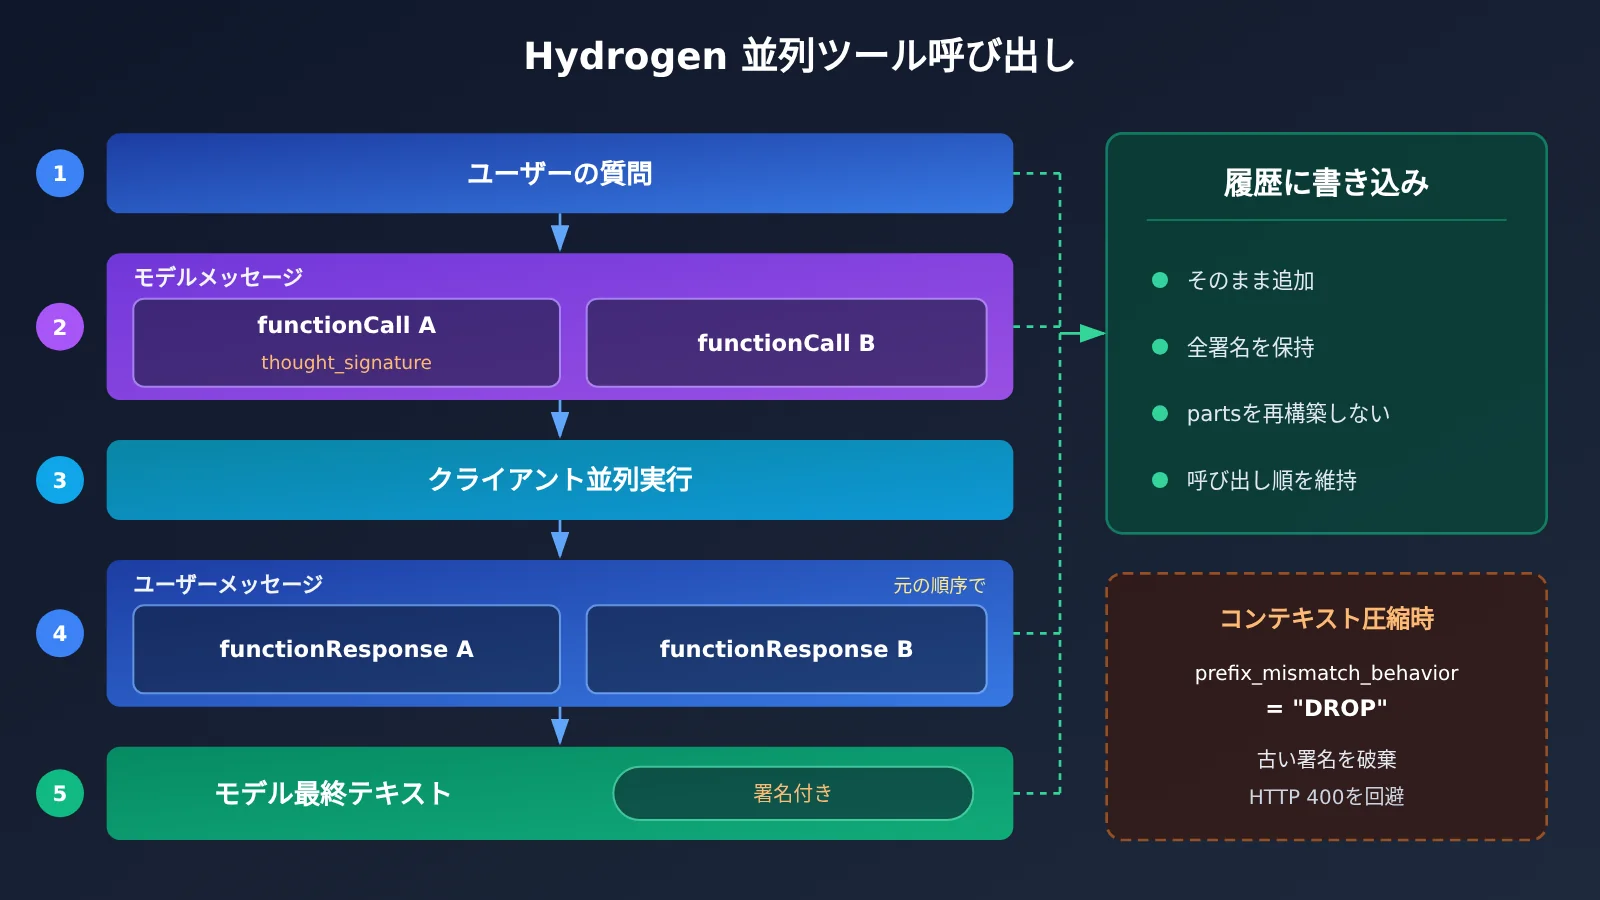
新しい動作:Hydrogen のマルチターン会話では、関連するすべてのパーツに付随する署名を保持する必要があります。これには最終テキストパーツが持つ署名も含まれます。公式の移行ガイドでは、並列ツール呼び出しについて次のように規定されています。
- 複数の並列
functionCallは同一のモデルメッセージ内に置かなければならない thought_signatureは最初の並列functionCallパーツにのみ配置する- 後続の
functionResponseは、対応する呼び出し ID、名前、そして順序に従って返す必要がある - 同じモデルで署名を再利用する際、履歴のプレフィックスが変わると、デフォルトでは HTTP 400 が返されることがある
Hydrogen の署名維持における変更方法
最も確実なのは、parts を手動で再構築しないことです。モデルが返した content オブジェクトをそのまま履歴に追加します。
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # そのまま保持し、署名も一緒に残る

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # functionCall と同じ順序を保つ
]
history.append(types.Content(role="user", parts=responses))
履歴を圧縮したりトリミングしたりする Agent(スライディングウィンドウや要約による置き換えなど)では、履歴のプレフィックスが必ず変化します。そのような場合は、移行ガイドに従って prefix_mismatch_behavior="DROP" を設定すると、プレフィックスが一致しないときに古い署名を破棄するようになり、エラーを返さずに済みます。このフィールドがリクエスト内のどこに置かれるかは、公式の移行ガイドで確認してください。
典型的な影響:自社開発の Agent Harness、ファイルを並列検索するコーディングアシスタント、コンテキスト圧縮を伴う長い会話のボットが最も大きな影響を受けます。署名の返送については、個別に統合テストを書くことをおすすめします。
七、Hydrogen への移行チェックリストと最小限の呼び出し例
| チェック項目 | 移行前(3.8 Flash) | 移行後(Hydrogen) | 完了 |
|---|---|---|---|
| モデル ID | 旧モデル ID | gemini-4-hydrogen |
☐ |
| SDK | 任意のバージョン | Python >= 2.34.0、JS >= 2.32.0(Interactions) | ☐ |
| API バージョン | v1 | 長い出力の継続生成が必要な場合は v1beta1 を使用 | ☐ |
| 思考パラメータ | thinking_budget / MINIMAL | thinking_level を明示的に設定 | ☐ |
| 生成パラメータ | temperature などは調整可能 | penalty、candidate_count、プリフィルターン数を削除 | ☐ |
| キャッシュ | cached_content | 安定したコンテンツを先頭に配置し、プレフィックス ≥ 4,096 tokens | ☐ |
| ツール呼び出し | 履歴を自前で再構築 | 署名をそのまま保持し、並列レスポンスは順序どおりに返却 | ☐ |
| エラー処理 | 汎用的なリトライ | HTTP 400 の検証エラーと無視されるエラーを区別 | ☐ |
OpenAI互換インターフェースによる迅速な検証
チームの業務コードがOpenAI SDKをベースにしている場合、まず互換インターフェース経由でHydrogenの出力品質を迅速に検証し、その後ネイティブSDKへの改修を判断できます。モデルが提供されているかどうか、および透過可能なパラメータについては、プラットフォームのモデルリストとドキュメントに準拠してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
完全な実装コードを表示(ツール呼び出しと履歴保持を含む)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 統一インターフェースで、新旧モデルの比較が容易
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # 安定したシステムプロンプトを先頭に配置し、暗黙的キャッシュのヒットを促進
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # assistantメッセージ全体をそのまま履歴に書き戻し、フィールドを削らずに保持
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # tool_callsの元の順序に従って結果を順次返す
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 クイックスタートのヒント:移行期間中は3.8 Flashを対照群として残し、同じ実リクエスト群で新旧モデルを同時に実行することをお勧めします。APIYI apiyi.com なら1つのAPIキーで2つのモデルを同時に呼び出せます。新規ユーザーには無料テスト枠があるため、まず小流量で比較してから全量切り替えするのに適しています。
よくある質問 FAQ
Q1:Gemini 4 Hydrogen とは何ですか?
Gemini 4 Hydrogen は Google DeepMind が 2026年11月12日にリリースしたモデルで、API ID は `gemini-4-hydrogen` です。Gemini 4 Carbon をベースに調整されたモデルで、速度、日常的なプログラミング、マルチツール呼び出し、自動化タスクの実行に重点を置いています。単体で使用することも、マルチモデルシステムで実行者や検証者として機能させることもできます。
Q2:Hydrogen と Gemini 3.8 Flash の能力差はどの程度ですか?
Google 公式が公開したデータによると、Hydrogen は Terminal-Bench 4.1 で 57.0%、3.8 Flash は 18.2% です。同じテスト条件ではタスク完了速度が約 2.5 倍速くなります。これらは公式またはパートナーによるテスト結果であり、すべての実際のタスクにそのまま当てはめることはできません。
Q3:Hydrogen に移行するとコストは下がりますか?
必ずしもそうとは限りません。Google AI Studio の公式価格ページ(検証日 2026年11月13日)によると、Hydrogen の標準呼び出しは入力 $1.50、出力 $7.50(100万トークンあたりの米ドル)です。一方、3.8 Flash は 2026年12月31日まで $0.75 / $3.75 で、2027年1月1日から $1.50 / $7.50 に調整されます。単価は現時点で 3.8 Flash の 2 倍であり、総コストは思考の長さ、リトライ回数、タスク完了効率によって変わります。
Q4:どのプロジェクトで互換性を優先的に確認すべきですか?
主に以下のカテゴリです:
– **マルチツールを並列呼び出しする Agent**:署名の位置とレスポンスの順序が最もエラーになりやすい;
– **コンテキスト圧縮を伴う長い会話システム**:プレフィックスの不一致を処理する必要がある;
– **長いレポートや長いコードの生成**:SDK をアップグレードし、v1beta1 に切り替える必要がある;
– **明示的キャッシュでコストを制御しているバッチ処理システム**:暗黙的キャッシュ戦略に変更する必要がある。
Q5:API を使って新旧モデルを手早く比較するには?
推奨される方法は次のとおりです:
1. APIYI apiyi.com にアクセスしてアカウントを登録し、APIキーを取得する;
2. 本記事の OpenAI 互換のサンプルを使い、`model` をそれぞれ新旧モデルの ID に設定する;
3. 同じ業務リクエストのセットで、出力品質、レイテンシ、トークン使用量を比較する。
統一インターフェースを使うことで、2つのモデルそれぞれに認証やリクエスト用のコードを用意する必要がなくなります。
Q6:Hydrogen にはどのような既知の制限がありますか?
公式モデルカードには次のように記載されています:依然としてハルシネーション(幻覚)を生成する可能性がある;高思考レベルでは所要時間とコストが明らかに増加し、遅延やタイムアウトが時々発生する;知識のカットオフは 2026年3月;3.8 Flash と比べて不合理な拒否の指標が 5.57 ポイント悪化している。さらに Hydrogen は Live API とファインチューニングをサポートしていません。コミュニティの初期フィードバックでは、Agent タスクで過剰実行が発生したと報告するユーザーもおり、これは個々の体験に基づくものです。
Q7:移行初期にコストリスクを抑えるには?
まず明示的に `thinking_level=”medium”` を設定してベースラインを実行し、その後マルチステップの Agent に対して個別に High を有効にすることをおすすめします。同時に、暗黙的キャッシュのヒット率と思考トークンの割合を確認してください。従量課金で利用し、複数モデルの使用量をまとめて確認したい場合は、APIYI apiyi.com の統一請求で比較することもできます。
Hydrogen移行の核心ポイント Key Takeaways
- 名前を変えるだけではありません:モデルIDを
gemini-4-hydrogenに変更するのは第一歩に過ぎず、さらに4つの設定を同時に調整する必要があります。 - SDKが必須条件です:長い出力の継続生成にはPython >= 2.34.0、JS >= 2.32.0(Interactions API)が必要で、v1beta1を使用します。
- 思考パラメータの世代交代:
thinking_budgetとMINIMALはHTTP 400を返すようになり、デフォルトの段階はHighに変わりました。 - サンプリングパラメータが無効化:temperature、top_p、top_kは無視され、penalty、複数候補、プレフィルラウンドは削除が必要です。
- キャッシュは構造次第:明示的キャッシュは廃止され、安定したプレフィックスが4,096トークンに達しないと暗黙的キャッシュにヒットしません。
- 署名は完全である必要があります:並列呼び出しの署名は最初のfunctionCallのみに付与され、応答は順序通りに返されます。履歴圧縮はDROPに設定できます。
- 比較してから切り替えを:APIYI apiyi.comを通じて同じKeyで新旧モデルを呼び出し、小規模トラフィックで検証してから全量移行してください。
まとめ
Gemini 3.8 FlashからHydrogenへのアップグレードの核心ポイント:
- 基盤層:モデルIDとSDKを更新し、1,048,576トークンの統一クォータと、単一セグメント65,536トークンの出力上限を理解する;
- パラメータ層:
thinking_budgetの代わりにthinking_levelを使用し、無効になったサンプリングと生成フィールドを整理する; - 状態層:暗黙的キャッシュにヒットするようプロンプト構造を再設計し、
thought_signatureをそのまま保持して返送する。
本記事のチェックリストに沿って項目ごとに改修することをお勧めします。さらに、ツール呼び出しと長い出力の回帰テストを作成したうえで、実際のトラフィックを新モデルに切り替えてください。APIYI apiyi.comを通じて新旧モデルの効果比較を素早く完了することをお勧めします。本プラットフォームはOpenAI互換インターフェースと、新規ユーザー向けの無料テストクォータを提供しています。
📚 参考資料
- Gemini 4 Hydrogen 開発者移行ガイド:公式の互換性変更と移行チェックリスト
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
説明:SDK の最低バージョン、署名ルール、prefix_mismatch_behavior などの詳細に関する一次情報源
-
Gemini 4 入門と移行時の相違点対照:長文出力と API バージョンに関する解説
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
説明:続き生成機能では v1beta1 API を使用する必要があることを説明
-
Google Cloud Hydrogen モデル仕様:コンテキスト、パラメータ、機能サポート一覧
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
説明:temperature、top_p、top_k の固定値とキャッシュのサポート状況
-
Google 公式ブログ:Gemini 4 Hydrogen リリース告知
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
説明:製品の位置づけ、3.8 Flash との公式比較データ
-
Google AI Studio 料金ページ:公式 API 料金
- リンク:
aistudio.google.com/docs/pricing -
説明:標準、Batch、Flex、Priority、およびキャッシュヒット時の料金
-
Artificial Analysis による独立評価:4段階の思考レベル評価
- リンク:
artificialanalysis.ai/models/gemini-4-hydrogen -
説明:第三者によるインテリジェンス指数、評価所要時間、コストデータ
-
Google DeepMind モデルカード:能力、限界、安全性評価
- リンク:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - 説明:既知の制限と公式のモデル間評価
著者:APIYI 技術チーム
技術交流:移行の過程で互換性の問題に遭遇した場合は、APIYI 公式サイトからお気軽にご連絡ください。その他の接続資料は docs.apiyi.com のドキュメントセンターでご確認いただけます。