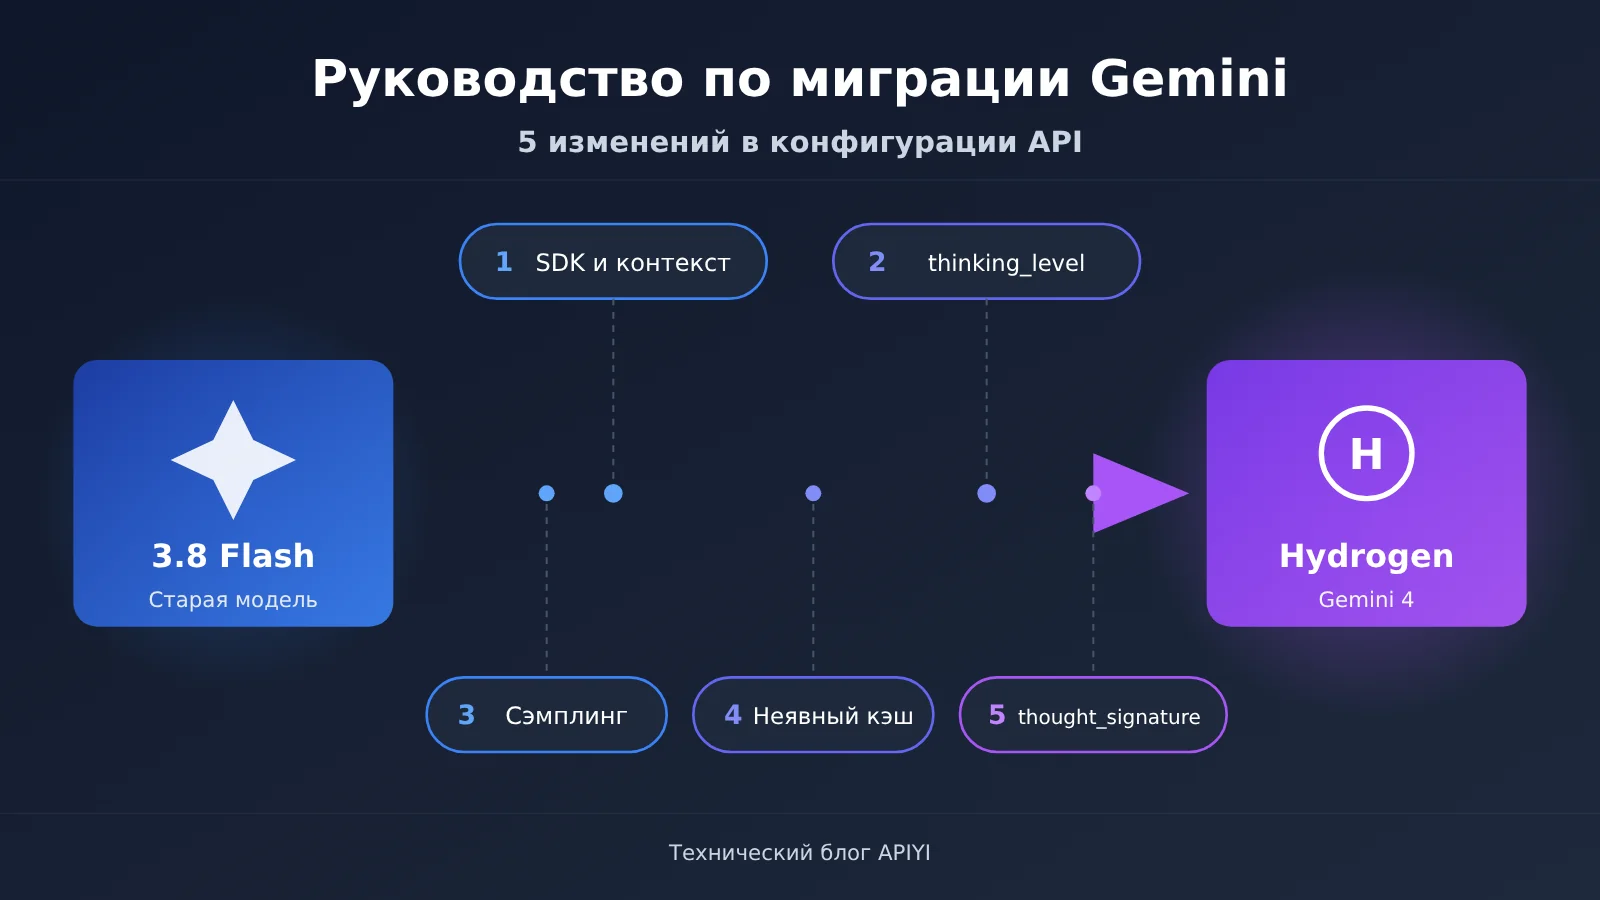
Примечание автора: при переходе с Gemini 3.8 Flash на Hydrogen нужно одновременно настроить SDK и контекст, параметры мышления, конфигурацию сэмплирования, кэширование, а также управление подписями при многошаговых вызовах инструментов.
Google официально выпустила Gemini 4 Hydrogen 12 ноября 2026 года; ID API-модели — gemini-4-hydrogen, позиционирование — повседневное программирование и выполнение задач AI-агентами. Многие команды первым делом заменяют имя модели в коде и сразу выкатывают в продакшен — а в итоге получают HTTP 400, параметры, которые не работают, ошибки при многошаговых вызовах инструментов и обрезанные длинные ответы. В этой статье разобраны 5 настроек API, которые обязательно нужно изменить при обновлении Gemini 3.8 Flash до Hydrogen; каждый пункт раскрывается по схеме «старое поведение → новое поведение → способ исправления → типичные последствия».
Это не пересказ презентации. Названия параметров, допустимые значения, версии SDK и типы ошибок в статье взяты из официального руководства Google Cloud по миграции и документации по спецификациям модели; сторонние обзоры и отзывы сообщества будут отмечены отдельно с указанием источника.
Главная ценность: после прочтения статьи вы сможете взять чек-лист и по пунктам изменить существующий код вызовов Gemini 3.8 Flash, чтобы плавно перенести агентные и пакетные сценарии на Hydrogen.
5 терминов, которые нужно знать при переходе на Hydrogen
Прежде чем вносить изменения, давайте договоримся о нескольких понятиях, которые постоянно встречаются в руководстве по миграции:
- thinking_level: параметр уровня мышления, который управляет глубиной рассуждений модели. Hydrogen использует его вместо старого
thinking_budget; допустимые значения — Low, Medium, High, XHigh. - thought_signature: сигнатура, связанная с рассуждениями, которую модель возвращает в ответе. При многоходовых диалогах и вызовах инструментов её нужно сохранять и передавать обратно без изменений, иначе модель не сможет продолжить предыдущее состояние рассуждений.
- continuation_token: маркер продолжения, который используется для стыковки следующего фрагмента длинного вывода. Когда один фрагмент вывода достигает лимита, с его помощью можно продолжить генерацию.
- Неявное кэширование: платформа автоматически переиспользует подходящие входные префиксы; для совпавшей части тарификация идёт по цене кэша, и разработчику не нужно вручную создавать объекты кэша.
- Контекстное окно: объём информации, который модель может обработать за один раз. Входные данные, вывод, рассуждения и вызовы инструментов в Hydrogen совместно занимают единый лимит в 1,048,576 токенов.
1. Почему при переходе на Hydrogen нельзя просто сменить ID модели
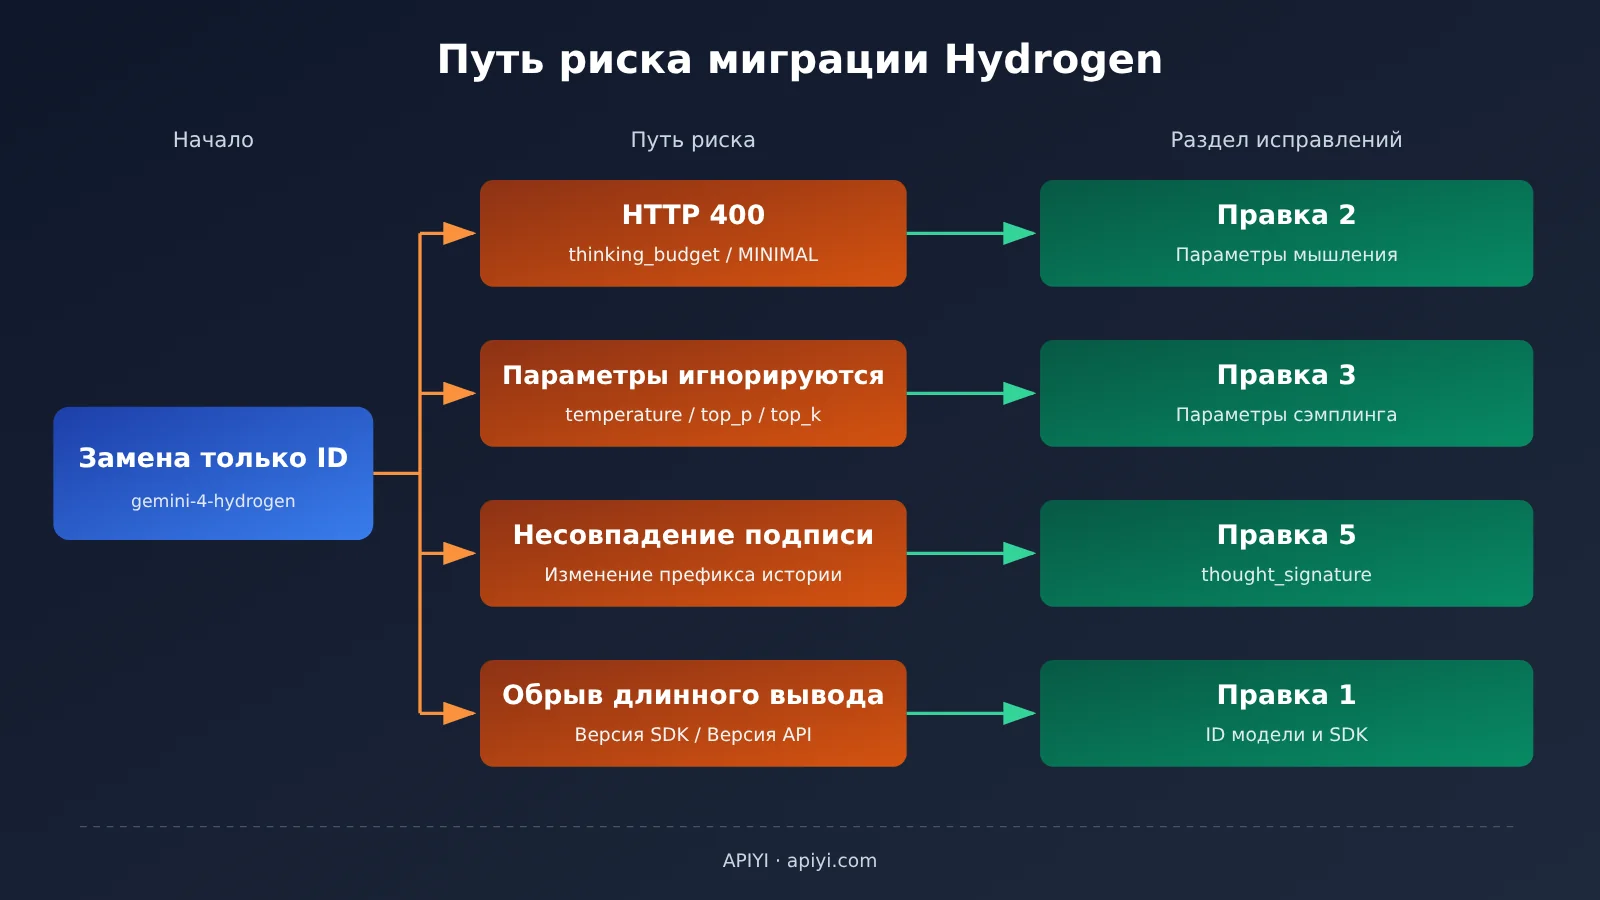
Gemini 3.8 Flash и Hydrogen хоть и относятся к одному семейству Gemini, но их поведение на уровне API имеет немало несовместимостей. Согласно официальному руководству по миграции, параметр thinking_budget и уровень рассуждений MINIMAL в Hydrogen не поддерживаются — такой запрос сразу вернёт HTTP 400. А вот параметры сэмплирования вроде temperature, top_p, top_k ошибки не вызовут, их просто молча проигнорируют. Первая категория проблем вылезет ещё на этапе тестирования, вторая же может создать ложное впечатление, будто «параметры всё ещё работают».
Есть ещё два типа рисков, и они куда менее заметны. Первый — управление подписями при многораундовых вызовах инструментов стало строже: если историю диалога сжать или обрезать, подпись может перестать совпадать с префиксом, и это вызовет HTTP 400. Второй — уровень рассуждений по умолчанию поднялся с Medium до High, и если не задать его явно, тот же самый запрос начнёт тратить больше токенов на рассуждения, да и задержка вырастет. Ниже в таблице — обзор пяти изменений:
| Что меняется | Старое поведение (3.8 Flash) | Новое поведение (Hydrogen) | Последствия, если не менять |
|---|---|---|---|
| ID модели, SDK и контекст | Старый ID модели, работает старый SDK | gemini-4-hydrogen, для продолжения длинного вывода есть требование к минимальной версии SDK |
Длинный вывод обрывается, продолжение недоступно |
| Параметры рассуждений | thinking_budget, по умолчанию Medium |
thinking_level, по умолчанию High |
HTTP 400 либо рост стоимости и задержки |
| Параметры сэмплирования и генерации | temperature, top_p, top_k и прочие можно настраивать | Фиксированные значения, пользовательские настройки игнорируются; часть полей надо удалить | Стиль вывода не контролируется, часть запросов не проходит валидацию |
| Кэширование | Поддерживается явное кэширование cached_content |
Только неявное кэширование, порог 4,096 tokens | Ссылки на кэш перестают работать, оценка стоимости искажается |
| thought_signature | Правила подписей довольно мягкие | Строгие правила для параллельных вызовов и изменения префикса | Многораундовый агент падает или цепочка рассуждений рвётся |
II. Изменение первое: ID модели, версии SDK и ограничения контекста в Hydrogen
Было → стало: во времена 3.8 Flash большинство проектов не обращало внимания на версию SDK. После перехода на Hydrogen ID модели нужно поменять на gemini-4-hydrogen, а если нужны сверхдлинные ответы, версия SDK становится жёстким требованием. В официальном руководстве по миграции от Google указаны такие минимальные версии:
| Язык разработки | Автопродолжение GenerateContent | Автопродолжение Interactions API |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | Отдельно не указана | >= 1.77.0 |
| Java | Отдельно не указана | >= 1.80.0 |
Как менять контекст и длинные ответы в Hydrogen
У Hydrogen 1,048,576 токенов — это единый лимит: входные данные и история контекста, токены рассуждений, токены, связанные с вызовом инструментов, и финальный ответ — всё вычитается из одного общего пула. То есть нельзя сначала подать на вход 1 млн токенов и сверху получить ещё 1 млн на выход. Для агентов, которые анализируют длинные документы, нужно заранее оставлять на входной стороне запас под рассуждения и вызовы инструментов.
Обычно лимит на одну генерацию в интерактивном режиме — 65,536 токенов. Если нужно больше, есть три варианта: автоматическое продолжение через поддерживаемую версию SDK, фоновая длинная генерация с background=true в Interactions API или самостоятельная склейка сегментов через continuation_token. Отдельно стоит отметить: в официальной вводной документации сказано, что для продолжения длинных ответов сейчас нужен API v1beta1, а v1 в Agent Platform эту функцию не поддерживает.
Типичное влияние: чаще всего спотыкаются те, кто массово генерирует длинные отчёты и большие файлы кода. Рекомендую сначала обновить SDK, потом переключить версию API на v1beta1 и в конце прогнать регрессионный тест запросом длиннее 65,536 токенов.
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
3. Изменение 2: в Hydrogen thinking_budget заменён на thinking_level
Как было раньше: 3.8 Flash использовал thinking_budget, чтобы управлять длиной рассуждения через количество токенов; можно было также выбрать уровень MINIMAL, а уровнем по умолчанию был Medium.
Как стало: Hydrogen принимает только thinking_level. Допустимые значения — четыре уровня: Low, Medium, High и XHigh, по умолчанию — High. Если продолжать передавать thinking_budget или MINIMAL, вернётся HTTP 400. Официальные рекомендации по применению такие: Low — для классификации, Medium — для обычной разработки, High — для многошаговых агентов, XHigh — для сложных глубоких рассуждений.
Сторонняя организация Artificial Analysis 12 ноября завершила независимую оценку всех четырёх уровней (Intelligence Index v5.0.1) — это помогает понять разницу между ними. Время и стоимость в таблице ниже — средние значения по стандартизированным оценочным задачам; они не отражают реальные затраты обычного пользователя на один диалог:
| Уровень рассуждения | Официальный рекомендуемый сценарий | Индекс интеллекта (AA) | Среднее время оценки | Средняя стоимость оценки |
|---|---|---|---|---|
| Low | Классификация, простое извлечение | 27 | 1.3 мин | $0.29 |
| Medium | Обычная разработка | 41 | 3.7 мин | $0.80 |
| High (по умолчанию) | Многошаговый агент | 51 | 8.3 мин | $1.87 |
| XHigh | Сложные глубокие рассуждения | 54 | 13.5 мин | $3.16 |
Судя по данным, High на 10 баллов выше Medium, а XHigh — всего на 3 балла выше High, при этом стоимость оценки растёт с $1.87 до $3.16. Это значит, что самый высокий уровень не обязательно самый выгодный, а способности одной и той же модели на разных уровнях тоже сильно различаются.
Пример изменения thinking_level в Hydrogen
В примере ниже используется синтаксис официального Google Gen AI SDK. Регистр значений перечисления проверяйте по определениям типов в установленной версии SDK:
from google import genai
from google.genai import types

client = genai.Client()

# Старый вариант (3.8 Flash): на Hydrogen вернёт HTTP 400
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# Новый вариант: для обычных задач программирования выбираем Medium
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# Для многошагового агента выбираем High (это также значение по умолчанию, лучше указать явно)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修复这个函数中的空指针问题:...",
    config=coding_config,
)
print(resp.text)
Типичные последствия: так как токены рассуждения тарифицируются по цене вывода, проекты без явно заданного уровня после миграции автоматически попадут на High — счёт и задержка вырастут. Рекомендуется сопоставить старые диапазоны thinking_budget уровням: меньший бюджет — Low или Medium, больший — High.
IV. Изменение третье: очистка недействующих параметров генерации в Hydrogen
Старое поведение: 3.8 Flash позволял регулировать случайность вывода через temperature, top_p, top_k, а также поддерживал параметры штрафов и вывод нескольких кандидатов.
Новое поведение: в Hydrogen температура по умолчанию равна 1.0, и её указание не применяется; top_p фиксирован на 0.95, top_k фиксирован на 64 — эти три параметра, если их передать, будут проигнорированы. Официальный чек-лист миграции также требует обработать следующие поля:
| Поле или поведение | Требование миграции Hydrogen | Подсказка по диагностике |
|---|---|---|
| temperature / top_p / top_k | Пользовательские значения игнорируются | Ошибки нет, стиль нужно контролировать через промпт |
| frequency_penalty / presence_penalty | Удалить | Ориентируйтесь на фактическую ошибку; надёжнее всего удалить их все |
| candidate_count > 1 | Удалить настройку нескольких кандидатов | Если нужна вариативность — делайте несколько запросов |
| Предзаполненные ходы истории model | Удалить | Больше нельзя задавать формат, «начиная за модель» |
| cached_content | Больше не ссылается на явный кэш | См. изменение четвёртое |
| thinking_budget | Перейти на допустимый thinking_level | Возвращает HTTP 400 |
Официальная документация особо предупреждает: некоторые старые параметры просто игнорируются, а другие приводят к ошибке валидации запроса. Поэтому диагностика не может быть универсальной: при 400 в первую очередь проверяйте thinking_budget, MINIMAL и поля, которые нужно удалить; если стиль вывода не соответствует ожиданиям, проверьте, не зависите ли вы всё ещё от параметров температуры.
Упрощённая конфигурация запроса для Hydrogen
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # стабильный контент — в начало, это помогает неявному кэшированию
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # структурированный вывод по-прежнему поддерживается
    max_output_tokens=8192,
)
Типичное влияние: проектам, которые раньше полагались на низкую температуру для стабильного JSON-вывода, стоит перейти на возможности структурированного вывода; проектам, которые использовали предзаполненные ходы model для контроля формата, нужно перенести требования к формату в системный промпт.
V. Изменение 4: в Hydrogen явное кэширование заменено неявным
Старое поведение: в 3.8 Flash разработчик мог сначала создать объект кэша, а затем ссылаться на него в запросе через cached_content="cachedContents/xxx".
Новое поведение: Hydrogen не поддерживает явное контекстное кэширование — только неявное, причём механизм долговременного неявного кэширования включён по умолчанию. Минимальная длина префикса для кэширования снизилась с 6,144 токенов в 3.8 Flash до 4,096 токенов, поэтому более короткие общие системные промпты и фиксированные справочные материалы тоже чаще попадают в кэш.
Как мигрировать: удалите все вызовы caches.create и ссылки на cached_content, а вместо этого оптимизируйте порядок сборки промпта. Google рекомендует размещать стабильное общее содержимое в начале промпта, а меняющийся вопрос пользователя — в конце:
- Системный промпт и ролевая инструкция (почти не меняются)
- Общая база знаний, документация API, правила оформления кода (меняются редко)
- История диалога (дополняется с каждым ходом)
- Текущий вопрос пользователя (меняется каждый раз)
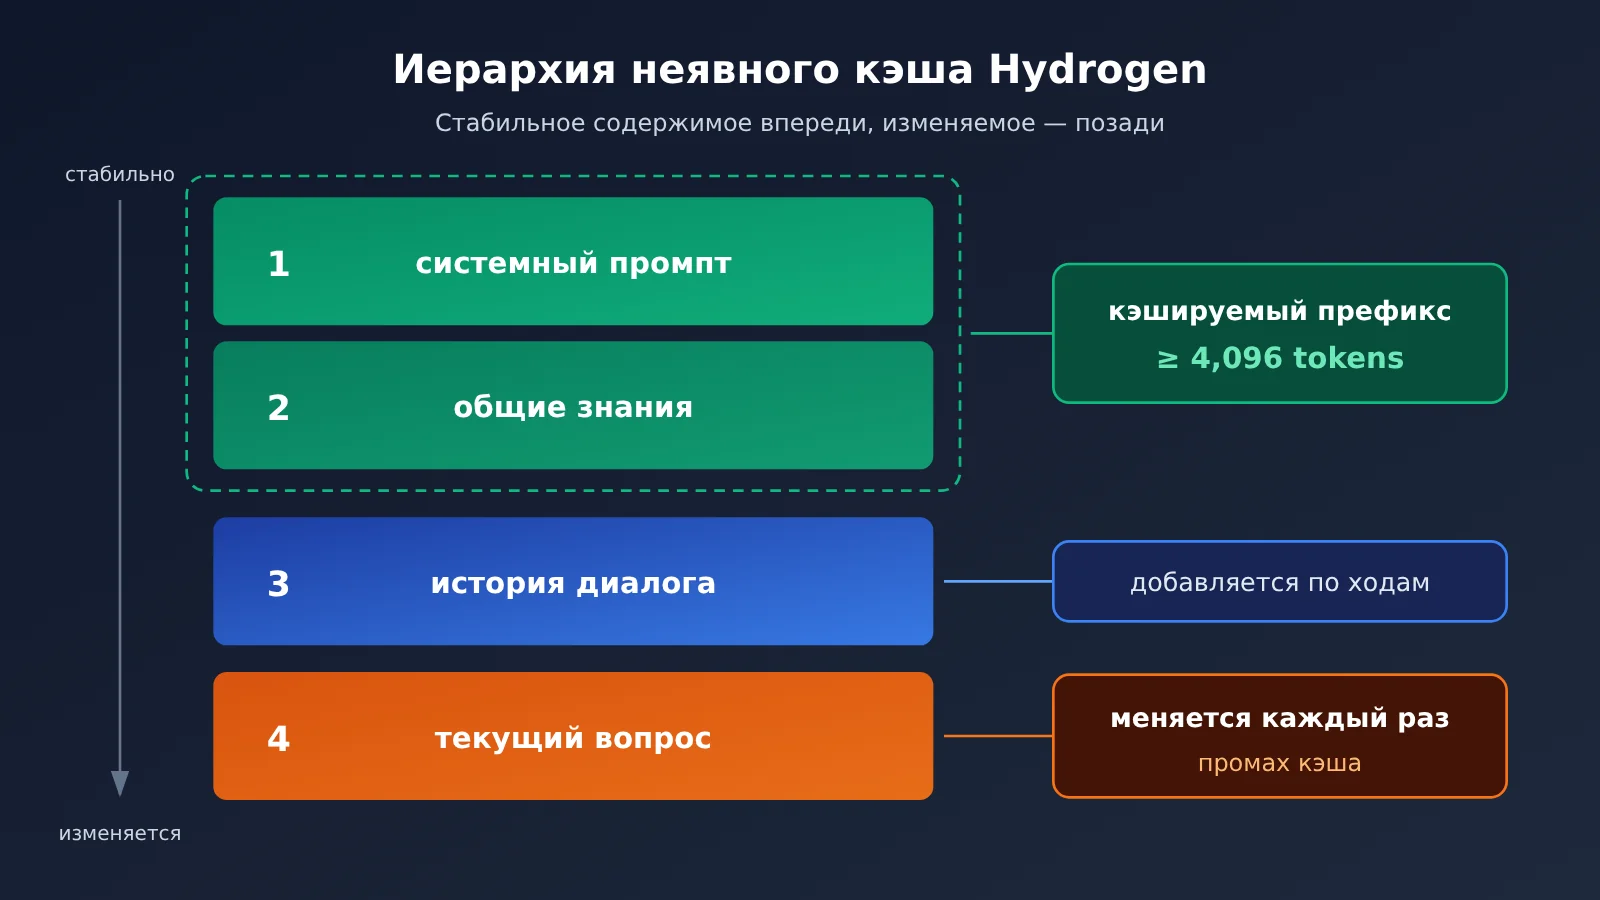
Что это даёт на практике: по официальной странице тарифов Google AI Studio (проверено 13 ноября 2026 г.; доллары за миллион токенов) для стандартных вызовов Hydrogen цена входных токенов при попадании в неявный кэш составляет $0.075, в режимах Batch и Flex — $0.0375, что намного ниже $1.50 за обычный ввод. Если вставить динамические переменные (метку времени, ID пользователя и т. п.) в начало промпта, префикс каждый раз будет разным, и кэш не сработает.
VI. Изменение пятое: правильное поддержание thought_signature в Hydrogen
Прежнее поведение: на 3.8 Flash многие агентные фреймворки сами пересобирали историю диалога, сохраняя только текст и результаты вызовов инструментов, — потеря подписи обычно не давала заметных последствий.
Новое поведение: в Hydrogen многораундовый диалог требует сохранять подписи всех значимых частей, включая подпись, которую несёт финальная текстовая часть. Официальное руководство по миграции описывает правила для параллельных вызовов инструментов так:
- несколько параллельных
functionCallдолжны находиться в одном сообщении модели; thought_signatureпомещается только в первую часть параллельногоfunctionCall;- последующие
functionResponseдолжны возвращаться в соответствии с ID вызова, именем и порядком; - при повторном использовании подписи той же моделью, если префикс истории изменился, по умолчанию может вернуться HTTP 400.
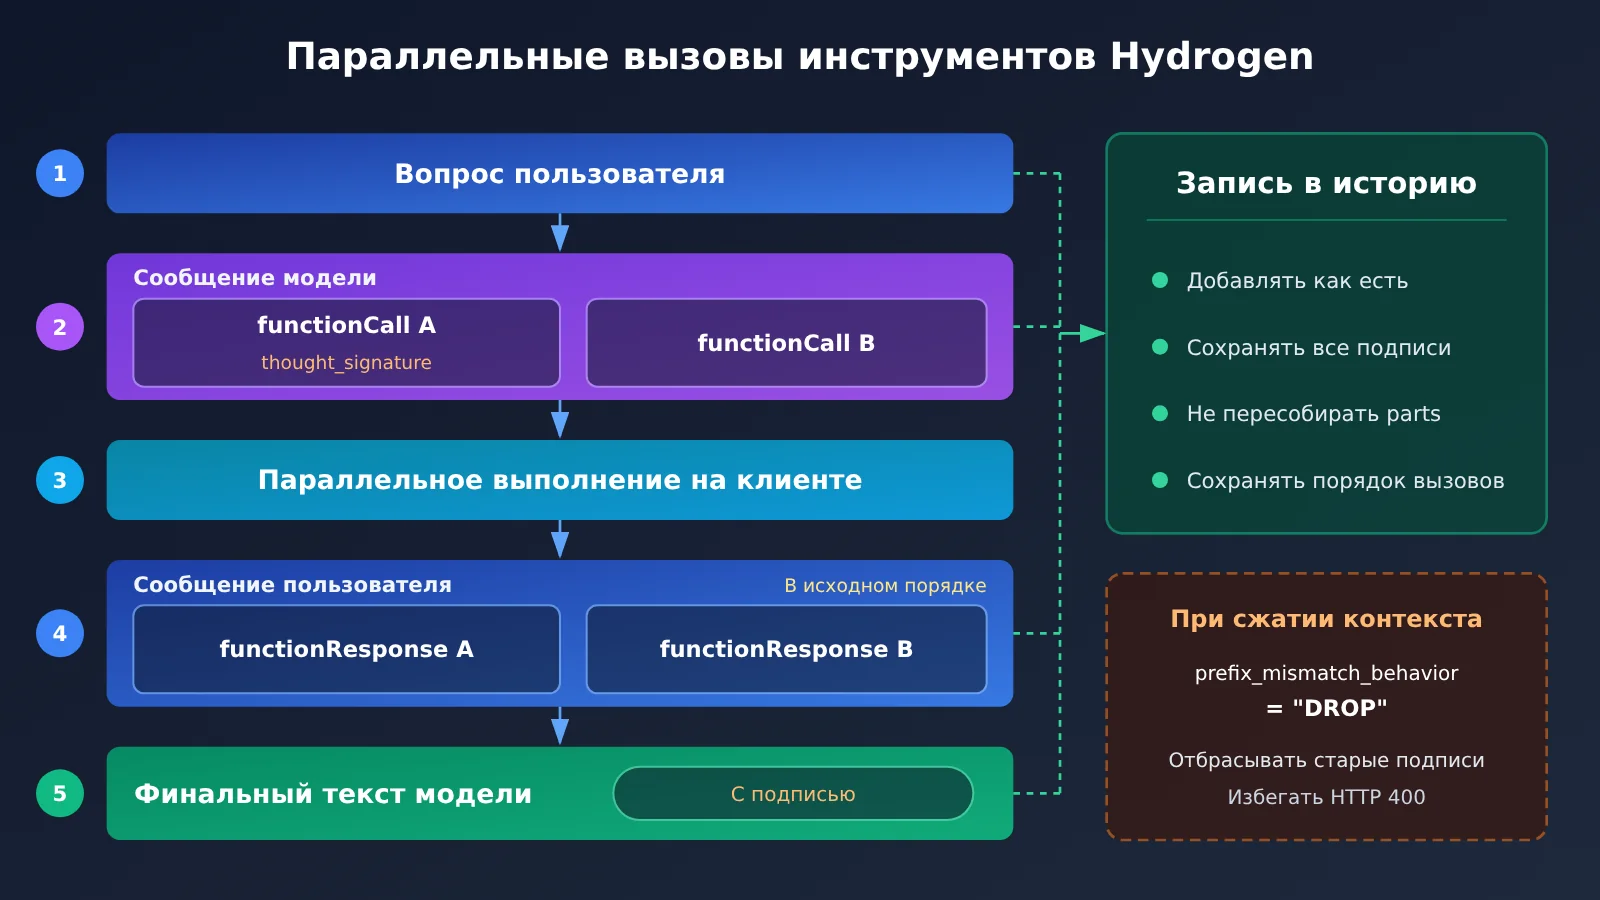
Как исправить поддержание подписи в Hydrogen
Самый надёжный способ — не пересобирать parts вручную, а добавлять объект content, возвращённый моделью, в историю как есть:
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # сохраняем как есть — подпись остаётся вместе с ним

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # сохраняем тот же порядок, что и у functionCall
]
history.append(types.Content(role="user", parts=responses))
Для агентов, которые сжимают или обрезают историю (например, скользящее окно, замена на сводку), префикс истории неизбежно меняется. В этом случае можно, согласно руководству по миграции, задать prefix_mismatch_behavior="DROP" — тогда при несовпадении префикса модель отбросит старую подпись, а не вернёт ошибку. Точное место этого поля в запросе уточняйте в официальном руководстве по миграции.
Типичные последствия: сильнее всего страдают самодельные Agent Harness, помощники по кодированию с параллельным поиском файлов и боты для длинных сессий со сжатием контекста. Для них стоит отдельно написать интеграционные тесты на возврат подписи.
7. Чек-лист миграции на Hydrogen и минимальный пример вызова
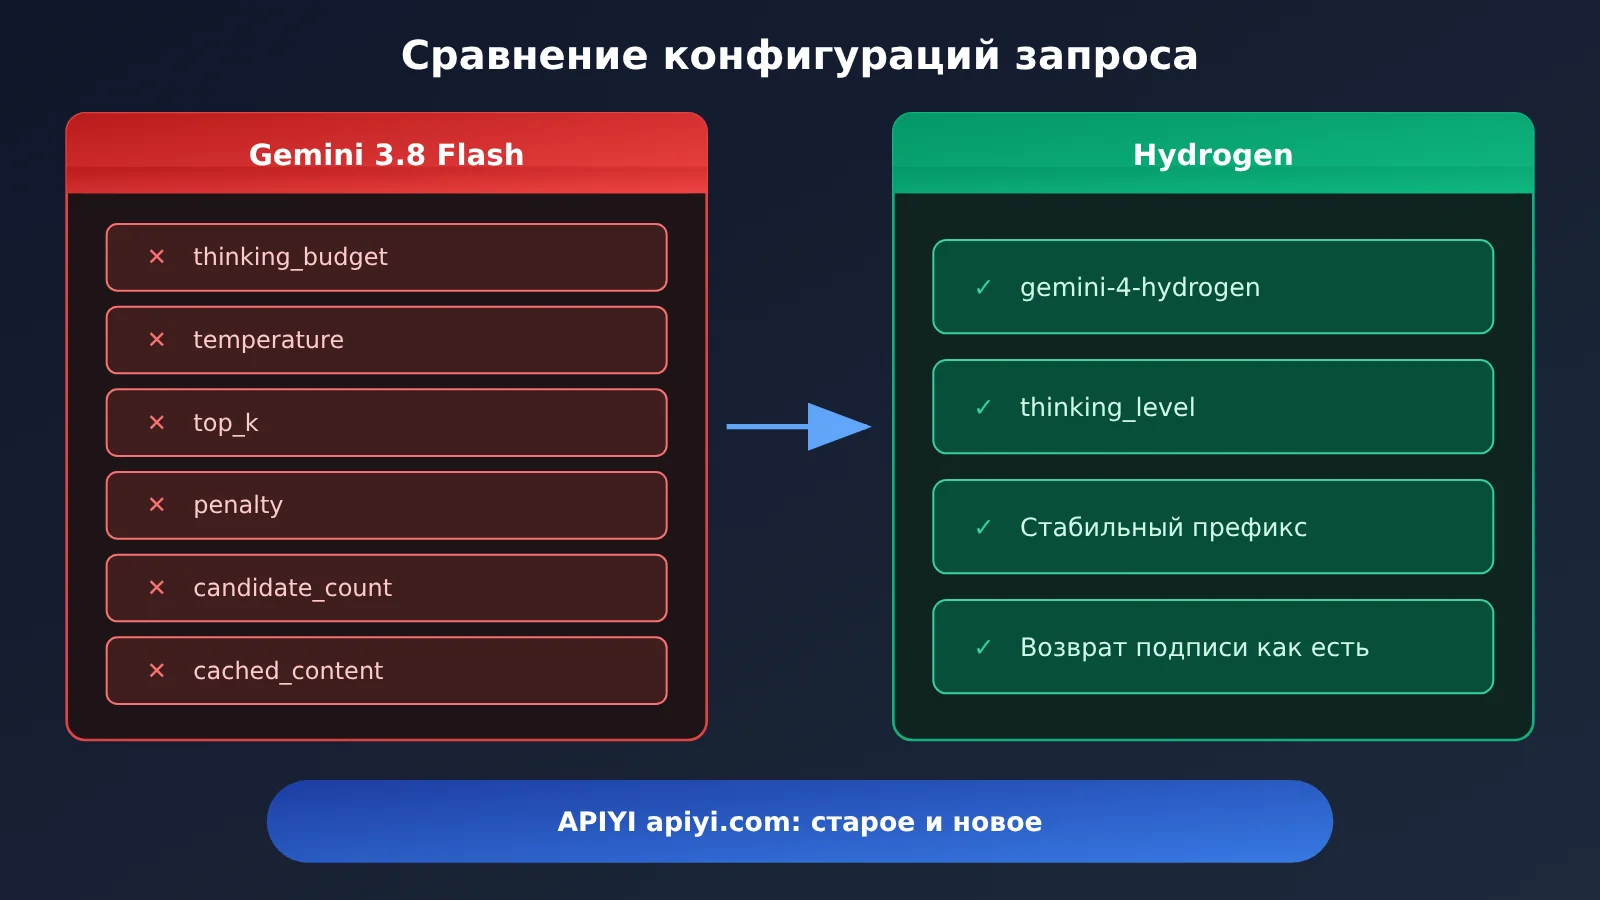
| Проверка | До миграции (3.8 Flash) | После миграции (Hydrogen) | Готово |
|---|---|---|---|
| ID модели | Старый ID модели | gemini-4-hydrogen |
☐ |
| SDK | Любая версия | Python >= 2.34.0, JS >= 2.32.0 (Interactions) | ☐ |
| Версия API | v1 | v1beta1, если нужно продолжение длинного вывода | ☐ |
| Параметры обдумывания | thinking_budget / MINIMAL | Явно задавать thinking_level | ☐ |
| Параметры генерации | temperature и другие настраиваются | Убрать penalty, candidate_count, предзаполненные раунды | ☐ |
| Кэширование | cached_content | Стабильный контент — в начало, префикс ≥ 4,096 tokens | ☐ |
| Вызов инструментов | История собирается заново вручную | Подпись сохраняется как есть, параллельные ответы возвращаются по порядку | ☐ |
| Обработка ошибок | Универсальные повторные попытки | Различать ошибки валидации HTTP 400 и молчаливое игнорирование | ☐ |
Быстрая проверка через OpenAI-совместимый интерфейс
Если бизнес-код команды построен на OpenAI SDK, можно сначала быстро проверить качество вывода Hydrogen через совместимый интерфейс, а затем решать, стоит ли переводить всё на нативный SDK. Доступность модели в каталоге и параметры, которые можно передавать напрямую, уточняйте в списке моделей и документации платформы:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
Посмотреть полный код реализации (с вызовом инструментов и сохранением истории)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс — удобно сравнивать старую и новую модели
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # Стабильный системный промпт ставим в самое начало — так больше шансов попасть в неявный кеш
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # Всю assistant-сообщение целиком пишем обратно в историю, не обрезая поля
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # Возвращаем результаты по одному в исходном порядке tool_calls
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 Совет для быстрого старта: на время миграции имеет смысл оставить 3.8 Flash в качестве контрольной группы и прогонять одни и те же реальные запросы через старую и новую модели одновременно. Через APIYI apiyi.com можно одним API-ключом вызывать обе модели, новым пользователям доступен бесплатный тестовый лимит — удобно сначала сравнить на небольшом трафике, а потом переключаться полностью.
Часто задаваемые вопросы (FAQ)
В1: Что такое Gemini 4 Hydrogen?
Gemini 4 Hydrogen — модель, выпущенная Google DeepMind 12 ноября 2026 года, её API ID — `gemini-4-hydrogen`. Она создана на базе Gemini 4 Carbon и ориентирована на скорость, повседневное программирование, вызовы множества инструментов и автоматическое выполнение задач. Может использоваться как сама по себе, так и в составе мультимодельных систем — в роли исполнителя или проверяющего.
В2: Насколько сильно Hydrogen отличается по возможностям от Gemini 3.8 Flash?
По официальным данным Google, Hydrogen показывает 57,0% на Terminal-Bench 4.1, а 3.8 Flash — 18,2%; при одинаковых условиях тестирования задачи выполняются примерно в 2,5 раза быстрее. Это результаты официальных тестов или тестов партнёров, и напрямую переносить их на все реальные задачи нельзя.
В3: Снизится ли стоимость после перехода на Hydrogen?
Не обязательно. Согласно официальной странице цен Google AI Studio (проверено 13 ноября 2026 года), стандартный вызов Hydrogen стоит $1.50 за вход и $7.50 за выход (долларов за миллион tokens), тогда как у 3.8 Flash до 31 декабря 2026 года — $0.75 / $3.75, а с 1 января 2027 года — $1.50 / $7.50. Цена за единицу сейчас вдвое выше, чем у 3.8 Flash, а итоговая стоимость зависит от длины рассуждений, числа повторов и эффективности выполнения задач.
В4: В каких проектах проверять совместимость нужно в первую очередь?
Прежде всего в следующих категориях:
— **Агенты с параллельными вызовами множества инструментов**: чаще всего ошибки возникают в расположении подписей и порядке ответов;
— **Системы с длинными сессиями и сжатием контекста**: нужно решать проблему несовпадения префиксов;
— **Генерация длинных отчётов и длинного кода**: нужно обновить SDK и перейти на v1beta1;
— **Пакетные системы, где стоимость контролируется явным кэшированием**: нужно перейти на стратегию неявного кэширования.
В5: Как быстро сравнить старую и новую модель через API?
Рекомендуемый подход такой:
1. Зайти на APIYI apiyi.com, зарегистрировать аккаунт и получить API-ключ;
2. Использовать пример из этой статьи с совместимостью с OpenAI, подставив в `model` ID старой и новой модели соответственно;
3. Сравнить качество вывода, задержку и расход токенов на одном и том же наборе бизнес-запросов.
Единый интерфейс избавляет от необходимости отдельно поддерживать аутентификацию и код запросов для двух моделей.
В6: Какие известные ограничения есть у Hydrogen?
В официальной карточке модели указано: она всё ещё может галлюцинировать; на высоких уровнях рассуждений время и стоимость заметно растут, иногда случаются задержки или таймауты; знания обрываются в марте 2026 года; по сравнению с 3.8 Flash показатель необоснованных отказов ухудшился на 5,57 процентного пункта. Кроме того, Hydrogen не поддерживает Live API и Fine-tuning. В ранних отзывах сообщества некоторые пользователи сообщали об избыточном выполнении задач агентами — это индивидуальный опыт.
В7: Как контролировать риск расходов на начальном этапе миграции?
Советую сначала явно задать `thinking_level=»medium»` и снять базовый замер, а потом уже для многошаговых агентов отдельно включать High; заодно проверьте долю попаданий в неявный кэш и долю «размышляющих» токенов. Если хочется платить по факту потребления и видеть расход по нескольким моделям в одном месте, можно воспользоваться единым биллингом APIYI apiyi.com для сравнения.
Ключевые моменты миграции на Hydrogen
- Дело не только в названии: поменять ID модели на
gemini-4-hydrogen— это лишь первый шаг, ещё четыре параметра конфигурации надо поправить одновременно. - SDK — обязательное условие: для продолжения длинных ответов нужны Python >= 2.34.0 и JS >= 2.32.0 (Interactions API), причём с v1beta1.
- Параметры размышления сменились:
thinking_budgetиMINIMALвернут HTTP 400, а уровень по умолчанию теперь High. - Параметры сэмплирования больше не работают: temperature, top_p и top_k игнорируются, а penalty, несколько кандидатов и предзаполненные ходы нужно убрать.
- Кэш держится на структуре: явный кэш отменён, и для попадания в неявный кэш стабильный префикс должен дотягивать до 4,096 tokens.
- Подпись должна быть полной: при параллельных вызовах подпись есть только в первом functionCall, ответы приходят по порядку, а для сжатия истории можно установить DROP.
- Сначала сравните, потом переключайтесь: вызывайте старую и новую модели одним и тем же ключом через APIYI apiyi.com, проверьте на небольшом трафике — и только потом мигрируйте полностью.
Итог
Ключевые моменты при переходе с Gemini 3.8 Flash на Hydrogen:
- Базовый уровень: обновить ID модели и SDK, разобраться с единой квотой в 1 048 576 токенов и лимитом вывода в 65 536 токенов на один сегмент;
- Уровень параметров: заменить
thinking_levelнаthinking_budget, вычистить устаревшие поля сэмплирования и генерации; - Уровень состояния: переработать структуру промпта так, чтобы попадать в неявный кэш, а
thought_signatureсохранять как есть и возвращать обратно.
Рекомендуем пройти по чек-листу из этой статьи пункт за пунктом, написать регрессионные тесты для вызова инструментов и длинных выводов — и только потом переключать реальный трафик на новую модель. Для быстрого сравнения старой и новой модели удобно использовать APIYI apiyi.com: платформа предоставляет OpenAI-совместимый интерфейс и бесплатную тестовую квоту для новых пользователей.
📚 Справочные материалы
- Руководство по миграции для разработчиков Gemini 4 Hydrogen: официальные изменения совместимости и чек-лист миграции
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Что внутри: первоисточник по минимальной версии SDK, правилам подписи,
prefix_mismatch_behaviorи другим деталям -
Введение в Gemini 4 и разбор различий при миграции: длинный вывод и версии API
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
Что внутри: объясняется, что для функции продолжения генерации нужен API v1beta1
-
Спецификации модели Google Cloud Hydrogen: таблица контекста, параметров и поддерживаемых возможностей
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Что внутри: фиксированные значения temperature, top_p, top_k и поддержка кэширования
-
Официальный блог Google: анонс выпуска Gemini 4 Hydrogen
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Что внутри: позиционирование продукта и официальные данные сравнения с 3.8 Flash
-
Страница цен Google AI Studio: официальные цены на API
- Ссылка:
aistudio.google.com/docs/pricing -
Что внутри: цены Standard, Batch, Flex, Priority и при попадании в кэш
-
Независимая оценка Artificial Analysis: тестирование четырёх уровней thinking
- Ссылка:
artificialanalysis.ai/models/gemini-4-hydrogen -
Что внутри: сторонний индекс интеллекта, время и стоимость оценки
-
Модельная карта Google DeepMind: возможности, ограничения и оценка безопасности
- Ссылка:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Что внутри: известные ограничения и официальная кросс-модельная оценка
Автор: техническая команда APIYI
Техническое обсуждение: если при миграции возникнут проблемы совместимости — будем рады пообщаться через официальный сайт APIYI; больше материалов по подключению ищите в центре документации docs.apiyi.com