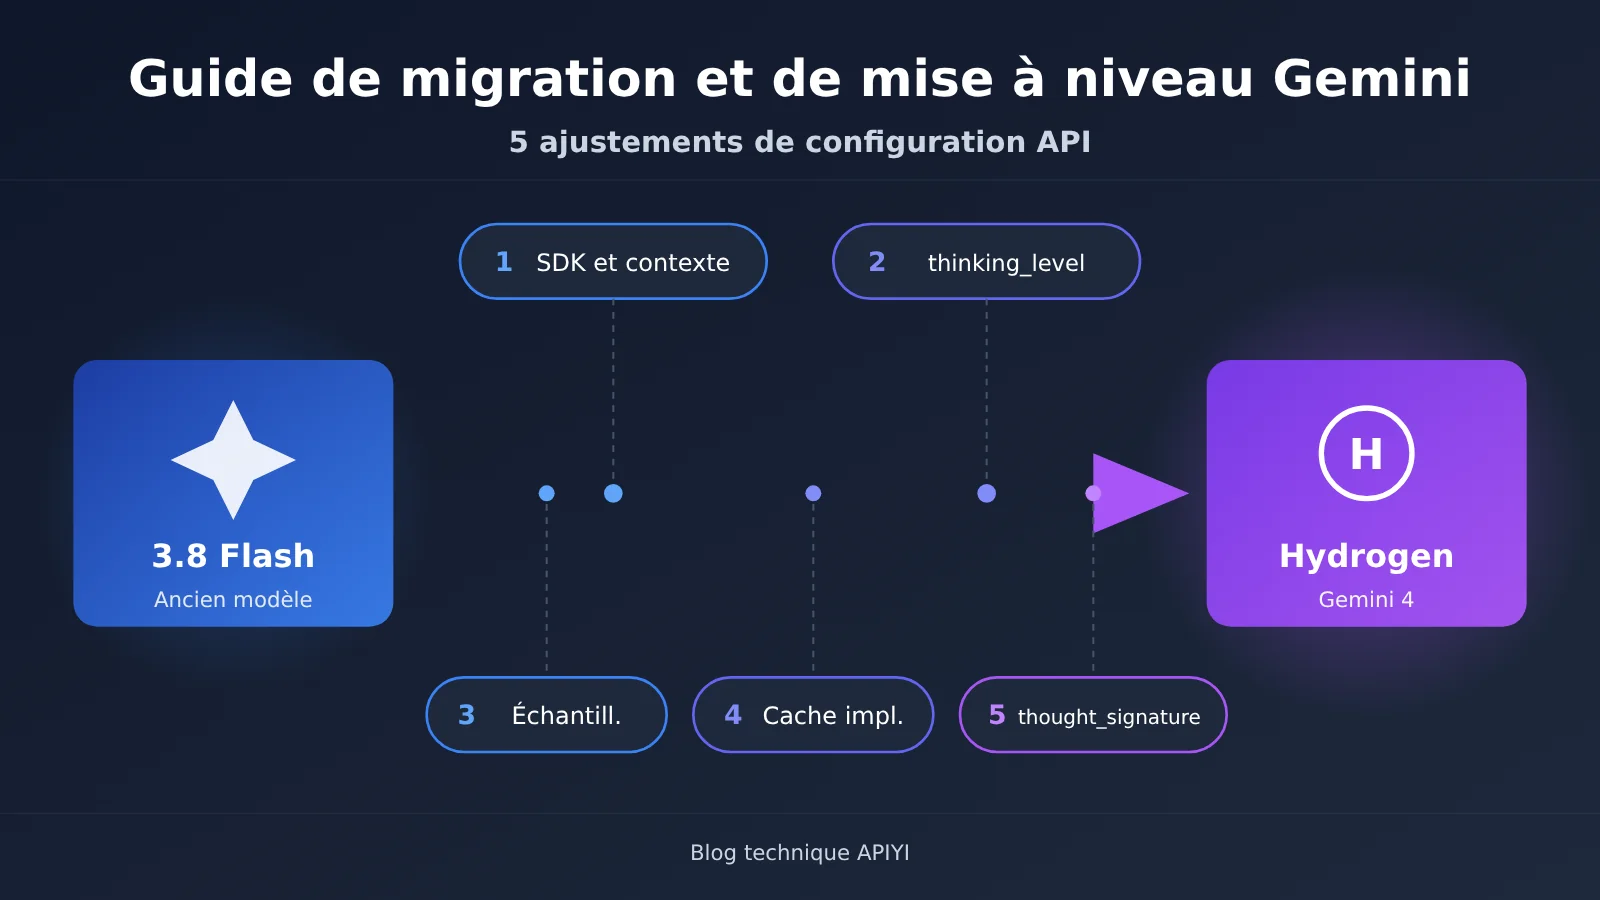
Note de l’auteur : migrer de Gemini 3.8 Flash vers Hydrogen demande d’ajuster en même temps le SDK et le contexte, les paramètres de réflexion, la configuration d’échantillonnage, le cache, ainsi que la gestion des signatures pour les appels d’outils en plusieurs tours.
Google a officiellement lancé Gemini 4 Hydrogen le 12 novembre 2026, avec l’identifiant de modèle API gemini-4-hydrogen, positionné pour la programmation au quotidien et l’exécution d’agents IA. Beaucoup d’équipes ont eu comme premier réflexe de remplacer le nom du modèle dans leur code puis de mettre en production directement — pour se retrouver face à des HTTP 400, des paramètres sans effet, des erreurs sur les appels d’outils en plusieurs tours et des sorties longues tronquées. Cet article récapitule les 5 configurations API qu’il faut ajuster pour passer de Gemini 3.8 Flash à Hydrogen, chacune traitée dans l’ordre « ancien comportement → nouveau comportement → méthode de correction → impact typique ».
Ce n’est pas une simple reprise de l’annonce. Les noms de paramètres, les valeurs autorisées, les numéros de version de SDK et les types d’erreurs cités ici proviennent tous du guide de migration officiel de Google Cloud et de la documentation de spécifications du modèle ; les évaluations de tiers et les retours de la communauté sont signalés séparément avec leur source.
L’essentiel : à la fin de cet article, vous aurez une liste de vérification pour modifier une à une votre code d’appel Gemini 3.8 Flash existant, et pour migrer sans accroc vos agents et vos traitements par lots vers Hydrogen.
Les 5 termes à connaître pour migrer vers Hydrogen
Avant de modifier quoi que ce soit, commençons par clarifier quelques concepts qui reviennent sans cesse dans le guide de migration :
- thinking_level : paramètre de niveau de réflexion qui contrôle la profondeur de raisonnement du modèle. Hydrogen l’utilise à la place de l’ancien
thinking_budget; les niveaux valides sont Low, Medium, High et XHigh. - thought_signature : signature associée au raisonnement renvoyée par le modèle dans sa réponse. Lors des conversations multi-tours et des appels d’outils, elle doit être conservée et renvoyée telle quelle, sinon le modèle ne peut pas reprendre l’état de raisonnement précédent.
- continuation_token : marqueur de continuation utilisé pour enchaîner le segment suivant d’une sortie longue. Une fois la limite d’un segment atteinte, il permet de poursuivre la génération.
- cache implicite : la plateforme réutilise automatiquement les préfixes d’entrée éligibles ; la partie concernée est facturée au tarif du cache, sans que le développeur ait à créer manuellement un objet de cache.
- fenêtre de contexte : étendue d’informations qu’un modèle peut traiter en une seule fois. Chez Hydrogen, l’entrée, la sortie, la réflexion et les appels d’outils partagent un même quota unifié de 1,048,576 tokens.
1. Pourquoi migrer vers Hydrogen ne se limite pas à changer l’ID du modèle
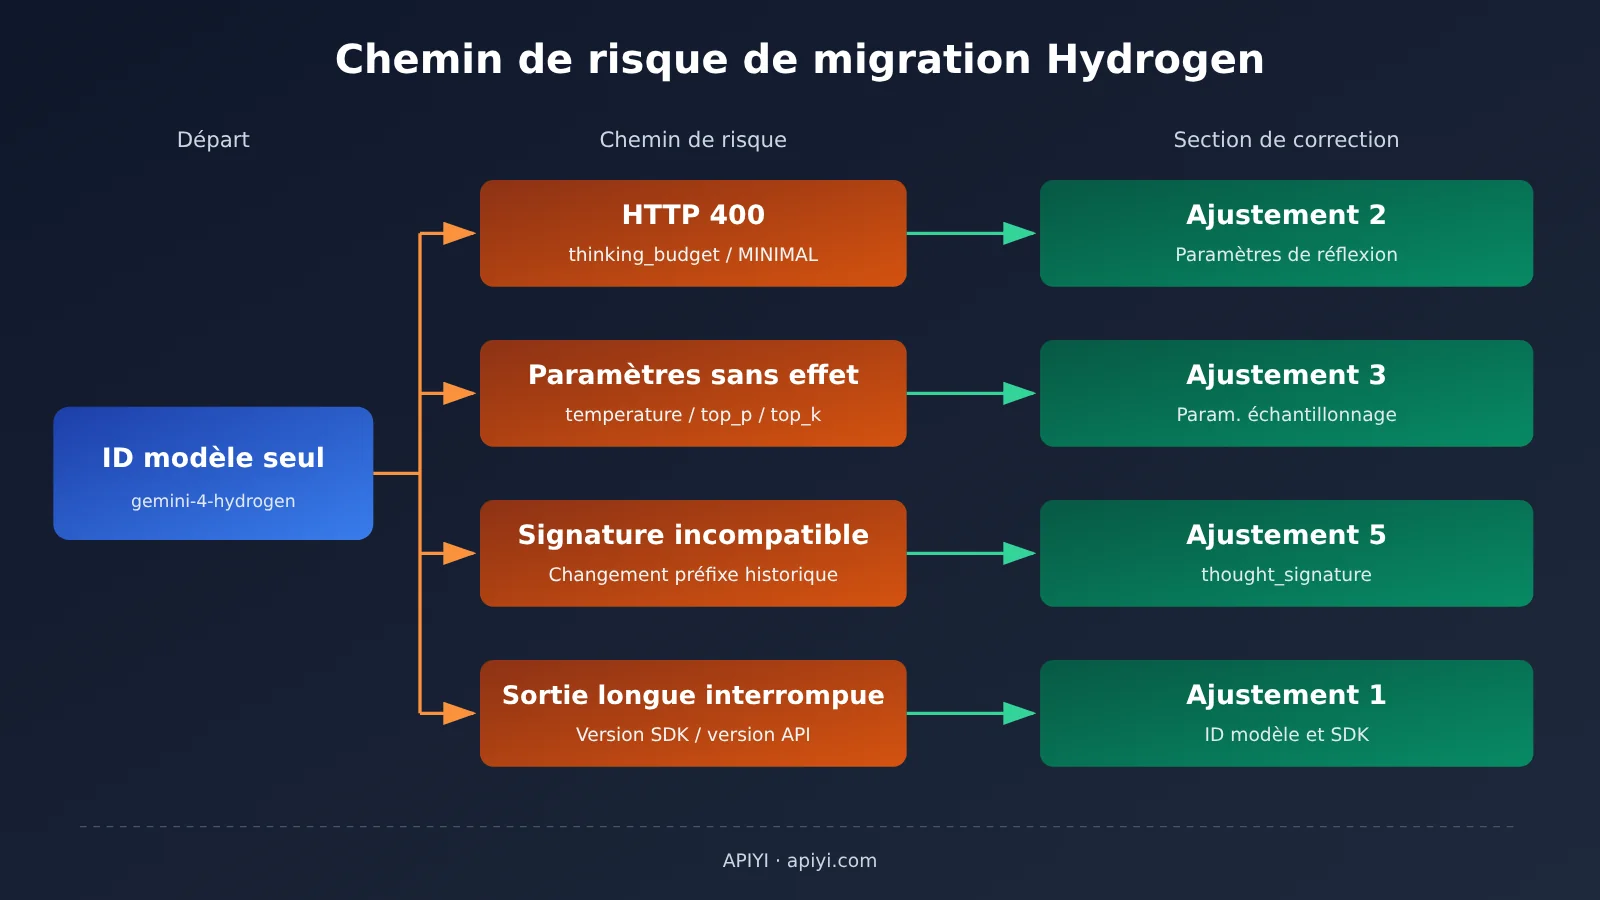
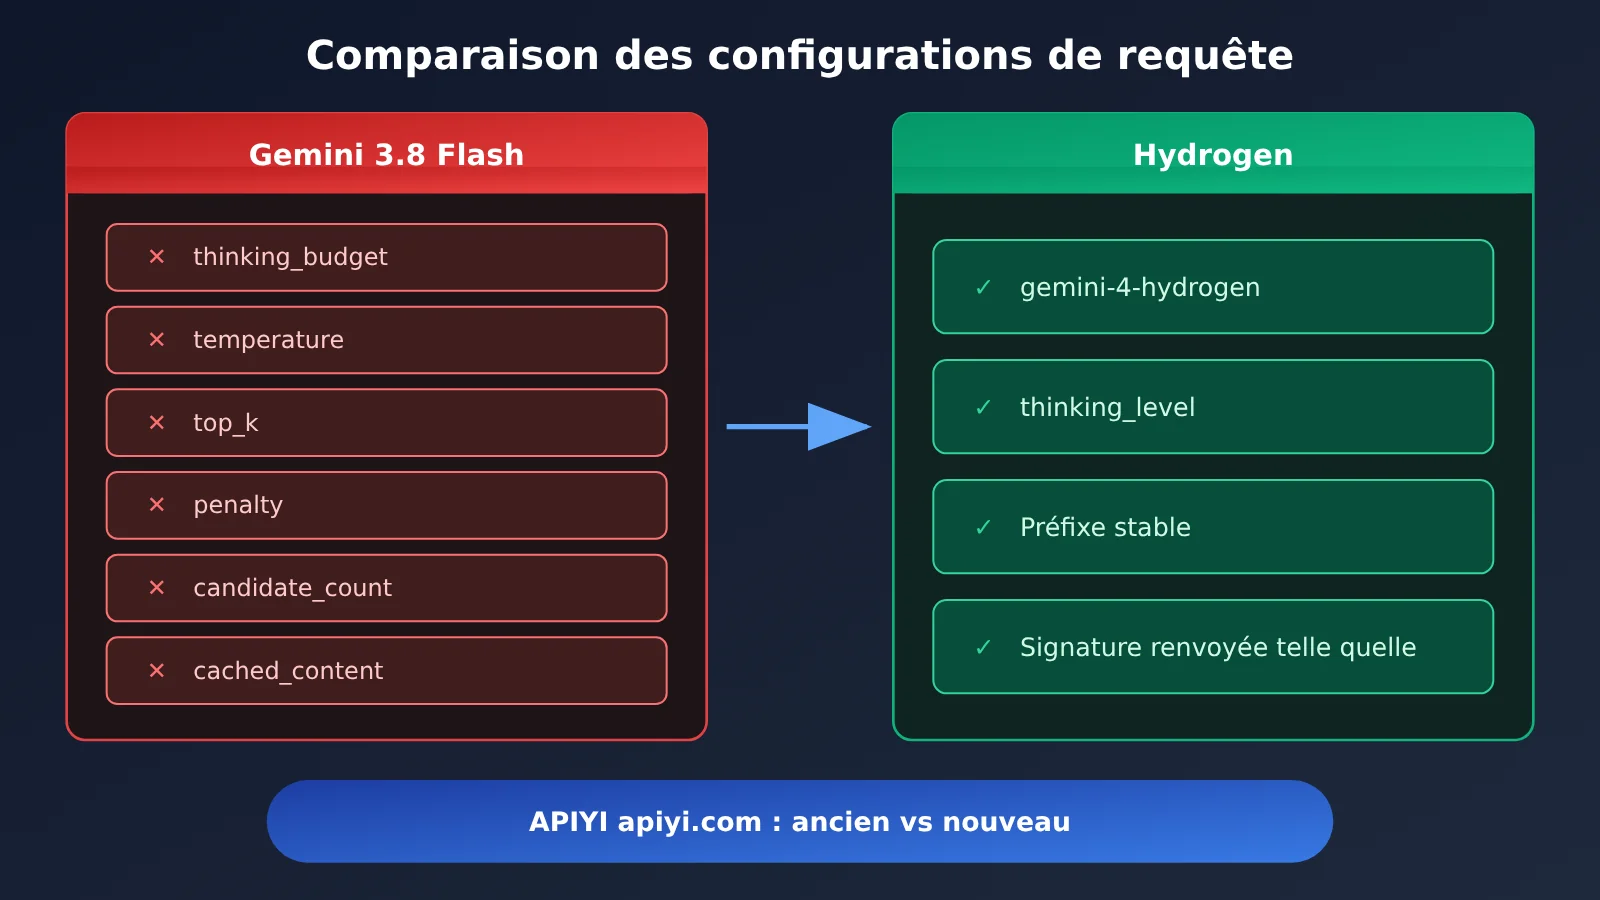
Gemini 3.8 Flash et Hydrogen appartiennent tous deux à la famille Gemini, mais leurs comportements d’API présentent plusieurs incompatibilités. Selon le guide de migration officiel, thinking_budget et le niveau de réflexion MINIMAL ne sont pas pris en charge sur Hydrogen : la requête renvoie directement HTTP 400. En revanche, les paramètres d’échantillonnage comme temperature, top_p et top_k ne déclenchent pas d’erreur ; ils sont simplement ignorés en silence. Le premier type de problème se repère dès les tests, tandis que le second peut vous faire croire que « les paramètres sont toujours actifs ».
Deux autres risques sont plus discrets. D’une part, la gestion des signatures lors des appels d’outils multi-tours est plus stricte : si l’historique de conversation est compressé ou tronqué, une signature qui ne correspond plus au préfixe peut déclencher HTTP 400. D’autre part, le niveau de réflexion par défaut passe de Medium à High ; sans réglage explicite, la même requête consomme davantage de tokens de réflexion et allonge la latence. Le tableau ci-dessous récapitule les cinq ajustements :
| Ajustement | Ancien comportement (3.8 Flash) | Nouveau comportement (Hydrogen) | Conséquence si rien n’est changé |
|---|---|---|---|
| ID du modèle, SDK et contexte | Ancien ID de modèle, ancien SDK utilisable | gemini-4-hydrogen, version minimale du SDK requise pour la continuation des sorties longues |
Interruption des sorties longues, continuation indisponible |
| Paramètres de réflexion | thinking_budget, Medium par défaut |
thinking_level, High par défaut |
HTTP 400, ou hausse des coûts et de la latence |
| Paramètres d’échantillonnage et de génération | temperature, top_p, top_k, etc. réglables | Valeurs fixes, personnalisation ignorée ; certains champs doivent être supprimés | Style de sortie non contrôlable, échec de validation de certaines requêtes |
| Cache | Prise en charge du cache explicite cached_content |
Uniquement le cache implicite, seuil de 4,096 tokens | Références de cache invalides, estimation des coûts faussée |
| thought_signature | Règles de signature relativement souples | Règles strictes pour les appels parallèles et les changements de préfixe | Erreurs d’Agent multi-tours ou rupture du raisonnement |
2. Ajustement n°1 : ID de modèle, version du SDK et limites de contexte de Hydrogen
Ancien comportement → nouveau comportement : à l’époque de 3.8 Flash, la plupart des projets ne se souciaient guère de la version du SDK. Après la migration vers Hydrogen, l’ID de modèle doit devenir gemini-4-hydrogen ; et si vous avez besoin de sorties très longues, la version du SDK devient une condition incontournable. Voici les versions minimales indiquées dans le guide de migration officiel de Google :
| Langage de développement | Reprise automatique de GenerateContent | Reprise automatique de l’API Interactions |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | non listé séparément par Google | >= 1.77.0 |
| Java | non listé séparément par Google | >= 1.80.0 |
Comment modifier le contexte et les sorties longues de Hydrogen
Les 1,048,576 tokens de Hydrogen constituent un quota unifié : l’entrée et l’historique de contexte, les tokens de réflexion, les tokens liés aux appels d’outils et la sortie finale sont tous déduits de ce même pool. Autrement dit, vous ne pouvez pas saisir 1 million de tokens puis générer 1 million de tokens supplémentaires. Pour les agents d’analyse de longs documents, il faut donc réserver activement, côté entrée, de la place pour la réflexion et les appels d’outils.
La limite d’une génération en une seule passe au premier plan est généralement de 65,536 tokens. Au-delà de cette longueur, trois options s’offrent à vous : utiliser la reprise automatique d’un SDK compatible, définir background=true dans l’API Interactions pour une génération longue en arrière-plan, ou maintenir vous-même un continuation_token pour concaténer les segments un à un. Attention : la documentation d’introduction officielle précise que la reprise des sorties longues nécessite actuellement l’API v1beta1, et que la v1 d’Agent Platform ne prend pas cette fonctionnalité en charge.
Impact typique : les activités de génération en masse de longs rapports ou de longs fichiers de code sont les plus exposées. Je vous conseille de commencer par mettre à jour le SDK, puis de basculer la version d’API sur v1beta1, et enfin de lancer un test de régression avec une requête dépassant 65,536 tokens.
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
III. Deuxième ajustement : dans Hydrogen, thinking_budget devient thinking_level
Ancien comportement : 3.8 Flash utilisait thinking_budget pour contrôler la longueur de la réflexion en nombre de tokens, avec la possibilité de choisir le niveau MINIMAL, le niveau par défaut étant Medium.
Nouveau comportement : Hydrogen n’accepte plus que thinking_level, dont les valeurs autorisées sont Low, Medium, High et XHigh, soit quatre niveaux, la valeur par défaut étant High. Continuer à transmettre thinking_budget ou MINIMAL renvoie une erreur HTTP 400. Les usages recommandés par la documentation officielle sont les suivants : Low pour la classification, Medium pour la programmation courante, High pour les agents multi-étapes, XHigh pour les raisonnements complexes et approfondis.
L’organisme tiers Artificial Analysis a réalisé le 12 novembre une évaluation indépendante des quatre niveaux (Intelligence Index v5.0.1), qui aide à comprendre les différences entre ces niveaux. Les durées et les coûts indiqués dans le tableau ci-dessous sont les moyennes de ses tâches d’évaluation standardisées ; ils ne représentent pas le coût réel d’une conversation individuelle pour un utilisateur ordinaire :
| Niveau de réflexion | Scénario recommandé officiellement | Indice d’intelligence (AA) | Temps moyen d’évaluation | Coût moyen d’évaluation |
|---|---|---|---|---|
| Low | Classification, extraction simple | 27 | 1.3 minutes | $0.29 |
| Medium | Programmation courante | 41 | 3.7 minutes | $0.80 |
| High (par défaut) | Agent multi-étapes | 51 | 8.3 minutes | $1.87 |
| XHigh | Raisonnement complexe et approfondi | 54 | 13.5 minutes | $3.16 |
D’après ces données, High dépasse Medium de 10 points, tandis que XHigh ne devance High que de 3 points, alors que le coût d’évaluation passe de 1,87 $ à 3,16 $. Cela montre que le niveau le plus élevé n’est pas forcément le plus avantageux, et que les capacités d’un même nom de modèle peuvent varier considérablement d’un niveau à l’autre.
Exemple de modification de thinking_level pour Hydrogen
L’exemple ci-dessous utilise la syntaxe officielle du SDK Google Gen AI. Pour la casse des valeurs d’énumération, fiez-vous aux définitions de type de la version du SDK installé :
from google import genai
from google.genai import types

client = genai.Client()

# Ancienne écriture (3.8 Flash) : renverra une erreur HTTP 400 sur Hydrogen
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# Nouvelle écriture : Medium pour les tâches de programmation courante
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# Agent multi-étapes : High (également la valeur par défaut, mieux vaut l'écrire explicitement)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修复这个函数中的空指针问题:...",
    config=coding_config,
)
print(resp.text)
Impact typique : comme les tokens de réflexion sont facturés au prix de sortie, les projets qui ne définissent pas explicitement le niveau se retrouveront automatiquement sur High après la migration, ce qui fera augmenter la facture et la latence. Il est recommandé de faire correspondre les anciennes plages de thinking_budget à des niveaux : un budget faible correspond à Low ou Medium, un budget élevé à High.
IV. Ajustement 3 : nettoyer les paramètres de génération devenus sans effet dans Hydrogen
Ancien comportement : 3.8 Flash permettait de régler l’aléa de la sortie via temperature, top_p et top_k, et prenait également en charge les paramètres de pénalité ainsi que les sorties à candidats multiples.
Nouveau comportement : dans Hydrogen, la température par défaut est de 1.0 et toute valeur personnalisée reste sans effet, top_p est figé à 0.95 et top_k à 64 — ces trois paramètres sont ignorés dès qu’ils sont transmis. La liste de migration officielle demande en plus de traiter les champs suivants :
| Champ ou comportement | Exigence de migration Hydrogen | Astuce de dépannage |
|---|---|---|
| temperature / top_p / top_k | Les valeurs personnalisées sont ignorées | Aucune erreur remontée : il faut passer par l’invite pour contrôler le style |
| frequency_penalty / presence_penalty | À supprimer | Fiez-vous à l’erreur réelle ; les supprimer systématiquement reste la solution la plus sûre |
| candidate_count > 1 | Supprimer le réglage multi-candidats | Si vous avez besoin de diversité, faites plusieurs requêtes |
tours d’historique model pré-remplis |
À supprimer | Plus moyen d’« amorcer » la réponse du modèle pour imposer un format |
| cached_content | Ne plus référencer de cache explicite | Voir l’ajustement 4 |
| thinking_budget | Utiliser à la place un thinking_level valide |
Renvoie un HTTP 400 |
La documentation officielle le précise bien : certains anciens paramètres sont simplement ignorés, d’autres font échouer la validation de la requête. Le dépannage ne peut donc pas être uniforme. En cas de 400, vérifiez en priorité thinking_budget, MINIMAL et les champs à supprimer ; si le style de sortie ne correspond pas à ce que vous attendez, regardez plutôt si le code s’appuie encore sur les paramètres de température.
Configuration de requête simplifiée pour Hydrogen
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # placer le contenu stable en premier favorise le cache implicite
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # la sortie structurée reste prise en charge
    max_output_tokens=8192,
)
Impact typique : les projets qui comptaient sur une température basse pour garantir une sortie JSON stable doivent désormais s’appuyer sur les capacités de sortie structurée ; ceux qui s’appuyaient sur des tours model pré-remplis pour contrôler le format doivent inscrire les exigences de format directement dans l’invite système.
5. Ajustement 4 : Hydrogen passe du cache explicite au cache implicite
Ancien comportement : sur 3.8 Flash, les développeurs pouvaient d’abord créer un objet de cache, puis y faire référence dans la requête via cached_content="cachedContents/xxx".
Nouveau comportement : Hydrogen ne prend pas en charge le cache contextuel explicite ; il ne prend en charge que le cache implicite et active par défaut un mécanisme de cache implicite persistant. La longueur minimale du préfixe pour le cache passe de 6,144 tokens sur 3.8 Flash à 4,096 tokens, ce qui permet aussi de toucher plus facilement des invites système publiques et des supports de connaissances fixes relativement courts.
Comment procéder : supprimez tous les appels à caches.create et toutes les références à cached_content, puis optimisez plutôt l’ordre de concaténation des invites. Google recommande de placer le contenu public stable au début de l’entrée et la question de l’utilisateur, qui change à chaque fois, à la fin :
- Invite système et définition du rôle (quasiment inchangées)
- Base de connaissances publique, documentation API, conventions de code (modifications peu fréquentes)
- Historique de la conversation (ajouté tour après tour)
- Question actuelle de l’utilisateur (change à chaque fois)
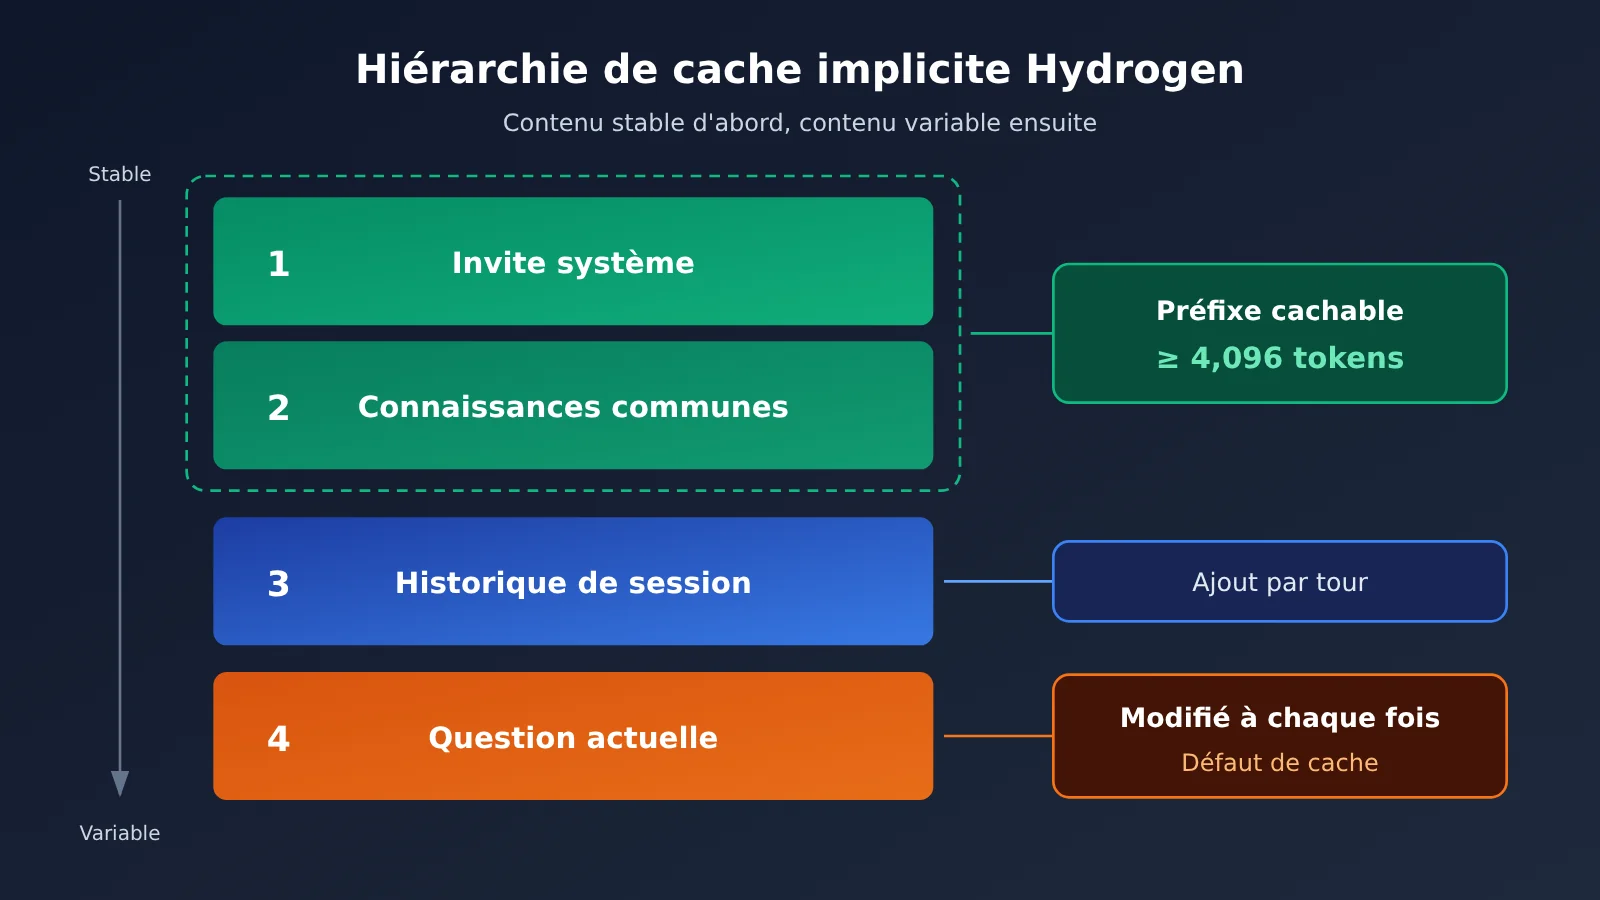
Impact typique : côté tarifs, selon la page officielle des prix de Google AI Studio (vérifiée le 13 novembre 2026, en dollars par million de tokens), l’entrée bénéficiant d’un cache hit implicite pour un appel standard à Hydrogen est facturée $0.075, contre $0.0375 en modes Batch et Flex, bien moins que les $1.50 d’une entrée standard. Si vous insérez des variables dynamiques (horodatage, ID utilisateur, etc.) au début de l’invite, le préfixe diffère à chaque fois et aucun cache hit ne sera possible.
6. Ajustement n°5 : bien gérer thought_signature dans Hydrogen
Ancien comportement : sur 3.8 Flash, beaucoup de frameworks d’agents reconstruisaient eux-mêmes l’historique de conversation en ne gardant que le texte et les résultats d’appels d’outils ; la perte de signature n’avait alors souvent aucun effet visible.
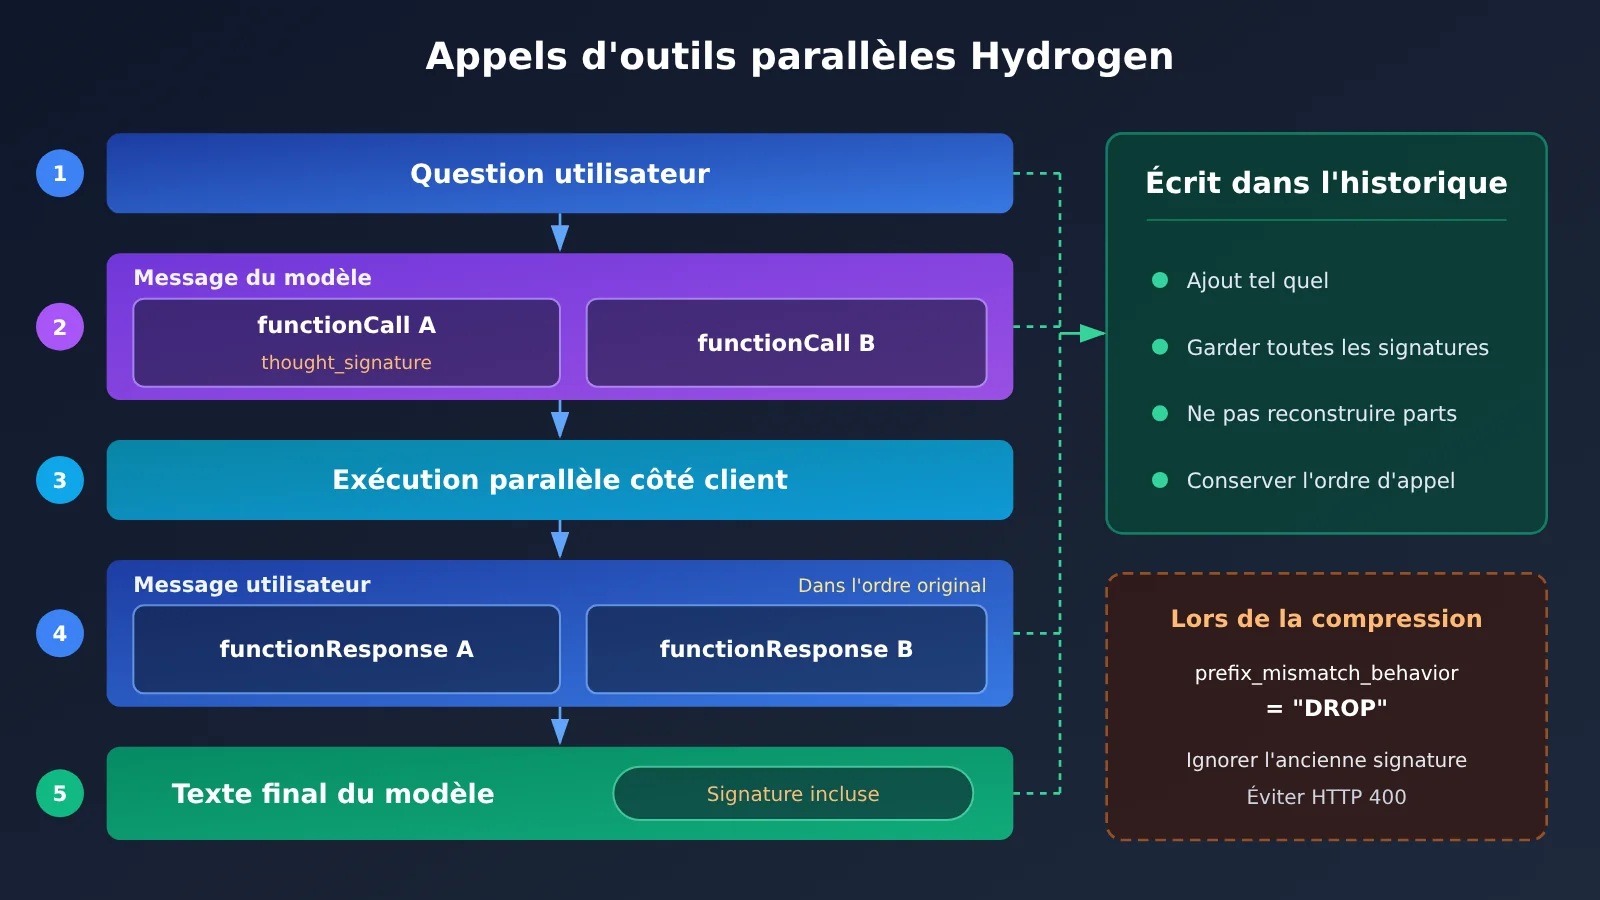
Nouveau comportement : dans Hydrogen, une conversation multi-tours doit conserver la signature de toutes les parties concernées, y compris celle portée par la partie texte finale. Le guide de migration officiel précise ce qui suit pour les appels d’outils parallèles :
- plusieurs
functionCallparallèles doivent se trouver dans un seul et même message du modèle ; thought_signaturese place uniquement dans la première partiefunctionCallparallèle ;- les
functionResponsesuivants doivent être renvoyés dans l’ordre, avec l’ID et le nom correspondant à l’appel ; - si un même modèle réutilise une signature et que le préfixe de l’historique a changé, la requête peut par défaut renvoyer une erreur HTTP 400.
Comment corriger la gestion des signatures dans Hydrogen
La méthode la plus sûre consiste à ne pas reconstruire les parts à la main, mais à ajouter tel quel l’objet content renvoyé par le modèle à l’historique :
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # conservé tel quel, la signature l'est aussi

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # garder le même ordre que les functionCall
]
history.append(types.Content(role="user", parts=responses))
Pour les agents qui compressent ou tronquent l’historique (fenêtre glissante, remplacement par un résumé, par exemple), le préfixe de l’historique changera forcément. Dans ce cas, on peut configurer prefix_mismatch_behavior="DROP" comme le recommande le guide de migration : le modèle abandonne alors les anciennes signatures au lieu de renvoyer une erreur lorsque le préfixe ne correspond pas. Pour savoir où placer exactement ce champ dans la requête, reportez-vous au guide de migration officiel.
Impact typique : les Agent Harness maison, les assistants de codage qui lisent les fichiers en parallèle et les chatbots à longue conversation avec compression de contexte sont les plus touchés. Mieux vaut écrire un test d’intégration dédié au renvoi des signatures.
VII. Liste de vérification pour la migration vers Hydrogen et exemple d’appel minimal
| Élément de vérification | Avant migration (3.8 Flash) | Après migration (Hydrogen) | Fait |
|---|---|---|---|
| ID du modèle | Ancien ID de modèle | gemini-4-hydrogen |
☐ |
| SDK | N’importe quelle version | Python >= 2.34.0, JS >= 2.32.0 (Interactions) | ☐ |
| Version de l’API | v1 | Utiliser v1beta1 pour la poursuite des sorties longues | ☐ |
| Paramètres de réflexion | thinking_budget / MINIMAL | Définir explicitement thinking_level | ☐ |
| Paramètres de génération | temperature etc. ajustables | Supprimer penalty, candidate_count et les tours préremplis | ☐ |
| Cache | cached_content | Placer le contenu stable en premier, préfixe ≥ 4 096 tokens | ☐ |
| Appel d’outils | Reconstruire l’historique soi-même | Conserver la signature telle quelle, renvoyer les réponses parallèles dans l’ordre | ☐ |
| Gestion des erreurs | Nouvelle tentative générique | Distinguer les erreurs de validation HTTP 400 des erreurs ignorées silencieusement | ☐ |
Validation rapide via l’interface compatible OpenAI
Si le code métier de votre équipe s’appuie sur le SDK OpenAI, vous pouvez d’abord vérifier rapidement la qualité des sorties de Hydrogen via l’interface compatible, puis décider seulement ensuite s’il faut passer au SDK natif. La disponibilité du modèle et les paramètres réellement transmissibles dépendent de la liste des modèles et de la documentation de la plateforme :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
Voir le code d’implémentation complet (avec appels d’outils et conservation de l’historique)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée, pratique pour comparer ancien et nouveau modèle
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # L'invite système stable est placée en tête, ce qui favorise le cache implicite
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # On réécrit tel quel le message assistant complet dans l'historique, sans en rogner les champs
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # Renvoyer les résultats un par un, dans l'ordre d'origine des tool_calls
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 Conseil pour démarrer vite : pendant la migration, gardez 3.8 Flash comme groupe de contrôle et faites tourner les deux modèles en parallèle sur le même lot de requêtes réelles. Avec APIYI apiyi.com, une seule clé API suffit pour appeler les deux modèles, et les nouveaux utilisateurs bénéficient d’un quota de test gratuit : idéal pour comparer sur un petit volume de trafic avant de basculer tout le reste.
FAQ : questions fréquentes
Q1 : Qu’est-ce que Gemini 4 Hydrogen ?
Gemini 4 Hydrogen est un modèle publié par Google DeepMind le 12 novembre 2026, avec l’ID d’API `gemini-4-hydrogen`. Il dérive de Gemini 4 Carbon et met l’accent sur la vitesse, le codage au quotidien, l’appel à de multiples outils et l’exécution de tâches automatisées. Il peut être utilisé seul ou jouer le rôle d’exécutant ou de validateur dans un système multi-modèles.
Q2 : Quel est l’écart de capacité entre Hydrogen et Gemini 3.8 Flash ?
D’après les chiffres officiels publiés par Google, Hydrogen atteint 57,0 % sur Terminal-Bench 4.1, contre 18,2 % pour 3.8 Flash ; à conditions de test identiques, les tâches sont terminées environ 2,5 fois plus vite. Il s’agit de résultats officiels ou de partenaires, qu’on ne peut pas extrapoler directement à toutes les tâches réelles.
Q3 : Le coût baisse-t-il après migration vers Hydrogen ?
Pas forcément. D’après la page tarifaire officielle de Google AI Studio (vérifiée le 13 novembre 2026), un appel standard à Hydrogen coûte 1,50 $ en entrée et 7,50 $ en sortie (dollars par million de tokens), tandis que 3.8 Flash est à 0,75 $ / 3,75 $ jusqu’au 31 décembre 2026, puis passera à 1,50 $ / 7,50 $ à partir du 1er janvier 2027. Le prix unitaire est donc actuellement le double de celui de 3.8 Flash ; le coût total dépend de la longueur de réflexion, du nombre de tentatives et de l’efficacité d’achèvement des tâches.
Q4 : Quels projets doivent prioritairement vérifier leur compatibilité ?
Principalement les catégories suivantes :
– **Les agents qui appellent plusieurs outils en parallèle** : c’est là que les positions de signature et l’ordre des réponses cassent le plus facilement ;
– **Les systèmes de conversation longue avec compression de contexte** : il faut gérer les problèmes de non-correspondance de préfixe ;
– **La génération de longs rapports et de longs blocs de code** : il faut mettre à jour le SDK et passer à v1beta1 ;
– **Les systèmes de traitement par lots qui comptent sur le cache explicite pour maîtriser les coûts** : il faut passer à une stratégie de cache implicite.
Q5 : Comment comparer rapidement ancien et nouveau modèle via l’API ?
La marche à suivre recommandée :
1. Rendez-vous sur APIYI apiyi.com, créez un compte et récupérez une clé API ;
2. Utilisez l’exemple compatible OpenAI de cet article, en mettant dans `model` l’ID de l’ancien puis du nouveau modèle ;
3. Comparez la qualité des sorties, la latence et la consommation de tokens sur un même lot de requêtes métier.
Une interface unifiée évite de maintenir séparément l’authentification et le code de requête pour deux modèles.
Q6 : Quelles sont les limitations connues de Hydrogen ?
La fiche modèle officielle signale : le modèle peut encore halluciner ; les niveaux de réflexion élevés augmentent nettement la durée et le coût, avec parfois des latences ou des dépassements de délai ; les connaissances s’arrêtent à mars 2026 ; l’indicateur de refus injustifié se dégrade de 5,57 points de pourcentage par rapport à 3.8 Flash. Par ailleurs, Hydrogen ne prend pas en charge la Live API ni le Fine-tuning. Parmi les premiers retours de la communauté, certains utilisateurs rapportent aussi une sur-exécution des tâches d’agent, mais cela relève de l’expérience individuelle.
Q7 : Comment limiter le risque financier au début de la migration ?
Je conseille de commencer par une base de référence avec `thinking_level= »medium »` défini explicitement, puis d’activer High uniquement pour les agents multi-étapes. Vérifiez en parallèle le taux de réussite du cache implicite et la part de tokens de réflexion. Si vous préférez la facturation à l’usage et un suivi centralisé de la consommation multi-modèles, vous pouvez aussi vous appuyer sur la facturation unifiée d’APIYI apiyi.com pour faire vos comparaisons.
Points clés à retenir pour la migration vers Hydrogen
- Bien plus qu’un changement de nom : passer l’ID du modèle à
gemini-4-hydrogenn’est que la première étape ; quatre autres éléments de configuration doivent être ajustés en parallèle. - Le SDK est un prérequis incontournable : la reprise des sorties longues exige Python >= 2.34.0 et JS >= 2.32.0 (Interactions API), avec la version v1beta1.
- Les paramètres de réflexion changent de génération :
thinking_budgetetMINIMALrenvoient un HTTP 400, et le niveau par défaut passe désormais à High. - Les paramètres d’échantillonnage ne fonctionnent plus : temperature, top_p et top_k sont ignorés ; penalty, les candidats multiples et les tours de préremplissage doivent être supprimés.
- Le cache repose sur la structure : le cache explicite disparaît ; un préfixe stable d’au moins 4 096 tokens est nécessaire pour toucher le cache implicite.
- La signature doit être complète : pour les appels parallèles, la signature n’apparaît que sur le premier functionCall, les réponses reviennent dans l’ordre, et l’historique compressé peut être défini sur DROP.
- Comparer avant de basculer : via APIYI apiyi.com, appelez l’ancien et le nouveau modèle avec la même clé API ; validez sur un faible volume de trafic avant la migration complète.
Résumé
L’essentiel pour passer de Gemini 3.8 Flash à Hydrogen :
- Couche de base : mettez à jour l’ID du modèle et le SDK, et comprenez le quota unifié de 1 048 576 tokens ainsi que la limite de sortie de 65 536 tokens par segment ;
- Couche des paramètres : remplacez
thinking_budgetparthinking_levelet nettoyez les champs d’échantillonnage et de génération devenus inopérants ; - Couche d’état : repensez la structure de l’invite pour toucher le cache implicite, et conservez
thought_signaturetel quel en le renvoyant.
Conseil : suivez la checklist de cet article point par point, écrivez des tests de régression pour les appels d’outils et les sorties longues, puis basculez le trafic réel vers le nouveau modèle. Pour comparer rapidement l’ancien et le nouveau modèle, nous recommandons APIYI apiyi.com : la plateforme propose une interface compatible OpenAI et des crédits de test gratuits pour les nouveaux utilisateurs.
📚 Références
- Guide de migration des développeurs Gemini 4 Hydrogen : changements officiels de compatibilité et liste de migration
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Description : source de première main pour la version minimale du SDK, les règles de signature,
prefix_mismatch_behavioret autres détails -
Prise en main de Gemini 4 et comparatif des différences de migration : sorties longues et versions de l’API
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
Description : explique que la fonctionnalité de continuation nécessite l’API v1beta1
-
Spécifications de Google Cloud Hydrogen : tableau du contexte, des paramètres et de la prise en charge des fonctionnalités
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Description : valeurs fixes de temperature, top_p, top_k et prise en charge du cache
-
Blog officiel Google : annonce du lancement de Gemini 4 Hydrogen
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Description : positionnement produit et données de comparaison officielles avec 3.8 Flash
-
Page tarifs de Google AI Studio : tarifs officiels de l’API
- Lien :
aistudio.google.com/docs/pricing -
Description : tarifs Standard, Batch, Flex, Priority et prix de cache hit
-
Évaluation indépendante Artificial Analysis : évaluation des quatre niveaux de réflexion
- Lien :
artificialanalysis.ai/models/gemini-4-hydrogen -
Description : indice d’intelligence tiers, durée et coût des évaluations
-
Fiche modèle Google DeepMind : capacités, limites et évaluation de sécurité
- Lien :
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Description : limites connues et évaluations officielles inter-modèles
Auteur : équipe technique APIYI
Échanges techniques : si vous rencontrez des problèmes de compatibilité lors de la migration, n’hésitez pas à échanger avec nous via le site officiel APIYI. Pour davantage de ressources d’intégration, consultez le centre de documentation docs.apiyi.com