Nota do autor: Migrar do Gemini 3.8 Flash para o Hydrogen exige ajustar, ao mesmo tempo, o SDK e o contexto, os parâmetros de pensamento (thinking), a configuração de amostragem, o cache e o gerenciamento de assinaturas em chamadas de ferramentas com múltiplas rodadas.
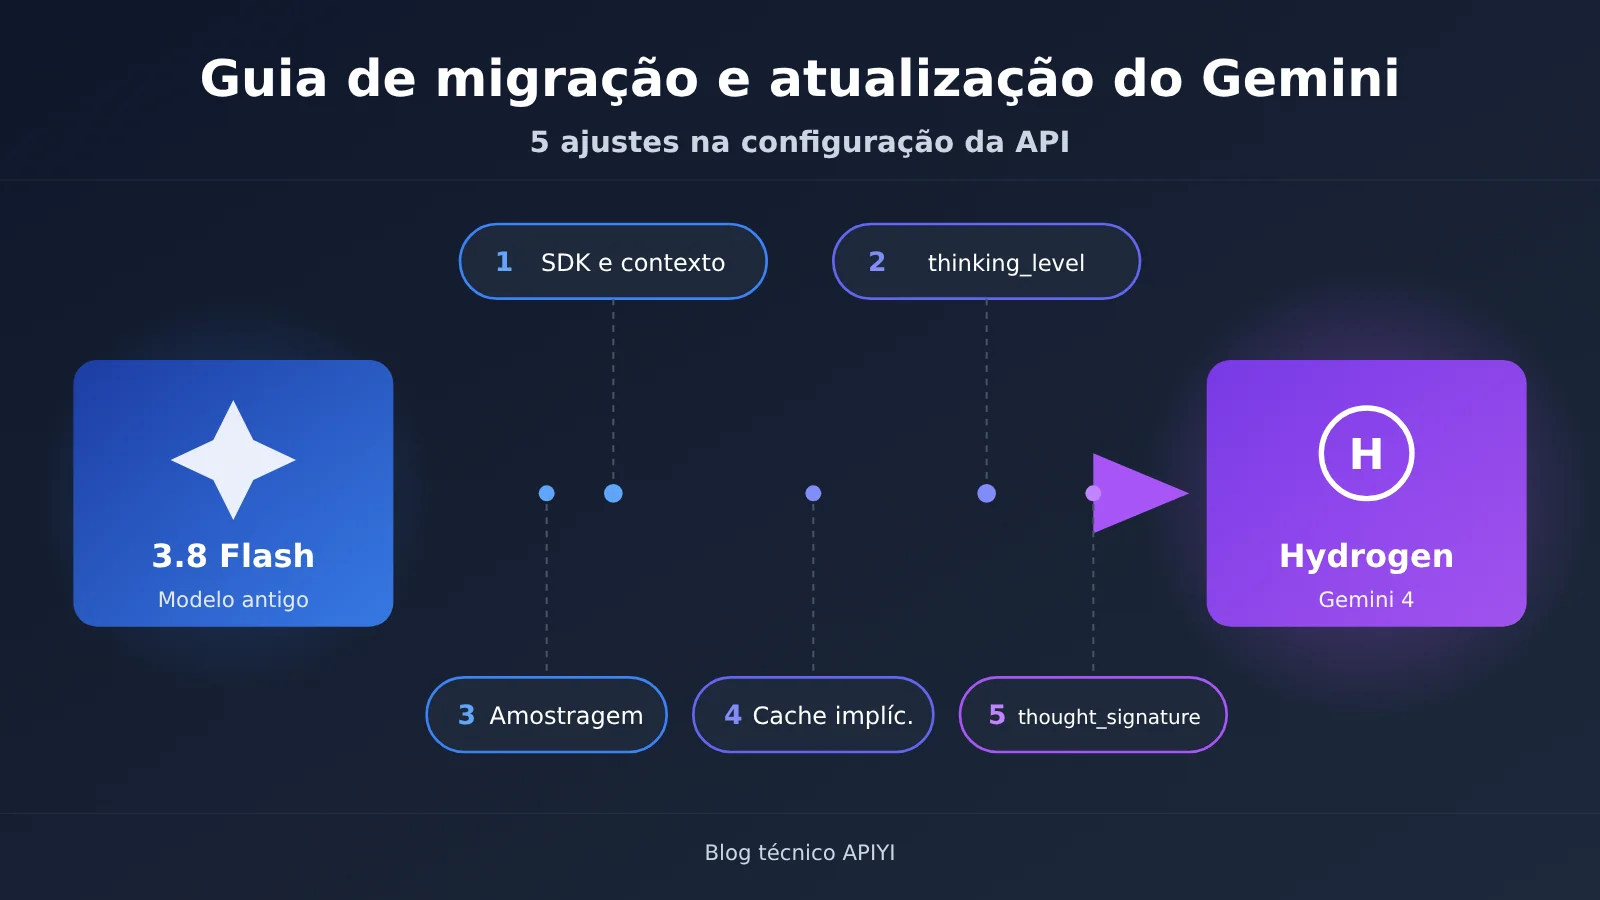
O Google lançou oficialmente o Gemini 4 Hydrogen em 12 de novembro de 2026, com o ID de modelo de API gemini-4-hydrogen, posicionado para programação do dia a dia e execução de agentes de IA. A primeira reação de muitas equipes é simplesmente substituir o nome do modelo no código e colocar em produção. O resultado são erros HTTP 400, parâmetros que não fazem efeito, falhas em chamadas de ferramentas com múltiplas rodadas e saídas longas truncadas. Este artigo reúne os 5 ajustes de configuração da API que são obrigatórios ao atualizar do Gemini 3.8 Flash para o Hydrogen, e cada item é apresentado na ordem “comportamento antigo → novo comportamento → como alterar → impacto típico”.
Não se trata de uma repetição do anúncio de lançamento. Os nomes de parâmetros, valores válidos, versões de SDK e tipos de erro citados aqui vêm do guia oficial de migração do Google Cloud e da documentação de especificação do modelo. Avaliações de terceiros e feedback da comunidade terão suas fontes indicadas separadamente.
Valor principal: depois de ler este artigo, você pode usar uma lista de verificação para ajustar, item por item, o código atual de chamadas do Gemini 3.8 Flash e migrar com tranquilidade as operações de agentes e de processamento em lote para o Hydrogen.
5 termos essenciais para migrar para Hydrogen
Antes de mexer no código, vale alinhar alguns conceitos que aparecem o tempo todo no guia de migração:
- thinking_level: parâmetro de nível de raciocínio que controla a profundidade do pensamento do modelo. Hydrogen o usa no lugar do antigo
thinking_budget; os níveis válidos são Low, Medium, High e XHigh. - thought_signature: assinatura de associação do raciocínio retornada pelo modelo na resposta. Em conversas de múltiplos turnos e chamadas de ferramentas, ela precisa ser preservada e reenviada exatamente como está; caso contrário, o modelo não consegue retomar o estado de raciocínio anterior.
- continuation_token: marcador de continuação usado para emendar a próxima parte de uma saída longa. Quando um segmento de saída atinge o limite, dá para continuar a geração com ele.
- cache implícito: a plataforma reutiliza automaticamente prefixos de entrada que atendam aos critérios; a parte que aproveita o cache é cobrada pelo preço de cache, sem o desenvolvedor precisar criar um objeto de cache manualmente.
- janela de contexto: faixa de informação que o modelo consegue processar em uma única vez. No Hydrogen, entrada, saída, raciocínio e chamadas de ferramentas ocupam juntos uma cota unificada de 1,048,576 tokens.
1. Por que atualizar para Hydrogen não se resume a trocar o ID do modelo
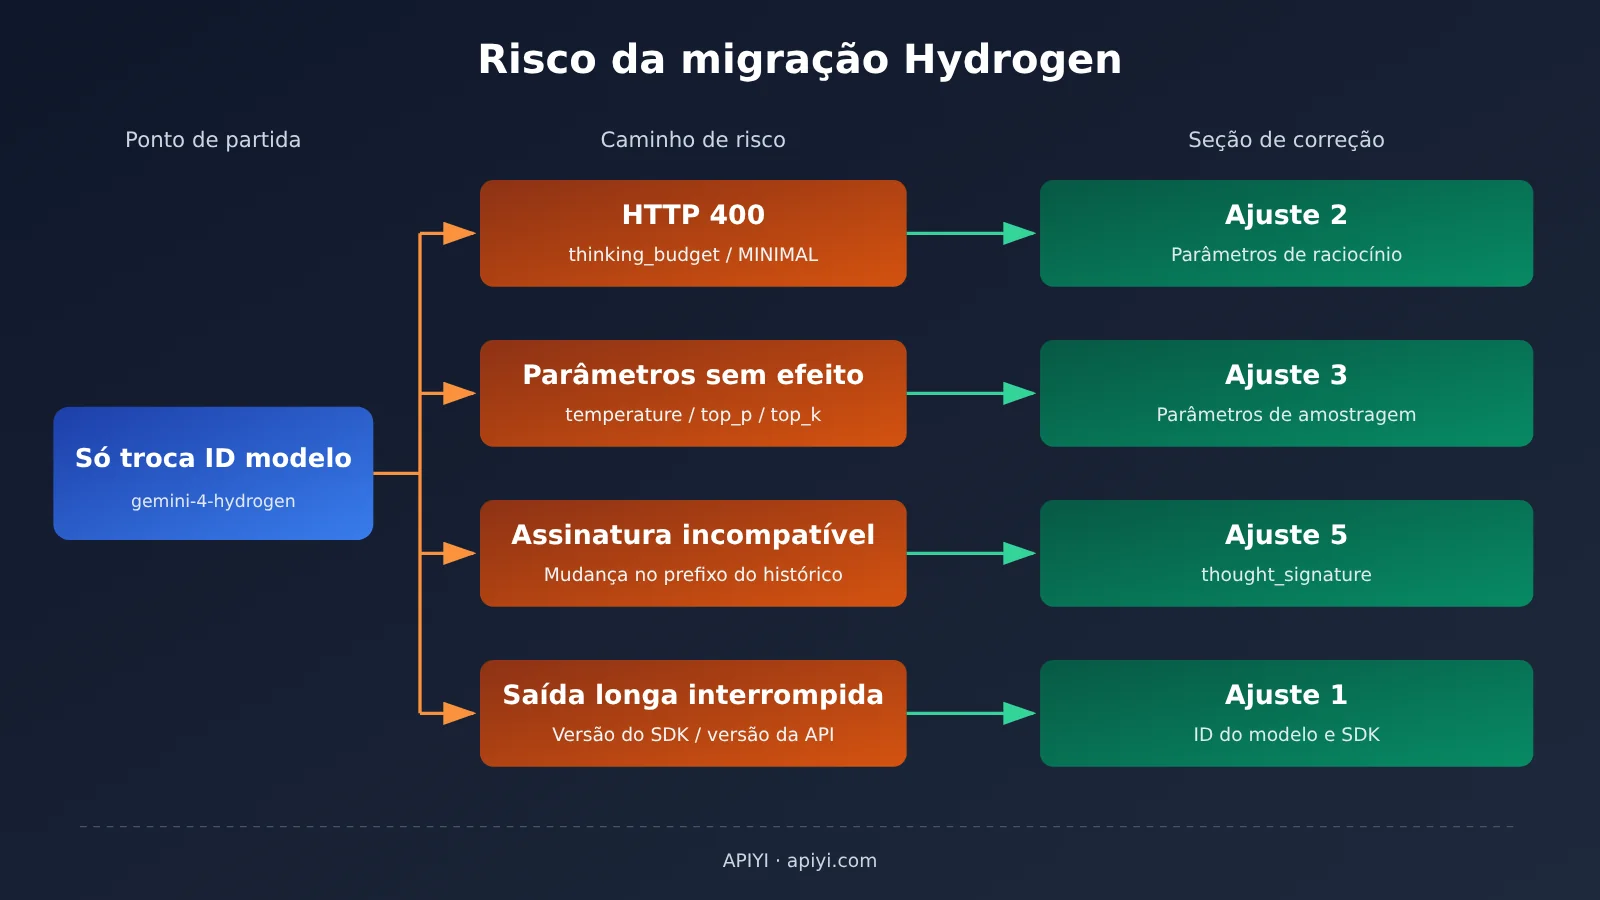
Gemini 3.8 Flash e Hydrogen, embora pertençam à mesma família Gemini, têm vários comportamentos de API incompatíveis. Segundo o guia oficial de migração, thinking_budget e o nível de raciocínio MINIMAL não são suportados no Hydrogen — a requisição retorna HTTP 400 direto; já parâmetros de amostragem como temperature, top_p e top_k não dão erro, apenas são ignorados silenciosamente. O primeiro tipo de problema aparece já na fase de testes; o segundo pode fazer você achar que “os parâmetros ainda estão valendo”.
Há ainda dois riscos mais sutis. Um é que o gerenciamento de assinaturas em chamadas de ferramentas com múltiplos turnos é mais rígido: se o histórico da conversa for comprimido ou cortado, a assinatura pode não corresponder ao prefixo e disparar HTTP 400. Outro é que o nível padrão de raciocínio subiu de Medium para High; sem definir isso explicitamente, a mesma requisição consome mais tokens de raciocínio e tem latência maior. A tabela abaixo resume os cinco ajustes:
| Item de ajuste | Comportamento anterior (3.8 Flash) | Novo comportamento (Hydrogen) | Consequência de não alterar |
|---|---|---|---|
| ID do modelo, SDK e contexto | ID de modelo antigo, SDK antigo ainda pode ser usado | gemini-4-hydrogen, continuação de saídas longas exige uma versão mínima do SDK |
Saídas longas interrompidas; continuação indisponível |
| Parâmetros de raciocínio | thinking_budget, padrão Medium |
thinking_level, padrão High |
HTTP 400, ou aumento de custo e latência |
| Parâmetros de amostragem e geração | temperature, top_p, top_k etc. ajustáveis |
Valores fixos; personalizações são ignoradas; alguns campos precisam ser removidos | Estilo de saída fora de controle; algumas requisições falham na validação |
| Cache | Suporta cache explícito via cached_content |
Só suporta cache implícito, com limite mínimo de 4,096 tokens | Referências de cache deixam de funcionar; estimativa de custo imprecisa |
thought_signature |
Regras de assinatura relativamente flexíveis | Regras rígidas para chamadas paralelas e mudanças de prefixo | Erros em agentes de múltiplos turnos ou quebra do raciocínio |
2. Ajuste 1: ID do modelo, versão do SDK e limites de contexto do Hydrogen
Comportamento antigo → novo comportamento: na era do 3.8 Flash, a maioria dos projetos não era sensível à versão do SDK. Depois da migração para o Hydrogen, o ID do modelo precisa ser alterado para gemini-4-hydrogen; se você precisar de saídas extremamente longas, a versão do SDK passa a ser uma condição obrigatória. O guia oficial de migração do Google informa as seguintes versões mínimas:
| Linguagem de desenvolvimento | Continuação automática do GenerateContent | Continuação automática da Interactions API |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | Não listado separadamente pela documentação oficial | >= 1.77.0 |
| Java | Não listado separadamente pela documentação oficial | >= 1.80.0 |
Como ajustar contexto e saídas longas no Hydrogen
Os 1.048.576 tokens do Hydrogen formam uma cota unificada: entrada, contexto histórico, tokens de raciocínio, tokens relacionados a chamadas de ferramentas e saída final são todos descontados desse mesmo pool. Ou seja, não dá para inserir 1 milhão de tokens e depois gerar outros 1 milhão de tokens adicionais. Para agentes que analisam documentos longos, é preciso reservar proativamente espaço para raciocínio e chamadas de ferramentas no lado da entrada.
O limite de uma geração em primeiro plano em um único trecho costuma ser de 65.536 tokens. Quando esse comprimento é ultrapassado, há três opções: usar a continuação automática de um SDK compatível, definir background=true na Interactions API para fazer uma geração longa em segundo plano ou manter manualmente o continuation_token e concatenar os trechos. Vale destacar que a documentação oficial de introdução explica que a continuação de saídas longas atualmente exige a API v1beta1; a v1 da Agent Platform não oferece suporte a esse recurso.
Impacto típico: negócios que geram relatórios longos e arquivos de código extensos em lote são os que mais tendem a esbarrar nisso. A recomendação é atualizar o SDK primeiro, depois mudar a versão da API para v1beta1 e, por fim, fazer um teste de regressão com uma requisição que ultrapasse 65.536 tokens.
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
3. Ajuste 2: o thinking_budget do Hydrogen passa a ser thinking_level
Comportamento antigo: o 3.8 Flash usava thinking_budget para controlar o tamanho do raciocínio pelo número de tokens, e ainda permitia escolher o nível MINIMAL, com Medium como padrão.
Novo comportamento: o Hydrogen só aceita thinking_level, com quatro valores válidos — Low, Medium, High e XHigh — e o padrão é High. Continuar enviando thinking_budget ou MINIMAL retorna HTTP 400. Os usos recomendados oficialmente são: Low para classificação, Medium para programação do dia a dia, High para agentes de múltiplas etapas e XHigh para raciocínio profundo e complexo.
A instituição independente Artificial Analysis concluiu em 12 de novembro uma avaliação independente dos quatro níveis (Intelligence Index v5.0.1), que ajuda a entender as diferenças entre eles. Os tempos e custos da tabela abaixo são médias das tarefas padronizadas de avaliação e não representam o gasto real de um usuário comum em uma única conversa:
| Nível de raciocínio | Cenário recomendado oficialmente | Índice de Inteligência (AA) | Tempo médio de avaliação | Custo médio de avaliação |
|---|---|---|---|---|
| Low | Classificação, extração simples | 27 | 1.3 minutos | $0.29 |
| Medium | Programação do dia a dia | 41 | 3.7 minutos | $0.80 |
| High (padrão) | Agentes de múltiplas etapas | 51 | 8.3 minutos | $1.87 |
| XHigh | Raciocínio profundo e complexo | 54 | 13.5 minutos | $3.16 |
Olhando os números, High fica 10 pontos acima de Medium, enquanto XHigh soma apenas 3 pontos a mais que High — e o custo de avaliação salta de US$ 1.87 para US$ 3.16. Isso mostra que o nível mais alto nem sempre é o mais vantajoso, e que a diferença de capacidade de um mesmo nome de modelo entre os níveis também é grande.
Exemplo de alteração do thinking_level no Hydrogen
Os exemplos abaixo usam a sintaxe oficial do Google Gen AI SDK. Para a forma de escrita (maiúsculas ou minúsculas) dos valores de enumeração, considere a definição de tipos da versão do SDK instalada:
from google import genai
from google.genai import types

client = genai.Client()

# Forma antiga (3.8 Flash): retorna HTTP 400 no Hydrogen
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# Forma nova: escolha Medium para tarefas de programação do dia a dia
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# Agentes de múltiplas etapas usam High (que também é o padrão; recomenda-se declarar explicitamente)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修复这个函数中的空指针问题:...",
    config=coding_config,
)
print(resp.text)
Impacto típico: como os tokens de raciocínio são cobrados pelo preço de saída, projetos que não definem o nível explicitamente caem automaticamente em High após a migração, e tanto a fatura quanto a latência aumentam. A recomendação é mapear as antigas faixas de thinking_budget para níveis: orçamentos menores correspondem a Low ou Medium, e orçamentos maiores a High.
4. Ajuste 3: limpar os parâmetros de geração obsoletos no Hydrogen
Comportamento anterior: o 3.8 Flash permitia ajustar a aleatoriedade da saída com temperature, top_p e top_k, além de aceitar parâmetros de penalidade e saída com múltiplos candidatos.
Novo comportamento: a temperatura padrão do Hydrogen é 1.0 e valores personalizados não têm efeito; top_p fica fixo em 0.95 e top_k fica fixo em 64. Esses três parâmetros são ignorados quando enviados. A lista oficial de migração também exige tratar os seguintes campos:
| Campo ou comportamento | Requisito de migração do Hydrogen | Dica de solução de problemas |
|---|---|---|
| temperature / top_p / top_k | Valores personalizados são ignorados | Não gera erro; é preciso controlar o estilo pelo comando |
| frequency_penalty / presence_penalty | Remover | Baseie-se nos erros reais; excluir todos é o caminho mais seguro |
| candidate_count > 1 | Remover a configuração de múltiplos candidatos | Quando precisar de diversidade, faça várias requisições |
| turnos de histórico do model preenchidos previamente | Remover | Não dá mais para usar a tática de “iniciar a resposta pelo model” para orientar o formato |
| cached_content | Não referenciar mais o cache explícito | Veja o Ajuste 4 |
| thinking_budget | Passar a usar um thinking_level válido |
Retorna HTTP 400 |
A documentação oficial alerta especialmente que alguns parâmetros antigos apenas são ignorados, enquanto outros fazem a validação da requisição falhar. Por isso, a lógica de solução de problemas não pode ser a mesma para todos os casos: ao receber 400, verifique primeiro thinking_budget, MINIMAL e os campos que precisam ser removidos; se o estilo da saída não corresponder ao esperado, verifique se o projeto ainda depende do parâmetro de temperatura.
Configuração de requisição simplificada do Hydrogen
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # Conteúdo estável primeiro, favorece o cache implícito
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # A saída estruturada ainda é suportada
    max_output_tokens=8192,
)
Impacto típico: projetos que antes dependiam de temperatura baixa para garantir saída JSON estável devem passar a usar o recurso de saída estruturada; projetos que dependiam de turnos do model preenchidos previamente para controlar o formato precisam incluir os requisitos de formato no comando de sistema.
5. Ajuste 4: cache explícito do Hydrogen passa a ser cache implícito
Comportamento antigo: No 3.8 Flash, o desenvolvedor podia primeiro criar um objeto de cache e depois referenciá-lo na requisição por meio de cached_content="cachedContents/xxx".
Novo comportamento: O Hydrogen não oferece suporte a cache de contexto explícito, apenas a cache implícito, com o mecanismo de cache implícito persistente habilitado por padrão. O comprimento mínimo do prefixo de cache caiu dos 6,144 tokens do 3.8 Flash para 4,096 tokens, então comandos de sistema públicos mais curtos e materiais de conhecimento fixos também passam a ter mais chance de acertar o cache.
Como modificar: Remova todas as chamadas caches.create e as referências a cached_content e, em vez disso, otimize a ordem de montagem dos comandos. O Google recomenda colocar o conteúdo público estável no início da entrada e a pergunta do usuário, que muda a cada vez, no final:
- Comando de sistema e definição de papel (quase não muda)
- Base de conhecimento pública, documentação de API, padrões de código (mudança pouco frequente)
- Histórico da conversa (acrescentado a cada turno)
- Pergunta atual do usuário (muda a cada vez)
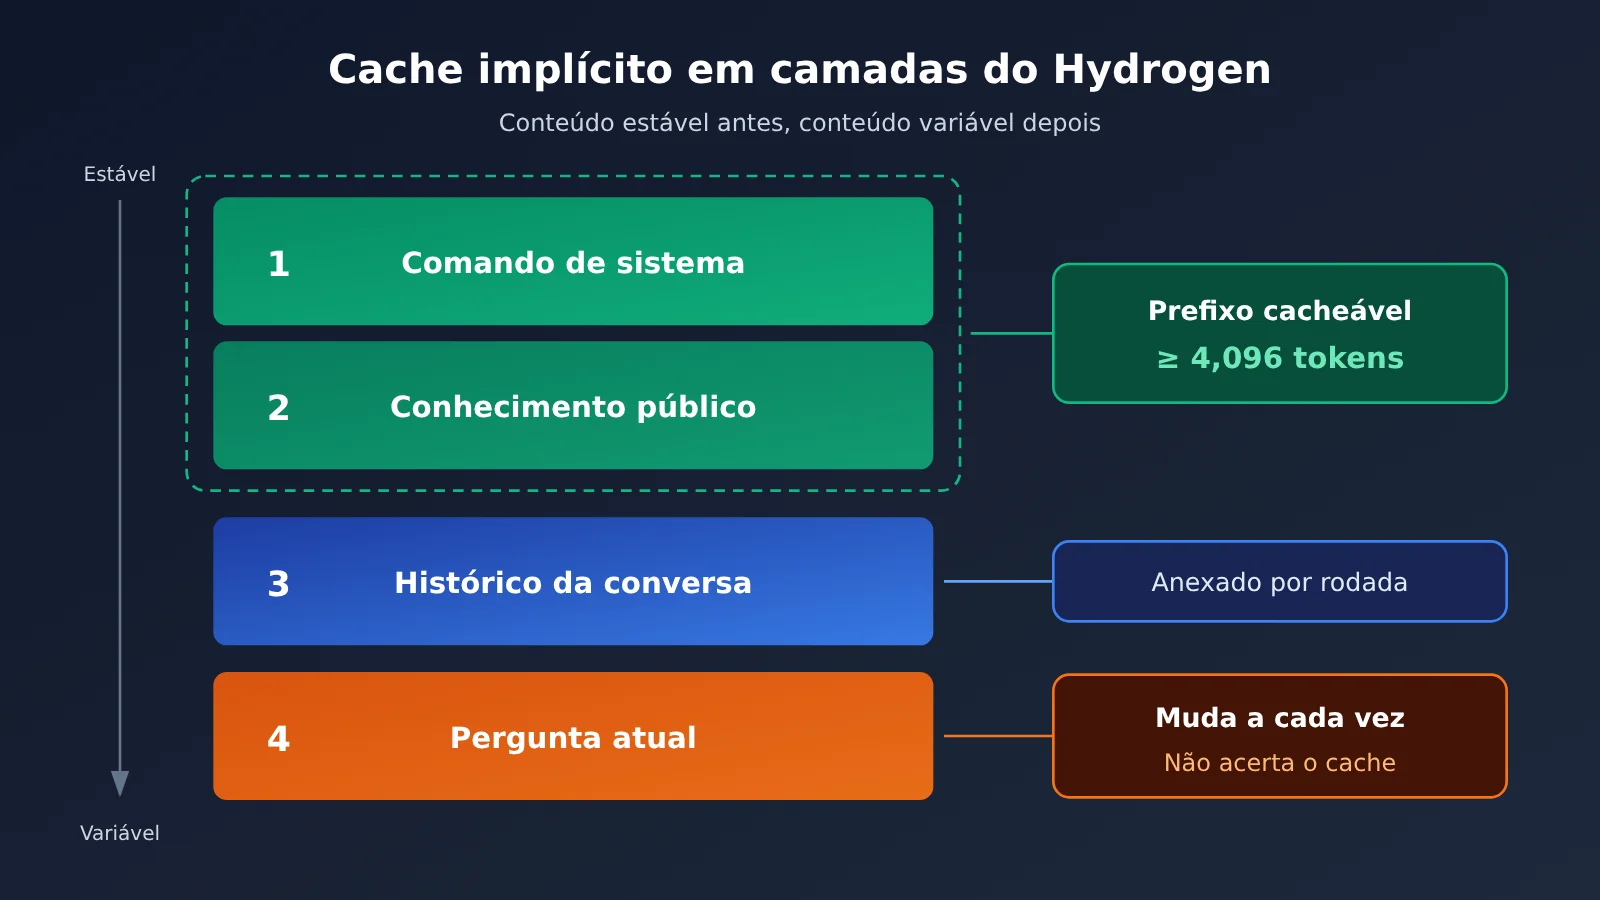
Impacto típico: Em relação ao preço, segundo a página oficial de preços do Google AI Studio (verificação em 13 de novembro de 2026, em dólares por milhão de tokens), a entrada com acerto de cache implícito do Hydrogen em chamadas padrão custa $0.075, e nos modos Batch e Flex custa $0.0375, bem abaixo dos $1.50 da entrada padrão. Se você inserir variáveis dinâmicas (timestamp, ID do usuário etc.) no começo dos comandos, o prefixo será diferente a cada vez e o cache não vai acertar.
6. Ajuste 5: manter corretamente o thought_signature no Hydrogen
Comportamento anterior: no 3.8 Flash, muitos frameworks de Agent reconstruíam por conta própria o histórico da conversa, mantendo apenas o texto e os resultados das chamadas de ferramenta. A perda da assinatura muitas vezes não tinha impacto perceptível.
Novo comportamento: as conversas de múltiplas rodadas no Hydrogen precisam preservar as assinaturas de todas as partes relevantes anteriores, incluindo a assinatura carregada pela parte de texto final. O guia oficial de migração define o seguinte para chamadas paralelas de ferramentas:
- Vários
functionCallparalelos devem estar na mesma mensagem do modelo; - O
thought_signaturedeve ser colocado apenas na primeira partefunctionCallparalela; - Os
functionResponsesubsequentes devem ser retornados de acordo com o ID, o nome e a ordem da chamada correspondente; - Ao reutilizar uma assinatura no mesmo modelo, se o prefixo do histórico mudar, por padrão pode ser retornado HTTP 400.
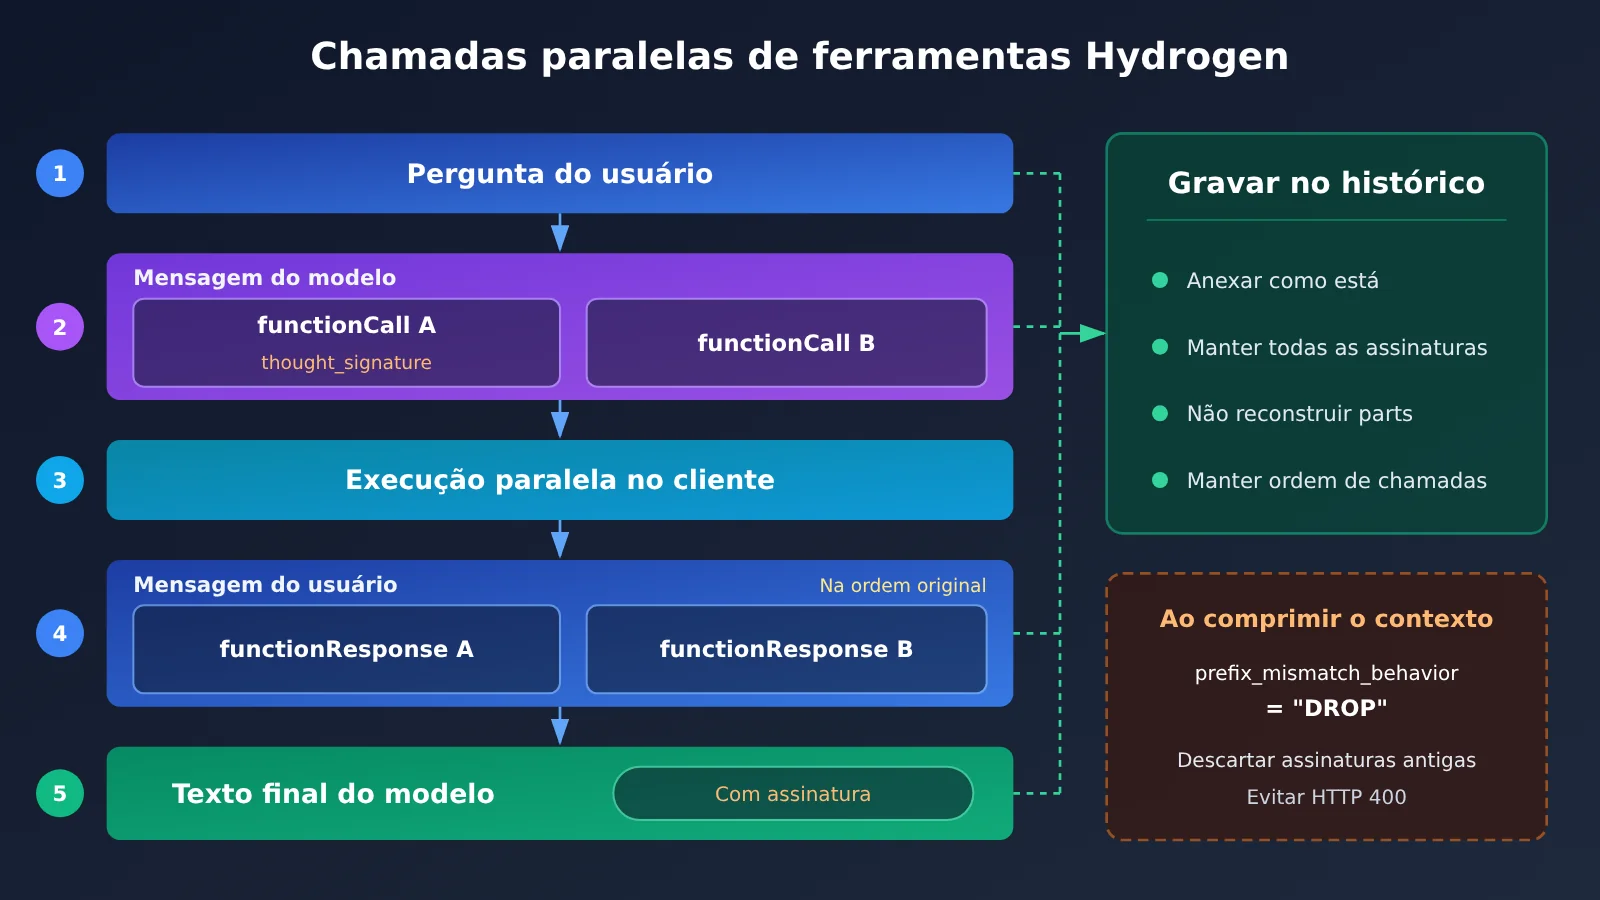
Método de alteração para manutenção da assinatura no Hydrogen
A abordagem mais segura é não reconstruir manualmente as parts, mas anexar ao histórico o objeto content retornado pelo modelo como está:
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # manter como está; a assinatura é preservada junto

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # manter a mesma ordem dos functionCall
]
history.append(types.Content(role="user", parts=responses))
Para Agents que compactam ou recortam o histórico (por exemplo, janela deslizante, substituição por resumo), o prefixo do histórico necessariamente muda. Nesse caso, pode-se configurar prefix_mismatch_behavior="DROP" conforme o guia de migração, para que o modelo descarte a assinatura antiga em vez de retornar erro quando o prefixo não corresponder. A posição exata desse campo na requisição deve ser consultada no guia oficial de migração.
Impacto típico: os mais afetados são Agent Harness desenvolvidos internamente, assistentes de programação que pesquisam arquivos em paralelo e bots de conversas longas com compactação de contexto; recomenda-se escrever testes de integração dedicados ao retorno da assinatura.
7. Checklist de migração do Hydrogen e exemplo mínimo de chamada
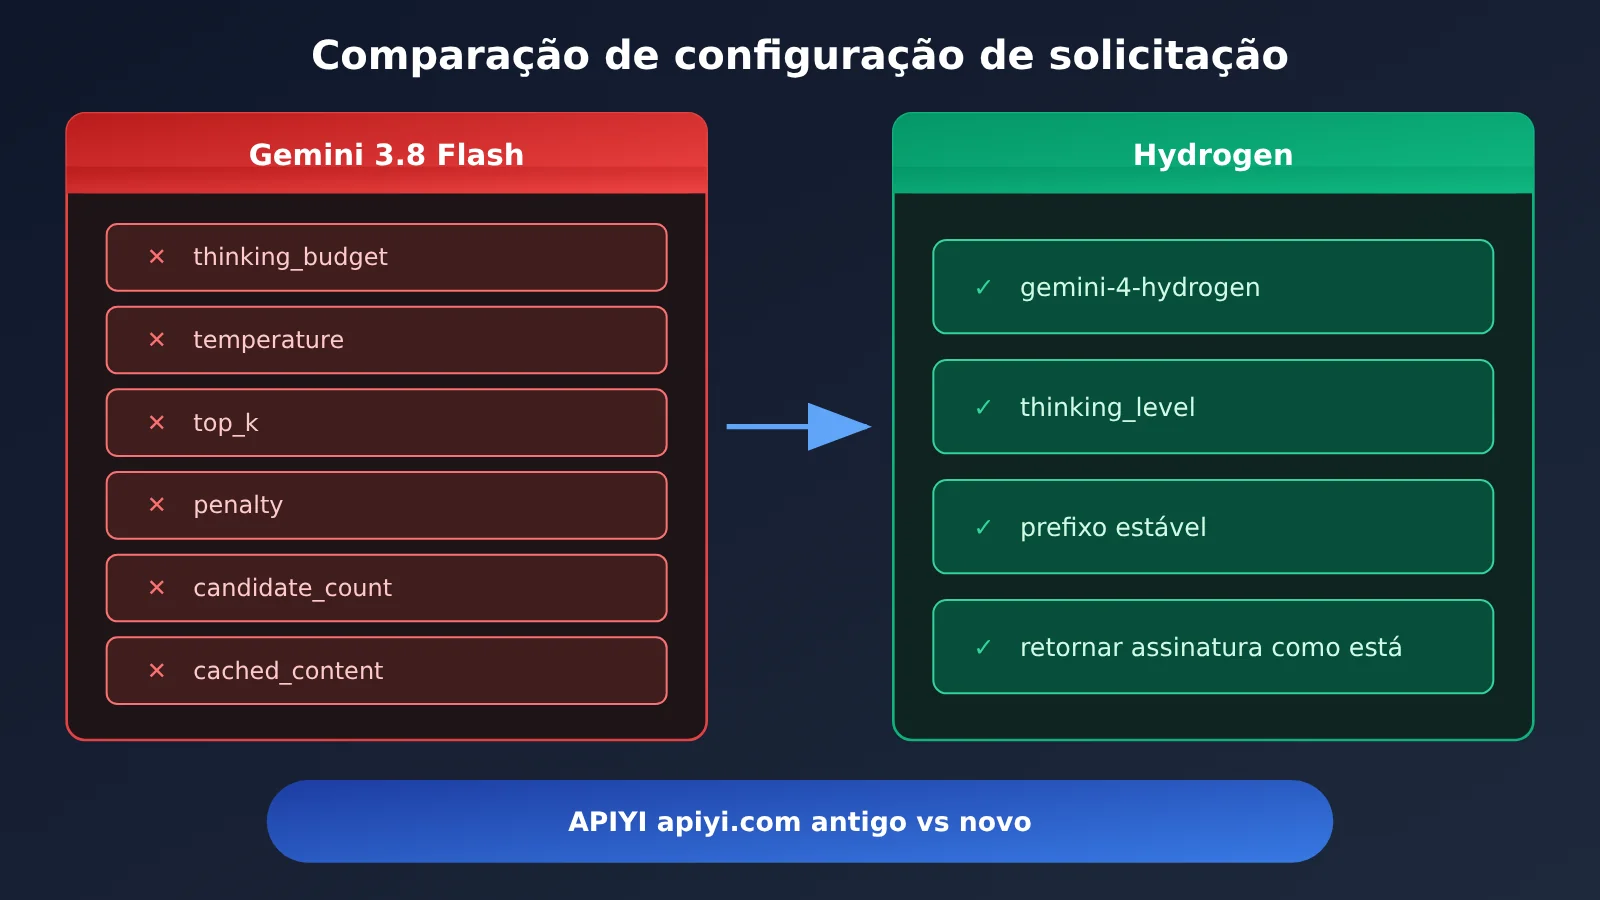
| Item de verificação | Antes da migração (3.8 Flash) | Depois da migração (Hydrogen) | Concluído |
|---|---|---|---|
| ID do modelo | ID do modelo antigo | gemini-4-hydrogen |
☐ |
| SDK | Qualquer versão | Python >= 2.34.0, JS >= 2.32.0 (Interactions) | ☐ |
| Versão da API | v1 | Use v1beta1 quando precisar de continuação para saídas longas | ☐ |
| Parâmetros de raciocínio | thinking_budget / MINIMAL | Definir thinking_level explicitamente | ☐ |
| Parâmetros de geração | temperature e outros ajustáveis | Remover penalty, candidate_count e turnos de preenchimento prévio | ☐ |
| Cache | cached_content | Conteúdo estável no início, prefixo ≥ 4,096 tokens | ☐ |
| Chamadas de ferramentas | Reconstruir o histórico por conta própria | Preservar a assinatura como está; respostas paralelas retornadas em ordem | ☐ |
| Tratamento de erros | Retentativa genérica | Distinguir erros de validação HTTP 400 de falhas ignoradas silenciosamente | ☐ |
Validação rápida via interface compatível com OpenAI
Se o código de negócio da equipe é baseado no SDK da OpenAI, vale primeiro validar rapidamente a qualidade das saídas do Hydrogen pela interface compatível — e só depois decidir se faz sentido migrar para o SDK nativo. Quais modelos estão disponíveis e quais parâmetros podem ser repassados deve ser conferido na lista de modelos e na documentação da plataforma:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
Ver o código de implementação completo (com chamada de ferramentas e preservação do histórico)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada, facilita comparar modelos novos e antigos
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # O prompt de sistema estável fica no início, o que favorece o acerto do cache implícito
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # A mensagem assistant inteira volta ao histórico como está, sem recortar campos
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # Retorna os resultados um a um, na ordem original dos tool_calls
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 Dica para começar rápido: durante a migração, vale manter o 3.8 Flash como grupo de controle e disparar o mesmo lote de requisições reais nos dois modelos ao mesmo tempo. Com a APIYI apiyi.com dá para chamar os dois modelos com uma única chave API, e novos usuários têm cota gratuita de teste — ideal para fazer uma comparação com pouco tráfego antes de trocar tudo.
Perguntas frequentes (FAQ)
Q1: O que é o Gemini 4 Hydrogen?
Gemini 4 Hydrogen é um modelo lançado pelo Google DeepMind em 12 de novembro de 2026, com ID de API `gemini-4-hydrogen`. Ele é adaptado a partir do Gemini 4 Carbon e prioriza velocidade, programação do dia a dia, invocação de múltiplas ferramentas e execução de tarefas automatizadas. Pode ser usado de forma independente ou atuar como executor ou validador em sistemas multi-modelo.
Q2: Qual é a diferença de capacidade entre o Hydrogen e o Gemini 3.8 Flash?
De acordo com os dados publicados oficialmente pelo Google, o Hydrogen atinge 57,0% no Terminal-Bench 4.1, enquanto o 3.8 Flash atinge 18,2%; nas mesmas condições de teste, a velocidade de conclusão de tarefas é cerca de 2,5 vezes maior. Esses são resultados de testes oficiais ou de parceiros e não podem ser extrapolados diretamente para todas as tarefas reais.
Q3: O custo diminui após migrar para o Hydrogen?
Não necessariamente. Segundo a página oficial de preços do Google AI Studio (verificada em 13 de novembro de 2026), a invocação padrão do Hydrogen custa US$ 1,50 de entrada e US$ 7,50 de saída (dólares por milhão de tokens), enquanto o 3.8 Flash custa US$ 0,75 / US$ 3,75 até 31 de dezembro de 2026 e passa a US$ 1,50 / US$ 7,50 a partir de 1º de janeiro de 2027. O preço unitário atual é o dobro do 3.8 Flash, e o custo total depende do comprimento do raciocínio, do número de tentativas e da eficiência na conclusão das tarefas.
Q4: Quais projetos precisam priorizar a verificação de compatibilidade?
Principalmente as seguintes categorias:
– **Agentes que invocam múltiplas ferramentas em paralelo**: a posição da assinatura e a ordem das respostas são os pontos mais propensos a erro;
– **Sistemas de sessões longas com compactação de contexto**: é preciso lidar com problemas de incompatibilidade de prefixo;
– **Geração de relatórios longos e códigos extensos**: é necessário atualizar o SDK e mudar para v1beta1;
– **Sistemas de processamento em lote que dependem de controle explícito de cache para reduzir custos**: é preciso mudar para a estratégia de cache implícito.
Q5: Como comparar rapidamente os modelos antigo e novo via API?
A abordagem recomendada é:
1. Acessar APIYI apiyi.com, registrar uma conta e obter a chave API;
2. Usar o exemplo compatível com OpenAI deste artigo, definindo `model` como o ID do modelo antigo e do novo, respectivamente;
3. Comparar qualidade de saída, latência e consumo de tokens usando o mesmo lote de requisições de negócio.
Uma interface unificada evita manter códigos separados de autenticação e requisição para os dois modelos.
Q6: Quais são as limitações conhecidas do Hydrogen?
O cartão oficial do modelo aponta: ainda pode gerar alucinações; os níveis altos de raciocínio aumentam significativamente o tempo e o custo, com eventuais atrasos ou timeouts; o conhecimento tem corte em março de 2026; em comparação com o 3.8 Flash, o indicador de recusas injustificadas piorou 5,57 pontos percentuais. Além disso, o Hydrogen não oferece suporte à Live API nem a fine-tuning. Em feedbacks iniciais da comunidade, alguns usuários também relataram execução excessiva em tarefas de agentes, o que é uma experiência individual.
Q7: Como controlar o risco de custos no início da migração?
Recomenda-se primeiro definir explicitamente `thinking_level=”medium”` para rodar a linha de base e depois ativar o nível High apenas para agentes de múltiplas etapas; ao mesmo tempo, verificar a taxa de acerto do cache implícito e a proporção de tokens de raciocínio. Se você quiser cobrança por uso e visualizar centralizadamente o consumo de vários modelos, também pode usar o faturamento unificado do APIYI apiyi.com para comparação.
Pontos-chave da migração para o Hydrogen
- Não é só trocar de nome: alterar o ID do modelo para
gemini-4-hydrogené apenas o primeiro passo; outras quatro configurações precisam ser ajustadas em sincronia. - O SDK é um requisito obrigatório: a continuação de saídas longas exige Python >= 2.34.0, JS >= 2.32.0 (Interactions API) e o uso de v1beta1.
- Os parâmetros de raciocínio mudaram de geração:
thinking_budgeteMINIMALretornam HTTP 400, e o nível padrão agora é High. - Parâmetros de amostragem ficam sem efeito: temperature, top_p e top_k são ignorados; penalty, múltiplas candidatas e turnos de preenchimento precisam ser removidos.
- O cache depende da estrutura: o cache explícito foi removido; um prefixo estável precisa atingir 4.096 tokens para acertar o cache implícito.
- A assinatura deve estar completa: em chamadas paralelas, a assinatura fica apenas no primeiro functionCall; as respostas são retornadas em ordem e o histórico compactado pode ser definido como DROP.
- Compare antes de alternar: use a mesma chave para chamar os modelos antigo e novo via APIYI apiyi.com, valide com pouco tráfego e só depois migre tudo.
Resumo
Pontos-chave para atualizar do Gemini 3.8 Flash para o Hydrogen:
- Camada base: atualize o ID do modelo e o SDK e entenda a cota unificada de 1.048.576 tokens e o limite de saída de 65.536 tokens por segmento;
- Camada de parâmetros: substitua
thinking_budgetporthinking_levele remova os campos de amostragem e geração que não funcionam mais; - Camada de estado: redesenhe a estrutura do comando para acertar o cache implícito, preservando e devolvendo o
thought_signatureexatamente como veio.
Recomendo seguir o checklist deste artigo item por item, escrever testes de regressão para chamadas de ferramentas e saídas longas, e só depois redirecionar o tráfego real para o novo modelo. Vale a pena usar a APIYI apiyi.com para comparar rapidamente os resultados dos modelos antigo e novo — a plataforma oferece uma interface compatível com OpenAI e cota gratuita de teste para novos usuários.
📚 Materiais de referência
- Guia de migração para desenvolvedores do Gemini 4 Hydrogen: mudanças oficiais de compatibilidade e checklist de migração
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Descrição: fonte primária para detalhes como versão mínima do SDK, regras de assinatura,
prefix_mismatch_behavioretc. -
Introdução ao Gemini 4 e comparativo das diferenças de migração: saídas longas e notas sobre a versão da API
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
Descrição: explica que o recurso de continuação de texto exige a API v1beta1
-
Especificações do modelo Google Cloud Hydrogen: tabela de contexto, parâmetros e suporte a recursos
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Descrição: valores fixos de temperatura,
top_p,top_ke situação do suporte a cache -
Blog oficial do Google: anúncio de lançamento do Gemini 4 Hydrogen
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descrição: posicionamento do produto e dados oficiais de comparação com o 3.8 Flash
-
Página de preços do Google AI Studio: preços oficiais da API
- Link:
aistudio.google.com/docs/pricing -
Descrição: preços padrão, Batch, Flex, Priority e acertos de cache
-
Avaliação independente da Artificial Analysis: avaliação com quatro níveis de pensamento
- Link:
artificialanalysis.ai/models/gemini-4-hydrogen -
Descrição: índice de inteligência de terceiros, dados de tempo e custo da avaliação
-
Model card do Google DeepMind: capacidades, limitações e avaliação de segurança
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Descrição: limitações conhecidas e avaliação oficial entre modelos
Autor: Equipe técnica da APIYI
Contato técnico: Se você encontrar problemas de compatibilidade durante a migração, é só falar com a gente pelo site oficial da APIYI. Para mais materiais de integração, consulte a central de documentação em docs.apiyi.com