
Ringkasan uji penulisan GPT, Claude, Kimi: kesimpulan dulu
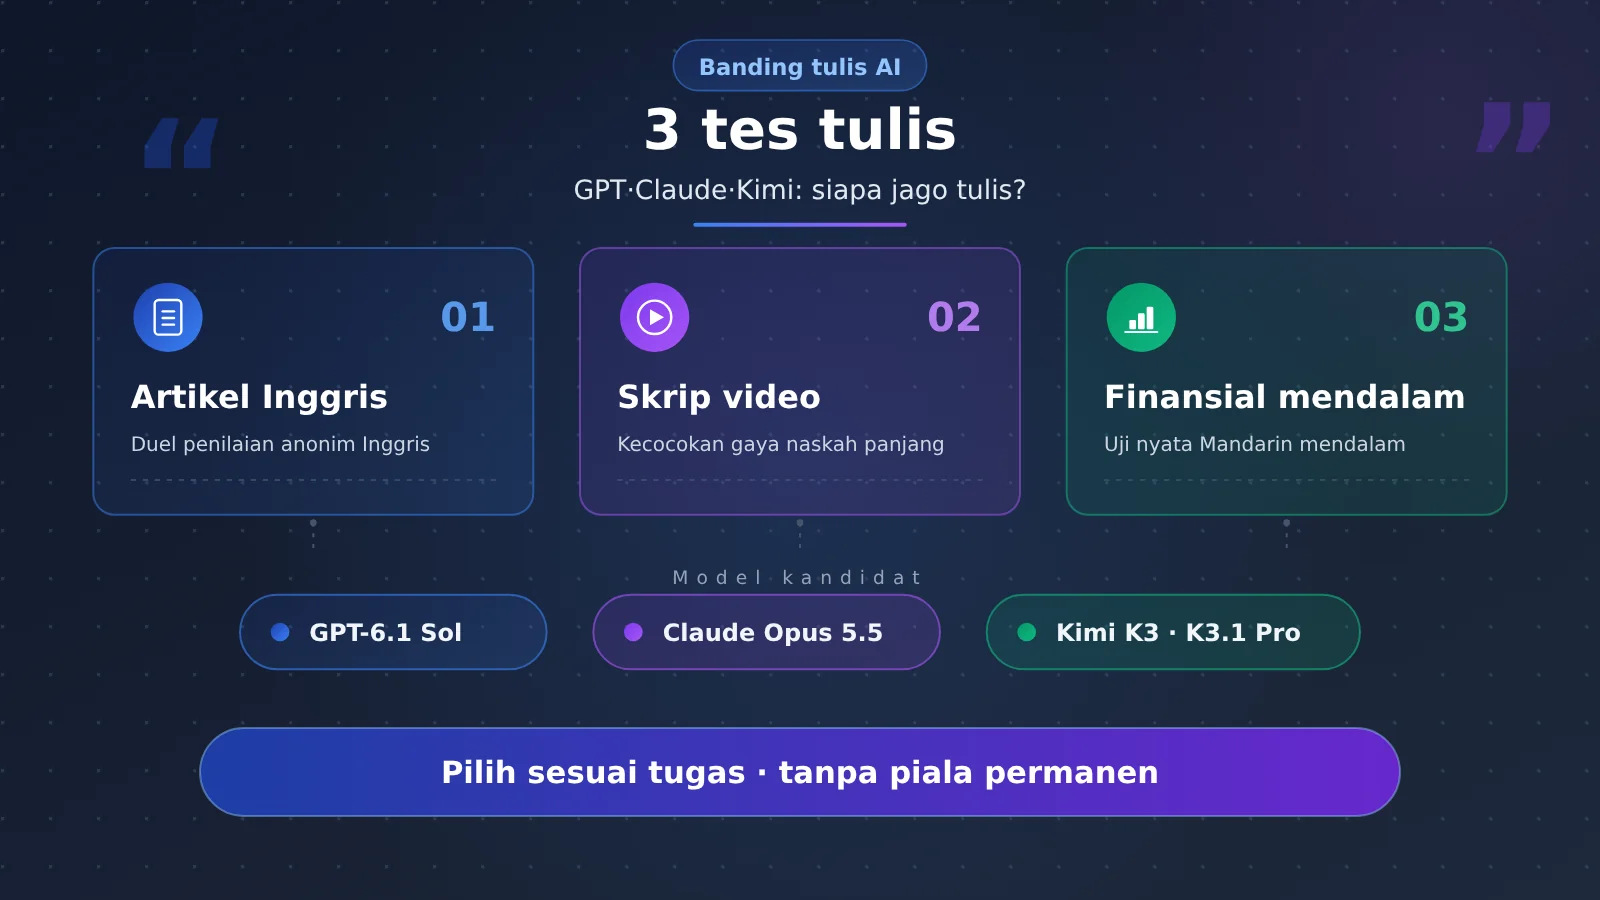
Untuk artikel berbahasa Inggris, coba GPT-6.1 Sol lebih dulu; untuk naskah panjang yang menonjolkan gaya bahasa, coba Claude Opus 5.5; untuk penjelasan sains populer, Kimi K3 layak dipertimbangkan. Performa keseluruhan Kimi K3.1 Pro dalam bahasa Inggris juga sangat kuat, hampir menyamai GPT di ToneBench.
Ketiga pengujian ini mencakup tugas, bahasa, dan metode evaluasi yang berbeda. Kesimpulan paling praktis adalah menyusun daftar kandidat, lalu mengujinya dengan naskah Anda sendiri—bukan memberikan piala permanen kepada tiga keluarga model.
Saran untuk memulai: Anda bisa memanggil model kandidat lewat antarmuka terpadu APIYI apiyi.com, dan membandingkan draf awal menggunakan paket materi yang sama. Besaran kuota uji coba gratis untuk pengguna baru mengikuti ketentuan platform yang berlaku saat ini.
Uji Penulisan GPT, Claude, dan Kimi: Apa yang Akan Dibahas Berikutnya?
Artikel ini membedah secara berurutan peringkat penulisan bahasa Inggris, uji naskah panjang video bergaya, dan uji langsung artikel keuangan mendalam berbahasa Mandarin. Di bagian akhir diberikan pilihan berdasarkan skenario, langkah evaluasi buta, dan contoh pemanggilan, dengan fokus pada kualitas artikel serta biaya penyuntingan manual.
Mari sepakati dua istilah lebih dulu: tolok ukur penulisan adalah pengujian yang mengevaluasi keluaran berdasarkan tugas yang telah ditetapkan; evaluasi buta adalah membandingkan teks setelah identitas model disembunyikan. Evaluasi buta dapat dilakukan oleh manusia atau model; saat membaca hasil, penting untuk membedakan siapa penilainya.
Uji Penulisan GPT, Claude, dan Kimi Satu: Artikel Bahasa Inggris, Lihat GPT
AI Writing Benchmark adalah proyek penulisan bahasa Inggris yang dikelola oleh Johannes Eva, dengan pernyataan bahwa proyek tidak menerima pembayaran dari produsen model. Artikel ini menggunakan hasil pembaruan 11 November 2026 dan kueri pada 12 November.
Proyek ini mencakup 115 model dan mencatat 131.507 pertandingan evaluasi buta publik. Proyek menilai penulisan melalui perbandingan teks anonim; peringkat penilai AI dan peringkat suara manusia ditampilkan secara terpisah.
| Model | Skor komprehensif bahasa Inggris | Dasar hasil |
|---|---|---|
| GPT-6.1 Sol | 95.3 | Peringkat pertama daftar komprehensif |
| Claude Opus 5.5 | 92.9 | Peringkat kedua daftar komprehensif |
| Kimi K3.1 Pro | 91.9 | Peringkat ketiga daftar komprehensif |
Skor komprehensif merangkum berbagai jenis tugas; skor kategori tugas hanya mencerminkan satu jenis soal. GPT-6.1 Sol memperoleh skor kategori 98.5 pada konten artikel, blog, dan penyuntingan, yang perlu dicatat terpisah dari skor komprehensif 95.3.
Ini adalah skor relatif di dalam tolok ukur tersebut. Proyek mendefinisikan 50 sebagai estimasi probabilitas satu berbanding dua untuk mengalahkan model rata-rata saat ini pada bahasa dan kategori tertentu; pembaca sebaiknya memperhatikan posisi kompetitif, bukan menganggap skor sebagai proporsi konten yang layak terbit.
Sederhananya: jika tugasnya adalah blog atau artikel editorial berbahasa Inggris, GPT-6.1 Sol punya alasan kuat untuk masuk putaran pertama pengujian. Untuk artikel berbahasa Mandarin, perlu mencari bukti berbahasa Mandarin tersendiri.
Hasil lain yang menarik: Kimi K3 memimpin kategori penjelasan dan sains populer dengan 94.9. Yang menang di sini adalah K3, sedangkan peringkat ketiga di daftar komprehensif adalah K3.1 Pro; nama versi harus disimpan bersama dengan skornya.
Uji Menulis GPT, Claude, Kimi Bagian 2: Gaya Tulisan Naskah Panjang, Claude Unggul
ToneBench membuat model membaca Brief kreatif, paket materi riset, dan panduan gaya, lalu menghasilkan naskah YouTube lengkap. Model tidak bisa melihat draf akhir penulis asli, dan juga tidak bisa mengakses internet atau memanggil alat eksternal.
Artikel ini menggunakan materi yang diperbarui pada 10 November 2026. Tugasnya adalah naskah panjang video kreator tertentu; materi yang diberikan tidak mencantumkan secara jelas semua bahasa tugas, sehingga di sini ditafsirkan sebagai skenario naskah.
Pengujian mencakup 87 model, 151 konfigurasi, setiap konfigurasi menyelesaikan 10 tugas, dan setiap tugas dihasilkan secara independen 5 kali. Total dihasilkan 7.550 naskah, yang dinilai 30.200 kali oleh empat reviewer AI.
Pengujian ini terutama berfokus pada kecocokan gaya, yaitu apakah nada, ritme, dan cara ekspresi mendekati kreator target. Bobot kecocokan gaya 19%, kedalaman konten, akurasi, dan nilai 15%, serta juga menilai koherensi dan kontrol panjang.
Tabel di bawah menggunakan Writing Score dari konfigurasi terbaik masing-masing model, serta peringkat model yang tercantum dalam materi. Claude sesuai dengan xhigh; materi tidak memberikan nama konfigurasi penalaran spesifik untuk dua model lainnya, sebaiknya dilengkapi saat pengujian ulang.
| Model | Peringkat Model | Writing Score | Estimasi biaya pengujian per naskah |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Writing Score adalah metrik yang merangkum performa menulis dalam pengujian ini, sedangkan peringkat melibatkan skala Elo. Jadi, skor Kimi yang lebih tinggi 0,1 dengan peringkat satu tingkat lebih rendah harus dipahami sebagai keduanya berperforma mirip.
Claude unggul dalam kelompok hasil ini, dengan estimasi biaya pengujian sekitar 4,2 kali lipat GPT. Ini adalah estimasi biaya ToneBench, tidak bisa langsung diterapkan sebagai tarif artikel untuk platform lain.
Untuk memahami peringkat, sebaiknya menempatkan tugas dan penilaian dalam satu gambaran yang sama. Saat menguji ulang melalui APIYI apiyi.com, disarankan menyimpan catatan konfigurasi, lalu kembali ke papan peringkat asli untuk memeriksa skala perbandingan.
Interval kepercayaan peringkat pertama dan kedua ToneBench saling tumpang tindih; menghapus satu naskah referensi mana pun juga akan mengubah posisi teratas. Penelitian juga menemukan reviewer memiliki preferensi vendor tertentu, namun setelah mengecualikan penilaian unit, Claude tetap memimpin.
Penilaian intinya adalah: Untuk naskah panjang yang perlu menyerap materi dan mempertahankan suara kreator, Claude layak dicoba lebih dulu. Hasil ini cocok untuk memandu pemilihan kandidat, tetapi besaran keunggulannya masih perlu diverifikasi dengan naskah sendiri.
Perlu diperhatikan juga, skor item tunggal Least Slop milik GPT-6 Sol termasuk versi lain dan metrik lain, sehingga tidak bisa digunakan untuk menggantikan Writing Score GPT-6.1 Sol.
Uji Penulisan Ketiga GPT, Claude, Kimi: Apa yang Dicari dari Naskah Mendalam Berbahasa Mandarin?
Uji OmniTools berlangsung pada 26 Oktober hingga 3 November 2026, dengan objek naskah mendalam bidang keuangan berbahasa Mandarin dari PANews. Uji ini membandingkan 10 model dan 26 artikel.
| Model | Skor buta AI | Jumlah artikel uji | Skor naturalitas |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
Dalam uji ini, skor keseluruhan dan naturalitas Claude lebih tinggi. Untuk naskah mendalam bidang keuangan berbahasa Mandarin, Claude Opus 5.5 adalah kandidat yang lebih layak dicoba lebih dulu.
Namun sampelnya sedikit, jumlah artikel tiap model tidak seimbang, dan Kimi tidak ikut serta. Karena itu, materi ini hanya bisa melengkapi bukti skenario berbahasa Mandarin untuk GPT dan Claude, dan tidak bisa memberikan peringkat lengkap ketiganya dalam bahasa Mandarin.
Penilaian menggunakan Claude Opus 5.5 dan DeepSeek V4 Pro, dengan aturan tidak menilai model sendiri. Penerbit memiliki latar belakang komersial sebagai layanan routing API, jadi informasi sumber ini perlu dipertahankan saat membaca.
Evaluasi editor adalah catatan terpisah. Tingkat adopsi editor Claude sebesar 100% hanya terkait 1/1 putaran, cocok dijadikan bahan observasi kasus; adopsi jangka panjangnya masih memerlukan dukungan lebih banyak naskah.
Ringkasan satu kalimat: Di sini ada sinyal positif untuk Claude dalam menulis naskah panjang bidang keuangan berbahasa Mandarin, dan cakupan buktinya tepat berada di skenario ini.
Uji Penulisan GPT, Claude, Kimi: Pilih Kandidat Berdasarkan Skenario
Menyatukan ketiga hasil ini seharusnya menghasilkan tabel pemilihan model, bukan sekadar menjumlahkan skor. Bahasa artikel, tugas, dan gaya tulisan yang dituju menentukan bukti mana yang relevan untuk Anda.
| Skenario Penulisan | Kandidat Prioritas | Dasar Pemilihan |
|---|---|---|
| Blog berbahasa Inggris, artikel editorial | GPT-6.1 Sol | Unggul di kategori artikel berbahasa Inggris |
| Naskah video panjang bergaya kreator | Claude Opus 5.5 | Saat ini memimpin ToneBench |
| Naskah mendalam keuangan berbahasa Mandarin | Claude Opus 5.5 | Unggul dalam uji sampel kecil berbahasa Mandarin |
| Penjelasan dan sains populer berbahasa Inggris | Kimi K3 | Unggul di kategori penjelasan dan sains populer |
| Konten panjang berbasis paket materi | Uji buta bersama ketiga model | GPT dan Kimi berdekatan di ToneBench |
| Platform verifikasi pemanggilan | APIYI apiyi.com | Antarmuka terpadu memudahkan pergantian model |
Untuk skenario seperti tutorial teknis berbahasa Mandarin dan pengenalan produk, tiga bukti yang ada belum mencakup secara menyeluruh. Pendekatan yang lebih aman adalah menguji kandidat secara bersamaan, lalu melihat siapa yang mampu menjelaskan teknologi dengan jelas dan menulis fakta secara akurat.
Uji Penulisan GPT, Claude, Kimi: Bagaimana Membuat Perbandingan Sendiri?
Sebaiknya pilih topik nyata, lalu berikan materi, perencanaan, panjang, dan izin alat yang sama persis kepada setiap model. Setiap model menghasilkan secara mandiri minimal tiga kali, kemudian sembunyikan nama model dan serahkan hasilnya kepada editor untuk dinilai.
Penilaian dapat dimulai dari lima aspek: akurasi fakta, eksekusi perencanaan, kealamian ekspresi, kejelasan struktur, dan nilai konten. Bobot ditentukan oleh tugas tim, dan tandai bahwa ini adalah aturan yang dibuat sendiri.
Selanjutnya catat biaya penyuntingan manual: jumlah kerja yang diperlukan untuk memperbaiki hingga siap terbit. Idealnya catat juga waktu penyuntingan, paragraf yang ditulis ulang, kesalahan fakta, dan status penggunaan akhir.
Saran konfigurasi: Gunakan satu kunci API di APIYI apiyi.com untuk berganti model, sehingga mengurangi pekerjaan integrasi berulang. Saat pengujian, simpan versi model, parameter, dan penggunaan Token aktual agar mudah direproduksi.
Berikut adalah contoh pemanggilan minimal. Masukkan paket materi aktual yang sama ke dalam brief, ganti nama model, dan draf pembanding pun dapat dihasilkan; kunci sebaiknya disediakan secara aman oleh lingkungan runtime.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
Kode ini untuk tahap awal; uji buta resmi tetap perlu melakukan pengulangan generasi, penyajian anonim, dan pencatatan konfigurasi. Untuk memverifikasi model unggulan di kategori penjelasan, perlu menambahkan Kimi K3.
FAQ Uji Penulisan GPT, Claude, Kimi
Dalam uji penulisan GPT, Claude, Kimi, versi Kimi mana yang sebaiknya diuji?
Untuk penjelasan edukasi, prioritaskan menyertakan Kimi K3; saat membandingkan peringkat komprehensif artikel ini dengan hasil ToneBench, gunakan K3.1 Pro. Sebelum memanggil melalui APIYI apiyi.com, periksa daftar model dan nama model spesifiknya agar tidak tertukar versi.
Dalam uji penulisan GPT, Claude, Kimi, bagaimana membandingkan biaya aktual?
Bandingkan “biaya per naskah yang layak”: akumulasi biaya pemanggilan ditambah beban kerja penyuntingan. Saat menguji di APIYI apiyi.com, catat pemakaian aktual dan jumlah percobaan ulang, lalu hitung berdasarkan harga saat itu — ini lebih mendekati kondisi produksi dibandingkan hanya melihat biaya draf awal.
Penutup uji penulisan GPT, Claude, Kimi: pilih model yang lebih hemat penyuntingan
Untuk artikel bahasa Inggris, coba GPT dulu; untuk naskah panjang bergaya dan artikel mendalam bidang keuangan berbahasa Mandarin, coba Claude dulu; untuk penjelasan edukasi, sertakan Kimi. Ini adalah urutan prioritas untuk tugas spesifik, bukan peringkat permanen seluruh keluarga model.
Disarankan memverifikasi hasilnya melalui APIYI apiyi.com dengan menggunakan paket materi yang sama. Pilihan akhirnya tergantung pada siapa yang menyelesaikan perencanaan lebih akurat, mempertahankan lebih banyak paragraf yang bisa dipakai, sehingga editor tidak perlu menambah satu putaran lembur.
Referensi Pengujian Penulisan GPT, Claude, Kimi
-
AI Writing Benchmark: aiwritingbenchmark.com
Peringkat keseluruhan dan peringkat per kategori berbahasa Inggris, menggunakan data yang diperbarui pada 11 November 2026. -
Towards AI ToneBench: benchmark.towardsai.com/models/
Pengujian skrip video, peringkat model, konfigurasi, dan estimasi biaya, menggunakan data per 10 November 2026. -
Uji Coba Penulisan Artikel Panjang Mendalam OmniTools: omnitools.ai/evals/longform-writing
Pengujian artikel mendalam bidang keuangan berbahasa Mandarin PANews, periode pengujian 26 Oktober hingga 3 November 2026.
Penulis: Tim Konten Teknis APIYI. Kami terbuka untuk berdiskusi mengenai konfigurasi model, metode uji buta, dan pengalaman editorial melalui APIYI apiyi.com.


