Catatan penulis: Alphabet mengungkapkan bahwa API model pihak pertamanya memproses hampir 32 miliar token per menit. Artikel ini membandingkan Gemini 4 Argon, 3.8 Flash, dan 3.5 Flash-Lite dari segi harga resmi, evaluasi independen, dan simulasi biaya, untuk membantu Anda menghitung “total biaya per tugas yang memenuhi syarat”.
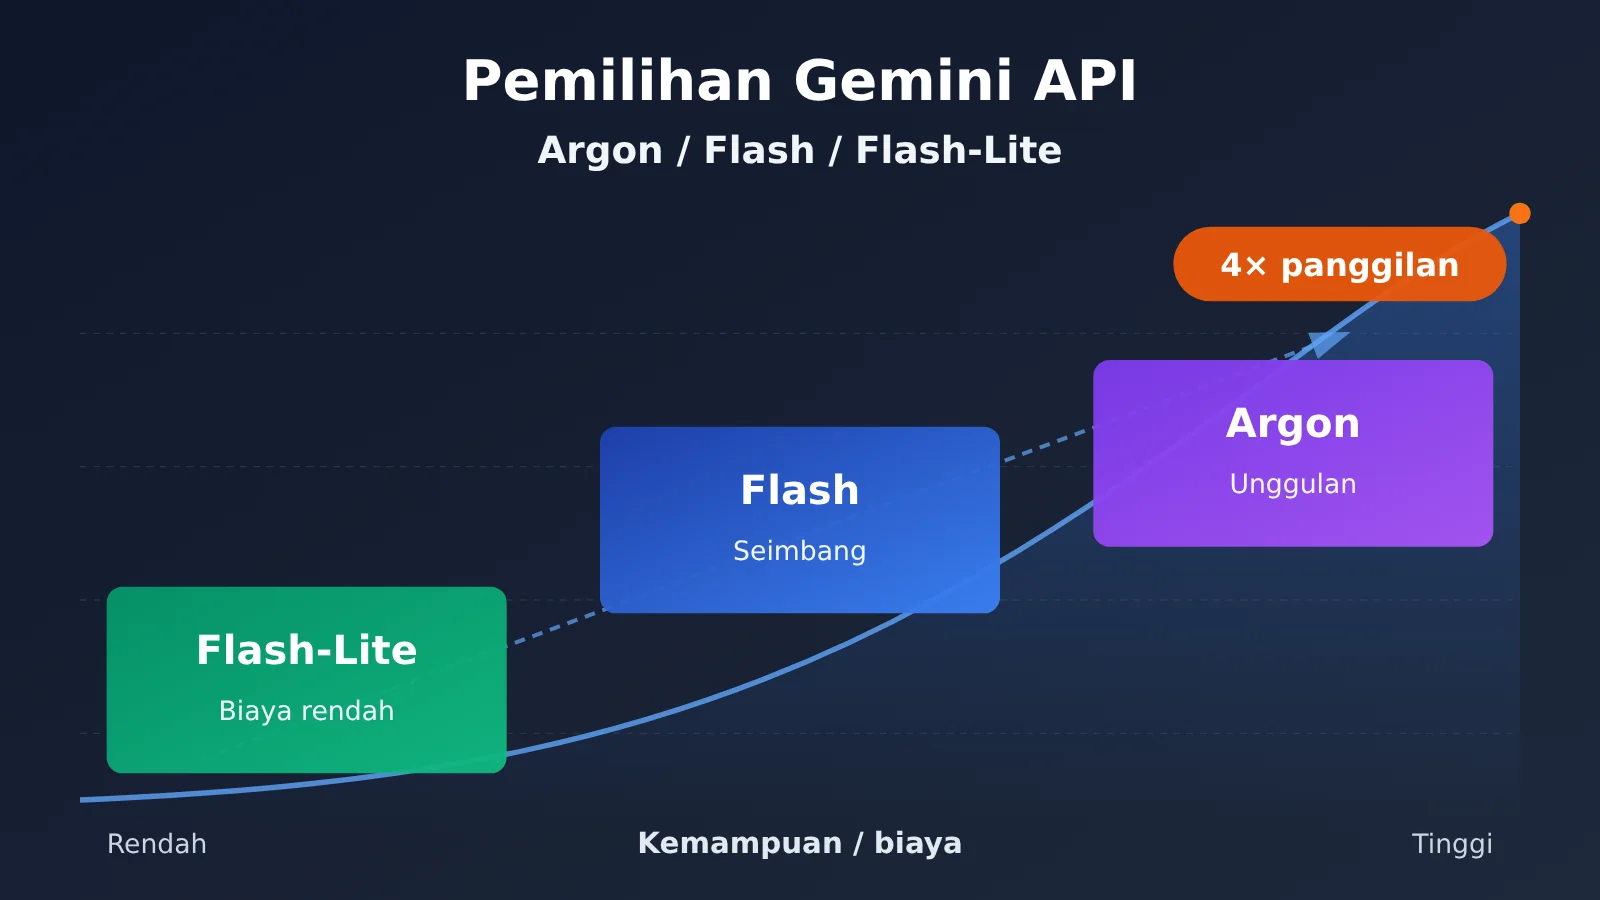
Pada 28 Oktober 2026, CEO Alphabet Sundar Pichai mengumumkan dalam laporan keuangan kuartal ketiga bahwa API model pihak pertamanya saat ini memproses hampir 32 miliar token per menit, meningkat lebih dari 4 kali lipat dibandingkan tahun sebelumnya. Angka ini mencerminkan penggunaan Gemini API secara keseluruhan oleh pengembang dan perusahaan, bukan pencapaian satu model tertentu.
Ini bukan artikel yang sekadar menyarankan Anda memilih model paling canggih. Ketika volume pemanggilan meningkat, dampak dari persoalan biaya dan pemilihan model juga makin besar. Salah memilih model bisa membuat tagihan bulanan berbeda hingga beberapa kali lipat. Model yang kurang mampu juga bisa memaksa Anda mengulang tugas berkali-kali, sehingga biayanya justru lebih mahal.
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami perbedaan kemampuan, harga, kecepatan, dan skenario penggunaan ketiga model Gemini: Argon, Flash, dan Flash-Lite. Artikel ini juga menyediakan metode pengujian untuk kebutuhan bisnis yang bisa langsung Anda ikuti guna menentukan pilihan awal.
Lonjakan penggunaan Gemini API: ringkasan informasi utama
| Informasi | Detail |
|---|---|
| Waktu pengumuman | 28 Oktober 2026 (laporan keuangan Alphabet kuartal III 2026) |
| Diumumkan oleh | CEO Alphabet Sundar Pichai |
| Data utama | API model pihak pertama memproses hampir 32 miliar token per menit, naik sekitar 40% dari angka yang diumumkan pada kuartal sebelumnya dan lebih dari 4 kali lipat dibandingkan tahun sebelumnya |
| Model API andalan saat ini | Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite |
| Cakupan dampak | Semua pengembang dan perusahaan yang membangun aplikasi melalui Gemini Developer API |
Apa arti 32 miliar token per menit bagi pengembang Gemini API?
Lonjakan penggunaan menunjukkan bahwa model sudah masuk ke lingkungan produksi dalam skala besar. Namun, bukan berarti setiap proyek harus menggunakan model andalan yang paling mahal. Saat memilih model, pertimbangkan setidaknya kompleksitas tugas, kualitas output yang dibutuhkan, volume permintaan, kecepatan respons, konsumsi token, toleransi bisnis terhadap kesalahan, kebutuhan konteks panjang dan pemanggilan alat, serta potensi perubahan harga ke depan.
Perlu diperhatikan, Flash dalam artikel ini merujuk pada Gemini 3.8 Flash, sedangkan Flash-Lite merujuk pada Gemini 3.5 Flash-Lite. Jangan tertukar dengan seri Gemini 2.5 Flash yang lebih lama. Selain itu, besarnya volume pemanggilan global tidak berarti kuota pengembang individu tidak dibatasi. Batas pemanggilan akan dibahas tersendiri di bagian selanjutnya.
Posisi tiga model Gemini: Argon, Flash, dan Flash-Lite
Google saat ini menawarkan tiga tingkatan model untuk memenuhi kebutuhan biaya dan kemampuan yang berbeda. Tabel berikut disusun berdasarkan halaman spesifikasi resmi masing-masing model:
| Aspek | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| ID API | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| Posisi resmi | Model penalaran unggulan | Keseimbangan efisiensi dan kemampuan | Latensi rendah, biaya rendah, throughput tinggi |
| Jendela konteks | Sekitar 1 juta token | Input 1048576 token | Input 1048576 token |
| Batas output default | 65536 token (dapat diperluas dengan mekanisme output panjang) | 65536 token | 65536 token |
| Tingkat pemikiran | low / medium / high, default medium | low / medium / high, default medium | minimal / low / medium / high, default minimal |
| Kemampuan alat | Pemanggilan fungsi, output terstruktur, Search Grounding, eksekusi kode | Pemanggilan fungsi, output terstruktur, eksekusi kode, pencarian file, Search Grounding | Output terstruktur, pemanggilan fungsi, cache |
| Modalitas input | Teks, gambar, audio, video, PDF | Teks, gambar, audio, video, PDF | Teks, gambar, audio, video, PDF |
| Tingkat API gratis | Tidak tersedia | Tingkat gratis terbatas | Tingkat gratis terbatas |
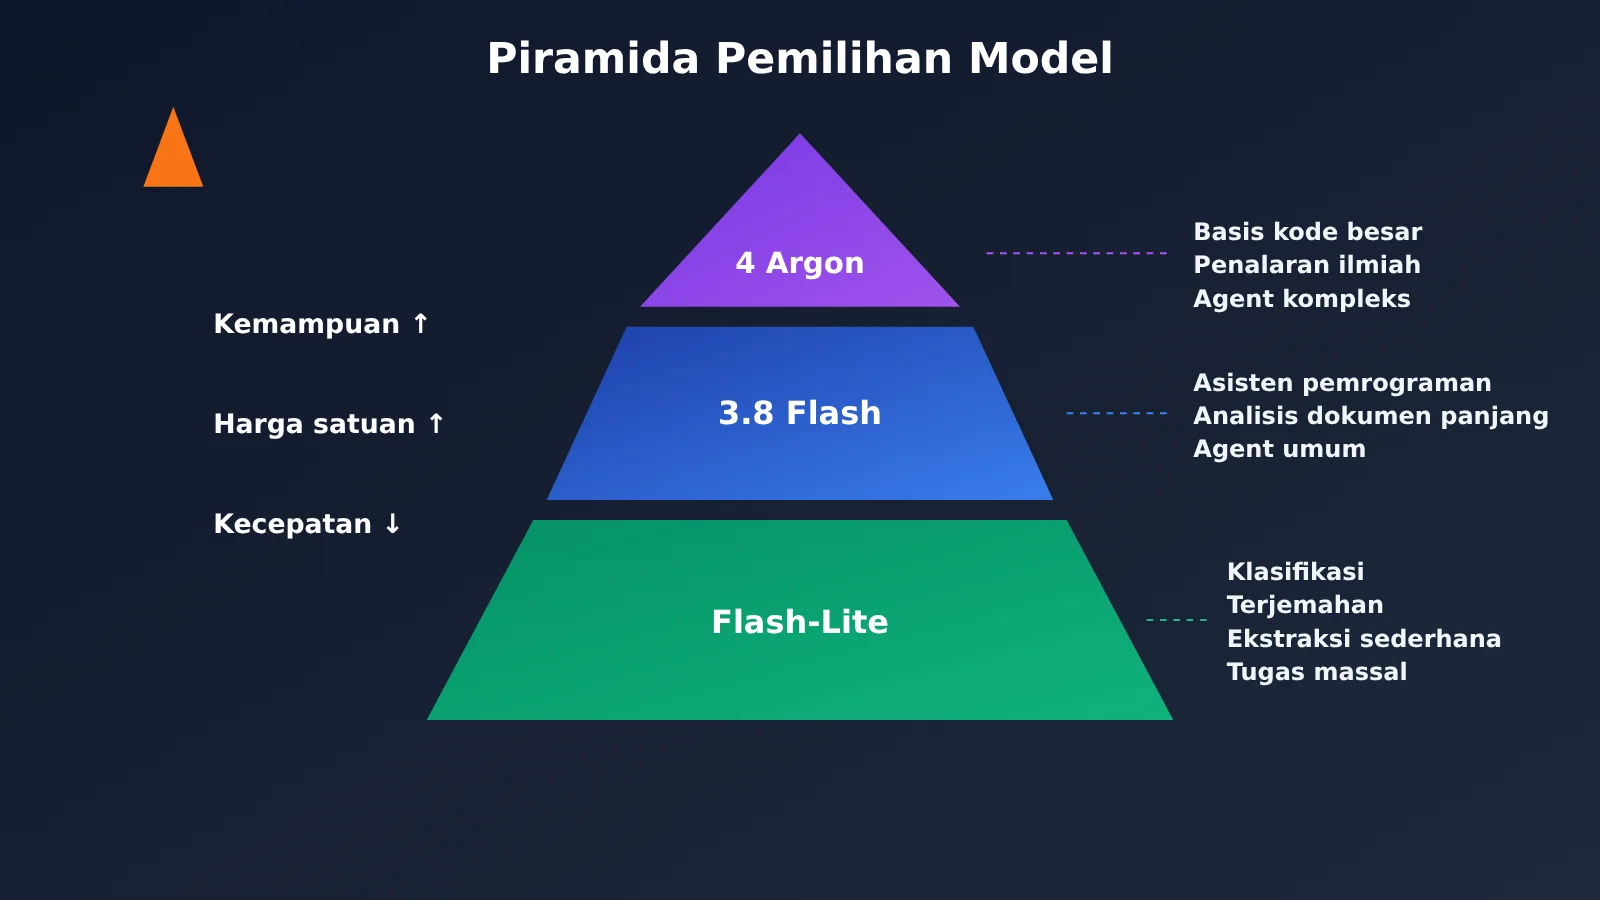
Batas kemampuan ketiga model Gemini
Argon resmi diluncurkan pada 13 Oktober 2026 dan ditujukan terutama untuk rekayasa perangkat lunak yang kompleks, penalaran matematika dan ilmiah, Agent otonom dengan banyak langkah, serta pembuatan output panjang. Kemampuan output panjangnya memerlukan mekanisme dan konfigurasi eksekusi khusus; bukan berarti setiap permintaan bisa langsung menghasilkan 1 juta token.
3.8 Flash memiliki kemampuan penalaran, bukan sekadar “versi murah yang tidak bisa berpikir”. Model ini cocok untuk asisten pemrograman sehari-hari, analisis dokumen panjang, penulisan konten, dan alur kerja Agent umum. 3.5 Flash-Lite diluncurkan pada 21 Juli 2026 dan dioptimalkan untuk klasifikasi, penerjemahan, ekstraksi sederhana, penguraian dokumen, serta subtugas sederhana dalam Agent. Model ini juga mampu menangani beberapa tugas pemrograman dan penalaran. Perbedaan utamanya dengan model kelas atas terletak pada kemampuan, stabilitas, dan efisiensi biaya untuk tugas yang kompleks.
Harga resmi Gemini API: Perbandingan biaya Argon, Flash, dan Flash-Lite
Berikut harga resmi untuk paket berbayar standar Gemini Developer API (dolar AS per 1 juta token), belum termasuk markup platform pihak ketiga, kontrak perusahaan, dan biaya pemanggilan alat:
| Model | Input | Output | Input yang ditemukan di cache | Masa berlaku harga |
|---|---|---|---|---|
| Gemini 4 Argon (saat ini) | $2.00 | $10.00 | $0.10 | Hingga 2026-11-30 |
| Gemini 4 Argon (setelah penyesuaian) | $4.00 | $20.00 | $0.20 | Mulai 2026-12-01 |
| Gemini 3.8 Flash (saat ini) | $0.75 | $3.75 | $0.075 | Hingga 2026-12-31 |
| Gemini 3.8 Flash (setelah penyesuaian) | $1.50 | $7.50 | $0.15 | Mulai 2027-01-01 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | Tidak ada tanggal penggandaan harga yang diumumkan secara resmi |
Berdasarkan harga saat ini, harga input Argon sekitar 2,67 kali harga Flash, harga input Flash 2,5 kali harga Flash-Lite, dan harga output Argon 4 kali harga Flash-Lite. Harga Argon dan Flash saat ini masih berupa harga promosi, yang masing-masing berakhir pada 30 November dan 31 Desember 2026. Setelah itu, harga per unitnya menjadi dua kali lipat. Untuk anggaran tahunan proyek jangka panjang, pastikan perhitungannya menggunakan harga setelah penyesuaian.
Ada satu detail lain yang mudah terlewat: Google memasukkan token pemikiran internal model ke dalam biaya output. Tagihan tidak hanya bergantung pada panjang jawaban yang terlihat oleh pengguna; tingkat pemikiran yang tinggi dapat meningkatkan biaya output secara signifikan. Jika tugas tidak memerlukan respons langsung, Anda bisa menggunakan Batch API. Harga input dan output ketiga model 50% lebih rendah daripada harga standar, tetapi mode eksekusi dan batas antreannya berbeda dari permintaan real-time.
Perbandingan Benchmark Independen dan Kecepatan Tiga Model Gemini
Data berikut berasal dari platform pengujian pihak ketiga independen Artificial Analysis. Seluruhnya menggunakan sistem Intelligence Index v5.0, tanpa mencampurkan skor v4.x:
| Metrik | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| Indeks kemampuan keseluruhan v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78% | 60% | 25% |
| Terminal-Bench 4.0 | 57% | 20% | 1% |
| FrontierCode 2.0 | 26% | 19% | 6% |
| Kecepatan output teramati | Lebih dari 80 token/detik | Sekitar 120–140 token/detik | Lebih dari 400 token/detik |
| Kanal akses | API resmi Google, APIYI apiyi.com | API resmi Google, APIYI | API resmi Google, APIYI |
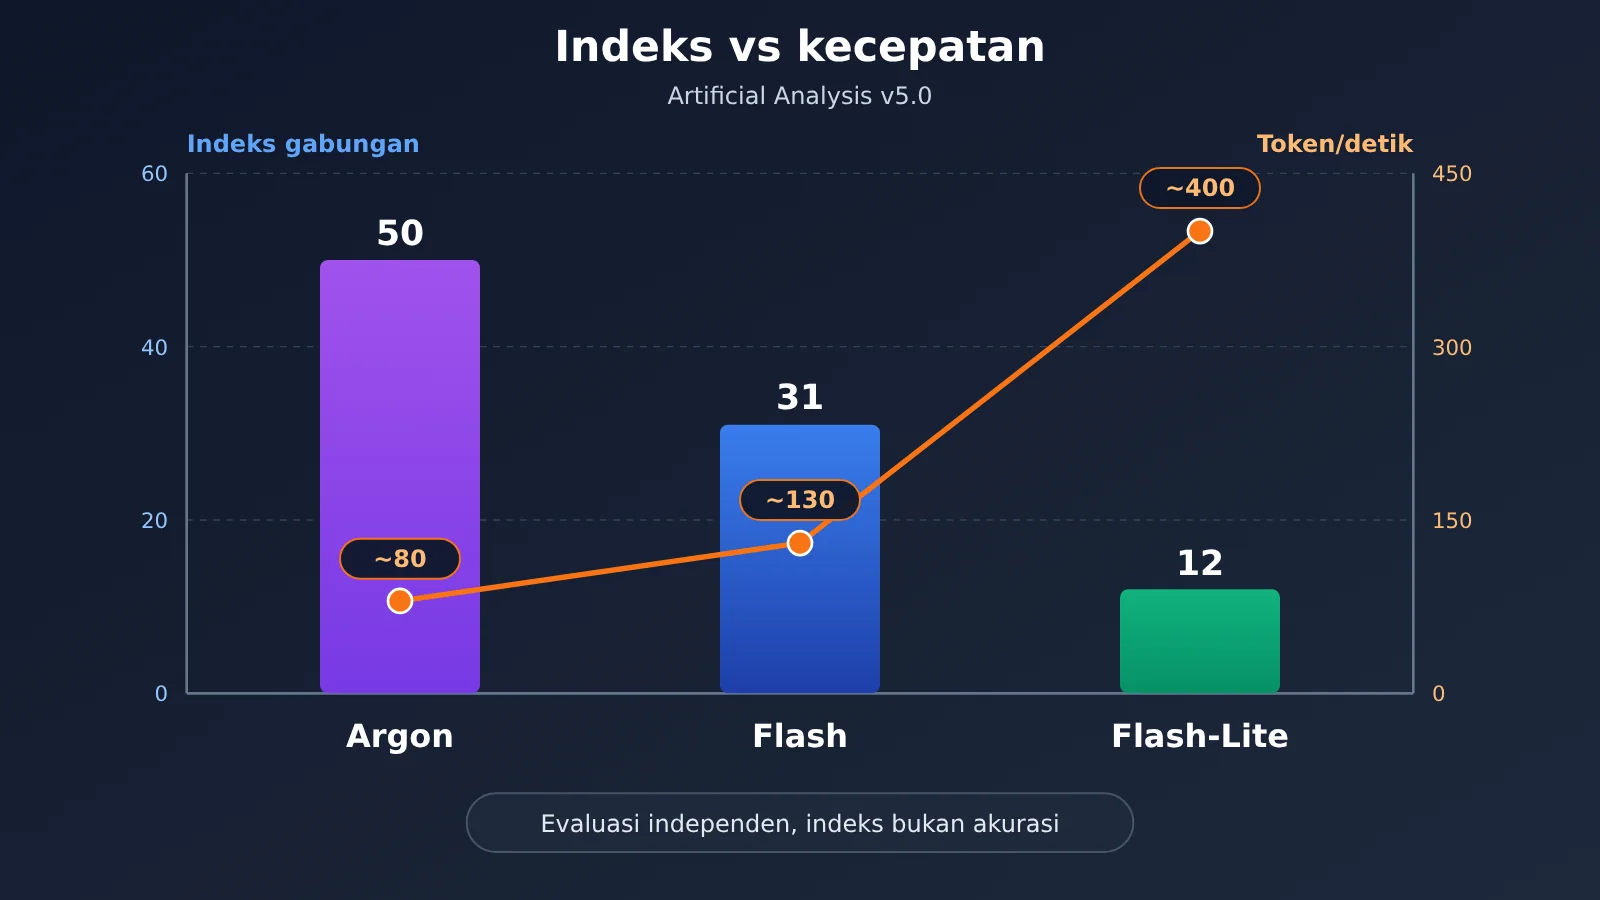
Untuk memahami data ini dengan tepat, perhatikan tiga hal:
- Indeks bukan tingkat akurasi: 50, 31, dan 12 adalah skor indeks dalam sistem pengujian, bukan berarti model “menjawab 50% dengan benar”.
- Perbedaan kemampuan pada tugas kompleks cukup jelas: Dalam benchmark pemrograman dan otomatisasi yang kompleks, Argon paling unggul, Flash berada di tengah, dan Flash-Lite lebih lemah. Namun, ini tidak membuktikan bahwa Argon lebih baik untuk setiap tugas bisnis sederhana. Untuk tugas seperti klasifikasi dan perapian format, ketiga model mungkin sudah memadai.
- Kecepatan tidak bisa langsung dikonversi menjadi waktu pengerjaan: Kecepatan output dapat berubah mengikuti kondisi layanan. Waktu aktual juga dipengaruhi oleh waktu berpikir, latensi token pertama, pemanggilan alat, antrean, dan fluktuasi jaringan.
💡 Catatan perbandingan: Skor benchmark hanya menunjukkan gambaran umum perbedaan kemampuan model. Hasil pada tugas bisnis Anda sendiri tetap menjadi acuan utama. Melalui APIYI apiyi.com, Anda bisa beralih antara tiga model Gemini menggunakan kunci API yang sama dan membandingkannya dengan sampel Anda sendiri.
Simulasi biaya Gemini API: selisih tagihan Argon, Flash, dan Flash-Lite
Berikut adalah contoh teoretis, bukan tagihan hasil pengujian. Perhitungannya mengasumsikan Token output sudah mencakup seluruh Token untuk proses berpikir, tanpa memperhitungkan biaya cache, alat pencarian, dan percobaan ulang. Semua dihitung berdasarkan harga standar Oktober 2026:
| Asumsi skenario | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A: 1.000 panggilan per hari, masing-masing 5.000 Token input / 1.000 Token output (biaya harian) | $20.00 | $7.50 | $4.00 |
| A: seperti di atas selama 30 hari berturut-turut | sekitar $600 | sekitar $225 | sekitar $120 |
| B: klasifikasi 100.000 entri, masing-masing 1.000 Token input / 200 Token output | $400 | $150 | $80 |
| B menggunakan Batch API (harga satuan turun setengah) | sekitar $200 | sekitar $75 | sekitar $40 |
Skenario B hanya menunjukkan perbedaan harga satuan dengan penggunaan Token yang sama. Dalam praktiknya, jumlah Token untuk proses berpikir, panjang output, dan jumlah percobaan ulang berbeda pada setiap model. Jadi, kita tidak bisa langsung menganggap Flash-Lite dengan biaya $80 akan menghasilkan kualitas yang setara dengan Argon seharga $400. Selain itu, setelah harga promosi Argon dan Flash berakhir, biaya pada kedua kolom tersebut akan naik dua kali lipat.
Analisis dampak: mengapa biaya Gemini API tidak cukup dinilai dari harga Token
Dampak bagi pengembang
“Harga” model setidaknya punya tiga lapisan. Pertama, harga satuan Token. Kedua, jumlah Token yang benar-benar dipakai untuk suatu tugas, termasuk input, output, proses berpikir, pengulangan konteks, dan percobaan ulang. Ketiga, total biaya untuk menyelesaikan tugas dengan hasil yang memenuhi standar. Ini juga mencakup tingkat keberhasilan, pemeriksaan manual, percobaan ulang setelah gagal, waktu penyelesaian, dan kerugian bisnis akibat kesalahan.
Jika Flash-Lite sudah memenuhi standar bisnis untuk klasifikasi sederhana, beralih ke Argon justru membuang biaya. Sebaliknya, jika tugas pemrograman yang kompleks berulang kali gagal di Flash-Lite, tetapi bisa diselesaikan Argon dengan lebih sedikit percobaan ulang, Argon mungkin lebih hemat secara keseluruhan. Ini adalah pertimbangan bersyarat dalam memilih model, bukan kesimpulan statistik tentang tingkat keberhasilan ketiga model tersebut.
Masukan dari komunitas juga menunjukkan hal ini. Seorang pengguna Reddit menggunakan Argon High untuk rekayasa balik di lingkungan OpenCode. Satu kali eksekusi menghabiskan sekitar 900.000 Token, tetapi tugasnya tetap belum selesai. Ini adalah pengujian pribadi, bukan gambaran rata-rata industri. Namun, hasilnya mengingatkan kita bahwa alur kerja Agent yang kompleks bisa menghabiskan banyak Token tanpa menjamin keberhasilan. Pengguna lain melaporkan bahwa Argon cepat mencapai batas kuota pada langganan konsumen. Itu adalah pengalaman menggunakan produk langganan Gemini dan tidak bisa disamakan dengan batas kuota Developer API.
Dampak bagi industri
- Arsitektur bertingkat dengan beberapa model menjadi pilihan standar: Google Cloud sudah menjelaskan orkestrasi multimodel dan Smart Routing untuk menekan biaya perusahaan dengan menyalurkan tugas ke model yang sesuai.
- Metrik evaluasi bergeser dari “harga satuan” ke “biaya per tugas yang memenuhi standar”: Semakin besar volume pemanggilan, semakin penting menggunakan kumpulan data uji bisnis untuk memilih model, bukan sekadar mengacu pada papan peringkat.
- Siklus anggaran menjadi lebih pendek: Seiring berakhirnya berbagai harga promosi, tim perlu meninjau kombinasi model dan anggaran setiap kuartal.
Cara developer memilih antara Argon, Flash, dan Flash-Lite
Rekomendasi berikut bergantung pada kebutuhan dan hasil pengujian. Tidak ada satu model yang terbaik untuk semua situasi:
- Klasifikasi data berskala besar (misalnya mengelompokkan 100.000 berita AI ke dalam kategori peluncuran, pembaruan, harga, dan kebijakan): coba Flash-Lite terlebih dahulu. Syaratnya, tingkat akurasi dan kepatuhan format pada sampel uji harus memenuhi target. Jika belum, naikkan ke 3.8 Flash.
- Penataan dokumen panjang (mengubah laporan keuangan atau dokumentasi teknis menjadi tabel fakta): coba 3.8 Flash terlebih dahulu. Kemampuan pemahamannya lebih kuat daripada Lite, tetapi biayanya lebih rendah daripada Argon. Untuk mendeteksi kontradiksi antar dokumen atau menangani penalaran yang sulit, gunakan Argon secara khusus.
- Proyek kode yang kompleks (memahami codebase besar atau melakukan refactoring dalam beberapa tahap): coba Argon terlebih dahulu. Baik posisi resminya maupun benchmark pemrograman independen menunjukkan kemampuan yang lebih kuat, tetapi tingkat keberhasilan, pelaksanaan tugas oleh tool, dan biayanya tetap perlu diuji dalam proyek nyata.
- Terjemahan sederhana dalam jumlah besar: coba Flash-Lite terlebih dahulu. Konten yang sangat khusus, seperti hukum dan medis, tetap membutuhkan pemeriksaan kualitas tambahan. Jangan langsung menggunakannya tanpa peninjauan hanya karena biayanya murah.
- Agent perusahaan: sebaiknya jangan hanya menggunakan satu model. Flash-Lite dapat menangani klasifikasi, ekstraksi, dan standardisasi format; 3.8 Flash menangani perencanaan umum dan alur kerja bertahap; sementara Argon menangani penalaran sulit dan pemecahan masalah yang rumit. Ini adalah strategi rekayasa yang direkomendasikan, bukan persyaratan wajib dari Google.
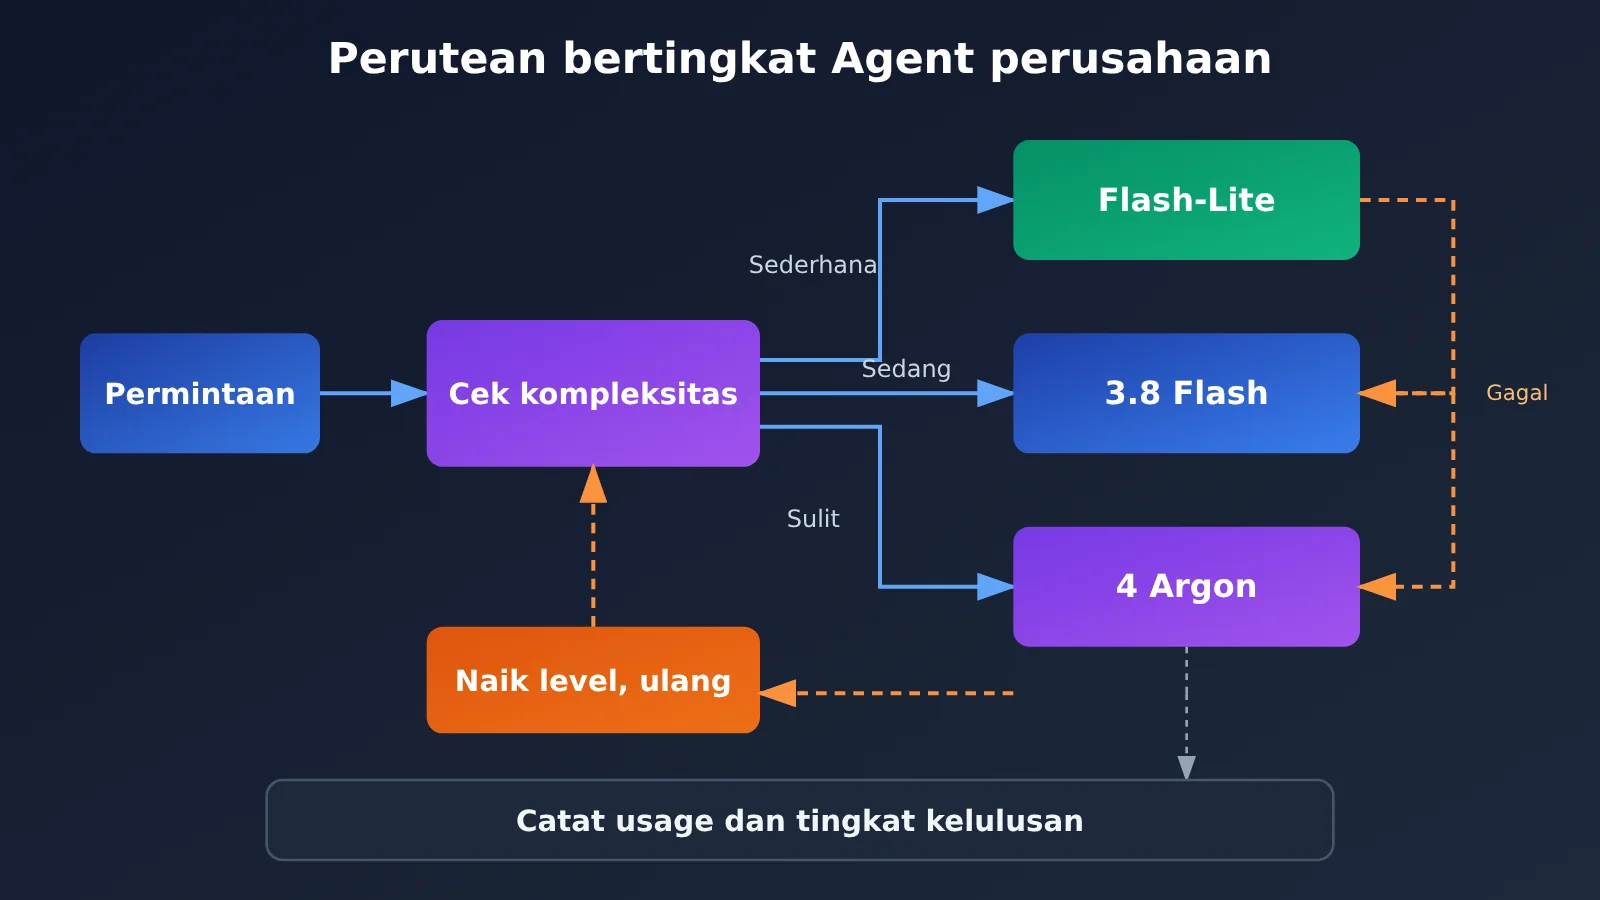
🎯 Saran pemilihan: Kunci perutean bertingkat adalah kemampuan beralih di antara ketiga model dengan biaya rendah. APIYI apiyi.com menyediakan antarmuka yang kompatibel dengan OpenAI. Cukup ubah parameter
modeluntuk beralih tingkat, sehingga cocok untuk memulai pengujian perbandingan berskala kecil.
Panduan Singkat: Memanggil Tiga Model Gemini melalui API
Contoh Sederhana
Gunakan OpenAI SDK dan ubah model untuk beralih antara Argon, Flash, dan Flash-Lite:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
Lihat kode lengkap perutean bertingkat + estimasi biaya
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 Mulai cepat: Sebaiknya ambil kuota uji coba gratis untuk pengguna baru di APIYI apiyi.com terlebih dahulu. Uji 100–300 sampel yang representatif pada ketiga tingkatan model, lalu tentukan tingkatan default untuk lingkungan produksi. Perlu diingat, harga, kuota, dan dukungan cache di platform pihak ketiga bisa berbeda dari akses langsung ke Google. Ikuti ketentuan yang berlaku di platform.
Hal yang Perlu Diperhatikan Sebelum Deploy Gemini API
- Batas pemanggilan: Gemini API menerapkan batas RPM, TPM, dan RPD berdasarkan proyek, bukan kunci individual. Melampaui salah satu batas akan menghasilkan error.
- Token berpikir: Harga output mencakup token berpikir. Periksa metadata penggunaan (usage metadata), jangan memperkirakan biaya berdasarkan panjang jawaban yang terlihat.
- Cache: Argon hanya mendukung cache implisit, bukan cache eksplisit. Flash dan Flash-Lite mendukung cache, dengan biaya yang bergantung pada konfigurasi.
- Data di tingkat gratis: Data di tingkat gratis dapat digunakan untuk meningkatkan produk. Jangan masukkan data sensitif perusahaan ke tingkat gratis, dan periksa ketentuan layanan sebelum deploy.
- Metrik pengujian: Catat tingkat keberhasilan, akurasi fakta, kepatuhan struktur, jumlah halusinasi, latensi rata-rata dan latensi pada persentil tinggi, jumlah token aktual, jumlah percobaan ulang, serta biaya per tugas yang memenuhi kriteria. Tingkat berpikir default berbeda-beda, jadi cantumkan konfigurasi yang digunakan dalam laporan.
FAQ: Pertanyaan Umum tentang Pemilihan Gemini API
Q1: Apa itu Gemini 4 Argon, 3.8 Flash, dan 3.5 Flash-Lite?
Ketiganya adalah model unggulan Gemini API dari Google dalam tiga kelas berbeda: Argon merupakan model penalaran andalan, 3.8 Flash menyeimbangkan kemampuan dan efisiensi, sedangkan 3.5 Flash-Lite dirancang untuk latensi rendah, biaya rendah, dan throughput tinggi. Ketiganya mendukung jendela konteks input sekitar satu juta token dan menghasilkan output berupa teks.
Q2: Kapan harga promosi Argon dan Flash berakhir?
Harga Argon saat ini berlaku hingga 30 November 2026. Mulai 1 Desember, harga satuan input, output, dan cache akan naik dua kali lipat. Harga 3.8 Flash berlaku hingga 31 Desember 2026 dan naik dua kali lipat mulai 1 Januari 2027. Untuk Flash-Lite, Google saat ini belum mencantumkan tanggal kenaikan serupa.
Q3: Apakah skor 50 dari Artificial Analysis berarti model menjawab 50% pertanyaan dengan benar?
Tidak. Angka 50, 31, dan 12 adalah skor gabungan Intelligence Index v5.0, bukan persentase jawaban benar. Skor ini berguna untuk membandingkan tingkat kemampuan antarmodel secara umum, tetapi tidak bisa langsung dikonversi menjadi tingkat keberhasilan dalam kebutuhan bisnis Anda.
Q4: Bagaimana cara membandingkan ketiga model Gemini dengan biaya rendah?
Anda bisa menggunakan antarmuka yang kompatibel dengan OpenAI dan mendukung berbagai model. Setelah mendaftar di APIYI apiyi.com dan mendapatkan kunci API serta kuota gratis, ganti `model` dalam contoh artikel ini dengan masing-masing dari tiga ID API. Lalu, catat penggunaan dan tingkat hasil yang memenuhi kriteria pada kumpulan sampel yang sama.
Q5: Di Reddit ada yang bilang kuota Argon habis setelah beberapa putaran. Apakah API juga begitu?
Umpan balik itu berasal dari produk langganan Gemini untuk konsumen, jadi tidak sama dengan batas Developer API. Kuota API bergantung pada tingkat pembayaran, status proyek, dan model, serta dihitung berdasarkan RPM/TPM/RPD. Jika mengaksesnya melalui platform agregator, aturan kuota platform tersebut juga berlaku. Anda bisa melihat model yang tersedia dan metode penagihan di konsol APIYI apiyi.com.
Q6: Apa saja kekurangan yang sudah diketahui dari ketiga model ini?
Argon memiliki harga satuan tertinggi, kecepatan paling lambat, dan tidak menyediakan paket gratis reguler. Tugas Agent yang kompleks juga bisa menghabiskan banyak token. Pada benchmark terminal dan pemrograman yang paling sulit, 3.8 Flash tertinggal cukup jauh dari Argon. Flash-Lite kurang unggul dalam tugas pemrograman dan otomatisasi yang kompleks, sementara terjemahan di bidang khusus perlu ditinjau oleh manusia.
Poin Penting Memilih Gemini API
- Latar belakang: API model milik Google memproses hampir 32 miliar token per menit. Angka ini mencerminkan pertumbuhan keseluruhan, bukan pencapaian satu model.
- Tiga pilihan model: Argon menangani penalaran kompleks, 3.8 Flash menjadi pilihan utama yang seimbang, dan Flash-Lite menangani tugas ringan dengan throughput tinggi.
- Perbedaan harga: Harga input saat ini adalah $2 / $0,75 / $0,30. Harga Argon dan Flash akan naik dua kali lipat setelah masa promosi berakhir.
- Memahami hasil evaluasi: Indeks AA v5.0 adalah 50 / 31 / 12. Angka ini merupakan indeks, bukan tingkat akurasi; pada tugas sederhana, perbedaannya belum tentu besar.
- Biaya tersembunyi: Token untuk penalaran dihitung sebagai output. Bersama biaya cache, percobaan ulang, dan penggunaan alat, semuanya menentukan total tagihan.
- Cara memulai: Dengan satu kunci dari APIYI apiyi.com, Anda bisa beralih di antara ketiga model dan membandingkannya menggunakan 100–300 sampel.
Kesimpulan
Lonjakan pemanggilan Gemini API menunjukkan bahwa Model Bahasa Besar sudah masuk ke tahap penggunaan dalam produksi berskala besar. Namun, pertanyaan utama dalam memilih model tetap sama:
- Kelompokkan berdasarkan tugas: Untuk klasifikasi dan terjemahan, coba Flash-Lite terlebih dahulu. Untuk mengubah dokumen menjadi data terstruktur, coba 3.8 Flash. Untuk kode kompleks dan Agent dengan tugas yang sulit, coba Argon.
- Hitung biaya per tugas yang memenuhi standar: Yang perlu dioptimalkan adalah total biaya per tugas yang memenuhi standar, bukan harga terendah per satu juta token.
- Perhatikan akhir masa promosi: Harga promosi Argon berakhir pada 30 November dan Flash pada 31 Desember. Hitung anggaran berdasarkan harga setelah penyesuaian.
Yang benar-benar dibutuhkan developer bukanlah model yang selalu paling canggih atau paling murah, melainkan kombinasi model yang mampu menyelesaikan tugas bisnis secara konsisten dengan biaya yang dapat diterima. Sebaiknya gunakan kuota gratis dari APIYI apiyi.com untuk membandingkan ketiga model terlebih dahulu, lalu tentukan strategi perutean untuk lingkungan produksi.
📚 Referensi
- Sambutan CEO dalam laporan keuangan Alphabet Q3 2026: sumber data 32 miliar token/menit
- Tautan:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Keterangan: latar belakang berita dan pengungkapan awal pertumbuhan penggunaan API
-
Harga resmi Gemini API: harga standar, cache, dan Batch untuk ketiga model
- Tautan:
ai.google.dev/gemini-api/docs/pricing -
Keterangan: mencakup tanggal berakhirnya harga promosi dan penjelasan biaya token thinking
-
Dokumentasi spesifikasi model Gemini: Argon / 3.8 Flash / 3.5 Flash-Lite
- Tautan:
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
Keterangan: konteks, batas output, tingkat thinking, dan kemampuan penggunaan alat
-
Perbandingan model Artificial Analysis: evaluasi independen pihak ketiga v5.0
- Tautan:
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
Keterangan: indeks keseluruhan, benchmark khusus, dan pengamatan kecepatan
-
Batas pemanggilan dan mekanisme thinking Gemini API: RPM/TPM/RPD dan konfigurasi thinking
- Tautan:
ai.google.dev/gemini-api/docs/rate-limits -
Keterangan: aturan kuota dan token thinking yang perlu dibaca sebelum peluncuran
-
Orkestrasi multimodel Google Cloud: Smart Routing dan pengelolaan biaya Agent
- Tautan:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Keterangan: pendekatan resmi untuk routing berjenjang di tingkat perusahaan
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs resmi APIYI. Untuk materi integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com.