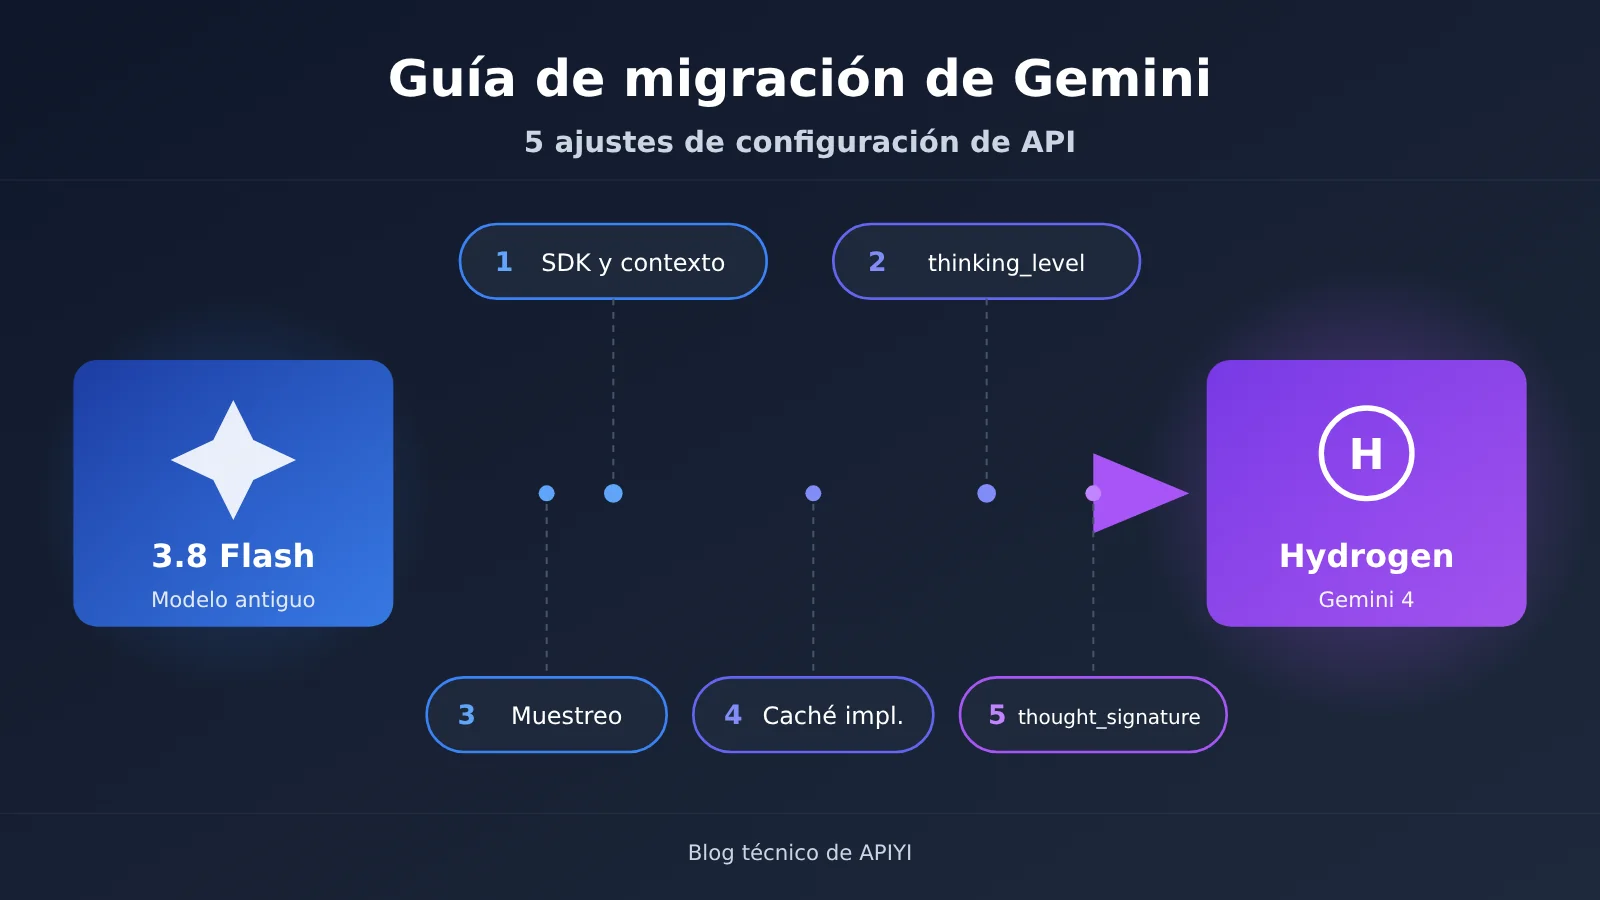
Nota del autor: para migrar de Gemini 3.8 Flash a Hydrogen, es necesario ajustar al mismo tiempo el SDK y el contexto, los parámetros de pensamiento, la configuración de muestreo, la caché y la gestión de firmas en las llamadas de herramientas en múltiples turnos.
Google lanzó oficialmente Gemini 4 Hydrogen el 12 de noviembre de 2026, con ID de modelo API gemini-4-hydrogen, orientado a la programación cotidiana y a la ejecución de agentes de IA. Muchos equipos reaccionan reemplazando el nombre del modelo en el código y lanzando a producción; el resultado son HTTP 400, parámetros que no surten efecto, errores en llamadas de herramientas en múltiples turnos y salidas largas truncadas. Este artículo repasa las 5 configuraciones de API que deben ajustarse al actualizar de Gemini 3.8 Flash a Hydrogen, y cada una se desarrolla en el orden «comportamiento anterior → comportamiento nuevo → método de modificación → impacto típico».
No es un resumen de lanzamiento. Los nombres de parámetros, valores válidos, versiones del SDK y tipos de error citados provienen de la guía oficial de migración de Google Cloud y de la documentación de especificaciones del modelo; las evaluaciones de terceros y los comentarios de la comunidad se indicarán por separado con su fuente.
Valor clave: al terminar de leer, contarás con una lista de verificación para modificar punto por punto el código existente que llama a Gemini 3.8 Flash y migrar sin sobresaltos tus agentes y procesos por lotes a Hydrogen.
Los 5 términos que debes conocer para migrar a Hydrogen
Antes de ponerte a modificar nada, vale la pena unificar varios conceptos que aparecen una y otra vez en la guía de migración:
- thinking_level: parámetro de nivel de pensamiento que controla la profundidad de razonamiento del modelo. Hydrogen lo usa en lugar del antiguo
thinking_budget; los niveles válidos son Low, Medium, High y XHigh. - thought_signature: firma asociada al razonamiento que el modelo devuelve en la respuesta. En conversaciones de varios turnos y en llamadas a herramientas debes conservarla y reenviarla tal cual; de lo contrario, el modelo no puede enlazar con el estado de razonamiento anterior.
- continuation_token: marca de continuación que sirve para enlazar el siguiente fragmento de una salida larga. Cuando un segmento de salida alcanza su límite, puedes seguir generando con este token.
- Caché implícita: la plataforma reutiliza automáticamente los prefijos de entrada que cumplan los requisitos; la parte que coincide se factura a precio de caché, sin necesidad de que el desarrollador cree objetos de caché manualmente.
- Ventana de contexto: el rango de información que el modelo puede procesar en una sola vez. En Hydrogen, la entrada, la salida, el pensamiento y las llamadas a herramientas comparten un cupo unificado de 1,048,576 tokens.
1. Por qué actualizar a Hydrogen no consiste solo en cambiar el ID del modelo
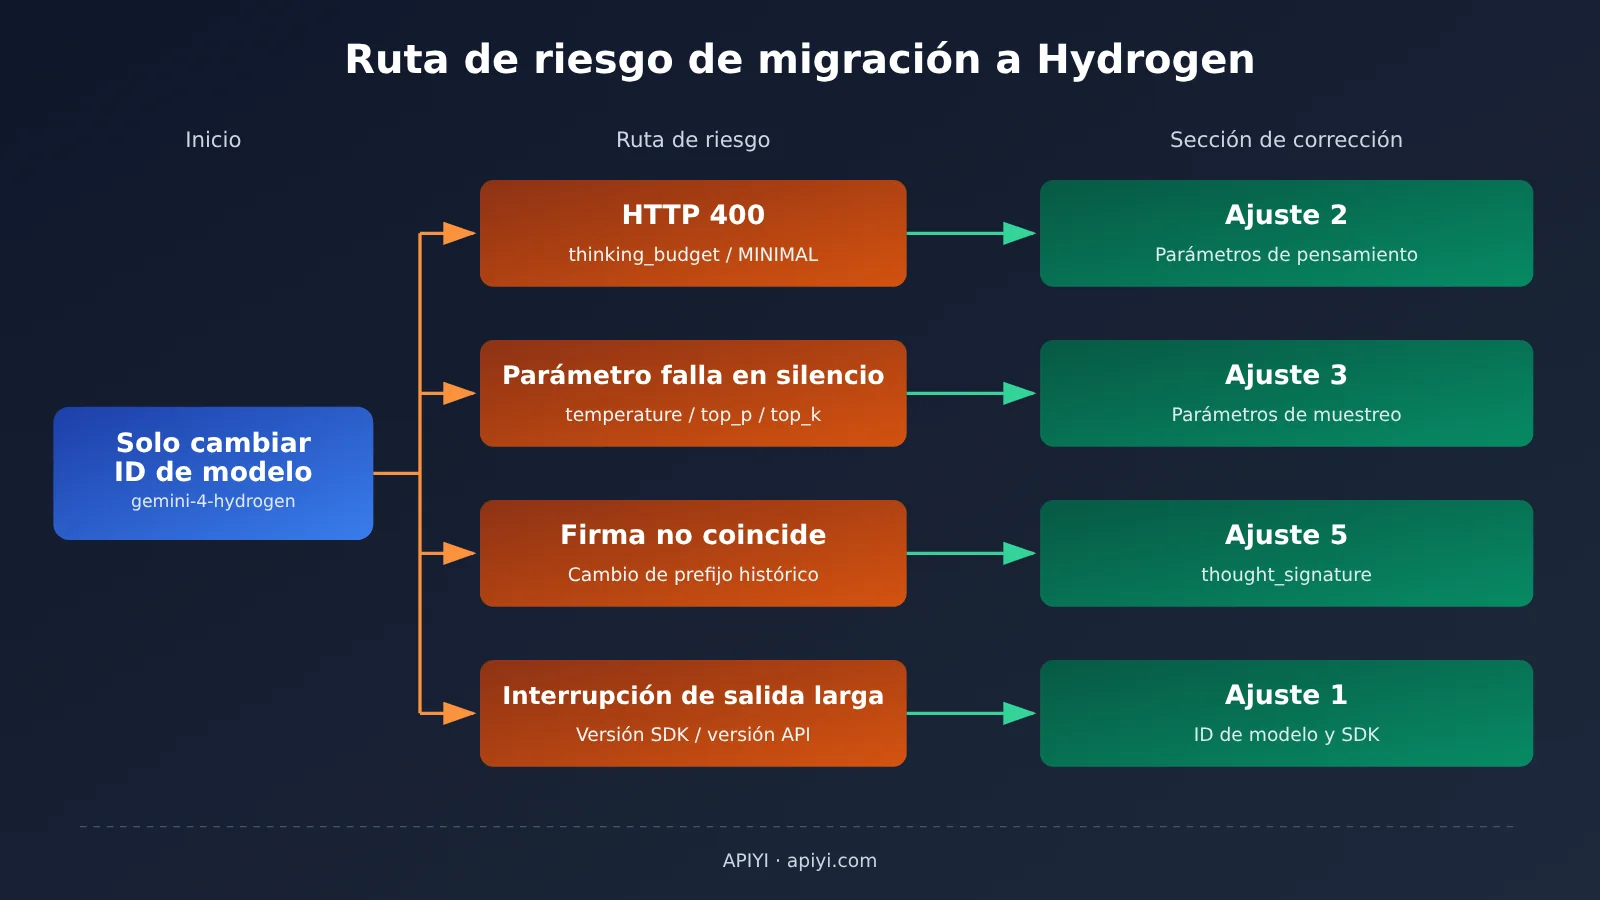
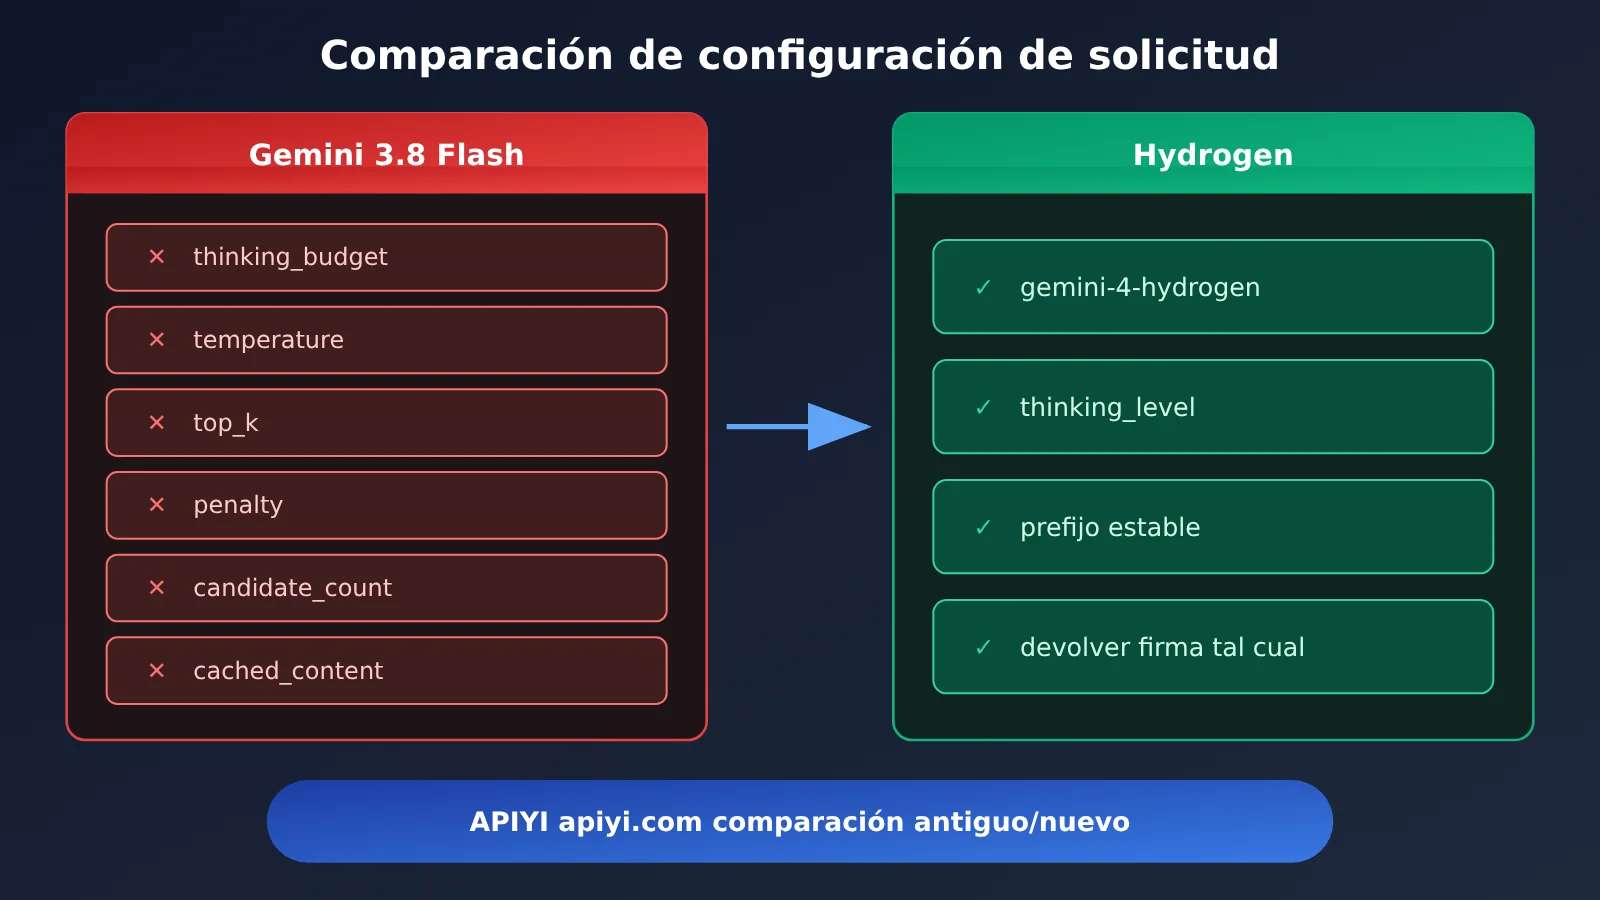
Aunque Gemini 3.8 Flash y Hydrogen pertenecen a la misma familia Gemini, su comportamiento de API presenta varias incompatibilidades. Según la guía oficial de migración, thinking_budget y el nivel de pensamiento MINIMAL no son compatibles con Hydrogen: la solicitud devuelve directamente un HTTP 400. En cambio, parámetros de muestreo como temperature, top_p y top_k no producen error, simplemente se ignoran en silencio. El primer tipo de problema se detecta durante las pruebas; el segundo puede hacerte creer que «los parámetros siguen funcionando».
Hay otros dos riesgos más difíciles de detectar. Por un lado, la gestión de firmas en llamadas a herramientas de varios turnos es más estricta: si el historial de conversación se comprime o se recorta, y la firma deja de coincidir con el prefijo, puede dispararse un HTTP 400. Por otro, el nivel de pensamiento predeterminado pasa de Medium a High; si no lo estableces explícitamente, la misma solicitud consumirá más tokens de pensamiento y tardará más. La siguiente tabla resume los cinco ajustes:
| Ajuste | Comportamiento anterior (3.8 Flash) | Comportamiento nuevo (Hydrogen) | Consecuencia de no cambiarlo |
|---|---|---|---|
| ID del modelo, SDK y contexto | ID de modelo antiguo; el SDK de versión anterior aún sirve | gemini-4-hydrogen; la continuación de salidas largas requiere una versión mínima del SDK |
Salidas largas cortadas; continuación no disponible |
| Parámetros de pensamiento | thinking_budget, Medium por defecto |
thinking_level, High por defecto |
HTTP 400, o aumento de coste y latencia |
| Parámetros de muestreo y generación | temperature, top_p, top_k, etc. ajustables | Valores fijos; los personalizados se ignoran; algunos campos deben eliminarse | Estilo de salida incontrolable; algunas solicitudes no pasan la validación |
| Caché | Compatible con caché explícita cached_content |
Solo caché implícita, con umbral de 4,096 tokens | Las referencias a caché dejan de ser válidas; estimación de costes inexacta |
| thought_signature | Reglas de firma relativamente flexibles | Reglas estrictas para llamadas en paralelo y cambios de prefijo | Errores en agentes de varios turnos o ruptura del razonamiento |
Segundo, ajuste 1: el ID del modelo, la versión del SDK y los límites de contexto de Hydrogen
Comportamiento anterior → nuevo comportamiento: en la era de 3.8 Flash, la mayoría de los proyectos no era sensible a la versión del SDK. Tras migrar a Hydrogen, el ID del modelo debe cambiarse a gemini-4-hydrogen; si se necesitan salidas extremadamente largas, la versión del SDK pasa a ser un requisito obligatorio. Las versiones mínimas indicadas en la guía oficial de migración de Google son las siguientes:
| Lenguaje de desarrollo | Continuación automática de GenerateContent | Continuación automática de Interactions API |
|---|---|---|
| Python | google-genai >= 2.30.1 | google-genai >= 2.34.0 |
| JavaScript / TypeScript | @google/genai >= 2.29.1 | @google/genai >= 2.32.0 |
| Go | No indicado oficialmente | >= 1.77.0 |
| Java | No indicado oficialmente | >= 1.80.0 |
Cómo modificar el contexto y las salidas largas de Hydrogen
Los 1,048,576 tokens de Hydrogen son un cupo unificado: la entrada y el contexto histórico, los tokens de pensamiento, los tokens relacionados con llamadas a herramientas y la salida final se descuentan todos de este mismo fondo. Es decir, no se pueden introducir primero 1 millón de tokens y luego generar otro millón adicional. Para los agentes de análisis de documentos largos, es necesario reservar proactivamente espacio para el pensamiento y las llamadas a herramientas en la entrada.
El límite de una generación en primer plano de un solo segmento suele ser de 65,536 tokens. Cuando se supera esta longitud, hay tres opciones disponibles: usar la continuación automática de un SDK compatible, establecer background=true en Interactions API para realizar una generación larga en segundo plano, o mantener manualmente continuation_token y empalmar los segmentos uno por uno. Cabe prestar especial atención a que la documentación de introducción oficial indica que la continuación de salidas largas actualmente requiere la API v1beta1; la v1 de Agent Platform no admite esta función.
Impacto típico: los flujos de trabajo que generan informes largos o archivos de código extensos por lotes son los más propensos a encontrar problemas. Se recomienda actualizar primero el SDK, luego cambiar la versión de API a v1beta1 y, por último, realizar una prueba de regresión con una solicitud que supere los 65,536 tokens.
pip install -U "google-genai>=2.34.0"
npm install @google/genai@^2.32.0
3. Ajuste 2: cambiar thinking_budget por thinking_level en Hydrogen
Comportamiento anterior: 3.8 Flash usaba thinking_budget para controlar la longitud del razonamiento según la cantidad de tokens; también permitía elegir el nivel MINIMAL, y el nivel predeterminado era Medium.
Comportamiento nuevo: Hydrogen solo acepta thinking_level, con cuatro valores válidos: Low, Medium, High y XHigh, y High es el valor predeterminado. Si se sigue pasando thinking_budget o MINIMAL, se devolverá HTTP 400. Los usos recomendados oficialmente son: Low para clasificación, Medium para programación habitual, High para agentes de varios pasos y XHigh para razonamiento profundo complejo.
La entidad externa Artificial Analysis completó el 12 de noviembre una evaluación independiente de los cuatro niveles (Intelligence Index v5.0.1), que ayuda a entender las diferencias entre niveles. Los tiempos y costos de la siguiente tabla son promedios de sus tareas de evaluación estandarizadas, y no representan el gasto real de un usuario común en una sola conversación:
| Nivel de razonamiento | Escenario recomendado oficialmente | Índice de inteligencia (AA) | Tiempo promedio de evaluación | Costo promedio de evaluación |
|---|---|---|---|---|
| Low | Clasificación, extracción simple | 27 | 1.3 minutos | $0.29 |
| Medium | Programación habitual | 41 | 3.7 minutos | $0.80 |
| High (predeterminado) | Agentes de varios pasos | 51 | 8.3 minutos | $1.87 |
| XHigh | Razonamiento profundo complejo | 54 | 13.5 minutos | $3.16 |
Según los datos, High supera a Medium por 10 puntos, mientras que XHigh solo está 3 puntos por encima de High, pero el costo de evaluación sube de 1.87 a 3.16 dólares. Esto muestra que el nivel más alto no necesariamente es la opción más rentable, y que un mismo nombre de modelo puede tener capacidades muy distintas según el nivel.
Ejemplo de modificación de thinking_level en Hydrogen
El siguiente ejemplo usa la sintaxis oficial del SDK Google Gen AI. Para el uso de mayúsculas y minúsculas en los valores de enumeración, consulta las definiciones de tipos de la versión del SDK que tengas instalada:
from google import genai
from google.genai import types

client = genai.Client()

# Forma antigua (3.8 Flash): devolvería HTTP 400 en Hydrogen
# thinking_config=types.ThinkingConfig(thinking_budget=2048)

# Forma nueva: para tareas de programación habituales, elige Medium
coding_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)

# Para agentes de varios pasos, elige High (también es el valor predeterminado; se recomienda escribirlo explícitamente)
agent_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="high"),
)

resp = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="修复这个函数中的空指针问题:...",
    config=coding_config,
)
print(resp.text)
Impacto típico: dado que los tokens de razonamiento se facturan al precio de salida, los proyectos que no configuran el nivel de forma explícita terminarán automáticamente en High después de la migración, y tanto la factura como la latencia aumentarán. Se recomienda asignar los antiguos rangos de thinking_budget a niveles: los presupuestos pequeños corresponden a Low o Medium, y los grandes a High.
4. Ajuste tres: limpiar los parámetros de generación que ya no funcionan en Hydrogen
Comportamiento anterior: 3.8 Flash permitía ajustar la aleatoriedad de la salida con temperature, top_p y top_k, y también admitía parámetros de penalización y salidas con varios candidatos.
Comportamiento nuevo: en Hydrogen la temperatura por defecto es 1.0 y los valores personalizados no surten efecto, top_p está fijado en 0.95 y top_k en 64; si pasas estos tres parámetros, se ignoran. La lista oficial de migración también pide gestionar los siguientes campos:
| Campo o comportamiento | Requisito de migración en Hydrogen | Sugerencia de diagnóstico |
|---|---|---|
| temperature / top_p / top_k | Los valores personalizados se ignoran | No da error; hay que controlar el estilo con las indicaciones |
| frequency_penalty / presence_penalty | Eliminar | Guíate por el error real; lo más seguro es borrarlos todos |
| candidate_count > 1 | Eliminar la configuración de múltiples candidatos | Si necesitas diversidad, haz varias solicitudes |
| Turnos de historial del modelo pre-rellenados | Eliminar | Ya no puedes guiar el formato «dándole un empujón inicial» al modelo |
| cached_content | Deja de hacer referencia al caché explícito | Ver ajuste cuatro |
| thinking_budget | Pasa a usar un thinking_level válido |
Devuelve HTTP 400 |
La documentación oficial advierte especialmente que algunos parámetros antiguos simplemente se ignoran, mientras que otros provocan que la validación de la solicitud falle. Por eso la lógica de diagnóstico no puede ser uniforme: cuando te encuentres con un 400, revisa primero thinking_budget, MINIMAL y los campos que hay que eliminar; si el estilo de salida no coincide con lo esperado, comprueba entonces si sigues dependiendo de los parámetros de temperatura.
Configuración de solicitud simplificada de Hydrogen
config = types.GenerateContentConfig(
    system_instruction=STABLE_SYSTEM_PROMPT,   # contenido estable al principio, favorece el caché implícito
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
    response_mime_type="application/json",      # la salida estructurada sigue siendo compatible
    max_output_tokens=8192,
)
Impacto típico: los proyectos que antes dependían de una temperatura baja para garantizar una salida JSON estable deberían pasarse a la capacidad de salida estructurada; los que dependían de pre-rellenar turnos del modelo para controlar el formato tienen que incluir los requisitos de formato en la indicación del sistema.
5. Ajuste 4: la caché explícita de Hydrogen pasa a ser caché implícita
Comportamiento anterior: en 3.8 Flash, el desarrollador podía crear primero un objeto de caché y luego referenciarlo en la solicitud mediante cached_content="cachedContents/xxx".
Comportamiento nuevo: Hydrogen no admite caché de contexto explícita; solo admite caché implícita, y el mecanismo de caché implícita persistente está habilitado por defecto. La longitud mínima del prefijo cacheable baja de los 6,144 tokens de 3.8 Flash a 4,096 tokens, de modo que resulta más fácil acertar con indicaciones de sistema comunes relativamente cortas y con materiales de conocimiento fijos.
Cómo modificarlo: elimina todas las llamadas a caches.create y las referencias a cached_content, y en su lugar optimiza el orden en que concatenas la indicación. Google recomienda colocar el contenido público y estable al principio de la entrada, y la pregunta del usuario —que cambia cada vez— al final:
- Indicación de sistema y definición del rol (casi nunca cambian)
- Base de conocimiento común, documentación de la API, convenciones de código (cambian con poca frecuencia)
- Historial de la conversación (se añade turno a turno)
- Pregunta actual del usuario (cambia en cada ocasión)
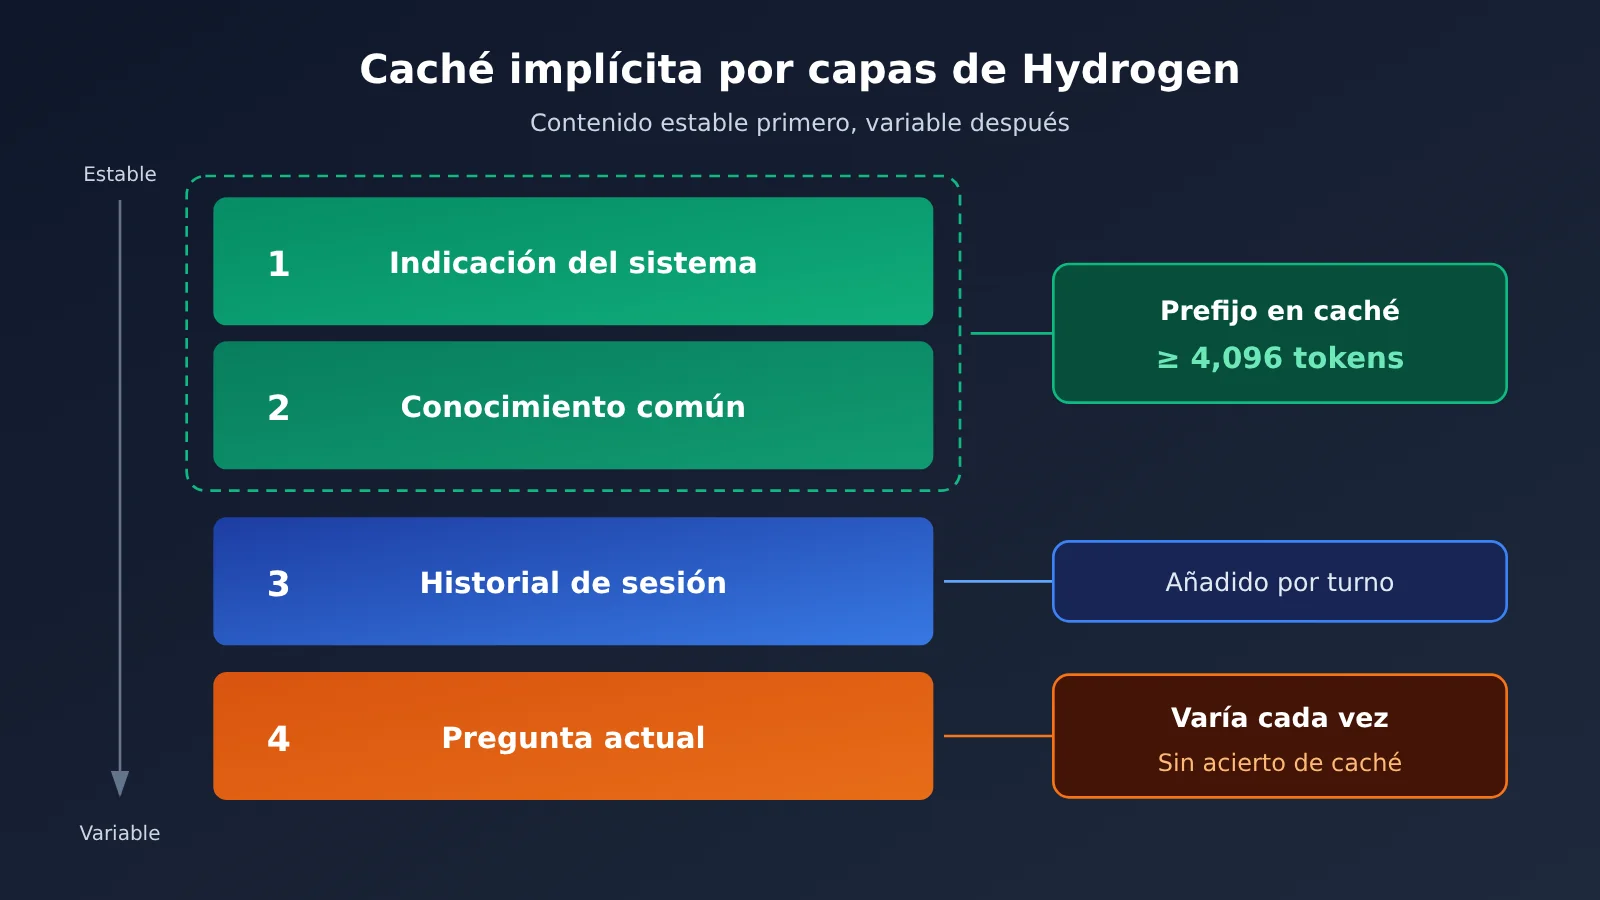
Impacto típico: en cuanto al precio, según la página oficial de precios de Google AI Studio (fecha de verificación: 13 de noviembre de 2026, en dólares por millón de tokens), la entrada con acierto de caché implícita en una llamada estándar de Hydrogen cuesta $0.075, y en los modos Batch y Flex, $0.0375, muy por debajo de los $1.50 de la entrada estándar. Si insertas variables dinámicas (marcas de tiempo, ID de usuario, etc.) al principio de la indicación, el prefijo cambia cada vez y la caché no puede acertar.
Seis, ajuste cinco: mantener correctamente thought_signature en Hydrogen
Comportamiento anterior: En 3.8 Flash, muchos frameworks de Agentes reconstruyen por su cuenta el historial de la conversación, conservando solo el texto y los resultados de las invocaciones de herramientas; la pérdida de la firma rara vez tiene un impacto visible.
Comportamiento nuevo: Las conversaciones de múltiples turnos de Hydrogen deben conservar la firma de todas las partes relevantes anteriores, incluida la firma que acompaña la parte de texto final. La guía oficial de migración establece lo siguiente para las invocaciones de herramientas en paralelo:
- Los múltiples
functionCallen paralelo deben estar en el mismo mensaje del modelo; thought_signaturese coloca solo en la primera parte defunctionCallen paralelo;- Los
functionResponseposteriores deben devolverse según el ID de invocación, el nombre y el orden correspondientes; - Cuando el mismo modelo reutiliza la firma, si el prefijo del historial cambia, por defecto puede devolver HTTP 400.
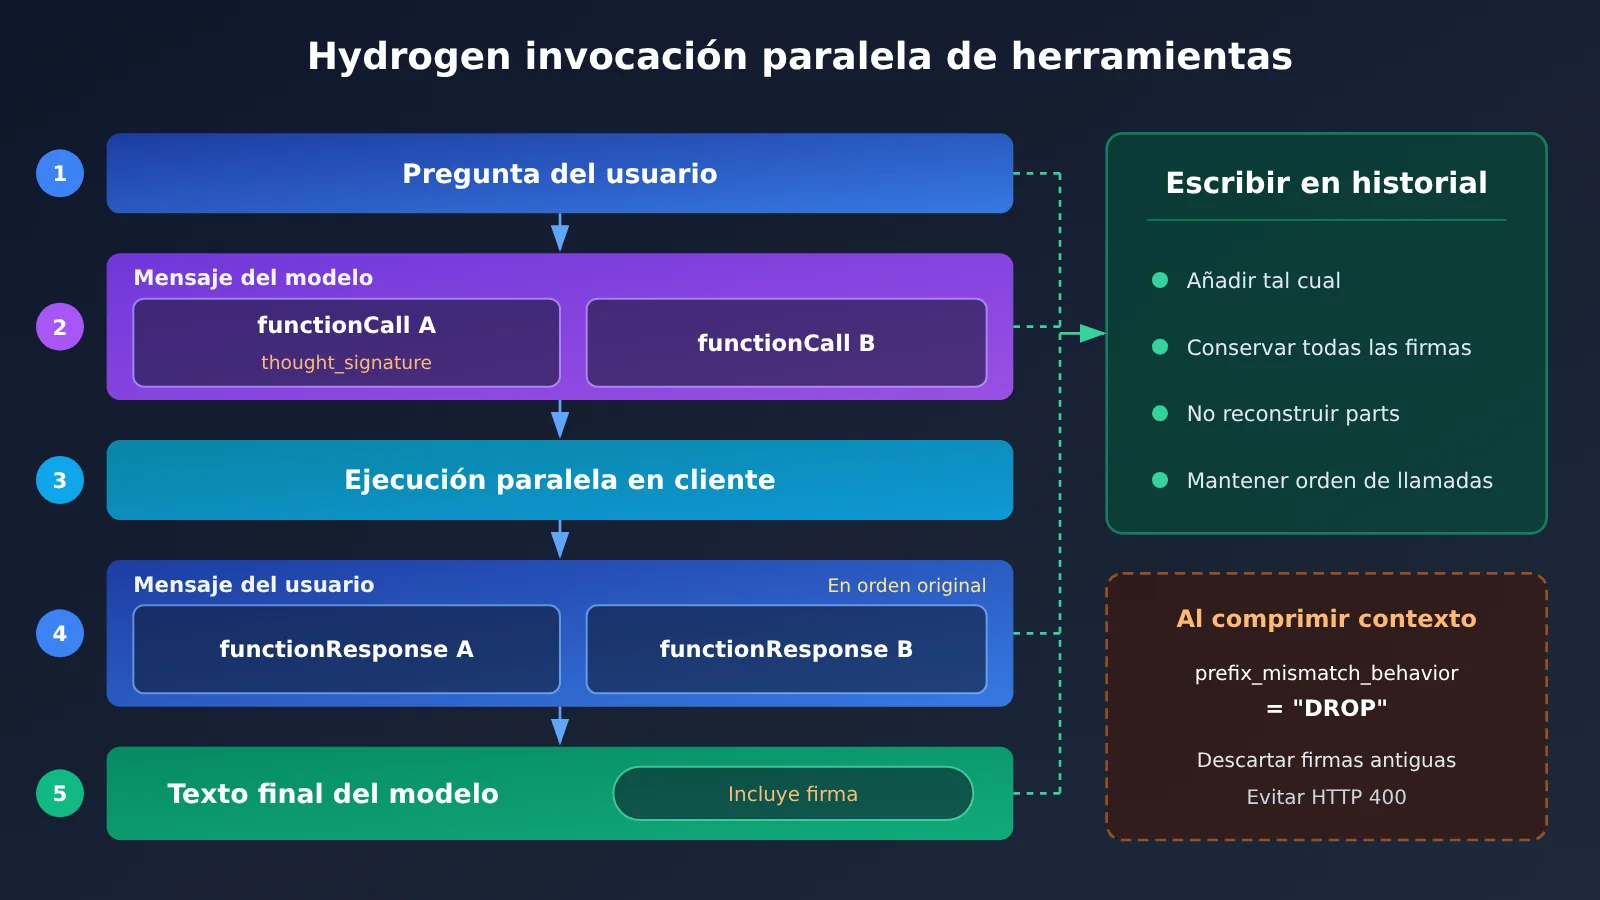
Cómo modificar el mantenimiento de la firma en Hydrogen
La forma más segura es no reconstruir manualmente las partes, sino añadir tal cual al historial el objeto content devuelto por el modelo:
history = [types.Content(role="user", parts=[types.Part(text=question)])]
resp = client.models.generate_content(
    model="gemini-4-hydrogen", contents=history, config=agent_config
)
model_content = resp.candidates[0].content
history.append(model_content)          # conservar tal cual, la firma se mantiene junto con él

calls = [p.function_call for p in model_content.parts if p.function_call]
responses = [
    types.Part.from_function_response(name=c.name, response=run_tool(c))
    for c in calls                      # mantener el mismo orden que los functionCall
]
history.append(types.Content(role="user", parts=responses))
Para los Agentes que comprimen o recortan el historial (por ejemplo, ventana deslizante o sustitución por resumen), el prefijo del historial necesariamente cambia. En ese caso, se puede configurar prefix_mismatch_behavior="DROP" según la guía de migración, para que el modelo descarte las firmas antiguas en lugar de devolver un error cuando el prefijo no coincida. La ubicación concreta de este campo en la solicitud debe consultarse en la guía oficial de migración.
Impacto típico: Los frameworks de Agentes propios (Agent Harness), los asistentes de programación que recuperan archivos en paralelo y los bots de conversaciones largas con compresión de contexto son los más afectados; se recomienda escribir pruebas de integración específicas para la devolución de firmas.
7. Lista de verificación para la migración a Hydrogen y ejemplo mínimo de invocación
| Elemento de verificación | Antes de migrar (3.8 Flash) | Después de migrar (Hydrogen) | Completado |
|---|---|---|---|
| ID del modelo | ID del modelo antiguo | gemini-4-hydrogen |
☐ |
| SDK | Cualquier versión | Python >= 2.34.0, JS >= 2.32.0 (Interactions) | ☐ |
| Versión de API | v1 | Usar v1beta1 cuando se necesite continuar salidas largas | ☐ |
| Parámetros de pensamiento | thinking_budget / MINIMAL | Establecer thinking_level explícitamente | ☐ |
| Parámetros de generación | temperature y otros ajustables | Eliminar penalty, candidate_count y rondas de prellenado | ☐ |
| Caché | cached_content | Colocar el contenido estable al inicio, prefijo ≥ 4,096 tokens | ☐ |
| Llamadas a herramientas | Reconstruir el historial por cuenta propia | Conservar la firma tal cual, devolver las respuestas paralelas en orden | ☐ |
| Manejo de errores | Reintento genérico | Distinguir los errores de validación HTTP 400 de los omitidos en silencio | ☐ |
Verificación rápida mediante la interfaz compatible con OpenAI
Si el código de negocio de tu equipo se basa en el SDK de OpenAI, primero puedes verificar rápidamente la calidad de salida de Hydrogen mediante la interfaz compatible y luego decidir si conviene migrar al SDK nativo. Los modelos disponibles y los parámetros que se pueden transferir dependen de la lista de modelos y la documentación de la plataforma:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "用 Python 写一个带重试的 HTTP 请求函数"}],
)
print(resp.choices[0].message.content)
Ver el código de implementación completo (con llamadas a herramientas y conservación del historial)
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada para comparar modelos nuevos y antiguos
)

TOOLS = [{
    "type": "function",
    "function": {
        "name": "read_file",
        "description": "读取仓库中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    },
}]

STABLE_SYSTEM_PROMPT = "你是代码修复助手。只修改与问题相关的代码。"

def read_file(path: str) -> str:
    with open(path, encoding="utf-8") as f:
        return f.read()

def run_agent(question: str, model: str = "gemini-4-hydrogen", max_steps: int = 8) -> str:
    # La indicación del sistema estable se coloca al principio para favorecer los aciertos de caché implícita
    messages = [
        {"role": "system", "content": STABLE_SYSTEM_PROMPT},
        {"role": "user", "content": question},
    ]
    for _ in range(max_steps):
        resp = client.chat.completions.create(
            model=model, messages=messages, tools=TOOLS
        )
        msg = resp.choices[0].message
        # Se vuelve a escribir todo el mensaje assistant en el historial tal cual, sin recortar sus campos
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        # Devolver los resultados uno por uno en el orden original de tool_calls
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = read_file(**args) if call.function.name == "read_file" else ""
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })
    return "达到最大步数,任务未完成"

if __name__ == "__main__":
    print(run_agent("检查 utils.py 中的 parse_date 函数是否有时区问题"))
🚀 Sugerencia para empezar rápido: durante la migración, conviene mantener 3.8 Flash como grupo de control y ejecutar los modelos nuevo y antiguo en paralelo con el mismo lote de solicitudes reales. Con APIYI apiyi.com puedes llamar a ambos modelos con una sola clave API; los nuevos usuarios tienen una cuota de prueba gratuita, ideal para hacer primero una comparación con poco tráfico y luego cambiar por completo.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es Gemini 4 Hydrogen?
Gemini 4 Hydrogen es un modelo publicado por Google DeepMind el 12 de noviembre de 2026, con ID de API `gemini-4-hydrogen`. Se adaptó a partir de Gemini 4 Carbon y pone el acento en la velocidad, la programación del día a día, las llamadas con múltiples herramientas y la ejecución de tareas de automatización. Puede usarse por sí solo o desempeñar el papel de ejecutor o validador dentro de un sistema multimodelo.
Q2: ¿Qué tan grande es la diferencia de capacidades entre Hydrogen y Gemini 3.8 Flash?
Según los datos publicados por Google, Hydrogen alcanza un 57.0% en Terminal-Bench 4.1, frente al 18.2% de 3.8 Flash; además, en las mismas condiciones de prueba, completa las tareas aproximadamente 2.5 veces más rápido. Se trata de resultados de pruebas oficiales o de socios, así que no conviene extrapolarlos directamente a todo tipo de tareas reales.
Q3: ¿Se reducirán los costos después de migrar a Hydrogen?
No necesariamente. Según la página oficial de precios de Google AI Studio (verificada el 13 de noviembre de 2026), una llamada estándar a Hydrogen cuesta $1.50 de entrada y $7.50 de salida (dólares por millón de tokens), mientras que 3.8 Flash cuesta $0.75 / $3.75 hasta el 31 de diciembre de 2026 y, a partir del 1 de enero de 2027, pasa a $1.50 / $7.50. Ahora mismo el precio unitario es el doble del de 3.8 Flash; el costo total depende de la longitud del pensamiento, el número de reintentos y la eficiencia con la que se completan las tareas.
Q4: ¿Qué proyectos deberían revisar primero la compatibilidad?
Principalmente estos tipos:
– **Agentes que hacen llamadas paralelas a múltiples herramientas**: los puntos más propensos a errores son la posición de las firmas y el orden de las respuestas;
– **Sistemas de conversaciones largas con compresión de contexto**: hay que resolver el problema del prefijo que no coincide;
– **Generación de informes extensos y código largo**: conviene actualizar el SDK y cambiar a v1beta1;
– **Sistemas de procesamiento por lotes que dependen del control explícito de caché para reducir costos**: deben pasar a una estrategia de caché implícita.
Q5: ¿Cómo comparar rápidamente el modelo nuevo y el antiguo mediante la API?
El enfoque recomendado es:
1. Visitar APIYI apiyi.com, registrarse y obtener una clave API;
2. Usar el ejemplo compatible con OpenAI de este artículo, configurando `model` con el ID del modelo nuevo y el del antiguo, respectivamente;
3. Comparar con el mismo lote de solicitudes de negocio la calidad de salida, la latencia y el consumo de tokens.
Una interfaz unificada evita tener que mantener por separado el código de autenticación y de solicitudes para cada modelo.
Q6: ¿Qué limitaciones conocidas tiene Hydrogen?
La ficha oficial del modelo señala: todavía puede generar alucinaciones; los niveles altos de pensamiento aumentan claramente el tiempo y el costo, y en ocasiones hay latencia o timeouts; el conocimiento está cortado a marzo de 2026; y, comparado con 3.8 Flash, el indicador de rechazos injustificados empeora 5.57 puntos porcentuales. Además, Hydrogen no admite Live API ni Fine-tuning. Entre los comentarios tempranos de la comunidad, algunos usuarios también reportan una ejecución excesiva en tareas de Agent; se trata de experiencias individuales.
Q7: ¿Cómo controlar el riesgo de costos durante la migración inicial?
Se sugiere empezar estableciendo explícitamente `thinking_level=»medium»` para ejecutar la línea base y, después, activar High solo para los Agentes de varios pasos; al mismo tiempo, revisar la tasa de aciertos de la caché implícita y la proporción de tokens de pensamiento. Si se quiere facturación por uso y ver de forma centralizada el consumo de varios modelos, también se puede usar la facturación unificada de APIYI apiyi.com para hacer la comparación.
Puntos clave de la migración a Hydrogen
- No es solo cambiar el nombre: cambiar el ID del modelo a
gemini-4-hydrogenes apenas el primer paso; hay otras cuatro configuraciones que deben ajustarse en paralelo. - El SDK es un requisito obligatorio: la continuación de salidas largas exige Python >= 2.34.0 y JS >= 2.32.0 (Interactions API), además de usar v1beta1.
- Cambio de generación en los parámetros de razonamiento:
thinking_budgetyMINIMALdevuelven HTTP 400, y el nivel predeterminado ahora es High. - Los parámetros de muestreo dejan de funcionar: temperature, top_p y top_k se ignoran; penalty, múltiples candidatos y los turnos prellenados deben eliminarse.
- La caché depende de la estructura: la caché explícita se elimina; el prefijo estable debe alcanzar 4,096 tokens para acertar la caché implícita.
- La firma debe estar completa: en llamadas paralelas, la firma aparece solo en el primer functionCall, las respuestas se devuelven en orden y el historial comprimido puede configurarse en DROP.
- Compara antes de cambiar: usa APIYI apiyi.com para invocar el modelo antiguo y el nuevo con la misma clave API, valida con poco tráfico y luego migra por completo.
Resumen
Puntos clave para actualizar de Gemini 3.8 Flash a Hydrogen:
- Capa base: actualiza el ID del modelo y el SDK, y comprende la cuota unificada de 1,048,576 tokens y el límite de salida de 65,536 tokens por segmento;
- Capa de parámetros: sustituye
thinking_budgetporthinking_levely limpia los campos de muestreo y generación que dejaron de funcionar; - Capa de estado: rediseña la estructura de la indicación para acertar la caché implícita, y conserva y devuelve
thought_signaturetal cual.
Se recomienda aplicar los cambios uno por uno siguiendo la lista de verificación de este artículo, escribir pruebas de regresión para las llamadas a herramientas y las salidas largas, y luego cambiar el tráfico real al nuevo modelo. Para comparar rápidamente el rendimiento entre el modelo antiguo y el nuevo, recomendamos usar APIYI apiyi.com: la plataforma ofrece una interfaz compatible con OpenAI y crédito de prueba gratuito para nuevos usuarios.
📚 Referencias
- Guía de migración para desarrolladores de Gemini 4 Hydrogen: cambios oficiales de compatibilidad y lista de verificación para la migración
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Descripción: la fuente de primera mano sobre versiones mínimas del SDK, reglas de firma,
prefix_mismatch_behaviory otros detalles -
Guía de inicio y comparación de diferencias de migración de Gemini 4: notas sobre salidas largas y versiones de API
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 -
Descripción: aclara que la función de continuación requiere usar la API v1beta1
-
Especificaciones del modelo Google Cloud Hydrogen: tabla de contexto, parámetros y funciones compatibles
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Descripción: valores fijos de temperatura, top_p y top_k, y compatibilidad con caché
-
Blog oficial de Google: anuncio de lanzamiento de Gemini 4 Hydrogen
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descripción: posicionamiento del producto y datos oficiales de comparación con 3.8 Flash
-
Página de precios de Google AI Studio: precios oficiales de la API
- Enlace:
aistudio.google.com/docs/pricing -
Descripción: precios estándar, Batch, Flex, Priority y de aciertos de caché
-
Evaluación independiente de Artificial Analysis: evaluación de los cuatro niveles de pensamiento
- Enlace:
artificialanalysis.ai/models/gemini-4-hydrogen -
Descripción: índice de inteligencia de terceros, tiempo de evaluación y datos de costos
-
Ficha del modelo de Google DeepMind: capacidades, limitaciones y evaluación de seguridad
- Enlace:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Descripción: limitaciones conocidas y evaluación oficial entre modelos
Autor: Equipo técnico de APIYI
Intercambio técnico: si encuentras problemas de compatibilidad durante la migración, no dudes en contactarnos a través del sitio web oficial de APIYI. Para más material de integración, consulta el centro de documentación docs.apiyi.com