Resumen: En las llamadas multirronda a Responses API con GPT-6.2, reescribir entradas anteriores puede reducir los aciertos de caché y también puede hacer que algunos elementos de razonamiento pierdan la elegibilidad para reutilización. Los desarrolladores pueden optar por una estructura de contexto de solo adición y luego usar registros de uso emparejados para localizar las diferencias de coste.
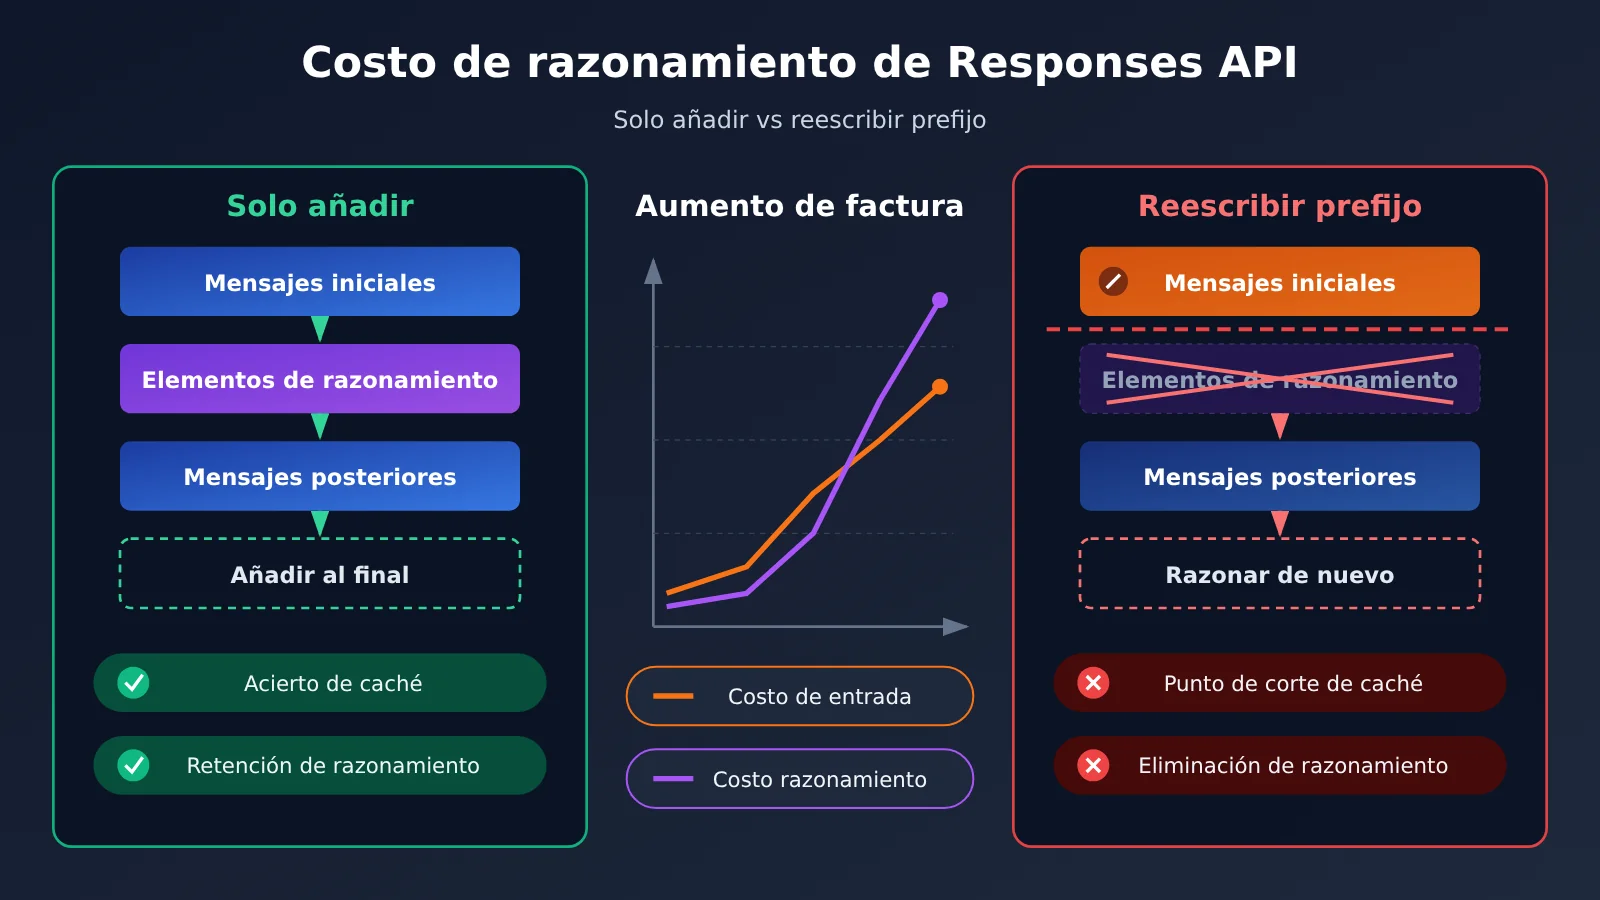
Vamos directo a la conclusión. Normalmente, el aumento de la factura no tiene una sola causa: puede venir de dos lugares al mismo tiempo. Primero, después de modificar el prefijo de entrada, se lee menos caché, y la entrada que antes se facturaba a precio de caché pasa a facturarse a precio de entrada normal. Segundo, GPT-6.2 eliminó elementos de razonamiento anteriores debido a prefix_mismatch, el modelo necesita volver a razonar y puede incurrir en costes de razonamiento adicionales. Si estos dos elementos aparecen y qué proporción representa cada uno depende de la versión del modelo, la ubicación del cambio y el usage real. El ejemplo de cálculo que sigue solo sirve para mostrar el método de desglose de costes; no representa ninguna factura real. Si llamas a través de APIYI (apiyi.com), se recomienda usar tu propio historial input gestionado para crear un grupo de control y luego conciliar según los registros de consumo.
Mapa de conocimiento sobre los costos de inferencia de la API Responses de OpenAI
La tabla siguiente resume el contenido de las cuatro secciones del artículo y cómo se relacionan entre sí; también indica el orden de lectura. La sección 1 explica de dónde vienen los costos, la sección 2 muestra qué operaciones los activan, la sección 3 ofrece métodos de medición y la sección 4 convierte las cifras medidas en importes en dinero, además de proponer un plan de cambios.
| Número | Pregunta que responde | Qué aporta a la siguiente sección | Qué puedes hacer al terminar |
|---|---|---|---|
| 1 | Dónde suben los costos | Dos líneas de observación: lectura de caché y salida adicional | Entender el significado de los campos relevantes en usage |
| 2 | Qué acciones de edición lo activan | Lista de ubicaciones de código que hay que revisar | Determinar si tu forma de mantener el contexto tiene riesgos |
| 3 | Cómo aislar los cambios | Un conjunto de datos emparejados que se pueden comparar | Confirmar mediante experimentos controlados si el problema existe |
| 4 | De cuánto es la diferencia y cómo corregirlo | Fórmulas de desglose de la cuenta y tres modificaciones | Estimar la diferencia y verificar el cobro real por ID de solicitud |
Si ya has confirmado que existe reescritura del prefijo, puedes empezar directamente por la sección 3. Las secciones 1 y 2 pueden servirte como referencia durante la revisión.
Para saber: términos relacionados con el costo de razonamiento de la Responses API
| Término | Explicación breve |
|---|---|
| Responses API | Interfaz de OpenAI para gestionar de forma unificada las respuestas del modelo, el razonamiento y las llamadas a herramientas |
| Prefijo de entrada | Contenido y configuración de entrada temprana que se mantienen en el mismo orden al inicio de solicitudes multiturno |
| Acierto de caché | En esta solicitud se reutilizan tokens de entrada ya procesados; esa parte se factura al precio de lectura de caché |
| Elemento de razonamiento | Un tipo de elemento estructurado en la respuesta de un modelo de razonamiento que puede reutilizarse en solicitudes posteriores compatibles |
prefix_mismatch |
Un valor de motivo en el diagnóstico relacionado con GPT-6.2 que indica que un prefijo anterior se modificó, por lo que se eliminó el elemento de razonamiento |
| Solo añadir | Forma de mantener el historial que conserva el contenido y el orden existentes y solo añade eventos posteriores al final |
reasoning_tokens |
Subelemento de razonamiento dentro del uso de salida, útil para observar el consumo de razonamiento |
x-request-id |
Identificador de solicitud en el encabezado de respuesta, usado para vincular la respuesta del cliente con los registros del proveedor |
1. Por qué el costo de razonamiento de Responses API sube por dos vías
1.1 Primera vía: se reduce la lectura de caché
Según la documentación «Prompt caching» de OpenAI, la caché de indicaciones empieza a comparar desde el inicio de la solicitud. Basta con que se modifique algún fragmento temprano para que la parte posterior al punto de cambio deje de facturarse como lectura de caché y pase a facturarse al precio de entrada normal. Tomando como ejemplo el precio de contexto corto de gpt-6.2-sol en la tabla de precios de APIYI, la entrada normal cuesta 2 USD por millón de tokens y la lectura de caché 0.10 USD; hay una diferencia de 20 veces.
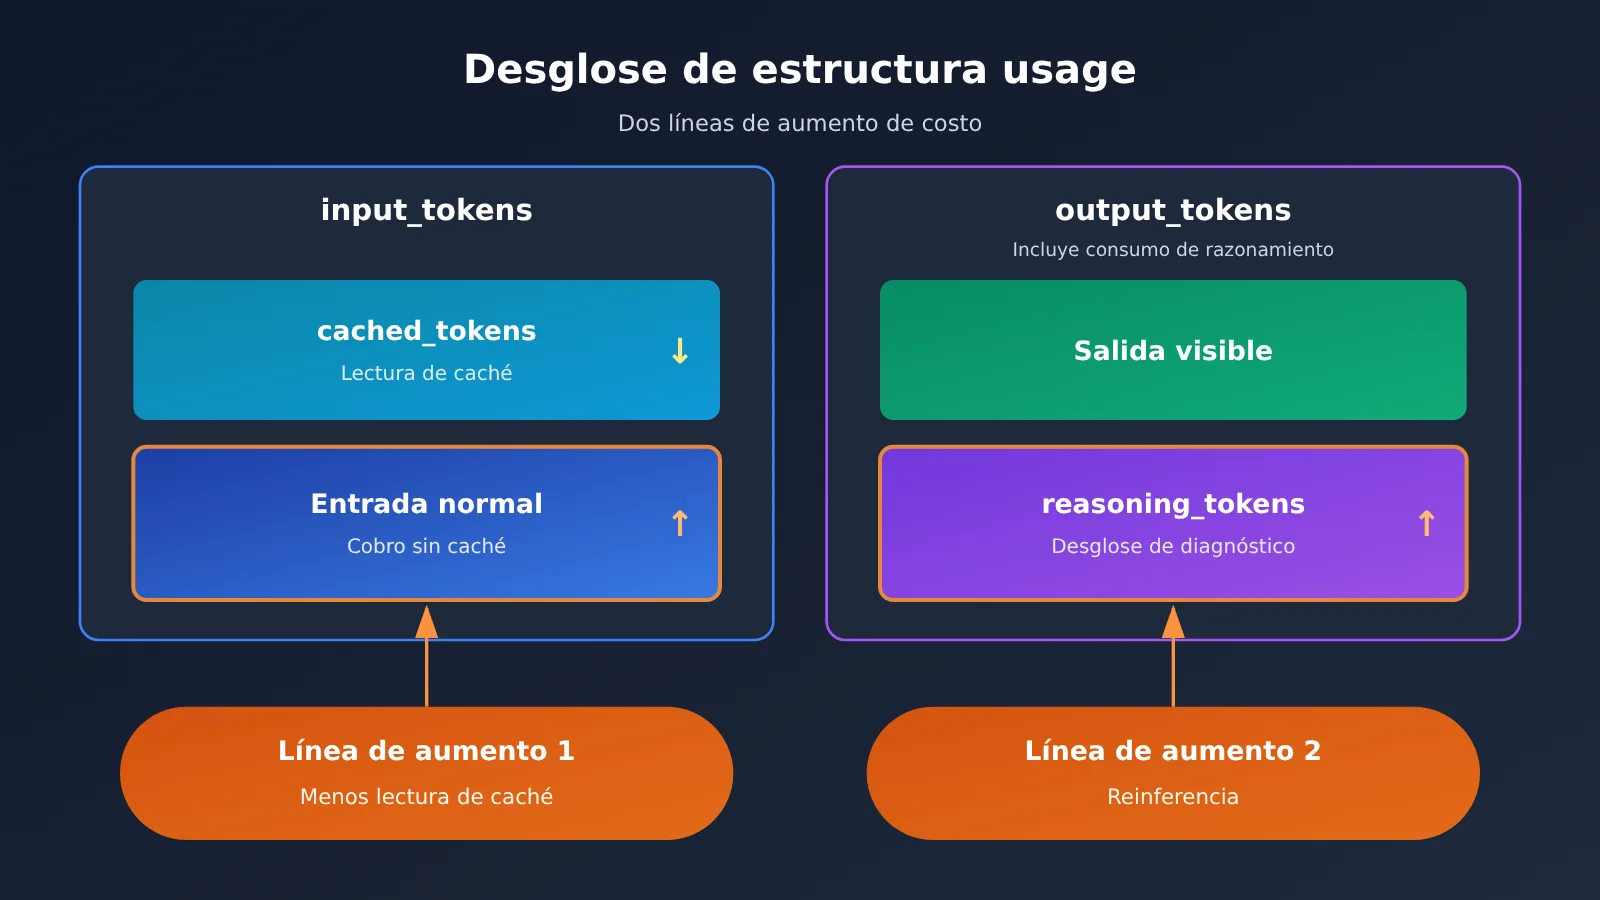
Este cambio de costo tiene campos correspondientes en usage: el total de input_tokens puede quedar prácticamente igual, pero la cantidad de cached_tokens dentro de ese total bajará. Mirando solo el volumen total de entrada no se detecta este problema; hay que registrar por separado el volumen de lectura de caché.
1.2 Segunda vía: nueva salida cuando los elementos de razonamiento dejan de poder reutilizarse
En el API Changelog de OpenAI del 2026-11-17, se marcó como comportamiento a partir de GPT-6.2 «editar el historial temprano hace que se eliminen elementos de razonamiento con el motivo prefix_mismatch». Cuando se eliminan esos elementos, el modelo ya no ve el contenido de razonamiento anterior en turnos posteriores y puede necesitar razonar de nuevo, lo que puede generar un costo adicional de razonamiento.
Esta vía se refleja en el lado de la salida: aumentan reasoning_tokens y la salida total. Puede coincidir con la reducción de lecturas de caché, pero en usage son dos campos independientes, así que al investigar conviene observarlos por separado.
1.3 Relación de inclusión entre output_tokens y reasoning_tokens
Según «Counting tokens» de OpenAI, output_tokens ya incluye el consumo de razonamiento; output_tokens_details.reasoning_tokens es solo un subelemento de diagnóstico dentro de ese total. Al calcular el costo, basta multiplicar output_tokens por el precio unitario de salida. Si además sumas reasoning_tokens por separado, lo estarás contando dos veces.
2. Qué acciones de edición del prefijo hacen subir los costos de razonamiento
2.1 Operaciones comunes que activan prefix_mismatch
Según las indicaciones de OpenAI en «Keep the prefix unchanged» y «Reasoning models», las siguientes operaciones reescriben el prefijo y, en GPT-6.2, pueden provocar que se eliminen elementos de razonamiento:
| Operación | Escenario típico en código | Riesgo |
|---|---|---|
| Reescribir mensajes antiguos | Corregir después la redacción del segundo turno del usuario, o añadir una marca de tiempo a mensajes antiguos | Reescribe el prefijo |
| Reescribir resultados antiguos de herramientas | Acortar el JSON devuelto por herramientas anteriores para ahorrar tokens | Reescribe el prefijo (acortar también cuenta como reescritura) |
| Insertar contenido antes de elementos de razonamiento relacionados | Colocar material recién recuperado en medio del historial | Reescribe el prefijo |
| Eliminar un elemento completo sin cambiar el resto | Borrar un mensaje antiguo completo | No activa esa causa de eliminación, pero la cantidad de aciertos de caché aún puede cambiar |
| Añadir después de elementos de razonamiento | Agregar nuevos mensajes en orden cronológico | No activa esa causa de eliminación |
«Acortar la salida antigua de una herramienta» parece una forma de ahorrar tokens, pero en realidad es una reescritura. Solo cuando se elimina un elemento completo y el resto de los elementos permanece sin cambios no se activa prefix_mismatch. Aun así, el punto de coincidencia de la caché también puede cambiar, por lo que el volumen de lectura de caché sigue necesitando una medición real.
2.2 Diferencias entre cambios de versión, nivel de razonamiento y familia de modelos
Estos tipos de cambios deben evaluarse por separado:
- Diferencias de versión: OpenAI aclara que la eliminación de elementos de razonamiento por
prefix_mismatches un comportamiento que empieza con GPT-6.2. GPT-6.1 Sol admitereasoning.context: all_turns, por lo que puede renderizar razonamientos anteriores cuando hay historial compatible disponible. Al migrar de 6.1 a 6.2, hay que volver a validar la forma en que se mantenía el contexto. - Nivel de razonamiento: ambas generaciones de Sol ofrecen cinco niveles:
low,medium,high,xhighymax; 6.2 Sol rechazanone. El artículo de terceros de OrcaRouter recomienda no modificar directamentereasoning.effortentre solicitudes, sino añadir un elementoconfiguration_updateeninput. El mismo artículo señala que los historiales que contienen este tipo de elementos se truncan automáticamente y que/responses/compactlos rechaza. Antes de adoptar esta práctica, consulte la documentación oficial de OpenAI. - Cambio de familia de modelos y degradación: según OpenAI, cambiar de familia de modelos o usar un modelo de menor capacidad también puede eliminar elementos de razonamiento existentes. Esta es una causa distinta de
prefix_mismatch, por lo que conviene clasificarlas por separado al hacer el recuento.
2.3 Posición y facturación de instructions de nivel superior en GPT-6.2
OpenAI, en «Using GPT-6.2», indica que las instructions de nivel superior de GPT-6.2 se añaden después de input y se facturan como entrada no cacheada. Por eso sirven para indicaciones temporales del desarrollador para el turno actual, no para grandes configuraciones de sistema que permanecen invariables a largo plazo.
Las instrucciones que deben reutilizarse a largo plazo deben colocarse como el primer mensaje developer dentro de input, para que se puedan cachear. Si hay que ajustar instrucciones de largo plazo, añada un nuevo mensaje developer al final del historial; no vuelva a modificar el primero.
3. Aislar los cambios de coste de razonamiento de la Responses API mediante solicitudes de control
3.1 Diseño del grupo de control
Fijando el modelo, el nivel de razonamiento, la definición de herramientas y el volumen de entrada, se cambia una sola variable: la forma de mantener el historial. El grupo A solo añade, el grupo B reescribe un fragmento al principio. Ambos grupos ejecutan varias rondas con el mismo conjunto de tareas.
Cada solicitud se registra de forma uniforme según la tabla siguiente. La calidad de la tarea debe puntuarse manualmente o mediante un script de evaluación, porque la reducción de coste no puede lograrse a costa de peores resultados.
| Campo | Origen | Propósito |
|---|---|---|
| Grupo | Personalizado | Distinguir el grupo de solo añadir del grupo de reescritura |
cached_tokens |
usage.input_tokens_details |
Observar la primera línea |
reasoning_tokens |
usage.output_tokens_details |
Observar la segunda línea |
output_tokens |
usage |
Calcular el coste de salida |
| Latencia | Cronometraje del cliente | Un aumento del razonamiento suele conllevar mayor tiempo de ejecución |
| Calidad de la tarea | Puntuación manual o de evaluación | Descartar los casos en que se sacrifica calidad por coste |
x-request-id |
Cabecera de respuesta | Conciliación |
3.2 Ejemplo de invocación solo con anexado
El siguiente código mantiene por sí mismo el historial de input, añadiendo únicamente al final en cada turno, y al mismo tiempo escribe el uso y el ID de la solicitud en el log:
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # fijado para toda la conversación, no se modifica entre turnos

# Prefijo estable: las instrucciones reutilizables se colocan en el primer elemento de input y no se modifican después
history = [{"role": "developer", "content": "Eres un asistente de revisión de código, responde de forma concisa."}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # si el grupo de destino devuelve o no esto debe verificarse primero
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # Solo anexado: la salida de este turno (incluidos los elementos de razonamiento) se coloca tal cual al final del historial
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
El grupo de reescritura reutiliza la misma función: antes del turno N se modifica el contenido de history[1] y se establece variant como "early_rewrite", dejando el resto de los parámetros sin cambios.
🚀 Inicio rápido: al construir el grupo de control, puedes cambiar entre
gpt-6.1-solygpt-6.2-solcon la misma clave API a través de APIYI apiyi.com. Con la misma estructura de logs, podrás comparar el impacto de las diferencias entre versiones sobre la caché y el consumo de razonamiento.
3.3 Diagnóstico auxiliar con conexión directa al proveedor oficial
Con conexión directa a OpenAI, es posible establecer prompt_cache_options.comparison_response_id con el ID de alguna respuesta anterior y luego leer el motivo del diagnóstico devuelto y el número de tokens en caché. El campo input_transformations de la respuesta enumera qué elementos de razonamiento se eliminaron y por qué; dentro de él, prefix_mismatch puede corresponderse por ID con elementos de razonamiento en la salida de la respuesta antigua.
# Solo para conexión directa oficial a OpenAI
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
Este diagnóstico tiene dos limitaciones: el diagnóstico de caché solo reporta la primera diferencia según el principio de mejor esfuerzo, y no permite confirmar si el modelo realmente reutilizó el razonamiento preservado. Puede decirte «se eliminó un elemento de razonamiento», pero no puede decirte «cuánto se gastó de más por eso»; el costo aún debe determinarse combinando el uso emparejado de la sección 3.1.
3.4 Consideraciones al invocar mediante APIYI
La conexión directa a OpenAI admite el uso de previous_response_id para reanudar el estado de la sesión. La guía de invocación nativa de la API Responses de APIYI (docs.apiyi.com) afirma en el cuerpo del texto que este método encadenado no funciona, pero la sección de preguntas frecuentes de la misma página registra que, según pruebas reales del 2026-09-02, sí está disponible. Dado que ambas afirmaciones son inconsistentes, la línea base más segura es: gestionar uno mismo el historial de input, tal como se describe en la sección 3.2.
La reanudación de estado, el reenvío de elementos de razonamiento cifrados y los campos de diagnóstico mencionados pueden comportarse de manera distinta según el grupo de tokens; es necesario verificarlo por separado en el grupo objetivo. Si los campos de diagnóstico no están disponibles, los registros de uso emparejados siguen sirviendo como base para la evaluación.
4. Desglose numérico del costo de inferencia de Responses API y ejecución de la transformación
4.1 Precios de lista utilizados para la estimación
A continuación se muestran los precios de lista predeterminados para contexto corto que aparecen en la tabla general de precios de APIYI apiyi.com (actualizada el 2026-11-20 a las 15:17, hora de Beijing; unidad: dólares por millón de tokens). El cargo real también depende del grupo de tokens al que pertenece el modelo y del costo de recarga; ambos deben verificarse por separado.
| ID de modelo APIYI | Entrada normal | Lectura de caché | Salida |
|---|---|---|---|
gpt-6.2-sol, gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
El contexto largo debe calcularse por separado. Cuando la entrada de gpt-6.2-sol supera 272,000 tokens, el precio de entrada que figura actualmente en la tabla general de APIYI es $3, mientras que la página oficial del modelo Standard de OpenAI indica $4; para gpt-6.1-sol, el precio de entrada de contexto largo es $4 en ambos casos. Para los precios de caché y de salida en los tramos de contexto largo, consulte las reglas de facturación en tiempo real de cada canal.
4.2 Ejemplo de desglose de costos de dos solicitudes
Condiciones del supuesto: contexto corto, precio de lista predeterminado de APIYI Sol, y ambas solicitudes tienen 12.000 tokens de entrada; no hay escritura de caché facturada por separado ni cargos por herramientas. Todas las cifras siguientes son hipotéticas, no datos medidos.
| Concepto | Prefijo conservado | Prefijo reescrito |
|---|---|---|
| Lectura de caché | 9.000 × $0.10/M = $0.0009 | 3.000 × $0.10/M = $0.0003 |
| Entrada normal | 3.000 × $2/M = $0.0060 | 9.000 × $2/M = $0.0180 |
| Salida total | 1.000 × $10/M = $0.0100 | 1.600 × $10/M = $0.0160 |
| Total | $0.0169 | $0.0343 |
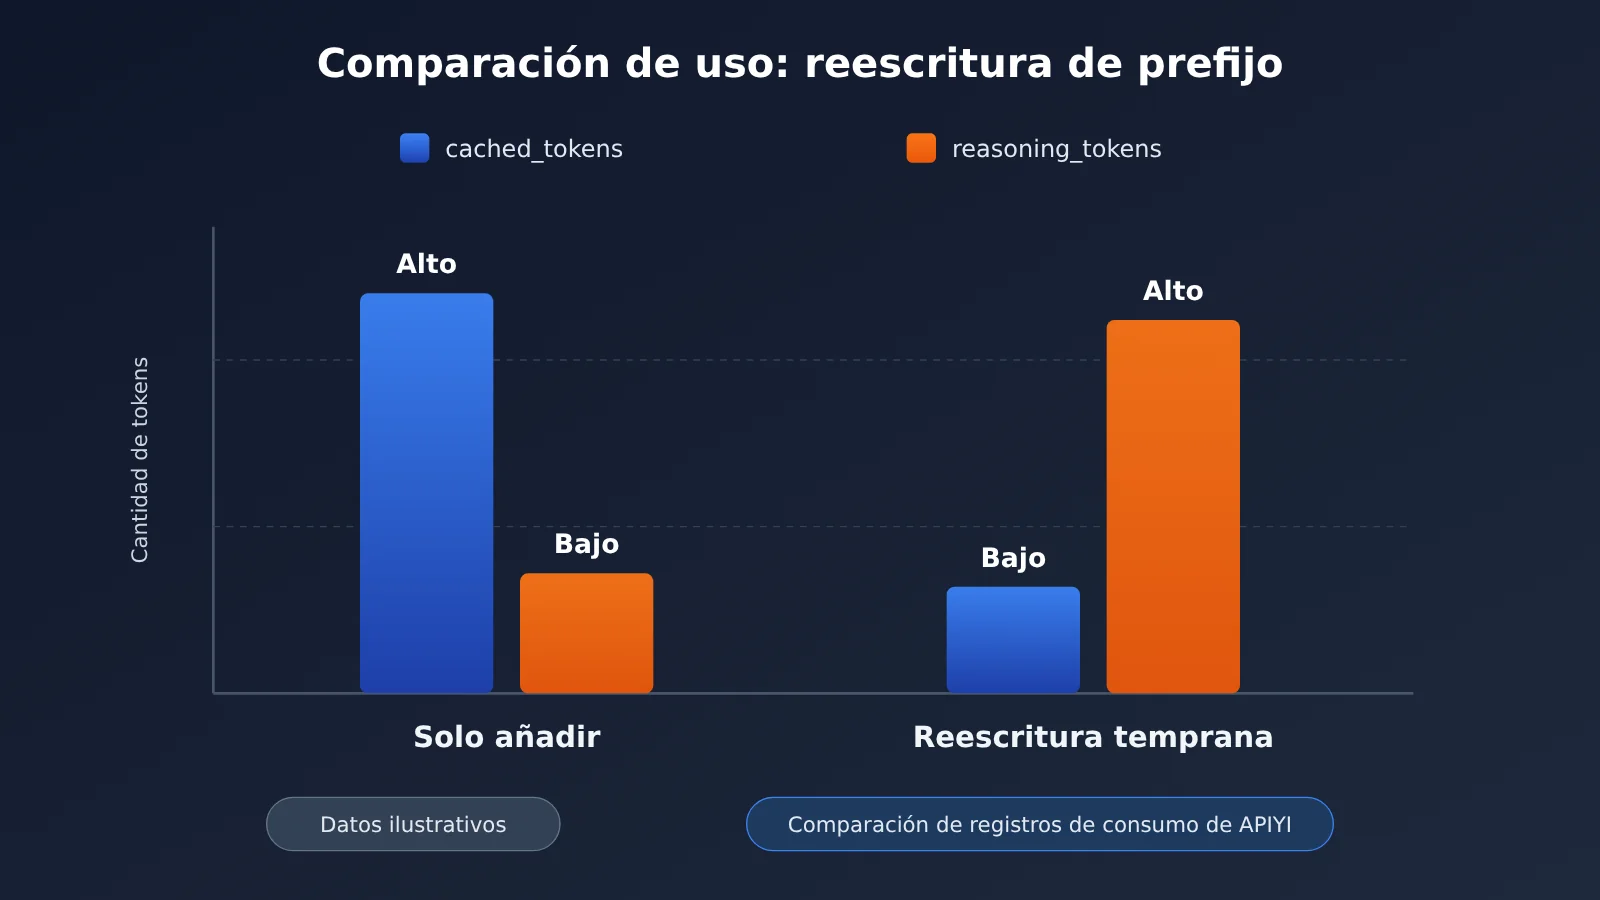
La diferencia entre ambas es de $0.0174, que se puede dividir en dos partes: $0.0114 provienen de 6.000 tokens de entrada que pasan de precio de caché a precio de entrada normal, es decir, 6.000 × ($2 − $0.10) / 1.000.000; y $0.0060 provienen de los 600 tokens de salida adicionales. Estas dos partes corresponden, respectivamente, a las dos líneas de la sección 1. La diferencia real debe basarse en tu propio usage. Si existe escritura de caché facturada por separado, hay que calcularla por separado en tres categorías mutuamente excluyentes: entrada normal, lectura de caché y escritura de caché.
4.3 Reconciliación con el ID de solicitud
Después de estimar, toca verificar el cargo real. En los registros de consumo de APIYI apiyi.com, usa el x-request-id del encabezado de respuesta para localizar el registro correspondiente con type=2, y convierte el cargo real en dólares con quota ÷ 500,000. Anota también el modelo, el grupo del token, la franja horaria de la invocación y el consumo de entrada y salida de esa solicitud.
Por ahora no existen facturas públicas de comparación de prefijos de APIYI para el mismo grupo y la misma tarea. Por eso, al evaluar el efecto de la optimización, conviene guiarte por tus propios registros de solicitudes emparejadas y tus registros de cargos.
💰 Consejo de reconciliación: asocia uno por uno el
request_idde los registros de la sección 3.2 con el registro de consumo, y obtendrás tres columnas: «campo de consumo → importe estimado → cargo real». La columna en la que aparezca la desviación te dice en qué eslabón está el problema.
4.4 Tres cambios
- Fijar la definición de herramientas e instrucciones estables: mantén el orden original de las definiciones de herramientas y no las modifiques a mitad de la conversación; las instrucciones de largo plazo van en el primer mensaje developer del
input, mientras que la indicación temporal del turno actual puede usar elinstructionsde nivel superior de GPT-6.2, pero acepta que se factura como entrada no cacheada. - Añadir el contexto en orden: los mensajes nuevos, los resultados nuevos de herramientas y los materiales nuevos de recuperación se añaden al final. Cuando de verdad haya que recortar, elimina elementos completos en lugar de reescribir su contenido.
- Probar por separado el contexto largo y la migración de versión: cuando el contexto largo supera los 272,000 tokens de entrada se aplica otra tarifa, así que conviene crear un grupo de control aparte; al migrar de
gpt-6.1-solagpt-6.2-sol, o al ajustar el nivel de precio o cambiar de familia de modelos, valida primero con el método de comparación de la sección 3 y después despliega a plena escala.
Una vez completados estos cambios, puedes comprobar el efecto así: vuelve a ejecutar los dos grupos de comparación sobre el mismo conjunto de tareas. Si en el grupo de solo añadir la proporción de cached_tokens se mantiene estable, reasoning_tokens no sube de forma anómala y el cargo real verificado por ID de solicitud coincide con la estimación, eso indica que este gasto ya está bajo control.
Referencias
- OpenAI «Keep the prefix unchanged»: conservación del prefijo y diagnóstico
prefix_mismatch- Enlace:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Enlace:
- OpenAI «Reasoning models»: reutilización de elementos de razonamiento y excepciones para la eliminación del elemento completo
- Enlace:
developers.openai.com/api/docs/guides/reasoning
- Enlace:
- OpenAI «Prompt caching» y «Counting tokens»: reglas de coincidencia de caché y campos de uso
- Enlace:
developers.openai.com/api/docs/guides/prompt-caching
- Enlace:
- Registro de cambios de la API de OpenAI (entrada de GPT-6.2, 2026-11-17)
- Enlace:
developers.openai.com/api/docs/changelog
- Enlace:
- OrcaRouter «GPT-6.2 Preserved Reasoning»: enfoque de reescritura de solo adición recopilado por un tercero
- Enlace:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- Enlace:
- APIYI «Tabla general de precios de modelos»
- Enlace:
docs.apiyi.com/models
- Enlace:
- APIYI «API de consulta de logs»
- Enlace:
docs.apiyi.com/api-capabilities/log-query
- Enlace:
- APIYI «Guía de invocación nativa de la API Responses de OpenAI»
- Enlace:
docs.apiyi.com/api-capabilities/openai/native
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: no dudes en contactarnos desde la página de inicio de APIYI. Encontrarás más material en el centro de documentación docs.apiyi.com.