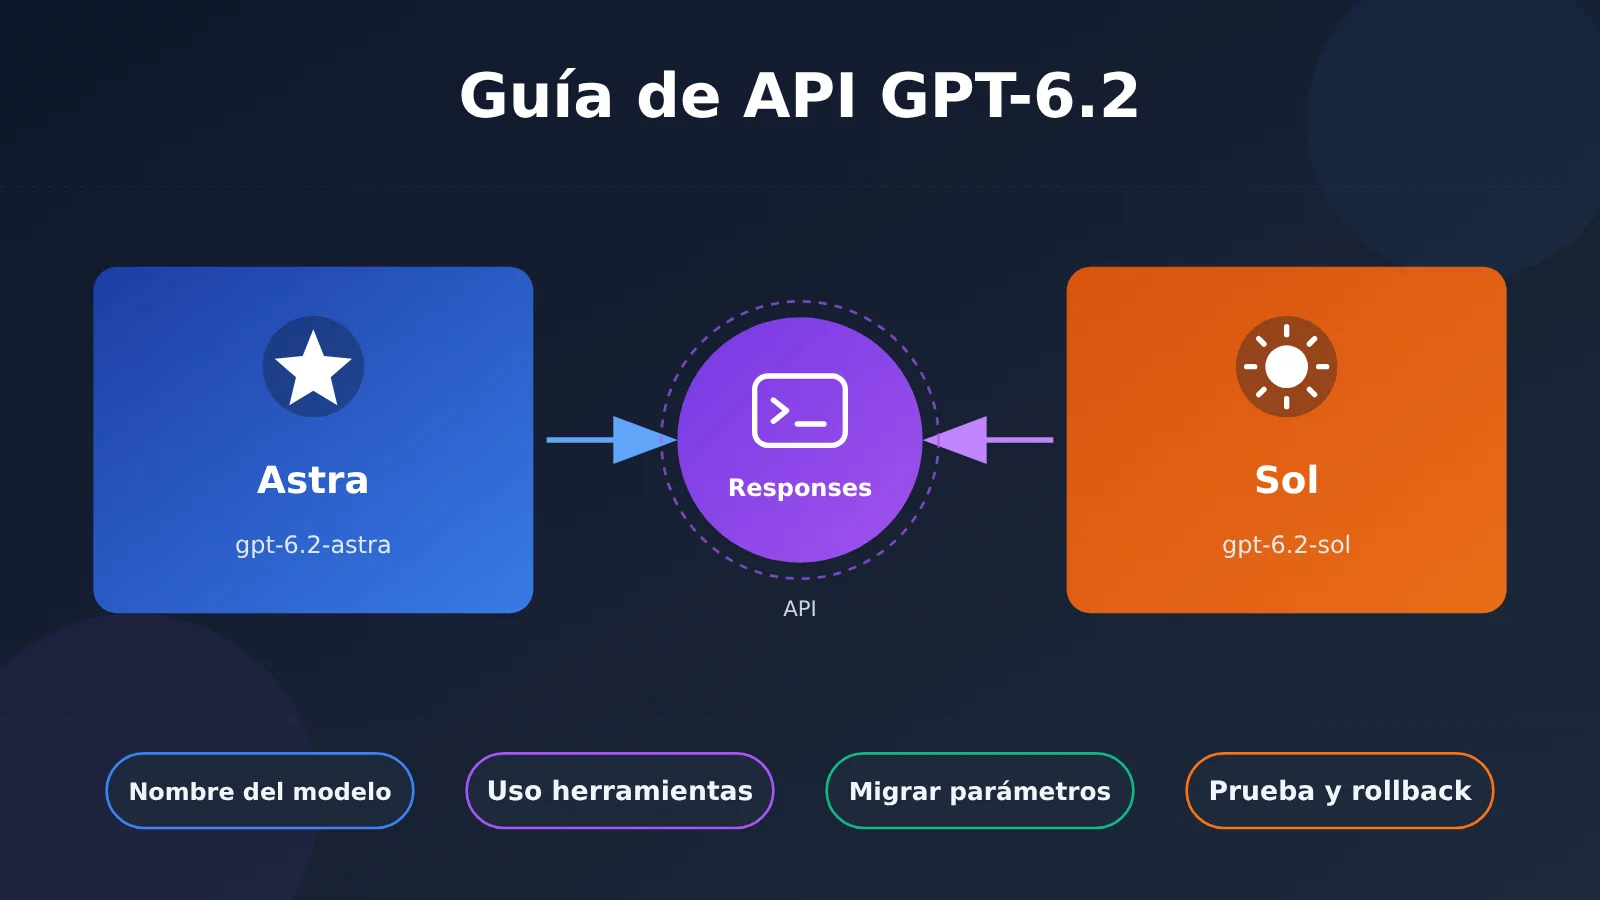
Respuesta directa: Al integrar la API de GPT-6.2, cambia el nombre del modelo a gpt-6.2-astra o gpt-6.2-sol. Para una integración nueva, se recomienda usar medium como intensidad de razonamiento; en código antiguo, none o minimal deben cambiarse a low. Las solicitudes solo de texto todavía pueden usar Chat Completions, pero en cuanto haya llamadas a herramientas, es obligatorio usar Responses API. Además, hay que eliminar parámetros de muestreo como temperature y top_p. Si migras desde GPT-5.5 o una versión anterior, también debes cambiar el parámetro de caché a prompt_cache_options.ttl="30m". Lo que más se pasa por alto en la migración es el prefijo del historial: las nuevas instrucciones deben añadirse después del historial existente, no reescribir el historial.
¿Qué puedes llevarte de este artículo?
- Qué información está confirmada sobre GPT-6.2 Astra y Sol, publicados por OpenAI el 17 de noviembre de 2026, y qué forma parte de la promoción de las evaluaciones oficiales.
- El precio estándar de la API de ambos modelos y el multiplicador de facturación cuando la entrada supera 272K.
- Una lista de migración de parámetros por versión: qué cambios aplican a todas las migraciones a GPT-6.2 y cuáles solo a GPT-5.5 y versiones anteriores.
- Un ejemplo de bucle de llamadas a herramientas de Responses reescrito a partir del formato oficial.
- Cómo diagnosticar errores comunes y una lista de verificación para la aceptación con tráfico reducido y la reversión.
Índice: Primero, con «Para saber» y «Resumen de impacto», unificamos terminología y vemos cómo afecta a los distintos roles. La primera parte, «Hechos objetivos», reúne los puntos clave del anuncio, las evaluaciones oficiales, los precios y la guía de migración original. La segunda parte, «Práctica de migración y criterio analítico», cubre en orden la selección del modelo, un ejemplo mínimo, la lista de parámetros, el bucle de herramientas, el diagnóstico de errores y la aceptación y reversión; esta parte corresponde a criterio editorial y recomendaciones operativas.
GPT-6.2 API: conceptos clave
| Concepto | Explicación breve |
|---|---|
| GPT-6.2 Astra / Sol | Los dos modelos que OpenAI lanzó en esta ronda. Los nombres de modelo en la API son gpt-6.2-astra y gpt-6.2-sol; Astra tiene un precio más alto y Sol, más bajo |
| Responses API | La interfaz unificada más reciente de OpenAI. Las llamadas a herramientas de GPT-6.2 deben realizarse a través de esta interfaz |
| Chat Completions | La interfaz tradicional de completado de chat. GPT-6.2 todavía permite usarla para enviar solicitudes de solo texto |
| reasoning effort | Nivel de intensidad de razonamiento. La recomendación oficial para nuevas integraciones es usar medium |
| Elementos de razonamiento (reasoning items) | Elementos de salida relacionados con el razonamiento que el modelo devuelve en la respuesta. En conversaciones multiturno y bucles de herramientas, deben devolverse tal cual |
| Prefijo histórico | La secuencia de entrada ya enviada en una conversación multiturno; mantenerla sin cambios favorece los aciertos de caché y la continuidad del razonamiento |
| Caché de indicaciones (prompt caching) | Los prefijos repetidos se pueden facturar a una tarifa más baja de lectura de caché |
| GDPval v2 / ALE / FrontierCode 2.0 | Nombres de evaluación citados por OpenAI en los materiales de lanzamiento; las puntuaciones de los tres no se pueden comparar entre sí mezclándolas |
Panorama rápido del impacto de la API de GPT-6.2
- Desarrolladores que ya tienen aplicaciones con la API de OpenAI: cambiar el nombre del modelo no es difícil; el trabajo principal está en la limpieza de parámetros y el cambio de interfaz. Las aplicaciones de Chat Completions que usan function calling necesitan migrar a Responses API; esta es la principal carga de trabajo de esta ronda de migración.
- Aplicaciones que dependen de parámetros de muestreo: los sistemas que controlan el estilo de salida mediante
temperature,top_p, o que dependen delogprobspara evaluar la confianza, verán que estas capacidades se han eliminado en GPT-6.2 y necesitan cambiar de enfoque. - Responsables de costes: el precio unitario de Astra y Sol difiere 4 veces. Cuando las solicitudes de contexto largo superan 272K, la facturación total de la petición aumenta, así que el presupuesto debe recalcularse según la distribución real de la longitud de las solicitudes.
- Usuarios normales de ChatGPT: el alcance de esta ronda es ChatGPT Work, Codex y la API; Chat normal no entra en el alcance de este lanzamiento.
1. Hechos objetivos de la API de GPT-6.2
Esta sección solo recopila información de los materiales oficiales de OpenAI, con fecha de verificación 18 de noviembre de 2026. Los datos de evaluación que aparecen en el artículo provienen de informes oficiales de OpenAI, no de pruebas realizadas por este equipo.
1.1 Fecha de lanzamiento, nombres de modelos y alcance de disponibilidad de la API de GPT-6.2
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. Los nombres de modelo en la API son gpt-6.2-astra y gpt-6.2-sol. Ambos modelos aceptan entrada de texto e imágenes, producen texto como salida y no tienen capacidad nativa de generación de video.
El despliegue será gradual y abarcará ChatGPT Work, Codex y la API; el ChatGPT Chat estándar no forma parte de esta fase. Por eso, a corto plazo, algunas cuentas u organizaciones puede que aún no puedan invocar estos modelos. Antes de hacer el cambio definitivo, conviene confirmar la disponibilidad dentro de la propia organización.
1.2 Datos oficiales de evaluación de la API de GPT-6.2 (según la versión oficial)
OpenAI presentó los siguientes resultados de evaluación en sus materiales de lanzamiento. Cada dato solo es válido dentro de su propia evaluación:
- GDPval v2: GPT-6.2 Astra supera a GPT-6 Astra en 6.2 puntos porcentuales y genera un 22 % menos de tokens de salida. GPT-6.2 Sol supera a GPT-6.1 Sol en 5.3 puntos porcentuales.
- Agents’ Last Exam (ALE): GPT-6.2 Astra mejora en 5.2 puntos respecto a GPT-6 Astra.
- FrontierCode 2.0: con el nivel de razonamiento max, Sol y Astra difieren en 0.5 puntos, y el coste por tarea es aproximadamente 1/5 del de Astra. Esta conclusión solo se aplica a esta prueba y no debe generalizarse como una conclusión general sobre costes.
Estos tres conjuntos de cifras usan unidades y bases de comparación distintas, así que no se pueden sumar ni ordenar entre sí. Por ejemplo, los «6.2 puntos porcentuales» de GDPval v2 y los «5.2 puntos» de ALE no están en la misma escala.
1.3 Precio estándar de la API de GPT-6.2
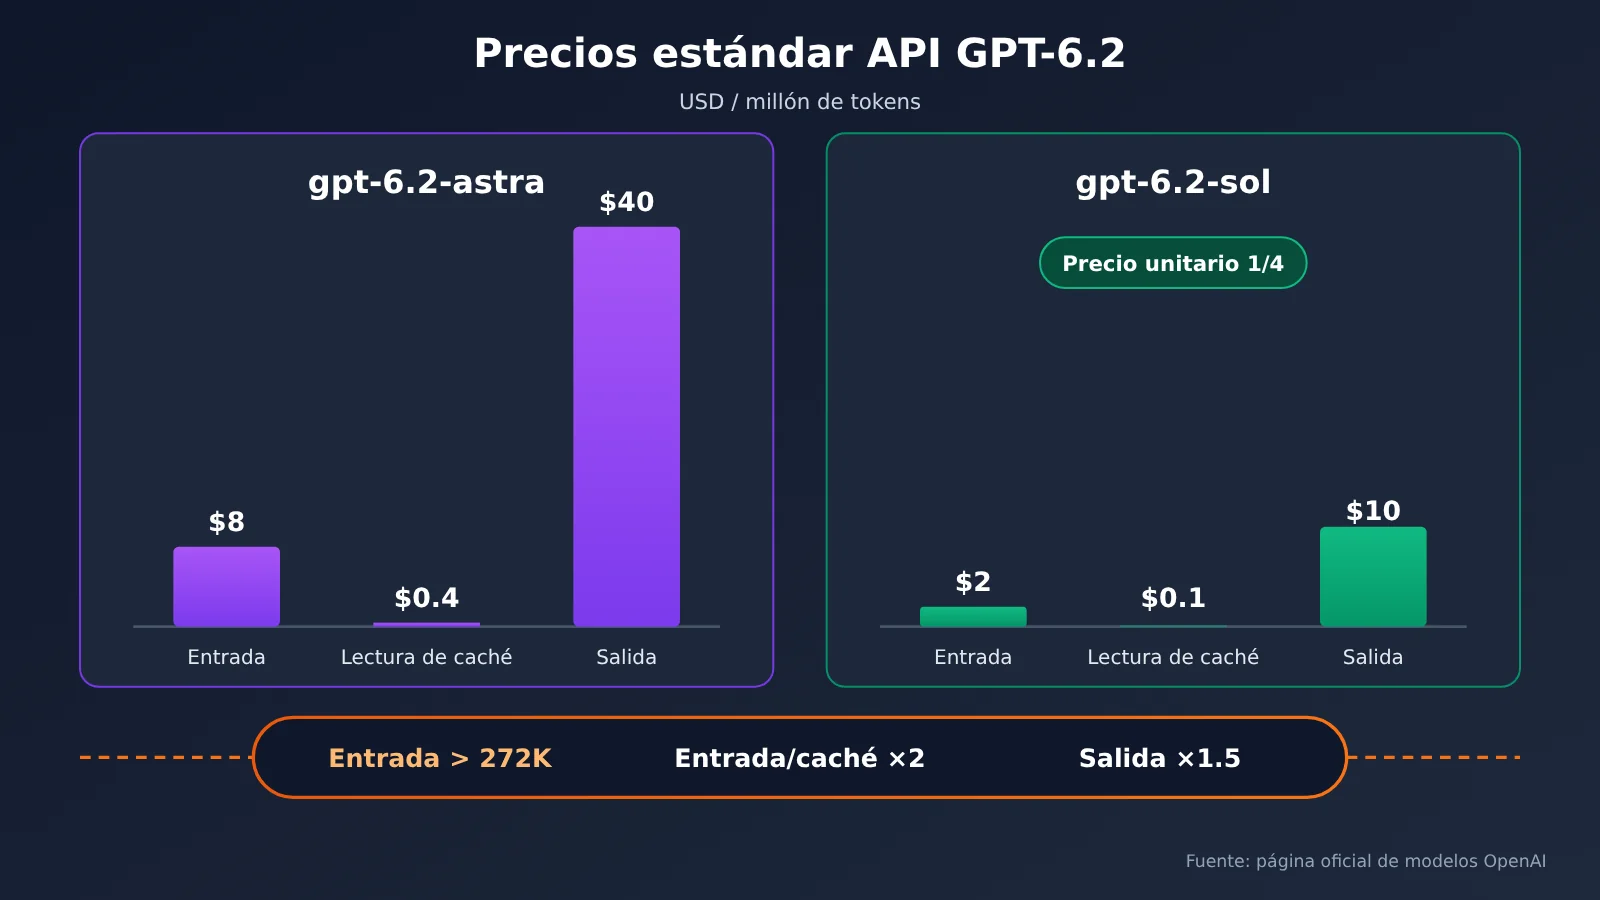
La siguiente tabla muestra el precio estándar oficial de la API, expresado en dólares por millón de tokens:
| Modelo | Entrada sin caché | Lectura de caché | Salida | Cuando la entrada supera 272K |
|---|---|---|---|---|
gpt-6.2-astra |
$8 | $0.4 | $40 | Las tarifas de entrada y caché de toda la solicitud ×2, la salida ×1.5 |
gpt-6.2-sol |
$2 | $0.1 | $10 | Las tarifas de entrada y caché de toda la solicitud ×2, la salida ×1.5 |
Hay dos detalles más que conviene tener en cuenta. Primero, la escritura en caché se cobra aparte y no aparece en la tabla. Segundo, el recargo por contexto largo se calcula sobre «toda la solicitud»: basta que la entrada de una sola solicitud supere 272K para que toda la entrada de esa solicitud se facture al doble, no solo la parte que excede el límite.
1.4 Puntos clave de la guía oficial de migración de la API GPT-6.2
La guía de migración al modelo más reciente de OpenAI (la página latest-model) recoge los siguientes ajustes:
| Aspecto | Chat Completions | Responses API | Aplica a |
|---|---|---|---|
| Llamadas a herramientas | No compatible; es obligatorio cambiar a Responses | Compatible | Todas las aplicaciones que migran a GPT-6.2 |
| Parámetros de muestreo | Se eliminan temperature y top_p |
Se eliminan temperature y top_p |
Todas las migraciones |
| Salidas de probabilidad | Se eliminan logprobs y top_logprobs |
Se elimina top_logprobs y se quita message.output_text.logprobs de include |
Todas las migraciones |
| Intensidad de razonamiento | Las nuevas integraciones usan medium; none y minimal pasan a low |
Lo mismo | Todas las migraciones |
| Retención de caché | prompt_cache_retention pasa a prompt_cache_options.ttl="30m" |
Lo mismo | Migraciones desde GPT-5.5 y versiones anteriores |
Respecto a las conversaciones de varios turnos, la guía también precisa lo siguiente: debe conservarse el prefijo histórico existente, añadir las nuevas instrucciones al final y no reescribir nada. Al cambiar a un modelo inferior, o al cambiar de usuario u organización, se pueden perder elementos de razonamiento.
2. Práctica de migración de GPT-6.2 API y criterios de análisis
Esta sección recoge las valoraciones y recomendaciones operativas que el editor plantea a partir de la información oficial anterior. El código se ha reescrito conforme al formato de la documentación oficial, sin verificarse en ejecución; antes de la integración, revisa cada punto con la documentación oficial.
2.1 Selección de modelo de API GPT-6.2: primero Sol, luego Astra
Si nos fijamos solo en el precio oficial, tanto la entrada como la salida de Sol cuestan 1/4 de lo que cuesta Astra. El resultado de FrontierCode 2.0 según el cual «Sol y Astra difieren en 0.5 puntos y el costo es aproximadamente 1/5» sugiere que, en algunas tareas de programación, la relación calidad-precio de Sol podría ser muy destacada. Sin embargo, esta conclusión proviene de una sola evaluación; para saber si se cumple en tu negocio, tendrás que validarla con tus propios datos.
La estrategia predeterminada que recomienda la editorial es: primero ejecutar el conjunto de regresión completo con gpt-6.2-sol, identificar los tipos de tareas en los que Sol no alcanza los requisitos de calidad y, después, evaluar Astra específicamente para esas tareas. Además, hay que tener en cuenta que el dato de GDPval v2 según el cual Astra «genera un 22% menos tokens de salida» es el resultado de compararlo con GPT-6 Astra, así que no sirve directamente para compensar la diferencia de precio unitario entre Astra y Sol.
💡 Recomendación de selección: al hacer pruebas comparativas entre Astra y Sol, usa el mismo conjunto de regresión y el mismo nivel de razonamiento, y registra por separado la calidad, la latencia y el consumo de tokens. Si necesitas comparar varios modelos desde una misma interfaz, primero consulta en la lista de modelos de APIYI apiyi.com si la serie GPT-6.2 ya está disponible; si no lo está, utiliza directamente la API oficial de OpenAI.
2.2 Ejemplo mínimo de Responses de la API de GPT-6.2
A continuación se muestra el ejemplo mínimo de invocación de solo texto, usando la API Responses y el nivel de razonamiento medium. Primero, instala o actualiza el SDK oficial de Python: python -m pip install --upgrade openai. Configura OPENAI_API_KEY en el entorno de ejecución; no escribas la clave real en el código, el artículo ni el repositorio de versiones. El siguiente ejemplo invoca por defecto la API oficial de OpenAI.
import os
from openai import OpenAI

# Adaptado del formato de la documentación oficial, ejecución no verificada
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # Llama por defecto a la API oficial de OpenAI

response = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "medium"},
    input="用三句话说明什么是提示词缓存。"
)
print(response.output_text)
En el ejemplo, deliberadamente no se escribieron temperature ni top_p, porque GPT-6.2 ya eliminó estos dos parámetros. Si tu función envoltorio los incluye por defecto, necesitas filtrarlos de forma uniforme en la capa de invocación.
🎯 Consejo técnico: Al integrar servicios de terceros como APIYI apiyi.com, primero verifica la documentación oficial de ese servicio, su lista de modelos, el soporte de Responses y el precio real; luego configura su dirección y la clave dedicada que emite. No envíes la clave oficial de OpenAI a direcciones de terceros. Este artículo no verifica la compatibilidad de interfaces de terceros.
2.3 Lista de verificación de migración de parámetros de la API de GPT-6.2
La lista de verificación de migración se divide en dos grupos según la versión de origen, para evitar aplicar a todos los proyectos cambios que solo están pensados para versiones anteriores.
2.3.1 Pasos obligatorios para todos los proyectos que migran a GPT-6.2
- Sustituye el nombre del modelo por
gpt-6.2-astraogpt-6.2-sol, y gestiónalo de forma centralizada en el centro de configuración para facilitar una futura reversión. - Elimina
temperatureytop_p. Si antes usabas una temperatura baja para que la salida fuera más estable, puedes optar por instrucciones más explícitas, un formato de salida estructurado o lógica de validación. - En los proyectos que usan Chat Completions, elimina
logprobsytop_logprobs. En los que usan Responses, eliminatop_logprobsy quitamessage.output_text.logprobsdel arrayinclude. - Nivel de razonamiento: en nuevas integraciones, usa
mediumpor defecto; si antes estaba configurado comononeominimal, cámbialo alow. - Todas las solicitudes que incluyan
toolsdeben pasar a usar la API de Responses.
2.3.2 Pasos necesarios solo al migrar desde GPT-5.5 o versiones anteriores
- Cambia
prompt_cache_retentionporprompt_cache_options.ttl="30m". - Después de migrar, comprueba que la tasa de aciertos de caché sea normal. El precio de lectura desde caché es solo 1/20 del de una entrada no cacheada; una caída en la tasa de aciertos disparará directamente los costos.
Si migras desde GPT-6 o GPT-6.1, los puntos de la lista 2.3.1 también deben revisarse uno por uno. En el código de llamadas a herramientas que ya usaba Responses, confirma también que no queden parámetros eliminados.
2.4 GPT-6.2 API: ciclo de herramientas y prefijo de historial
La invocación de herramientas es la parte de mayor riesgo en esta migración. En la API Responses, un ciclo completo de herramientas consta de cuatro pasos: el modelo devuelve un elemento function_call; tu código ejecuta la función correspondiente; el resultado se añade a la entrada como function_call_output; y se vuelve a solicitar al modelo. El modelo puede seguir solicitando herramientas, así que no se debe asumir que la segunda respuesta será necesariamente la respuesta final.
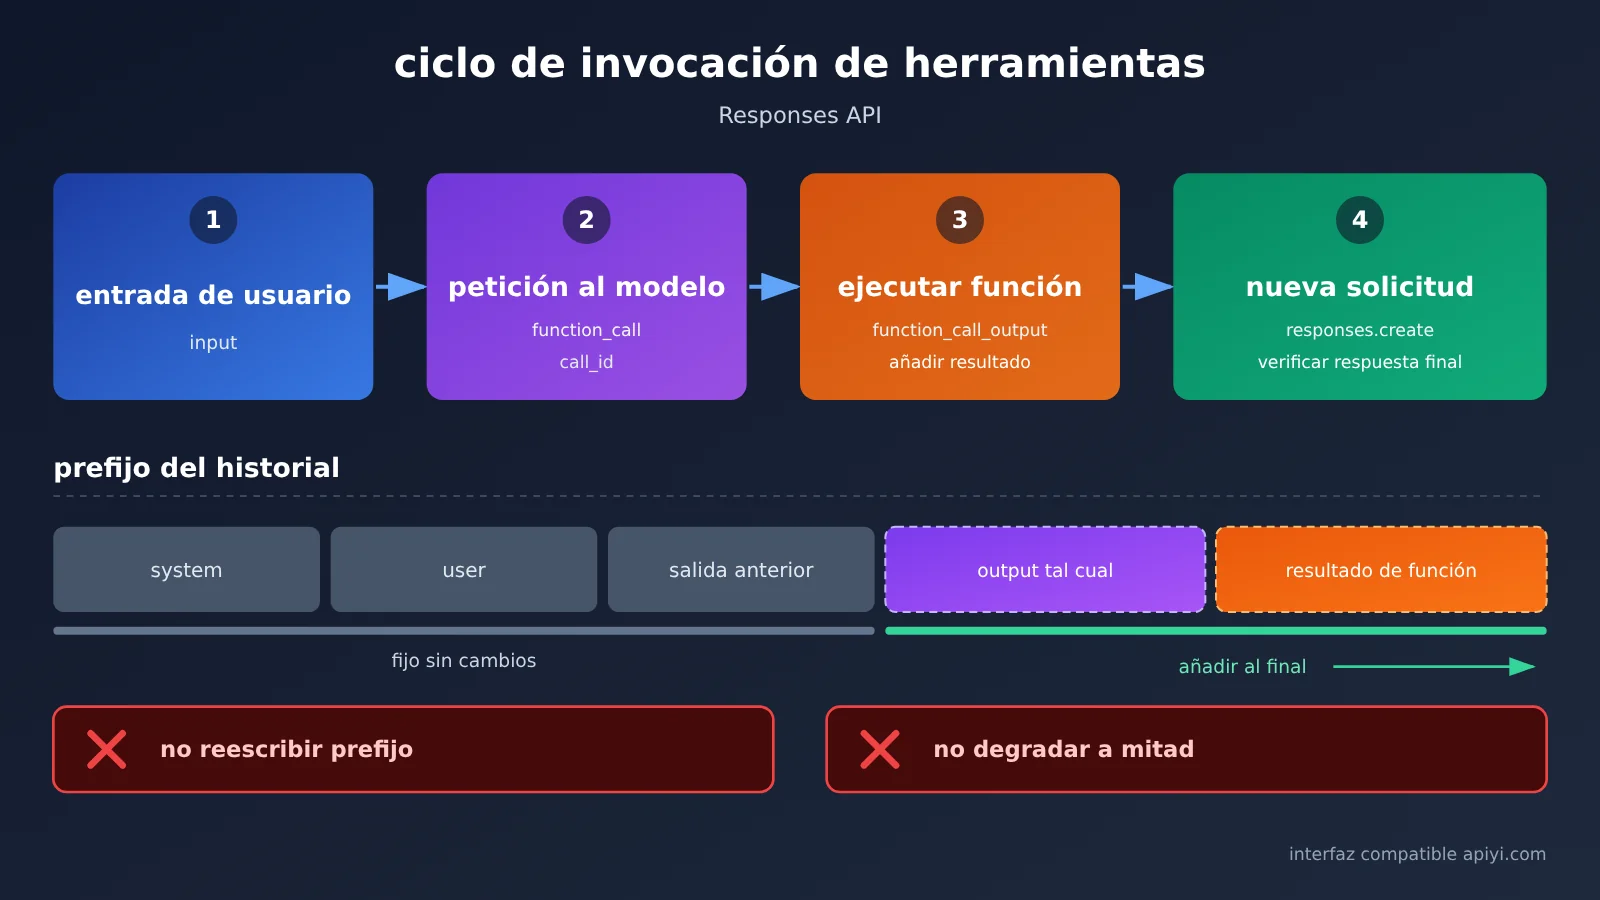
El principio clave es: añadir el output devuelto por el modelo al historial tal cual, sin filtrar ni recomponerlo. Los elementos de razonamiento están incluidos en esas salidas. Si solo se conserva la parte de texto, o si se reescribe a mitad de camino una instrucción de sistema anterior, las rondas siguientes pueden perder la continuidad del razonamiento y el prefijo de caché también dejará de ser válido.
Ver ejemplo de llamada a función de un solo turno (adaptado del formato oficial, no verificado en ejecución)
import os
import json
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # Llama a la API oficial de OpenAI de forma predeterminada

MODEL = "gpt-6.2-sol"

tools = [{
    "type": "function",
    "name": "get_order_status",
    "description": "根据订单号查询订单状态",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False
    },
    "strict": True
}]

def get_order_status(order_id: str) -> dict:
    # Reemplaza con tu lógica de negocio real
    return {"order_id": order_id, "status": "shipped"}

# Prefijo de historial existente: mantenerlo intacto, añadir solo al final
history = [
    {"role": "user", "content": "帮我查一下订单 A1024 的状态"}
]

first = client.responses.create(
    model=MODEL,
    input=history,
    tools=tools,
    reasoning={"effort": "medium"}
)

# Añadir la salida del modelo tal cual (incluye elementos de razonamiento y elementos function_call)
history += first.output

for item in first.output:
    if item.type == "function_call" and item.name == "get_order_status":
        args = json.loads(item.arguments)
        result = get_order_status(**args)
        history.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(result, ensure_ascii=False)
        })

final = client.responses.create(
    model=MODEL,
    input=history,
    tools=tools,
    reasoning={"effort": "medium"}
)
if final.status != "completed":
    raise RuntimeError(f"响应未完成:{final.status}")
if any(item.type == "function_call" for item in final.output):
    raise RuntimeError("模型仍请求工具;请按相同流程继续处理,不能当作最终答复")
print(final.output_text)
La función anterior devuelve datos de demostración, no realiza una consulta real de pedidos; el ejemplo muestra solo una ronda de llamada a función. En producción también hay que validar el nombre de la llamada y los parámetros, comprobar los permisos de consulta, gestionar errores de herramientas, establecer un ciclo con límite para las solicitudes de herramientas posteriores, y manejar tiempos de espera y respuestas incompletas.
Cuando necesites añadir una nueva restricción, por ejemplo «a partir de ahora responde en inglés», debes añadirla como una nueva entrada al final de history, sin volver atrás a modificar la instrucción inicial. Dentro de una misma sesión no cambies a un modelo de versión inferior ni migres la sesión entre usuarios u organizaciones. La documentación oficial ya lo indica: estos cambios pueden provocar la pérdida de los elementos de razonamiento.
2.5 Diagnóstico de errores de la API GPT-6.2
La siguiente tabla ordena las direcciones de diagnóstico según los puntos clave de la migración oficial. «Posible causa» es una inferencia editorial; el texto exacto del error dependerá de lo que devuelva realmente la API:
| Síntoma | Posible causa | Cómo resolverlo |
|---|---|---|
| Solicitud rechazada, indicando que el parámetro no es compatible | Quedan parámetros eliminados como temperature, top_p, logprobs |
Filtrarlos de forma uniforme en la capa de encapsulación de la llamada |
Falla Chat Completions cuando lleva tools |
La invocación de herramientas de GPT-6.2 solo funciona con Responses | Migrar a responses.create |
| Error en el nivel de razonamiento | Se sigue usando none o minimal |
Cambiar a low |
| La configuración de caché no surte efecto o la tasa de aciertos cae en picado | Se sigue usando prompt_cache_retention, o se reescribió el prefijo del historial |
Cambiar a prompt_cache_options.ttl="30m" y mantener el prefijo estable |
| La calidad cae notablemente en la segunda mitad de una conversación de varios turnos | No se devolvieron los elementos de razonamiento, o se degradó el modelo a mitad de camino / se cambió de organización | Añadir output tal cual y fijar un único modelo por sesión |
| La factura supera con creces lo estimado | Algunas solicitudes de entrada superan 272K y activan el recargo sobre toda la cuenta | Analizar la distribución de longitud de entrada y truncar o resumir las solicitudes largas |
| El nombre del modelo no existe o no hay permisos | La apertura oficial es gradual, o la interfaz de terceros aún no ofrece ese modelo | Confirmar los permisos de la organización; para interfaces de terceros, guiarse por la lista de modelos de la plataforma |
🛠 Consejo de diagnóstico: si el problema solo aparece en la interfaz de terceros, primero envía la misma solicitud a través de la API oficial como referencia. Así puedes determinar si el problema está en tu código o en la capa de compatibilidad de la interfaz. Si encuentras problemas de compatibilidad en APIYI apiyi.com, puedes contactar al soporte técnico de la plataforma indicando el ID de la solicitud.
2.6 Aceptación con tráfico reducido y rollback del API GPT-6.2
La recomendación al editar es no cambiar todo de una vez, sino avanzar en tres pasos: «prueba en sombra → despliegue gradual en pequeña proporción → ampliación». En cada paso hay que definir criterios claros de aceptación y condiciones de rollback:
| Etapa | Recomendación de tráfico | Criterios de aceptación | Condiciones que activan el rollback |
|---|---|---|---|
| Prueba en sombra | Duplicar las solicitudes de producción, sin devolver los resultados al usuario | Calidad del conjunto de regresión, tasa de éxito de llamadas a herramientas, tasa de parseo de salida estructurada | La calidad en tareas clave es claramente inferior a la del modelo anterior |
| Despliegue gradual en pequeña proporción | Un grupo reducido de usuarios reales | Tasa de errores, latencia P95, número de tokens por solicitud, tasa de aciertos de caché | La tasa de errores o el costo supera el umbral predefinido |
| Ampliación | Aumentar la proporción de forma progresiva | Proporción de solicitudes con contexto largo, costo diario, comentarios de usuarios | Aparecen muchas solicitudes que superan 272K y el costo se descontrola |
El diseño del rollback tiene dos puntos clave. Primero, el nombre del modelo, el tipo de interfaz y el nivel de razonamiento deben estar en flags de configuración; al hacer rollback solo se cambia la configuración, sin volver a desplegar una nueva versión. Segundo, el rollback se hace por sesión nueva: las sesiones que ya están en curso con GPT-6.2 deberían, en lo posible, terminar con el modelo original, para evitar que una degradación a mitad de camino provoque la pérdida de elementos de razonamiento.
🚀 Inicio rápido: al hacer un despliegue gradual, puedes usar la misma clave API en APIYI apiyi.com para llamar al modelo anterior y al modelo candidato y compararlos, siempre que la plataforma ofrezca los modelos correspondientes. Esto debe verificarse en la consola de la plataforma; este artículo no lo garantiza.
En esta migración a GPT-6.2, el verdadero trabajo no está en cambiar el nombre del modelo, sino en tres frentes: mover las llamadas a herramientas a Responses, limpiar los parámetros eliminados y mantener estable el prefijo del historial. Las evaluaciones oficiales señalan direcciones que vale la pena observar, especialmente la relación costo-beneficio de Sol en algunas tareas. Pero si esas cifras se cumplen en tu negocio es algo que solo pueden responder tu propio conjunto de regresión y los datos del despliegue gradual.
Lo que se aprende en el papel siempre es superficial; para conocer de verdad este asunto, hay que ponerlo en práctica. — Lu You, Leyendo libros en una noche de invierno para mi hijo Yu
Referencias
Para la estructura del código, consulta también la Guía de inicio rápido de OpenAI y la Guía de llamada a funciones. Este artículo solo revisa la documentación y la estructura del código; no se realizaron pruebas pagadas con la API.
-
Anuncio de OpenAI: presentación de GPT-6.2 Astra y Sol
- Enlace: Documentación oficial
- Descripción: fecha de lanzamiento, datos de evaluación y alcance de disponibilidad
-
Página del modelo de OpenAI: GPT-6.2 Astra
- Enlace: Documentación oficial
- Descripción: nombre del modelo, modalidades y precios estándar
-
Página del modelo de OpenAI: GPT-6.2 Sol
- Enlace: Documentación oficial
- Descripción: nombre del modelo, modalidades y precios estándar
-
Guía de migración de OpenAI: modelo más reciente
- Enlace: Documentación oficial
- Descripción: eliminación de parámetros, niveles de razonamiento, configuración de caché y requisitos de prefijo histórico
-
Centro de ayuda de OpenAI: ChatGPT Work y Codex
- Enlace: Documentación oficial
- Descripción: notas de disponibilidad en ChatGPT Work y Codex
Autor: Equipo técnico de APIYI
Contacto técnico: si durante la migración encuentras problemas de compatibilidad de interfaces, puedes contactarnos desde la página principal de APIYI (apiyi.com). Para más recursos de integración, consulta el centro de documentación en docs.apiyi.com.