Nota del autor: A partir de una tarea de desarrollo de software de Agent de 30 minutos, desglosamos los costos de las entradas normales, las escrituras y lecturas de caché, las salidas y los intercambios con herramientas durante varias llamadas de Agent. Comparamos cómo cobran la caché tres proveedores y usamos un ejemplo de 12 llamadas para explicar en qué condiciones la caché realmente permite ahorrar.
El 9 de noviembre de 2026, Google Cloud presentó TPU 8tx y TPU 8i Max, dos sistemas TPU de octava generación, y publicó como código abierto TPU Sync, una solución para transferir KV Cache. La «barrera de memoria de la era de los Agent» vuelve a estar en el centro de la conversación. Es natural que muchos desarrolladores se pregunten: si la KV Cache subyacente es cada vez más rápida, ¿también bajará la factura de API de mi Agent?
Qué te aporta este artículo: al terminar, tendrás una fórmula completa para calcular los costos de Agent, una comparación de las tarifas de caché de tres proveedores y una lista de optimizaciones de costos que podrás aplicar de inmediato.
Costos de API en llamadas multi-turno de Agent: resumen de los puntos clave
| Elemento | Detalles |
|---|---|
| Contexto | El 9 de noviembre de 2026, Google presentó TPU 8tx, TPU 8i Max y TPU Sync, con el foco puesto en los cuellos de botella de memoria y KV Cache de Agent |
| Pregunta que interesa a los desarrolladores | ¿Las optimizaciones de bajo nivel pueden traducirse en facturas más bajas por el uso de la API de Agent? |
| Conclusión principal | La factura depende conjuntamente de los tokens de entrada normales, las escrituras y lecturas de la caché, los tokens de salida, el número de llamadas y el costo de las herramientas |
| Variables clave | Si el prefijo es estable, si el TTL de la caché cubre el tiempo de espera de las herramientas y si el contexto histórico se descontrola |
| Ámbitos afectados | Escenarios de llamadas multi-turno, como los agentes de programación, los agentes para documentos extensos y la colaboración entre varios agentes |
Cómo es una tarea de 30 minutos con llamadas multi-turno de Agent
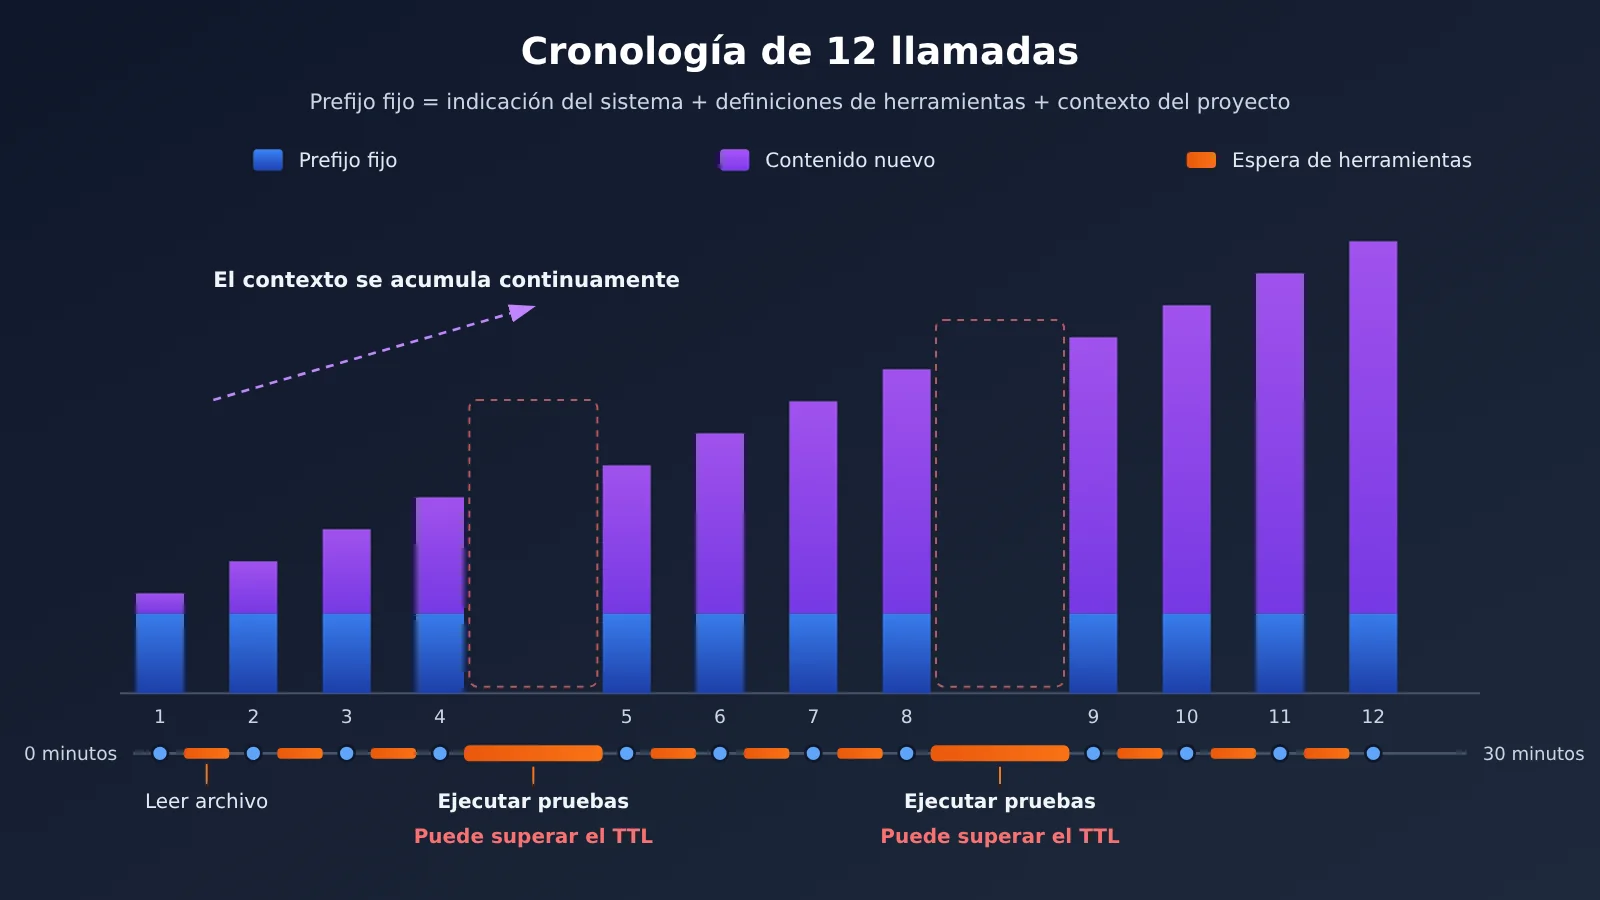
Imagina que un agente de desarrollo de software recibe el encargo de corregir una prueba fallida de un módulo. Primero lee la estructura del proyecto y el código fuente relacionado, propone una solución, usa herramientas para modificar archivos y ejecutar pruebas, espera los resultados y, después, sigue razonando a partir de los errores. En 30 minutos, este ciclo de «razonar—usar herramientas—esperar—razonar» puede repetirse más de diez veces.
El problema es que, en esencia, la API de un Modelo de Lenguaje Grande no tiene estado. En cada solicitud, el agente tiene que volver a enviar al modelo la indicación del sistema, las definiciones de las herramientas, el contexto del proyecto y el historial de conversaciones y resultados de las herramientas. La solicitud número 12 suele incluir casi todo el historial de las 11 rondas anteriores. De ahí viene la «recomputación del contexto».
¿De qué se compone el costo de las llamadas a la API en varias rondas de un agente?
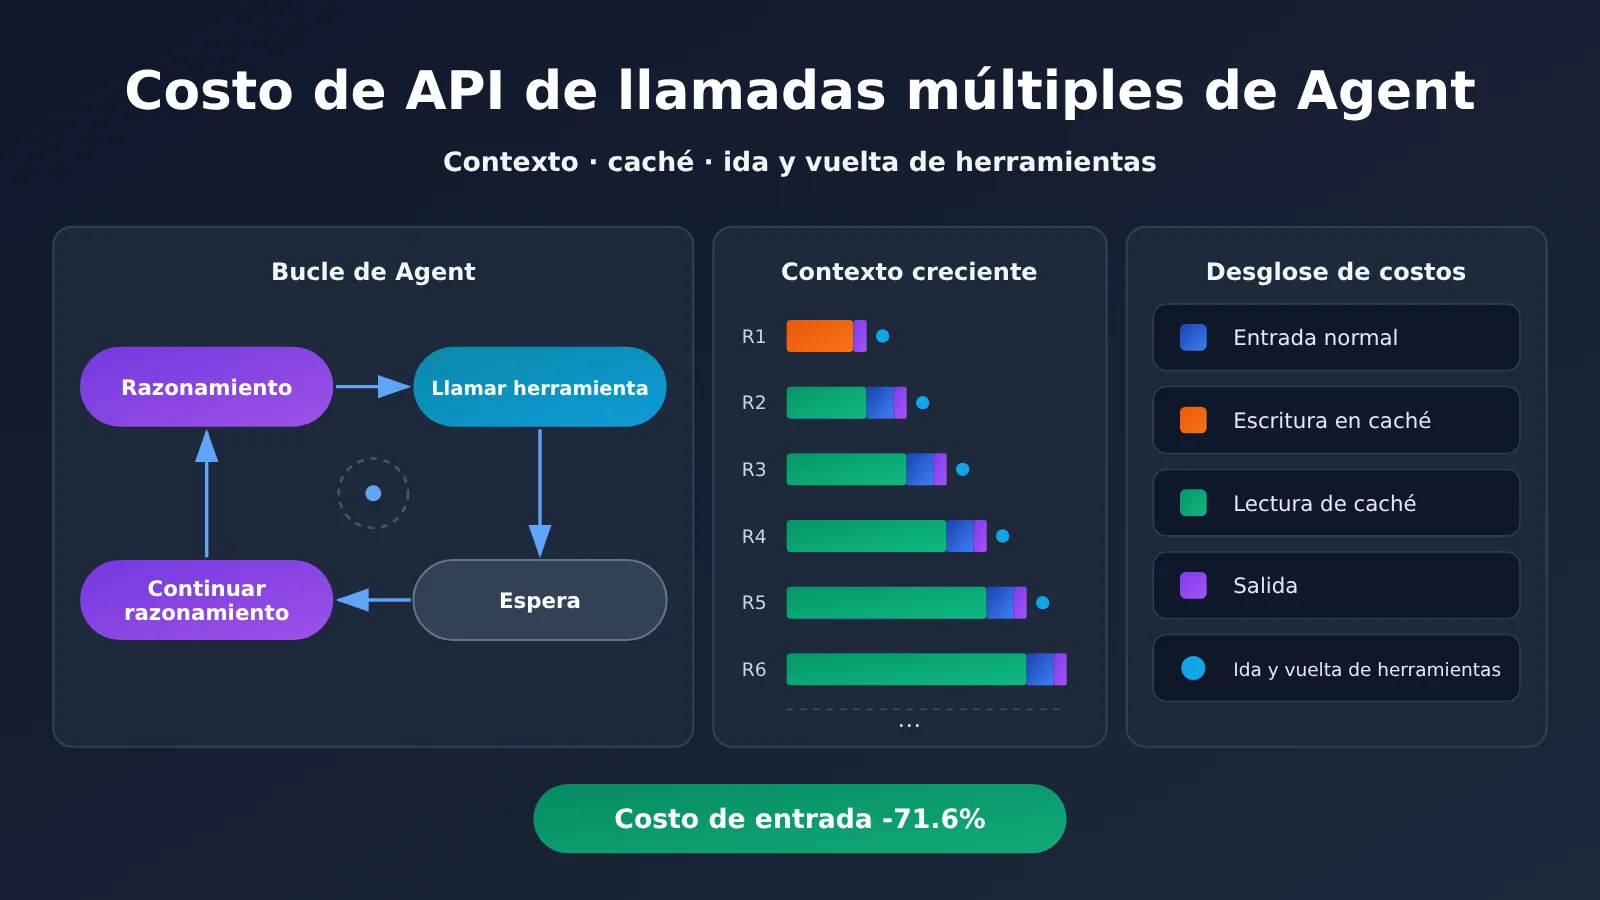
Si desglosamos una tarea de un agente, el costo incluye al menos cinco componentes. Los cuatro primeros corresponden al costo de los tokens del modelo; el quinto se genera fuera del modelo, pero suele pasarse por alto.
| Concepto de costo | Significado | Características de facturación |
|---|---|---|
| Entrada normal | Tokens de entrada que no se benefician de la caché y se cobran a la tarifa estándar | Precio estándar de entrada |
| Escritura en caché | Parte de la entrada que se usa para crear una caché reutilizable | Algunos proveedores y modelos la cobran con una tarifa superior a la de entrada estándar |
| Lectura de caché | Entrada que coincide con una caché existente | Suele costar mucho menos que la entrada estándar |
| Tokens de salida | Contenido generado por el modelo, incluidos los parámetros de las llamadas a herramientas | Suele ser el componente más caro por token; la caché no reduce su costo |
| Herramientas y ejecución externa | Servicios externos, como búsquedas, ejecución de código y bases de datos | Se cobran según las tarifas de cada servicio y aumentan el número de llamadas al modelo |
Con esto, podemos expresar el costo de una tarea con la siguiente fórmula:
Costo total de la tarea = Σ (entrada normal × precio de entrada + escritura en caché × precio de escritura + lectura de caché × precio de lectura + salida × precio de salida) + costo de herramientas y ejecución externa
El símbolo Σ indica que se suman todas las llamadas al modelo que se hacen durante la tarea. Esto significa que el número de llamadas también es un multiplicador: cuantas más interacciones con herramientas haya, más llamadas al modelo se realizarán y más veces se cobrará el prefijo fijo. Las llamadas a herramientas no solo cuestan lo que cobra cada herramienta: también dividen una inferencia en varias llamadas, cada una de las cuales debe volver a incluir el contexto.
Diferencias entre KV Cache, Prompt Cache y compresión del contexto en llamadas de Agent con varias rondas
Al hablar de los costos de Agent, estos tres conceptos se confunden con facilidad. Pertenecen a capas distintas y tienen efectos muy diferentes en la factura.
| Tecnología | Capa | Qué significa | Efecto para quienes usan la API |
|---|---|---|---|
| KV Cache | Inferencia del modelo | Guarda los estados Key/Value de los cálculos de atención para evitar volver a procesar los tokens del historial | El usuario no lo controla directamente; afecta los costos y la latencia del proveedor |
| Prompt Cache | Servicio de API | El proveedor reutiliza prefijos de indicaciones repetidos y factura por separado las escrituras y lecturas de la caché | Se refleja directamente en los campos de caché de la factura |
| Compresión del contexto | Aplicación | Resume, filtra o recorta el historial antes de incluirlo en la solicitud | Reduce los tokens enviados, pero puede hacer que se pierdan detalles |
Conviene tener en cuenta que la documentación oficial de OpenAI indica que Prompt Cache guarda tensores KV, no el texto original de los tokens. Por eso, Prompt Caching puede entenderse como una forma de ofrecer y facturar la reutilización de estados KV de bajo nivel. No es algo completamente independiente de KV Cache, pero lo único que el usuario puede percibir son las reglas de facturación.
La compresión del contexto es otra cosa. Cambia qué información se incluye en las solicitudes posteriores, no cómo se reutiliza. Cuanto más agresiva sea la compresión, menos tokens se usarán, pero también aumentará el riesgo de que Agent olvide detalles importantes.
Por qué las optimizaciones de bajo nivel en las llamadas de Agent con varias rondas no reducen necesariamente la factura
El TPU 8i Max que acaba de presentar Google duplica el ancho de banda de HBM y la memoria SRAM integrada en el chip. En pruebas internas sobre la plataforma Ironwood, TPU Sync redujo en más de un 90 % la latencia de transferencia de KV Cache. Por su parte, Agent Compute Engine pausa las sesiones cuando Agent está inactivo y traslada la memoria de trabajo fuera del chip. Estas optimizaciones mejoran el aprovechamiento de recursos del proveedor y reducen la latencia de inferencia —por ejemplo, el TTFT—, lo que para el usuario puede traducirse en respuestas más rápidas.
Sin embargo, los precios de la API son una decisión comercial del proveedor, y la factura del usuario sigue calculándose por tokens. Una mayor eficiencia del hardware podría influir en los precios a largo plazo, pero no hay una relación automática ni proporcional entre ambas cosas. Además, a fecha de 2026-11-10, TPU 8tx y TPU 8i Max siguen marcados como Coming soon y todavía no se han anunciado sus precios. Para los desarrolladores, lo que pueden controlar de inmediato es la estructura de sus tokens, no el hardware del proveedor.
Coste de las llamadas de API en varias rondas de agentes: comparación de la facturación de caché de tres proveedores
Los tres principales proveedores ofrecen mecanismos de caché, pero difieren bastante en cómo se activan, en el TTL y en la forma de calcular los cargos. La siguiente tabla se basa en la documentación oficial de cada proveedor; consulta la información del modelo y la interfaz correspondiente para conocer los detalles concretos.
| Proveedor | Mecanismo de caché | Opciones de TTL | Coste de escritura | Coste de lectura | Plataformas disponibles |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching, con caché automática de prefijos en los modelos compatibles | En algunos modelos nuevos, 30 minutos de forma predeterminada; algunos admiten 12 horas | En los modelos e interfaces con la configuración correspondiente: 1,25 veces el precio de la entrada normal para 30 minutos y 2,5 veces para 12 horas; es posible que otros modos de caché no cobren un coste adicional de escritura | Por lo general, 0,1 veces el precio de la entrada normal; en algunos modelos, menos | API oficial, APIYI apiyi.com |
| Anthropic | Prompt Caching | 5 minutos de forma predeterminada, ampliables a 1 hora | 1,25 veces el precio de la entrada normal para 5 minutos y 2 veces para 1 hora | Varía según el modelo | API oficial, APIYI apiyi.com |
| Google Gemini | Context Caching, con caché implícita y explícita | El TTL de la caché explícita se puede configurar | La caché explícita tiene un coste adicional, calculado según el número de tokens almacenados en caché y el tiempo de almacenamiento | Los aciertos reducen el coste de las entradas repetidas | API oficial, APIYI apiyi.com |
Tomemos como ejemplo los precios oficiales de Claude Sonnet 5.5: la entrada normal cuesta $2.00 por millón de tokens, la escritura en caché de 5 minutos cuesta $2.50, la escritura en caché de 1 hora cuesta $4.00 y la lectura desde caché cuesta $0.10. La lectura desde caché cuesta solo el 5 % de la entrada normal, por eso reutilizar un prefijo puede reducir tanto los costes.
Ten en cuenta que OpenAI indica expresamente que no se garantiza que haya un acierto de caché en cada llamada. Además, la caché explícita de Gemini no implica un «almacenamiento gratuito»: el tiempo de almacenamiento también se factura. La caché ofrece un descuento condicionado, no una rebaja que se aplique automáticamente.
🎯 Recomendación técnica: las capacidades de caché, las reglas de facturación y los campos de respuesta varían según el modelo de cada proveedor. Usar una pasarela unificada no hace que todos los modelos reciban automáticamente el mismo descuento por caché. Te recomendamos probar los modelos candidatos por separado con el mismo código compatible con OpenAI a través de APIYI apiyi.com y basarte en los campos
usagedevueltos y en la factura real.
Cálculo real del costo de caché en llamadas de Agent en varias rondas: ejemplo de 12 llamadas
Retomemos la tarea de desarrollo de 30 minutos del apartado anterior y usemos los precios oficiales de Claude Sonnet 5.5 para crear un ejemplo. Supongamos lo siguiente:
- La tarea invoca el modelo 12 veces, con 22.000 tokens de entrada en cada llamada;
- 20.000 tokens de cada llamada corresponden al indicación del sistema, las definiciones de herramientas y el contexto del proyecto, que se repiten;
- Se añaden 2.000 tokens nuevos en cada llamada;
- Se usa una caché de 1 hora y las solicitudes posteriores la reutilizan correctamente.
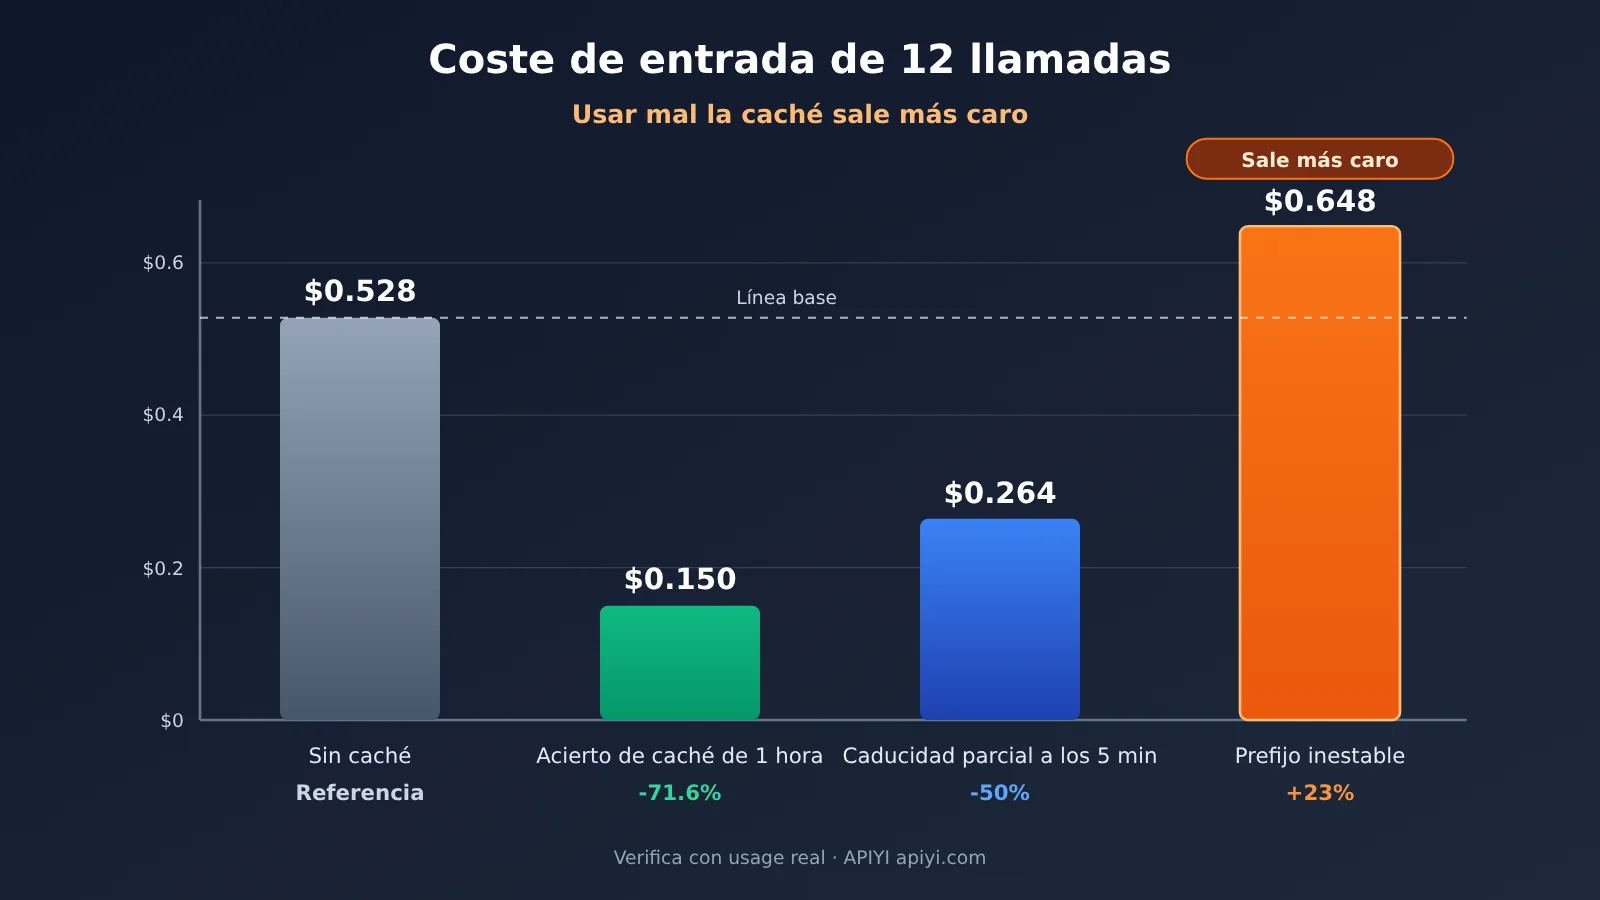
Sin caché: 12 × 22.000 × $2 / 1.000.000 = $0.528.
Con caché de 1 hora: la primera escritura de 20.000 tokens cuesta $0.080; los 2.000 tokens de entrada normal de la primera llamada cuestan $0.004; las 11 lecturas posteriores de la caché cuestan $0.022; y los 11 aportes de entrada nuevos cuestan $0.044. El total es $0.150, lo que supone un ahorro de aproximadamente 71,6 % en el costo de entrada.
Este ejemplo solo calcula los tokens de entrada; no incluye los tokens de salida, las llamadas a herramientas ni los costos de servicios externos. En un Agent real, el historial también crece con cada ronda, pero la conclusión sigue siendo la misma: el contexto repetido es uno de los costos que más tienden a crecer en las llamadas de un Agent a lo largo de varias rondas.
Cómo afectan al costo de Agent los fallos de caché, los cambios de prefijo y el TTL
Lo anterior representa el caso ideal. A continuación, usando los mismos precios, analizamos tres situaciones habituales que pueden reducir el ahorro. (Son escenarios ilustrativos calculados en este artículo con los precios oficiales por unidad).
| Escenario | Supuesto | Costo de entrada | Respecto al caso sin caché |
|---|---|---|---|
| Sin caché | Las 12 llamadas se cobran como entradas normales | $0.528 | Referencia |
| Caché de 1 hora con aciertos en todas las llamadas | 1 escritura y 11 lecturas | $0.150 | Ahorro de aproximadamente 71,6 % |
| Caché de 5 minutos con aciertos en todas las llamadas | Precio de escritura de $2.50 y 11 lecturas | $0.120 | Ahorro de aproximadamente 77,3 % |
| Caché de 5 minutos con fallos parciales | El tiempo de espera de las herramientas provoca 4 escrituras y 8 lecturas | $0.264 | Ahorro de aproximadamente 50 % |
| Prefijo inestable | El prefijo cambia en cada llamada; las 12 se cobran como escrituras de 5 minutos | $0.648 | Se gasta aproximadamente un 23 % más |
Estas observaciones pueden servir directamente para tomar decisiones:
- El TTL debe cubrir el tiempo de espera de las herramientas: la escritura en una caché de 5 minutos es más barata, pero si la ejecución de pruebas o una confirmación manual tarda más de 5 minutos, la caché caduca y hay que volver a escribirla. El ahorro se reduce de forma notable.
- La estabilidad del prefijo importa más que el TTL: si colocas marcas de tiempo o ID aleatorios al principio de la indicación, cada solicitud tendrá un prefijo diferente y no podrá reutilizar la caché. En los modos que cobran un recargo por escritura, la caché puede hacer que la factura sea más alta.
- Un TTL más largo no siempre es mejor: el precio de escritura para 1 hora es 1,6 veces el de 5 minutos. Solo conviene si existe una posibilidad real de que el intervalo entre llamadas supere los 5 minutos.
Cómo reducir el costo de API en las llamadas de varias rondas de un agente
Ejemplo mínimo: registrar los aciertos de caché de cada llamada
El primer paso para optimizar es «hacer visible» el costo. El siguiente código envía una solicitud mediante una interfaz compatible con OpenAI e imprime los campos relacionados con la caché incluidos en usage:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="your-model-name",  # Sustituye esto por el modelo que quieras probar
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
Ver la implementación completa: prefijo estable + seguimiento del costo por tarea
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Prefijo fijo: coloca al principio las instrucciones del sistema, las definiciones de herramientas y el contexto compartido del proyecto, y mantenlo idéntico byte por byte
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # Precio unitario: dólares por millón de tokens; usa el precio oficial del modelo elegido
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # Añade solo los mensajes nuevos, sin reordenar el historial; deja la información dinámica (como las marcas de tiempo) para el final
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
Ten en cuenta que la estimación anterior solo contempla el descuento por lectura. Si el modelo utilizado cobra por separado las escrituras en caché, tendrás que añadir ese concepto según los campos que devuelva. Los nombres y significados de los campos de usage pueden variar entre modelos; consulta la respuesta real.
🚀 Inicio rápido: Te recomendamos probar primero el script de seguimiento en APIYI, apiyi.com, usando el crédito de prueba gratuito. Así podrás comparar la tasa de aciertos de caché y el costo por tarea en distintos modelos antes de decidir qué modelo y qué TTL usar en producción.
Cinco acciones para optimizar el costo de las invocaciones de Agent en varias rondas
- Mantén estable el prefijo de la indicación: coloca primero las instrucciones del sistema, las definiciones de herramientas y el material de referencia compartido; deja las marcas de tiempo y la información dinámica del usuario para el final. Evita cambiar sin motivo el orden y los campos de las definiciones de herramientas.
- Elige un TTL adecuado: usa un TTL corto para tareas con muchas invocaciones y poco tiempo entre ellas. En Agents que pasan largos periodos en pruebas, compilaciones o aprobaciones humanas, evalúa si el sobrecosto de escritura de un TTL más largo se compensa con las reescrituras que permite evitar.
- Controla el contexto del historial: añade contenido sin reordenarlo para no invalidar el prefijo de la caché. Resume las salidas extensas de las herramientas y conserva las conclusiones clave, el estado de la tarea y las pruebas necesarias.
- Reduce las invocaciones innecesarias del modelo: combina en una sola invocación las herramientas que puedan ejecutarse en lote y delega los pasos deterministas al código, en lugar de pedirle al modelo que los evalúe. Así reduces el número de rondas desde el origen.
- Supervisa las métricas reales: registra por tarea los tokens de entrada normales, las escrituras y lecturas de caché, los tokens de salida, la tasa de aciertos de la caché, el TTFT y el costo total. Evalúa el costo por tarea, no el costo de una sola solicitud.
Análisis del impacto de las invocaciones de API de Agent en varias rondas sobre los costos
Impacto en los desarrolladores
- El modelo de costos debe pasar de «una solicitud» a «una tarea»: las tarifas de Agent dependen de toda la cadena de invocaciones. Si solo se considera el precio unitario, se subestima considerablemente la factura real.
- La ingeniería de indicaciones también debe tener en cuenta la estructura de facturación: la estabilidad del prefijo determina directamente si la caché puede funcionar. Por eso, diseñar la estructura de las indicaciones pasa a formar parte de la optimización de costos.
- La selección de modelos requiere pruebas reales: los descuentos de caché, los TTL y los sobrecostos de escritura varían según el modelo. El costo de una misma tarea puede cambiar mucho al usar otro modelo.
Impacto en el sector
- La competencia en infraestructura se centra en las cargas de trabajo de Agent: que Google dé prioridad al ancho de banda de memoria, la transferencia de KV Cache y la suspensión y reanudación de Agent indica que las interacciones en varias rondas y con contextos largos ya son cargas de trabajo habituales.
- Los usuarios notarán primero las mejoras en la latencia: las optimizaciones de bajo nivel mejoran primero el TTFT y el rendimiento. Que baje el precio por token depende de la estrategia de precios del proveedor, así que los desarrolladores no deberían darlo por descontado en sus presupuestos.
Preguntas frecuentes
P1: ¿Por qué el costo de API de las llamadas de un Agent en varias rondas es más alto de lo esperado?
Como la API no mantiene estado, cada llamada debe volver a incluir la indicación del sistema, las definiciones de las herramientas y el contexto del historial. Cuantas más llamadas se hacen, más veces se cobra este contenido fijo. Los intercambios con herramientas también aumentan el número de rondas.
P2: ¿KV Cache y Prompt Cache son lo mismo?
No exactamente. KV Cache reutiliza estados en la capa de inferencia del modelo; Prompt Cache es el almacenamiento en caché y la facturación, por parte del proveedor, de prefijos reutilizables en la capa de API. La documentación de OpenAI indica que lo que se guarda son los tensores KV. Los usuarios solo pueden percibir Prompt Cache a través de las reglas de facturación; no pueden controlar KV Cache directamente.
P3: ¿Bajarán de inmediato los precios de la API cuando Google lance sus nuevas TPU?
No hay motivos para afirmarlo. Al 10 de noviembre de 2026, TPU 8tx y TPU 8i Max todavía aparecen como «Próximamente» y no tienen precios publicados. Las mejoras de hardware optimizan principalmente el uso de recursos y la latencia de los proveedores. Que esto se refleje en el precio por token depende de la política de precios de cada proveedor.
P4: ¿El almacenamiento en caché siempre permite ahorrar?
No necesariamente. Si el prefijo cambia en cada llamada y no se produce ningún acierto de caché, y el modo utilizado aplica un recargo por escribir en la caché, el costo puede ser mayor que si no se usara. Si las herramientas tardan más que el TTL, las reescrituras frecuentes también reducen el ahorro.
P5: ¿Cómo puedo comparar rápidamente el rendimiento de la caché de distintos modelos?
Te recomendamos ejecutar el mismo flujo de trabajo de Agent en varios modelos y registrar la tasa de aciertos de caché y el costo total por tarea. Con APIYI (apiyi.com) puedes usar una sola clave API para llamar a modelos como OpenAI, Claude y Gemini. Solo tienes que cambiar el parámetro `model` para compararlos.
P6: ¿Qué riesgos tiene la compresión del contexto?
La compresión cambia el contenido que se incluye en las solicitudes posteriores y puede hacer que se pierdan detalles importantes. Esto puede provocar que el Agent repita errores e incluso aumentar el número de rondas de llamadas. Además, si el contenido comprimido se vuelve a generar en cada ronda, se rompe el prefijo de caché. Por eso, conviene diseñarla junto con la estrategia de caché.
P7: Al usar una puerta de enlace unificada, ¿todos los modelos ofrecen los mismos descuentos de caché?
No. Las funciones de caché, las reglas de facturación y los campos de respuesta dependen del modelo de origen. Al hacer pruebas en APIYI (apiyi.com), comprueba por separado los campos de caché y el costo real de cada modelo antes de incluirlos en el presupuesto.
Puntos clave sobre los costos de las llamadas a la API en varias rondas de Agent
- La unidad de costo es la tarea: la factura de Agent suma toda la cadena de llamadas, no solo una solicitud.
- El contexto repetido es el principal costo: en el ejemplo de 12 llamadas, una caché de 1 hora puede reducir los costos de entrada aproximadamente un 71,6 %.
- La caché ofrece descuentos condicionados: si el prefijo no es estable o el TTL es demasiado corto, el ahorro disminuye e incluso puede aumentar el costo.
- Cada proveedor factura de forma distinta: hay que confirmar el multiplicador de escritura, el descuento de lectura y los costos de almacenamiento para cada modelo.
- Optimizar el hardware no equivale a reducir la factura: las mejoras de KV subyacentes reducen primero la latencia; el precio depende de las tarifas del proveedor.
- Primero mide y luego optimiza: con la interfaz unificada de APIYI en apiyi.com, mide la tasa de aciertos de caché y el costo por tarea de cada modelo.
Resumen
El costo de las llamadas a la API en varias rondas de Agent depende de tres factores inseparables: el recálculo del contexto, los aciertos de caché y las rondas de llamadas a herramientas:
- El recálculo del contexto determina la base del costo: cuantas más llamadas, más contenido se repite.
- Los aciertos de caché determinan cuánto se reduce el costo de la parte repetida. La estabilidad del prefijo y el TTL son factores clave.
- Las rondas de llamadas a herramientas generan costos externos y aumentan el número de invocaciones del modelo.
La inversión de Google en KV Cache y en el muro de memoria de la infraestructura hará que Agent funcione más rápido, pero lo que los desarrolladores pueden controlar de inmediato es la estructura de sus propios tokens. Conviene empezar por cinco aspectos: estabilizar los prefijos, elegir un TTL adecuado, reducir el historial, limitar las llamadas y supervisar los costos por tarea. Después, valida el efecto de cada optimización con datos reales a través de APIYI en apiyi.com.
📚 Referencias
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: anuncio del lanzamiento de los nuevos sistemas TPU de octava generación
- Enlace:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Descripción: contexto sobre el límite de memoria de los agentes y KV Cache
-
Google Cloud Blog – Introducing TPU Sync: biblioteca de código abierto para transferir KV Cache y pesos
- Enlace:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Descripción: optimización de las transferencias de KV Cache de bajo nivel y criterios de prueba
-
Documentación de la API de OpenAI – Prompt Caching: mecanismos de caché y buenas prácticas
- Enlace:
platform.openai.com/docs/guides/prompt-caching -
Descripción: reglas de caché de prefijos, tiempo de retención y recomendaciones de monitorización
-
Documentación de Anthropic – Prompt Caching: TTL de caché e información sobre precios
- Enlace:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
Descripción: precios de escritura y lectura para las cachés de 5 minutos y 1 hora
-
Google AI for Developers – Context Caching: caché implícita y explícita de Gemini
- Enlace:
ai.google.dev/gemini-api/docs/caching - Descripción: información sobre el TTL de la caché explícita y los costos de almacenamiento
Autor: equipo técnico de APIYI
Contacto técnico: visita la página de inicio de APIYI, apiyi.com, para ponerte en contacto con nosotros. Encontrarás más información de integración en el centro de documentación, docs.apiyi.com.