Кратко: В многоходовых вызовах Responses API с GPT-6.2 изменение ранних входных данных может уменьшить число попаданий в кэш и лишить часть элементов рассуждения права на повторное использование. Разработчики могут перейти на структуру контекста, в которую данные только добавляются, а затем с помощью парных журналов использования выявить разницу в стоимости.
Сразу к выводу. Причины роста счёта обычно не одна, и часто они приходят сразу из двух источников: во-первых, после изменения входного префикса чтений из кэша становится меньше, и входные данные, которые раньше тарифицировались по цене кэша, начинают тарифицироваться по обычной цене ввода; во-вторых, GPT-6.2 из-за prefix_mismatch удаляет ранние элементы рассуждения, модели приходится рассуждать заново, и могут возникнуть дополнительные расходы на рассуждение. Появятся ли эти две составляющие и какова доля каждой, зависит от версии модели, места изменения и фактического usage. Пример расчёта ниже лишь демонстрирует методику разбивки счёта по статьям и не отражает какой-либо реальный счёт. Если вы вызываете модель через APIYI (apiyi.com), рекомендуется собрать контрольную группу на основе истории input, которую вы ведёте сами, а затем сверять расчёты с журналами использования.
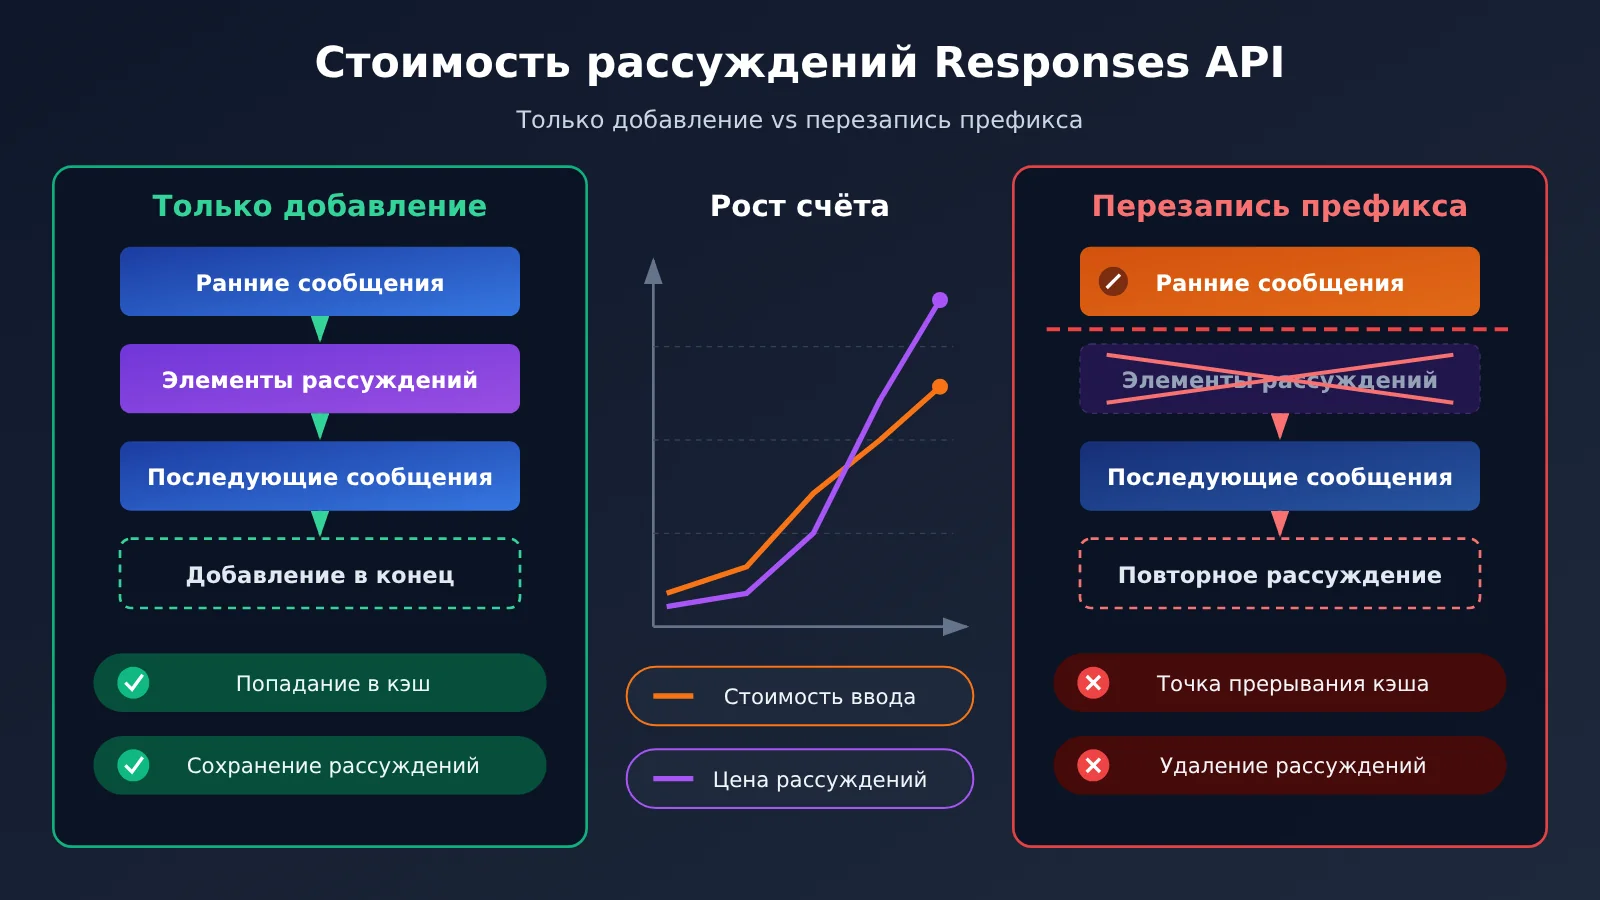
Карта знаний о стоимости инференса в OpenAI Responses API
В таблице ниже — содержание всех четырёх разделов статьи и их взаимосвязи, а также рекомендуемый порядок чтения. Раздел 1 объясняет, откуда берутся расходы; раздел 2 показывает, какие операции их запускают; раздел 3 даёт методику измерения; раздел 4 переводит измеренные цифры в деньги и предлагает план доработки.
| № | На какой вопрос отвечает | Что даёт для следующего раздела | Что вы сможете после прочтения |
|---|---|---|---|
| 1 | Где именно растут расходы | Две линии наблюдения: чтение из кэша и新增 output | Понимать смысл соответствующих полей в usage |
| 2 | Какие действия редактирования их запускают | Список мест в коде, которые нужно проверить | Оценить, есть ли риск в вашем способе поддержания контекста |
| 3 | Как изолировать изменения | Набор парных данных для сравнения | Убедиться с помощью контрольного эксперимента, существует ли проблема |
| 4 | Насколько велика разница в деньгах и как исправить | Формула разбивки расходов и три направления доработки | Оценить разницу и сверить фактическое списание по request ID |
Если вы уже подтвердили, что префикс переписывается, можно сразу начинать с раздела 3. Разделы 1 и 2 пригодятся как справочный материал при диагностике.
Что нужно знать: термины, связанные со стоимостью инференса в Responses API
| Термин | Краткое объяснение |
|---|---|
| Responses API | Интерфейс OpenAI для единообразной обработки ответов модели, рассуждений и вызовов инструментов |
| Входной префикс | Ранние входные данные и конфигурация, которые сохраняют одинаковый порядок в начале запросов с несколькими раундами |
| Попадание в кэш | В текущем запросе повторно используются уже обработанные входные токены; эта часть тарифицируется по цене чтения из кэша |
| Элемент рассуждения | Структурированный элемент в ответе reasoning-модели, который можно повторно использовать в совместимых последующих запросах |
prefix_mismatch |
Значение причины в диагностике, связанной с GPT-6.2: более ранний префикс был изменён, поэтому элемент рассуждения удаляется |
| Только добавление | Способ ведения истории, при котором исходное содержимое и порядок сохраняются, а последующие события добавляются только в конец |
reasoning_tokens |
Подэлемент рассуждений в выходной части usage; по нему удобно отслеживать расход на рассуждения |
x-request-id |
Идентификатор запроса в заголовке ответа; используется для связи ответа клиента с логами поставщика |
1. Почему стоимость инференса в Responses API растёт в двух местах
1.1 Первая составляющая: сокращение чтения из кэша
Согласно документации OpenAI «Prompt caching», кэш промптов начинает сопоставление с начала запроса. Если какая-то ранняя часть содержимого переписана, всё, что идёт после точки изменения, уже нельзя тарифицировать как чтение из кэша — будет применяться обычная цена ввода. Возьмём для примера тариф для короткого контекста gpt-6.2-sol из общего прайс-листа APIYI: обычный ввод — 2 доллара за миллион токенов, чтение из кэша — 0,10 доллара. Разница в 20 раз.
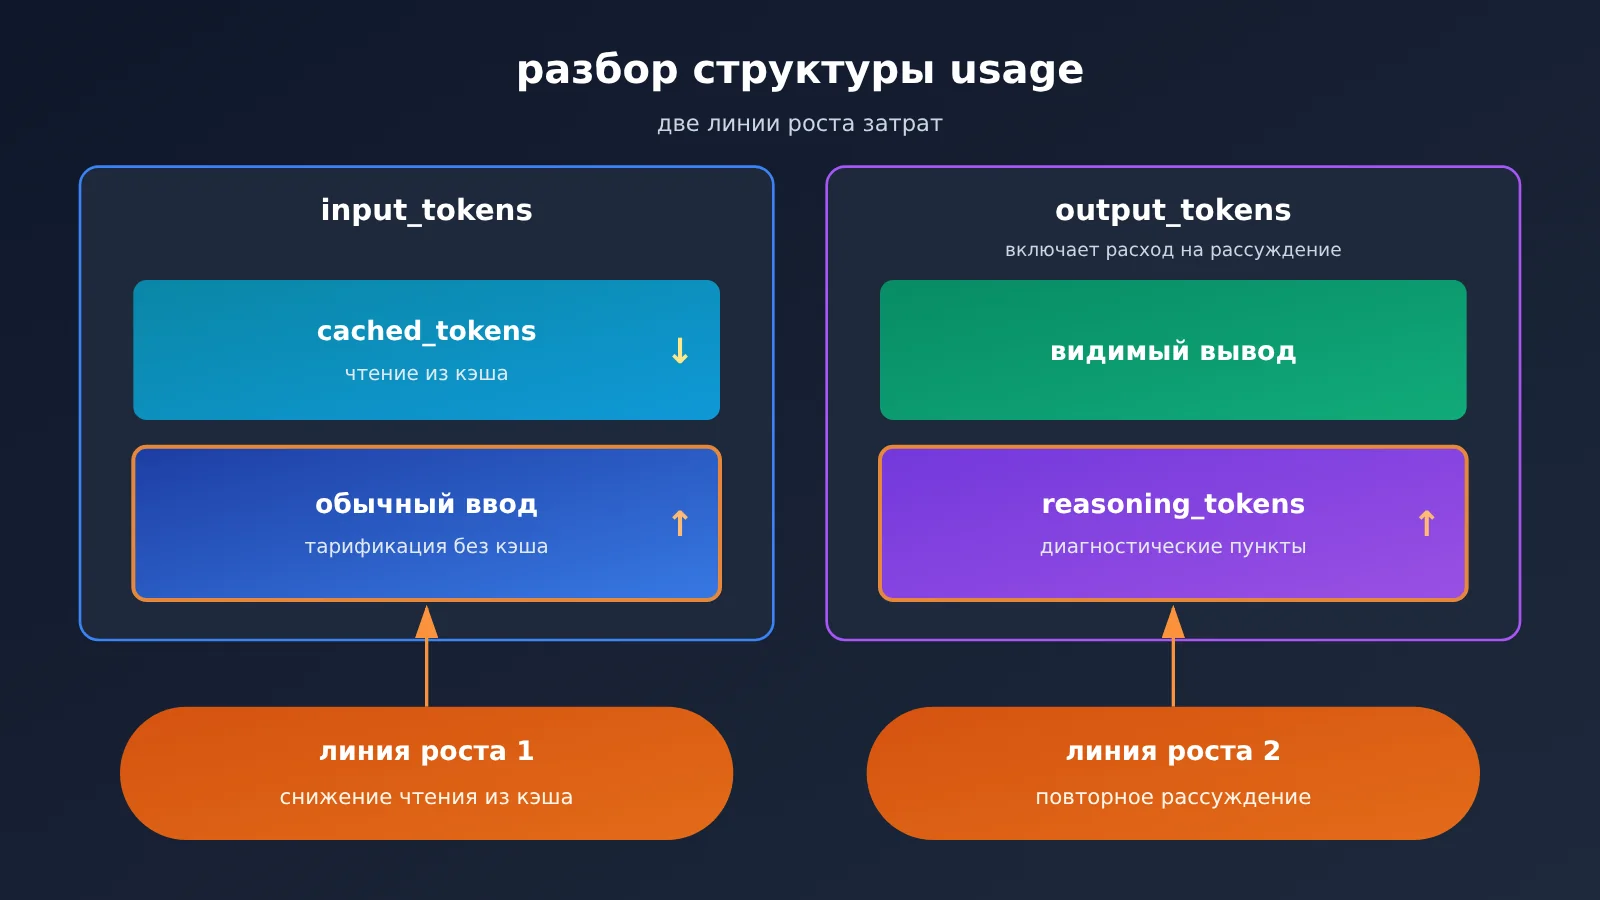
Эта часть изменения стоимости отражается в полях usage: общий объём input_tokens может почти не измениться, но cached_tokens внутри станет меньше. Если смотреть только на общий объём ввода, проблему не заметишь — нужно отдельно фиксировать объём чтения из кэша.
1.2 Вторая составляющая: новые выходные токены после потери права на повторное использование элемента рассуждения
В API Changelog OpenAI от 2026-11-17 поведение «редактирование ранней истории приводит к удалению элемента рассуждения по причине prefix_mismatch» отмечено как действующее начиная с GPT-6.2. После удаления элемента рассуждения модель в следующих раундах не видит предыдущее содержание рассуждений и может запускать рассуждения заново — отсюда возможны дополнительные затраты на рассуждения.
Эта составляющая проявляется на стороне вывода: растут reasoning_tokens и общий объём вывода. Она может возникать одновременно с сокращением чтения из кэша, но в usage это два независимых поля, поэтому при разборе нужно смотреть на них отдельно.
1.3 Как соотносятся output_tokens и reasoning_tokens
Согласно документации OpenAI «Counting tokens», output_tokens уже включает расход на рассуждения, а output_tokens_details.reasoning_tokens — лишь диагностический подэлемент внутри него. При расчёте стоимости просто умножайте output_tokens на цену вывода. Если дополнительно прибавить reasoning_tokens ещё раз, получится двойной учёт.
2. Какие действия по редактированию префикса увеличивают стоимость инференса
2.1 Типичные операции, которые вызывают prefix_mismatch
Согласно документации OpenAI «Keep the prefix unchanged» и «Reasoning models», перечисленные ниже операции изменяют префикс и в GPT-6.2 могут привести к удалению элементов reasoning:
| Операция | Типичный сценарий в коде | Риск |
|---|---|---|
| Перезапись старых сообщений | Вернуться и исправить формулировку пользователя во втором раунде или добавить к старым сообщениям метку времени | Изменяет префикс |
| Перезапись старых результатов инструментов | Сократить JSON, возвращённый инструментом на раннем этапе, чтобы экономить токены | Изменяет префикс (сокращение тоже считается изменением) |
| Вставка содержимого перед соответствующим элементом reasoning | Вставить новые найденные материалы в середину истории | Изменяет префикс |
| Удаление элемента целиком без изменения остального содержимого | Удалить одно полное старое сообщение | Не вызывает эту причину удаления, но объём кэш-попаданий всё равно может измениться |
| Добавление после элемента reasoning | Добавить новые сообщения в хронологическом порядке | Не вызывает эту причину удаления |
«Сокращение старых выходных данных инструмента» выглядит как экономия токенов, но это изменение. prefix_mismatch не срабатывает только при удалении полных элементов и сохранении остальных без изменений. Даже в этом случае начальная точка сопоставления кэша может измениться, поэтому объём чтения из кэша всё равно нужно измерять на практике.
2.2 Различия между версиями, уровнями reasoning и сменой семейства моделей
Эти типы изменений нужно оценивать отдельно:
- Различия версий: OpenAI прямо указывает, что удаление элементов reasoning из-за
prefix_mismatch— это поведение, начиная с GPT-6.2. GPT-6.1 Sol поддерживаетreasoning.context: all_turnsи может воспроизводить более ранние reasoning-элементы, когда доступна совместимая история. При миграции с 6.1 на 6.2 прежний способ поддержания контекста нужно проверить заново. - Уровни reasoning: оба поколения Sol предлагают пять уровней —
low,medium,high,xhigh,max; 6.2 Sol отклоняетnone. В сторонней статье OrcaRouter описан подход: не менятьreasoning.effortнапрямую между запросами, а добавлять вinputэлементconfiguration_update. Там же отмечается, что истории с такими элементами автоматически усекаются, а/responses/compactих отклоняет. Прежде чем применять такой подход, ориентируйтесь на официальную документацию OpenAI. - Смена семейства моделей и понижение уровня модели: согласно OpenAI, переключение на другое семейство моделей или на модель с меньшими возможностями тоже может удалить уже имеющиеся элементы reasoning. Это отличается от
prefix_mismatchпо причине, и при сборе статистики их нужно относить к разным категориям.
2.3 Расположение и тарификация верхнеуровневого instructions в GPT-6.2
В документе OpenAI «Using GPT-6.2» указано: верхнеуровневый instructions в GPT-6.2 добавляется после input и тарифицируется как некешированный ввод. Поэтому его удобно использовать для временных developer-промптов текущего раунда, но не для больших неизменных системных инструкций, рассчитанных на долгую работу.
Инструкции, которые нужно переиспользовать долго, стоит помещать в input как первое developer-сообщение, чтобы они кешировались. Если долгосрочные инструкции нужно изменить, добавьте новое developer-сообщение в конец истории и не правьте первое задним числом.
3. Изолируем изменения стоимости reasoning в Responses API с помощью контрольных запросов
3.1 Дизайн контрольных групп
Фиксируем модель, уровень reasoning, определения инструментов и объём входных данных — меняем только одну переменную: способ ведения истории. Группа A только дописывает историю, группа B один раз изменяет фрагмент в её начале. Каждая группа проходит несколько раундов на одном и том же наборе задач.
Для каждого запроса единообразно фиксируем данные по таблице ниже. Качество выполнения задачи нужно оценивать вручную или скриптом: экономия не должна достигаться за счёт ухудшения результата.
| Поле | Источник | Назначение |
|---|---|---|
| Группа | Указываем сами | Различать группу с только дописыванием и группу с изменениями |
cached_tokens |
usage.input_tokens_details |
Наблюдать за первой линией |
reasoning_tokens |
usage.output_tokens_details |
Наблюдать за второй линией |
output_tokens |
usage |
Рассчитывать стоимость вывода |
| Задержка | Замер на клиенте | Рост reasoning обычно увеличивает время выполнения |
| Качество выполнения задачи | Оценка вручную или скриптом | Исключать ситуацию, когда качество меняют на экономию |
x-request-id |
Заголовок ответа | Сверка |
3.2 Пример вызова в режиме append-only
Приведённый ниже код сам поддерживает историю input: на каждом раунде он только добавляет новые элементы в конец и записывает расход и ID запроса в лог:
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # фиксируется на весь сеанс, не меняется между раундами

# Стабильный префикс: переиспользуемые инструкции помещаются первым элементом input и больше не изменяются
history = [{"role": "developer", "content": "你是代码审查助手,回答简洁。"}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # сначала нужно проверить, возвращает ли целевая группа эти данные
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # Только добавление: вывод текущего раунда (включая reasoning-элементы) как есть помещается в конец истории
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
Группа с перезаписью использует ту же функцию: перед N-м раундом измените содержимое history[1] и установите variant в "early_rewrite", остальные параметры не меняйте.
🚀 Быстрый старт: при сборке контрольной группы можно через APIYI apiyi.com с тем же API-ключом переключаться между
gpt-6.1-solиgpt-6.2-sol. При единой структуре логов можно сравнить, как различия версий влияют на кеширование и расход reasoning-токенов.
3.3 Вспомогательная диагностика при прямом подключении к официальному API
При прямом подключении к OpenAI можно указать в prompt_cache_options.comparison_response_id ID одного из предыдущих ответов, а затем прочитать возвращённую причину диагностики и количество закэшированных токенов. В поле input_transformations ответа перечисляется, какие элементы рассуждения были удалены и почему; при этом prefix_mismatch можно сопоставить по ID с элементом рассуждения из вывода старого ответа.
# Только для прямого подключения к официальному OpenAI
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
У этой диагностики есть два ограничения: во-первых, она по принципу «наилучших усилий» сообщает только о первом найденном различии, а во-вторых, не позволяет подтвердить, действительно ли модель повторно использовала сохранённые рассуждения. Она может сказать, что «элемент рассуждения был удалён», но не скажет, «сколько из-за этого переплатили»; стоимость по-прежнему нужно оценивать по парным записям использования из раздела 3.1.
3.4 На что обратить внимание при вызове через APIYI
При прямом подключении к OpenAI можно продолжать состояние сессии с помощью previous_response_id. В руководстве по нативному вызову Responses API от APIYI (docs.apiyi.com) в основном тексте утверждается, что эта цепочечная схема не работает, однако в FAQ на той же странице записано, что по результатам тестирования 2026-09-02 она была работоспособна. Два утверждения противоречат друг другу, поэтому более надёжной базовой схемой будет самостоятельно управлять историей input — так, как описано в разделе 3.2.
Продолжение состояния, передача зашифрованных элементов рассуждения и перечисленные выше диагностические поля могут вести себя по-разному в зависимости от группы токенов, поэтому их нужно отдельно проверять на целевой группе. Если диагностические поля недоступны, ориентиром по-прежнему могут служить парные журналы использования.
4. Разбираем стоимость инференса Responses API в цифрах и внедряем изменения
4.1 Цены из прайс-листа для расчёта
Ниже приведены цены по умолчанию для короткого контекста из общего прайс-листа APIYI apiyi.com (обновлено 2026-11-20 в 15:17 по пекинскому времени; единица — доллары США за миллион токенов). Фактическое списание зависит ещё от группы токенов, к которой относится модель, и от стоимости пополнения — это нужно проверять отдельно.
| ID модели APIYI | Обычный ввод | Чтение из кеша | Вывод |
|---|---|---|---|
gpt-6.2-sol, gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
Длинный контекст нужно считать отдельно. Когда ввод для gpt-6.2-sol превышает 272,000 токенов, в текущем общем прайс-листе APIYI указана цена ввода $3, а на официальной странице OpenAI для моделей Standard — $4; для gpt-6.1-sol цена ввода при длинном контексте в обоих источниках составляет $4. Цены кеша и вывода для длинного контекста проверяйте по актуальным правилам биллинга соответствующего канала.
4.2 Пример расчёта разбивки затрат для двух запросов
Допущения: короткий контекст, стандартные тарифы APIYI Sol по умолчанию, входные данные обоих запросов составляют 12,000 токенов, отдельно выделенной платы за запись в кэш нет, платы за инструменты тоже нет. Все числа ниже — допущения, а не измеренные данные.
| Показатель | Сохранённый префикс | Переписанный префикс |
|---|---|---|
| Чтение из кэша | 9,000 × $0.10/M = $0.0009 | 3,000 × $0.10/M = $0.0003 |
| Обычный ввод | 3,000 × $2/M = $0.0060 | 9,000 × $2/M = $0.0180 |
| Общий вывод | 1,000 × $10/M = $0.0100 | 1,600 × $10/M = $0.0160 |
| Итого | $0.0169 | $0.0343 |
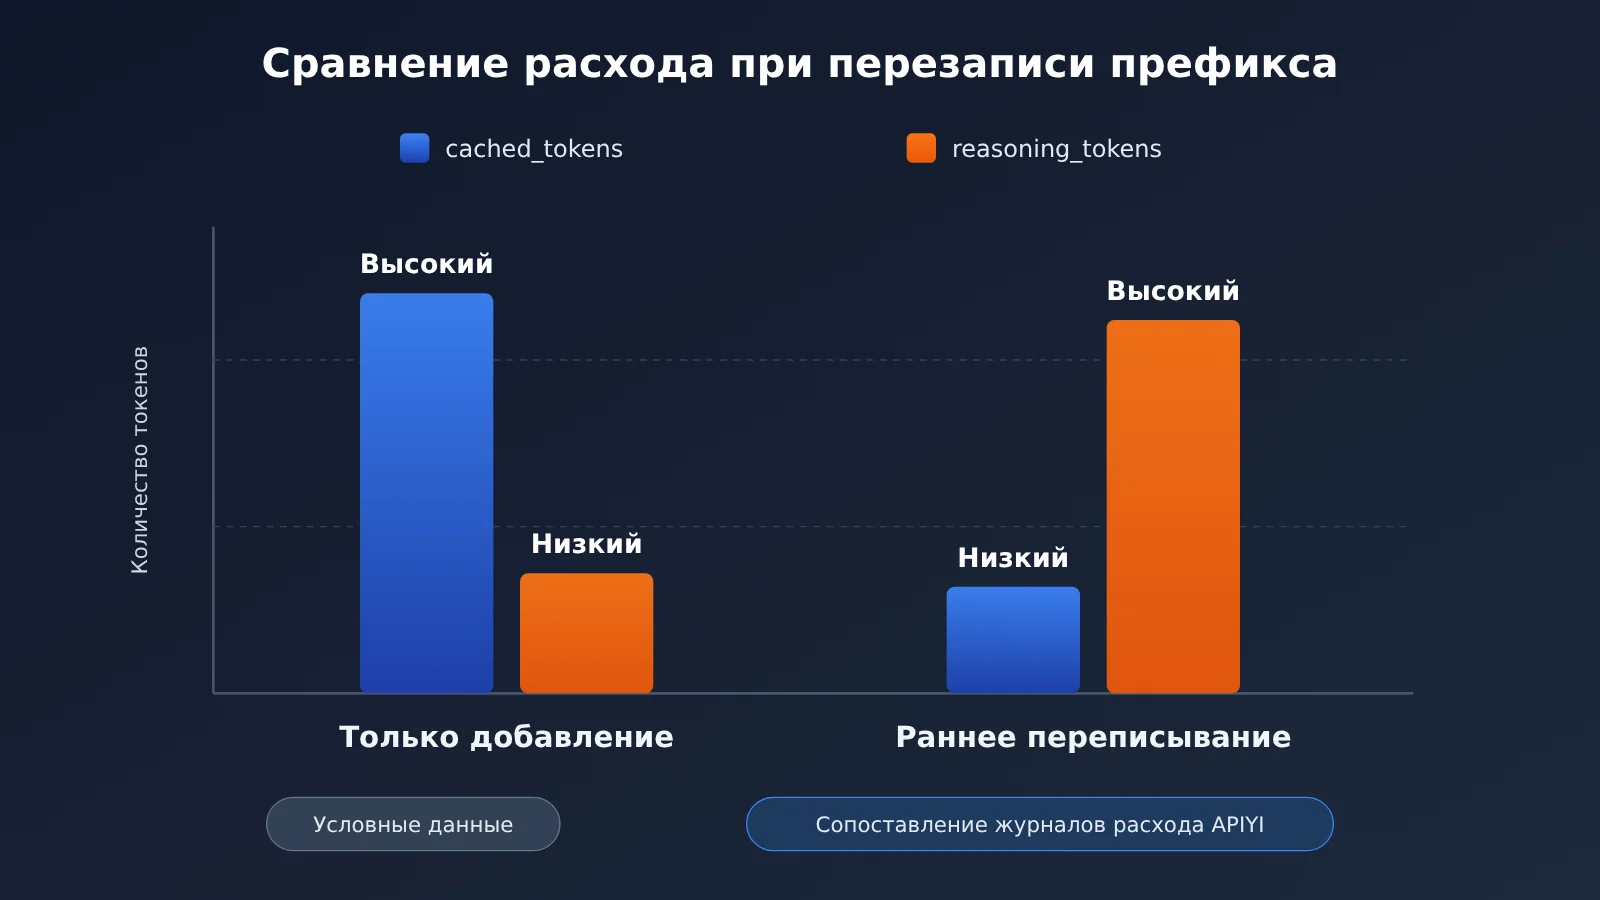
Разница между двумя вариантами составляет $0.0174, и её можно разложить на две части: $0.0114 — за счёт того, что 6,000 входных токенов переходят с цены кэша на цену обычного ввода, то есть 6,000 × ($2 − $0.10) / 1,000,000; $0.0060 — за счёт дополнительных 600 токенов общего вывода. Эти две части соответствуют двум линиям из раздела 1. Фактическую разницу нужно определять по вашему собственному usage. Если есть отдельно выделенная запись в кэш, расчёт следует вести отдельно по трём взаимоисключающим категориям: обычный ввод, чтение из кэша и запись в кэш.
4.3 Сверка по ID запроса
После оценки проверяем фактическое списание. В журнале расходов APIYI apiyi.com найдите по x-request-id из заголовка ответа соответствующую запись type=2 и пересчитайте фактическое списание в долларах по формуле quota ÷ 500,000. Заодно фиксируйте модель, группу токенов, временной интервал вызова, а также объём ввода и вывода для этого запроса.
Публичного сравнительного счёта по префиксам для APIYI в рамках одной группы и одной задачи пока нет. Поэтому при оценке эффекта от доработок опирайтесь на собственные парные журналы запросов и записи о списаниях.
💰 Совет по сверке: сопоставьте
request_idиз журнала раздела 3.2 с журналом расходов запись за записью и получите три столбца: «поле объёма использования → оценка суммы → фактическое списание». Если в каком-то столбце обнаружилось отклонение — значит, проблема именно на этом этапе.
4.4 Три доработки
- Фиксированные определения инструментов и стабильные инструкции: определения инструментов остаются в исходном порядке и не меняются посреди сессии; долгосрочные инструкции помещаются в первое developer-сообщение в
input, а временные подсказки текущего раунда можно передавать в верхнеуровневомinstructionsGPT-6.2, но нужно учитывать, что они тарифицируются как некэшированный ввод. - Дополнять контекст по порядку: новые сообщения, результаты инструментов и новые результаты поиска добавляются в конец. Если действительно нужно сократить — удаляйте целые элементы, а не переписывайте их содержимое.
- Отдельно тестировать длинный контекст и миграцию версий: после превышения 272 000 входных токенов применяется другой тариф, поэтому для длинного контекста нужна отдельная контрольная группа; при миграции с
gpt-6.1-solнаgpt-6.2-sol, смене тарифа или семейства моделей сначала проверяйте по методике сравнения из раздела 3 и только потом выкатывайте на всё.
После этих доработок эффект можно проверить так: заново прогоните обе группы сравнения на том же наборе задач. Если в группе с чистыми дополнениями доля cached_tokens стабильна, reasoning_tokens не выросли аномально, а фактическое списание, сверенное по ID запроса, совпадает с оценкой — значит, эти расходы уже под контролем.
Справочные материалы
- OpenAI «Keep the prefix unchanged»: сохранение префикса и диагностика
prefix_mismatch.- Ссылка:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Ссылка:
- OpenAI «Reasoning models»: переиспользование reasoning-элементов и исключения при полном удалении элемента.
- Ссылка:
developers.openai.com/api/docs/guides/reasoning
- Ссылка:
- OpenAI «Prompt caching» и «Counting tokens»: правила сопоставления кэша и поля использования (usage).
- Ссылка:
developers.openai.com/api/docs/guides/prompt-caching
- Ссылка:
- OpenAI API Changelog (запись по GPT-6.2, 2026-11-17).
- Ссылка:
developers.openai.com/api/docs/changelog
- Ссылка:
- OrcaRouter «GPT-6.2 Preserved Reasoning»: сторонний обзор подхода к переписыванию по принципу «только добавление» (append-only).
- Ссылка:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- Ссылка:
- APIYI «Сводная таблица цен на модели».
- Ссылка:
docs.apiyi.com/models
- Ссылка:
- APIYI «API запроса логов».
- Ссылка:
docs.apiyi.com/api-capabilities/log-query
- Ссылка:
- APIYI «Руководство по нативному вызову OpenAI Responses API».
- Ссылка:
docs.apiyi.com/api-capabilities/openai/native
- Ссылка:
Автор: Техническая команда APIYI
Общение по техническим вопросам: свяжитесь с нами на главной странице сайта APIYI, больше материалов — в центре документации docs.apiyi.com.