Ringkasan: Dalam pemanggilan Responses API multi-putaran GPT-6.2, menulis ulang input awal dapat mengurangi cache hit dan juga membuat sebagian item inferensi kehilangan kelayakan untuk digunakan ulang. Pengembang dapat beralih ke struktur konteks yang hanya ditambah, lalu menggunakan log penggunaan berpasangan untuk melacak selisih biaya.
Mulai dari kesimpulan. Kenaikan tagihan biasanya bukan hanya disebabkan satu hal dan bisa datang dari dua tempat sekaligus: pertama, setelah prefiks input diubah, pembacaan cache berkurang, sehingga input yang tadinya ditagih dengan harga cache kini ditagih dengan harga input biasa; kedua, GPT-6.2 menghapus item inferensi awal karena prefix_mismatch, model perlu melakukan inferensi ulang, sehingga biaya inferensi tambahan mungkin terjadi. Apakah kedua hal ini muncul dan berapa porsinya masing-masing bergantung pada versi model, lokasi perubahan, serta usage aktual. Contoh perhitungan di bawah hanya untuk mendemonstrasikan metode perincian biaya dan tidak mewakili tagihan nyata apa pun. Jika memanggil melalui APIYI (apiyi.com), sebaiknya buat kelompok kontrol menggunakan riwayat input yang Anda kelola sendiri, lalu hitung berdasarkan log konsumsi.
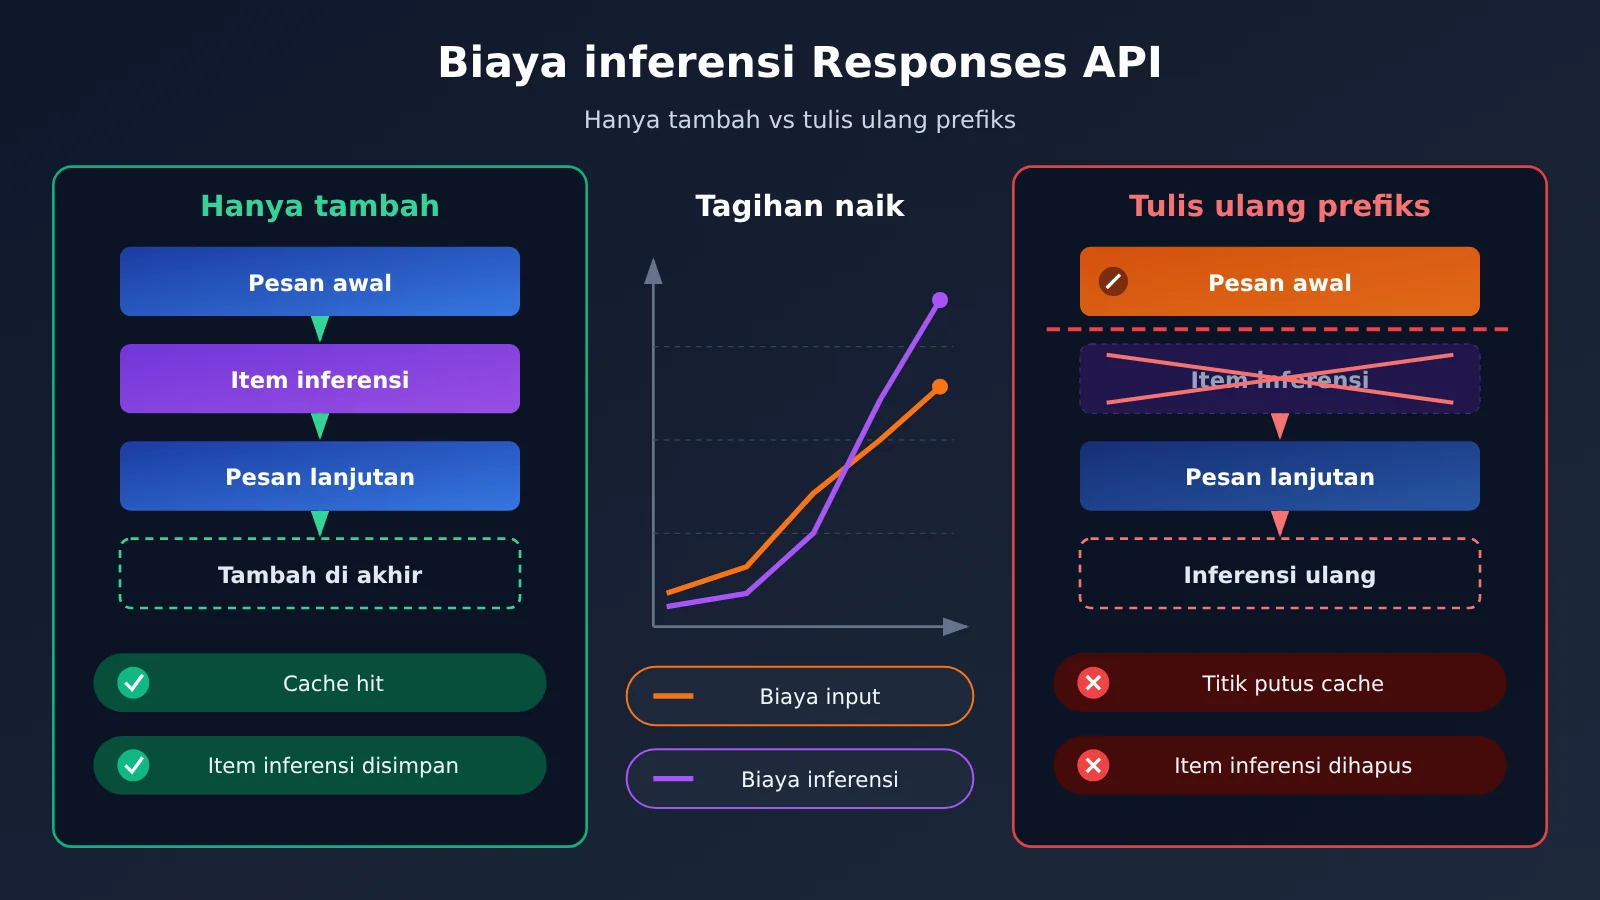
Peta pengetahuan biaya inferensi OpenAI Responses API
Tabel di bawah ini merangkum isi dan hubungan keempat bagian artikel sekaligus menunjukkan urutan pembacaan. Bagian 1 menjelaskan dari mana biaya berasal, Bagian 2 menjelaskan operasi apa yang memicunya, Bagian 3 memberikan metode pengukuran, dan Bagian 4 mengubah angka hasil pengukuran menjadi nominal uang serta memberikan rencana perbaikan.
| No. | Pertanyaan yang dijawab | Apa yang diberikan untuk bagian berikutnya | Setelah membaca, Anda dapat |
|---|---|---|---|
| 1 | Di mana biaya naik | Dua jalur pengamatan: pembacaan cache, output baru | Memahami arti field terkait dalam usage |
| 2 | Tindakan edit apa yang memicu | Daftar lokasi kode yang perlu diperiksa | Menilai apakah cara Anda memelihara konteks berisiko |
| 3 | Cara mengisolasi perubahan | Sekumpulan data berpasangan yang dapat dibandingkan | Memastikan ada tidaknya masalah dengan eksperimen kontrol |
| 4 | Berapa selisih biayanya dan bagaimana memperbaikinya | Rumus perincian biaya dan tiga perubahan | Memperkirakan selisih dan mencocokkan tagihan aktual berdasarkan ID permintaan |
Jika Anda sudah memastikan ada penulisan ulang prefiks, Anda bisa langsung mulai dari Bagian 3. Bagian 1 dan Bagian 2 dapat dijadikan acuan pembanding saat melakukan pemeriksaan.
Perlu Diketahui: Terminologi Terkait Biaya Inferensi Responses API
| Istilah | Penjelasan Singkat |
|---|---|
| Responses API | Antarmuka OpenAI untuk menangani respons model, inferensi, dan pemanggilan tool secara terpadu |
| Prefiks input | Konten input awal dan konfigurasi yang mempertahankan urutan sama di awal permintaan multi-putaran |
| Cache hit | Permintaan kali ini menggunakan kembali Token input yang sudah diproses; bagian ini ditagih dengan harga baca cache |
| Reasoning item | Sejenis item terstruktur dalam respons model inferensi yang dapat digunakan kembali pada permintaan lanjutan yang kompatibel |
prefix_mismatch |
Salah satu nilai alasan dalam diagnostik terkait GPT-6.2, yang menunjukkan prefiks awal diubah sehingga reasoning item dihapus |
| Hanya menambah (append-only) | Cara pemeliharaan riwayat yang mempertahankan konten dan urutan asli, hanya menambahkan event lanjutan di akhir |
reasoning_tokens |
Subitem inferensi dalam penggunaan output, dipakai untuk mengamati konsumsi inferensi |
x-request-id |
Pengenal permintaan pada header respons, digunakan untuk mengaitkan respons klien dengan log penyedia |
1. Mengapa biaya inferensi Responses API meningkat di dua tempat
1.1 Jalur pertama: pembacaan cache berkurang
Menurut penjelasan OpenAI dalam《Prompt caching》, caching petunjuk dimulai dari awal permintaan. Begitu ada bagian konten awal yang diubah, bagian setelah titik perubahan tidak dapat lagi ditagih dengan harga baca cache dan akan ditagih dengan harga input biasa. Mengambil contoh harga konteks pendek gpt-6.2-sol pada tabel harga APIYI, input biasa adalah 2 dolar per juta Token, sedangkan baca cache 0,10 dolar—selisih keduanya mencapai 20 kali.
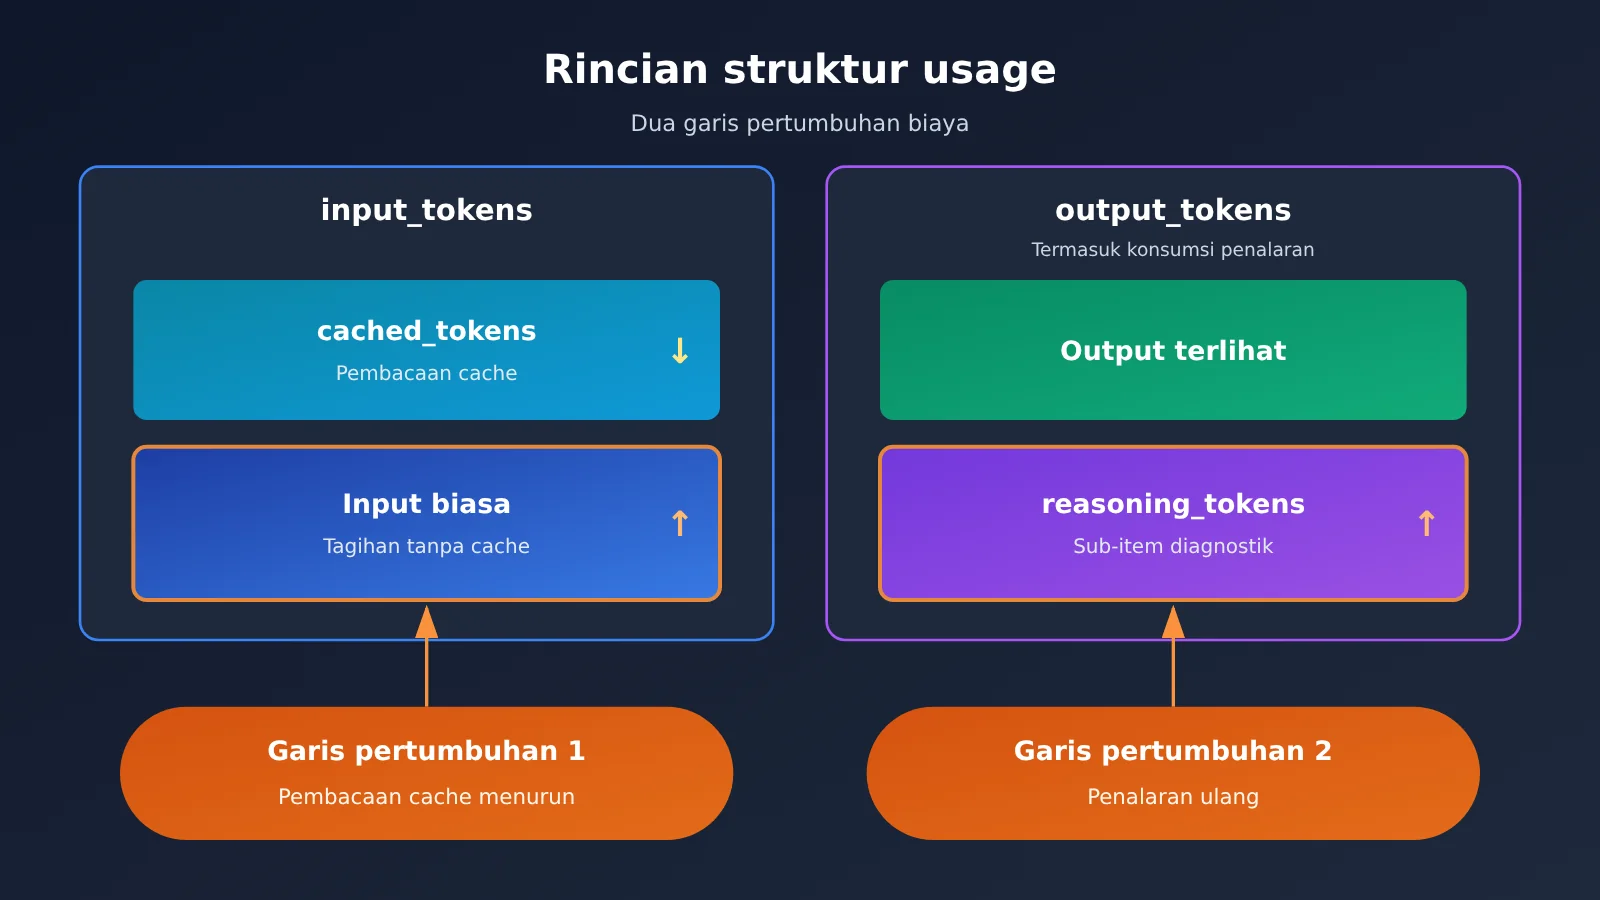
Perubahan biaya ini memiliki field yang sesuai di usage: total input_tokens mungkin hampir tidak berubah, tetapi cached_tokens di dalamnya akan berkurang. Jika hanya melihat total input, masalah ini tidak akan terdeteksi; jumlah pembacaan cache harus dicatat secara terpisah.
1.2 Jalur kedua: output baru setelah reasoning item kehilangan kelayakan untuk digunakan kembali
Dalam API Changelog OpenAI tanggal 2026-11-17, perilaku “mengedit riwayat awal menyebabkan reasoning item dihapus dengan alasan prefix_mismatch” ditandai sebagai perilaku yang dimulai sejak GPT-6.2. Setelah reasoning item dihapus, model tidak dapat melihat konten inferensi sebelumnya pada putaran berikutnya dan mungkin perlu melakukan inferensi ulang, sehingga berpotensi menimbulkan biaya inferensi tambahan.
Jalur ini tercermin di sisi output, terlihat dari reasoning_tokens dan total output yang membengkak. Ini bisa muncul bersamaan dengan berkurangnya pembacaan cache, tetapi keduanya adalah dua field terpisah di usage, sehingga saat menelusuri masalah keduanya perlu diamati secara terpisah.
1.3 Hubungan keterkandungan antara output_tokens dan reasoning_tokens
Menurut OpenAI《Counting tokens》, output_tokens sudah mencakup konsumsi inferensi, dan output_tokens_details.reasoning_tokens hanyalah subitem diagnostik di dalamnya. Saat menghitung biaya, cukup kalikan output_tokens dengan harga satuan output. Jika reasoning_tokens ditambahkan lagi secara terpisah, maka akan terjadi penghitungan ganda.
2. Tindakan pengeditan prefiks mana yang memicu kenaikan biaya penalaran
2.1 Operasi umum yang memicu prefix_mismatch
Menurut penjelasan OpenAI dalam “Keep the prefix unchanged” dan “Reasoning models”, operasi berikut termasuk mengubah prefiks dan pada GPT-6.2 dapat menyebabkan item penalaran dihapus:
| Operasi | Skenario kode umum | Risiko |
|---|---|---|
| Menulis ulang pesan lama | Mengoreksi kembali frasa pengguna pada giliran kedua, atau menambahkan stempel waktu ke pesan lama | Mengubah prefiks |
| Mengubah hasil tool lama | Demi menghemat Token, mempersingkat JSON yang dikembalikan tool sebelumnya | Mengubah prefiks (mempersingkat juga termasuk mengubah) |
| Menyisipkan konten sebelum item penalaran terkait | Menyisipkan materi hasil pencarian baru ke tengah riwayat | Mengubah prefiks |
| Menghapus satu item secara utuh dan konten lainnya tidak berubah | Menghapus satu pesan lama secara utuh | Tidak memicu alasan penghapusan tersebut, tetapi jumlah cache hit masih mungkin berubah |
| Menambahkan setelah item penalaran | Menambahkan pesan baru sesuai urutan waktu | Tidak memicu alasan penghapusan tersebut |
“Mempersingkat keluaran tool lama” terlihat seperti menghemat Token, tetapi itu termasuk mengubah prefiks. Hanya jika item dihapus secara utuh dan item lainnya tidak berubah, prefix_mismatch tidak akan terpicu. Meskipun demikian, titik awal pencocokan cache juga bisa berubah, sehingga jumlah pembacaan cache tetap perlu diukur secara aktual.
2.2 Perbedaan antara perubahan versi, tingkat, dan keluarga model
Beberapa jenis perubahan ini perlu dinilai secara terpisah:
- Perbedaan versi: OpenAI secara eksplisit menyatakan bahwa penghapusan item penalaran karena
prefix_mismatchadalah perilaku yang dimulai pada GPT-6.2. GPT-6.1 Sol mendukungreasoning.context: all_turns, sehingga dapat merender penalaran yang lebih awal ketika riwayat yang kompatibel tersedia. Saat bermigrasi dari 6.1 ke 6.2, cara pemeliharaan konteks yang ada perlu diverifikasi ulang. - Tingkat penalaran: Kedua generasi Sol menyediakan lima tingkat, yaitu
low,medium,high,xhigh, danmax; Sol 6.2 akan menolaknone. Pendekatan yang dirangkum dalam artikel pihak ketiga OrcaRouter adalah tidak mengubahreasoning.effortsecara langsung di antara permintaan, melainkan menambahkan itemconfiguration_updateke dalaminput. Artikel tersebut juga menyebutkan bahwa riwayat yang berisi item semacam ini akan terpotong secara otomatis dan ditolak oleh/responses/compact. Sebelum menerapkan pendekatan ini, gunakan dokumentasi resmi OpenAI sebagai acuan. - Pergantian keluarga model dan downgrade: Menurut penjelasan OpenAI, mengganti keluarga model atau beralih ke model dengan kemampuan lebih rendah juga dapat menghapus item penalaran yang sudah ada. Ini adalah alasan yang berbeda dari
prefix_mismatch, sehingga saat menghitung, keduanya harus dikelompokkan secara terpisah.
2.3 Posisi dan penagihan instructions tingkat atas pada GPT-6.2
Dokumen OpenAI “Using GPT-6.2” menjelaskan bahwa instructions tingkat atas pada GPT-6.2 akan ditambahkan setelah input dan ditagih sebagai input yang tidak di-cache. Karena itu, tempat ini cocok untuk petunjuk developer sementara pada giliran saat ini, tetapi tidak cocok untuk pengaturan sistem besar yang tidak berubah dalam jangka panjang.
Instruksi yang perlu digunakan kembali dalam jangka panjang sebaiknya ditempatkan sebagai pesan developer pertama di dalam input agar dapat di-cache. Jika perlu menyesuaikan instruksi jangka panjang, tambahkan pesan developer baru di akhir riwayat, jangan kembali mengubah pesan pertama.
3. Mengisolasi Perubahan Biaya Penalaran API Responses dengan Permintaan Kontrol
3.1 Desain Kelompok Kontrol
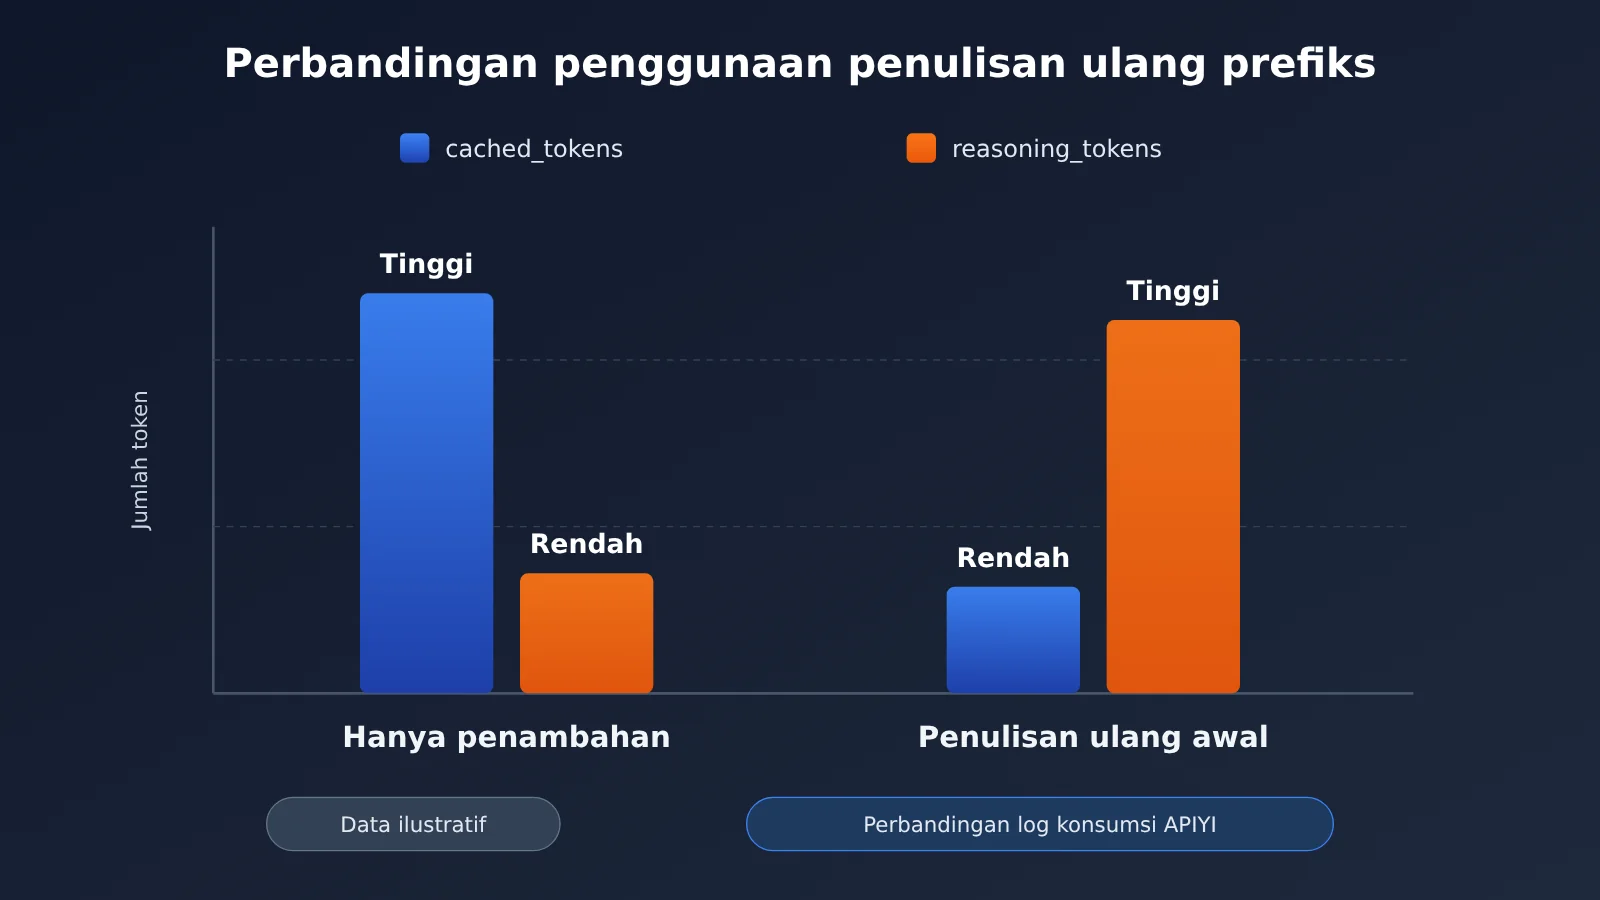
Tetapkan model, tingkat penalaran, definisi alat, dan volume input; ubah hanya satu variabel, yaitu cara memelihara riwayat: kelompok A hanya menambah (append), sedangkan kelompok B menulis ulang satu bagian konten di tahap awal. Kedua kelompok menjalankan beberapa putaran dengan set tugas yang sama.
Setiap permintaan dicatat secara seragam sesuai tabel berikut. Kualitas tugas perlu dinilai secara manual atau oleh skrip evaluasi, karena penurunan biaya tidak boleh dibayar dengan hasil yang lebih buruk.
| Bidang | Sumber | Kegunaan |
|---|---|---|
| Kelompok | Kustom | Membedakan kelompok hanya-tambah dan kelompok tulis ulang |
cached_tokens |
usage.input_tokens_details |
Amati garis pertama |
reasoning_tokens |
usage.output_tokens_details |
Amati garis kedua |
output_tokens |
usage |
Hitung biaya output |
| Latensi | Pengukuran waktu sisi klien | Peningkatan penalaran biasanya disertai waktu yang lebih lama |
| Kualitas tugas | Penilaian manual atau evaluasi | Menyingkirkan kasus menukar kualitas dengan biaya |
x-request-id |
Header respons | Rekonsiliasi |
3.2 Contoh pemanggilan tambah-saja (append-only)
Kode di bawah ini memelihara riwayat input sendiri, dan pada setiap putaran hanya menambahkan di bagian akhir, sekaligus menuliskan penggunaan (usage) dan ID permintaan ke log:
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # tetap untuk seluruh sesi, tidak diubah antar putaran

# prefiks stabil: instruksi yang dapat digunakan ulang diletakkan sebagai item pertama input, setelah itu tidak diubah lagi
history = [{"role": "developer", "content": "Kamu adalah asisten tinjauan kode, jawablah dengan ringkas."}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # apakah grup target dikembalikan perlu diverifikasi dulu
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # tambah-saja: output putaran ini (termasuk item reasoning) dikembalikan apa adanya ke akhir riwayat
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
Kelompok rewrite menggunakan fungsi yang sama: sebelum putaran ke-N, ubah isi history[1] dan set variant menjadi "early_rewrite", parameter lainnya tetap tidak berubah.
🚀 Mulai cepat: saat menyiapkan kelompok pembanding, Anda dapat beralih antara
gpt-6.1-soldangpt-6.2-solmelalui APIYI apiyi.com dengan kunci API yang sama. Dengan struktur log yang sama, Anda bisa membandingkan dampak perbedaan versi terhadap penggunaan cache dan reasoning.
3.3 Diagnostik pendukung pada koneksi langsung resmi
Saat terhubung langsung ke OpenAI, Anda dapat menyetel prompt_cache_options.comparison_response_id ke ID respons sebelumnya, lalu membaca alasan diagnostik dan jumlah token cache yang dikembalikan. input_transformations dalam respons akan mencantumkan item penalaran mana yang dihapus beserta alasannya; di antaranya, prefix_mismatch dapat dipetakan berdasarkan ID ke item penalaran dalam output respons lama.
# Hanya untuk koneksi langsung resmi OpenAI
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
Diagnostik ini memiliki dua batasan: diagnostik cache secara best-effort hanya melaporkan perbedaan pertama, dan tidak dapat memastikan apakah model benar-benar menggunakan kembali penalaran yang dipertahankan. Ia dapat memberi tahu Anda bahwa “item penalaran telah dihapus”, tetapi tidak dapat memberi tahu “berapa biaya tambahan yang dikeluarkan karenanya”; biaya tetap harus dinilai dengan menggabungkan penggunaan berpasangan dari bagian 3.1.
3.4 Hal yang perlu diperhatikan saat memanggil melalui APIYI
Koneksi langsung OpenAI mendukung penyambungan status sesi menggunakan previous_response_id. Panduan pemanggilan native Responses API APIYI (docs.apiyi.com) pada teks utamanya menyatakan bahwa cara berantai tersebut tidak berlaku, tetapi FAQ di halaman yang sama mencatat bahwa pada pengujian 2026-09-02 cara itu dapat digunakan. Kedua pernyataan tersebut tidak konsisten, sehingga baseline yang lebih aman adalah: kelola sendiri riwayat input, sama seperti penulisan pada bagian 3.2.
Penyambungan status, pengiriman kembali item penalaran terenkripsi, serta field diagnostik di atas, perilaku aktualnya dapat berbeda tergantung grup token, sehingga perlu diverifikasi secara terpisah pada grup target. Jika field diagnostik tidak tersedia, log penggunaan berpasangan tetap dapat dijadikan dasar penilaian.
4. Mengurai Biaya Inferensi Responses API dengan Angka dan Menerapkan Perubahan
4.1 Harga Daftar yang Digunakan untuk Estimasi
Berikut adalah harga default untuk konteks pendek dalam tabel harga lengkap APIYI apiyi.com (diperbarui 20 November 2026 pukul 15:17 WIB, satuan dolar AS per juta token). Penagihan aktual juga bergantung pada grup token tempat model berada dan biaya pengisian ulang, jadi keduanya perlu diperiksa secara terpisah.
| ID Model APIYI | Input normal | Baca cache | Output |
|---|---|---|---|
gpt-6.2-sol, gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
Konteks panjang perlu dihitung secara terpisah. Saat input gpt-6.2-sol melebihi 272.000 token, harga input yang tercantum di tabel lengkap APIYI saat ini adalah $3, sedangkan halaman model Standard resmi OpenAI mencantumkan $4; untuk gpt-6.1-sol, harga input konteks panjang sama di kedua sisi, yaitu $4. Untuk harga cache dan harga output pada tingkat konteks panjang, silakan cocokkan dengan aturan penagihan real-time masing-masing kanal.
4.2 Contoh perhitungan pemisahan biaya untuk dua permintaan
Asumsi: konteks pendek, harga standar APIYI Sol, input pada kedua permintaan adalah 12.000 Token, tidak ada penulisan cache yang dicantumkan terpisah, dan tidak ada biaya tool. Semua angka berikut hanyalah asumsi, bukan data hasil pengukuran.
| Item | Prefix dipertahankan | Prefix ditulis ulang |
|---|---|---|
| Pembacaan cache | 9.000 × $0,10/M = $0,0009 | 3.000 × $0,10/M = $0,0003 |
| Input biasa | 3.000 × $2/M = $0,0060 | 9.000 × $2/M = $0,0180 |
| Total output | 1.000 × $10/M = $0,0100 | 1.600 × $10/M = $0,0160 |
| Total | $0,0169 | $0,0343 |
Selisih antara keduanya adalah $0,0174, yang dapat dipecah menjadi dua bagian: $0,0114 berasal dari 6.000 Token input yang berubah dari harga cache menjadi harga input biasa, yaitu 6.000 × ($2 − $0,10) / 1.000.000; $0,0060 berasal dari tambahan 600 Token output. Kedua bagian ini masing-masing berkaitan dengan dua jalur pada Bagian 1. Selisih aktual harus mengacu pada usage Anda sendiri. Jika ada penulisan cache yang dicantumkan terpisah, perhitungan harus dilakukan berdasarkan tiga kategori yang saling eksklusif: input biasa, pembacaan cache, dan penulisan cache.
4.3 Rekonsiliasi dengan ID permintaan
Setelah melakukan estimasi, cocokkan dengan biaya aktual yang ditagih. Di log konsumsi APIYI apiyi.com, temukan catatan type=2 yang sesuai lewat x-request-id di header respons, lalu konversikan dengan quota ÷ 500,000 untuk mendapatkan jumlah dolar biaya aktual yang ditagih. Catat juga model, grup token, rentang waktu pemanggilan, serta pemakaian input dan output untuk permintaan tersebut.
Saat ini belum ada tagihan pembanding prefiks APIYI yang dipublikasikan untuk grup dan tugas yang sama. Karena itu, saat mengevaluasi dampak perubahan, gunakan log permintaan berpasangan dan catatan penagihan Anda sendiri sebagai acuan.
💰 Saran rekonsiliasi: Kaitkan
request_iddi log bagian 3.2 dengan log konsumsi satu per satu untuk mendapatkan tiga kolom: “field pemakaian → estimasi biaya → biaya aktual yang ditagih”. Kolom mana yang menunjukkan selisih, di situ letak masalahnya.
4.4 Tiga perubahan
- Buat definisi alat tetap dan instruksi stabil: Pertahankan urutan definisi alat seperti semula, jangan diubah di tengah sesi; instruksi jangka panjang diletakkan di pesan developer pertama dalam
input, sedangkan petunjuk sementara untuk giliran saat ini bisa memakaiinstructionstingkat atas GPT-6.2, tetapi harus siap menerima bahwa itu ditagih sebagai input yang tidak di-cache. - Tambahkan konteks secara berurutan: Pesan baru, hasil alat baru, dan materi hasil pencarian baru ditambahkan ke bagian akhir. Jika memang perlu meringkas, hapus item secara utuh, jangan menulis ulang isinya.
- Uji konteks panjang dan migrasi versi secara terpisah: Konteks panjang yang melebihi 272,000 token input memakai tarif lain, jadi buat kelompok pembanding terpisah; saat bermigrasi dari
gpt-6.1-solkegpt-6.2-sol, atau menyesuaikan tier dan berganti keluarga model, verifikasi dulu dengan metode pembanding di bagian 3 sebelum diluncurkan secara penuh.
Setelah menyelesaikan perubahan di atas, Anda bisa menguji hasilnya seperti ini: jalankan ulang dua kelompok pembanding pada kumpulan tugas yang sama. Jika proporsi cached_tokens pada kelompok yang hanya menambahkan konteks stabil, reasoning_tokens tidak naik secara tidak wajar, dan biaya aktual yang ditagih—yang dicek berdasarkan ID permintaan—sesuai dengan estimasi, berarti biaya bagian ini sudah terkendali.
Referensi
- OpenAI《Keep the prefix unchanged》: Mempertahankan prefiks dan diagnostik
prefix_mismatch- Tautan:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Tautan:
- OpenAI《Reasoning models》: Reuse item penalaran dan pengecualian penghapusan seluruh item
- Tautan:
developers.openai.com/api/docs/guides/reasoning
- Tautan:
- OpenAI《Prompt caching》dan《Counting tokens》: Aturan pencocokan cache dan field penggunaan
- Tautan:
developers.openai.com/api/docs/guides/prompt-caching
- Tautan:
- OpenAI API Changelog (entri GPT-6.2, 2026-11-17)
- Tautan:
developers.openai.com/api/docs/changelog
- Tautan:
- OrcaRouter《GPT-6.2 Preserved Reasoning》: Pendekatan penulisan ulang hanya-tambah yang dirangkum pihak ketiga
- Tautan:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- Tautan:
- APIYI《Tabel Harga Model Lengkap》
- Tautan:
docs.apiyi.com/models
- Tautan:
- APIYI《API Kueri Log》
- Tautan:
docs.apiyi.com/api-capabilities/log-query
- Tautan:
- APIYI《Panduan Pemanggilan Native OpenAI Responses API》
- Tautan:
docs.apiyi.com/api-capabilities/openai/native
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda situs APIYI, materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com