Zusammenfassung: Bei mehrstufigen Aufrufen der Responses API von GPT-6.2 kann das Umschreiben früher Eingaben die Cache-Trefferquote senken und außerdem dazu führen, dass einige Reasoning-Elemente nicht mehr wiederverwendet werden dürfen. Entwickler können stattdessen auf eine reine Append-Kontextstruktur umstellen und die Kostenunterschiede anschließend anhand paarweiser Nutzungsprotokolle eingrenzen.
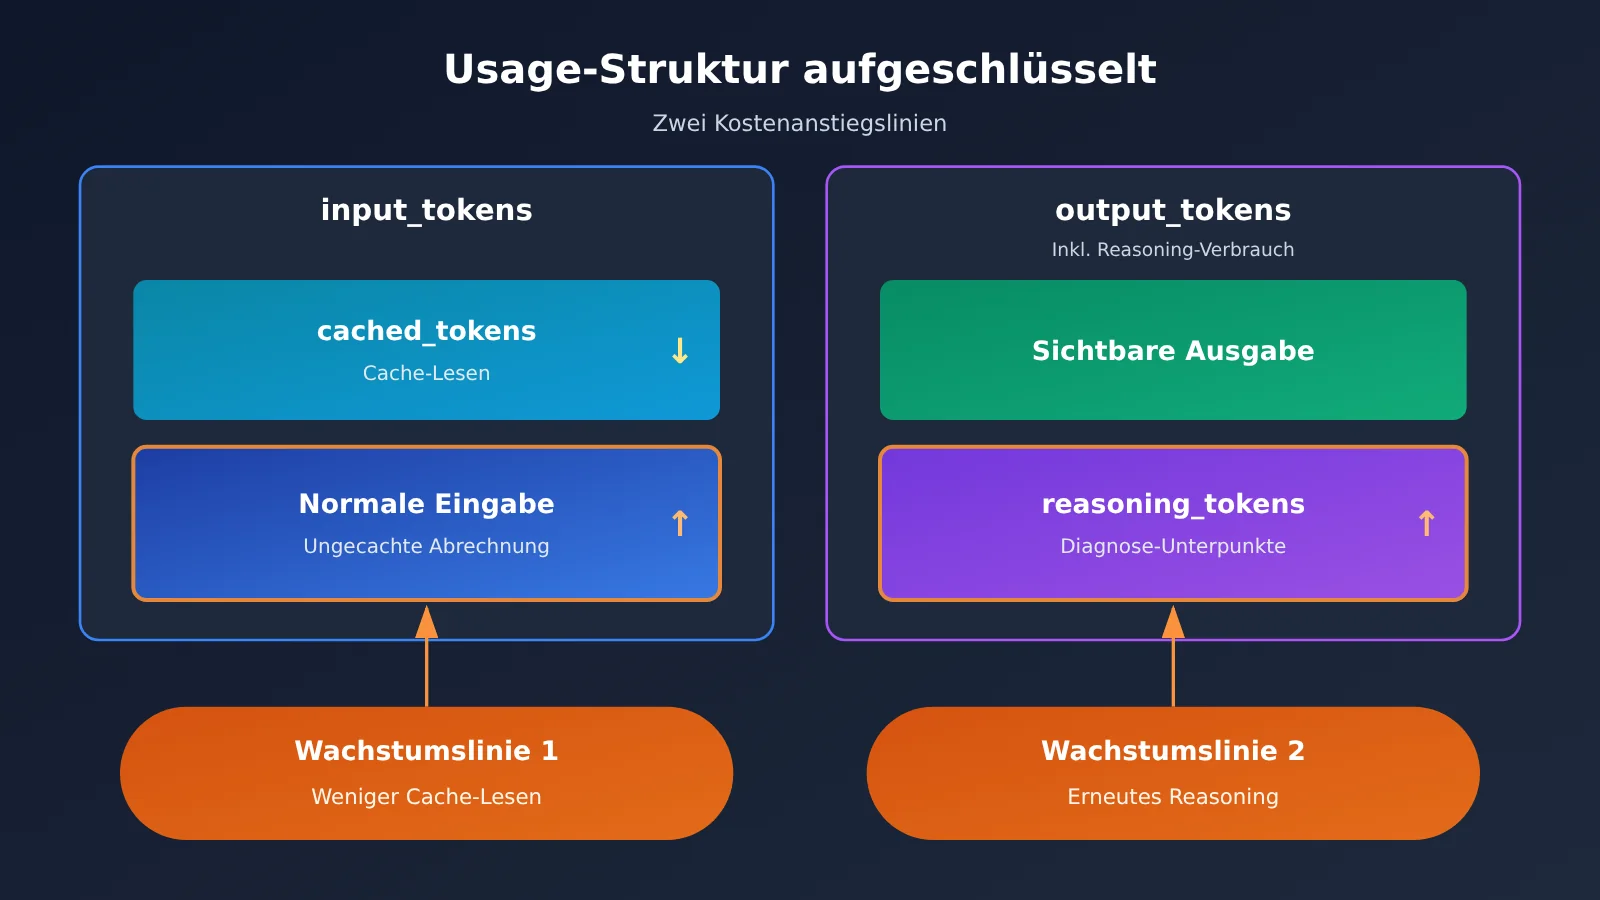
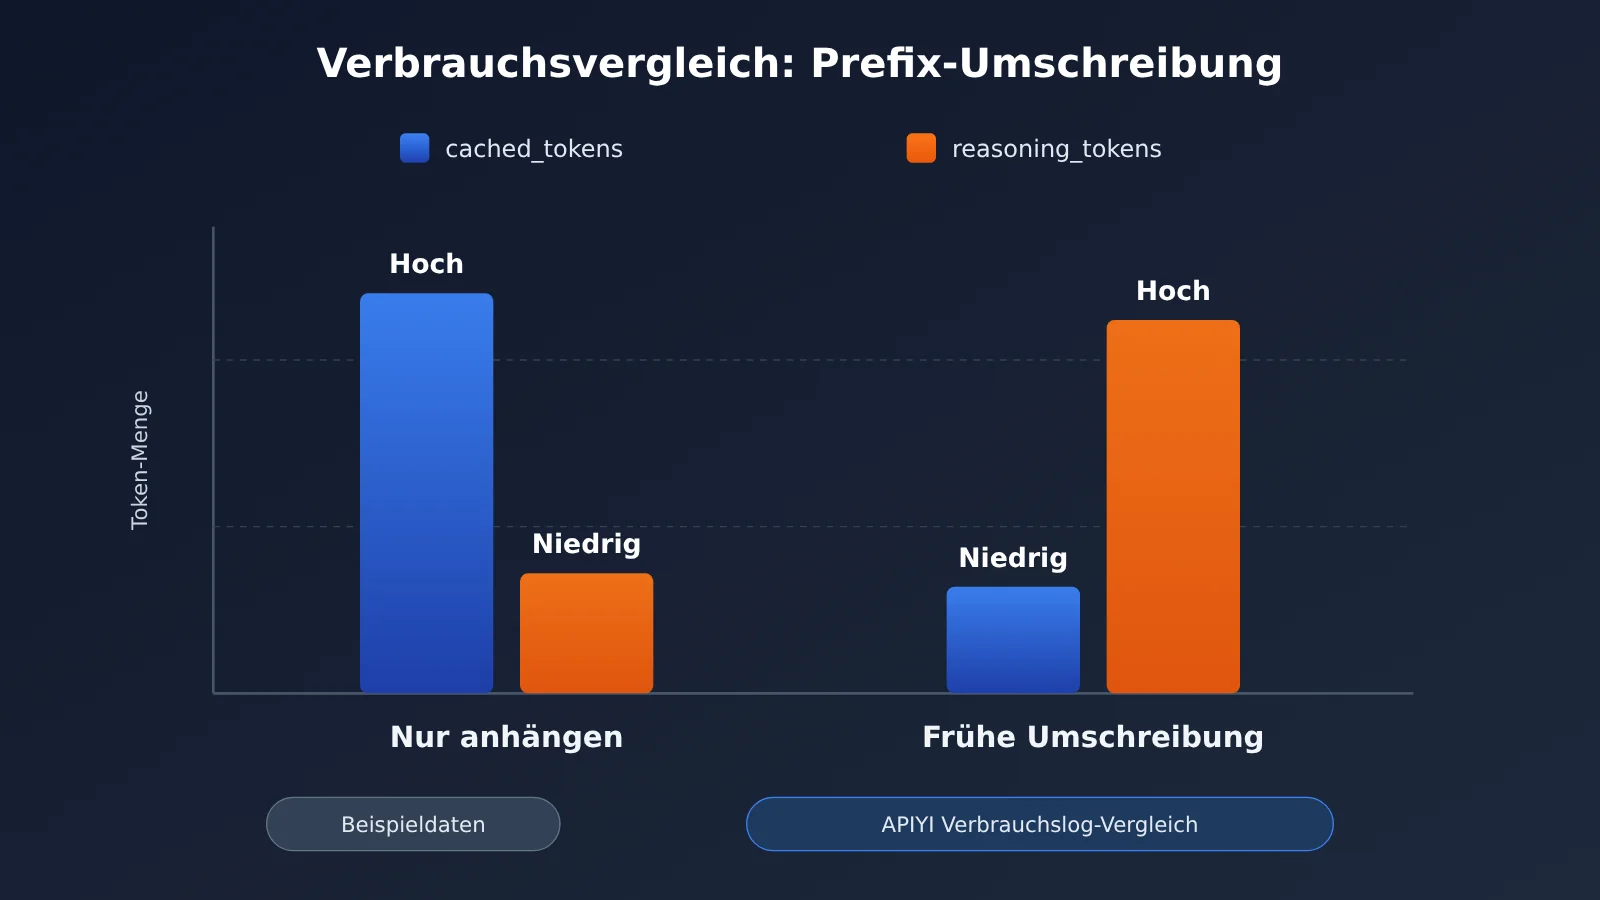
Zuerst das Fazit. Steigende Rechnungen haben meist nicht nur eine Ursache, sondern kommen oft aus zwei Richtungen zusammen: Erstens werden nach einer Änderung des Eingabe-Präfixes weniger Cache-Lesevorgänge verzeichnet, sodass Eingaben, die zuvor zum Cache-Preis abgerechnet wurden, jetzt zum normalen Eingabepreis abgerechnet werden. Zweitens entfernt GPT-6.2 wegen prefix_mismatch frühe Reasoning-Elemente, wodurch das Modell erneut inferieren muss und zusätzliche Inferenzkosten entstehen können. Ob diese beiden Effekte auftreten und wie viel sie jeweils ausmachen, hängt von der Modellversion, der Position der Änderung und dem tatsächlichen usage ab. Das folgende Rechenbeispiel dient nur dazu, die Methode der Kostenaufteilung zu veranschaulichen, und entspricht keiner echten Rechnung. Wer über APIYI (apiyi.com) aufruft, sollte mit der selbst verwalteten input-Historie eine Vergleichsgruppe aufbauen und dann anhand der Verbrauchsprotokolle nachrechnen.
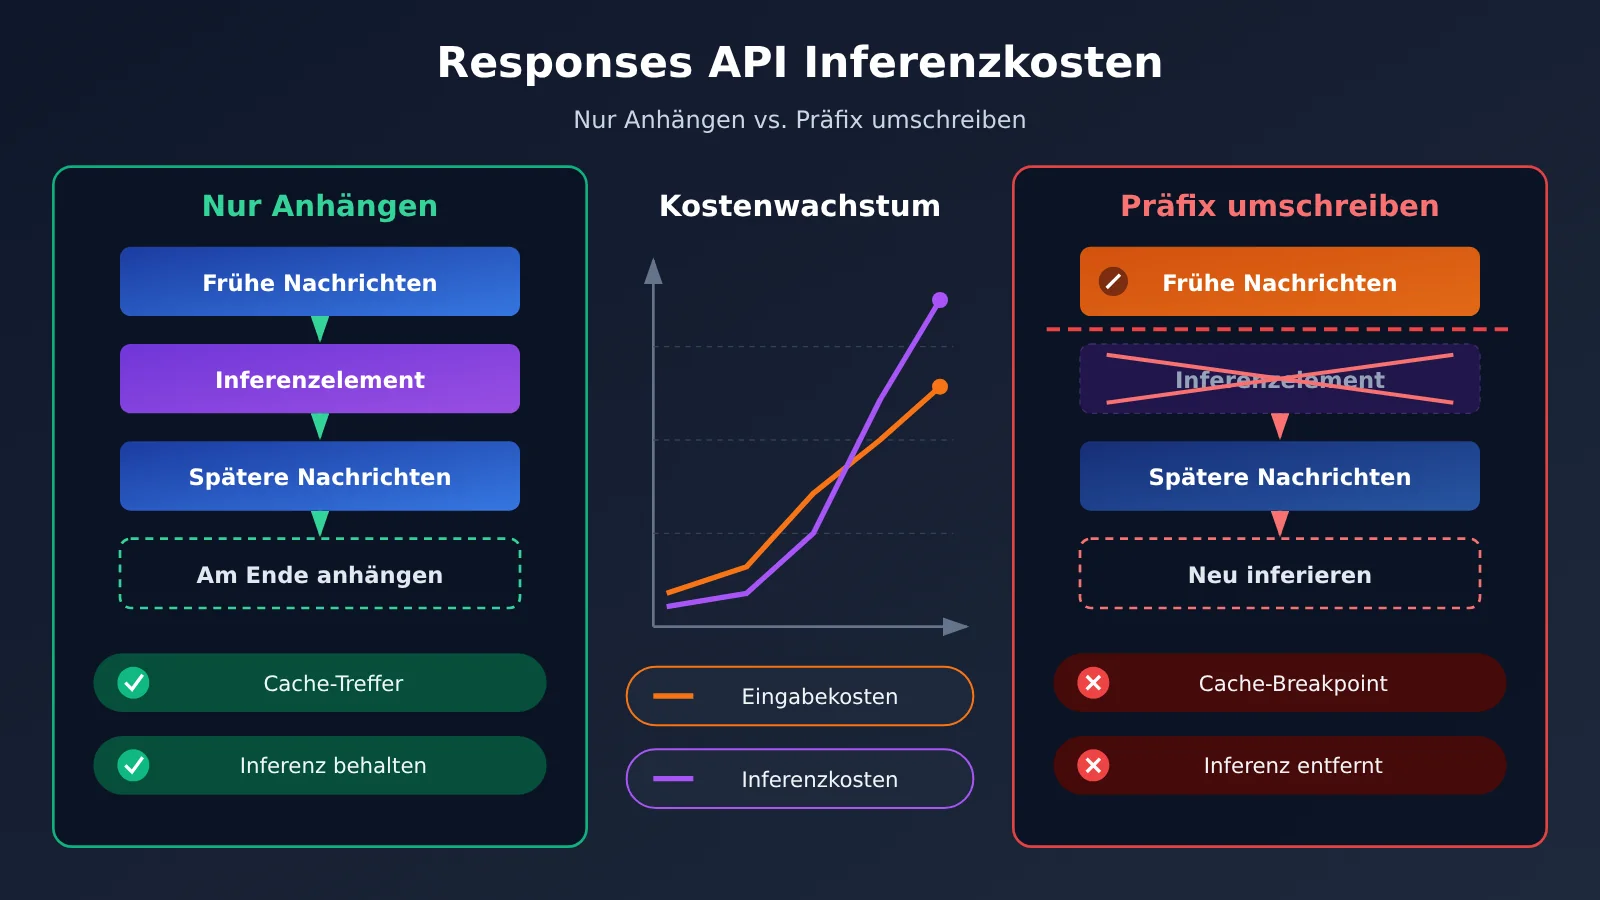
Wissenslandkarte zu den Inferenzkosten der OpenAI Responses API
Die folgende Tabelle zeigt die Inhalte der vier Abschnitte des gesamten Artikels und ihre Beziehungen zueinander sowie die empfohlene Lesereihenfolge. Abschnitt 1 erklärt, woher die Kosten kommen, Abschnitt 2 beschreibt, welche Vorgänge sie auslösen, Abschnitt 3 liefert die Messmethode, und Abschnitt 4 rechnet die gemessenen Zahlen in Geldbeträge um und stellt einen Umbauplan vor.
| Nr. | Beantwortete Frage | Was er für den nächsten Abschnitt liefert | Was man danach tun kann |
|---|---|---|---|
| 1 | Wo die Kosten steigen | Zwei Beobachtungslinien: Cache-Lesen, neu hinzugekommene Ausgaben | Die Bedeutung der relevanten Felder in usage verstehen |
| 2 | Welche Bearbeitungsvorgänge sie auslösen | Eine Liste der Code-Stellen, die geprüft werden müssen | Einschätzen, ob die eigene Art der Kontextpflege riskant ist |
| 3 | Wie man Änderungen isoliert | Eine Reihe vergleichbarer Paardaten | Mit einem Kontrollexperiment bestätigen, ob das Problem tatsächlich besteht |
| 4 | Wie viel Geld die Differenz ausmacht und wie man es behebt | Eine Aufschlüsselungsformel und drei Umbauansätze | Die Differenz schätzen und die tatsächliche Abrechnung anhand der Request-ID abgleichen |
Wenn Sie bereits bestätigt haben, dass eine Präfix-Umschreibung vorliegt, können Sie direkt mit Abschnitt 3 beginnen. Abschnitt 1 und Abschnitt 2 dienen dann als Referenz beim Prüfen.
Kurz erklärt: Begriffe rund um die Inferenzkosten der Responses API
| Begriff | Kurze Erklärung |
|---|---|
| Responses API | OpenAIs Schnittstelle zur einheitlichen Behandlung von Modellantworten, Inferenz und Tool-Aufrufen |
| Eingabe-Präfix | Der frühe Eingabeteil samt Konfiguration, der bei mehreren aufeinanderfolgenden Anfragen zu Beginn in gleicher Reihenfolge beibehalten wird |
| Cache-Treffer | Bei dieser Anfrage werden bereits verarbeitete Eingabe-Token wiederverwendet; dieser Teil wird zum Cache-Lesepreis abgerechnet |
| Reasoning-Element | Ein strukturiertes Element in den Antworten von Reasoning-Modellen, das in kompatiblen Folgeanfragen wiederverwendet werden kann |
prefix_mismatch |
Ein Ursachenwert aus der Diagnose rund um GPT-6.2: Ein früherer Präfix wurde verändert, wodurch das Reasoning-Element entfernt wurde |
| Nur anhängen | Eine Art der Verlaufsführung, bei der bestehende Inhalte und ihre Reihenfolge erhalten bleiben und spätere Ereignisse nur am Ende ergänzt werden |
reasoning_tokens |
Der Reasoning-Unterposten in der Ausgabennutzung, an dem sich der Reasoning-Verbrauch ablesen lässt |
x-request-id |
Die Anfragekennung im Antwort-Header, mit der sich die Antwort beim Client den Logs des Anbieters zuordnen lässt |
1. Warum die Inferenzkosten der Responses API an zwei Stellen steigen
1.1 Die erste Linie: weniger Cache-Lesevorgänge
Laut OpenAIs Dokumentation „Prompt caching“ beginnt der Abgleich des Prompt-Cache am Anfang der Anfrage. Sobald ein früher Abschnitt verändert wird, lässt sich der gesamte Teil ab der Änderungsstelle nicht mehr zum Cache-Lesepreis abrechnen und wird stattdessen zum normalen Eingabepreis berechnet. Nehmen wir als Beispiel den Kurzkontext-Preis für gpt-6.2-sol aus der APIYI-Preistabelle: Die normale Eingabe liegt bei 2 US-Dollar pro Million Token, das Cache-Lesen bei 0,10 US-Dollar — ein Unterschied um den Faktor 20.
Diese Kostenverschiebung hat ein passendes Feld in usage: Die Gesamtmenge input_tokens kann nahezu unverändert bleiben, doch der darin enthaltene Anteil cached_tokens wird kleiner. Schaut man nur auf die gesamte Eingabemenge, entdeckt man dieses Problem nicht — die Cache-Lesemenge muss separat erfasst werden.
1.2 Die zweite Linie: neue Ausgabe, nachdem Reasoning-Elemente ihre Wiederverwendbarkeit verloren haben
Im API Changelog von OpenAI vom 2026-11-17 ist vermerkt, dass „das Bearbeiten früherer Verlaufsabschnitte dazu führt, dass Reasoning-Elemente mit der Begründung prefix_mismatch entfernt werden“ — als Verhalten ab GPT-6.2. Nach dem Entfernen sieht das Modell in den folgenden Runden die vorherigen Reasoning-Inhalte nicht mehr und muss unter Umständen erneut inferieren, wodurch zusätzliche Inferenzkosten entstehen können.
Diese Linie zeigt sich auf der Ausgabeseite: reasoning_tokens und die Gesamtausgabe werden größer. Sie kann gleichzeitig mit weniger Cache-Lesevorgängen auftreten, in usage handelt es sich jedoch um zwei unabhängige Felder, die bei der Fehlersuche getrennt betrachtet werden müssen.
1.3 Das Verhältnis von output_tokens und reasoning_tokens
Laut OpenAIs „Counting tokens“ enthält output_tokens den Reasoning-Verbrauch bereits, output_tokens_details.reasoning_tokens ist nur ein diagnostischer Unterposten davon. Für die Kostenberechnung multipliziert man output_tokens mit dem Ausgabepreis. Würde man reasoning_tokens zusätzlich separat addieren, käme es zu einer Doppelzählung.
2. Welche Präfix-Bearbeitungen die Inferenzkosten erhöhen
2.1 Häufige Operationen, die prefix_mismatch auslösen
Laut OpenAI-Dokumentation „Keep the prefix unchanged“ und „Reasoning models“ zählen die folgenden Operationen zum Umschreiben des Präfix und können bei GPT-6.2 dazu führen, dass Reasoning-Elemente entfernt werden:
| Operation | Typisches Codeszenario | Risiko |
|---|---|---|
| Alte Nachrichten umschreiben | Nachträgliches Korrigieren der Formulierung aus Runde 2 des Nutzers oder Ergänzen eines Zeitstempels bei einer alten Nachricht | Präfix wird umgeschrieben |
| Alte Tool-Ergebnisse umschreiben | Kürzen des JSON aus einem früheren Tool-Aufruf, um Token zu sparen | Präfix wird umgeschrieben (auch Kürzen gilt als Umschreiben) |
| Inhalte vor einem zugehörigen Reasoning-Element einfügen | Neu abgerufene Materialien mitten in den Verlauf einschieben | Präfix wird umgeschrieben |
| Ein Element vollständig löschen, restlicher Inhalt bleibt unverändert | Eine vollständige alte Nachricht entfernen | Löst diesen Entfernungsgrund nicht aus, die Cache-Treffermenge kann sich jedoch ändern |
| Nach dem Reasoning-Element anhängen | Neue Nachrichten in zeitlicher Reihenfolge hinzufügen | Löst diesen Entfernungsgrund nicht aus |
„Alte Tool-Ausgaben kürzen“ sieht nach Token-Einsparung aus, ist aber ein Umschreiben. Nur wenn ein vollständiges Element gelöscht wird und die übrigen Elemente unverändert bleiben, wird prefix_mismatch nicht ausgelöst. Selbst dann kann sich der Ausgangspunkt des Cache-Abgleichs verschieben, sodass die Menge der Cache-Lesevorgänge weiterhin praktisch gemessen werden muss.
2.2 Unterschiede zwischen Versions-, Stufen- und Modellfamilien-Wechsel
Diese Arten von Änderungen müssen getrennt bewertet werden:
- Versionsunterschiede: OpenAI stellt ausdrücklich klar, dass das Entfernen von Reasoning-Elementen aufgrund von
prefix_mismatchein Verhalten ist, das mit GPT-6.2 beginnt. GPT-6.1 Sol unterstütztreasoning.context: all_turnsund kann ältere Reasoning-Inhalte rendern, sofern ein kompatibler Verlauf verfügbar ist. Beim Migrieren von 6.1 auf 6.2 muss die bisherige Art der Kontextpflege erneut validiert werden. - Reasoning-Stufen: Beide Sol-Generationen bieten die fünf Stufen
low,medium,high,xhigh,max; 6.2 Sol lehntnoneab. Der in einem Drittanbieter-Artikel von OrcaRouter beschriebene Ansatz besteht darin,reasoning.effortnicht direkt zwischen den Anfragen zu ändern, sondern stattdessen einenconfiguration_update-Eintrag ininputanzuhängen. Derselbe Artikel weist darauf hin, dass Verläufe mit solchen Einträgen automatisch abgeschnitten und von/responses/compactabgelehnt werden. Bevor Sie diesen Ansatz übernehmen, sollten Sie sich an der offiziellen OpenAI-Dokumentation orientieren. - Wechsel der Modellfamilie und Downgrade: Laut OpenAI kann auch ein Wechsel der Modellfamilie oder die Verwendung eines weniger fähigen Modells vorhandene Reasoning-Elemente entfernen. Das ist ein anderer Grund als
prefix_mismatchund sollte in der Auswertung separat kategorisiert werden.
2.3 Position und Abrechnung der Top-Level-instructions bei GPT-6.2
In „Using GPT-6.2“ erklärt OpenAI, dass die Top-Level-instructions von GPT-6.2 nach input angehängt und als nicht gecachte Eingabe abgerechnet werden. Deshalb eignen sie sich für temporäre Developer-Hinweise der aktuellen Runde, nicht für langfristig unveränderte, umfangreiche Systemvorgaben.
Anweisungen, die langfristig wiederverwendet werden sollen, gehören als erste Developer-Nachricht in input, damit sie gecacht werden können. Wenn Sie langfristige Anweisungen anpassen wollen, hängen Sie eine neue Developer-Nachricht am Ende des Verlaufs an, statt die erste rückwirkend zu ändern.
3. Mit Kontrollanfragen Änderungen der Inferenzkosten der Responses API isolieren
3.1 Design der Kontrollgruppe
Modell, Reasoning-Stufe, Tool-Definitionen und Eingabemenge werden konstant gehalten; geändert wird nur eine Variable: die Art der Verwaltung des Gesprächsverlaufs. Gruppe A hängt ausschließlich an, Gruppe B schreibt an einer frühen Stelle einen Inhalt um. Beide Gruppen führen mehrere Durchläufe aus und verwenden denselben Aufgabensatz.
Jede Anfrage wird einheitlich gemäß der folgenden Tabelle protokolliert. Die Aufgabenqualität muss manuell oder durch ein Evaluierungsskript bewertet werden, denn eine Kostensenkung darf nicht auf Kosten schlechterer Ergebnisse gehen.
| Feld | Quelle | Zweck |
|---|---|---|
| Gruppe | selbst definiert | Unterscheidung zwischen der Nur-Anhängen-Gruppe und der Umschreibungsgruppe |
cached_tokens |
usage.input_tokens_details |
Beobachtung der ersten Kostenlinie |
reasoning_tokens |
usage.output_tokens_details |
Beobachtung der zweiten Kostenlinie |
output_tokens |
usage |
Berechnung der Ausgabekosten |
| Latenz | clientseitige Messung | Mehr Reasoning geht in der Regel mit längerer Laufzeit einher |
| Aufgabenqualität | manuelle oder Evaluierungsbewertung | Ausschluss des Falls, dass Qualität gegen Kosten eingetauscht wird |
x-request-id |
Antwort-Header | Abgleich |
3.2 Beispiel für einen Append-only-Aufruf
Der folgende Code verwaltet den input-Verlauf selbst, hängt in jeder Runde nur am Ende an und schreibt Nutzung sowie Request-ID in ein Log:
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # Für die gesamte Sitzung festgelegt; wird nicht zwischen den Runden geändert

# Stabiler Präfix: wiederverwendbare Anweisungen als erster input-Eintrag, danach nicht mehr ändern
history = [{"role": "developer", "content": "你是代码审查助手,回答简洁。"}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # Ob die Zielgruppierung dies zurückliefert, muss zuerst geprüft werden
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # Nur anhängen: Ausgabe dieser Runde (inklusive Reasoning-Elementen) unverändert ans Ende des Verlaufs stellen
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
Die Rewrite-Gruppe verwendet dieselbe Funktion: Vor der N-ten Runde den Inhalt von history[1] ändern und variant auf "early_rewrite" setzen; alle übrigen Parameter bleiben unverändert.
🚀 Schnellstart: Beim Aufbau der Kontrollgruppe kannst du über APIYI apiyi.com mit demselben API-Schlüssel zwischen
gpt-6.1-solundgpt-6.2-solwechseln. Mit derselben Log-Struktur lässt sich vergleichen, wie sich Versionsunterschiede auf Cache- und Reasoning-Nutzung auswirken.
3.3 Unterstützende Diagnose bei offizieller Direktverbindung
Bei einer Direktverbindung zu OpenAI können Sie prompt_cache_options.comparison_response_id auf die ID einer früheren Antwort setzen und anschließend den zurückgegebenen Diagnosegrund sowie die Anzahl der gecachten Token auslesen. Die input_transformations in der Antwort listen auf, welche Reasoning-Elemente entfernt wurden und aus welchem Grund; dabei lässt sich prefix_mismatch anhand der ID den Reasoning-Elementen in der Ausgabe der alten Antwort zuordnen.
# Nur für die offizielle Direktverbindung zu OpenAI
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
Diese Diagnose hat zwei Einschränkungen: Die Cache-Diagnose meldet nach dem Best-Effort-Prinzip nur die erste Abweichung und kann nicht bestätigen, ob das Modell die beibehaltenen Reasoning-Elemente tatsächlich wiederverwendet hat. Sie sagt Ihnen zwar „das Reasoning-Element wurde entfernt“, aber nicht „so viel hat das zusätzlich gekostet“; die Kosten müssen weiterhin zusammen mit den paarweisen Verbrauchswerten aus Abschnitt 3.1 beurteilt werden.
3.4 Hinweise beim Aufruf über APIYI
Die Direktverbindung zu OpenAI unterstützt das Fortsetzen des Sitzungszustands über previous_response_id. Der Leitfaden für native Aufrufe der Responses API von APIYI (docs.apiyi.com) behauptet im Fließtext, diese Verkettung funktioniere nicht, doch die FAQ auf derselben Seite dokumentiert, dass sie am 2026-09-02 in der Praxis funktionierte. Da sich die beiden Angaben widersprechen, ist die sicherere Basis: den input-Verlauf selbst zu verwalten, wie in Abschnitt 3.2 beschrieben.
Das Fortsetzen des Zustands, die Rückübertragung verschlüsselter Reasoning-Elemente sowie die genannten Diagnosefelder können sich in der Praxis je nach Token-Gruppe unterschiedlich verhalten und müssen in der Zielgruppe separat überprüft werden. Falls die Diagnosefelder nicht verfügbar sind, können paarweise Verbrauchsprotokolle weiterhin als Grundlage für die Beurteilung dienen.
4. Die Inferenzkosten der Responses API mit Zahlen aufschlüsseln und die Umstellung konkret umsetzen
4.1 Die für die Schätzung verwendeten Listenpreise
Die folgenden Angaben sind die Standard-Listenpreise für kurzen Kontext aus der Gesamtpreistabelle von APIYI apiyi.com (aktualisiert am 20.11.2026, 15:17 Uhr Pekinger Zeit, Einheit: US-Dollar pro Million Token). Die tatsächliche Abrechnung hängt zusätzlich von der Token-Gruppe des jeweiligen Modells und den Aufladungskosten ab – beides muss separat geprüft werden.
| APIYI-Modell-ID | Normaler Input | Cache-Lesen | Output |
|---|---|---|---|
gpt-6.2-sol, gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
Langer Kontext muss separat berechnet werden. Überschreitet der Input bei gpt-6.2-sol 272,000 Token, so liegt der in der aktuellen Gesamttabelle von APIYI aufgeführte Inputpreis bei $3, während die offizielle Standard-Modellseite von OpenAI $4 angibt; bei gpt-6.1-sol beträgt der Inputpreis für langen Kontext auf beiden Seiten $4. Die Cache-Preise und Output-Preise der Langkontext-Stufe prüfen Sie bitte anhand der Echtzeit-Abrechnungsregeln des jeweiligen Kanals.
4.2 Rechenbeispiel zur Kostenaufteilung zweier Anfragen
Annahmen: kurzer Kontext, Standardpreis von APIYI Sol, die Eingabe beider Anfragen umfasst jeweils 12,000 Token, es gibt keine separat ausgewiesenen Cache-Schreibvorgänge und keine Tool-Gebühren. Alle folgenden Zahlen sind Annahmen, keine Messdaten.
| Posten | Beibehaltener Präfix | Umgeschriebener Präfix |
|---|---|---|
| Cache-Lesen | 9,000 × $0.10/M = $0.0009 | 3,000 × $0.10/M = $0.0003 |
| Normaler Input | 3,000 × $2/M = $0.0060 | 9,000 × $2/M = $0.0180 |
| Gesamtausgabe | 1,000 × $10/M = $0.0100 | 1,600 × $10/M = $0.0160 |
| Summe | $0.0169 | $0.0343 |
Die Differenz zwischen beiden beträgt $0.0174 und lässt sich in zwei Teile zerlegen: $0.0114 entfallen auf 6,000 Eingabe-Token, die vom Cache-Preis zum normalen Eingabepreis wechseln, also 6,000 × ($2 − $0.10) / 1,000,000; $0.0060 entfallen auf die 600 zusätzlichen Gesamtausgabe-Token. Diese beiden Teile entsprechen den zwei Linien aus Abschnitt 1. Für die tatsächliche Differenz ist deine eigene usage maßgeblich. Wenn Cache-Schreibvorgänge separat ausgewiesen werden, sind sie getrennt nach den drei sich gegenseitig ausschließenden Kategorien normaler Input, Cache-Lesen und Cache-Schreiben zu berechnen.
4.3 Abgleich anhand der Request-ID
Nach der Schätzung prüfen Sie die tatsächliche Abrechnung. Suchen Sie in den Verbrauchsprotokollen von APIYI apiyi.com anhand der x-request-id aus dem Antwort-Header den passenden Datensatz mit type=2 und rechnen Sie mit quota ÷ 500,000 den tatsächlich abgerechneten Dollarbetrag aus. Notieren Sie dabei auch Modell, Token-Gruppierung, Aufrufzeitraum sowie die Input- und Output-Nutzung dieser Anfrage.
Derzeit gibt es keine öffentlich zugänglichen Präfix-Vergleichsabrechnungen von APIYI für dieselbe Gruppe und dieselbe Aufgabe. Für die Bewertung der Umbaumaßnahmen sollten daher Ihre eigenen paarweisen Anfrageprotokolle und Abrechnungsdatensätze maßgeblich sein.
💰 Tipp zum Abgleich: Verknüpfen Sie die
request_idaus den Protokollen in Abschnitt 3.2 einzeln mit den Verbrauchsprotokollen und erstellen Sie drei Spalten: „Nutzungsfeld → geschätzter Betrag → tatsächliche Abrechnung“. Wenn eine Spalte abweicht, zeigt das, an welcher Stelle das Problem liegt.
4.4 Drei Umbaumaßnahmen
- Tool-Definitionen fixieren und stabile Anweisungen verwenden: Die Tool-Definitionen behalten ihre ursprüngliche Reihenfolge und werden nicht mitten in der Sitzung geändert; langfristige Anweisungen stehen in der ersten Developer-Nachricht in
input, während temporäre Hinweise für den aktuellen Durchlauf über das Top-Level-Feldinstructionsvon GPT-6.2 laufen können – allerdings muss man akzeptieren, dass sie als ungecachter Input abgerechnet werden. - Kontext in der richtigen Reihenfolge anhängen: Neue Nachrichten, neue Tool-Ergebnisse und neu abgerufene Materialien werden ans Ende angehängt. Wenn tatsächlich gekürzt werden muss, löschen Sie ganze Einträge, statt deren Inhalt umzuschreiben.
- Langkontext und Versionsmigration separat testen: Bei einem Langkontext von mehr als 272.000 Input-Token gilt eine andere Preisstufe, daher sollte eine eigene Kontrollgruppe eingerichtet werden; bei der Migration von
gpt-6.1-solzugpt-6.2-soloder beim Wechsel der Preisstufe bzw. der Modellfamilie sollten Sie zuerst mit der Vergleichsmethode aus Abschnitt 3 validieren und erst dann vollständig ausrollen.
Nach Abschluss der oben genannten Umbaumaßnahmen können Sie die Wirkung so prüfen: Führen Sie auf demselben Aufgaben-Set erneut zwei Vergleichsgruppen aus. Wenn der Anteil der cached_tokens in der Nur-Anhängen-Gruppe stabil bleibt, die reasoning_tokens nicht ungewöhnlich ansteigen und die anhand der Request-ID abgeglichenen tatsächlichen Abrechnungen mit den Schätzungen übereinstimmen, sind die Kosten in diesem Bereich unter Kontrolle.
Referenzen
- OpenAI „Keep the prefix unchanged“: Präfix-Erhalt und die
prefix_mismatch-Diagnose- Link:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Link:
- OpenAI „Reasoning models“: Wiederverwendung von Reasoning-Elementen und die Ausnahme beim vollständigen Löschen eines Elements
- Link:
developers.openai.com/api/docs/guides/reasoning
- Link:
- OpenAI „Prompt Caching“ und „Counting tokens“: Cache-Matching-Regeln und Usage-Felder
- Link:
developers.openai.com/api/docs/guides/prompt-caching
- Link:
- OpenAI API Changelog (Eintrag zu GPT-6.2, 17.11.2026)
- Link:
developers.openai.com/api/docs/changelog
- Link:
- OrcaRouter „GPT-6.2 Preserved Reasoning“: eine von Drittanbietern zusammengestellte Darstellung der reinen Append-Umschreibpraxis
- Link:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- Link:
- APIYI „Gesamtübersicht der Modellpreise“
- Link:
docs.apiyi.com/models
- Link:
- APIYI „Log-Abfrage-API“
- Link:
docs.apiyi.com/api-capabilities/log-query
- Link:
- APIYI „Leitfaden zum nativen Aufruf der OpenAI Responses API“
- Link:
docs.apiyi.com/api-capabilities/openai/native
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Melden Sie sich gern über die Startseite der APIYI-Website bei uns – weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com