Nota del autor: A partir de los datos de pruebas reales de Kimi K3, cuyo código ya es abierto, estimamos los requisitos de hardware, el costo mensual, el costo por token y el punto de equilibrio para desplegar K3.1 Pro localmente. Así podrás decidir cuándo conviene alquilar, comprar o usar directamente la API.
Empecemos por la conclusión: Kimi K3.1 Pro está a punto de hacerse de código abierto, pero el despliegue local no es para usuarios particulares. Según la información oficial, los pesos completos se publicarán antes del 4 de noviembre. El modelo se presenta como un modelo de pesos abiertos de escala 3T. A 26 de octubre de 2026, los pesos de K3.1 Pro aún no se han publicado. Todas las cifras de hardware y memoria de video de este artículo se estiman a partir de las mediciones reales de Kimi K3, que ya está disponible como código abierto. Habrá que revisarlas cuando se publiquen los pesos.
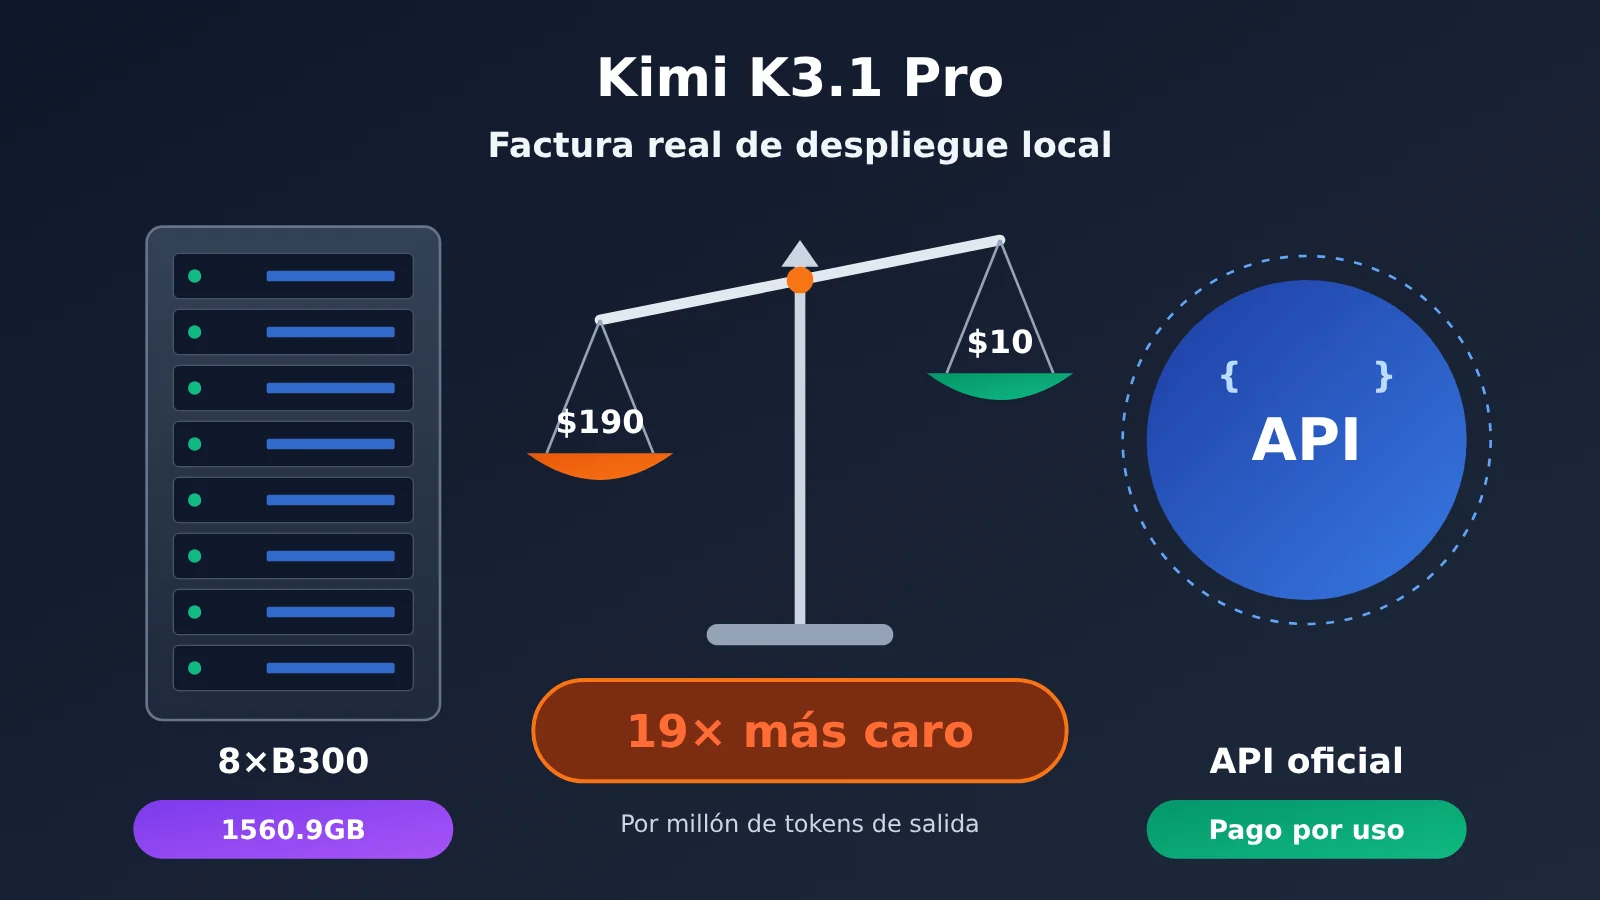
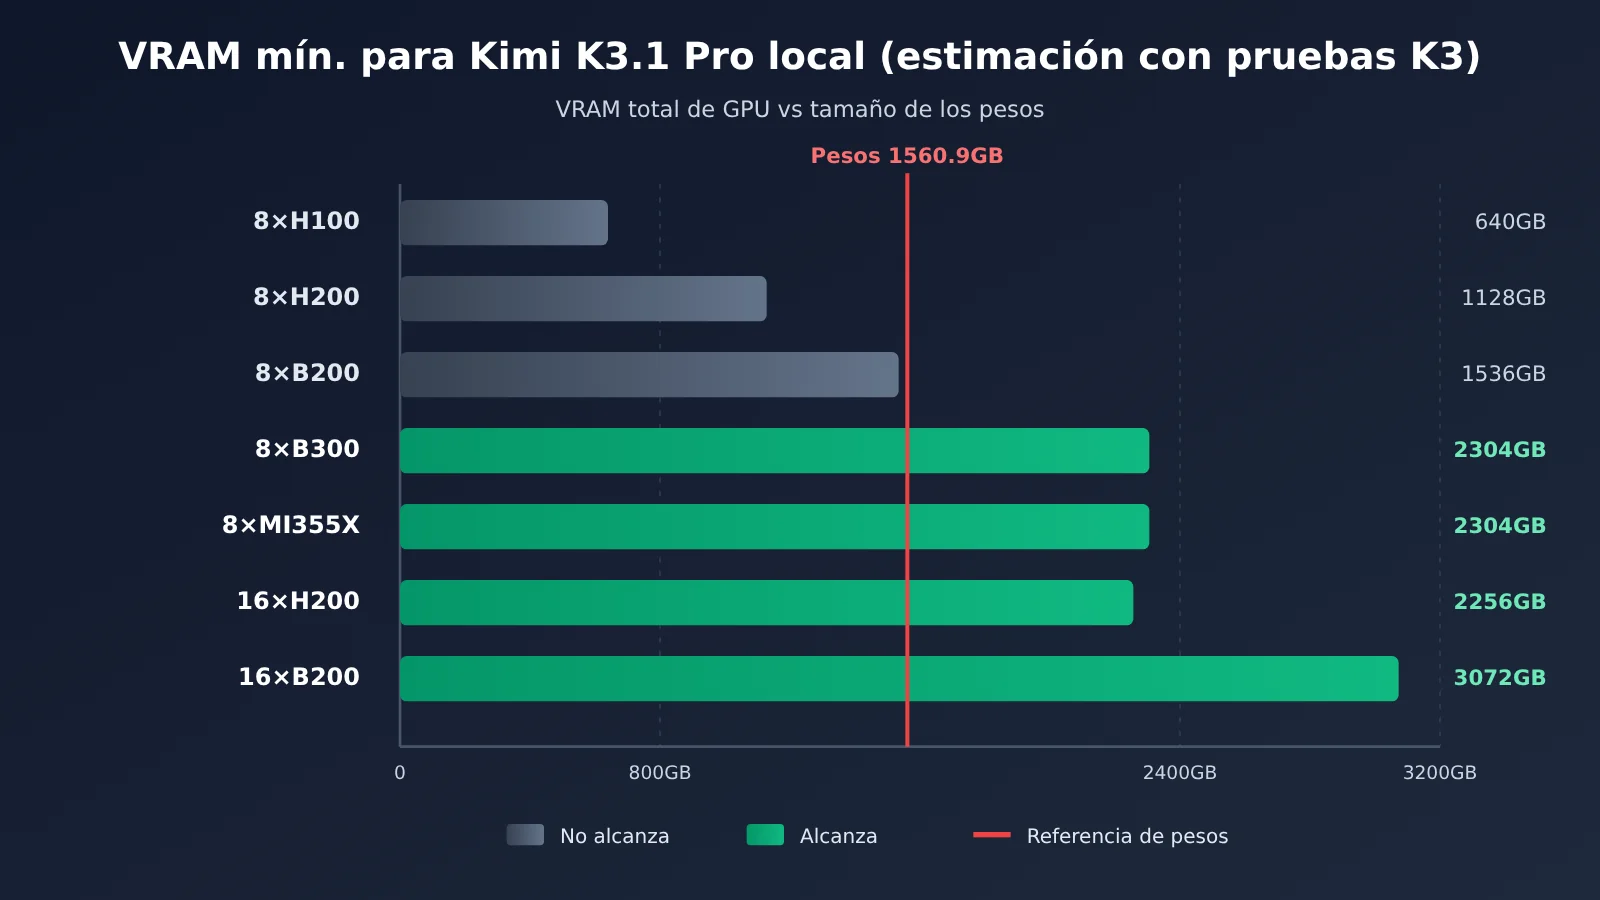
Según las mediciones de K3, solo los pesos ocupan 1560,9 GB: caben justo en 8 B300, mientras que con 8 H200 faltan unos 400 GB. Si tienes un equipo con 8×B300 dedicado únicamente a tu uso, el costo por cada millón de tokens de salida ronda los $190.00: 19 veces el precio de la API oficial ($10.00).
Este artículo no pretende desanimarte, sino ayudarte a decidir si te conviene montar tu propia infraestructura. Indicamos si cada cifra procede de una fuente oficial, de pruebas de terceros o de una estimación nuestra, para que puedas aplicar los cálculos directamente a tu volumen de negocio.
Qué te llevas: al terminar de leer, podrás calcular el costo real de desplegar Kimi K3.1 Pro por tu cuenta y usar una lista de comprobación para decidir si te conviene alquilar servidores, comprarlos o llamar directamente a la API.
Aspectos clave del despliegue local de Kimi K3.1 Pro
| Aspecto | Conclusión | Nivel de evidencia |
|---|---|---|
| Estado de los pesos | Aún no se han publicado; según la declaración oficial, se publicarán antes del 4 de noviembre | Texto oficial |
| Tamaño de los pesos | Los pesos de K3 ocupan 1560,9 GB; la arquitectura de K3.1 Pro mantiene la misma base | Pruebas de terceros (K3) |
| Mínimo para una sola máquina | 8×B300 / 8×GB300 / 8×MI355X | Configuración recomendada por los frameworks de inferencia + pruebas reales |
| Costo unitario para uso propio | Aproximadamente 190,00 USD por millón de tokens de salida | Factura de pruebas de terceros |
| Condiciones para igualar el costo de la API | Mantener una salida estable superior a 1500 tok/s a largo plazo | Estimación de este artículo |
Cómo interpretar los distintos niveles de evidencia sobre el despliegue local de Kimi K3.1 Pro
En este artículo distinguimos tres niveles de evidencia; tenlos en cuenta al leerlo. Texto oficial se refiere a lo publicado por Moonshot en el blog de kimi.ai, la documentación de platform.kimi.ai y las fichas de modelos de Hugging Face. Pruebas de terceros hace referencia a datos de pruebas publicados por AWS, GPUStack, OpenZeka y usuarios de Modal, entre otros. En cada caso indicaremos la fuente y la fecha. Estimación de este artículo son cálculos que hemos realizado a partir de precios públicos y tasas de rendimiento. Indicaremos las fórmulas y los supuestos; estas cifras no son datos oficiales.
La estimación también se basa en información oficial: K3.1 Pro es una versión de Kimi K3 sometida a postentrenamiento (post-trained version of Kimi K3) y mantiene la misma arquitectura, pero utiliza más capacidad de cómputo para el postentrenamiento con RL. Por eso, el número de parámetros, los formatos de cuantización y el tamaño de los pesos de K3 sirven como una referencia razonable para establecer los requisitos mínimos de despliegue de K3.1 Pro.
Requisitos de hardware para desplegar Kimi K3.1 Pro localmente: por qué hay que empezar con 8 B300
【Datos oficiales】La ficha del modelo K3 indica que tiene 2,8 T de parámetros totales, 104 B de parámetros activos y 93 capas. Cuenta con 896 expertos de enrutamiento; cada token selecciona 16, además de 2 expertos compartidos. Su contexto es de 1.048.576 tokens. Los pesos usan MXFP4 y las activaciones, MXFP8. El entrenamiento con conciencia de cuantización se aplica desde la etapa de SFT.
【Pruebas de terceros】Alguien contabilizó uno a uno los archivos del repositorio de Hugging Face: los 96 fragmentos safetensors suman 1.560.936.091.448 bytes, unos 1.560,9 GB. El tamaño medido supera el valor teórico de «2,8 T × 0,5 bytes = 1.400 GB» porque algunas partes que aparecen en la lista de permitidos del archivo config —como las capas de atención, los expertos compartidos, lm_head y la torre visual— conservan una precisión mayor. La receta de vLLM indica un mínimo de 1.680 GB de memoria GPU y especifica que se necesitan al menos 8×GB300. Para cargas de producción reales hacen falta varios nodos.
| Configuración | Memoria GPU total | ¿Puede ejecutarse? | Observaciones |
|---|---|---|---|
| 8×H100 80GB | 640GB | No | Los pesos ocupan 2,4 veces la memoria disponible |
| 32×H100 | 2,56TB | Con dificultad | SGLang tiene una receta, pero Hopper no es compatible de forma nativa con MXFP4 y requiere descuantización en tiempo de ejecución |
| 8×H200 141GB | 1,13TB | No | Faltan unos 400GB; es la opción que se queda más cerca |
| 16×H200 (dos equipos) | 2,26TB | Sí | También requiere des cuantización |
| 8×B200 180GB | 1,44TB | No | Faltan unos 120GB |
| 16×B200 / GB200 | 2,88TB | Sí | Configuración de referencia Blackwell |
| 8×B300 / GB300 | 2,30TB | Sí | Ruta predeterminada oficial; cabe justo en un solo equipo |
| 8×MI355X | 2,30TB | Sí | Validación de AMD desde el día cero |
| Una GPU / RTX 4090 / Mac de 512GB | — | No | Harían falta 75 RTX 4090 para que cupieran los pesos |
La caché KV no es el cuello de botella. K3 solo tiene 24 capas Gated MLA, que requieren unos 27 KiB por token; las otras 69 capas KDA necesitan únicamente un estado fijo por secuencia. Según los cálculos de terceros, la caché KV para un usuario con un contexto de 1 M de tokens ocupa unos 29,5 GB, y con un contexto de 8K, alrededor de 0,7 GB. El verdadero obstáculo son los 1,56 TB de pesos.
Si aun así quieres desplegarlo, estos son los requisitos estrictos del lado del framework (según las recetas de vLLM y el cookbook de SGLang para K3):
- Imagen de vLLM:
vllm/vllm-openai:kimi-k3; solo hay una versión para CUDA 13. Se requiere el controlador r580 o posterior y vLLM ≥ 0.27.0. - Estrategias de paralelismo: TP / TEP requieren al menos 8 GPU y DEP, al menos 16. La caché KV distribuida figura como no compatible en todo el hardware incluido.
- Planificación de nodos con SGLang: B300 usa 1 nodo con 8 GPU; B200 y H200 necesitan 2 nodos con 8 GPU.
- Según la información de Moonshot para agosto de 2026, citada por terceros, se recomienda usar un supernodo con más de 64 aceleradores en entornos de producción.
Costos reales de una factura mensual para desplegar Kimi K3.1 Pro localmente: cuatro opciones
A continuación, estimamos el costo mensual de operar una sola máquina con 8×B300 las 24 horas del día. Para la conversión, usamos un tipo de cambio uniforme de 1 USD = 7,25 yuanes. Los precios proceden de tres fuentes: tarifas por uso recopiladas por ComputeUnion entre el 24 y el 25 de octubre de 2026, facturas reales de usuarios de Modal y las actas del informe «Estudio del sector del alquiler de capacidad de cómputo» (reproducidas por Sina Finance el 20 de mayo de 2026).
⚠️ Los precios nacionales de alquiler y compra de equipos completos (por ejemplo, unos 80.000 yuanes al mes por una H200, entre 160.000 y 190.000 yuanes al mes por una B300 con contrato a cinco años, y entre 6,8 y 7 millones de yuanes por una B300 en el mercado al contado) corresponden a estimaciones del sector, no a tarifas publicadas por los fabricantes, y sirven solo como referencia de escala. La oferta habitual se basa en equipos completos con ocho GPU y exige un contrato mínimo de un año.
| Opción | Base del cálculo | Costo mensual | Observaciones |
|---|---|---|---|
| Alquiler por uso en el extranjero (24/7) | Equipo completo B300: 342–464 yuanes por hora × 730 horas | Aproximadamente 249.800–338.700 yuanes (34.500–46.700 USD) | Cotizaciones de terceros + estimación de este artículo |
| Prueba real de Modal (24/7) | 56,79 USD/hora × 730 horas | 41.457,00 USD, aproximadamente 300.600 yuanes | Factura real de un tercero |
| Alquiler nacional de equipo completo a cinco años | Estimación del sector | 160.000–190.000 yuanes | Precio no publicado; contrato mínimo de un año |
| Compra + electricidad | Equipo de 6,8–7 millones de yuanes amortizado linealmente en 3 años, más unos 8.800 yuanes de electricidad | Aproximadamente 198.000–203.000 yuanes | No incluye personal de operaciones, repuestos, espacio en el centro de datos ni ancho de banda |
| Apagar el equipo después de usarlo solo 4 horas al día | Pago por uso en el extranjero | Aproximadamente 26.000–30.000 yuanes | Cada reinicio implica un arranque en frío de unos 27 minutos |
El costo de la electricidad se estima según los supuestos de este artículo: carga de 13,2 kW, PUE de 1,3 y tarifa eléctrica de 0,7 yuanes/kWh, lo que equivale a unos 12 yuanes por hora. La opción de compra parece la más barata, pero la tabla no incluye el costo del personal de ingeniería de operaciones, que es precisamente el mayor gasto oculto para los equipos pequeños.
La idea de «apagar el equipo después de usarlo solo 4 horas al día» parece económica, pero es difícil de llevar a la práctica. En las pruebas reales de Modal, el arranque en frío tarda unos 27 minutos: hay que cargar 1,56 TB de pesos, ejecutar la compilación JIT y capturar 51 CUDA graphs. En tareas cortas, la espera al iniciar puede durar más que la propia inferencia.
Coste por unidad de Kimi K3.1 Pro: el rendimiento determina cuánto más pagas que por la API
El pago mensual es solo la cifra superficial. Lo que realmente determina si vale la pena es el coste por millón de tokens. La fórmula estimada en este artículo es: coste por millón de tokens de salida = coste de la máquina por hora ÷ tokens de salida por hora (en millones). Para el numerador, usamos en todos los casos los $56.79/hora medidos por Modal.
【Mediciones de terceros】Estos son algunos datos de rendimiento con 8×B300:
- Modal en una sola máquina (TP8, MXFP4 nativo): rendimiento sostenido de 92 tok/s, TTFT de 0,92–1,02 segundos
- OpenZeka (DGX B300, TP8, vLLM): 105,7 tok/s con concurrencia 1; 32,45 tok/s por usuario con concurrencia 64; se estima que puede atender a 150 usuarios de chat o a 50 usuarios de Agent
- Ejemplo oficial de AWS (29 de julio de 2026, p6-b300.48xlarge): 516 tok/s con concurrencia 8 y un rendimiento total de 4.634 tok/s con alta concurrencia
- GPUStack (30 de julio de 2026): entrada de 64K con 10 solicitudes concurrentes; 100,5 segundos de extremo a extremo con vLLM; rendimiento agregado de prefill de aproximadamente 19K–23K tok/s
| Rendimiento estable de salida | Salida por hora | Coste por millón de tokens de salida | Comparación con la API oficial a $10.00 |
|---|---|---|---|
| 92 tok/s (una solicitud a máximo rendimiento) | 0,33M | $171.50 (cifra del autor original: $190.00) | Aproximadamente 17–19 veces más |
| 500 tok/s | 1,80M | $31.50 | Aproximadamente 3 veces más |
| 1.000 tok/s | 3,60M | $15.80 | Aproximadamente 1,6 veces más |
| 1.500 tok/s | 5,40M | $10.50 | Prácticamente igual |
| 3.000 tok/s | 10,80M | $5.30 | Aproximadamente la mitad |
| 4.634 tok/s (pico medido por AWS) | 16,68M | $3.40 | Aproximadamente un tercio |
Si lo usa una sola persona o unas pocas, en la práctica se queda en la primera fila. Si no se alcanza suficiente concurrencia, la mayor parte del tiempo la máquina está infrautilizada y el coste por millón de tokens de salida ronda los $190.00. De ahí viene lo de «19 veces más caro» del título. Solo si el negocio puede mantener el rendimiento por encima de 1.500 tok/s, el coste por unidad de la infraestructura propia puede igualar al de la API.
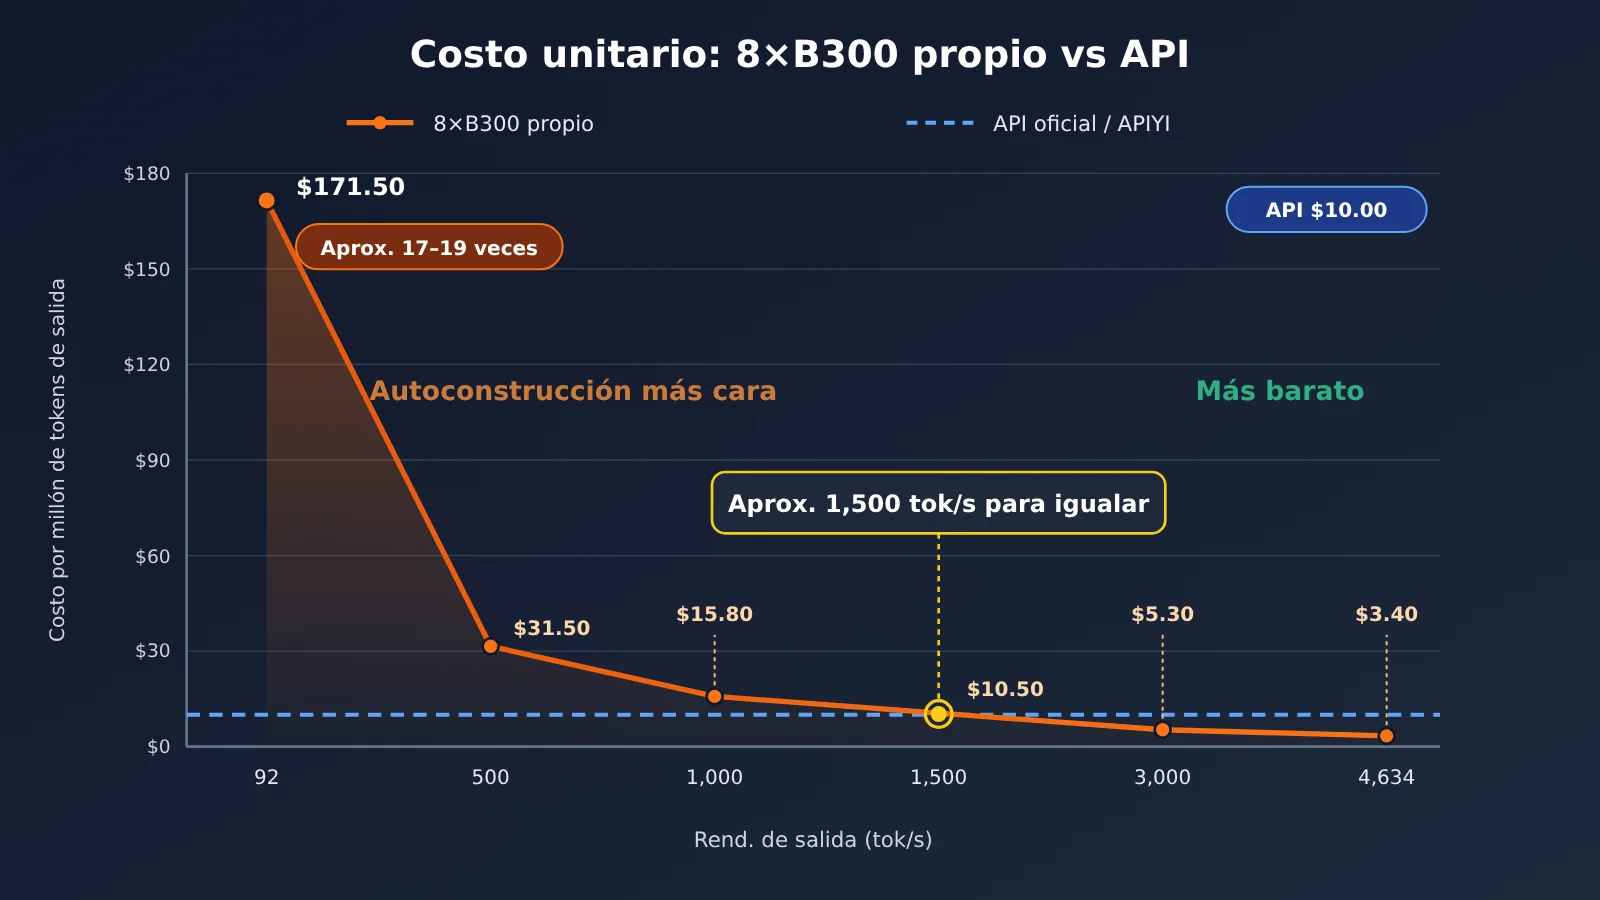
💡 Nota sobre la comparación: la línea de referencia de la API en el gráfico usa el precio oficial de $10.00 por millón de tokens de salida. El precio de salida de kimi-k3.1-pro en APIYI apiyi.com es igual al oficial, así que sirve como referencia directa.
Punto de equilibrio del despliegue local de Kimi K3.1 Pro: ¿cuántos tokens hay que usar al mes?
Veámoslo desde otra perspectiva: ¿cuántos tokens hay que usar al mes para que el despliegue propio iguale el costo de la API? Estas estimaciones se basan en los siguientes supuestos: se toma como referencia la API oficial, a $2,00 por millón de tokens de entrada y $10,00 por millón de tokens de salida; se calcula una proporción de entrada y salida de 5:1, habitual en escenarios con agentes, y no se tienen en cuenta los aciertos de caché.
| Opción de despliegue propio | Costo mensual | Tokens de entrada necesarios al mes | Tokens de salida necesarios al mes |
|---|---|---|---|
| Pago por uso en el extranjero, 24/7 | $41.457,00 | Aproximadamente 10.400 millones | Aproximadamente 2.070 millones |
| Equipo completo en China, contrato a cinco años | 190.000 yuanes | Aproximadamente 6.550 millones | Aproximadamente 1.310 millones |
| Compra directa (depreciación + electricidad) | 203.000 yuanes | Aproximadamente 6.980 millones | Aproximadamente 1.400 millones |
¿Qué representan más de mil millones de tokens de salida al mes? Según las estimaciones de OpenZeka, un equipo con 8×B300 puede dar servicio a 50 usuarios con agentes concurrentes. Un equipo pequeño de menos de diez personas ni siquiera se acercaría a ese volumen.
Hay otra variable fácil de pasar por alto: la caché. La tarifa oficial por los aciertos de caché es de solo $0,20 por millón de tokens, y la tasa de aciertos suele ser alta en escenarios con agentes y documentos largos. Cuanto mayor sea la proporción de uso de la caché, menor será el costo de la API y más alto seguirá siendo el umbral de rentabilidad del despliegue propio.
Cuándo tiene sentido alojar Kimi K3.1 Pro por cuenta propia
Alojarlo por cuenta propia no es imposible, pero necesitas una razón clara. En estos casos puede ser una opción razonable:
- El cumplimiento normativo o el funcionamiento sin conexión son imprescindibles: los datos no pueden salir de la red interna o deben mantenerse en aislamiento físico, así que no puedes usar una API por barata que sea. Sin embargo, la API oficial ya admite la retención cero de datos (ZDR). Te recomendamos comprobar primero si cumple tus requisitos normativos.
- Necesitas hacer ajustes finos y destilación: quieres realizar un posentrenamiento especializado con K3.1 Pro o destilarlo en un modelo pequeño de entre 30B y 120B parámetros. En ese caso, necesitas tener acceso a los pesos completos.
- Tienes GPU disponibles y personal especializado en operaciones: ya dispones de 8×B300, 8×MI355X o dos H200 sin uso, y cuentas con ingenieros que conozcan vLLM o SGLang para encargarse de la operación. Solo entonces el coste marginal puede ser bajo.
- El volumen de uso justifica la inversión: puedes mantener de forma estable más de 1.500 tok/s y generar mil millones de tokens al mes.
También conviene revisar la licencia con antelación. K3 utiliza la licencia Kimi K3. Según resúmenes de terceros, se requiere una autorización independiente si los ingresos anuales por ofrecer servicios del modelo a terceros superan los 20 millones de dólares. Habrá que consultar el archivo LICENSE del repositorio de Hugging Face cuando se publiquen los pesos de K3.1 Pro; por ahora, no podemos afirmar nada en nombre del equipo oficial.
En qué casos no conviene montar Kimi K3.1 Pro por tu cuenta
En estos casos, montarlo por tu cuenta probablemente te saldrá caro:
- Si quieres ahorrar: salvo que mantengas un rendimiento superior a 1.500 tok/s, el costo por unidad será más alto que con la API. Para uso propio, puede ser unas 19 veces mayor.
- Si quieres ejecutar tareas largas y encender o apagar el servicio según lo necesites: el arranque en frío tarda unos 27 minutos, así que esta modalidad prácticamente no es viable.
- Si solo lo usarás tú o un equipo pequeño: no aprovecharás toda la concurrencia; en la práctica, pagarás 56,79 $ por hora para obtener una velocidad de 92 tok/s.
- Si esperas que la cuantización permita ejecutarlo en una sola máquina: las opciones de la comunidad no son aptas para producción. Unsloth 1-bit (UD-IQ1_S, 594 GB) alcanza unos 9 tok/s en 8 × A100. El costo estimado por cada millón de tokens de salida es de 620,00 $, 3,3 veces más que con el modelo completo. La tasa de coincidencia top-1 entre la versión de 1 bit y el modelo completo es de alrededor del 79 %.
kimi-k3-in-cejecuta los pesos completos con 8,24 GB de memoria, pero tarda entre 10 y 32 segundos por token: es solo una demostración técnica.
La forma realmente adecuada de ejecutarlo «en local» será una versión destilada que publique la comunidad más adelante. Hasta entonces, para particulares y equipos pequeños, usar la API es la opción más sencilla.
Kimi K3.1 Pro: primeros pasos para probar tu negocio con la API
Antes de decidir si vas a desplegarlo por tu cuenta, te recomendamos probar durante un mes con operaciones reales a través de la API. Así podrás conocer las proporciones reales de tokens de entrada, salida y aciertos de caché, y después volver a la tabla de rentabilidad anterior para hacer los cálculos. APIYI apiyi.com ya ofrece kimi-k3.1-pro al mismo precio que el servicio oficial: $2.00 por entrada / $10.00 por salida / $0.20 por lectura de caché (en dólares por millón de tokens). Consulta la lista de modelos de la plataforma para ver los modelos y precios vigentes.
Puntos clave de la integración (interfaz compatible con OpenAI):
- Regístrate en APIYI apiyi.com y crea una clave API. Las cuentas nuevas reciben crédito gratuito para hacer pruebas.
- Configura
base_urldel SDK comohttps://api.apiyi.com/v1. - Usa
kimi-k3.1-procomo ID del modelo. Si necesitas más velocidad, puedes cambiar akimi-k3.1-pro-highspeed($4.00 por entrada / $20.00 por salida). - Parámetro de intensidad de razonamiento:
reasoning_effortpuede serlow,highomax; el valor predeterminado oficial esmax. La configuración usada en las evaluaciones oficiales fuetemperature = 1.0ytop_p = 0.95. - En conversaciones de varios turnos y al usar herramientas, debes devolver sin modificar los mensajes del asistente que incluyan
reasoning_content. De lo contrario, el contexto puede dejar de funcionar correctamente. - Prepara un script de estadísticas para registrar cada día
prompt_tokens,completion_tokensy el volumen de aciertos de caché. Estos datos te servirán más adelante para decidir si conviene desplegar el modelo por tu cuenta.
| Modelo | Entrada | Salida | Lectura de caché | Plataformas disponibles |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | APIYI apiyi.com, API oficial de Kimi |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | APIYI, API oficial de Kimi |
| kimi-k3 | $3.00 | $15.00 | $0.30 | APIYI |
🚀 Inicio rápido: Si tu proyecto todavía está en fase de validación, te recomendamos usar APIYI apiyi.com para probar kimi-k3.1-pro y otros modelos populares con la misma clave. Primero confirma que K3.1 Pro ofrece los mejores resultados para tu tarea y después decide si vale la pena desplegarlo por tu cuenta.
Preguntas frecuentes sobre el despliegue local de Kimi K3.1 Pro
Q1: ¿Ya se pueden descargar los pesos de Kimi K3.1 Pro?
Todavía no. El anuncio oficial dice: «The full model weights will be released by Nov 4», es decir, que se publicarán antes del 4 de noviembre de 2026. Todas las cifras de hardware de este artículo se han calculado a partir de K3, cuyos pesos ya están disponibles como código abierto. Cuando se publiquen los pesos, habrá que volver a comprobarlas con el tamaño real de los archivos.
Q2: ¿Por qué no se puede ejecutar Kimi K3.1 Pro con 8 GPU H200?
Las 8 H200 suman 1,13 TB de memoria de GPU, mientras que los pesos de K3 ocupan 1560,9 GB según las mediciones reales: hay una diferencia de unos 400 GB. Además, Hopper no es compatible de forma nativa con MXFP4. Incluso con dos máquinas, cada una equipada con 16 H200, habría que descomprimir los pesos durante la ejecución, lo que limitaría la velocidad.
Q3: ¿Cómo se calcula que cuesta «19 veces más»?
La cifra procede de pruebas de terceros: una instancia Modal con 8 B300 cuesta 56,79 USD por hora y mantiene una velocidad de unos 92 tokens por segundo por solicitud. Eso equivale a unos 190 USD por cada millón de tokens de salida. Al dividirlo por el precio oficial de la API, 10 USD, se obtiene un coste 19 veces mayor. Si se calcula estrictamente a 92 tokens por segundo, el coste es de 171,50 USD; el cálculo del autor original también incluye las pérdidas de rendimiento durante la ejecución real.
Q4: ¿Hay alguna forma de que un equipo pequeño ahorre dinero al alojar Kimi K3.1 Pro por su cuenta?
Prácticamente, no. La opción de comprar el hardware cuesta unos 200.000 yuanes al mes, sin contar el personal. Cuantizar el modelo para que quepa en una sola máquina puede salir aún más caro y dar peores resultados. Para un equipo pequeño, lo más práctico es usar una API de pago por uso, por ejemplo, invocar kimi-k3.1-pro a través de APIYI en apiyi.com. Pagas según el uso y los aciertos de caché cuestan solo 0,20 USD por millón de tokens.
Q5: ¿Cómo puedo invocar Kimi K3.1 Pro rápidamente mediante una API?
Regístrate en APIYI en apiyi.com para obtener una clave API y establece `base_url` en `https://api.apiyi.com/v1`. Luego, indica `kimi-k3.1-pro` como modelo. En general, no hace falta modificar el código existente del SDK de OpenAI. En las conversaciones de varios turnos, recuerda enviar de vuelta `reasoning_content`.
Q6: ¿Qué limitaciones conocidas tiene el despliegue local de Kimi K3.1 Pro?
Hay tres principales. Primero, el arranque en frío tarda unos 27 minutos, por lo que no es adecuado para el escalado elástico. Segundo, la imagen de vLLM solo está disponible para CUDA 13 y requiere controladores r580 o posteriores; los clústeres antiguos tendrán que actualizarse antes. Tercero, la caché KV distribuida no es compatible con ninguno de los equipos mencionados, lo que limita la expansión a varias máquinas.
Q7: ¿Cuándo será viable el despliegue local?
Cuando la comunidad publique versiones destiladas de entre 30B y 120B parámetros, habrá una opción que particulares y equipos pequeños podrán ejecutar en sus propios equipos. A corto plazo, los modelos completos de unos 3T parámetros seguirán requiriendo infraestructura de centro de datos.
Puntos clave sobre el despliegue local de Kimi K3.1 Pro
- Los pesos aún no se han publicado: el equipo promete publicarlos antes del 4 de noviembre. Todas las cifras actuales son estimaciones basadas en K3.
- Requisitos mínimos de hardware: los pesos ocupan 1560,9 GB. Para ejecutarlo en un solo equipo se necesitan, como mínimo, 8×B300, GB300 o MI355X.
- Coste mensual aproximado: mantener una máquina funcionando 24/7 cuesta entre 160.000 y 340.000 yuanes al mes, según la opción elegida.
- Coste por unidad: el uso propio cuesta unos 190,00 USD por cada millón de tokens de salida, 19 veces más que la API oficial.
- Cuándo se igualan los costes: se necesita un rendimiento sostenido superior a 1.500 tok/s y generar del orden de mil millones de tokens al mes.
- Cómo empezar: primero usa APIYI en apiyi.com para invocar kimi-k3.1-pro con cargas de trabajo reales. Después, decide si te conviene desplegarlo por tu cuenta basándote en los datos.
Lista de comprobación para elegir cómo desplegar Kimi K3.1 Pro
Responde estas cinco preguntas para decidir si te conviene alquilar, comprar o usar la API:
- ¿Los requisitos de cumplimiento impiden que los datos salgan de la red interna y tampoco basta con el ZDR oficial? — No: usa directamente la API.
- ¿Necesitas los pesos para ajustar el modelo o destilarlo? — Sí: considera alquilar máquinas por horas y detenerlas cuando termines.
- ¿Superas de forma estable los 1.300 millones de tokens de salida al mes? — No: el despliegue propio siempre será más caro que la API.
- ¿Ya tienes máquinas disponibles de la clase 8×B300 / MI355X y personal dedicado a operaciones? — Sí: puedes plantearte el despliegue propio. Si no, no compres máquinas solo para esto.
- ¿Tu carga de trabajo necesita poder iniciarse, detenerse y escalar con flexibilidad en cualquier momento? — Sí: el arranque en frío de 27 minutos hace que el despliegue propio no sea una buena opción; elige la API.
Resumen
Estas son las principales conclusiones sobre el despliegue local de Kimi K3.1 Pro:
- Requiere una gran inversión inicial: según las estimaciones basadas en K3, los pesos ocuparían unos 1,56 TB; 8×B300 apenas bastarían para alojarlos.
- Sale caro para uso propio: en una sola máquina, el coste ronda los 190,00 $ por cada millón de tokens de salida, 19 veces más que la API.
- Solo compensa a gran escala: el despliegue propio empieza a tener sentido cuando se mantiene un rendimiento superior a 1.500 tok/s y se generan alrededor de mil millones de tokens al mes.
Para la mayoría de los desarrolladores y equipos pequeños de China, lo más sensato es empezar con la API, poner en marcha el producto y recopilar datos de uso. Después, se puede valorar si merece la pena desplegar el modelo por cuenta propia. Recomendamos usar APIYI, en apiyi.com, para invocar kimi-k3.1-pro: el precio es el mismo que el oficial, los nuevos usuarios reciben una cuota gratuita y, con una sola clave, también se pueden comparar otros modelos populares.
📚 Referencias
- Blog oficial de lanzamiento de Kimi K3.1 Pro: fecha de publicación de los pesos y posicionamiento del modelo
- Enlace:
kimi.ai/blog/kimi-k3-1-pro -
Nota: publicación oficial que confirma que los pesos estarán disponibles antes del 4 de noviembre
-
Tarifas oficiales de la API de Kimi: precios de entrada, salida y caché de K3.1 Pro
- Enlace:
platform.kimi.ai/docs/pricing/chat -
Nota: fuente de los precios de la API usados como referencia en este artículo
-
Ficha del modelo Kimi K3: arquitectura, cuantización y licencia
- Enlace:
huggingface.co/moonshotai/Kimi-K3 -
Nota: 2,8 T de parámetros totales, cuantización MXFP4 y licencia Kimi K3
-
Receta de vLLM para Kimi K3: requisitos mínimos de memoria y despliegue
- Enlace:
recipes.vllm.ai/moonshotai/Kimi-K3 -
Nota: se necesitan al menos 8×GB300 y 1.680 GB de memoria como mínimo
-
Pruebas de inferencia de AWS con 8×B300: datos de rendimiento
- Enlace:
github.com/aws-samples/sample-llm-inference-on-eks -
Nota: rendimiento total de 4.634 tok/s con alta concurrencia
-
Pruebas de GPUStack con 8×B300: comparación entre vLLM y SGLang con contextos largos
- Enlace:
cnblogs.com/gpustack/p/22073008 - Nota: tiempos de extremo a extremo para entradas de 64K y 200K
Autor: Equipo técnico de APIYI
Consultas técnicas: puedes contactarnos desde la página de inicio del sitio web de APIYI. Encontrarás más información sobre la integración de modelos en el centro de documentación, docs.apiyi.com.