Nota del autor: si la tasa de aciertos de la caché de indicaciones de Claude se ha desplomado de repente a 0, o si la factura no baja por más que lo intentas, puedes usar diagnostics en tres pasos para localizar dónde se bifurca el prefijo y, después, cruzar esa información con usage para saber si la caché realmente está acertando. En este artículo también veremos cómo autodiagnosticar el problema cuando pasas por el proxy de APIYI. (Si tú tienes este problema, cuando termines de leer el artículo puedes enviárselo a tu Agent para que investigue.)
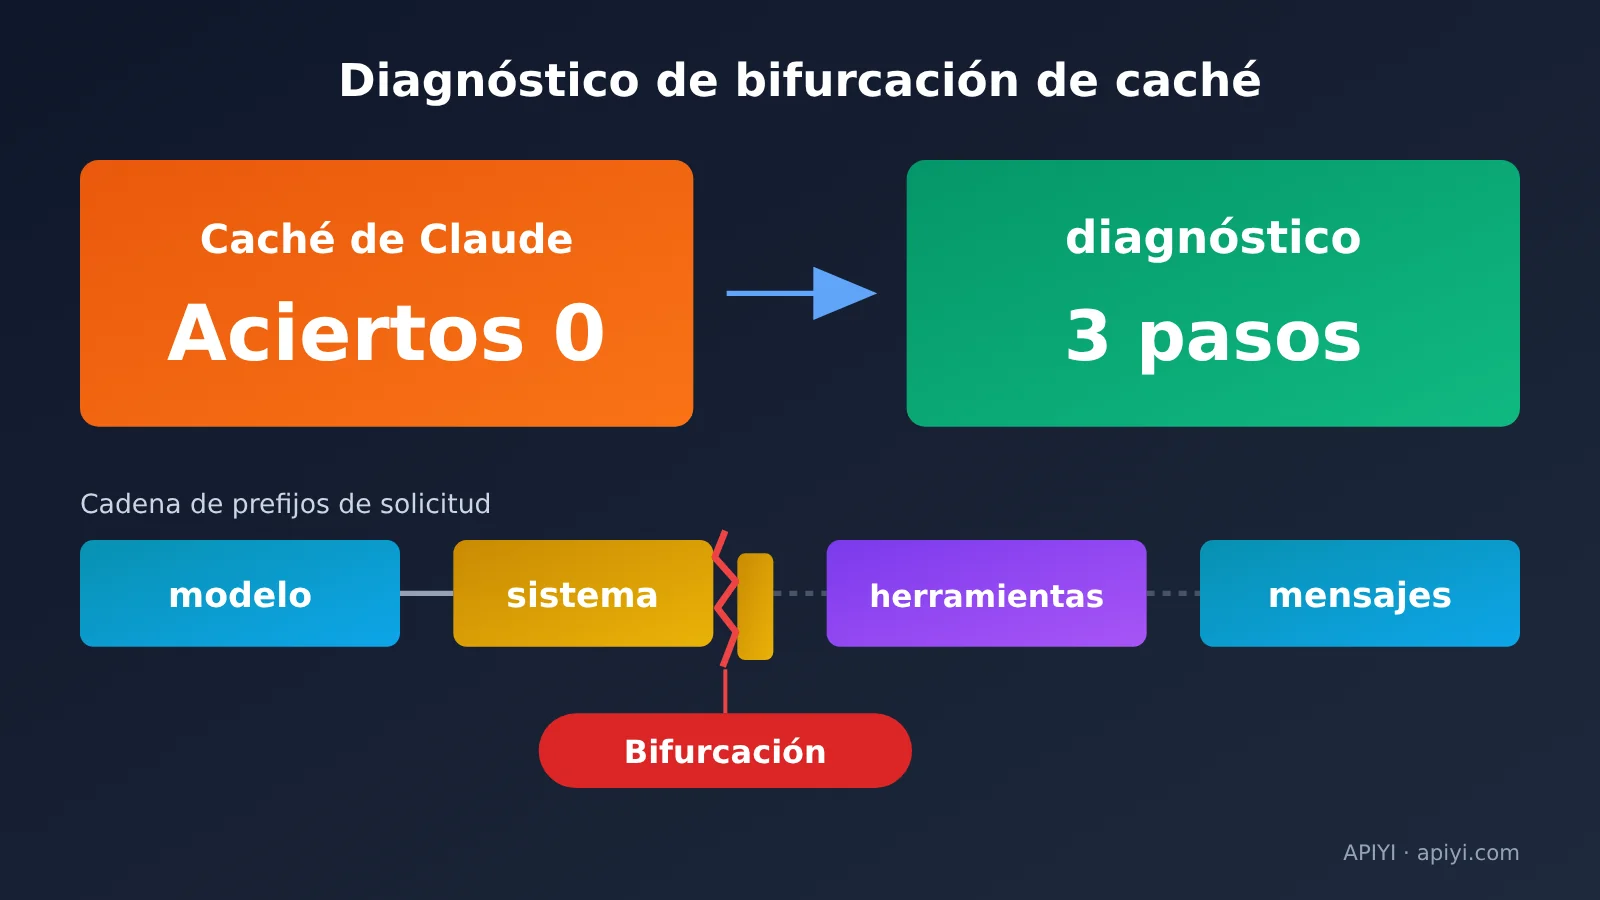
Que la caché no acierte no es magia: la API te dice desde qué segmento empieza a divergir el prefijo. Basta con devolver el id de la respuesta de la ronda anterior y verás en qué punto aparece la primera discrepancia: si está en model, en system, en tools o en messages.
Esto no es un análisis de lanzamiento de funcionalidades. Está escrito para desarrolladores que ya usan la caché de indicaciones de Claude pero que, de un día para otro, ven su tasa de aciertos caer a cero o tienen una factura que no deja de crecer. Todos los pasos de diagnóstico están explicados con claridad, incluyendo qué deberías ver en cada uno.
Valor principal: al terminar el artículo serás capaz de localizar la causa de un fallo de caché en un máximo de tres peticiones. También sabrás distinguir qué te dice diagnostics y qué te dice usage, y qué dos campos conviene comparar entre sí cuando trabajas a través de un proxy.
Aspectos clave del diagnóstico de caché de Claude (diagnostics)
En una frase: pasas el id de la respuesta anterior y la API compara las dos peticiones para señalar el primer punto de divergencia, ya esté en model, system, tools o messages. Antes, cuando la caché fallaba en silencio, solo veías que usage.cache_read_input_tokens caía a 0, sin saber qué fragmento había cambiado.
| Aspecto | Descripción | Qué te aporta |
|---|---|---|
| Activación | La huella solo se guarda si el cuerpo de la petición incluye un objeto diagnostics en el nivel superior |
No hay que tocar la lógica de negocio: basta con añadir un campo |
| Modo de comparación | previous_message_id recibe el id de la respuesta anterior |
Localizas directamente el primer segmento que diverge |
| Campo de conclusión | cache_miss_reason devuelve uno de seis tipos |
Cada tipo indica dónde está el arreglo |
| Métrica complementaria | Conviene leerlo junto con usage.cache_read_input_tokens |
Evitas confundir «no hubo divergencia» con «no surtió efecto» |
| Alcance | Solo lo ofrece la API oficial de Claude | Si usas otro canal, tendrás que autodiagnosticar con usage |
Cronología del diagnóstico de caché de Claude
La función llegó en mayo de 2026 en versión beta y por entonces exigía la cabecera anthropic-beta: cache-diagnosis-2026-04-07. En septiembre las reglas se endurecieron: solo se guardaba la huella en las peticiones que incluían explícitamente el objeto diagnostics; las que únicamente llevaban la cabecera ya no quedaban registradas.
El 23 de septiembre pasó a disponibilidad general, dejó de necesitar cache-diagnosis-2026-04-07 y las peticiones con la cabecera antigua siguen funcionando con normalidad. Ahora las respuestas de POST /v1/messages siempre incluyen el campo diagnostics, cuyo valor es null cuando no está activado. Así que ver ese campo en null no significa que la interfaz tenga un problema.
La huella solo guarda hashes y una estimación del número de tokens, nunca el contenido original de la indicación. Se indexa por response id, queda limitada a tu organización y workspace, y se conserva poco tiempo.
Diagnóstico de la tasa de aciertos de caché de Claude con diagnostics en 3 pasos
Los tres pasos siguientes se basan en la descripción oficial de los campos. Si llamas a través de APIYI, el base_url de la interfaz nativa de Messages se rellena con https://api.apiyi.com/v1, y la ruta de la solicitud es /v1/messages. Eso sí, ojo: en la sección de pruebas más adelante verás cómo devuelve realmente diagnostics el servicio proxy de API.
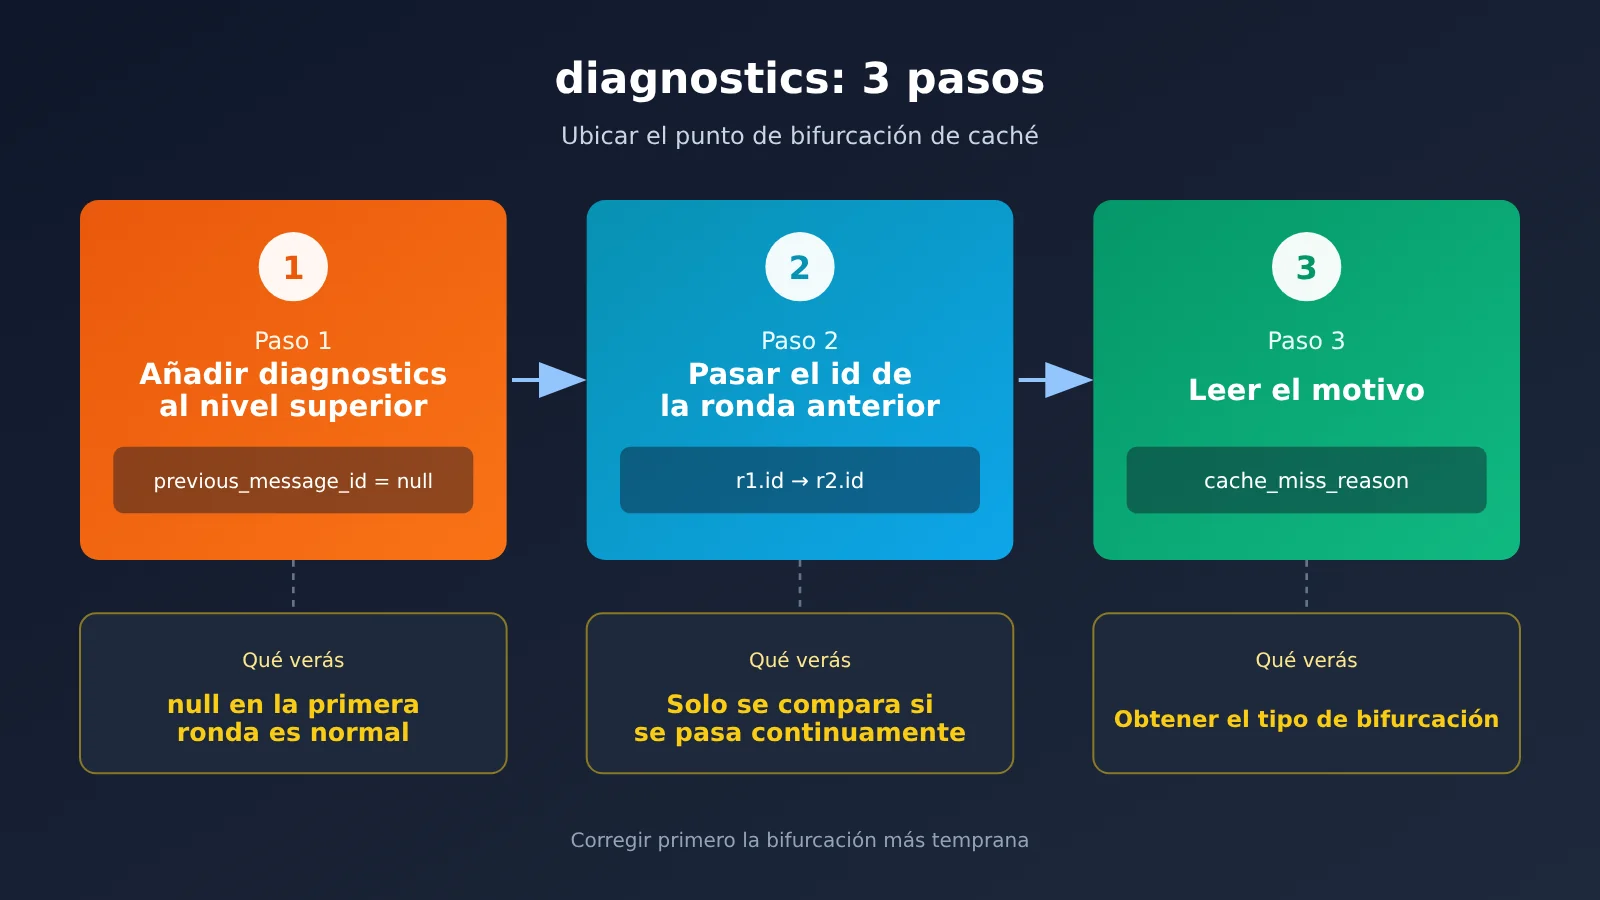
Paso 1: añade el objeto diagnostics en el nivel superior de la solicitud
diagnostics es el único interruptor: las solicitudes que no lo incluyen no guardan la huella, así que después no hay con qué comparar. En la primera ronda no hay nada que contrastar, por eso previous_message_id va como null, lo que significa «empezar a registrar a partir de esta ronda».
- Mantén el número de versión habitual en la cabecera:
anthropic-version: 2023-06-01 - A partir de la versión estable ya no hace falta incluir:
anthropic-beta: cache-diagnosis-2026-04-07 - Añade en el nivel superior del cuerpo de la solicitud:
"diagnostics": {"previous_message_id": null} - Los bloques
systemque quieras cachear se marcan igual que siempre:"cache_control": {"type": "ephemeral"} - Qué verás: en la respuesta
diagnosticsesnull,cache_read_input_tokenssuele ser 0 ycache_creation_input_tokenses mayor que 0
Ver null en la primera ronda no significa que haya fallado. En esta ronda se está escribiendo la caché; por definición no hay una ronda anterior con la que comparar, así que no hay nada que depurar.
Paso 2: a partir del segundo turno, pasa siempre el id de la respuesta anterior
Desde la segunda ronda, coloca el id de la respuesta del turno anterior en previous_message_id. El error más habitual es incluir diagnostics solo en el primer turno y olvidarlo después: la petición a la que apunta la ronda siguiente no queda registrada y recibirás previous_message_not_found.
- Cuerpo de la segunda petición:
"diagnostics": {"previous_message_id": "<id de la respuesta del primer turno>"} - Cuerpo de la tercera petición:
"diagnostics": {"previous_message_id": "<id de la respuesta del segundo turno>"} - La regla del bucle multirronda: el primer turno pasa
null, el segundo pasar1.id, el tercero pasar2.id, y así sucesivamente - En llamadas en streaming, el resultado aparece en el evento
message_start, y el id se va pasando igual, turno tras turno - Qué vas a ver: cuando el intervalo entre dos turnos consecutivos es lo bastante corto y ambos están en el mismo workspace, empiezan a aparecer los resultados de la comparación en la respuesta
Paso 3: leer cache_miss_reason y corregir según el diagnóstico
diagnostics puede tomar tres formas distintas; antes de leerlo, identifica cuál tienes delante:
null: la petición no incluyediagnostics, oprevious_message_idesnull, o la comparación ya terminó y no se encontraron divergencias{"cache_miss_reason": null}: la comparación sigue en curso porque la respuesta llegó demasiado rápido; en este turno no hay conclusión, mira el siguientecache_miss_reasones un objeto: ya hay conclusión y contiene el tipo de bifurcación con sus detalles- Qué vas a ver: una vez obtenido el tipo, corrige con la tabla de la sección siguiente y arregla primero la bifurcación más antigua, porque solo se reporta el primer punto de divergencia y los problemas posteriores pueden quedar ocultos detrás de él
🚀 Inicio rápido: si quieres confirmar antes si tu prefijo de caché puede escribirse y acertar, puedes usar la misma clave API en APIYI apiyi.com, alternando entre los distintos modelos de Claude durante dos rondas de comparación, y fijarte sobre todo en si los dos números de escritura y lectura de caché en
usagecoinciden.
Los seis tipos de cache_miss_reason y dónde corregirlos
Cuando tengas cache_miss_reason, usa esta tabla para ubicar qué hay que cambiar:
| Tipo | Significado | Dónde corregir |
|---|---|---|
model_changed |
El modelo es distinto al del turno anterior; por ejemplo, porque el enrutamiento, una prueba A/B o el fallback cambiaron de modelo. La caché está aislada por modelo. | Fija el modelo durante toda una misma conversación con caché. |
system_changed |
El system cambió. Lo más habitual es que se hayan insertado valores que varían en cada llamada, como timestamps o IDs de solicitud. | Convierte el system en una constante estable byte a byte y mueve los datos dinámicos al primer mensaje user después del punto de corte. |
tools_changed |
Se añadieron, quitaron o reordenaron herramientas, o la serialización de input_schema no es estable. |
Envía la misma lista de herramientas en cada turno, con el orden fijo y la serialización ordenada por clave. |
messages_changed |
Se modificaron, reordenaron o eliminaron mensajes anteriores, en lugar de añadir al final. | Añade solo al final del historial y reenvía el contenido assistant y los resultados de herramientas tal cual. |
previous_message_not_found |
No se encuentra la huella correspondiente; no significa que la solicitud haya cambiado. | Incluye diagnostics en cada turno, no mezcles workspaces y no dejes intervalos demasiado largos. |
unavailable |
En este turno no se pudo obtener el diagnóstico; por ejemplo, porque tool_choice, thinking, context_management, output_config, output_format o el conjunto de beta headers no coinciden, o porque la conversación es demasiado larga. |
Mantén estos parámetros sin cambios durante todo el ciclo de vida de una conversación con caché. |
Los cuatro tipos que terminan en _changed también vienen con cache_missed_input_tokens, que indica aproximadamente cuántos tokens de entrada cacheables se perdieron después del punto de bifurcación. Esta cifra se calcula a partir de la longitud en bytes, solo sirve para hacerte una idea del orden de magnitud, no es una cifra de facturación y, de vez en cuando, puede ser incluso mayor que usage.input_tokens.
Mirar solo diagnostics lleva a error: cruza ese dato con usage para saber si la caché de Claude acertó
diagnostics responde a la pregunta «¿ha cambiado mi solicitud?», mientras que usage.cache_read_input_tokens responde a «¿ha habido acierto de caché?». Son dos preguntas distintas, y si solo miras una de ellas es muy fácil sacar una conclusión equivocada.
Resultado de diagnostics |
Tokens de lectura de caché | Conclusión | Qué hacer |
|---|---|---|---|
null |
Alto | El prefijo es estable, la caché acierta | No hay que hacer nada |
null |
Bajo o 0 | La solicitud no cambió, pero la caché ya caducó | Reduce el intervalo entre solicitudes o pasa a un TTL de 1 hora |
*_changed |
Bajo | La solicitud cambió y por eso no hay acierto | Corrígelo siguiendo la tabla de la sección anterior |
*_changed |
Alto | El cambio está en una posición tardía y los breakpoints anteriores siguen acertando | Merece la pena corregirlo, aunque el impacto es pequeño |
Conviene insistir en un punto: null no significa que no haya funcionado; de hecho, puede ser justo el mejor resultado posible. Hay además varios casos en los que esta tabla no aplica: la primera ronda, cuando cache_miss_reason es null (la comparación todavía está en curso), y los valores previous_message_not_found y unavailable. En todos ellos simplemente no se ha generado una comparación válida.
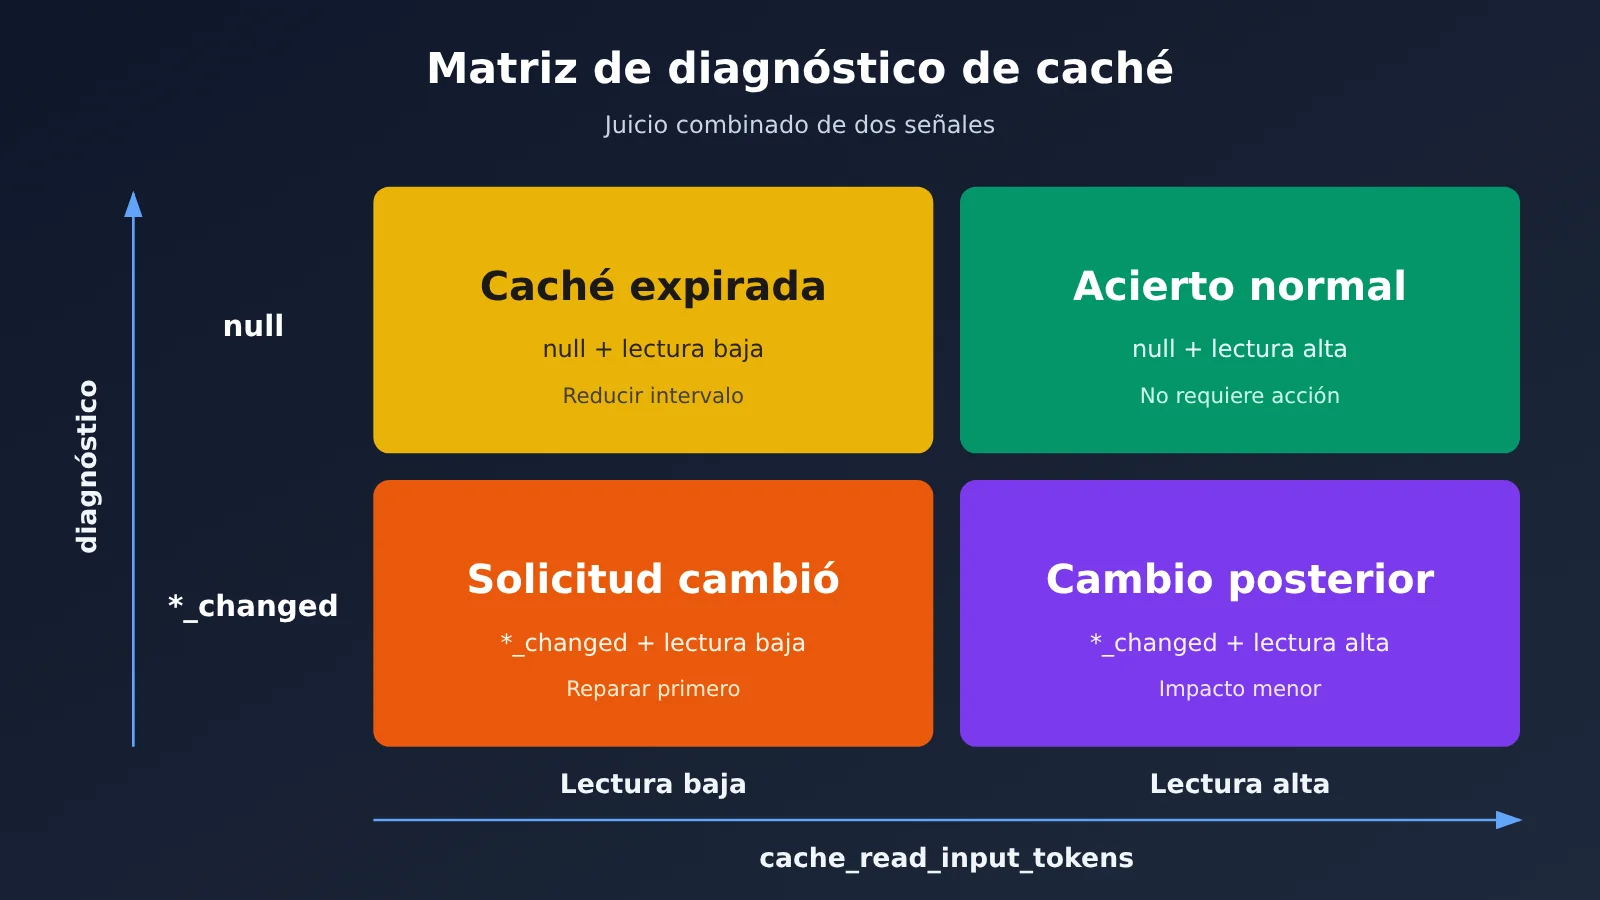
Si todavía no tienes claro en qué casilla cae cada ronda, puedes enviar la misma solicitud dos veces seguidas en APIYI apiyi.com, anotar las cifras de lectura y escritura de caché de cada ronda y contrastarlas con la matriz de arriba para ir descartando posibilidades una por una.
Causas habituales de una baja tasa de aciertos de caché en Claude: tres requisitos estrictos
Muchas veces, que la tasa de aciertos sea baja no se debe a que la solicitud haya cambiado, sino a que la caché nunca llegó a escribirse desde el principio. Si falta alguno de estos tres requisitos, la caché no entrará en funcionamiento:
- Hay que especificar
cache_controlde forma explícita: se puede colocar en un bloque de contenido concreto para crear un punto de interrupción explícito, o poner uncache_controlen el nivel superior de la solicitud para que el sistema coloque automáticamente el punto de interrupción en el último bloque cacheable. Sicontentes una cadena simple y no hay bloques de contenido donde colgar la marca, nunca se cacheará. - La longitud debe alcanzar el mínimo cacheable: en la API de Claude, tanto Sonnet 5.5 como Opus 5.5 requieren 512 tokens. Si el prefijo no es lo bastante largo, la caché se ignora de forma silenciosa y tampoco se produce ningún error.
- El prefijo debe ser idéntico byte a byte: el historial solo se añade, y system y tools se mantienen estables. Si cambia cualquier espacio, el orden de los campos JSON o una marca de tiempo, se tratará como un prefijo nuevo.
La documentación de caché de APIYI también recoge dos límites estrictos: una sola solicitud admite como máximo 4 puntos de interrupción cache_control, y cada punto de interrupción solo retrocede hasta los 20 bloques de contenido más recientes. En conversaciones largas de varios turnos, marcar solo el último mensaje no cubre todo el historial.
El TTL también se pasa por alto con frecuencia. Por defecto es de 5 minutos y se renueva con cada acierto, pero el cómputo empieza en la solicitud de escritura o lectura, no cuando termina la respuesta. Si una respuesta en streaming tarda 4 minutos en generarse, la siguiente solicitud debería enviarse en aproximadamente 1 minuto. Cuando necesites una ventana más larga, puedes añadir "ttl": "1h" dentro de cache_control.
La factura cuando la tasa de aciertos de caché de Claude cae a 0
Primero, los precios. Están en dólares por millón de tokens y son al 2026-10-25; para el precio vigente, manda la consola en tiempo real:
| Modelo | Entrada | Salida | Lectura de caché | Escritura de 5 min | Escritura de 1 h |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | $2.50 | $4 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $5 | $8 |
| Claude Haiku 5.5 (hasta 100 mil tokens) | $0.1 | $0.5 | $0.01 | $0.125 | $0.20 |
| Claude Haiku 5.5 (más de 100 mil tokens) | $0.50 | $2.50 | $0.05 | $0.625 | $1 |
Los multiplicadores hay que mirarlos por separado. La guía de caché de APIYI da el criterio general: acierto 0.1×, escritura de 5 minutos 1.25× y escritura de 1 hora 2×. Sonnet 5.5, con el ajuste oficial del 7 de octubre, bajó la lectura de caché de $0.20 a $0.10, así que ahora es 0.05× del precio base de entrada; el precio de escritura no cambió.
Este ajuste no es una rebaja para toda la línea: la lectura de caché de Sonnet 5 sigue en $0.20. Por eso no uses 0.1× para calcular Sonnet 5.5; para el modelo y el precio concretos, consulta la lista de modelos de la plataforma.
El punto de equilibrio, con el criterio general de 0.1× de la plataforma, queda así: con TTL de 5 minutos, reutilizar dos veces ya lo amortiza (1.25 + 0.1 = 1.35, menos que 2.0 sin caché); con TTL de 1 hora hacen falta tres reutilizaciones (2 + 0.2 = 2.2, menos que 3.0).
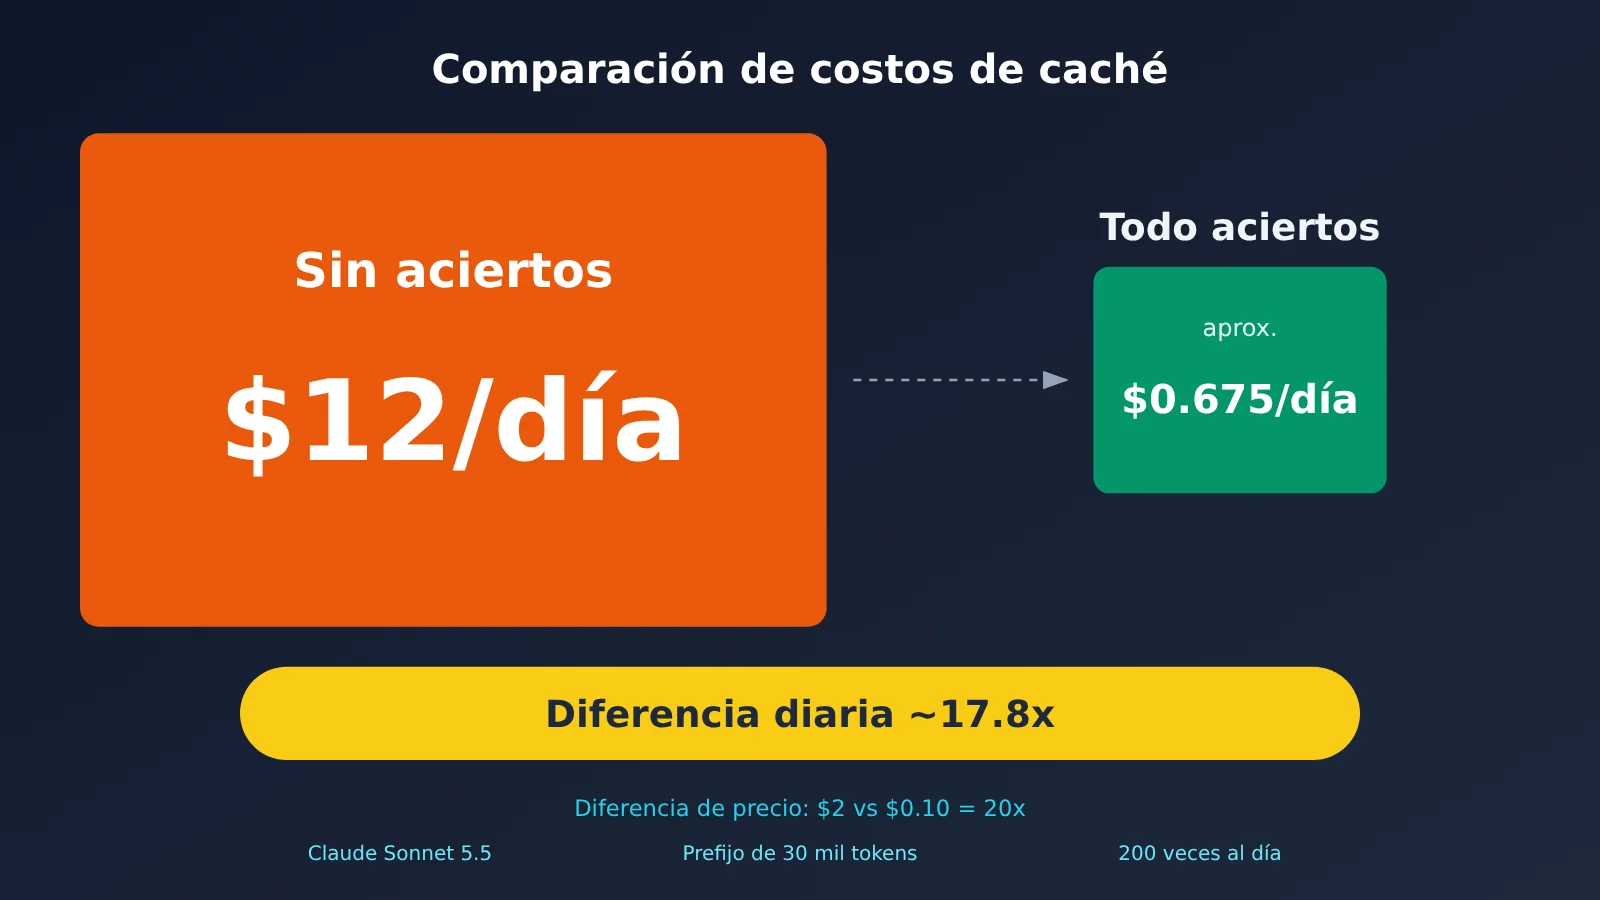
Veamos otro ejemplo. Sonnet 5.5, prefijo fijo de 30 mil tokens, 200 solicitudes al día, todas dentro del TTL de 5 minutos:
- Si todos aciertan: 200 × 30 mil × $0.10/millón = $0.60, más una escritura de $0.075; en total, unos $0.675/día
- Si ninguno acierta: 200 × 30 mil × $2/millón = $12/día
Entre ambos casos, la factura diaria se diferencia en unas 17.8 veces, y no se debe a la diferencia de precio unitario. El precio unitario es $2 frente a $0.10: 20 veces de diferencia. Si cambias a TTL de 1 hora, una escritura cuesta $0.12 y el precio del acierto no cambia. Cuando el intervalo entre solicitudes suela superar los 5 minutos, vale la pena comparar: ¿qué sale más barato, pagar ese sobrecosto de escritura o reconstruir el prefijo una y otra vez?
Cómo diagnosticar la tasa de aciertos de caché de Claude cuando usas APIYI
Primero, los resultados de la prueba. El 2026-10-26 hicimos una prueba real en APIYI con Claude Sonnet 5.5 y ejecutamos dos rondas: en la primera, escritura de caché 2523 y lectura 0; en la segunda, tras reenviar la misma solicitud tal cual, lectura de caché 2523 y escritura 0. El recuento de tokens coincide exactamente. Con Claude Opus 5.5, un prefijo largo también se escribe en caché y se reutiliza.
Pero en la respuesta no aparece el campo diagnostics. No aparece en llamadas sin streaming ni en el message_start de las llamadas con streaming. Volvimos a enviar la solicitud incluyendo el encabezado beta y, además, modificamos el system a propósito para provocar un fallo de caché real (lectura 0, escritura 2526); aun así, el campo no apareció. Todas las solicitudes devolvieron 200, sin errores. El canal upstream de la capa proxy no tiene por qué ser el de la API oficial de Claude, así que en escenarios con proxy lo principal es comparar los dos campos de usage.
| Síntoma en la autocomprobación | Explicación |
|---|---|
cache_read_input_tokens de este turno es exactamente igual a cache_creation_input_tokens del turno anterior |
El prefijo se reutilizó por completo |
| La lectura de este turno es claramente menor que la escritura del turno anterior | Solo se reutilizó un tramo más al principio; algo cambió en medio |
| La escritura siempre es 0 | No se añadió la marca de caché, el prefijo es demasiado corto o se usó el formato compatible con OpenAI |
| En el segundo turno vuelve a haber escritura y la lectura es 0 | El prefijo cambió; revisa marcas de tiempo, UUID y orden de serialización |
Además, tenlo muy en cuenta: la caché solo funciona con /v1/messages nativo. Si llamas a Claude con el formato compatible con OpenAI /v1/chat/completions, no obtendrás facturación de caché por más parámetros que envíes.
💡 Recomendación de diagnóstico: APIYI (apiyi.com) reenvía
cache_controltal cual al upstream y también devuelve sin modificar los dos campos de caché de la respuesta, así que el código no necesita adaptarse de forma adicional a la capa proxy. Si conviertes «lectura de este turno = escritura del turno anterior» en una alerta de logs, sustituirás buena parte de la revisión manual.
Limitaciones de diagnostics en el diagnóstico de caché de Claude
diagnostics no resuelve todos los problemas, así que conviene conocer sus límites antes de usarlo:
- Solo lo ofrece la API oficial de Claude; las versiones alojadas en Amazon Bedrock y Google Cloud no lo incluyen.
- La huella se conserva solo por poco tiempo, por lo que hay que enviar solicitudes en varias rondas consecutivas y con intervalos cortos.
- Las dos solicitudes deben pertenecer a la misma organización y al mismo workspace; puedes verificarlo con el encabezado de respuesta
anthropic-workspace-id. - En conversaciones largas, si el cambio queda muy escondido dentro de la lista de mensajes, es probable que solo devuelva
unavailable. - Es un mecanismo best-effort: si no obtiene resultado no bloquea la solicitud ni hace que falle.
Preguntas frecuentes (FAQ)
Q1: ¿Por qué `diagnostics` siempre es null?
Hay tres casos posibles: no se envió el objeto `diagnostics`; es la primera ronda y `previous_message_id` es `null`; la comparación terminó y no hubo divergencias. Conviene contrastarlo con las lecturas de caché: una lectura alta indica que todo va bien, y una lectura de 0 casi siempre significa que la caché caducó. Si pasas por un proxy, puede que el campo ni siquiera se devuelva; en ese caso, revisa el `usage` por tu cuenta.
Q2: ¿`previous_message_not_found` significa que la solicitud cambió?
No. Solo indica que no se encontró la huella correspondiente. Hay tres causas habituales: la ronda anterior no envió `diagnostics`, la ronda anterior venía de otro workspace o pasó demasiado tiempo entre ambas. Basta con incluir `diagnostics` en cada ronda y acortar el intervalo.
Q3: ¿El diagnóstico tiene un coste adicional?
La documentación oficial no incluye una partida separada de «coste de diagnóstico»; se factura junto con las solicitudes normales de Messages. Tampoco se especifica explícitamente que no haya recargo, así que toma como referencia la factura y la consola.
Q4: ¿Se puede usar este diagnóstico a través de un proxy?
En nuestras pruebas con APIYI no obtuvimos el campo `diagnostics`, pero las escrituras y los aciertos de caché funcionaron con normalidad. Puedes comprobar si «la lectura de esta ronda es exactamente igual a la escritura de la ronda anterior»; los detalles de integración están en la documentación de facturación de caché de APIYI en apiyi.com.
Q5: ¿Por qué puse `cache_control` y no se escribió nada en caché ni una sola vez?
Revisa tres cosas: si el `content` es una cadena pura; si el prefijo alcanza los 512 tokens (en Sonnet 5.5 y Opus 5.5); y si estás usando el formato compatible con OpenAI. Si falla cualquiera de las tres, la caché se omite en silencio.
Q6: Si aparecen varios problemas a la vez, ¿cuál arreglo primero?
Empieza por el que reporta `cache_miss_reason`. Solo señala el primer punto de bifurcación; una vez corregido, ejecuta otra ronda y aparecerán los problemas que quedaban ocultos detrás. Reproducir la misma solicitud una y otra vez en APIYI (apiyi.com) te permite descartarlos uno por uno con bastante rapidez.
Puntos clave del diagnóstico de caché de Claude
- Qué es
diagnostics: se le pasa el id de la respuesta de la ronda anterior y localiza el primer segmento en el que se bifurca el prefijo. - Cómo activarlo: incluye
diagnosticsen el nivel superior; en la primera ronda pasanully, a partir de ahí, envíalo en todas las rondas. - Qué significa
null: también esnullen la primera ronda o cuando no hay divergencia, así que no lo interpretes por sí solo como una señal de fallo. - Cómo interpretarlo: para sacar conclusiones, revisa
diagnosticsjunto concache_read_input_tokens. - Condiciones indispensables: usar marcadores explícitos, alcanzar los 512 tokens y que el prefijo sea idéntico byte a byte.
- Diferencia de coste: con un prefijo de 30.000 tokens y 200 llamadas al día, la factura diaria puede variar en un factor de aproximadamente 17,8.
- Autoverificación del proxy: en APIYI apiyi.com, revisa si «la lectura de esta ronda es igual a la escritura de la ronda anterior».
Resumen
El diagnóstico de la tasa de aciertos de caché de Claude se puede resumir en tres puntos:
- Localiza la bifurcación: incluye
diagnosticsen cada ronda, leecache_miss_reasony corrige primero el que se reporte antes. - Cruza la información: revisa
diagnosticsyusageen conjunto; que aparezcanullno significa que no haya funcionado. - Cumple las condiciones indispensables: aplica bien las marcas, alcanza la longitud mínima, haz que el historial solo se añada y mantén system y tools estables.
Si tu flujo de llamadas no puede obtener diagnostics, usa los dos campos de usage para hacer una autoverificación. Te recomiendo validar primero las cifras de lectura y escritura de caché con dos solicitudes en APIYI apiyi.com, y luego pasar a producción.
📚 Referencias
- Documentación oficial de Claude: Cache diagnostics: campos de diagnóstico, seis tipos y matriz de decisión
- Enlace:
platform.claude.com -
Descripción: los campos, la línea de tiempo y las limitaciones de diagnostics en este artículo se basan en ese documento.
-
Documentación oficial de Claude: Prompt caching: reglas de caché, TTL, longitud mínima y precios
- Enlace:
platform.claude.com -
Descripción: fuente de la longitud mínima almacenable en caché y de la tabla oficial de precios.
-
Lista de modelos de APIYI: precios de entrada, salida y lectura de caché de cada modelo Claude
- Enlace:
docs.apiyi.com/models -
Descripción: datos de precios actualizados al 2026-10-25.
-
Guía de facturación de caché de Claude Prompt Caching de APIYI: multiplicadores, punto de equilibrio y criterios de autodiagnóstico
- Enlace:
docs.apiyi.com/api-capabilities/claude-prompt-caching - Descripción: base para la resolución de problemas en escenarios con servicio proxy de API.
Autor: equipo técnico de APIYI
Contacto técnico: no dudes en contactarnos desde la página principal del sitio de APIYI; para más recursos, visita el centro de documentación docs.apiyi.com