Resumo: Em chamadas multirrodada do Responses API com GPT-6.2, reescrever as entradas iniciais pode reduzir os acertos de cache e também fazer com que alguns itens de raciocínio deixem de ser elegíveis para reutilização. Os desenvolvedores podem adotar uma estrutura de contexto em que só se acrescenta conteúdo ao final e, depois, usar registros de uso em pares para identificar a diferença de custos.
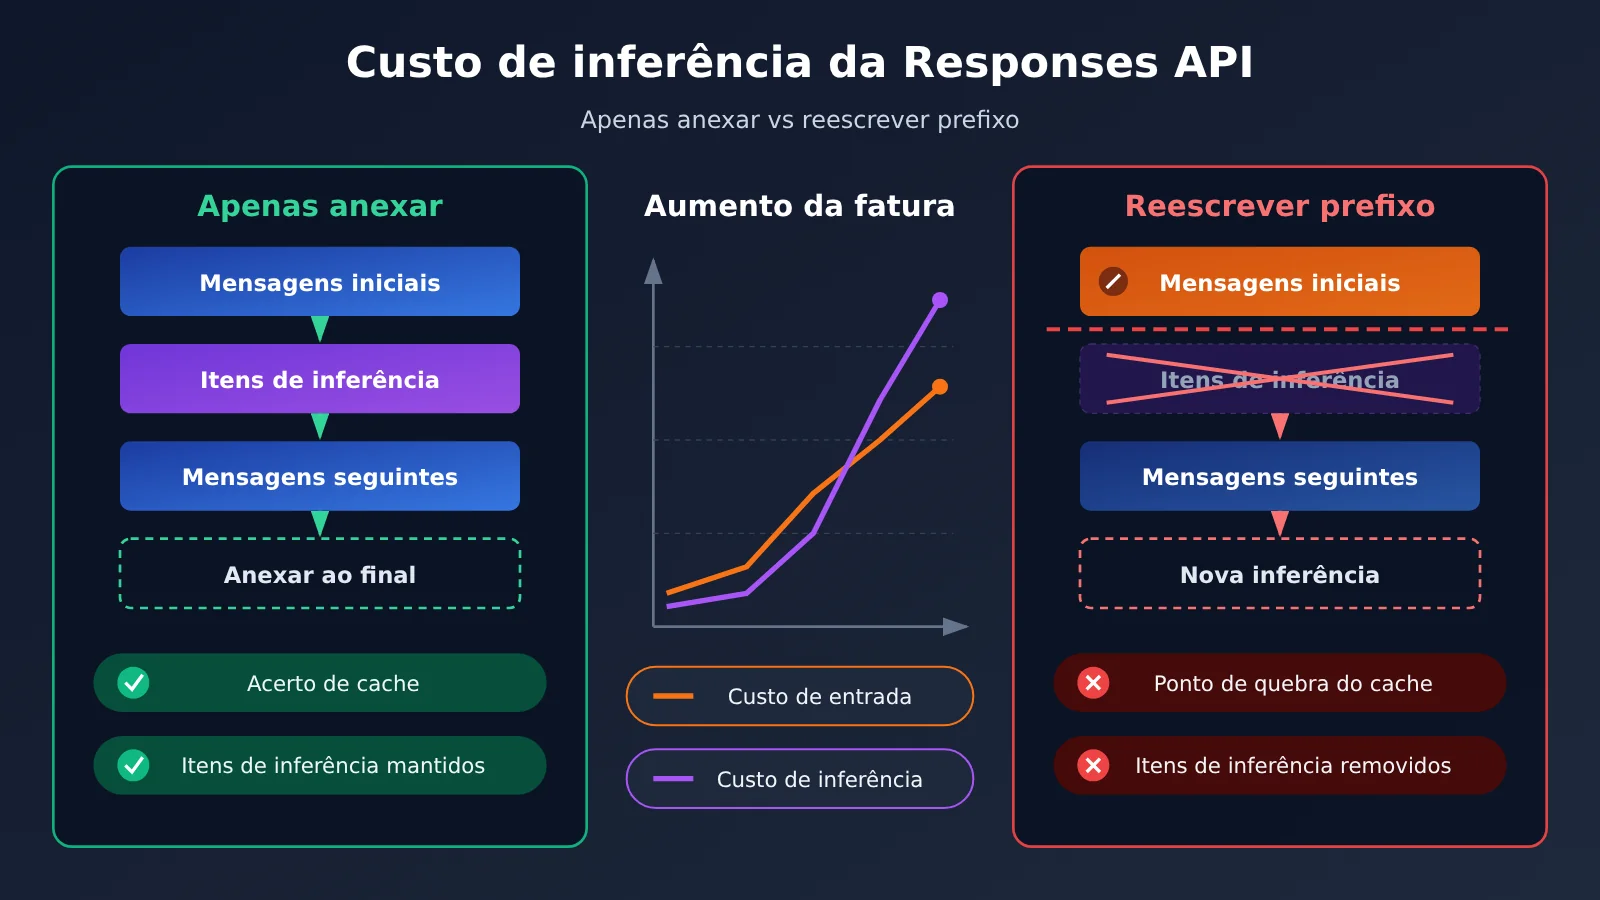
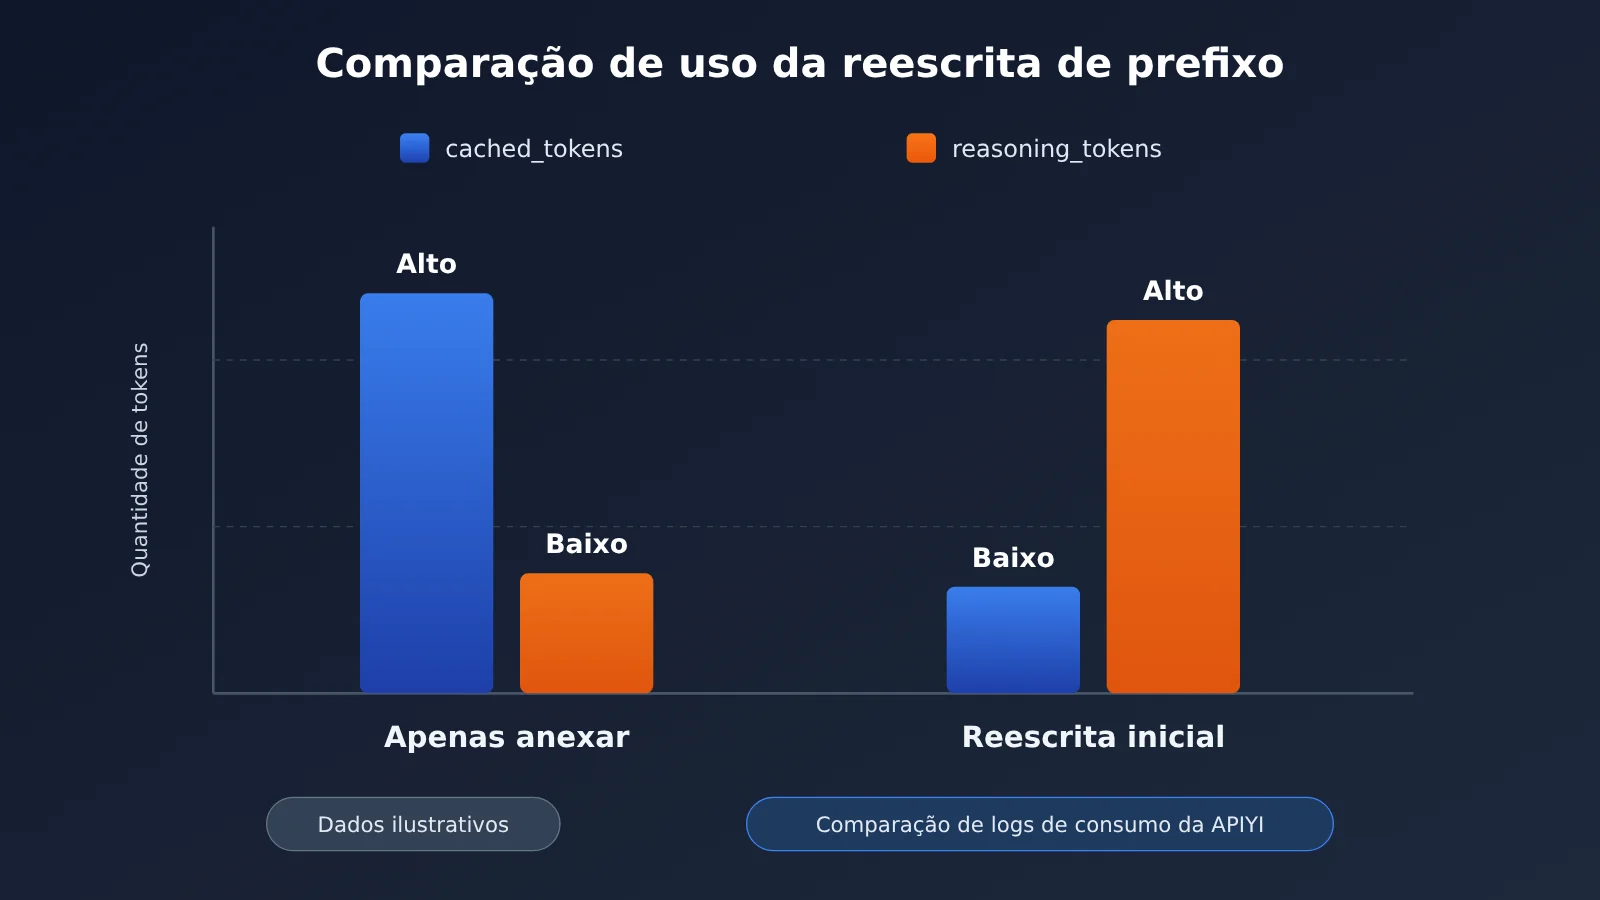
Já adianto a conclusão. O aumento da conta normalmente não tem uma única causa; pode vir de dois lugares ao mesmo tempo: primeiro, depois que o prefixo de entrada é alterado, as leituras de cache diminuem, e a entrada que antes era cobrada pelo preço de cache passa a ser cobrada pelo preço normal de entrada; segundo, o GPT-6.2 removeu itens de raciocínio anteriores por causa de prefix_mismatch, o modelo precisa raciocinar de novo, e pode haver custo extra de raciocínio. Se esses dois itens ocorrem e qual é a fatia de cada um depende da versão do modelo, do local da alteração e do usage real. O exemplo de cálculo abaixo serve apenas para demonstrar o método de decomposição da conta e não representa nenhuma conta real. Se você fizer as chamadas via APIYI (apiyi.com), recomenda-se usar o histórico de input sob seu próprio gerenciamento para montar um grupo de controle e depois conferir os números nos registros de consumo.
Mapa de conhecimento sobre custos de inferência na OpenAI Responses API
A tabela abaixo apresenta o conteúdo das quatro seções do artigo e suas relações mútuas, indicando também a ordem de leitura. A seção 1 explica de onde vêm os custos, a seção 2 mostra quais operações os disparam, a seção 3 traz o método de medição, e a seção 4 converte os números medidos em valores monetários e propõe um plano de ajuste.
| Nº | Pergunta respondida | O que entrega para a próxima seção | O que você pode fazer depois de ler |
|---|---|---|---|
| 1 | Onde o custo aumentou | Duas linhas de observação: leitura de cache e saída adicional | Entender o significado dos campos relevantes em usage |
| 2 | Quais ações de edição disparam o aumento | Lista de pontos de código que precisam ser investigados | Avaliar se sua forma de manter o contexto tem riscos |
| 3 | Como isolar as variações | Um conjunto de dados pareados comparáveis | Confirmar com experimento controlado se o problema existe |
| 4 | Quanto custa a diferença e como corrigir | Fórmula de decomposição de custos e três ajustes | Estimar a diferença e verificar a cobrança real pelo request ID |
Se você já confirmou que há reescrita de prefixo, pode começar direto pela seção 3. As seções 1 e 2 servem como referência de comparação durante a investigação.
Para Saber: Termos relacionados ao custo de inferência da Responses API
| Termo | Explicação resumida |
|---|---|
| Responses API | Interface da OpenAI usada para unificar o tratamento de respostas do modelo, raciocínio e chamadas de ferramentas |
| Prefixo de entrada | Conteúdo de entrada inicial e configurações mantidos na mesma ordem no começo de requisições de múltiplas rodadas |
| Acerto de cache | A requisição atual reutiliza tokens de entrada já processados, e essa parte é cobrada pelo preço de leitura de cache |
| Item de raciocínio | Um tipo de item estruturado na resposta de modelos de raciocínio, que pode ser reutilizado em requisições subsequentes compatíveis |
prefix_mismatch |
Valor de motivo em diagnósticos relacionados ao GPT-6.2, indicando que um prefixo anterior foi alterado, o que levou à remoção dos itens de raciocínio |
| Somente anexação | Forma de manutenção de histórico que preserva o conteúdo e a ordem originais e apenas acrescenta novos eventos no final |
reasoning_tokens |
Subitem de raciocínio dentro do uso de saída, usado para observar o consumo de raciocínio |
x-request-id |
Identificador da requisição no cabeçalho de resposta, usado para correlacionar a resposta do cliente com os logs do fornecedor |
1. Por que o custo de inferência da Responses API sobe em dois lugares
1.1 Primeira linha: menos leitura de cache
Conforme explica o documento “Prompt caching” da OpenAI, o cache de prompt começa a correspondência a partir do início da requisição. Basta que um trecho anterior seja reescrito para que a parte posterior ao ponto de alteração deixe de ser cobrada pelo preço de leitura de cache e passe a ser cobrada pelo preço normal de entrada. Tomando como exemplo o preço de contexto curto do gpt-6.2-sol na tabela geral de preços da APIYI, a entrada normal custa 2 dólares por milhão de tokens e a leitura de cache custa 0,10 dólar — uma diferença de 20 vezes.
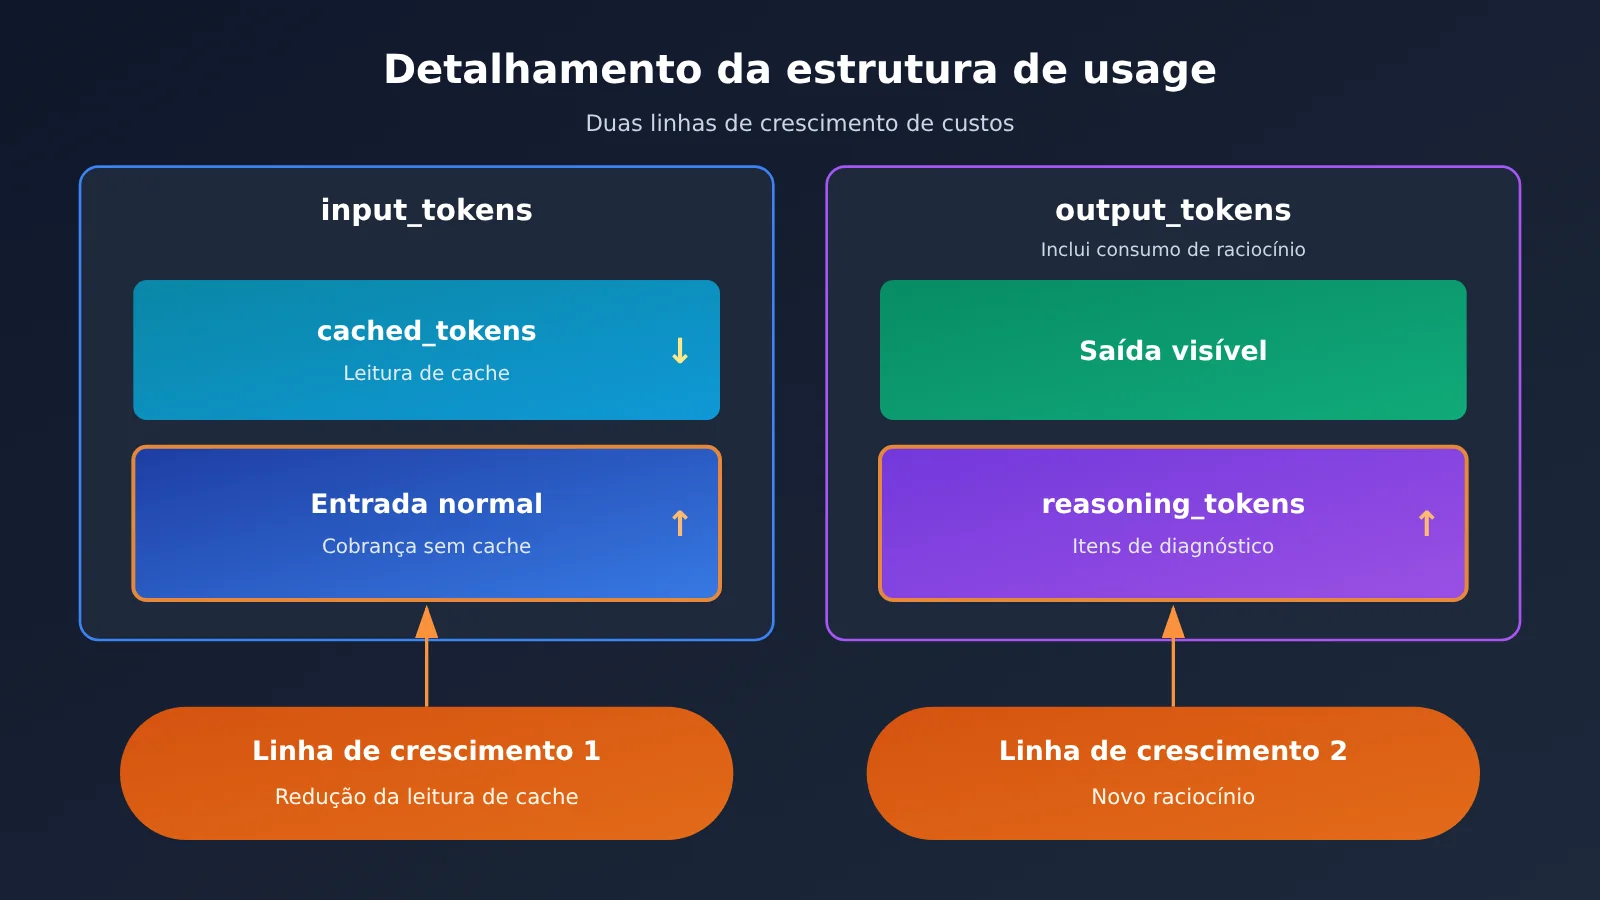
Essa variação de custo tem campo correspondente em usage: o total de input_tokens pode ficar praticamente igual, mas o cached_tokens dentro dele diminui. Olhar só para o volume total de entrada não revela o problema; é preciso registrar separadamente o volume de leitura de cache.
1.2 Segunda linha: nova saída depois que os itens de raciocínio perdem o direito de reutilização
No API Changelog da OpenAI de 2026-11-17, o comportamento de “editar o histórico anterior faz os itens de raciocínio serem removidos com o motivo prefix_mismatch” foi marcado como válido a partir do GPT-6.2. Depois que os itens de raciocínio são removidos, o modelo não vê mais o conteúdo de raciocínio anterior nas rodadas seguintes e pode precisar raciocinar de novo, o que pode gerar custo adicional de raciocínio.
Essa linha se reflete no lado da saída, aparecendo como mais reasoning_tokens e mais saída total. Ela pode ocorrer ao mesmo tempo que a redução na leitura de cache, mas são dois campos independentes em usage, então é preciso observá-los separadamente durante a investigação.
1.3 A relação de inclusão entre output_tokens e reasoning_tokens
Segundo o documento “Counting tokens” da OpenAI, output_tokens já inclui o consumo de raciocínio, e output_tokens_details.reasoning_tokens é apenas o subitem de diagnóstico dentro dele. Para calcular o custo, basta multiplicar output_tokens pelo preço unitário de saída. Se você somar reasoning_tokens outra vez em separado, vai contar duas vezes.
2. Quais ações de edição de prefixo fazem o custo de raciocínio aumentar
2.1 Operações comuns que acionam prefix_mismatch
Segundo as orientações do OpenAI em “Keep the prefix unchanged” e “Reasoning models”, as operações abaixo reescrevem o prefixo e, no GPT-6.2, podem fazer com que os itens de raciocínio sejam removidos:
| Operação | Cenário típico de código | Risco |
|---|---|---|
| Reescrever mensagens antigas | Voltar e corrigir a redação do turno 2 do usuário, ou adicionar um carimbo de data/hora a uma mensagem antiga | Reescreve o prefixo |
| Reescrever resultados antigos de ferramentas | Encurtar o JSON retornado por uma ferramenta anterior para economizar tokens | Reescreve o prefixo (encurtar também conta como reescrita) |
| Inserir conteúdo antes de um item de raciocínio relacionado | Colocar material recém-recuperado no meio do histórico | Reescreve o prefixo |
| Excluir um item inteiro mantendo o restante intacto | Remover uma mensagem antiga completa | Não aciona esse motivo de remoção, mas o volume de acertos de cache ainda pode mudar |
| Anexar depois de um item de raciocínio | Adicionar novas mensagens em ordem cronológica | Não aciona esse motivo de remoção |
“Encurtar a saída antiga de uma ferramenta” parece uma forma de economizar tokens, mas é uma reescrita. Só quando você exclui um item completo e mantém os demais inalterados é que o prefix_mismatch não é acionado. Mesmo assim, o ponto de partida do casamento de cache pode mudar, e o volume de leitura de cache ainda precisa ser medido na prática.
2.2 A diferença entre troca de versão, de nível e de família de modelo
Esses tipos de mudança precisam ser avaliados separadamente:
- Diferença de versão: a OpenAI deixa claro que a remoção de itens de raciocínio por
prefix_mismatché um comportamento que começa no GPT-6.2. O GPT-6.1 Sol suportareasoning.context: all_turnse consegue renderizar raciocínios anteriores quando o histórico compatível está disponível. Ao migrar de 6.1 para 6.2, a forma de manutenção de contexto que você já usava precisa ser validada novamente. - Nível de raciocínio: as duas gerações do Sol oferecem os cinco níveis
low,medium,high,xhighemax; o 6.2 Sol rejeitanone. A abordagem organizada pelo artigo de terceiros OrcaRouter é não alterarreasoning.effortdiretamente entre requisições, mas sim anexar um itemconfiguration_updatenoinput. O mesmo texto observa que históricos contendo esse tipo de item são truncados automaticamente e rejeitados por/responses/compact. Antes de adotar essa prática, baseie-se na documentação oficial da OpenAI. - Troca de família de modelo e downgrade: segundo a OpenAI, trocar de família de modelo ou passar para um modelo de capacidade menor também pode remover itens de raciocínio já existentes. Esse é um motivo diferente do
prefix_mismatche deve ser classificado separadamente nas estatísticas.
2.3 Posição e cobrança do instructions de nível superior no GPT-6.2
O documento “Using GPT-6.2” da OpenAI explica que o instructions de nível superior do GPT-6.2 é anexado depois do input e cobrado como entrada não cacheada. Por isso, ele serve para comandos temporários de desenvolvedor do turno atual, e não para grandes blocos de configuração de sistema que permanecem iguais por muito tempo.
Instruções que precisam ser reutilizadas por longo prazo devem ficar no input, como a primeira mensagem developer, para poderem ser cacheadas. Se quiser ajustar instruções de longo prazo, anexe uma nova mensagem developer ao final do histórico — não volte para editar a primeira.
3. Isolar mudanças no custo de raciocínio da Responses API com requisições de controle
3.1 Configuração do grupo de controle
Mantenha fixos o modelo, o nível de raciocínio, as definições de ferramentas e o volume de entrada; mude apenas uma variável: a forma de manutenção do histórico. O grupo A apenas acrescenta conteúdo, enquanto o grupo B reescreve um trecho no início. Cada grupo executa várias rodadas, usando o mesmo conjunto de tarefas.
Registre cada requisição de forma padronizada conforme a tabela abaixo. A qualidade da tarefa precisa ser pontuada manualmente ou por um script de avaliação, porque a redução de custo não pode vir às custas de resultados piores.
| Campo | Origem | Finalidade |
|---|---|---|
| Grupo | Personalizado | Distinguir o grupo que apenas acrescenta do grupo que reescreve |
cached_tokens |
usage.input_tokens_details |
Observar a primeira linha |
reasoning_tokens |
usage.output_tokens_details |
Observar a segunda linha |
output_tokens |
usage |
Calcular o custo de saída |
| Latência | Cronometragem no cliente | O aumento do raciocínio geralmente vem acompanhado de maior tempo de execução |
| Qualidade da tarefa | Pontuação manual ou por script de avaliação | Excluir casos em que se troca qualidade por custo |
x-request-id |
Cabeçalho da resposta | Conciliação |
3.2 Exemplo de chamada apenas com anexação
O código abaixo mantém o histórico de input por conta própria, acrescentando apenas ao final a cada rodada e, ao mesmo tempo, gravando o uso e o ID da requisição no log:
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # Fixado para toda a sessão; não altere entre as rodadas

# Prefixo estável: as instruções reutilizáveis ficam no primeiro item de input e não são alteradas depois
history = [{"role": "developer", "content": "你是代码审查助手,回答简洁。"}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # É preciso verificar antes se o grupo de destino é retornado
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # Apenas anexação: a saída desta rodada (incluindo itens de raciocínio) volta como está para o final do histórico
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
A variante de reescrita reutiliza a mesma função: antes da N-ésima rodada, altere o conteúdo de history[1] e defina variant como "early_rewrite"; os demais parâmetros permanecem iguais.
🚀 Início rápido: ao montar o grupo de controle, você pode alternar entre
gpt-6.1-solegpt-6.2-solusando a mesma chave API via APIYI apiyi.com. Com a mesma estrutura de logs, dá para comparar o impacto das diferenças entre versões no uso de cache e de raciocínio.
3.3 Diagnóstico auxiliar na conexão direta oficial
Ao se conectar diretamente à OpenAI, você pode definir prompt_cache_options.comparison_response_id como o ID de uma resposta anterior e, em seguida, ler o motivo do diagnóstico retornado e o número de tokens em cache. O campo input_transformations da resposta lista quais itens de raciocínio foram removidos e o motivo; entre eles, prefix_mismatch pode ser associado por ID ao item de raciocínio na saída da resposta antiga.
# Apenas para conexão direta oficial com a OpenAI
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
Esse diagnóstico tem duas limitações: o diagnóstico de cache, seguindo o princípio de melhor esforço, reporta apenas a primeira diferença, e não é possível confirmar se o modelo realmente reutilizou o raciocínio preservado. Ele informa que “um item de raciocínio foi removido”, mas não “quanto a mais foi gasto por causa disso”; o custo ainda precisa ser avaliado junto com o uso emparelhado da seção 3.1.
3.4 Observações ao chamar via APIYI
A conexão direta com a OpenAI permite continuar o estado da sessão com previous_response_id. O guia de invocação nativa da Responses API da APIYI (docs.apiyi.com) afirma, no corpo do texto, que esse modo encadeado não funciona, mas o FAQ da mesma página registra que ele funcionou em testes reais em 2026-09-02. Como as duas afirmações divergem, a linha de base mais segura é gerenciar você mesmo o histórico em input, como descrito na seção 3.2.
A continuidade de estado, o envio de itens de raciocínio criptografados de volta e os campos de diagnóstico acima podem variar na prática conforme o grupo de tokens, sendo necessário validar separadamente no grupo de destino. Se os campos de diagnóstico não estiverem disponíveis, os logs de uso emparelhados ainda podem servir como base para a avaliação.
4. Detalhando com números os custos de inferência da Responses API e implementando as mudanças
4.1 Preços de tabela usados na estimativa
A seguir estão os preços de tabela padrão para contexto curto da tabela geral de preços da APIYI apiyi.com (atualizada em 20/11/2026 às 15:17, horário de Pequim, em dólares por milhão de tokens). A cobrança efetiva também depende do grupo de tokens em que o modelo está e do custo de recarga, então é preciso verificar cada um separadamente.
| ID do modelo na APIYI | Entrada normal | Leitura de cache | Saída |
|---|---|---|---|
gpt-6.2-sol, gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
O contexto longo precisa ser calculado separadamente. Quando a entrada do gpt-6.2-sol ultrapassa 272.000 tokens, o preço de entrada listado atualmente na tabela geral da APIYI é $3, enquanto a página oficial do modelo Standard da OpenAI lista $4; para o gpt-6.1-sol, o preço de entrada para contexto longo é $4 nos dois lugares. Para os preços de cache e de saída da faixa de contexto longo, confira as regras de cobrança em tempo real de cada canal.
4.2 Exemplo de rateio entre duas requisições
Premissas: contexto curto, preço padrão do APIYI Sol, ambas as requisições com entrada de 12,000 tokens, sem gravação de cache listada separadamente e sem custo de ferramentas. Todos os números abaixo são hipotéticos, não dados medidos.
| Item | Prefixo preservado | Prefixo reescrito |
|---|---|---|
| Leitura de cache | 9,000 × $0.10/M = $0.0009 | 3,000 × $0.10/M = $0.0003 |
| Entrada normal | 3,000 × $2/M = $0.0060 | 9,000 × $2/M = $0.0180 |
| Saída total | 1,000 × $10/M = $0.0100 | 1,600 × $10/M = $0.0160 |
| Total | $0.0169 | $0.0343 |
A diferença entre as duas é de $0.0174, que pode ser decomposta em duas partes: $0.0114 vem dos 6,000 tokens de entrada que passam do preço de cache para o preço de entrada normal, ou seja, 6,000 × ($2 − $0.10) / 1,000,000; e $0.0060 vem dos 600 tokens de saída total adicionais. Essas duas partes correspondem, respectivamente, às duas linhas da seção 1. A diferença real deve ser baseada no seu próprio usage. Se houver gravação de cache listada separadamente, o cálculo deve ser feito separadamente nas três categorias mutuamente exclusivas: entrada normal, leitura de cache e gravação de cache.
4.3 Reconciliação pelo ID da requisição
Depois de estimar, confira a cobrança real. Nos logs de consumo do APIYI apiyi.com, use o x-request-id do cabeçalho de resposta para localizar o registro correspondente com type=2, e converta quota ÷ 500,000 para chegar ao valor real cobrado em dólares. Registre também o modelo, o grupo de token, o período da invocação e o uso de entrada e saída dessa requisição.
Ainda não existe um faturamento público de comparação por prefixo para APIYI no mesmo grupo e mesma tarefa. Por isso, ao avaliar o efeito das mudanças, você deve se basear nos seus próprios logs de requisições emparelhadas e nos registros de cobrança.
💰 Sugestão de reconciliação: associe o
request_iddos logs da seção 3.2 com os logs de consumo, item por item, gerando três colunas: “campo de uso → valor estimado → cobrança real”. A coluna em que aparecer desvio indica em qual etapa está o problema.
4.4 Três mudanças
- Fixe a definição das ferramentas e as instruções estáveis: mantenha a ordem original das definições de ferramentas e não as altere no meio da sessão; coloque as instruções de longo prazo na primeira mensagem developer do
input, e o prompt temporário da rodada atual pode usar oinstructionsde nível superior do GPT-6.2 — mas aceite que ele será cobrado como entrada não cacheada. - Anexe o contexto em ordem: novas mensagens, novos resultados de ferramentas e novos materiais recuperados vão todos para o final. Se realmente precisar enxugar, exclua itens completos, nunca reescreva o conteúdo deles.
- Teste separadamente contexto longo e migração de versão: quando o contexto longo passar de 272.000 tokens de entrada, aplica-se outra faixa de preço, então monte um grupo de controle separado; ao migrar de
gpt-6.1-solparagpt-6.2-sol, ou ao ajustar a faixa e trocar de família de modelos, valide primeiro com o método de comparação da seção 3 e só depois implante em produção integralmente.
Depois dessas mudanças, dá para verificar o efeito assim: rode novamente os dois grupos de controle sobre o mesmo conjunto de tarefas. Se a proporção de cached_tokens do grupo apenas de anexação estiver estável, se reasoning_tokens não tiver subido de forma anormal e se a cobrança real conferida pelo ID da requisição bater com a estimativa, significa que esse custo está sob controle.
Referências
- OpenAI《Keep the prefix unchanged》: manutenção do prefixo e diagnóstico
prefix_mismatch- Link:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Link:
- OpenAI《Reasoning models》: reutilização de itens de raciocínio e a exceção de remoção do item inteiro
- Link:
developers.openai.com/api/docs/guides/reasoning
- Link:
- OpenAI《Prompt caching》 e 《Counting tokens》: regras de correspondência de cache e campos de uso
- Link:
developers.openai.com/api/docs/guides/prompt-caching
- Link:
- OpenAI API Changelog (entrada do GPT-6.2, 2026-11-17)
- Link:
developers.openai.com/api/docs/changelog
- Link:
- OrcaRouter《GPT-6.2 Preserved Reasoning》: abordagem de reescrita apenas com acréscimos (append-only) organizada por terceiros
- Link:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- Link:
- APIYI《Tabela geral de preços de modelos》
- Link:
docs.apiyi.com/models
- Link:
- APIYI《API de consulta de logs》
- Link:
docs.apiyi.com/api-capabilities/log-query
- Link:
- APIYI《Guia de chamada nativa da OpenAI Responses API》
- Link:
docs.apiyi.com/api-capabilities/openai/native
- Link:
Autor: Equipe técnica da APIYI
Intercâmbio técnico: fique à vontade para nos contatar na página inicial do site da APIYI; mais materiais podem ser encontrados no centro de documentação docs.apiyi.com