摘要:在 GPT-6.2 的多輪 Responses API 調用中,改寫早期輸入可能減少緩存命中,也可能讓部分推理項失去複用資格。開發者可以改用僅追加的上下文結構,再用成對的用量日誌定位費用差異。
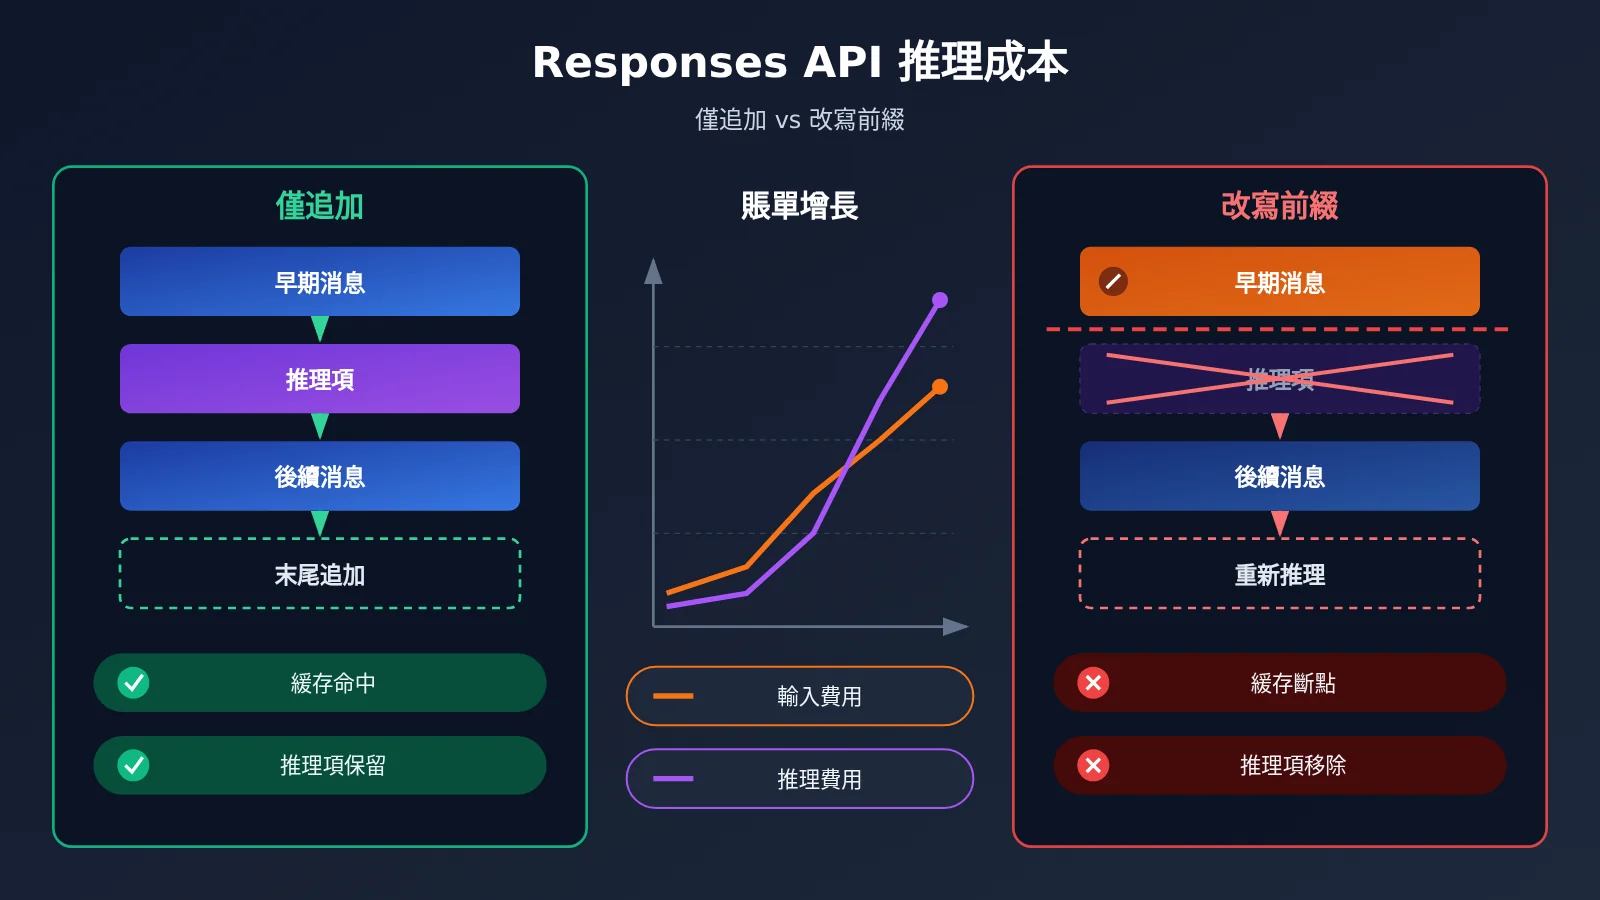
先說結論。賬單上漲的原因通常不止一個,可能同時來自兩處:一是輸入前綴被改動後,緩存讀取變少,原本按緩存價計費的輸入改按普通輸入價計費;二是 GPT-6.2 因 prefix_mismatch 移除了早期推理項,模型需要重新推理,可能發生額外推理成本。這兩項是否出現、各佔多少,取決於模型版本、改動位置以及實際 usage。下文的算例只用於演示拆賬方法,不代表任何真實賬單。如果通過 API易(apiyi.com)調用,建議用自己管理的 input 歷史建立對照組,再按消費日誌覈算。
OpenAI Responses API 推理成本知識地圖
下表列出全文四節的內容和相互關係,也標明閱讀順序。第 1 節解釋費用從哪裏來,第 2 節說明哪些操作會觸發,第 3 節給出測量方法,第 4 節把測到的數字換算成金額,並給出改造方案。
| 編號 | 回答的問題 | 爲下一節提供什麼 | 讀完能做什麼 |
|---|---|---|---|
| 1 | 費用漲在哪裏 | 兩條觀察線:緩存讀取、新增輸出 | 讀懂 usage 中相關字段的含義 |
| 2 | 哪些編輯動作會觸發 | 需要排查的代碼位置清單 | 判斷自己的上下文維護方式是否有風險 |
| 3 | 如何隔離變化 | 一組可對比的成對數據 | 用對照實驗確認問題是否存在 |
| 4 | 差多少錢、怎麼改 | 拆賬公式與三項改造 | 估算差額,並按請求 ID 覈對實際扣費 |
如果你已經確認存在前綴改寫,可以直接從第 3 節開始。第 1 節和第 2 節可作爲排查時的對照依據。
To Know:Responses API 推理成本相關術語
| 術語 | 簡明解釋 |
|---|---|
| Responses API | OpenAI 用於統一處理模型響應、推理與工具調用的接口 |
| 輸入前綴 | 多輪請求開頭保持相同順序的早期輸入內容及配置 |
| 緩存命中 | 本次請求複用已處理過的輸入 Token,這部分按緩存讀取價計費 |
| 推理項 | 推理模型響應中的一類結構化項目,可在兼容的後續請求中複用 |
prefix_mismatch |
GPT-6.2 相關診斷中的一個原因值,表示較早的前綴被改動,導致推理項被移除 |
| 僅追加 | 保留原有內容和順序,只在末尾添加後續事件的歷史維護方式 |
reasoning_tokens |
輸出用量中的推理子項,用於觀察推理消耗 |
x-request-id |
響應頭中的請求標識,用於關聯客戶端響應與供應方日誌 |
1. Responses API 推理成本爲何漲在兩處
1.1 第一條線:緩存讀取減少
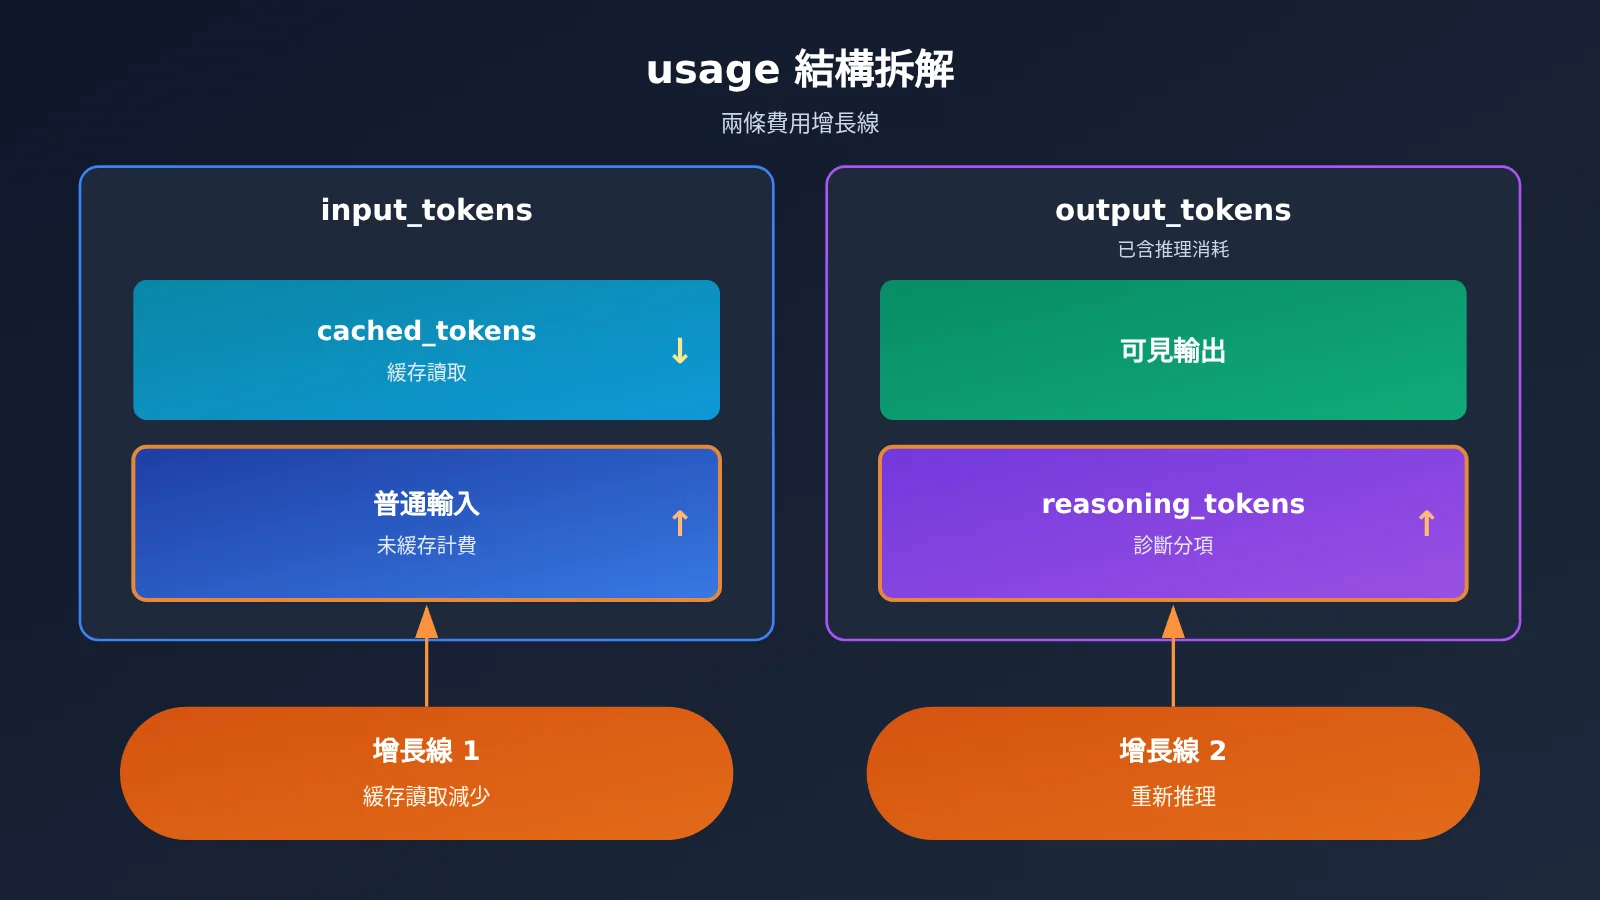
按 OpenAI《Prompt caching》的說明,提示緩存從請求開頭開始匹配。只要早期某段內容被改寫,從改動點往後的部分就無法再按緩存讀取計費,會改按普通輸入價計費。以 API易 價格總表中的 gpt-6.2-sol 短上下文標價爲例,普通輸入爲每百萬 Token 2 美元,緩存讀爲 0.10 美元,兩者相差 20 倍。
這部分費用變化在 usage 中有對應字段:input_tokens 總量可能基本不變,但其中的 cached_tokens 會變少。只看總輸入量是發現不了這個問題的,必須單獨記錄緩存讀取量。
1.2 第二條線:推理項失去複用資格後的新輸出
OpenAI 在 2026-11-17 的 API Changelog 中,把“編輯早期歷史導致以 prefix_mismatch 爲由移除推理項”標註爲從 GPT-6.2 開始的行爲。推理項被移除後,模型在後續輪次看不到之前的推理內容,可能需要重新推理,因此可能發生額外推理成本。
這條線反映在輸出側,表現爲 reasoning_tokens 和總輸出變多。它和緩存讀取減少可能同時出現,但在 usage 中是兩個獨立的字段,排查時需要分開觀察。
1.3 output_tokens 與 reasoning_tokens 的包含關係
根據 OpenAI《Counting tokens》,output_tokens 已經包含推理消耗,output_tokens_details.reasoning_tokens 只是其中的診斷分項。計算費用時,用 output_tokens 乘以輸出單價即可。如果再把 reasoning_tokens 單獨加一遍,就會重複計算。
2. 哪些前綴編輯動作會觸發推理成本上升
2.1 會觸發 prefix_mismatch 的常見操作
按 OpenAI《Keep the prefix unchanged》和《Reasoning models》的說明,以下操作屬於改寫前綴,在 GPT-6.2 上可能導致推理項被移除:
| 操作 | 典型代碼場景 | 風險 |
|---|---|---|
| 重寫舊消息 | 回頭修正用戶第 2 輪的措辭,或給舊消息補上時間戳 | 改寫前綴 |
| 改寫舊工具結果 | 爲了省 Token,縮短早期工具返回的 JSON | 改寫前綴(縮短也算改寫) |
| 在相關推理項之前插入內容 | 把新檢索到的資料插到歷史中間 | 改寫前綴 |
| 整項刪除且其餘內容不變 | 刪除一條完整的舊消息 | 不觸發該移除原因,緩存命中量仍可能變化 |
| 在推理項之後追加 | 按時間順序添加新消息 | 不觸發該移除原因 |
“縮短舊工具輸出”看起來是在節省 Token,但它屬於改寫。只有刪除完整的項目、並且其餘項目保持不變時,纔不會觸發 prefix_mismatch。即便如此,緩存的匹配起點也可能變化,緩存讀取量仍需實際測量。
2.2 版本、檔位與模型家族切換的區別
這幾類變化需要分開判斷:
- 版本差異:OpenAI 明確說明,因
prefix_mismatch移除推理項是從 GPT-6.2 開始的行爲。GPT-6.1 Sol 支持reasoning.context: all_turns,可以在兼容歷史可用時渲染較早的推理。從 6.1 遷移到 6.2 時,原有的上下文維護方式需要重新驗證。 - 推理檔位:兩代 Sol 都提供
low、medium、high、xhigh、max五檔,6.2 Sol 會拒絕none。第三方文章 OrcaRouter 整理的做法是不在請求之間直接修改reasoning.effort,而是在input中追加一個configuration_update項。該文同時指出,包含此類項目的歷史會被自動截斷和/responses/compact拒絕。採用這種做法前,請以 OpenAI 官方文檔爲準。 - 模型家族切換與降級:按 OpenAI 說明,切換模型家族或改用能力較低的型號,也可能移除已有的推理項。這和
prefix_mismatch是不同的原因,統計時應分開歸類。
2.3 GPT-6.2 頂層 instructions 的位置與計費
OpenAI《Using GPT-6.2》說明,GPT-6.2 的頂層 instructions 會追加在 input 之後,按未緩存輸入計費。因此它適合放當前輪次的臨時開發者提示,不適合放長期不變的大段系統設定。
需要長期複用的指令,應作爲第一條 developer 消息放在 input 中,以便被緩存。如果要調整長期指令,在歷史末尾追加一條新的 developer 消息,不要回頭修改第一條。
3. 用對照請求隔離 Responses API 推理成本變化
3.1 對照組設計
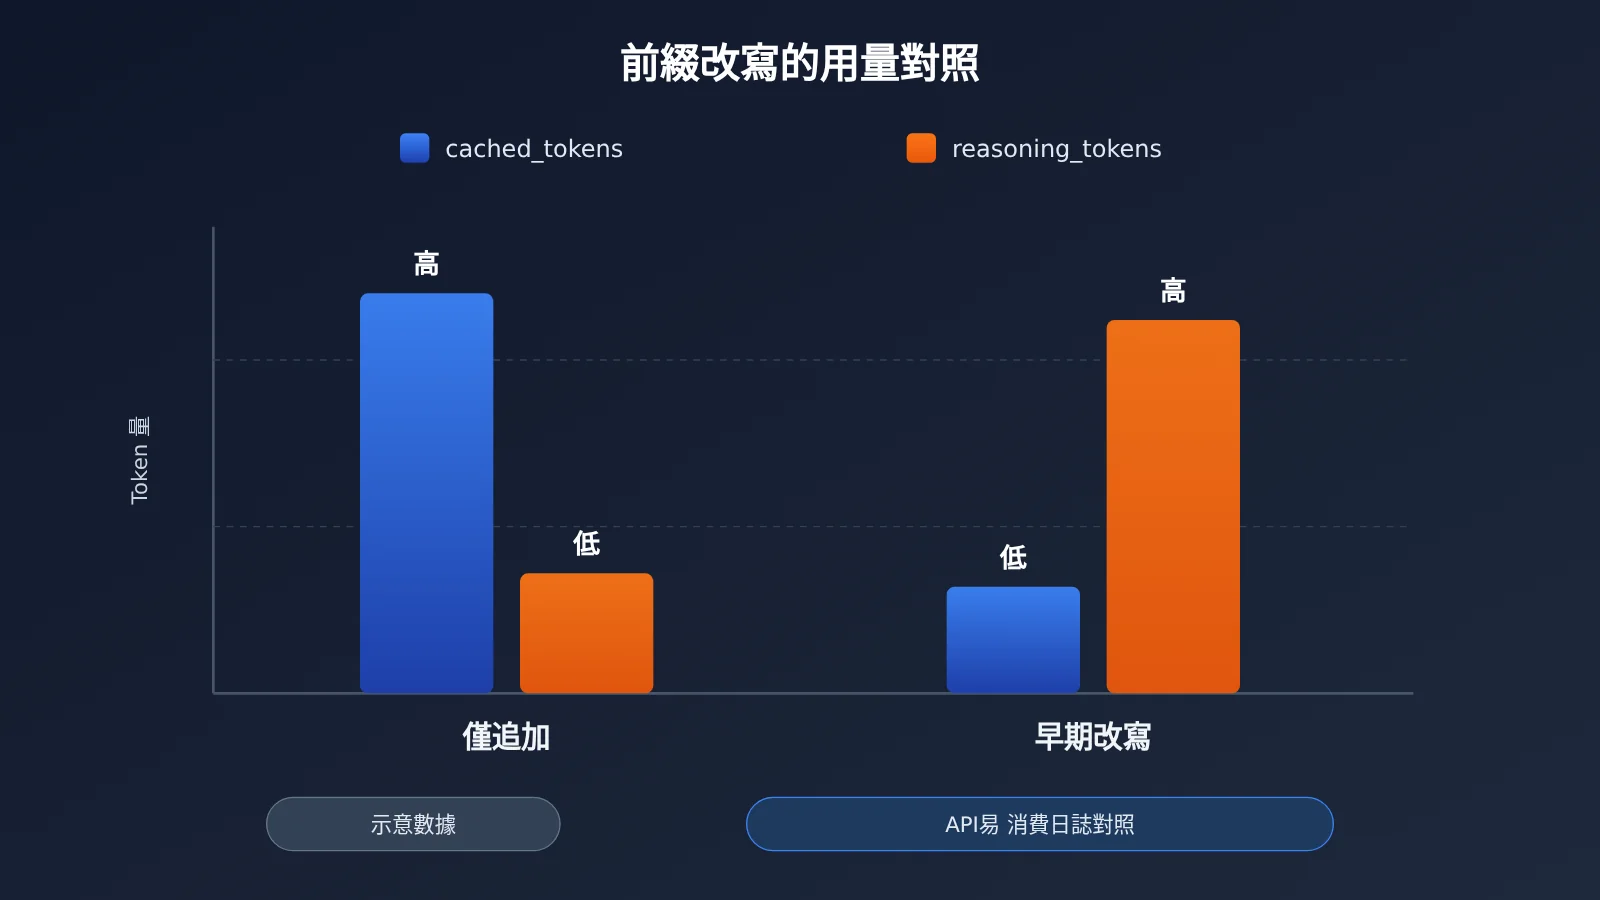
固定模型、推理檔位、工具定義和輸入量,只改變歷史維護方式這一個變量:A 組僅追加,B 組在早期改寫一處內容。兩組各跑多輪,並使用相同的任務集。
每次請求統一按下表記錄。任務質量需要人工或評測腳本打分,因爲費用下降不能以結果變差爲代價。
| 字段 | 來源 | 用途 |
|---|---|---|
| 組別 | 自定義 | 區分僅追加組與改寫組 |
cached_tokens |
usage.input_tokens_details |
觀察第一條線 |
reasoning_tokens |
usage.output_tokens_details |
觀察第二條線 |
output_tokens |
usage |
計算輸出費用 |
| 延遲 | 客戶端計時 | 推理增加通常伴隨耗時變長 |
| 任務質量 | 人工或評測打分 | 排除以質量換費用的情況 |
x-request-id |
響應頭 | 對賬 |
3.2 僅追加的調用示例
下面的代碼自己維護 input 歷史,每輪只在末尾追加,同時把用量和請求 ID 寫入日誌:
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # 整個會話固定,不在輪次之間修改

# 穩定前綴:可複用的指令放在 input 第一條,之後不再修改
history = [{"role": "developer", "content": "你是代碼審查助手,回答簡潔。"}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # 目標分組是否回傳需先覈驗
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # 僅追加:本輪輸出(含推理項)原樣放回歷史末尾
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
改寫組複用同一個函數:在第 N 輪前修改 history[1] 的內容,並把 variant 設爲 "early_rewrite",其餘參數保持不變。
🚀 快速開始:搭建對照組時,可以通過 API易 apiyi.com 用同一個 API Key 切換
gpt-6.1-sol與gpt-6.2-sol。在同一套日誌結構下,就能比較版本差異對緩存和推理用量的影響。
3.3 官方直連的輔助診斷
直連 OpenAI 時,可以把 prompt_cache_options.comparison_response_id 設爲之前某次響應的 ID,然後讀取返回的診斷原因和緩存 Token 數。響應中的 input_transformations 會列出哪些推理項被移除及原因,其中 prefix_mismatch 可以按 ID 對應到舊響應輸出中的推理項。
# 僅用於 OpenAI 官方直連
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
這個診斷有兩個限制:緩存診斷按盡力原則只報告第一處差異,而且無法確認模型是否真正複用了保留下來的推理。它能告訴你“推理項被移除了”,但不能告訴你“因此多花了多少”,費用仍需結合第 3.1 節的成對用量來判斷。
3.4 通過 API易 調用時的注意事項
OpenAI 直連支持用 previous_response_id 續接會話狀態。API易 的 Responses API 原生調用指南(docs.apiyi.com)正文稱該鏈式方式不生效,但同頁 FAQ 記錄了 2026-09-02 實測可用。兩處說法不一致,因此更穩妥的基線是:自己管理 input 歷史,與 3.2 節的寫法一致。
狀態續接、加密推理項的回傳以及上述診斷字段,實際表現可能因令牌分組而異,需要在目標分組上單獨驗證。如果診斷字段不可用,成對的用量日誌仍然可以作爲判斷依據。
4. 用數字拆解 Responses API 推理成本並落實改造
4.1 估算使用的標價
以下爲 API易 apiyi.com 價格總表中的短上下文默認標價(2026-11-20 15:17 北京時間更新,單位爲美元/百萬 Token)。實際扣費還要看模型所在的令牌分組和充值成本,需要分別覈對。
| API易模型 ID | 普通輸入 | 緩存讀 | 輸出 |
|---|---|---|---|
gpt-6.2-sol、gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
長上下文需要單獨計算。gpt-6.2-sol 的輸入超過 272,000 Token 時,API易 當前總表列出的輸入價爲 $3,OpenAI 官方 Standard 模型頁列出的是 $4;gpt-6.1-sol 的長上下文輸入價在兩邊均爲 $4。長上下文檔位的緩存價和輸出價,請按各自渠道的實時計費規則覈對。
4.2 兩次請求的拆賬算例
假設條件:短上下文,API易 Sol 默認標價,兩次請求的輸入都是 12,000 Token,沒有單列的緩存寫入,也沒有工具費。以下數字全部爲假設,不是實測數據。
| 項目 | 保留前綴 | 改寫前綴 |
|---|---|---|
| 緩存讀 | 9,000 × $0.10/M = $0.0009 | 3,000 × $0.10/M = $0.0003 |
| 普通輸入 | 3,000 × $2/M = $0.0060 | 9,000 × $2/M = $0.0180 |
| 總輸出 | 1,000 × $10/M = $0.0100 | 1,600 × $10/M = $0.0160 |
| 合計 | $0.0169 | $0.0343 |
兩次相差 $0.0174,可以拆成兩部分:$0.0114 來自 6,000 個輸入 Token 從緩存價變爲普通輸入價,即 6,000 × ($2 − $0.10) / 1,000,000;$0.0060 來自多出的 600 個總輸出 Token。這兩部分分別對應第 1 節的兩條線。實際差額要以你自己的 usage 爲準。如果存在單列的緩存寫入,應按普通輸入、緩存讀、緩存寫三個互斥類別分別計算。
4.3 用請求 ID 對賬
估算之後,再覈對實際扣費。在 API易 apiyi.com 的消費日誌中,用響應頭裏的 x-request-id 找到對應的 type=2 記錄,用 quota ÷ 500,000 換算出實際扣費的美元數。同時記錄模型、令牌分組、調用時間段,以及該次請求的輸入和輸出用量。
目前還沒有公開的 API易 同分組、同任務的前綴對照賬單。因此,評估改造效果時,應該以你自己的成對請求日誌和扣費記錄爲準。
💰 對賬建議:把第 3.2 節日誌中的
request_id與消費日誌逐條關聯,得到“用量字段 → 估算金額 → 實際扣費”三列。哪一列出現偏差,就說明問題出在哪個環節。
4.4 三項改造
- 固定工具定義和穩定指令:工具定義保持原有順序,不在會話中途修改;長期指令放在
input的第一條 developer 消息中,當前輪次的臨時提示可以用 GPT-6.2 的頂層instructions,但要接受它按未緩存輸入計費。 - 按順序追加上下文:新消息、新工具結果和新檢索資料都追加到末尾。確實需要精簡時,刪除完整項目,不要改寫其中的內容。
- 單獨測試長上下文和版本遷移:長上下文超過 272,000 輸入 Token 後適用另一檔價格,應單獨建立對照組;從
gpt-6.1-sol遷移到gpt-6.2-sol,或調整檔位、切換模型家族時,先用第 3 節的對照方法驗證,再全量上線。
完成以上改造後,可以這樣檢驗效果:在同一任務集上重新運行兩組對照。如果僅追加組的 cached_tokens 佔比穩定,reasoning_tokens 沒有異常升高,按請求 ID 覈對的實際扣費也與估算一致,就說明這部分費用已經得到控制。
參考資料
- OpenAI《Keep the prefix unchanged》:前綴保持與
prefix_mismatch診斷- 鏈接:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- 鏈接:
- OpenAI《Reasoning models》:推理項複用與整項刪除的例外
- 鏈接:
developers.openai.com/api/docs/guides/reasoning
- 鏈接:
- OpenAI《Prompt caching》與《Counting tokens》:緩存匹配規則與用量字段
- 鏈接:
developers.openai.com/api/docs/guides/prompt-caching
- 鏈接:
- OpenAI API Changelog(GPT-6.2 條目,2026-11-17)
- 鏈接:
developers.openai.com/api/docs/changelog
- 鏈接:
- OrcaRouter《GPT-6.2 Preserved Reasoning》:第三方整理的僅追加改寫做法
- 鏈接:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- 鏈接:
- API易《模型價格總表》
- 鏈接:
docs.apiyi.com/models
- 鏈接:
- API易《日誌查詢 API》
- 鏈接:
docs.apiyi.com/api-capabilities/log-query
- 鏈接:
- API易《OpenAI Responses API 原生調用指南》
- 鏈接:
docs.apiyi.com/api-capabilities/openai/native
- 鏈接:
作者:API易技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心