Nota del autor: en el ranking general de Artificial Analysis, Claude Fable 5.2 está por delante de Gemini 4 Neon. Este artículo separa la puntuación de inteligencia y el costo por tarea en dos cuentas distintas, y las compara punto por punto según el nivel, para ayudar a ver dónde está exactamente la diferencia entre ambos.
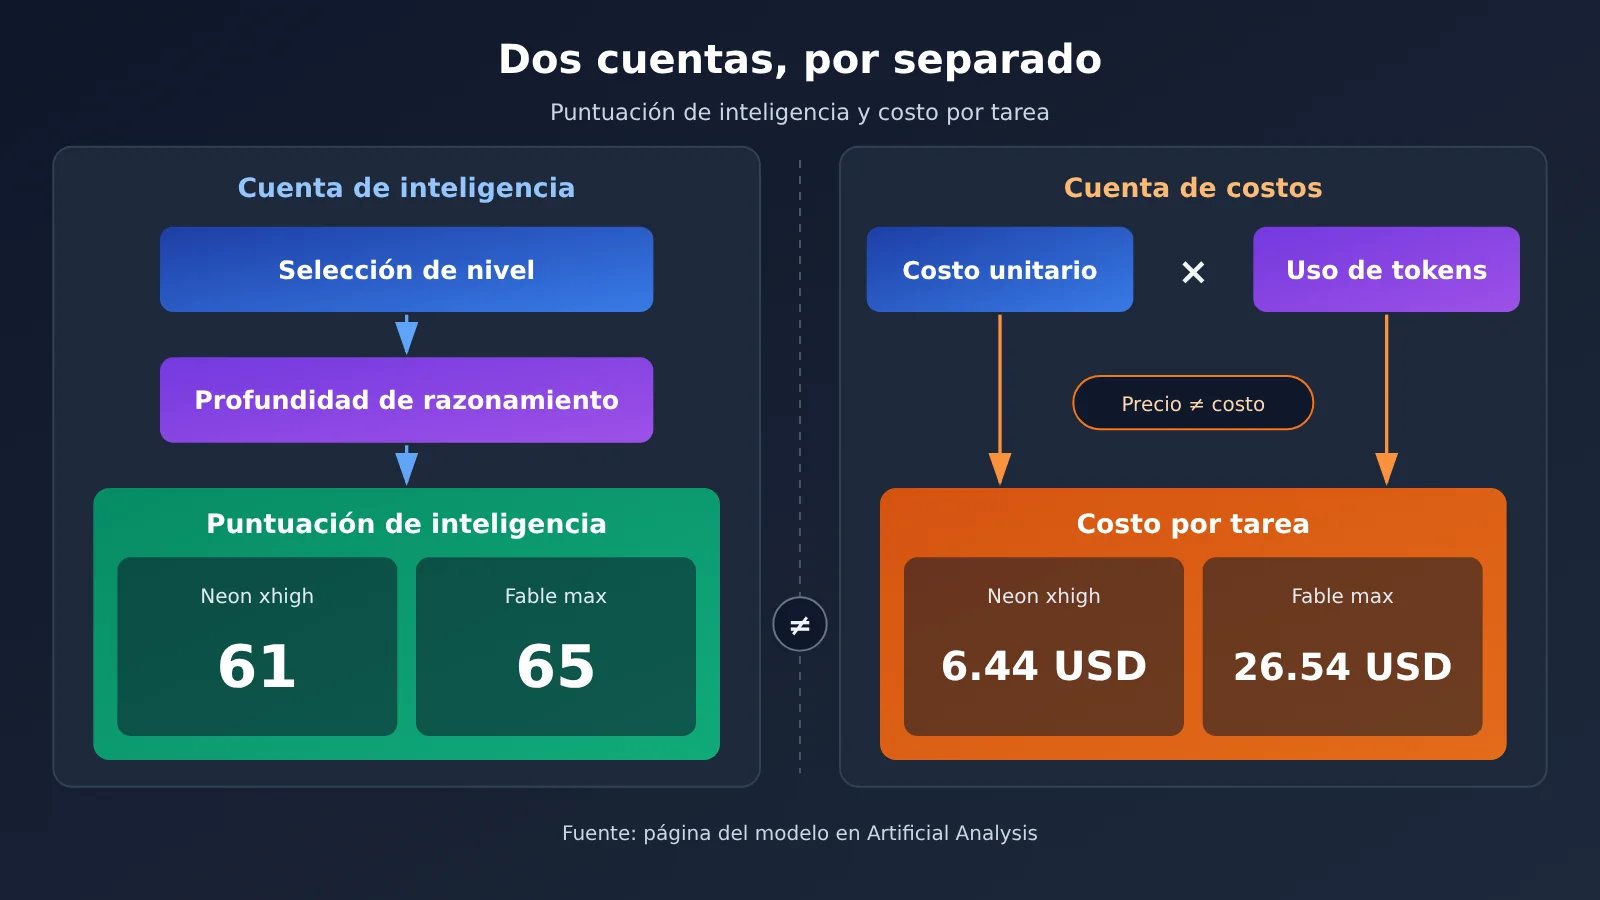
Gemini 4 Neon se publicó el 18 de noviembre de 2026. Según el orden del artículo de Artificial Analysis, Neon ocupa el tercer puesto en el ranking general en el nivel xhigh con 61 puntos; por delante están GPT-6.2 Astra (max) y Claude Fable 5.2 (max). Al ver este ranking, muchos desarrolladores se preguntan: ¿la ventaja de Fable 5.2 viene de la puntuación de inteligencia o de gastar más dinero?
Estas dos cuentas deben mirarse por separado. La puntuación de inteligencia corresponde al nivel max de Fable y al nivel xhigh de Neon; en el índice de codificación, Fable usa el nivel xhigh. La ficha de modelo de Google no tiene ninguna columna para Fable, así que las métricas desglosadas de Fable no se pueden tomar prestadas de otro modelo. Este artículo solo usa indicadores que coinciden tanto en el artículo de Artificial Analysis como en las dos páginas de modelos de Artificial Analysis, y cada cifra indica su fuente. Si necesitas verificar modelos y precios, puedes consultar directamente la lista de modelos de APIYI en apiyi.com.
Valor clave: al terminar este artículo, sabrás cuáles son la puntuación de inteligencia, el costo por tarea, el tiempo de ejecución, la velocidad de salida y el tiempo hasta el primer token de Gemini 4 Neon y Claude Fable 5.2, a qué nivel corresponde cada uno y entre qué cifras no se puede restar ni combinar. Fecha de verificación de datos: 19 de noviembre de 2026.
Puntos clave de Gemini 4 Neon y Claude Fable 5.2: la doble cuenta del índice de inteligencia y del coste
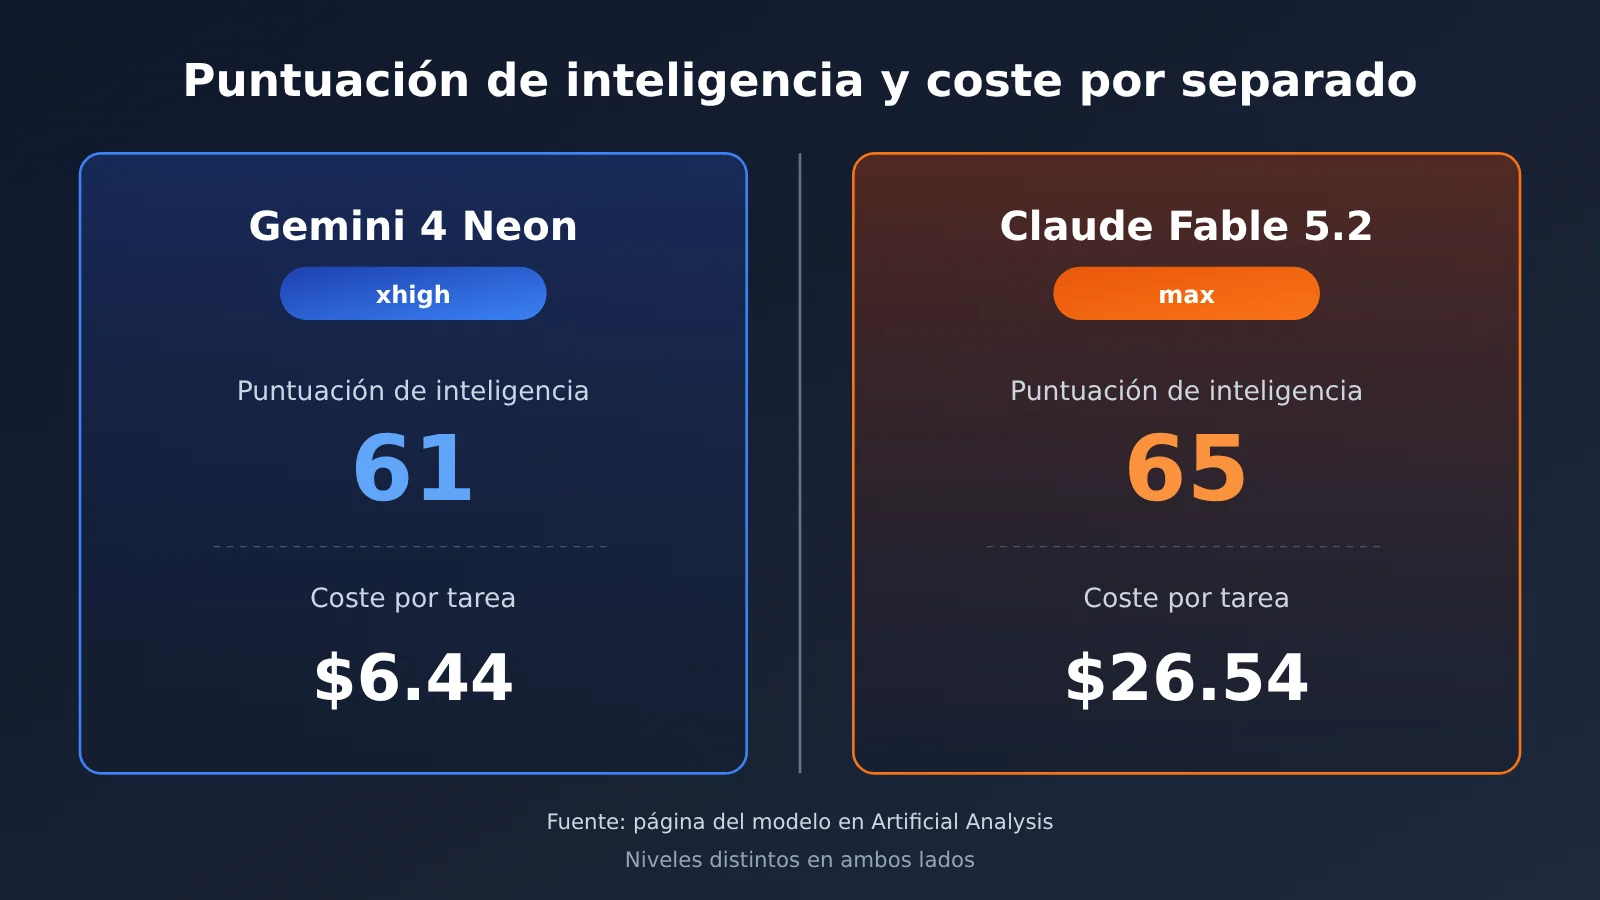
Todos los datos de la tabla siguiente salen de la página del modelo en Artificial Analysis (consultada el 2026-11-19, índice v5.0.1). Conviene tener en cuenta que los niveles comparados no son equivalentes: para Fable se toma max (que además es el Default Fallback de esa página) y para Neon se toma xhigh.
| Métrica | Gemini 4 Neon (xhigh) | Claude Fable 5.2 (max) | Fuente |
|---|---|---|---|
| Índice de inteligencia | 61 | 65 | Página del modelo en Artificial Analysis |
| Coste por tarea | 6.44 USD | 26.54 USD | Página del modelo en Artificial Analysis |
| Tiempo por tarea | 21.5 minutos | 41.6 minutos | Página del modelo en Artificial Analysis |
| Velocidad de salida | 110 token/s | 110 token/s | Página del modelo en Artificial Analysis |
| Primera ficha de respuesta | 56.51 s | 247.46 s | Página del modelo en Artificial Analysis |
| Precio de lista (entrada/salida, por millón de tokens) | 3.00 / 15.00 USD | 8.00 / 40.00 USD | Página del modelo en Artificial Analysis |
La cuenta del índice de inteligencia: Gemini 4 Neon frente a Claude Fable 5.2
En la columna del índice de inteligencia tenemos 61 frente a 65, y los niveles comparados son Neon xhigh contra Fable max. Según el artículo de Artificial Analysis, Neon xhigh supera en 1 punto a Gemini 4 Carbon high y se sitúa en el puesto 3 de la clasificación general, donde los dos primeros son GPT-6.2 Astra (max) y Claude Fable 5.2 (max). El blog de Google también afirma que el Artificial Analysis Intelligence Index con xhigh es 61, pero esa frase es una autodeclaración oficial; lo cierto es que el 61 coincide en tres sitios: el blog de Google, la ficha del modelo y Artificial Analysis.
Fable solo publica en la página del modelo los datos del nivel max, así que al compararlo transversalmente con otros niveles de Neon no existen condiciones homólogas. El nivel de razonamiento predeterminado de Neon es high, y tanto la guía para desarrolladores de Google Cloud como la página de modelos más reciente de AI Studio lo indican. En la página de Artificial Analysis, Neon high obtiene 60 puntos. Si tu invocación no configura ningún nivel adicional, lo que obtienes en la práctica es high, no xhigh.
La cuenta del coste por tarea: Gemini 4 Neon frente a Claude Fable 5.2
El coste por tarea es de 6.44 USD frente a 26.54 USD, y el tiempo por tarea de 21.5 minutos frente a 41.6 minutos. El artículo de Artificial Analysis describe el tiempo de Neon como «unos 21 minutos», mientras que la página del modelo indica 21.5 minutos; ambas cifras se mantienen tal cual. La velocidad de salida es de 110 token/s en los dos casos, pero el tiempo hasta el primer token marca una diferencia enorme: 56.51 segundos para Neon xhigh y 247.46 segundos para Fable max.
El precio unitario y el coste por tarea no son lo mismo. En la página de Artificial Analysis, GPT-6.2 Astra tiene el mismo precio de lista, 8.00/40.00 USD, pero su coste por tarea en el nivel max es de 4.00 USD, porque al ejecutar el índice genera bastantes menos tokens de salida. Por eso, a la hora de juzgar el coste por tarea hay que mirar a la vez el precio unitario y el consumo de tokens; el precio de lista por sí solo no basta.
Índice de codificación de Gemini 4 Neon y Claude Fable 5.2: niveles anotados por separado
Los datos de esta sección sobre codificación provienen del artículo de Artificial Analysis; tanto los niveles como el entorno de ejecución deben indicarse por separado. Neon se midió en Antigravity CLI; Fable y Opus 5.5 se midieron en Claude Code; los harness de evaluación no son los mismos en ambos casos.
| Modelo y nivel | Coding Agent Index | Costo por tarea de codificación | Entorno de ejecución | Fuente |
|---|---|---|---|---|
| Gemini 4 Neon xhigh | 59 | 6,86 USD | Antigravity CLI | Artículo de Artificial Analysis |
| Claude Fable 5.2 xhigh | 58 | 15,47 USD | Claude Code | Artículo de Artificial Analysis |
| Claude Opus 5.5 max | 58 | 12,61 USD | Claude Code | Artículo de Artificial Analysis |
| Gemini 4 Carbon high | 55 | No indicado en el artículo | Antigravity CLI | Artículo de Artificial Analysis |
Aquí Fable usa el nivel xhigh, distinto del nivel max de la columna de puntuación de inteligencia; estas dos cifras no deben interpretarse bajo la misma condición. Además, el blog de Google indica que el Neon Coding Agent Index es 58,6, mientras que el artículo de Artificial Analysis señala 59. La primera es una cifra oficial autodeclarada; la segunda proviene de un artículo de terceros. Este texto conserva ambas, sin descartar ninguna ni promediarlas.
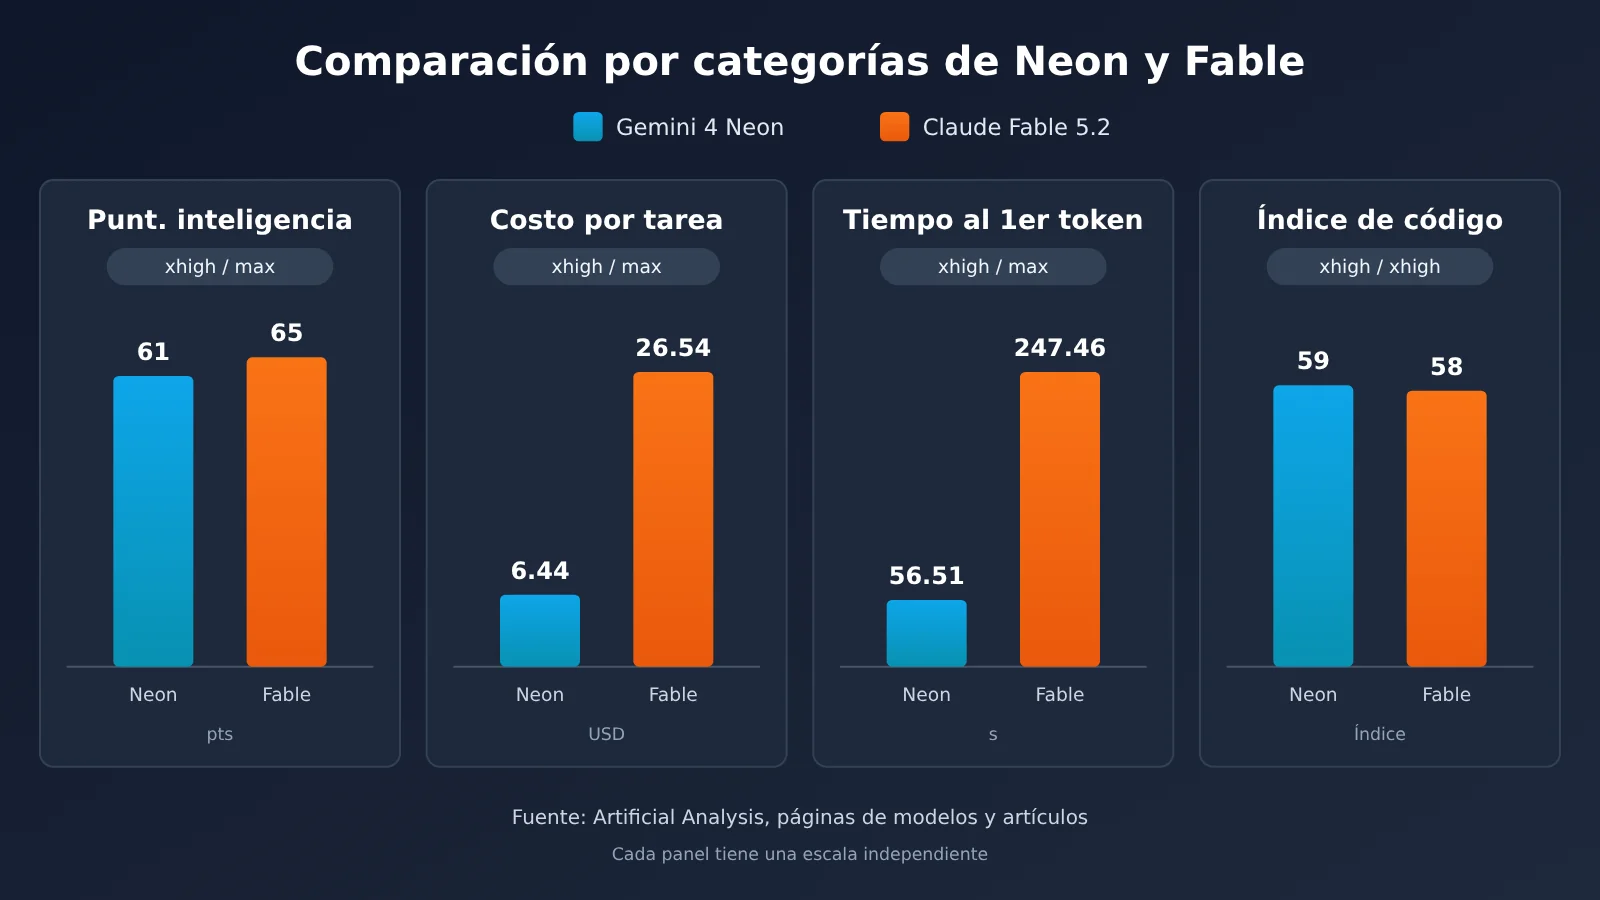
Nota sobre los datos: las cifras de la gráfica anterior provienen de la página de modelos de Artificial Analysis y de un artículo de Artificial Analysis; los niveles ya están indicados en la gráfica. Los precios de invocación de ambos modelos aparecen en la tabla de precios de APIYI más abajo.
Por qué la model card de Gemini 4 Neon no puede sustituir los desgloses de Claude Fable 5.2
La tabla comparativa de la model card de Gemini 4 Neon, de DeepMind, solo tiene tres columnas: Gemini 4 Neon, Claude Opus 5.5 y GPT-6.2 Sol, y en ella no aparece Claude Fable 5.2. El PDF con las notas de evaluación que acompaña la model card indica que, por defecto, los resultados de los modelos que no son Gemini provienen de lo que cada proveedor reporta por su cuenta. Por lo tanto, esa tabla es un resumen oficial de resultados, y no quiere decir que todos los modelos se volvieran a medir en el mismo laboratorio y el mismo día.
Opus 5.5 y Fable 5.2 son dos modelos distintos. En la página de modelo de Artificial Analysis, la puntuación de inteligencia de Opus 5.5 max es 59 y la de Fable 5.2 max es 65; además, sus precios de lista también difieren (4.00/20.00 frente a 8.00/40.00). Los porcentajes de la columna de Opus en la model card solo pueden representar a Opus 5.5, así que no sirven como desglose de Fable 5.2.
Estas son algunas cifras que se confunden con facilidad, junto con su criterio de medición:
| Afirmación | Cifra | Fuente y criterio |
|---|---|---|
| El coste por tarea de Neon high es menor que el de Carbon | 32% | Autoinformado por el fabricante (blog de Google); no se especifica si Carbon usa el precio de introducción o el precio estándar |
| Neon xhigh cuesta menos por tarea que Carbon | Aprox. 17% (6.44 frente a 7.76 dólares) | Artículo de Artificial Analysis; Carbon se calcula con el precio sin descuento |
| Coste por tarea de Carbon high | 4.90 dólares | Página de modelo de Artificial Analysis, calculado con el precio de introducción |
| Neon Coding Agent Index | 58.6 / 59 | Autoinformado por el fabricante / artículo de Artificial Analysis |
| Neon MKA | 56.5% / 56% | Model card / artículo de Artificial Analysis |
| Neon SWE-sweep | 12.8% / 39.0% | Autoinformado por el fabricante; corresponden a mini-SWE harness y a Google Antigravity, respectivamente |
Los tres datos de coste de la tabla anterior vienen de tres formas de contabilizar diferentes, así que no se pueden restar entre sí ni combinar en una sola cifra. En cuanto a la diferencia del SWE-sweep, que va del 12.8% al 39.0%, el blog de Google la explica como una mejora aportada por el harness, y no significa que los modelos en sí difieran en un factor de tres.
Gemini 4 Neon y Claude Fable 5.2: recomendaciones por escenario — primero define qué cuenta mirar
Los datos de ambos modelos están en la misma tabla, pero cada lector se fija en métricas distintas. A continuación agrupo según la pregunta «¿Qué métrica te importa más?»; en cada grupo solo indico qué columna conviene mirar, sin sacar conclusiones por ti.
Escenarios en los que priorizar la puntuación de inteligencia
- Razonamiento de largo alcance y análisis complejo: fíjate en la columna de puntuación de inteligencia y anota también el nivel (Fable max 65, Neon xhigh 61); al evaluar, reproduce con el mismo nivel.
- Si necesitas una clasificación comparativa: el artículo de Artificial Analysis ofrece una clasificación general; puedes citarla, pero indica en qué nivel se basa esa posición.
Escenarios en los que priorizar el costo y la latencia por tarea
- Invocaciones de alta frecuencia y tareas por lotes: fíjate en el costo por tarea (6.44 frente a 26.54 dólares) y el tiempo por tarea (21.5 frente a 41.6 minutos).
- Productos interactivos: fíjate en el tiempo hasta el primer token de respuesta (56.51 frente a 247.46 segundos). La velocidad de salida es la misma en ambos; para ver la diferencia de latencia, hay que mirar el tiempo hasta el primer token.
- Agentes de programación: consulta la tabla de programación y ten en cuenta que tanto Neon como Fable están en el nivel xhigh, pero sus entornos de ejecución son Antigravity CLI y Claude Code, respectivamente.
El rendimiento de Neon en cada nivel también merece una tabla aparte. Los siguientes datos provienen de la tabla resumen de la página del modelo en Artificial Analysis; en el tiempo hasta el primer token, las cifras de los tres últimos niveles proceden de las FAQ de esa misma página y no están en la misma columna que la tabla resumen.
| Nivel de Neon | Puntuación de inteligencia | Tiempo por tarea | Velocidad de salida | Primer token de respuesta |
|---|---|---|---|---|
| xhigh | 61 | 21.5 minutos | 110 tokens/segundo | 56.51 segundos |
| high (predeterminado) | 60 | 14.8 minutos | 101 tokens/segundo | 40.64 segundos (FAQ) |
| medium | 55 | 8.3 minutos | 101 tokens/segundo | 20.14 segundos (FAQ) |
| low | 44 | 3.7 minutos | 97 tokens/segundo | 13.93 segundos (FAQ) |
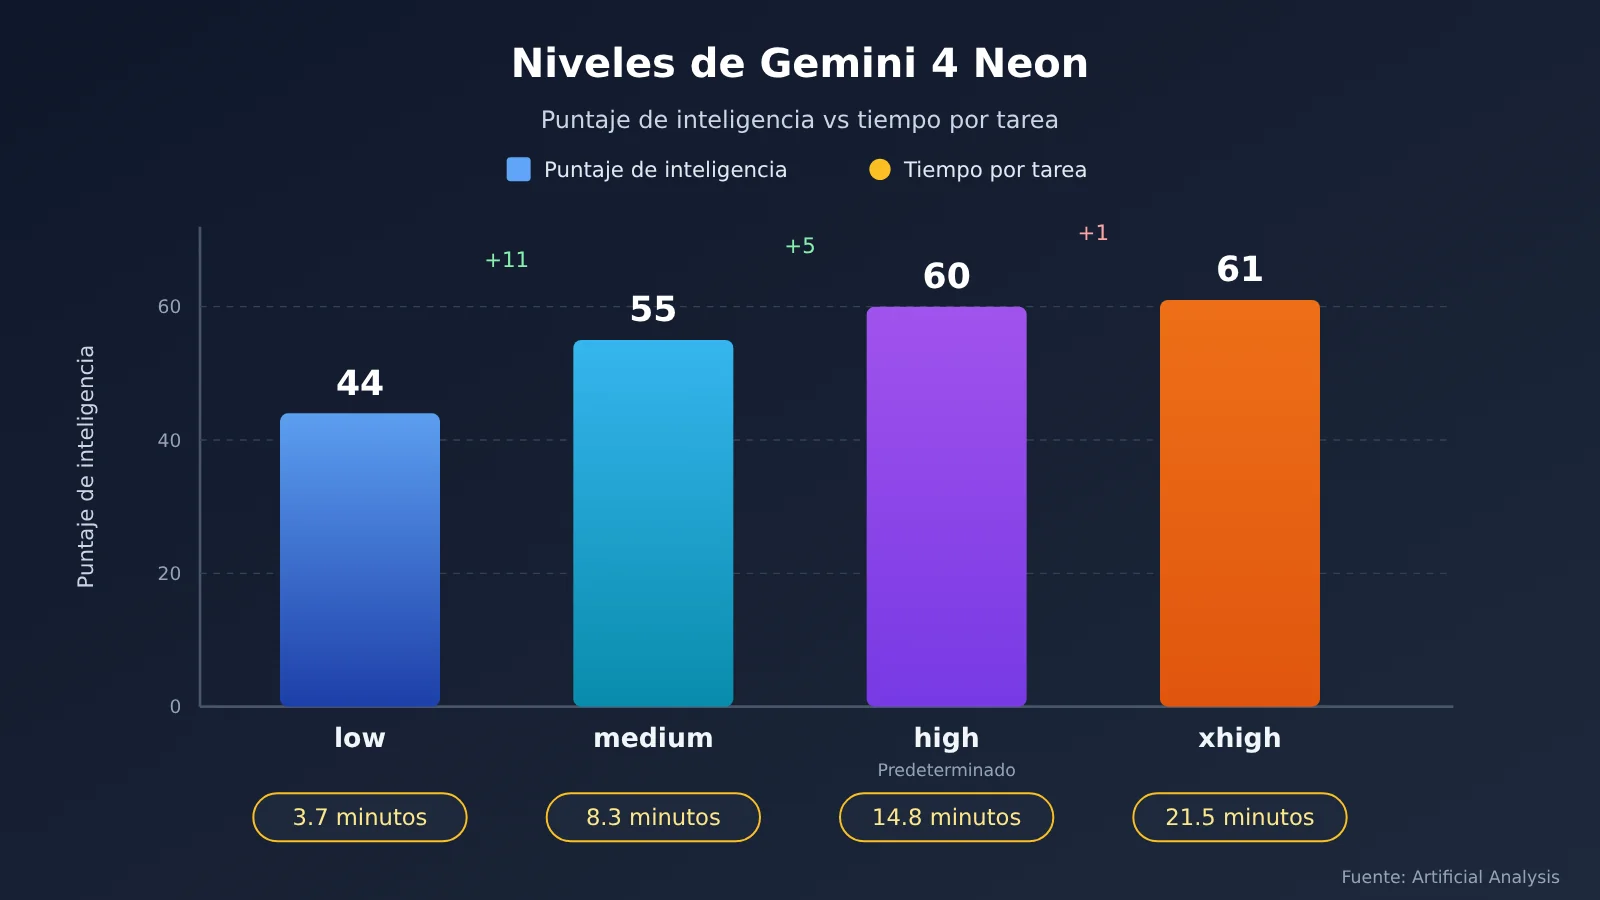
Además, los datos sobre GDP.pdf en el artículo de Artificial Analysis muestran que Neon high obtiene 33.4% y Neon xhigh, 28.0%. Esto indica que, en esta prueba, un nivel más alto no implica necesariamente una puntuación más alta.
Precios y disponibilidad de Gemini 4 Neon y Claude Fable 5.2
En cuanto a los precios oficiales, según la página de precios de Google AI Studio, gemini-4-neon no tiene nivel gratuito. Los precios de pago son: 3.00 USD por millón de tokens de entrada, 15.00 USD por millón de tokens de salida (incluye tokens de razonamiento), 0.15 USD por millón de tokens de caché, y solo admite caché implícita. El precio de lista de Fable 5.2 que muestra la página del modelo en Artificial Analysis es de 8.00/40.00 USD, con un descuento de caché del 98%.
En la tabla general de APIYI apiyi.com (la página indica actualización del 2026-11-16 a las 09:39, UTC+8) y en la interfaz de precios (consulta del 2026-11-19, versión shell-api-modelmak-v1, 285 modelos en total), la información de los modelos relevantes es la siguiente. Según la convención de la interfaz de precios, cuando model_ratio es 1, equivale a 2 USD por millón de tokens de entrada; completion_ratio de 5 indica que el precio unitario de salida es 5 veces el de entrada.
| ID del modelo | Entrada | Lectura de caché | Salida (USD/millón de tokens) | Endpoint | Plataformas disponibles |
|---|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | APIYI (ya disponible) |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | APIYI (ya disponible) |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | APIYI (ya disponible) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | APIYI (ya disponible) |
gemini-4-neon |
— | — | — | — | Google AI Studio oficial |
gemini-4-neon no aparece en la tabla general de APIYI ni en la interfaz de precios, por lo que aún no está disponible; añadiremos este modelo a la plataforma lo antes posible. Los modelos y precios se rigen por la lista de modelos de la plataforma. Los 2/10 USD de gemini-4-carbon en la tabla son el precio de catálogo actual de APIYI, coinciden con el precio introductorio de Google vigente hasta el 2026-11-30 y difieren del precio estándar posterior de Google, que es de 4/20 USD.
La agrupación de claude-fable-5-2 aparece escrita de forma diferente en dos lugares, así que aquí mostramos ambos conjuntos: en la tabla general de APIYI figuran ClaudeCode, Claude_Reverse, Claude_Enterprise, Default y SVIP; en la interfaz de precios, los ID de grupo son ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default y svip. Al configurar los grupos, guíate por lo que devuelva la interfaz que estés usando realmente.
Cómo invocar Claude Fable 5.2 a través de APIYI: inicio rápido
APIYI ofrece una interfaz compatible con OpenAI; para invocar claude-fable-5-2 solo hay que cambiar base_url y el nombre del modelo. Puedes seguir estos pasos:
- Obtén una clave API en APIYI y guárdala en una variable de entorno, por ejemplo
APIYI_API_KEY. No incluyas la clave en texto plano en el código. - En el SDK de OpenAI, configura base_url como
https://api.apiyi.com/v1; la inicialización del cliente puede quedar así:OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"]). - Realiza la solicitud:
client.chat.completions.create(model="claude-fable-5-2", messages=[{"role": "user", "content": "..."}]). Si necesitas la versión de razonamiento, cambia el nombre del modelo aclaude-fable-5-2-thinking; ambos tienen el mismo precio: 8 USD por millón de tokens de entrada, 0.2 USD por millón de tokens de lectura de caché y 40 USD por millón de tokens de salida. - Si tu proyecto usa el formato de solicitud estilo Anthropic, puedes utilizar el endpoint messages; el modelo y el precio no cambian.
- La serie Gemini se puede invocar de forma nativa: la dirección es
https://api.apiyi.com, la versión de API esv1betay los modelos disponibles incluyengemini-4-carbonygemini-4-hydrogen.
Una vez integrado, te recomendamos registrar en el log de solicitudes los tokens de entrada, los tokens de salida y el tiempo total de cada invocación. Así podrás calcular el costo por tarea con tus propios casos y compararlo con los 26.54 USD de Artificial Analysis; al hacerlo, ten en cuenta que la composición de las tareas no es la misma.
🚀 Inicio rápido: los usuarios nuevos que se registran en APIYI apiyi.com reciben crédito de prueba gratuito; pueden empezar ejecutando algunos casos reales de negocio con
claude-fable-5-2, anotar el uso de tokens y el tiempo, y luego decidir el plan y el presupuesto.
Recomendación de decisión: Gemini 4 Neon y Claude Fable 5.2, cómo elegir según el registro de costos
💡 Recomendación de elección: primero define si a tu negocio le importa más la puntuación de inteligencia, el costo por tarea o la latencia del primer token; después busca la columna correspondiente en la tabla y verifica el nivel.
- Verifica el nivel: la puntuación de inteligencia corresponde a Fable max y Neon xhigh; el índice de codificación corresponde a xhigh en ambos. Si pones en producción con otro nivel, tendrás que volver a consultar los datos de ese nivel.
- Verifica el criterio de medición: los datos autodeclarados por el fabricante, la ficha del modelo, los artículos de Artificial Analysis y la página del modelo de Artificial Analysis tienen fuentes distintas; conserva cada fuente y no las conviertas entre sí.
- Verifica los parámetros de invocación: según la guía para desarrolladores de Google Cloud, Neon solo tiene cuatro niveles de razonamiento: low, medium, high y xhigh; si pasas
thinking_budgetoMINIMAL, devolveráHTTP 400; Neon no admite caché de contexto explícita, y la caché implícita se aplica automáticamente a prefijos compartidos de más de 4096 tokens. - Vuelve a medir con tus propias tareas: los datos públicos solo sirven para acotar la elección; el costo y la latencia finales aún deben medirse con tus propias muestras.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es Gemini 4 Neon?
Gemini 4 Neon es un modelo que Google lanzó el 18 de noviembre de 2026. Según la ficha del modelo, deriva de Gemini 4 Carbon, tiene un corte de conocimiento en marzo de 2026 y admite entradas de texto, imagen, audio y video, con una ventana de contexto unificada de hasta 1 millón de tokens. Dentro de la línea de productos de Google, Neon se sitúa entre Hydrogen (ejecución rápida para el día a día) y Carbon (tareas complejas de largo alcance).
Q2: ¿Los datos de Opus 5.5 en la ficha del modelo de Gemini 4 Neon pueden representar a Claude Fable 5.2?
No. La ficha del modelo solo tiene tres columnas: Neon, Opus 5.5 y GPT-6.2 Sol; no incluye Fable 5.2, y, de forma predeterminada, los resultados de modelos que no son Gemini provienen de lo que reporta cada proveedor. Los datos que se pueden citar para Fable 5.2 son la puntuación de inteligencia, el costo, el tiempo, la velocidad y el índice de codificación que aparecen en la página del modelo y en los artículos de Artificial Analysis.
Q3: ¿Cuándo estará disponible Gemini 4 Neon y en qué canales se lanzará?
Según la publicación de Sundar Pichai (reportada oficialmente), Neon comenzó a implementarse desde el 18 de noviembre de 2026 en los siguientes canales: la API Gemini de Google AI Studio, Gemini for business, Google Antigravity en las versiones de pago Google AI Pro y Ultra, así como la Gemini App en Pro y Ultra. El ID de modelo que proporciona la guía para desarrolladores de Google Cloud es `gemini-4-neon`.
Q4: Si la velocidad de salida en ambos casos es de 110 tokens/segundo, ¿por qué difiere el tiempo por tarea?
La página del modelo de Artificial Analysis ofrece resultados agregados: los tiempos fueron de 21.5 minutos y 41.6 minutos, respectivamente, y el tiempo hasta el primer token fue de 56.51 segundos y 247.46 segundos, respectivamente. La página no desglosa la causa concreta de la diferencia de tiempo. Lo que sí se puede afirmar es que una misma velocidad de salida no implica el mismo tiempo total; el tiempo de espera hasta el primer token también forma parte del tiempo total.
Q5: ¿Cómo invocar Claude Fable 5.2 rápidamente mediante la API?
Después de obtener la clave API en APIYI apiyi.com, usa como base_url la dirección compatible con OpenAI indicada anteriormente; el nombre del modelo se escribe como `claude-fable-5-2` o `claude-fable-5-2-thinking`, y puedes usar tanto el endpoint chat como el endpoint messages. El precio es de 8 USD por millón de tokens de entrada, 0.2 USD por millón de tokens de lectura de caché y 40 USD por millón de tokens de salida; el nombre del grupo debe seguir la forma indicada tanto en la tabla general como en el endpoint de precios.
Q6: ¿Un precio unitario bajo implica un costo por tarea bajo?
No son directamente equivalentes. En la página del modelo de Artificial Analysis, el precio de lista de GPT-6.2 Astra es 8.00/40.00 USD, pero el costo por tarea en el nivel max es de solo 4.00 USD, porque al ejecutar el índice genera muchos menos tokens de salida. El costo por tarea depende tanto del precio unitario como del uso de tokens.
Q7: ¿Qué limitaciones conocidas tiene Gemini 4 Neon?
– **Precio**: AI Studio no tiene nivel gratuito; solo admite caché implícita.
– **Parámetros**: Pasar `thinking_budget` o `MINIMAL` devuelve `HTTP 400`, y tampoco admite caché de contexto explícita.
– **Longitud de salida**: La salida de un solo segmento tiene un máximo predeterminado de 65536 tokens; la decodificación larga tiene un máximo de 1048576 menos la longitud de entrada.
– **Versión de ciberseguridad**: La versión de ciberseguridad solo se abrirá en unos días para defensores de confianza del Fairwind Program, y no tiene un ID de modelo público (reportado oficialmente).
Gemini 4 Neon y Claude Fable 5.2: puntos clave
- La métrica de inteligencia depende del nivel: la página del modelo de Artificial Analysis muestra 61 para Neon xhigh y 65 para Fable max.
- Costo por tarea, visto por separado: Neon xhigh cuesta 6.44 dólares y Fable max 26.54 dólares; los tiempos son 21.5 y 41.6 minutos, respectivamente.
- Para la latencia, cuenta el tiempo hasta el primer token: en ambos lados la velocidad de salida es de 110 tokens/segundo; el tiempo hasta el primer token es de 56.51 y 247.46 segundos, respectivamente.
- El índice de programación también especifica el nivel: Neon xhigh es 59 y Fable xhigh 58; los costos por tarea de programación son 6.86 y 15.47 dólares, respectivamente.
- La ficha del modelo no incluye Fable: los desgloses de Opus 5.5 en la ficha del modelo no deben tomarse como datos de Fable 5.2.
- Cada cifra conserva su propio criterio: 32%, alrededor de 17%, 4.90 dólares, 58.6 y 59 pertenecen a métricas distintas.
- Punto de acceso:
claude-fable-5-2ya está disponible en APIYI;gemini-4-neonaún no está disponible.
Resumen
Al comparar Gemini 4 Neon y Claude Fable 5.2, hay tres puntos a tener en cuenta:
- Métrica de inteligencia: en la página del modelo de Artificial Analysis es 61 frente a 65, con niveles Neon xhigh y Fable max, respectivamente.
- Métrica de costo y latencia: costo por tarea 6.44 frente a 26.54 dólares, tiempo por tarea 21.5 frente a 41.6 minutos, tiempo hasta el primer token 56.51 frente a 247.46 segundos; en ambos lados la velocidad de salida es de 110 tokens/segundo.
- Métrica de programación: ambos están en el nivel xhigh, el índice es 59 frente a 58, el costo por tarea es 6.86 frente a 15.47 dólares, y los entornos de ejecución son Antigravity CLI y Claude Code, respectivamente.
Qué modelo elegir depende de qué métrica importa más para tu negocio. Sugiero acotar primero el rango con datos públicos y luego volver a medir costos y latencia con tus propias muestras. Puedes empezar probando claude-fable-5-2 en APIYI apiyi.com con la cuota gratuita; cuando gemini-4-neon esté disponible, podrás cambiar directamente el nombre del modelo en el mismo conjunto de APIs para compararlos.
📚 Materiales de referencia
-
Publicación de Sundar Pichai: lanzamiento y canales de distribución de Gemini 4 Neon (anuncio oficial)
- Enlace:
x.com/sundarpichai/status/2123167780988125621
- Enlace:
-
Blog de Google «Introducing Gemini 4 Neon»: evaluaciones, precios y posicionamiento según la información oficial
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon
- Enlace:
-
Ficha del modelo de DeepMind: tabla comparativa de tres columnas y especificaciones del modelo
- Enlace:
deepmind.google/models/model-cards/gemini-4-neon/
- Enlace:
-
Guía para desarrolladores de Google Cloud: ID del modelo, niveles de razonamiento y reglas de caché
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon
- Enlace:
-
Página de precios de Google AI Studio: tarifas de pago de gemini-4-neon
- Enlace:
aistudio.google.com/docs/pricing
- Enlace:
-
Artículo de Artificial Analysis: puntuación de inteligencia, coste e índice de programación de Neon
- Enlace:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain
- Enlace:
-
Página de modelo de Artificial Analysis: datos por niveles de Neon y Fable 5.2
- Enlace:
artificialanalysis.ai/models/gemini-4-neon - Enlace:
artificialanalysis.ai/models/claude-fable-5-2
- Enlace:
-
Tabla general y API de precios de APIYI: modelos ya disponibles, grupos y precios
- Enlace:
docs.apiyi.com/models.md - Enlace:
api.apiyi.com/api/pricing
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: escríbenos a través de la página principal del sitio web de APIYI; encontrarás más materiales en el centro de documentación docs.apiyi.com