概要:GPT-6.2 のマルチターン Responses API 呼び出しでは、初期入力を書き換えるとキャッシュヒットが減る可能性があり、一部の推論項目が再利用できなくなる可能性もあります。開発者は追記のみのコンテキスト構造に切り替え、ペアになった使用量ログで費用差を特定できます。
まず結論から述べます。請求額の上昇には通常複数の原因があり、次の2つが同時に絡む可能性があります。1つは入力プレフィックスが変更された結果、キャッシュ読み取りが減り、本来キャッシュ価格で課金される入力が通常の入力価格で課金されることです。もう1つは、GPT-6.2 が prefix_mismatch によって以前の推論項目を削除し、モデルが推論をやり直すため、追加の推論コストが発生する可能性があることです。この2つが実際に発生するか、それぞれどの程度を占めるかは、モデルのバージョン、変更箇所、実際の usage によって異なります。以下の計算例は費用を分解する方法を示すためのものであり、実際の請求額を表すものではありません。APIYI(apiyi.com)経由で呼び出す場合は、自分で管理している input 履歴を使って対照群を作り、利用ログに基づいて突き合わせることをおすすめします。
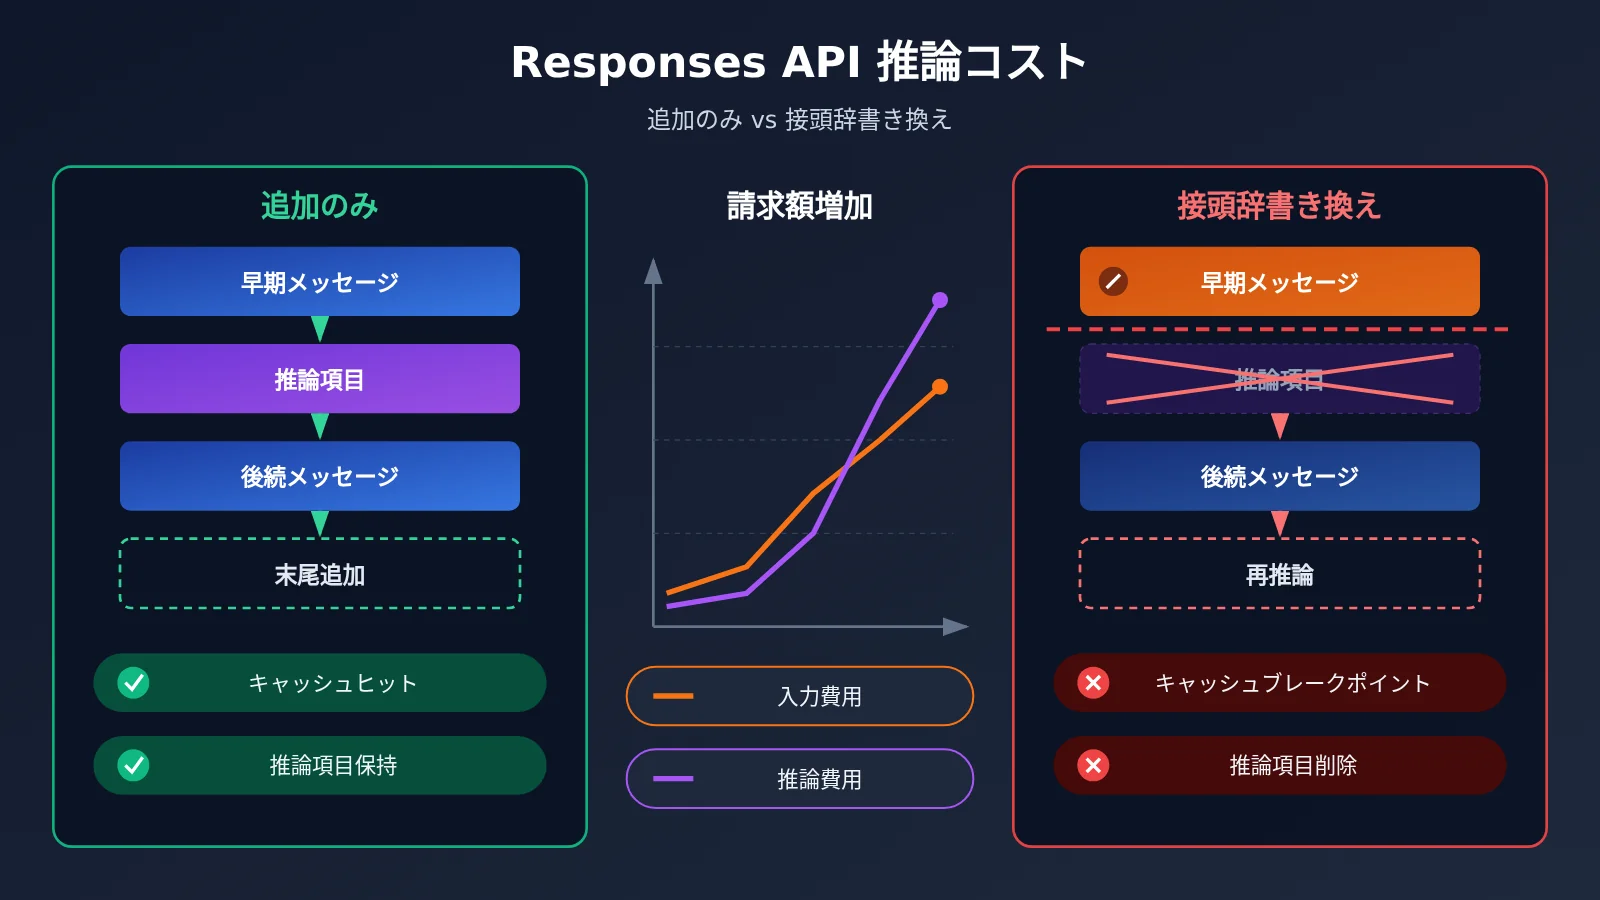
OpenAI Responses API 推論コストのナレッジマップ
以下の表は、本文全体の4つのセクションの内容と相互関係を示し、読む順序も明らかにします。第1節では費用の発生源を説明し、第2節ではどの操作が引き金になるかを示し、第3節では測定方法を提示し、第4節では測定した数値を金額に換算し、改善策を提示します。
| 番号 | 答える問い | 次の節に何を提供するか | 読後にできること |
|---|---|---|---|
| 1 | 費用はどこで増えるのか | 2つの観察軸:キャッシュ読み取り、新規出力 | usage の関連フィールドの意味を理解できる |
| 2 | どの編集操作が引き金になるか | 調査すべきコード箇所のリスト | 自分のコンテキスト維持方法にリスクがあるか判断できる |
| 3 | 変化をどう切り分けるか | 比較可能なペアデータ | 対照実験で問題の有無を確認できる |
| 4 | いくら差が出るのか、どう改善するか | コスト分解の計算式と3つの改善策 | 差額を見積もり、リクエスト ID ごとに実際の課金額を照合できる |
プレフィックスの書き換えが存在するとすでに確認できている場合は、第3節から読み始めて問題ありません。第1節と第2節は、調査時の参照資料として使えます。
To Know:Responses API 推論コストに関わる用語
| 用語 | 簡潔な説明 |
|---|---|
| Responses API | OpenAIがモデル応答・推論・ツール呼び出しを統一的に処理するためのインターフェース |
| 入力プレフィックス | 複数ターンのリクエスト冒頭で同じ順序を保つ早期の入力内容および設定 |
| キャッシュヒット | 今回のリクエストが処理済みの入力トークンを再利用する部分で、キャッシュ読み取り価格で課金される |
| 推論項目 | 推論モデルの応答に含まれる構造化項目の一種で、互換性のある後続リクエストで再利用できる |
prefix_mismatch |
GPT-6.2関連の診断における原因値の一つで、早期のプレフィックスが変更されたため推論項目が削除されたことを示す |
| 追加のみ | 元の内容と順序を保ち、末尾にのみ後続イベントを追加する履歴維持の方式 |
reasoning_tokens |
出力使用量のうちの推論サブ項目で、推論消費を観察するために使う |
x-request-id |
レスポンスヘッダー内のリクエスト識別子で、クライアント側の応答と供給側のログを関連付けるために使う |
1. Responses API の推論コストが2か所で膨らむ理由
1.1 第一の線:キャッシュ読み取りの減少
OpenAIの「Prompt caching」の説明によると、プロンプトキャッシュはリクエストの冒頭からマッチングを開始します。早期のどこかの内容が書き換えられると、変更点以降の部分はキャッシュ読み取りでは課金できなくなり、通常の入力価格で課金されます。APIYIの価格表にある gpt-6.2-sol の短いコンテキストの価格を例にすると、通常入力は100万トークンあたり2ドル、キャッシュ読み取りは0.10ドルで、両者の差は20倍です。
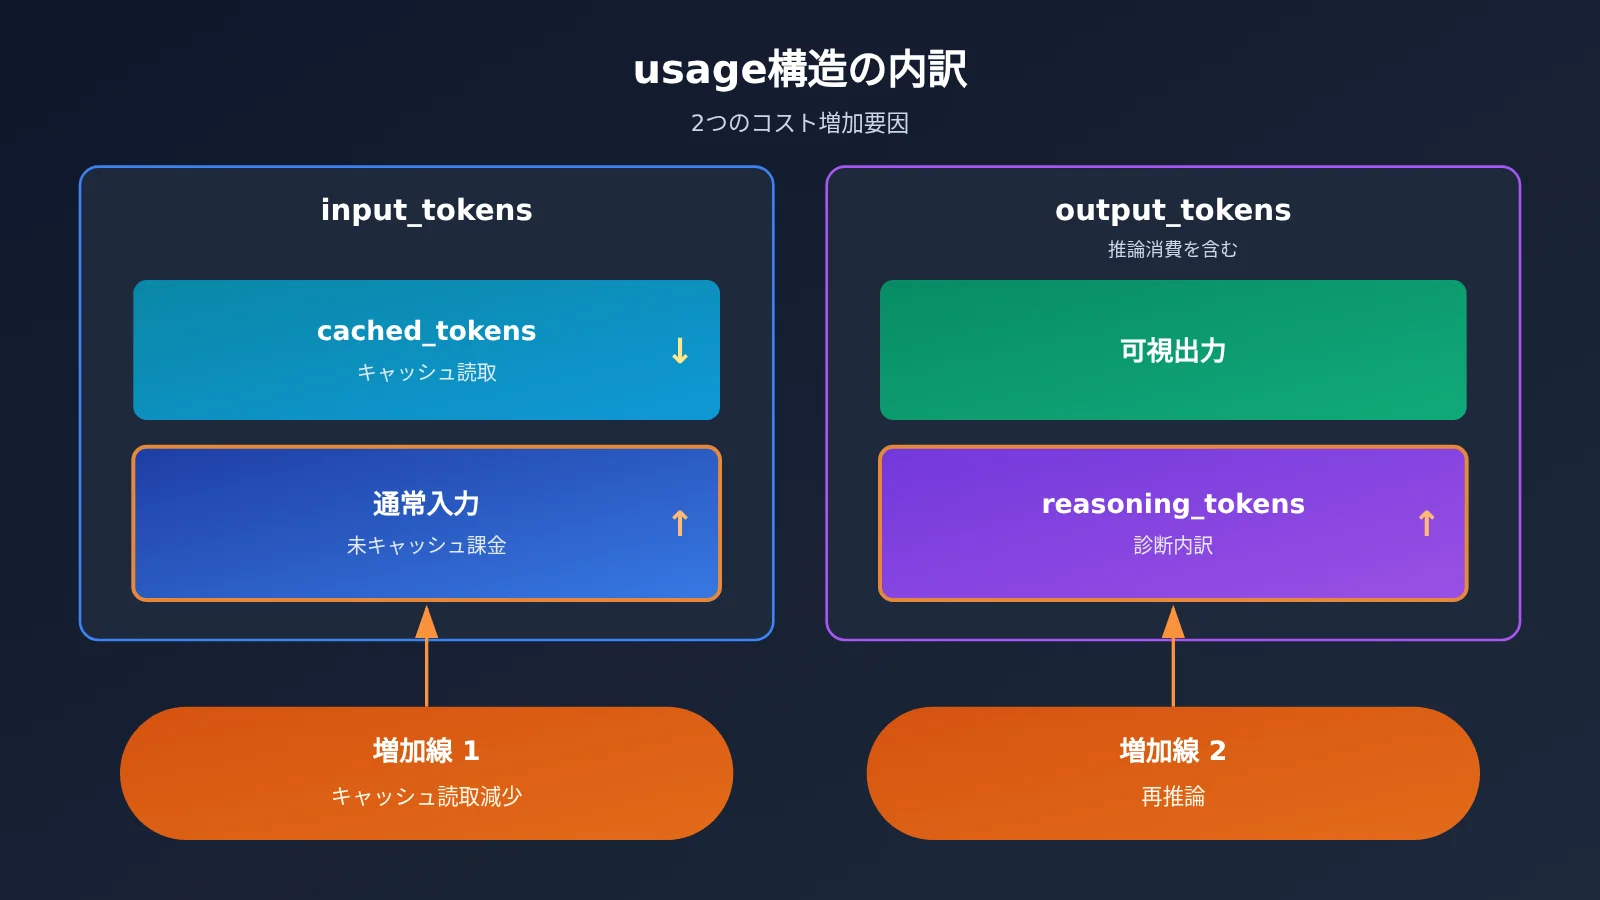
この費用変化は usage に対応するフィールドがあります。input_tokens の総量はほぼ変わらなくても、その中の cached_tokens は減少します。総入力量だけを見ていてはこの問題に気づけないため、キャッシュ読み取り量を個別に記録する必要があります。
1.2 第二の線:推論項目が再利用資格を失った後の新たな出力
OpenAIは2026-11-17のAPI Changelogで、「早期の履歴を編集すると prefix_mismatch を理由に推論項目が削除される」ことをGPT-6.2以降の動作として明記しました。推論項目が削除されると、モデルは後続のターンで以前の推論内容を見ることができず、再推論が必要になる可能性があるため、追加の推論コストが発生することがあります。
この線は出力側に反映され、reasoning_tokens や総出力の増加として現れます。キャッシュ読み取りの減少と同時に発生することもありますが、usage では2つの独立したフィールドであるため、調査時には分けて観察する必要があります。
1.3 output_tokens と reasoning_tokens の包含関係
OpenAIの「Counting tokens」によると、output_tokens はすでに推論消費を含んでおり、output_tokens_details.reasoning_tokens はその中の診断サブ項目にすぎません。費用を計算する際は、output_tokens に出力単価を掛けるだけで十分です。reasoning_tokens を別途もう一度加算すると、二重計算になります。
2. どのようなプレフィックス編集操作が推論コストの上昇を引き起こすのか
2.1 prefix_mismatch を引き起こす一般的な操作
OpenAIの「Keep the prefix unchanged」と「Reasoning models」の説明によると、以下の操作はプレフィックスの書き換えに該当し、GPT-6.2では推論項目が削除される可能性があります。
| 操作 | 典型的なコードシーン | リスク |
|---|---|---|
| 古いメッセージの書き換え | ユーザーの2ターン目の言い回しを後から修正したり、古いメッセージにタイムスタンプを付け加えたりする | プレフィックスを書き換える |
| 古いツール結果の書き換え | Tokenを節約するために、初期のツールが返したJSONを短縮する | プレフィックスを書き換える(短縮も書き換えに該当) |
| 関連する推論項目の前にコンテンツを挿入する | 新たに検索した資料を履歴の途中に挿入する | プレフィックスを書き換える |
| 項目全体を削除し、その他の内容を変えない | 古いメッセージを1件丸ごと削除する | この削除原因は発生しないが、キャッシュヒット量は変わりうる |
| 推論項目の後に追加する | 時系列に沿って新しいメッセージを追加する | この削除原因は発生しない |
「古いツール出力を短縮する」はTokenを節約しているように見えますが、それは書き換えに該当します。完全な項目を削除し、かつ残りの項目が変わらない場合にのみ、prefix_mismatch は発生しません。それでもキャッシュのマッチング開始点が変わりうるため、キャッシュ読み取り量は実際に測定する必要があります。
2.2 バージョン、ティア、モデルファミリー切り替えの違い
これらの変化は個別に判断する必要があります。
- バージョン差異:OpenAIは、
prefix_mismatchによる推論項目の削除がGPT-6.2から始まる挙動であると明確に説明しています。GPT-6.1 Solはreasoning.context: all_turnsをサポートし、互換性のある履歴が利用可能な場合に、より早い段階の推論をレンダリングできます。6.1から6.2へ移行する際は、従来のコンテキスト管理方法を再検証する必要があります。 - 推論ティア:両世代のSolはいずれも
low、medium、high、xhigh、maxの5段階を提供しますが、6.2 Solはnoneを拒否します。サードパーティの記事OrcaRouterがまとめた方法は、リクエスト間でreasoning.effortを直接変更するのではなく、inputにconfiguration_update項目を追加するというものです。同記事は同時に、この種の項目を含む履歴は自動的に切り捨てられ、/responses/compactで拒否されると指摘しています。この方法を採用する前に、OpenAI公式ドキュメントを基準にしてください。 - モデルファミリーの切り替えとダウングレード:OpenAIの説明によると、モデルファミリーの切り替えや、より能力の低いモデルへの変更も、既存の推論項目を削除する可能性があります。これは
prefix_mismatchとは異なる原因であり、統計時には別々に分類すべきです。
2.3 GPT-6.2 トップレベル instructions の位置と課金
OpenAI「Using GPT-6.2」によると、GPT-6.2のトップレベル instructions は input の後に追加され、キャッシュされていない入力として課金されます。そのため、現在のターンにおける一時的な開発者プロンプトを置くのに適しており、長期的に変わらない大規模なシステム設定を置くのには向いていません。
長期的に再利用する指示は、キャッシュされるように、最初のdeveloperメッセージとして input に置くべきです。長期的な指示を調整する場合は、履歴の末尾に新しいdeveloperメッセージを追加し、最初のメッセージを後から書き換えないでください。
3. 対照リクエストで Responses API の推論コスト変化を切り分ける
3.1 対照群の設計
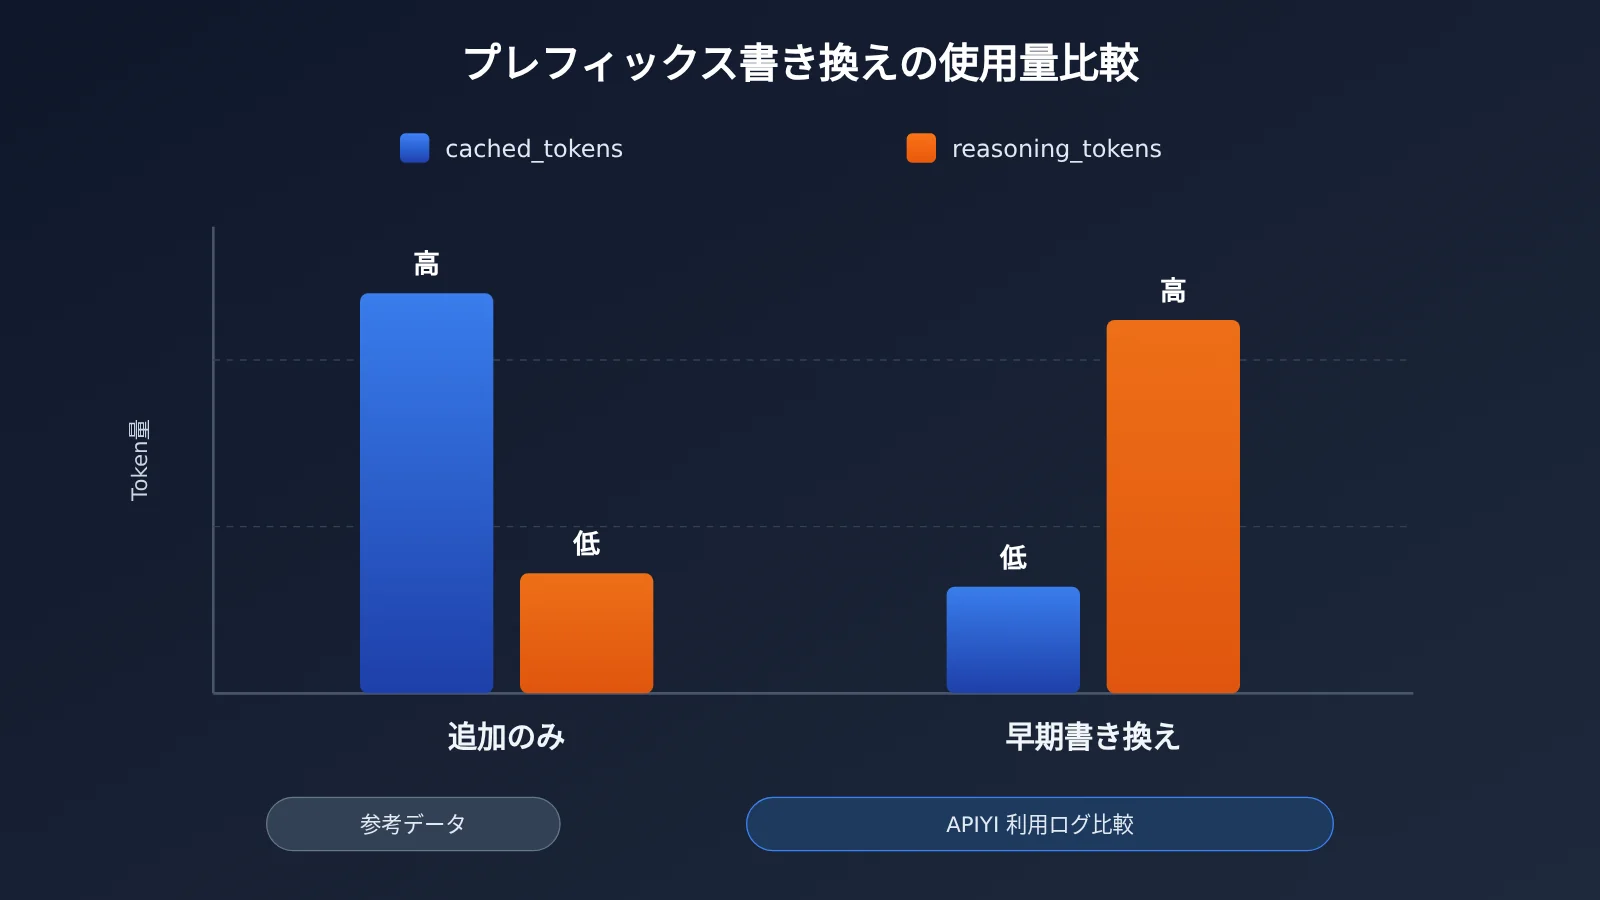
モデル、推論レベル、ツール定義、入力量を固定し、履歴の維持方法という1つの変数のみを変えます。A群は追加のみ、B群は早い段階で1箇所の内容を書き換えます。両群とも複数ラウンド実行し、同じタスクセットを使用します。
各リクエストは統一して以下の表のとおり記録します。タスク品質は人手または評価スクリプトで採点する必要があります。コスト削減を結果の悪化と引き換えにしてはならないからです。
| 項目 | 取得元 | 用途 |
|---|---|---|
| 群 | 独自定義 | 追加のみ群と書き換え群を区別 |
cached_tokens |
usage.input_tokens_details |
第1の指標を確認 |
reasoning_tokens |
usage.output_tokens_details |
第2の指標を確認 |
output_tokens |
usage |
出力コストを計算 |
| レイテンシ | クライアント側の計測 | 推論増加は通常、所要時間の増加を伴う |
| タスク品質 | 人手または評価による採点 | 品質を犠牲にしたコスト削減を排除 |
x-request-id |
レスポンスヘッダー | 照合 |
3.2 追記のみを行う呼び出し例
以下のコードは input の履歴を自前で管理し、各ターンでは末尾にのみ追記します。あわせて使用量とリクエスト ID をログに書き込みます。
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # セッション全体で固定、ターン間では変更しない

# 安定したプレフィックス:再利用可能な指示は input の先頭に置き、その後は変更しない
history = [{"role": "developer", "content": "你是代码审查助手,回答简洁。"}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # 対象グループが返送するかは事前に確認が必要
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # 追記のみ:今回の出力(推論項目を含む)をそのまま履歴の末尾に戻す
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
書き換え群では同じ関数を再利用します。N ターン目の前に history[1] の内容を変更し、variant を "early_rewrite" に設定します。その他のパラメータは変更しません。
🚀 クイックスタート:対照群を構築するときは、APIYI apiyi.com 経由で同じ APIキーを使い、
gpt-6.1-solとgpt-6.2-solを切り替えられます。同じログ構造のもとで、バージョン差異がキャッシュと推論使用量に与える影響を比較できます。
3.3 公式直連の補助診断
OpenAIに直接接続する場合、prompt_cache_options.comparison_response_id に以前のレスポンスIDを設定し、返却される診断理由とキャッシュトークン数を読み取ることができます。レスポンス内の input_transformations には、どの推論項目が削除されたかとその理由が列挙され、prefix_mismatch はIDによって旧レスポンス出力内の推論項目に対応付けることができます。
# OpenAI公式直連専用
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
この診断には2つの制限があります。キャッシュ診断はベストエフォート方式で最初の差異のみを報告し、モデルが保持された推論を実際に再利用したかどうかを確認できません。「推論項目が削除された」ことは教えてくれますが、「その結果いくら余分にコストがかかったか」は教えてくれません。費用は引き続き3.1節のペア用量と組み合わせて判断する必要があります。
3.4 APIYI経由で呼び出す際の注意事項
OpenAI直連は previous_response_id を使ってセッション状態を継続できます。APIYIのResponses APIネイティブ呼び出しガイド(docs.apiyi.com)の本文では、このチェーン方式は機能しないとされていますが、同じページのFAQには2026-09-02の実測で利用可能と記録されています。2箇所の記述が一致しないため、より安全なベースラインは、3.2節の記述と同様に input 履歴を自分で管理することです。
状態継続、暗号化された推論項目の返送、および上記の診断フィールドの実際の動作は、トークングループによって異なる可能性があるため、対象のグループで個別に検証する必要があります。診断フィールドが利用できない場合でも、ペアの用量ログは判断材料として引き続き利用できます。
4. Responses API の推論コストを数値で分解し、改修を実施する
4.1 試算に使用する料金
以下は、APIYI apiyi.com の料金一覧表にある短コンテキストのデフォルト料金です(2026-11-20 15:17 北京時間更新、単位は米ドル/100万トークン)。実際の請求額は、モデルが属するトークングループやチャージ費用によっても変わるため、それぞれ確認が必要です。
| APIYI モデル ID | 通常入力 | キャッシュ読み取り | 出力 |
|---|---|---|---|
gpt-6.2-sol、gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
長コンテキストは別途計算が必要です。gpt-6.2-sol の入力が 272,000 トークンを超える場合、APIYI の現在の一覧表に記載されている入力価格は $3 で、OpenAI 公式の Standard モデルページでは $4 と記載されています。gpt-6.1-sol の長コンテキスト入力価格は両方とも $4 です。長コンテキスト枠のキャッシュ価格と出力価格は、各チャネルのリアルタイムな課金ルールに従って確認してください。
4.2 2回のリクエストの課金内訳の計算例
前提条件:短いコンテキスト、APIYI Sol のデフォルト料金、2回のリクエストの入力はいずれも 12,000 トークン、個別計上のキャッシュ書き込みなし、ツール利用料なしとします。以下の数値はすべて仮定であり、実測データではありません。
| 項目 | プレフィックス保持 | プレフィックス書き換え |
|---|---|---|
| キャッシュ読み取り | 9,000 × $0.10/M = $0.0009 | 3,000 × $0.10/M = $0.0003 |
| 通常入力 | 3,000 × $2/M = $0.0060 | 9,000 × $2/M = $0.0180 |
| 総出力 | 1,000 × $10/M = $0.0100 | 1,600 × $10/M = $0.0160 |
| 合計 | $0.0169 | $0.0343 |
2回の差は $0.0174 で、2つの部分に分解できます。$0.0114 は 6,000 個の入力トークンがキャッシュ価格から通常入力価格に変わったことによるもので、つまり 6,000 ×($2 − $0.10)/ 1,000,000 です。$0.0060 は余分な 600 個の総出力トークンによるものです。この2つの部分は、それぞれ第1節の2本の線に対応します。実際の差額はご自身の usage に基づいて判断してください。個別計上のキャッシュ書き込みが存在する場合は、通常入力、キャッシュ読み取り、キャッシュ書き込みという3つの排他的カテゴリに分けて計算する必要があります。
4.3 リクエストIDで照合する
見積もりが終わったら、次は実際の課金を照合します。APIYI apiyi.com の消費ログで、レスポンスヘッダーの x-request-id を使って対応する type=2 の記録を探し、quota ÷ 500,000 で実際に課金されたドル額を換算します。あわせてモデル、トークングループ、呼び出しの時間帯、そしてそのリクエストの入力トークン数と出力トークン数も記録しておきましょう。
現時点では、APIYI の同一グループ・同一タスクにおけるプレフィックス対照の課金明細は公開されていません。そのため、改修効果を評価するときは、自分が取得したペアのリクエストログと課金記録を基準にしてください。
💰 照合のヒント:3.2 節のログにある
request_idと消費ログを1件ずつ紐付けて、「用量フィールド → 見積金額 → 実際の課金」という3列にまとめます。どの列にずれが生じているかを見れば、問題がどの段階にあるのかがわかります。
4.4 3つの改修
- ツール定義の固定と指示の安定化:ツール定義は元の順序を保ち、会話の途中で変更しないようにします。長期的な指示は
inputの最初の developer メッセージに置き、現在のターンだけに使う一時的なプロンプトは GPT-6.2 のトップレベルinstructionsを利用できます。ただし、これは未キャッシュの入力として課金される点を受け入れる必要があります。 - コンテキストを順序どおりに追記する:新しいメッセージ、新しいツール結果、新しい検索資料はすべて末尾に追加します。どうしても簡略化が必要な場合は、項目ごと丸ごと削除し、その中身は書き換えないようにします。
- 長いコンテキストとバージョン移行を個別にテストする:長いコンテキストは入力トークンが 272,000 を超えると別の価格帯が適用されるため、個別に対照グループを設けます。
gpt-6.1-solからgpt-6.2-solへの移行、あるいは価格帯の調整やモデルファミリーの切り替えを行う場合は、まず第 3 節の対照手法で検証してから全面展開してください。
以上の改修を終えたら、次のように効果を確認できます。同じタスクセットで2つの対照グループをもう一度実行します。追記のみのグループで cached_tokens の割合が安定しており、reasoning_tokens が異常に増えておらず、リクエストIDで照合した実際の課金が見積もりとも一致していれば、この部分のコストはすでに抑えられていると判断できます。
参考資料
- OpenAI「Keep the prefix unchanged」:プレフィックス保持と
prefix_mismatch診断- リンク:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- リンク:
- OpenAI「Reasoning models」:推論項目の再利用と、項目全体を削除する際の例外
- リンク:
developers.openai.com/api/docs/guides/reasoning
- リンク:
- OpenAI「Prompt caching」および「Counting tokens」:キャッシュマッチングのルールと使用量フィールド
- リンク:
developers.openai.com/api/docs/guides/prompt-caching
- リンク:
- OpenAI API Changelog(GPT-6.2 の項目、2026-11-17)
- リンク:
developers.openai.com/api/docs/changelog
- リンク:
- OrcaRouter「GPT-6.2 Preserved Reasoning」:サードパーティが整理した追記のみの書き換え手法
- リンク:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- リンク:
- APIYI「モデル料金一覧」
- リンク:
docs.apiyi.com/models
- リンク:
- APIYI「ログクエリ API」
- リンク:
docs.apiyi.com/api-capabilities/log-query
- リンク:
- APIYI「OpenAI Responses API ネイティブ呼び出しガイド」
- リンク:
docs.apiyi.com/api-capabilities/openai/native
- リンク:
著者:APIYI 技術チーム
技術交流:APIYI サイトのトップページからぜひお問い合わせください。詳細な資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。