Nota del autor: cuando una sesión WebRTC de GPT-Live-1.1 entra en modo de espera, el precio por minuto de voz baja de 0,05 USD a 0,02 USD. Este artículo explica cómo configurarlo, cómo verificar la facturación y cuánto se puede ahorrar realmente en una llamada.
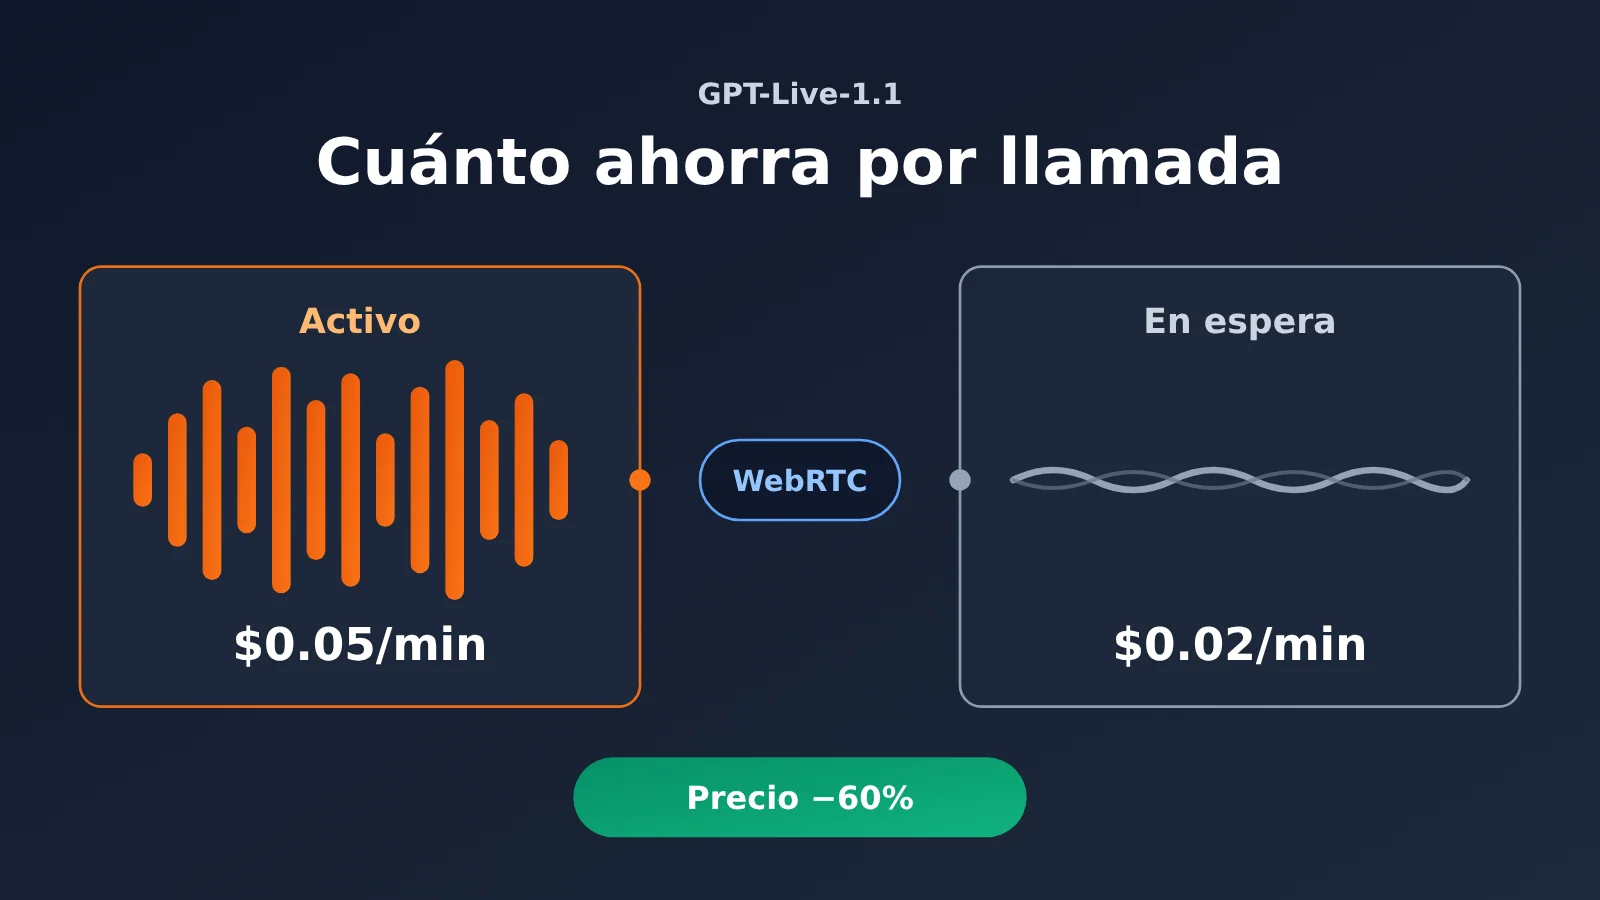
Resumen en una frase: cuando una sesión WebRTC de GPT-Live-1.1 cumple las condiciones y entra en estado de espera, el precio por minuto de voz baja de 0,05 USD a 0,02 USD. Cuánto se ahorra realmente depende de qué proporción del tiempo se pasa activo y qué proporción en espera, y también del uso del modelo backend y de las herramientas.
La conclusión tiene condiciones previas. Solo en sesiones WebRTC configuradas con modo de espera e inferencia pausada se obtiene el precio de espera de 0,02 USD por minuto. Bajo esta premisa, la proporción de ahorro equivale aproximadamente a «proporción de tiempo en espera × 60%». Si en la sesión siempre hay alguien hablando, o si se usa WebSocket o la conexión principal SIP, este descuento prácticamente no aplica. Además, la inferencia backend y las llamadas a herramientas se facturan aparte, y en llamadas largas esa parte suele salir más cara que la tarifa de voz.
Este no es un artículo breve que se limita a repetir una tabla de precios. A continuación desglosamos las condiciones de facturación y los campos de configuración según la documentación oficial de OpenAI, y presentamos un método de cálculo que permite conciliar las cuentas. Los ejemplos de escenarios que aparecen en este artículo son hipotéticos, sirven para explicar el método de cálculo y no representan facturas reales.
Términos relacionados con el standby de WebRTC en GPT-Live-1.1 (Para tener en cuenta)
Primero, unifiquemos algunos términos. Tanto la facturación como la configuración que veremos más adelante se basan en estas definiciones:
- WebRTC: conjunto de tecnologías de comunicación que permite transmitir audio y otros medios en tiempo real entre el navegador y el dispositivo. Es también el único transporte aplicable al standby nativo de GPT-Live.
- WebSocket: una conexión bidireccional persistente. La aplicación puede usarla para transmitir audio, eventos de sesión o mensajes de control por conexión lateral.
- SIP: protocolo habitual de establecimiento y control de sesiones en redes telefónicas; el acceso telefónico de GPT-Live va por esta vía.
- Standby: en este artículo se refiere específicamente al estado de facturación en el que una sesión WebRTC que cumple los requisitos mantiene la conexión, pero detiene la inferencia.
- Tiempo activo: fase que se factura con la tarifa de actividad y que puede incluir el periodo de silencio previo a que se cumplan las condiciones de pausa.
- Activación por voz: cuando el servicio detecta que alguien está hablando, inicia o reanuda la inferencia.
- Umbral de inactividad: determina cuánto tiempo sin voz debe transcurrir para que la sesión entre en standby; es configurable.
- Conexión lateral: conexión separada de la conexión de voz principal, utilizada para el control del servidor y el monitoreo de eventos; su forma habitual es un WebSocket sideband.
Puntos clave del modo standby de WebRTC en GPT-Live-1.1
| Punto clave | Descripción | Valor para el desarrollador |
|---|---|---|
| Dos tarifas diferenciadas | Activo $0.05/minuto, standby WebRTC que cumple los requisitos $0.02/minuto (OpenAI Pricing) | Precio unitario 60% menor en los períodos tranquilos |
| Facturación por segundo | Ambas tarifas se liquidan por segundo, sin redondeo a minutos completos | Las pausas breves también cuentan para el ahorro |
| Solo WebRTC | El standby económico nativo solo aplica a sesiones WebRTC configuradas con standby y con la inferencia pausada | Hay que pensar en el costo al elegir el transporte |
| El backend se cobra aparte | El uso del modelo backend y las herramientas se factura por separado | El standby optimiza solo una partida de la factura |
| Latencia de la primera respuesta | Tras despertar del standby, la primera respuesta a un audio corto puede ser más lenta | Hay que elegir entre costo y experiencia |
Entender el denominador del 60% del standby de GPT-Live-1.1 a partir de la tabla de facturación
Primero, aclaremos el criterio de las fechas. El OpenAI API Changelog registra esta actualización el 2026-11-19, mientras que la página del anuncio de lanzamiento en la comunidad de desarrolladores de OpenAI muestra 2026-11-20. La diferencia de un día probablemente se debe a distintos husos horarios; en este artículo, siempre que intervenga una fecha, indicamos la fuente. Según la página de OpenAI Pricing, la voz activa de ambos modelos GPT-Live cuesta $0.05/minuto, y el standby WebRTC que cumple los requisitos cuesta $0.02/minuto, con facturación por segundo, mientras que el uso del modelo backend y las herramientas se cobra aparte.
El «60% menos» se malinterpreta a menudo como «60% de ahorro en toda la llamada». El denominador del 60% es el precio unitario activo: (0.05 − 0.02) ÷ 0.05 = 60%, que solo describe la reducción del precio unitario por minuto al entrar en standby. El porcentaje de ahorro de toda la llamada hay que multiplicarlo además por la proporción de tiempo en standby.
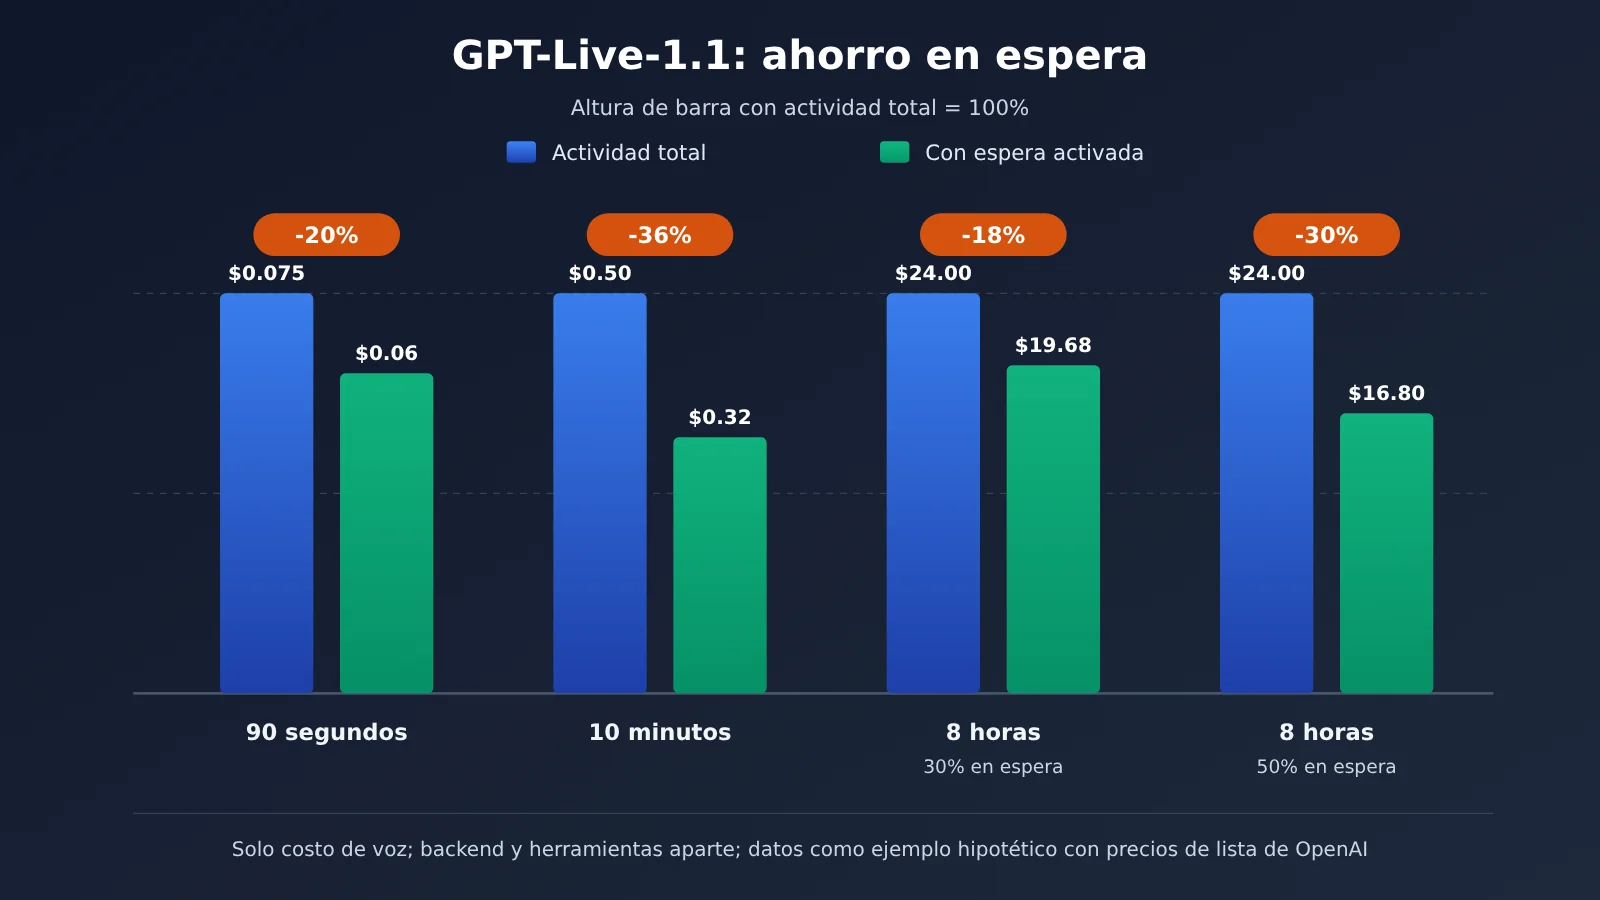
Pongamos un ejemplo hipotético. En una sesión de 10 minutos, con 4 minutos activos y 6 minutos en standby dentro del tiempo facturable, el costo de voz es 4×0.05 + 6×0.02 = $0.32. Los mismos 10 minutos totalmente activos serían $0.50. Comparando ambos, el costo de voz baja un 36%, que equivale exactamente a 60% × 60% de la proporción de standby.
| Concepto facturado | Precio unitario (tarifa oficial de OpenAI) | Granularidad de facturación | ¿Lo afecta el standby? |
|---|---|---|---|
| Voz activa | $0.05/minuto | Por segundo | Sí, parcialmente sustituida por el standby |
| Voz en standby WebRTC | $0.02/minuto | Por segundo | Solo WebRTC que cumple los requisitos |
| Tokens del modelo backend | Según la tarifa del modelo elegido | Por token | No |
| Llamadas a herramientas | Según la tarifa de la herramienta | Por llamada o por volumen | No |
Cómo configurar el modo de espera WebRTC de GPT-Live-1.1: desde la configuración de sesión hasta la conciliación de facturación
Según el documento «Managing GPT-Live sessions» de OpenAI, los elementos de configuración del modo de espera WebRTC no son muchos, pero cada uno influye directamente en cómo se dividen las fases de facturación.
| Campo / evento | Valor o significado | Puntos clave de configuración |
|---|---|---|
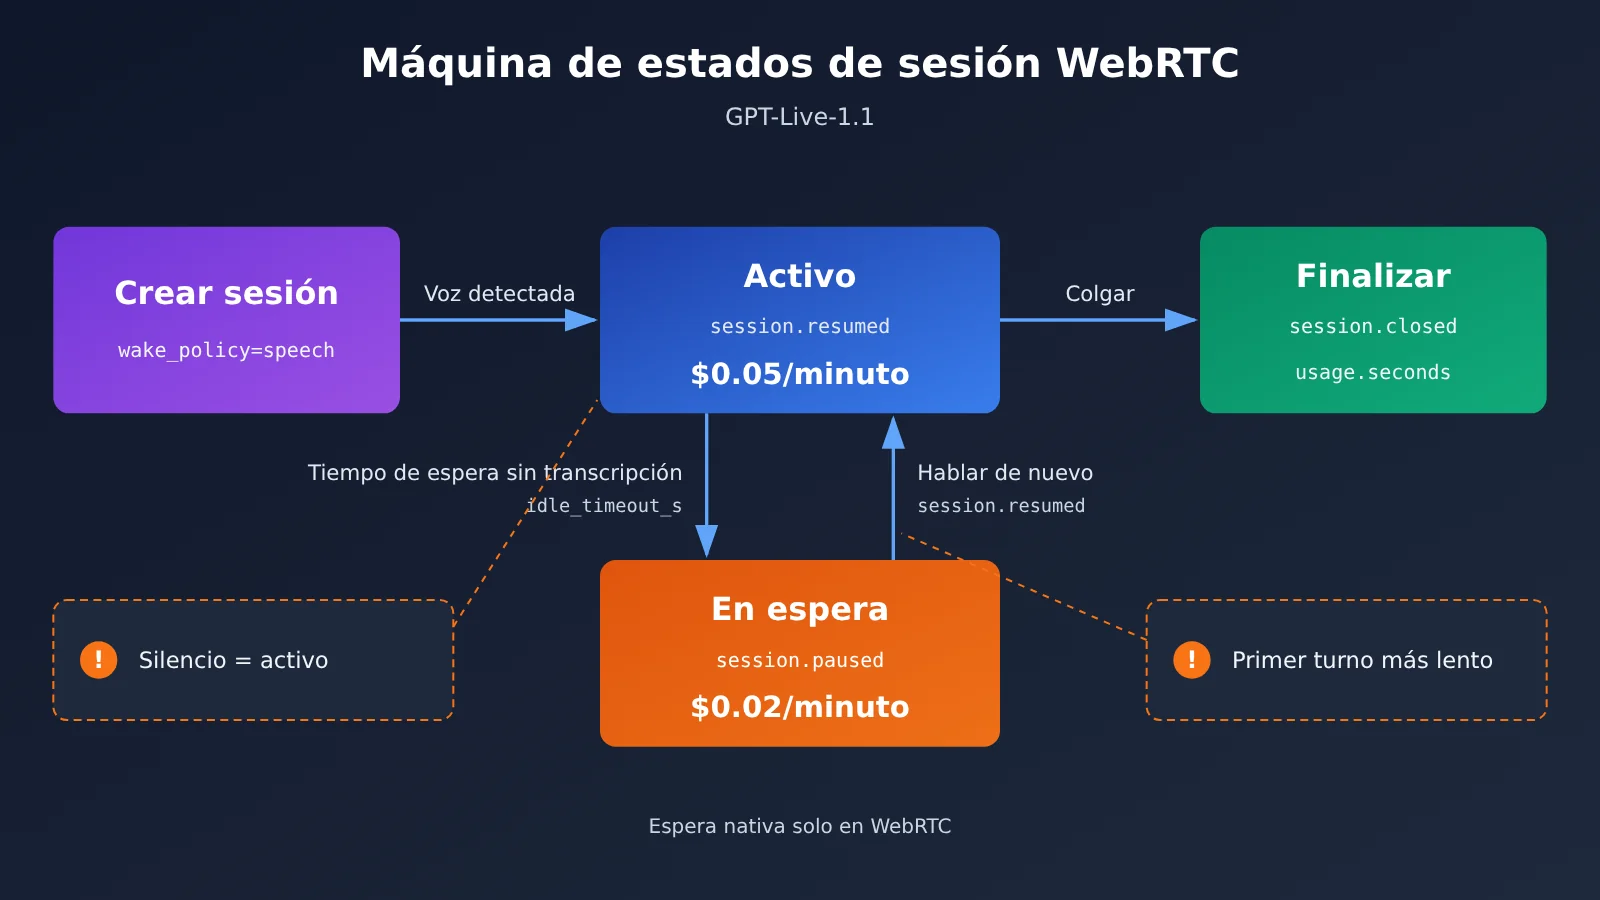
session.wake_policy.type |
Se establece en "speech" |
La sesión solo empieza a inferir cuando detecta voz; no infiere nada más conectarse |
session.idle_timeout_s |
Entero de 5 a 60 (segundos) | Si no se establece, tras el primer despertar la inferencia permanece activa todo el tiempo |
session.wake_policy.vad_threshold |
0–1, valor predeterminado 0.5 (resumen del documento por parte de OrcaRouter, un tercero) | Súbelo cuando el entorno sea ruidoso y se produzcan falsos despertares frecuentes |
session.paused |
La inferencia se pausa tras el tiempo de espera de inactividad | Se registra como inicio del modo de espera |
session.resumed |
La inferencia está lista para reanudarse; también se activa con el primer despertar | Se registra como inicio del estado activo |
session.closed |
Fin de la sesión; incluye el usage.seconds final |
Se usa para contrastar con la factura |
Los 4 pasos para configurar el modo de espera de GPT-Live-1.1
- Activar el despertar por voz al crear la sesión WebRTC: establezca
session.wake_policy.type = "speech". - Definir el umbral de inactividad:
session.idle_timeout_sdebe ser un entero entre 5 y 60. Cuanto más corto sea el umbral, antes se entra en modo de espera, pero si el usuario hace una pausa algo más larga puede provocar una pausa. - Mantener activa la pista de micrófono: durante el modo de espera, la pista de micrófono debe seguir activa para que el servicio pueda detectar voz y despertar. La conexión y el ID de sesión se mantienen sin cambios, y al reanudarse se conserva el historial de la conversación.
- Escuchar eventos y registrar marcas de tiempo: utilice
session.pausedysession.resumedpara determinar en qué fase se encuentra el servidor.
A continuación se muestra un fragmento ilustrativo de la configuración de sesión. Las rutas de los campos provienen de la documentación oficial; para la estructura completa de la solicitud, consulte «Create session» de OpenAI:
{
  "session": {
    "wake_policy": {
      "type": "speech",
      "vad_threshold": 0.5
    },
    "idle_timeout_s": 15
  }
}
Qué tiempos de silencio se siguen facturando a precio de actividad
Hay tres tipos de «silencio» que se prestan especialmente a errores de cálculo:
- El periodo de silencio antes del timeout: desde que termina la última frase hasta que vence
idle_timeout_s, la sesión se sigue facturando como activa. Con un umbral de 30 segundos, cada pausa implica como mínimo 30 segundos cobrados a precio de actividad. - Micrófono silenciado: aunque el usuario pulse mute en el cliente, la sesión no pasa por eso a standby; sigue activa.
- Espera de la respuesta del backend: el tiempo en que la inferencia no está en pausa y se espera el resultado del modelo o de una herramienta del backend también se liquida como fase activa.
A eso se suma un coste de inicialización. Según la recopilación que OrcaRouter hace de la documentación oficial, al crear una sesión WebRTC con POST /v1/live/sessions se cobran primero 15 segundos de duración de voz, y cuando la sesión empieza a funcionar esos segundos se descuentan del coste de duración. Para aplicaciones que crean sesiones de prueba con frecuencia, es un coste real; a efectos prácticos, la referencia es OpenAI Pricing.
Cuadrar las cuentas con la hora de los eventos
La idea para cuadrar las cuentas es esta: estimar la duración de cada fase a partir de las marcas de tiempo de los eventos y luego comparar el usage.seconds final de session.closed con la factura real. Abajo tienes un ejemplo de registrador de eventos. El canal por el que llegan los eventos (el canal de datos WebRTC o la conexión lateral) es algo que confirma la documentación oficial:
const timeline = [];
function onServerEvent(evt) {
  if (["session.resumed", "session.paused", "session.closed"].includes(evt.type)) {
    timeline.push({ type: evt.type, t: Date.now() / 1000 });
  }
  if (evt.type === "session.closed") {
    console.log("usage.seconds =", evt.usage?.seconds, timeline);
  }
}
Al hacer pruebas, conviene ejecutar por separado el mismo guion, el mismo backend y la misma grabación, una vez con el standby activado y otra con el standby desactivado, y registrar además el momento en que vuelve el primer fragmento de audio, para cuantificar el coste de latencia del primer turno después del despertar.
Y queda una advertencia a nivel de flujo de trabajo. CellCog publicó una tanda de experimentos comparativos con la misma configuración: primero 560 llamadas de reunión guionizadas y luego 120 llamadas de repetición. El guion original hacía la primera pregunta pronto; la versión antigua derivaba 134 de 160 preguntas al backend, y la 1.1 derivaba 91, aproximadamente 84% frente a 57%. En la repetición, con la primera pregunta situada después del segundo 10, ambas versiones quedaron en 48/60 (80%). Esto no refleja más que el comportamiento de delegación de un único equipo, en reuniones cortas y con un prompt concreto, y no midió el coste del standby, pero deja claro una cosa: el número de derivaciones al backend cambia según el guion, mientras que el coste del backend no se ve afectado por el standby.
Límites de implementación del modo de espera de GPT-Live-1.1 en WebSocket y SIP
OpenAI admite tres tipos de conexión Live: WebRTC, WebSocket y SIP telefónico, pero el modo de espera nativo de bajo costo solo se aplica a WebRTC. Hay que distinguir una cosa: una sesión WebRTC o SIP puede llevar además un WebSocket auxiliar para control y monitoreo, lo cual es distinto de «usar WebSocket para transportar el audio principal». Aunque la conexión principal WebRTC incluya un WebSocket auxiliar, sigue pudiendo usar el modo de espera.
| Transporte del audio principal | Modo de espera nativo $0.02 | Gestión de inactividad recomendada por OpenAI | Puntos de atención sobre costos |
|---|---|---|---|
| WebRTC | ✅ Se aplica si se cumplen las condiciones | wake_policy + idle_timeout_s | El período de silencio antes del timeout se factura como activo |
| WebRTC + WebSocket auxiliar | ✅ Se aplica a la conexión principal | El canal auxiliar solo se encarga de control y eventos | El canal auxiliar en sí no cambia la fase de facturación |
| WebSocket principal | ❌ No hay evidencia | La aplicación detecta la inactividad, cierra y reconstruye | Reconstruir la sesión tiene costos de inicialización |
| SIP telefónico | ❌ No hay evidencia | Primero confirma el impacto de cerrar la sesión en las llamadas entrantes | Mientras se mantiene la llamada, se presupuesta como activo |
Cómo funciona con WebSocket principal: gestiona el estado de inactividad en la aplicación, siguiendo la entrada y salida de audio, el estado de reproducción y las tareas pendientes del backend. Solo cuando haya un silencio prolongado y se permita desconectar, llama a session.close y espera session.closed. Cuando el usuario vuelva, se reconstruye la sesión; se puede hacer fork de la sesión anterior si se permite guardarla y su registro ya está completo, o restaurar el contexto desde el estado de texto que guardó la propia aplicación. Si está habilitada la activación por voz local, primero hay que almacenar en caché el audio inicial para no perder palabras durante el establecimiento de la conexión.
Cómo funciona con SIP: cerrar la sesión puede afectar a la propia conexión de la llamada entrante, por lo que «colgar y volver a conectar» no puede considerarse un modo de espera in situ. Si la llamada telefónica debe mantenerse, la aplicación o el sistema telefónico deben gestionar el flujo de espera, y los costos de voz activa de OpenAI deben incluirse en el presupuesto. Otra opción es crear un puente de medios propio y usar y validar realmente el modo de espera WebRTC en el lado de OpenAI. Todo esto forma parte de los límites de implementación en la capa de transporte y del estado de sesión; no hay ninguna evidencia de que los transportes que no son WebRTC también puedan disfrutar del precio de modo de espera de $0.02.
¿Cuánto se ahorra en una llamada completa? Guía rápida de costes en espera de GPT-Live-1.1
Cálculo de costes simplificado
La siguiente función convierte «ahorro proporcional = proporción en espera × 60%» en código, con las entradas en segundos:
ACTIVE, STANDBY = 0.05, 0.02  # Precio oficial de OpenAI, USD/minuto

def voice_cost(active_s: float, standby_s: float) -> tuple[float, float]:
    with_standby = active_s / 60 * ACTIVE + standby_s / 60 * STANDBY
    all_active = (active_s + standby_s) / 60 * ACTIVE
    return round(with_standby, 4), round(1 - with_standby / all_active, 4)

print(voice_cost(240, 360))      # 10 minutos: 4 minutos activos + 6 minutos en espera
print(voice_cost(60, 30))        # 90 segundos: 60 segundos activos + 30 segundos en espera
| Escenario supuesto | Activo / En espera | Tarifa de voz con espera | Tarifa de voz totalmente activa | Reducción de la tarifa de voz |
|---|---|---|---|---|
| Ejemplo oficial (según OrcaRouter) | 60 s / 30 s | $0.06 | $0.075 | 20% |
| Consulta de 10 minutos (supuesto de este artículo) | 4 min / 6 min | $0.32 | $0.50 | 36% |
| Guardia de 8 horas, 30% en espera (cálculo de OrcaRouter) | 5.6 h / 2.4 h | $19.68 | $24.00 | 18% |
| Guardia de 8 horas, 50% en espera (cálculo de OrcaRouter) | 4 h / 4 h | $16.80 | $24.00 | 30% |
La tabla solo contabiliza las tarifas de voz. En un despliegue real, los costes del modelo backend y de las herramientas suelen ser una partida mayor de la factura. El texto de OrcaRouter menciona que la documentación de OpenAI recomienda empezar con gpt-6-luna y cambiar a gpt-6-sol para tareas backend complejas; ambos se facturan según las tarifas estándar por token. En llamadas largas, los costes de backend bien pueden superar las tarifas de voz.
💡 Consejo de cálculo: Las cifras de la tabla son suposiciones calculadas con los precios oficiales; para la factura real, guíate por
usage.secondsy por la facturación de la plataforma. Si también estás evaluando otras soluciones de voz en tiempo real, puedes usar los créditos de prueba gratuitos de APIYI apiyi.com y comparar, con el mismo guion, los modelos Realtime facturados por token.
Elegir por separado la capa de voz de GPT-Live-1.1, el modelo backend y el punto de entrada API
A la fecha de consulta (2026-11-20), tanto la interfaz de sesión dedicada como las tarifas por minuto de GPT-Live-1.1 provienen de OpenAI oficial. Según la recopilación de terceros de OrcaRouter, GPT-Live solo puede conectarse a través del endpoint de Live sessions, y no admite otros endpoints como Chat Completions, Responses o Realtime.
En cuanto a APIYI, el registro público de modelos (generado el 2026-11-20 a las 15:17, UTC+8, con un total de 289 registros) no incluye gpt-live-1 ni gpt-live-1.1, y el archivo dinámico tampoco contiene el anuncio de lanzamiento correspondiente. Por lo tanto, por ahora no se puede considerar que APIYI ya ofrece la serie GPT-Live, /v1/live/sessions ni facturación por minuto. Tampoco se puede inferir que, por el hecho de que APIYI sea compatible con la interfaz de OpenAI, admita este tipo de sesiones de voz dedicadas.
Las opciones de voz en tiempo real que APIYI ya ha publicado constituyen un producto Realtime independiente:
| Solución | Método de acceso | Método de facturación | Standby / WebRTC / SIP | Plataforma disponible |
|---|---|---|---|---|
| GPT-Live-1.1 | /v1/live/sessions, WebRTC / WebSocket / SIP |
Activo $0.05, standby $0.02 por minuto, backend facturado aparte | WebRTC admite standby nativo | OpenAI oficial |
| gpt-realtime-2.1 | /v1/realtime WebSocket |
Entrada/salida de audio $32/$64 por millón de tokens de audio | WebRTC y SIP no disponibles | APIYI apiyi.com |
| gpt-realtime-2.1-mini | /v1/realtime WebSocket |
Entrada/salida de audio $10/$20 por millón de tokens de audio | WebRTC y SIP no disponibles | APIYI |
Los precios de Realtime de APIYI provienen de su documentación (la página indica conciliación al 2026-09-14); las dimensiones de facturación son tokens de texto, audio e imagen, y no se pueden convertir directamente con la facturación por minuto de GPT-Live.
APIYI Realtime: ejemplo de conexión minimalista
import os, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1"

async def main():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        print(await ws.recv())  # Imprime el primer evento del servidor

asyncio.run(main())
Ver código completo: cierre por inactividad del lado de la aplicación en el WebSocket principal
import os, time, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # Entrada Realtime de APIYI
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1-mini"
IDLE_LIMIT_S = 45          # Umbral de inactividad del lado de la aplicación, ajustable según el negocio
pending_backend_tasks = 0  # Mantenido por la aplicación: número de tareas pendientes del backend
is_playing = False         # Mantenido por la aplicación: si se está reproduciendo audio

async def run_session():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    last_activity = time.monotonic()
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        async def reader():
            nonlocal last_activity
            async for _ in ws:
                last_activity = time.monotonic()  # Cualquier evento del servidor se considera actividad

        task = asyncio.create_task(reader())
        while True:
            await asyncio.sleep(1)
            idle = time.monotonic() - last_activity
            busy = pending_backend_tasks > 0 or is_playing
            if idle > IDLE_LIMIT_S and not busy:
                print(f"空闲 {idle:.0f}s,主动关闭,用户回来后再重建")
                await ws.close()
                break
        task.cancel()

asyncio.run(run_session())
Los formatos de eventos y los parámetros de consulta se basan en la documentación de APIYI «Realtime: voz en tiempo real (WebSocket)». Esta forma de cerrar y volver a crear la conexión solo elimina conexiones inactivas en la capa de aplicación; no corresponde a ninguna tarifa oficial de espera a bajo costo.
🚀 Sugerencia de integración: para escenarios WebRTC que requieren el modo de espera nativo de GPT-Live, por ahora conecta directamente a OpenAI. Si necesitas montar rápidamente un prototipo de voz en tiempo real con WebSocket y gestionar varios modelos de forma unificada, primero puedes probar el flujo con
gpt-realtime-2.1-minien APIYI apiyi.com y luego decidir la solución definitiva según el costo.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es el modo en espera de WebRTC de GPT-Live-1.1?
Es un estado de facturación de las sesiones WebRTC: una vez configurados el despertar por voz y el umbral de inactividad, la sesión deja de hacer inferencia durante los periodos sin voz, pero la conexión se mantiene y se factura a $0.02/minuto. Cuando alguien vuelve a hablar, la inferencia se reanuda con el historial de conversación anterior.
Q2: ¿Una bajada del 60% significa que toda la llamada cuesta un 60% menos?
No. El 60% es la reducción del precio unitario en espera respecto al precio unitario activo. La reducción del coste de voz de toda la llamada equivale a la proporción en espera multiplicada por 60%: si la espera ocupa la mitad del tiempo, el coste de voz se ahorra alrededor del 30%. Los costes de backend y de herramientas no se ven afectados.
Q3: ¿Cuándo llegó GPT-Live-1.1 a la API?
La entrada del OpenAI API Changelog está fechada el 2026-11-19, mientras que la página de anuncios de la comunidad de desarrolladores de OpenAI muestra 2026-11-20; la diferencia puede deberse al criterio de zona horaria. GPT-Live-1 ya estaba disponible oficialmente antes, el 2026-09-10 (según el resumen de OrcaRouter).
Q4: ¿En qué escenarios conviene más activar el modo en espera?
– **Colas de atención al cliente**: el cliente permanece en línea pero no habla durante periodos largos.
– **Asistentes de coche o de escritorio**: conexión permanente, activación ocasional.
– **Puestos de guardia prolongada**: cuanto mayor la proporción en espera, mayor el ahorro.
En sesiones cortas y con mucha conversación, la proporción en espera es baja y además hay que asumir el coste del primer turno más lento tras el despertar, así que el beneficio es limitado.
Q5: ¿Se puede invocar GPT-Live-1.1 a través de APIYI?
A fecha de 2026-11-20, el registro público de modelos de APIYI no incluye la familia GPT-Live, ni existe anuncio de lanzamiento. Si necesitas voz en tiempo real, puedes usar `gpt-realtime-2.1` / `gpt-realtime-2.1-mini`, ya publicados en APIYI apiyi.com, conectándote mediante WebSocket a `/v1/realtime` y pagando por tokens de audio. Los nuevos usuarios tienen cuota de prueba gratuita para validarlo primero.
Q6: ¿Qué limitaciones conocidas tiene el modo en espera de GPT-Live-1.1?
– Solo aplica a WebRTC; las conexiones principales WebSocket y SIP no tienen base para los $0.02.
– El periodo de silencio antes del timeout, el micrófono silenciado y el tiempo de espera del backend se facturan como activos.
– Tras el despertar, la primera respuesta a un audio breve puede ser más lenta.
– Por ahora faltan datos de terceros sobre el despertar en espera y la conciliación de facturas; las puntuaciones de la clasificación de Artificial Analysis corresponden solo a GPT-Live-1 y no pueden extrapolarse a la 1.1.
Puntos clave del modo de espera WebRTC de GPT-Live-1.1
- Precio unitario: activo a $0.05/minuto y WebRTC en modo de espera que cumple los requisitos a $0.02/minuto; ambos se facturan por segundo.
- Cálculo: la reducción del costo de voz de toda la llamada equivale a la proporción de tiempo en espera multiplicada por 60%, no a un 60% fijo.
- Configuración:
wake_policy.type="speech"más unidle_timeout_sde 5–60 segundos, manteniendo activa la pista de micrófono. - Conciliación: usa las marcas de tiempo paused/resumed para estimar la duración de cada fase y luego compara
usage.secondscon la factura. - Límites: WebSocket y SIP solo se pueden volver a crear después de cerrarlos desde el lado de la aplicación; no cuentan como modo de espera de bajo costo.
- Acceso: GPT-Live requiere conexión directa con OpenAI; la voz en tiempo real por WebSocket se puede probar con el modelo Realtime en APIYI apiyi.com.
Resumen
Puntos clave del modo de espera WebRTC de GPT-Live-1.1:
- La reducción de precio tiene condiciones: solo las sesiones WebRTC que tienen configurado el modo de espera y la inferencia pausada se facturan a $0.02/minuto.
- El ahorro depende de la proporción: de 10 minutos, 6 en espera, el costo de voz baja de $0.50 a $0.32, un ahorro de aproximadamente 36%.
- La factura se mira en conjunto: el modelo backend y las herramientas se facturan por separado; el modo de espera solo optimiza uno de esos componentes.
Se recomienda hacer primero una prueba A/B con el mismo guion, activando y desactivando el modo de espera, registrando los tiempos de los eventos y la latencia de la primera ronda, y luego decidir el umbral de inactividad. Si todavía estás comparando diferentes soluciones de voz en tiempo real, te recomendamos probar primero el prototipo de Realtime a través de APIYI apiyi.com y comparar costos y experiencia con la cuota gratuita.
📚 Referencias
-
OpenAI API Pricing: tarifas de GPT-Live en actividad y en espera
- Enlace:
developers.openai.com/api/docs/pricing - Descripción: origen oficial de las tarifas de $0.05 y $0.02
- Enlace:
-
OpenAI Managing GPT-Live sessions: configuración en espera y descripción de eventos
- Enlace:
developers.openai.com/api/docs/guides/live-conversations - Descripción: wake_policy, idle_timeout_s y límites de transporte
- Enlace:
-
OpenAI API Changelog: entrada de actualización de GPT-Live-1.1
- Enlace:
developers.openai.com/api/docs/changelog - Descripción: fecha de la entrada 2026-11-19
- Enlace:
-
Prueba comparativa de CellCog: GPT-Live-1.1 vs GPT-Live-1
- Enlace:
cellcog.ai/blog/gpt-live-1-1-vs-gpt-live-1/ - Descripción: datos de delegación de 680 llamadas de reunión con guion, sin costes en espera
- Enlace:
-
Interpretación del lanzamiento por OrcaRouter: análisis de facturación en espera de GPT-Live-1.1
- Enlace:
orcarouter.ai/blog/gpt-live-1-1-api-release-standby-pricing - Descripción: transcripción de los ejemplos de cálculo oficiales y estimación para un turno de 8 horas
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: pueden contactarnos desde la página de inicio de APIYI; para los detalles de la integración de Realtime, consulten el centro de documentación docs.apiyi.com