Nota do autor: No DeepSeek Harness, com o nível de raciocínio definido como Max, como escolher entre o V4.1-Flash e o V4-Pro? Neste artigo, comparamos inteligência, preço e velocidade e explicamos por que o Flash é a escolha padrão para programar — e em quais situações vale a pena mudar para o Pro.
Ao abrir o seletor de modelos do DeepSeek Harness, você vai encontrar duas opções: DeepSeek-V4.1-Flash e DeepSeek-V4-Pro. Pelo senso comum, o modelo com “Pro” no nome e mais parâmetros deveria ser mais inteligente. Mas, com o nível de raciocínio no Max, muitos desenvolvedores querem saber: qual deles é melhor para programar? E qual é a diferença de preço e velocidade?
Esta não é uma análise conciliatória do tipo “cada um tem seus pontos fortes”. Conferimos a página oficial de preços da DeepSeek, o changelog, os resultados oficiais e testes independentes. A conclusão é clara: para programar no DeepSeek Harness, escolha o Flash por padrão; o Pro funciona melhor como modelo auxiliar para consultar conhecimentos, verificar fatos e ler documentos longos.
O que você vai aprender: ao final deste artigo, você saberá a qual versão correspondem o Pro e o Flash no DeepSeek Harness, qual deles tem melhor capacidade de programação com o raciocínio no Max, quanto diferem em custo e velocidade e como alternar entre eles conforme a tarefa.
Quais são as versões do Pro e do Flash no DeepSeek Harness
Antes de discutir “qual é mais inteligente”, vale entender a qual checkpoint cada um dos dois itens da lista do DeepSeek Harness corresponde. Muita gente ainda associa o Pro às versões iniciais, mas o nome do modelo nem sempre é atualizado junto com a versão real.
| Exibição na lista do Harness | ID da API | Checkpoint real | Status de lançamento |
|---|---|---|---|
| DeepSeek-V4.1-Flash | deepseek-flash |
V4.1-Flash-1017 (atualização de 17 de outubro) | Principal opção atual, otimizada especialmente para o Harness |
| DeepSeek-V4-Pro | deepseek-v4-pro |
V4-Pro-0813 (GA de 13 de agosto) | Continua disponível, com foco mais voltado à transição |
O DeepSeek V4 Pro será descontinuado?
Há tempos circula na comunidade o rumor de que o Pro seria descontinuado, e ele tem uma origem. Quando o V4.1 Flash foi lançado, em 10 de setembro, a comunicação oficial realmente dizia que o serviço do V4 Pro seria encerrado após 14 de setembro. No entanto, o mesmo registro de atualizações logo esclareceu que, a pedido de muitos usuários, o serviço de API do DeepSeek V4 Pro continuaria disponível após 14 de setembro de 2026, sem mudanças na cobrança.
Portanto, o Pro ainda pode ser usado normalmente, mas agora está posicionado como um produto de transição. O V4.1 Pro ainda não foi lançado oficialmente. No fim de outubro, houve apenas uma especulação sobre uma mudança na identificação do modelo no site oficial. Além disso, as avaliações negativas sobre o Pro no início se referiam principalmente ao problema de overfitting da versão de prévia do V4-Pro. A versão GA de agosto melhorou bastante, mas, no geral, ainda não superou o Flash em capacidade de programação.
Diferença de tamanho entre os parâmetros do DeepSeek Pro e do Flash
Os dois modelos têm tamanhos bem diferentes, e esse é um dos motivos pelos quais muita gente presume que o Pro é mais forte:
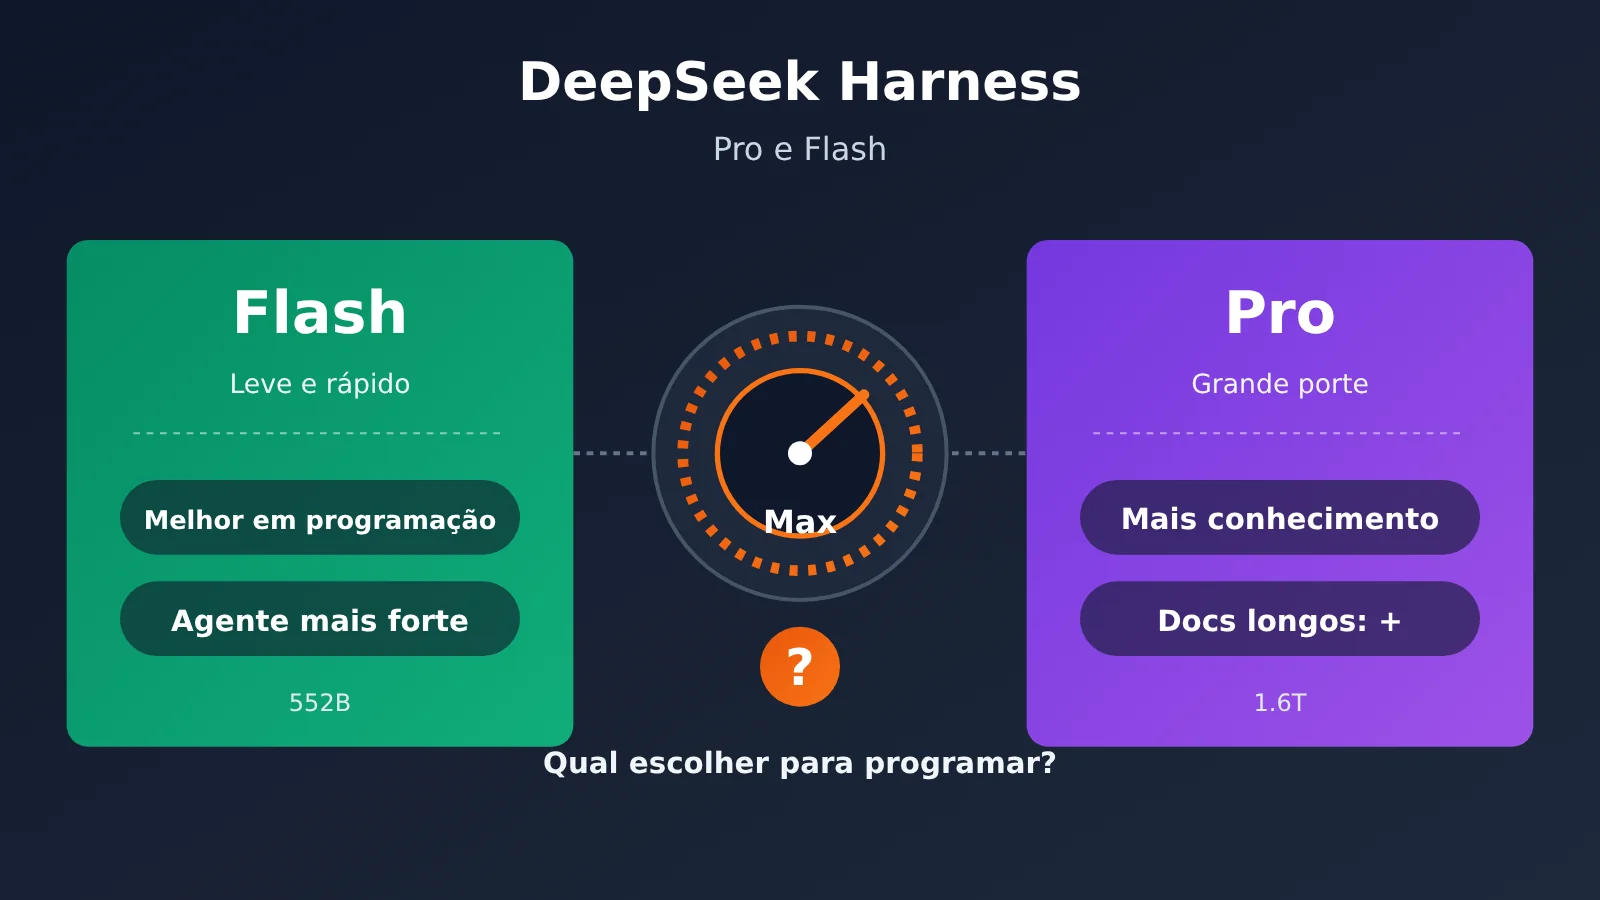
- Flash: arquitetura MoE com 552B de parâmetros totais, cerca de 8B de parâmetros ativados na entrada e 16B na saída; oferece suporte a uma janela de contexto de 1M
- Pro: 1,6T de parâmetros totais, com cerca de 49B ativados
O V4.1 Flash pertence a uma nova família de arquiteturas (CSA+HCA) e é o menor modelo dessa família. Ele não foi destilado do Pro: graças à nova arquitetura e a um pós-treinamento mais completo, alcançou e superou o Pro em tarefas de programação e de Agent. Mais parâmetros não significam mais capacidade de programar — essa é a premissa por trás de todas as conclusões a seguir.
Principais diferenças entre DeepSeek Pro e Flash: qual é mais inteligente para programar?
A inteligência é o fator mais importante na hora de escolher um modelo — e também aquele que mais facilmente pode ser distorcido pelo tamanho dos parâmetros. Veja a comparação dos resultados dos dois modelos em benchmarks oficiais e públicos:
| Benchmark | Capacidade avaliada | V4.1-Flash-1017 | V4-Pro-0813 | Vencedor |
|---|---|---|---|---|
| DeepSWE v1.1 | Engenharia de software em repositórios reais | 77.0 | 62.7 | Flash (+14.3) |
| AutomationBench | Automação e fluxos de trabalho de agentes | 60.5 | 31.8 (43.2 em outra medição) | Flash, com ampla vantagem |
| Terminal-Bench 2.1 | Uso de terminal e ferramentas | 90.6 | 87.9 | Flash |
| Codeforces | Competições de algoritmos | 3471 | 3348 | Flash |
| HLE (somente texto) | Raciocínio abrangente de alta dificuldade | 44.0 | 42.7 | Flash, por pouco |
| GPQA Diamond | Perguntas científicas de nível de pós-graduação | 90.9 | 92.4 | Pro |
| SimpleQA-Verified | Recuperação de fatos e taxa de alucinação | 42.3 | 55.2 | Pro (+12.9) |
| LongBench-V2 | Compreensão de documentos longos | 45.2 | 51.5 | Pro |
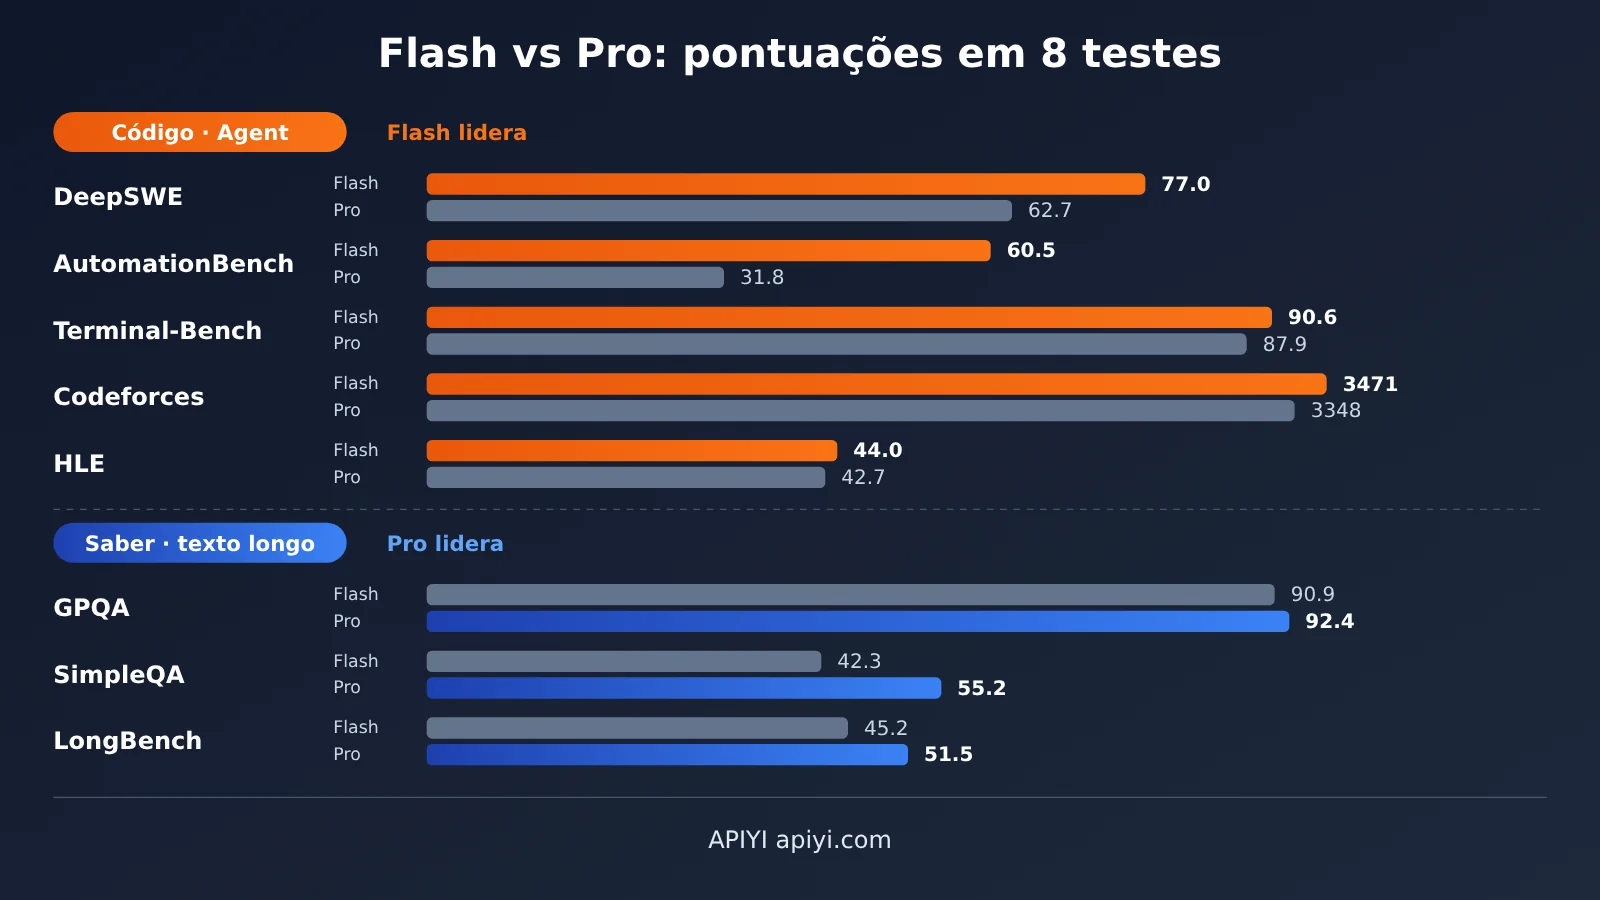
DeepSeek Flash leva vantagem em programação e agentes
Como mostra a tabela, o Flash geralmente leva vantagem em tudo que envolve programação, uso de ferramentas e ciclos de execução de agentes. A diferença de mais de 14 pontos no DeepSWE indica que o Flash é bem melhor para encontrar problemas em repositórios reais, fazer alterações em vários arquivos e passar nos testes. A vantagem no AutomationBench é ainda maior, refletindo o tipo de fluxo de trabalho com várias chamadas de ferramentas usado pelo Harness.
As diferenças no Terminal-Bench e no Codeforces são menores, mas seguem a mesma tendência. As análises de terceiros chegam à mesma conclusão: nos próprios benchmarks da DeepSeek, o modelo mais barato supera o maior na maioria das tarefas de programação e de agentes.
DeepSeek Pro mantém a vantagem em conhecimento e documentos longos
O Pro também tem seus pontos fortes. Seu número total maior de parâmetros oferece um estoque mais amplo de conhecimento geral. A vantagem de cerca de 13 pontos no SimpleQA-Verified significa menor probabilidade de alucinar ao responder perguntas sobre fatos obscuros, nomes de pessoas, números de versão e detalhes de APIs. O Pro também fica cerca de 6 pontos à frente no LongBench-V2 e tem um resultado um pouco melhor no GPQA Diamond, o que mostra sua força na leitura atenta de documentos longos e em perguntas acadêmicas.
Há outra diferença fácil de ignorar: o Flash é o único dos dois modelos que aceita entradas visuais. O Pro não consegue ler imagens. Portanto, ao usar capturas de tela, telas de erro ou protótipos de design no Harness, é preciso usar o Flash.
O DeepSeek Harness foi otimizado especialmente para o Flash
Nas notas de atualização da versão 1017, a equipe oficial afirma que a atualização foi otimizada especificamente para o DeepSeek Harness e recomenda atualizar para o Harness 0.2.1-rc.1 ou superior. Isso significa que, nessa interface gráfica, o formato das chamadas de ferramentas, o gerenciamento de contexto e o comportamento ao concluir tarefas do Flash foram adaptados especificamente. O Pro não recebeu esse mesmo tratamento.
Comparação de preços entre DeepSeek Pro e Flash: a diferença aumenta ainda mais com o raciocínio Max
A tabela abaixo mostra os preços unitários publicados na página oficial de preços, em dólares por milhão de tokens. O valor antes da barra é o preço de pico; o valor depois da barra é o preço fora do pico:
| Item de cobrança | Flash | Pro | Pro em relação ao Flash |
|---|---|---|---|
| Entrada (cache atingido) | 0.006 / 0.003 | 0.044 / 0.022 | cerca de 7,3× |
| Entrada (cache não atingido) | 0.30 / 0.15 | 1.32 / 0.66 | cerca de 4,4× |
| Saída | 1.20 / 0.60 | 3.96 / 1.98 | cerca de 3,3× |
| Limite de concorrência | 2500 | 500 | Flash é 5× o Pro |
O preço fora do pico é metade do preço de pico. O horário de pico é das 01:00 às 04:00 e das 06:00 às 10:00 UTC nos dias úteis, ou das 09:00 às 12:00 e das 14:00 às 18:00 no horário de Pequim. Nos fins de semana, o preço fora do pico vale o dia todo. Se você tiver tarefas que não são urgentes, como refatorações ou geração de testes em lote, deixe para executá-las à noite ou no fim de semana: o custo cai pela metade.
Por que a conta do Pro fica mais alta com o Max ativado
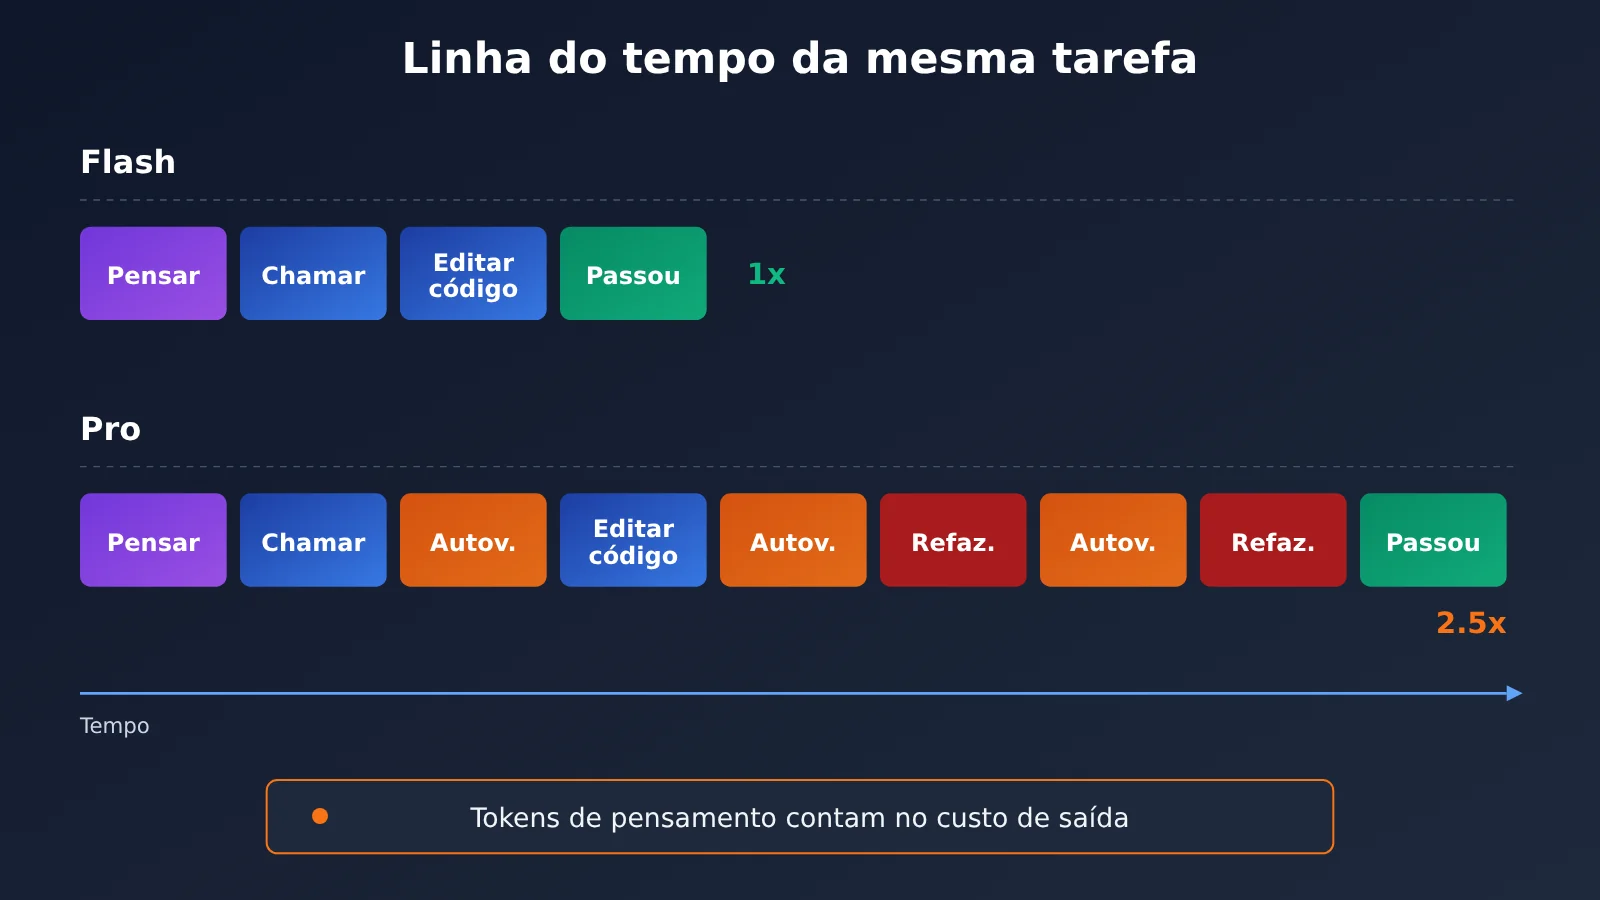
A tabela de preços mostra apenas parte da diferença. Com o nível de raciocínio definido como Max, os tokens gerados durante o processo de pensamento também são cobrados como saída. Além disso, no nível Max, o Pro tende a pensar e fazer verificações repetidas, demorando para apresentar o resultado final. Em testes de terceiros, o Pro levou mais de 2,5 vezes o tempo do Flash para concluir a mesma tarefa e ainda exigiu mais retrabalho.
Por isso, na prática, a diferença na conta costuma ser maior que os 3,3× indicados pela diferença no preço de saída da tabela: o Pro não só tem um preço unitário mais alto, como também gera mais tokens. Em ciclos de ferramentas no Harness, que podem facilmente chegar a dezenas de rodadas, esse custo se acumula rapidamente.
💰 Como otimizar os custos: se você usa DeepSeek e outros modelos, como Claude, GPT e Gemini, em vários projetos, pode centralizar as invocações e as contas pela APIYI, em apiyi.com. A plataforma oferece uma interface compatível com a OpenAI e cobrança por uso, facilitando a escolha de modelos conforme o tipo de tarefa e o controle dos custos totais.
Comparação de velocidade entre DeepSeek Flash e Pro
O Flash tem cerca de uma ordem de grandeza menos parâmetros ativos que o Pro e um limite de concorrência cinco vezes maior. Por isso, tanto a latência até o primeiro token quanto o tempo total das tarefas são bem menores. Em testes, ele chegou a cerca de 363 tok/s. Em cenários como o Harness, que exigem chamadas contínuas a ferramentas e várias rodadas de iteração, alguns segundos a menos por rodada podem reduzir bastante o tempo total da tarefa.
Vale observar que a lentidão do Pro se deve principalmente ao fato de que ele demora mais para pensar, e não à falta de capacidade computacional. O nível Max acentua sua tendência a ponderar repetidamente. Por isso, em ciclos com ferramentas, ele costuma ser mais lento sem entregar resultados melhores.
A tabela abaixo reúne os três aspectos para facilitar a comparação:
| Aspecto | DeepSeek V4.1 Flash | DeepSeek V4 Pro | Vencedor |
|---|---|---|---|
| Programação / refatoração de vários arquivos | DeepSWE 77.0 | DeepSWE 62.7 | Flash |
| Agent / cadeia de ferramentas | AutomationBench 60.5 | AutomationBench 31.8 | Flash |
| Conhecimento factual / baixa alucinação | SimpleQA 42.3 | SimpleQA 55.2 | Pro |
| Compreensão de documentos longos | LongBench 45.2 | LongBench 51.5 | Pro |
| Entrada visual | Compatível | Não compatível | Flash |
| Preço | Saída custa cerca de um terço do Pro | Preço unitário alto e mais tempo de pensamento | Flash |
| Velocidade e concorrência | Rápido, concorrência de 2500 | Lento, concorrência de 500 | Flash |
| Compatibilidade com Harness | Otimizado especificamente pelo fabricante | Sem otimização específica | Flash |
Recomendações de uso do DeepSeek Harness: quando escolher Pro ou Flash
Quando escolher DeepSeek Flash + Max
- Programação do dia a dia e correção de bugs: a vantagem de 14 pontos no DeepSWE é o indício mais direto
- Refatoração de vários arquivos e mudanças entre módulos: exige compreensão consistente do código e ciclos mais longos de uso de ferramentas
- Operações no terminal, execução de testes e scripts: o Flash lidera tanto no Terminal-Bench quanto no AutomationBench
- Perguntas sobre imagens: análise de erros em capturas de tela, recriação de interfaces e leitura de layouts — só o Flash oferece suporte
- Perguntas do dia a dia e iterações rápidas: é rápido e econômico; o plano Max traz os ganhos mais expressivos no Flash
Quando escolher DeepSeek Pro + Max
- Pesquisa de conhecimentos específicos e fatos: nomes de pessoas, versões de bibliotecas, parâmetros de uma API ou eventos históricos
- Leitura detalhada de documentos longos e artigos acadêmicos: vantagem de cerca de 6 pontos no LongBench-V2
- Textos que exigem conhecimento, mas não envolvem código: ideal quando você quer respostas com referências mais abrangentes e menos erros factuais
- Verificação cruzada de respostas factuais do Flash
Quando não recomendamos o Pro
Não use o Pro em ciclos longos de uso de ferramentas. No plano Max, ele só fica mais lento e mais caro, sem levar vantagem no Terminal-Bench nem no DeepSWE. Esse é o erro mais comum: achar que uma tarefa complexa exige um modelo maior e acabar gastando o dobro do tempo para obter um resultado ainda pior.
Como alternar entre DeepSeek Pro e Flash por tarefa usando a API
No Harness, alternar o modelo no meio da mesma sessão não tem custo adicional: os dois usam a mesma interface compatível com a OpenAI. Se você estiver criando seu próprio agente de programação fora do Harness, também pode implementar a mesma lógica de roteamento no código. Veja o exemplo mais simples:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com a OpenAI da APIYI
)

response = client.chat.completions.create(
    model="deepseek-flash",  # Use o Flash por padrão para escrever código; confira a lista de modelos da plataforma
    messages=[{"role": "user", "content": "用 Python 写一个带重试机制的 HTTP 请求函数"}]
)
print(response.choices[0].message.content)
Ver a implementação completa: seleção automática de Pro / Flash por tipo de tarefa
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Mapeamento entre tipos de tarefa e modelos: Flash para programação / agentes / visão; Pro para conhecimento / documentos longos
TASK_MODEL_MAP = {
    "code": "deepseek-flash",
    "agent": "deepseek-flash",
    "vision": "deepseek-flash",      # O Pro não aceita imagens como entrada
    "knowledge": "deepseek-v4-pro",  # Mais precisão na recuperação de fatos e menos alucinações
    "long_doc": "deepseek-v4-pro",   # Melhor compreensão de documentos longos
}

def ask_deepseek(
    prompt: str,
    task_type: str = "code",
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000,
) -> str:
    """Seleciona o modelo DeepSeek de acordo com o tipo de tarefa e faz a chamada."""
    model = TASK_MODEL_MAP.get(task_type, "deepseek-flash")

    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error ({model}): {e}"

# Para escrever código: use o Flash
print(ask_deepseek("重构这段函数,拆分为三个职责单一的方法:...", task_type="code"))

# Para consultar detalhes de uma API: use o Pro
print(ask_deepseek("requests 库 Session 对象的 mount 方法有哪些参数?", task_type="knowledge"))
A lógica de roteamento segue a mesma conclusão deste artigo: use o Flash como modelo principal e deixe o Pro para tarefas que exigem conhecimento. Quando o V4.1 Pro for lançado, basta alterar uma linha na tabela de mapeamento.
🚀 Comece agora: recomendamos usar a APIYI em apiyi.com para obter uma chave API e créditos gratuitos de teste para novos usuários. Com uma única chave, você pode chamar o DeepSeek e outros modelos populares, como OpenAI, Claude e Gemini. Use o código acima para comparar o desempenho real do Flash e do Pro no seu próprio repositório.
DeepSeek Pro ou Flash: recomendações para escolher
Considerando inteligência, preço e velocidade, a escolha no DeepSeek Harness pode ser resumida assim:
- Use Flash + Max por padrão: para escrever código, refatorar vários arquivos, executar ferramentas, analisar imagens e responder a perguntas do dia a dia. Essa também é a configuração padrão mais adequada no Harness.
- Mude para Pro em tarefas que exigem conhecimento: conhecimentos específicos, números de versão, detalhes de APIs, fatos históricos e leitura aprofundada de documentos longos — cenários em que o Pro lidera por 13 pontos no SimpleQA e por 6 no LongBench.
- Não use Pro em ciclos longos com ferramentas: no plano Max, ele é mais lento e mais caro, sem levar vantagem nos benchmarks de programação.
- Use Flash na rodada em que enviar uma imagem: o Pro não tem capacidade de visão.
- Deixe Pro como alternativa: antes do lançamento oficial do V4.1 Pro, use a opção Pro apenas como apoio para consultas de conhecimento. Reavalie quando a nova versão for lançada.
💡 Recomendação: os resultados dos benchmarks mostram apenas tendências gerais. No seu código e na lógica do seu negócio, a diferença pode ser maior ou menor. Recomendamos usar a mesma interface por meio da APIYI em apiyi.com e testar o Flash e o Pro em algumas tarefas reais do seu projeto. Compare a taxa de sucesso, o tempo de execução e o consumo de tokens antes de definir a configuração padrão da equipe.
Perguntas frequentes
Q1: Quais modelos são o Pro e o Flash no DeepSeek Harness?
O Flash corresponde ao `deepseek-flash`, que na prática é o V4.1-Flash-1017: um modelo MoE com 552B de parâmetros totais, suporte a visão e janela de contexto de 1M. O Pro corresponde ao `deepseek-v4-pro`, que na prática é a versão GA do V4-Pro-0813, com 1,6T de parâmetros totais e cerca de 49B de parâmetros ativos. Ele não aceita imagens como entrada.
Q2: O DeepSeek Pro tem mais parâmetros. Por que o Flash se sai melhor na programação?
O Flash faz parte de uma família de arquiteturas mais recente e passou por um post-training mais completo. Além disso, a versão 1017 foi otimizada especificamente para o Harness. A vantagem do Pro está no conhecimento proporcionado pelo maior número de parâmetros, não na programação nem no uso de ferramentas. Por isso, o Flash lidera no DeepSWE, AutomationBench e Terminal-Bench, enquanto o Pro se destaca no SimpleQA e no LongBench.
Q3: O DeepSeek V4 Pro vai ser descontinuado? Quando será lançado o V4.1 Pro?
A DeepSeek chegou a anunciar que encerraria o serviço do V4 Pro após 14 de setembro. Depois, na mesma nota de atualização, voltou atrás e informou que a API continuaria disponível, sem alterações na cobrança. Portanto, o modelo pode ser usado normalmente. Até o momento, o V4.1 Pro ainda não foi lançado oficialmente. No fim de outubro, surgiram apenas especulações sobre mudanças na identificação do modelo no site oficial. O melhor é acompanhar as notas de atualização oficiais.
Q4: Com o nível de raciocínio em Max, qual é a diferença de custo entre o Pro e o Flash?
O preço por unidade do Pro é cerca de 3,3 vezes maior para saídas, 4,4 vezes maior para entradas que não atingem o cache e 7,3 vezes maior para entradas que atingem o cache. No nível Max, os tokens de raciocínio entram no custo de saída. Como o Pro tende a pensar e revisar as respostas repetidamente, nos testes ele levou mais de 2,5 vezes o tempo do Flash. Por isso, a diferença na fatura costuma ser maior que a diferença entre os preços unitários.
Q5: Como chamar o DeepSeek Flash e o Pro pela API fora do Harness?
Os dois usam uma interface compatível com a OpenAI. Basta alterar o parâmetro `model` para alternar entre eles:
1. Acesse APIYI em apiyi.com e crie uma conta.
2. Obtenha uma chave API e os créditos gratuitos de teste para novos usuários.
3. Use o código deste artigo, defina `base_url` como `https://api.apiyi.com/v1` e informe o nome do modelo Flash ou Pro em `model`.
Consulte a lista de modelos da plataforma para ver os nomes disponíveis.
Q6: Dá para trocar do Flash para o Pro no meio de uma conversa?
Sim. A troca não tem custo adicional, e os dois usam a mesma interface. Uma prática comum é programar com o Flash e, quando houver dúvidas sobre detalhes de uma API ou números de versão, mudar para o Pro para conferir. Depois, é só voltar ao Flash e continuar a programação. O único cuidado é que, na rodada que incluir imagens, não dá para usar o Pro.
Q7: Quais são as limitações do DeepSeek Flash?
O principal ponto fraco do Flash está no conhecimento: sua pontuação no SimpleQA-Verified é de apenas 42,3, cerca de 13 pontos abaixo da do Pro. Isso aumenta a chance de alucinações em perguntas sobre fatos pouco conhecidos e números de versão específicos. A compreensão de documentos longos também é um pouco inferior à do Pro. Para contornar isso, confira fatos importantes com o Pro ou inclua diretamente no comando o conteúdo da documentação oficial. Se precisar comparar modelos de outros fornecedores, você também pode usar a mesma chave na APIYI, em apiyi.com, e alternar entre eles nos testes.
Principais conclusões sobre DeepSeek Pro e Flash
- Para escrever código, escolha o Flash por padrão: 77,0 no DeepSWE contra 62,7; ele supera o Pro em programação e capacidade de Agent.
- O Pro se destaca em conhecimento: fica cerca de 13 pontos à frente no SimpleQA e 6 pontos no LongBench, sendo uma boa opção para verificar fatos e ler textos longos.
- Mais parâmetros não significam mais capacidade para escrever código: o Flash superou o Pro graças à nova arquitetura e ao pós-treinamento; ele não é uma versão destilada do Pro.
- O modo Max amplia a diferença de custo: o Pro leva mais tempo para pensar, e a conta real fica acima da diferença de 3,3 vezes no preço por token de saída.
- O Flash leva vantagem em velocidade e concorrência: tem uma ordem de grandeza a menos de parâmetros ativos, e seu limite de concorrência é cinco vezes maior que o do Pro.
- Para usar imagens, só o Flash serve: o Pro não aceita entradas visuais.
- Valide com tarefas reais: você pode comparar os dois modelos nos seus próprios projetos usando uma interface unificada da APIYI.
Resumo
No DeepSeek Harness, com o nível de raciocínio configurado como Max, não é difícil escolher entre Pro e Flash:
- Capacidade: o Flash é melhor para escrever código, executar Agents e usar ferramentas; o Pro se sai melhor em consultas de conhecimento e na leitura de documentos longos.
- Preço: o preço unitário do Flash fica entre um sétimo e um terço do preço do Pro. No modo Max, a diferença é ainda maior, e os preços em horários de menor movimento podem cair pela metade.
- Velocidade: o Flash tem um tempo até o primeiro token e um tempo total de resposta bem menores. Seu limite de concorrência é cinco vezes maior que o do Pro, e ele também recebe otimizações específicas para o Harness.
Em resumo: use o Flash como modelo principal por padrão e deixe o Pro como opção complementar para consultas de conhecimento. Reavalie essa estratégia quando o V4.1 Pro for lançado oficialmente. Para validar essa conclusão no seu próprio código, recomendamos usar APIYI apiyi.com para chamar os dois modelos com uma única chave API, compará-los em tarefas reais e então definir a configuração padrão da equipe.
📚 Referências
- Registro oficial de atualizações da DeepSeek: lançamento do V4.1 Flash, continuidade do serviço V4 Pro e notas sobre as otimizações da versão 1017 para Harness
- Link:
api-docs.deepseek.com/updates -
Observação: fonte primária para confirmar versões dos modelos, status de lançamento e recomendações de versão do Harness
-
Página oficial de preços da DeepSeek: preços de entrada e saída do Flash e do Pro, horários de pico e fora de pico e limite de concorrência
- Link:
api-docs.deepseek.com/quick_start/pricing -
Observação: referência para calcular o custo real das invocações e programar tarefas em lote nos horários fora de pico
-
Comparação de modelos DeepSeek de 2026 da Respan: avaliação comparativa de terceiros
- Link:
respan.ai/articles/deepseek-model-comparison - Observação: perspectiva independente que confirma que “o modelo mais barato supera os demais na maioria das tarefas de programação e de agentes”
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Para mais informações sobre integração de modelos, acesse a central de documentação em docs.apiyi.com