Em 1º de novembro, a equipe DeepSeek Harness publicou no X o artigo “Explorando o design de superagentes”, sobre a arquitetura de superagentes (Super-agents). Cerca de 15 horas depois, o texto já tinha aproximadamente 1,3 milhão de visualizações e 9,4 mil curtidas. O artigo apresenta uma proposta de arquitetura, não funcionalidades de um produto.
Em resumo: nessa proposta, o sistema assume o gerenciamento das sessões, e o usuário lida com um único ponto de entrada. O Router (responsável pelo atendimento e pela distribuição de tarefas) recebe as solicitações, enquanto os Workers (sessões que trabalham em segundo plano) executam tarefas em paralelo. A pessoa fica responsável pelas decisões de alto nível e pela aprovação final.
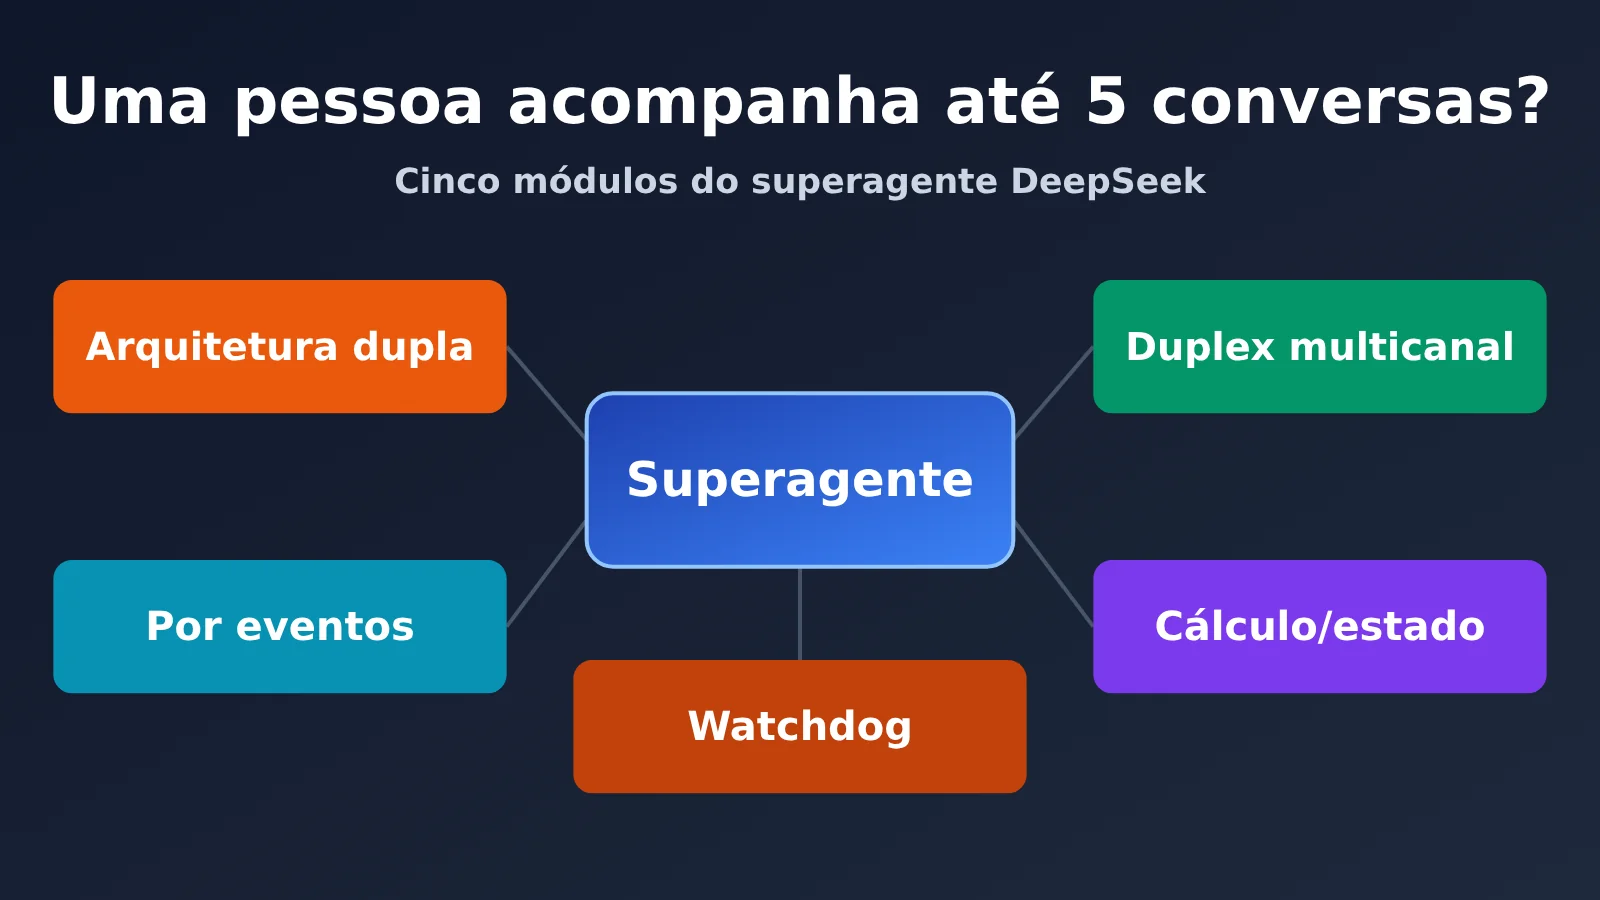
Por que o superagente da DeepSeek quer ir além de uma única sessão
Hoje, os agentes mais comuns ainda trabalham dentro de uma única sessão. Quando executa várias tarefas ao mesmo tempo, o usuário precisa alternar entre sessões e acompanhar o contexto de cada uma. Segundo a experiência da equipe DeepSeek Harness, uma pessoa normalmente consegue lidar com apenas 3 a 5 sessões ativas por vez. Esse número vem da experiência da equipe, não de uma estatística geral, mas aponta um gargalo: uma tarefa individual é limitada pela capacidade do modelo; várias tarefas são limitadas pela atenção humana.
Adicionar ferramentas de linha de comando e conectores externos a um agente local só permite que ele receba mensagens externas. Três limitações continuam:
- Bloqueio síncrono: o ReAct clássico (um ciclo que alterna entre raciocínio e chamadas de ferramentas) precisa esperar por operações demoradas e não consegue responder a novas mensagens nesse intervalo.
- Mistura de contextos: detalhes intermediários de tarefas diferentes ficam na mesma janela e interferem uns nos outros.
- Dependência do dispositivo: se o dispositivo local entrar em repouso ou ficar offline, o agente para de trabalhar.
Por isso, o artigo propõe desacoplar o agente de qualquer sessão individual controlada manualmente, transformando-o em uma entidade contínua. Ele precisa reunir as quatro características abaixo. Um único ciclo ReAct não dá conta disso: é necessária uma arquitetura de sistemas ao seu redor.
| Característica do superagente | Em outras palavras | Principal módulo responsável |
|---|---|---|
| Contínuo | Conversa em mensageiros instantâneos e no GitHub, mantendo a identidade de um mesmo agente | Arquitetura em duas camadas e interação multicanal |
| Eficiente | Aceita novas instruções antes de terminar a anterior e executa várias tarefas em paralelo | Arquitetura em duas camadas e interação full-duplex |
| Proativo | Monitora eventos do ambiente e age quando vale a pena | Arquitetura orientada a eventos |
| Persistente | Fica sempre online e se recupera automaticamente de falhas | Separação entre computação e estado, Watchdog |
Os cinco módulos do superagente DeepSeek, um por um
Vamos começar pela tabela geral. A coluna “Disponível agora?” merece atenção: o artigo apresenta uma direção de projeto, não necessariamente funcionalidades prontas para uso.
| Módulo | Qual problema resolve | Abordagem principal | Disponível agora? |
|---|---|---|---|
| Arquitetura em duas camadas | Dificuldade para conciliar continuidade e concorrência | O Router cuida das interações e distribui tarefas; os Workers executam em ambientes isolados | O protótipo tem um fluxo semelhante, mas o projeto completo precisa ser implementado por conta própria |
| Orientação a eventos | O agente só reage a comandos, e há muito ruído nos eventos | O código faz uma triagem rápida, o modelo faz uma análise mais cuidadosa e as assinaturas de Threads são encaminhadas diretamente | O protótipo pode monitorar o GitHub, com suporte opcional ao Feishu |
| Comunicação full-duplex multicanal | Tarefas longas bloqueiam a conversa e logs incomodam as pessoas | Chamadas assíncronas de ferramentas e regras de resposta definidas por canal | O DeepSeek Harness já implementou tarefas assíncronas, mas elas estão desativadas por padrão |
| Separação de processamento, estado e ambiente | O trabalho para quando o dispositivo fica offline e não alcança outros ambientes | O loop roda na nuvem, o estado fica no banco de dados e os endpoints permanecem em seus ambientes originais | O artigo original não informa se está disponível externamente; é preciso implementar por conta própria |
| Watchdog | O processo continua ativo, mas a tarefa trava ou sai do rumo | Uma sessão independente do sistema principal faz verificações periódicas | O artigo original não informa se está disponível externamente; é preciso implementar por conta própria |
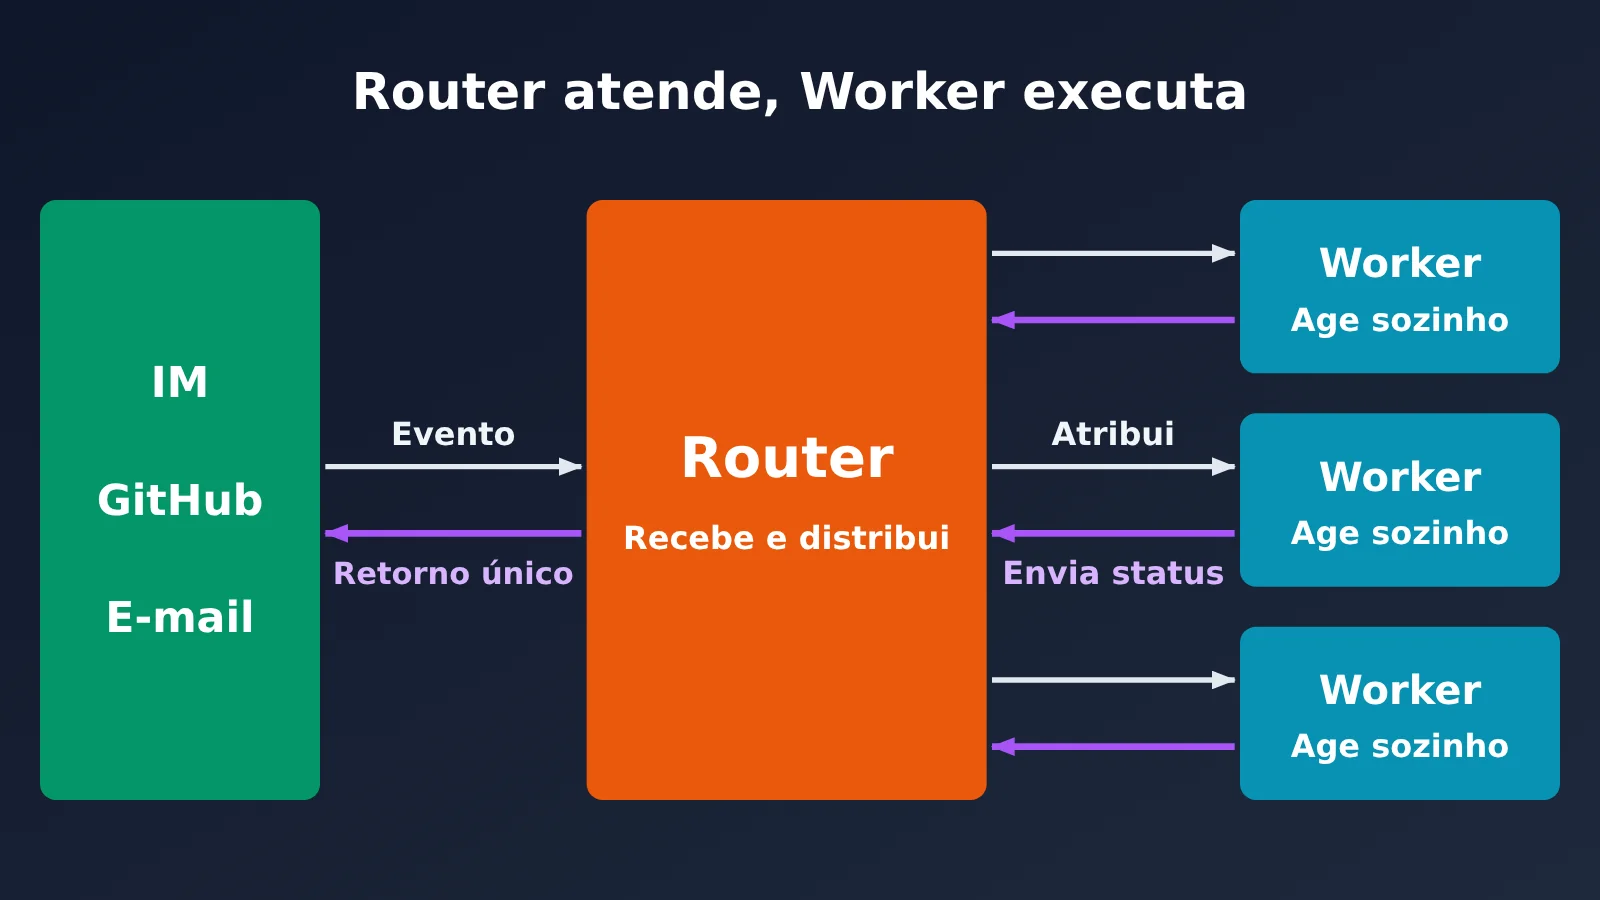
Módulo 1: Arquitetura de duas camadas Router/Worker do superagente DeepSeek
Analogia: o Router é como a recepção de um restaurante: recebe os pedidos e os encaminha. Os Workers são como a cozinha: cada estação prepara um prato.
Quando todos os eventos entram em uma única sessão, o contexto fica mais contínuo, mas a capacidade de processamento é baixa. Abrir uma nova sessão para cada evento aumenta a concorrência, mas deixa o sistema sem contexto global e pode causar confusão quando várias sessões respondem ao usuário separadamente. A arquitetura de duas camadas separa essas responsabilidades: o Router, que fica ativo continuamente, cuida da interação com as pessoas e da coordenação global, podendo até funcionar sem a ferramenta Bash. Os Workers têm contextos isolados, cada um cuida de uma única tarefa e não responde diretamente ao usuário; em vez disso, reportam seu status ao Router. A ideia do texto original é que as sessões sejam um detalhe de implementação do sistema, e não uma preocupação para o usuário.
O Router pode parecer um gargalo, mas os Triggers (eventos do ambiente) que chegam durante uma rodada de raciocínio entram em uma fila e são processados juntos na rodada seguinte. Suas requisições normalmente têm entradas longas e saídas curtas. Os eventos agrupados são processados em paralelo na fase de Prefill (a etapa inicial em que o modelo processa a entrada), então o tempo de uma requisição cresce mais lentamente que o tamanho do lote. Segundo a experiência da equipe, o trabalho do Router costuma ser mais simples do que parece, e um modelo leve geralmente é suficiente. Na implementação, você pode começar testando o Router com deepseek-v4.1-flash pela APIYI · apiyi.com e observar a precisão com que ele distribui as tarefas.
Os Workers determinam diretamente o resultado das tarefas e a qualidade do código. Por isso, o texto original recomenda usar, em geral, o modelo mais potente. Na APIYI · apiyi.com, você pode comparar deepseek-v4-pro e claude-opus-5-5 com o mesmo conjunto de tarefas antes de escolher o modelo padrão.
Módulo dois: Trigger orientado a eventos no superagente DeepSeek
Analogia: o porteiro primeiro confere os nomes na lista e pede ao gerente para decidir quando tem dúvidas; as solicitações seguintes de clientes antigos vão direto para o responsável original.
Para que um agente trabalhe de forma proativa, sua principal entrada precisa deixar de ser o comando humano e passar a ser eventos do ambiente, como mensagens em grupos, resultados de CI e comentários em revisões de código. Fluxos reais de eventos têm muito ruído: pedir que um Modelo de Linguagem Grande avalie cada evento seria inviável em termos de latência e capacidade computacional. Por isso, o artigo propõe duas camadas de filtragem:
- Fast Path (triagem rápida por código): faz verificações determinísticas com base em listas de permissões por origem, grupo, usuário ou bot. Cada origem pode ser configurada para “responder apenas a solicitações explícitas”, “tratar como evento candidato” ou “ignorar”.
- Slow Path (avaliação do modelo): apenas os eventos candidatos que passam pela triagem rápida são enviados ao LLM, que considera o contexto e uma política escrita em um comando para decidir se deve agir.
O roteamento também tem caminhos rápido e lento. Eventos consecutivos de um mesmo PR, tópico de mensagens instantâneas ou cadeia de e-mails formam uma Thread. Depois que um Worker se inscreve nela, os eventos seguintes são encaminhados diretamente pelo código, sem precisar passar novamente pela decisão do Router. Quando vários Workers se inscrevem na mesma Thread, todos recebem as mesmas notificações e podem identificar e resolver conflitos por conta própria.
O contexto é gerenciado como um cache. Informações que serão usadas em breve ficam diretamente na janela de contexto (Inline); informações completas usadas com pouca frequência ficam fora da janela, com apenas uma referência ou um resumo no contexto (Spill). O artigo também menciona ações antecipadas: consultar o calendário ou reproduzir uma issue em segundo plano, por exemplo. Apenas os resultados úteis são entregues; o restante é descartado. Assim, usa-se mais capacidade computacional para reduzir o tempo de espera e a necessidade de intervenção humana.
Módulo três: interação multicanal full-duplex do superagente DeepSeek
Analogia: ao ferver água, você não precisa ficar ao lado da chaleira. Ela avisa quando a água está pronta, e você pode continuar conversando com outra pessoa enquanto isso.
O ReAct assíncrono substitui chamadas demoradas por start() e stop(). start() retorna imediatamente, e a ferramenta roda em segundo plano. Ao terminar, o resultado volta para a sessão como um novo evento; o modelo também pode usar stop() para encerrar comandos que estão demorando demais. Assim, novas entradas do usuário podem ser processadas ao fim da etapa de raciocínio atual. O texto original afirma que o DeepSeek Harness já implementou esse mecanismo de tarefas assíncronas, mas ele ainda não está ativado por padrão.
O multicanal resolve a questão de “como se comunicar”. Em mensagens instantâneas, a comunicação deve ser leve e pouco intrusiva, com notificações apenas quando for necessária uma decisão ou aprovação. Uma regra prática validada pela equipe é limitar cada resposta a 100 palavras. Já no GitHub, em e-mails e documentos, a saída precisa ser estruturada e rica em informação: em um PR, por exemplo, é importante explicar o contexto do problema, as alterações e os resultados da validação.
Módulo quatro: separação entre computação, estado e ambiente no superagente DeepSeek
Analogia: os arquivos ficam guardados no arquivo da empresa, então um funcionário pode trocar de mesa e continuar trabalhando. Quando é preciso usar as ferramentas de uma máquina específica, basta enviar alguém até ela para executar o trabalho.
O artigo descreve esse desacoplamento em duas etapas. Primeiro, o loop do agente roda em contêineres de nuvem sem estado, enquanto o estado da sessão é armazenado em um banco de dados. Assim, reiniciar ou substituir um contêiner não interrompe a continuidade da tarefa. Depois, o ambiente de execução permanece onde está: cada endpoint recebe apenas um daemon leve (um pequeno programa que roda continuamente em segundo plano), que não armazena o estado da sessão e só executa comandos e retorna resultados.
Esse design também oferece suporte a BYOM (Bring Your Own Machine, ou conectar seu próprio computador ao agente na nuvem). Assim, não é preciso sincronizar todas as alterações ainda não commitadas e as credenciais locais com a nuvem. Quando o dispositivo volta a ficar online, o agente na nuvem pode continuar as tarefas que precisam ser executadas nele. O artigo “Decoupling the brain from the hands”, da Anthropic, também apresenta uma abordagem semelhante de desacoplamento e vale a leitura para comparação.
Módulo cinco: inspeção externa do superagente DeepSeek com Watchdog
Analogia: um supervisor de plantão não participa do trabalho em si, mas faz rondas periódicas para ver quem parou ou saiu do rumo.
Muitas falhas de agentes não são travamentos: o processo continua ativo, mas o modelo fica preso em um ciclo sem produzir resultados. As verificações tradicionais de atividade não conseguem detectar esse problema. O Watchdog é uma sessão independente, executada fora do sistema principal e acionada por mensagens periódicas. Ele lida tanto com falhas de infraestrutura, como erros de API e falhas na recuperação de estado, quanto usa um modelo para avaliar se cada Worker está fazendo progresso de fato. Os responsáveis pela manutenção podem perguntar em linguagem natural “por que falhou” e também pedir ajustes nos comandos e nas regras de acionamento enquanto o sistema está em execução.
Até onde é possível testar o protótipo do superagente DeepSeek hoje
O repositório associado é github.com/deepseek-ai/dsh-superagent-prototype, sob licença MIT. Na coleta de 02/11/2026, tinha 8.636 stars e 863 forks. Ele é um protótipo de pesquisa, não um produto oficial da DeepSeek, e também não equivale à versão interna da equipe nem à implementação completa descrita no artigo. Parte dos recursos apresentados aponta para desenvolvimentos futuros e ainda não foi implementada no protótipo.
O protótipo é um agente de programação proativo voltado a um único repositório do GitHub, empacotado como um bundle do DeepSeek Harness. Ele monitora o GitHub e pode se conectar opcionalmente ao Feishu. Quando recebe uma tarefa, cria um item de trabalho e a executa em sua própria sessão e diretório. Ao terminar, volta à conversa original para responder, por exemplo, com um PR. Há também um painel web que mostra os assuntos que precisam de atenção humana.
O que mostram os dois experimentos com o superagente da DeepSeek
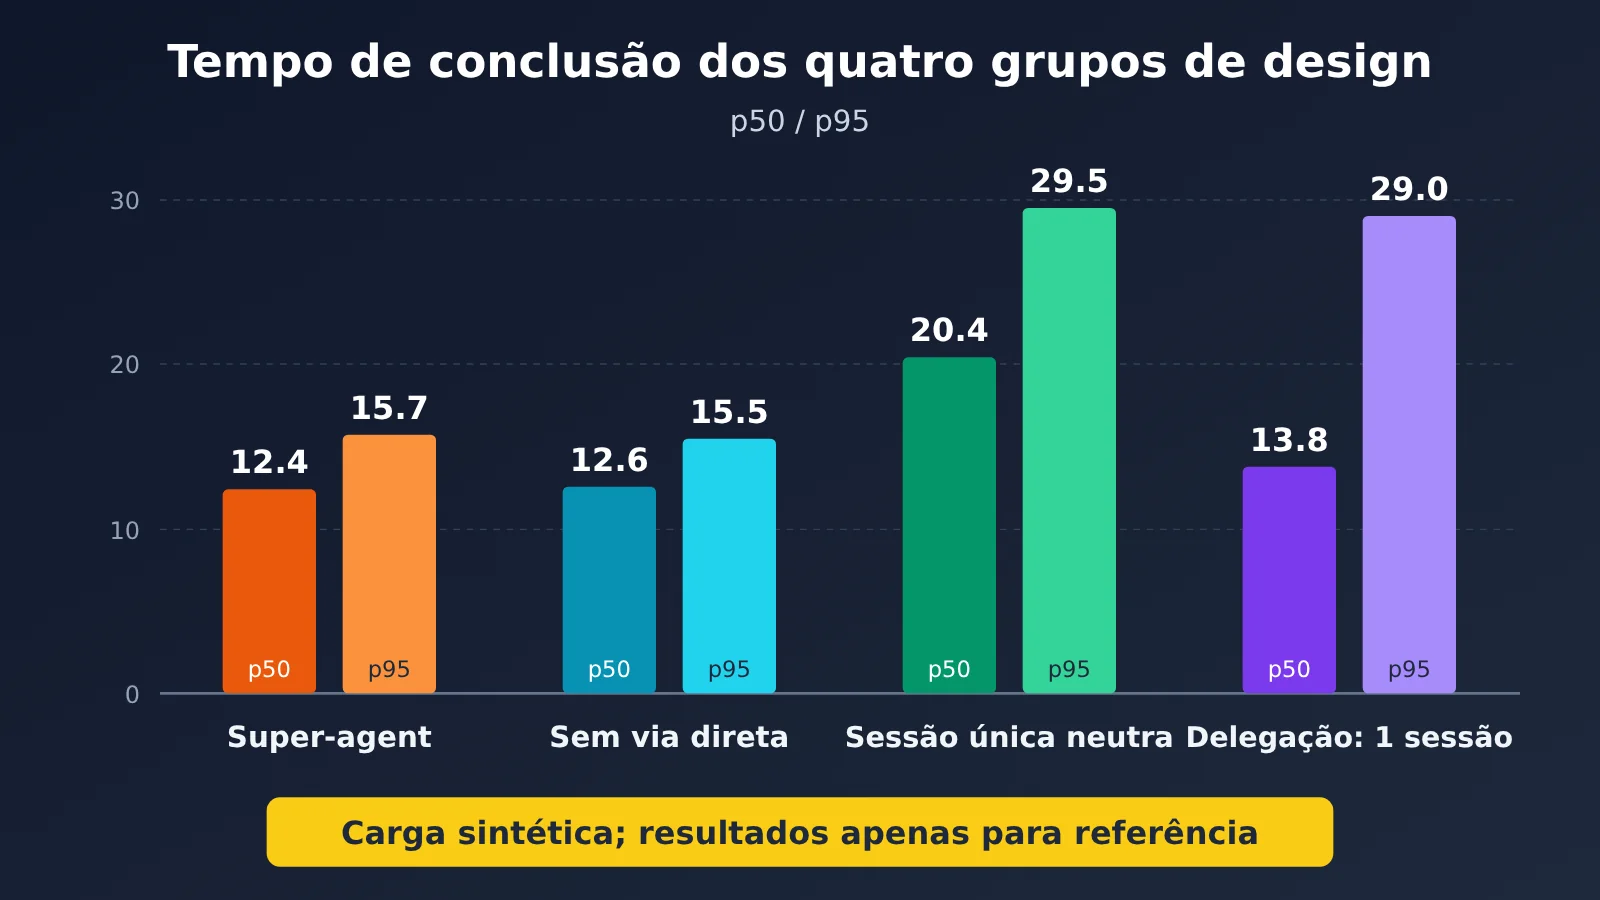
Os dados abaixo foram informados pelos próprios autores no artigo oficial. Os experimentos usaram cargas sintéticas e ambientes simplificados, e os autores dizem que os resultados servem apenas como referência. No primeiro experimento, cada execução teve cerca de 300 mensagens, incluindo aproximadamente 20 solicitações de trabalho. Cada arquitetura foi testada 5 vezes. As tarefas de programação foram simuladas com ferramentas que apenas consumiam tempo. Portanto, o teste mede agendamento e coordenação, não a qualidade da execução das tarefas.
Na tabela, p50 indica que metade das tarefas foi concluída dentro daquele tempo; p95 indica que 95% foram concluídas nesse prazo. Cache-read tokens são os tokens lidos do cache — ou seja, o contexto armazenado é reutilizado diretamente, sem novo processamento. Aqui, o valor é a soma de todas as sessões.
| Arquitetura | p50 (minutos) | p95 (minutos) | Cache-read tokens / execução |
|---|---|---|---|
| Super-agent | 12,4 | 15,7 | 23,2M |
| Sem Pass-through (encaminhamento direto de assinaturas) | 12,6 | 15,5 | 31,8M |
| Sessão única + subagente (comando neutro) | 20,4 | 29,5 | 6,1M |
| Sessão única + subagente (comando que prioriza a delegação) | 13,8 | 29,0 | 10,8M |
Com o comando neutro, o modelo não invocou o subagente em nenhuma das 5 execuções. Com o comando que priorizava a delegação, houve delegação em 4 das 5 execuções; na outra, o modelo considerou a tarefa pequena e a executou por conta própria. Isso mostra que, nessa carga, o desempenho de uma sessão única depende muito do comando e da decisão tomada pelo modelo em cada situação, enquanto a arquitetura de duas camadas incorpora a delegação ao sistema. O custo também é claro: o Super-agent consome bem mais tokens de leitura de cache, trocando tokens por tempos de conclusão menores e mais estáveis.
Sem o encaminhamento direto, o tempo de conclusão quase não mudou, mas o número de decisões do Router aumentou cerca de 30%, e os tokens de leitura de cache, cerca de 37%. Portanto, nessa carga, o encaminhamento direto não trouxe ganho de velocidade; sua principal função foi reduzir a sobrecarga do Router.
O segundo experimento submeteu a camada Router a um teste de carga separado: o Router invocou um modelo real, enquanto o Worker usou um modelo simulado. A taxa de chegada de Triggers que exigiam decisões do Router foi aumentada gradualmente.
| Taxa de chegada (vezes/minuto) | Tamanho médio do lote | Tempo por solicitação | Tempo de inferência rateado por decisão |
|---|---|---|---|
| Cerca de 1 | 1,0 | 2,5 segundos | 6,4 segundos |
| Cerca de 40 | 2,8 | 3,9 segundos | 1,6 segundo |
Uma decisão pode envolver várias solicitações ao LLM, então o tempo rateado pode ser maior que o tempo de uma única solicitação. Esses dados sustentam a conclusão de que, durante picos de eventos, o agrupamento automático pode aumentar a capacidade efetiva de processamento do Router. Mas eles não provam que o resultado seria o mesmo em um ambiente real de produção, nem mostram como seriam a qualidade das tarefas e o desempenho em diferentes bases de código.
Quatro questões em aberto sobre o Super-agent da DeepSeek
O artigo reconhece que as questões abaixo ainda não foram resolvidas. Vale considerá-las ao avaliar uma implementação:
- Como escalar a arquitetura: Em tarefas maiores e com componentes mais interdependentes, ainda não há consenso sobre se o Router deve ser dividido em partes, qual deve ser o tamanho delas ou quando os Workers devem se comunicar diretamente. Quanto menores as partes, maior a concorrência, mas menor o compartilhamento de memória e contexto. A memória de longo prazo também é um gargalo importante.
- Como usar sem sessões: Ainda são necessárias novas formas de interação para apresentar as tarefas e permitir que as pessoas intervenham em detalhes importantes sem interromper o trabalho em segundo plano.
- Limites de contexto e A2A: A2A (agent-to-agent) se refere à comunicação e à colaboração entre diferentes Agents. Conforme a organização cresce, configurar um Super-agent significa, na prática, decidir quais contextos serão compartilhados e quais ficarão isolados. Ainda não há uma resposta para a colaboração segura entre diferentes níveis de permissão.
- Segurança e privacidade: Este é o ponto que mais exige atenção prioritária. O ciclo na nuvem recebe eventos externos continuamente, enquanto os endpoints armazenam código privado e credenciais locais. Se o servidor for invadido ou o ciclo for comprometido por uma injeção de prompt (instruções maliciosas escondidas nas entradas), todos os endpoints conectados poderão ser controlados por invasores. Segundo o artigo, os Agents precisam de uma forma de “usar as credenciais sem vê-las”.
Checklist mínimo para implementar o superagente da DeepSeek em uma equipe pequena
A sequência abaixo é uma sugestão baseada nas ideias do artigo original, não um roteiro oficial. Comece com um projeto-piloto em um único repositório e em um ambiente confiável. Por enquanto, deixe o particionamento do Router de lado.
Primeiro passo: separar Router e Worker
- Código: crie um ponto de entrada Router que fique sempre ativo, sem acesso à ferramenta Bash. Para cada tarefa, crie um Worker separado, com contexto e diretório de trabalho próprios. Os resultados do Worker devem ser enviados apenas ao Router.
- Modelo: use um modelo leve no Router e um modelo mais capaz no Worker. Configure os dois separadamente para facilitar a troca individual.
- Pessoas: interajam apenas com o Router e definam os limites das tarefas, respondam às solicitações de decisão e aprovem o resultado final.
Segundo passo: adicionar a filtragem por Trigger
- Código: configure uma lista de fontes permitidas e uma política com três níveis. Mapeie PRs e tópicos de mensagens instantâneas (IM) para Threads e encaminhe diretamente ao Worker os eventos subsequentes aos quais ele já esteja inscrito.
- Modelo: faça uma análise semântica apenas dos eventos candidatos, decidindo se é preciso agir e criar um novo Worker.
- Pessoas: definam claramente as condições de ação no comando, verifiquem periodicamente os acionamentos indevidos e os que não aconteceram quando deveriam e ajustem a lista de fontes permitidas e a política.
Terceiro passo: adicionar o Watchdog
- Código: implemente-o fora do sistema principal, acionado por mensagens programadas, para verificar problemas de infraestrutura, como erros de API e falhas na recuperação de estado.
- Modelo: leia os registros de progresso do Worker para avaliar se ele está avançando de fato, travado ou se desviando do objetivo.
- Pessoas: definam as permissões de correção do Watchdog, aprovem suas alterações nos comandos e nas regras de acionamento e analisem as causas das falhas.
Desde o primeiro dia, evite colocar credenciais de produção diretamente no contexto do modelo e configure as permissões com o menor escopo necessário. As chamadas assíncronas de ferramentas e a separação dos recursos computacionais podem esperar até que as três primeiras etapas estejam estáveis e surjam problemas reais de bloqueio ou dispositivos offline.
Combinação de modelos e estimativa de custos para o superagente DeepSeek
A tabela abaixo apresenta os modelos da APIYI · apiyi.com consultados em 02/11/2026, com valores em US$/1 milhão de tokens. Consulte a lista da plataforma para confirmar os modelos e preços; o valor efetivamente cobrado é exibido no console.
| Modelo | Entrada | Saída | Leitura de cache |
|---|---|---|---|
| deepseek-v4.1-flash | 0.3 | 1.2 | 0.006 |
| deepseek-v4-flash | 0.44 | 1.32 | 0.01408 |
| deepseek-v4-pro | 1.32 | 3.96 | 0.043996 |
| claude-opus-5-5 | 4 | 20 | 0.2 |
Os valores abaixo são estimativas calculadas com base nos preços públicos, não resultados de testes. Supondo que cada chamada consuma 20 mil tokens de entrada e 2 mil tokens de saída, sem considerar o cache:
deepseek-v4.1-flashcusta cerca de US$ 0,0084,deepseek-v4-procerca de US$ 0,0343 eclaude-opus-5-5cerca de US$ 0,12.- Uma chamada do Router com
deepseek-v4.1-flashe uma do Worker comdeepseek-v4-procustam juntas cerca de US$ 0,0427; usarclaude-opus-5-5nos dois custa cerca de US$ 0,24, aproximadamente 5,6 vezes mais. - Se você executar 20 conjuntos por dia com esse consumo, a combinação de modelos custa cerca de US$ 0,85, enquanto usar apenas
claude-opus-5-5custa cerca de US$ 4,80. Na prática, o Worker costuma fazer mais de uma chamada, então refaça o cálculo com os números de tokens dos seus logs.
Em sistemas de longa duração, também é preciso calcular a leitura de cache separadamente. Usando como referência os 23,2 milhões de tokens de leitura de cache do experimento, o custo seria de cerca de US$ 0,14 com deepseek-v4.1-flash, US$ 1,02 com deepseek-v4-pro ou US$ 4,64 com claude-opus-5-5. Esses valores servem apenas como referência de escala: o experimento não divulgou a distribuição de tokens entre as camadas, e o cálculo não inclui os custos de entrada e saída.
O ideal é tornar os modelos do Router e do Worker configuráveis. Com a APIYI · apiyi.com, você pode alternar entre esses modelos usando uma única chave API. O base_url da interface compatível com OpenAI é https://api.apiyi.com/v1; para trocar de modelo, basta principalmente alterar seu nome. Isso facilita a comparação de qualidade e custo usando o mesmo conjunto de tarefas. O preço é apenas uma parte da escolha: o modelo padrão do Worker também deve ser definido com base na taxa de sucesso das tarefas e no volume de retrabalho.
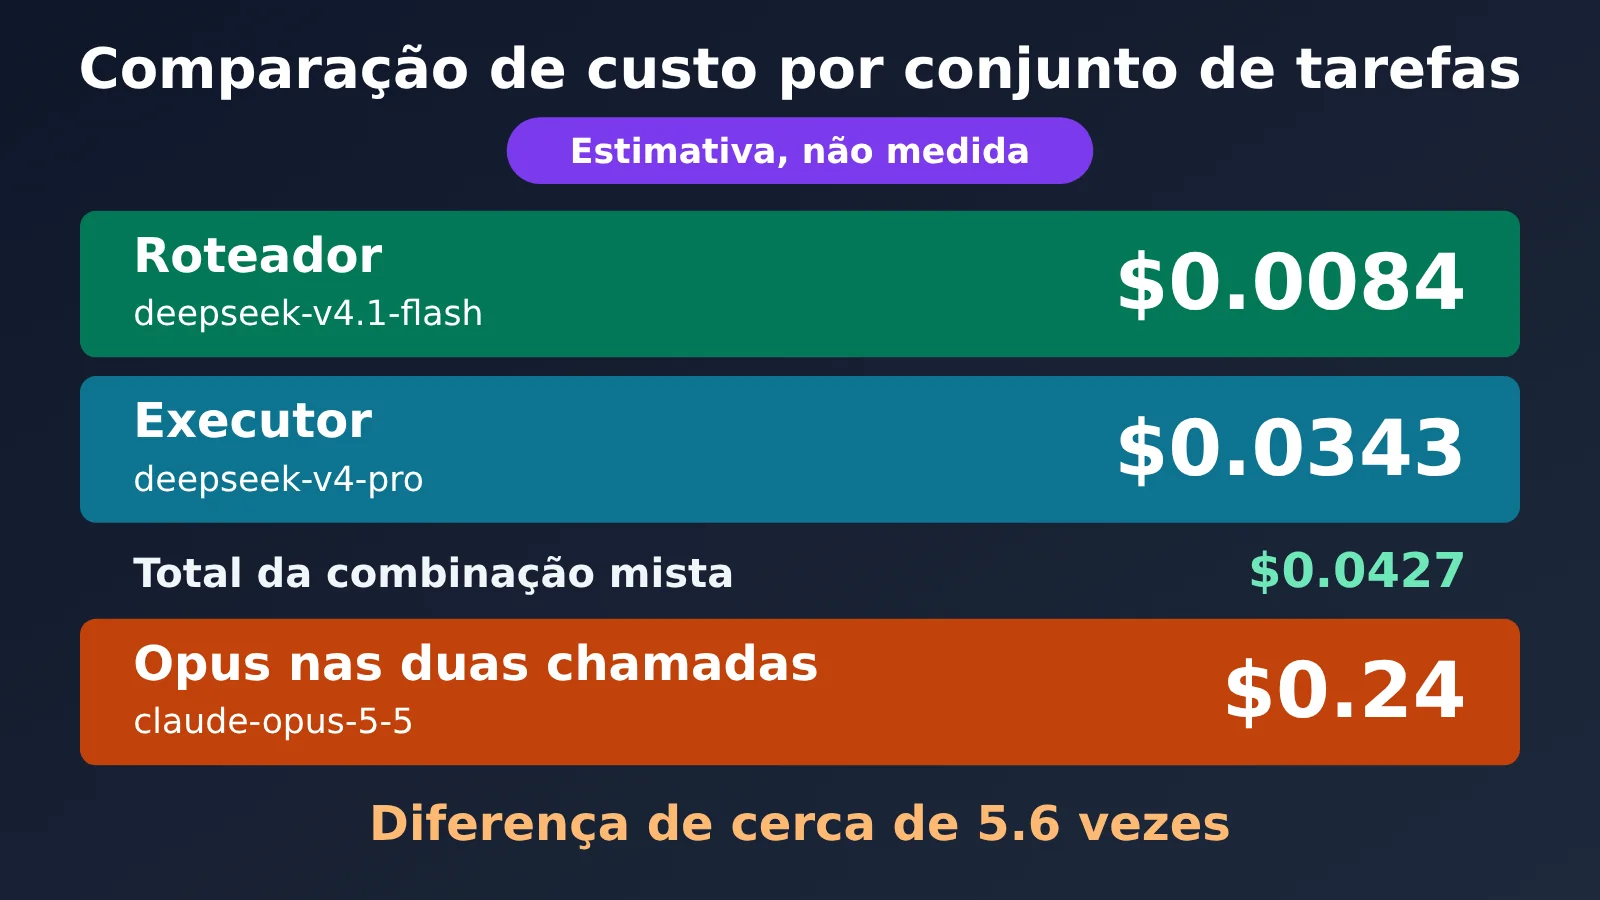
O gráfico acima usa os preços padrão da tabela de modelos da APIYI · apiyi.com. Substitua os valores pelo seu próprio consumo de tokens antes de fazer o orçamento.
Perguntas frequentes sobre o superagente DeepSeek
Q1: É um modelo novo?
Não. Este artigo discute a arquitetura de um sistema de agentes, com foco em como os componentes externos organizam sessões, eventos, estado e monitoramento. Nenhum modelo novo foi lançado.
Q2: Desenvolvedores comuns podem usá-lo diretamente?
Não é possível usar os cinco módulos como recursos prontos. Por enquanto, você pode experimentar o protótipo de pesquisa ou criar sua própria implementação seguindo as ideias do artigo. A única implementação existente mencionada explicitamente no texto original é o mecanismo de tarefas assíncronas do DeepSeek Harness, que vem desativado por padrão.
Q3: O dsh-superagent-prototype é um produto oficial?
Não. O README deixa claro que ele serve apenas como referência para pesquisa. Não é um produto oficial da DeepSeek e também não equivale à versão interna nem à implementação completa descrita no artigo.
Q4: Usar vários agentes sai mais caro?
Nesses experimentos, a leitura de tokens em cache foi maior: 23,2 milhões para o superagente, contra 6,1 a 10,8 milhões para a solução de sessão única. Em troca, o tempo de conclusão foi menor e mais estável. O custo total também depende da combinação de modelos e do tamanho da tarefa. Usar um modelo leve no Router e ativar o encaminhamento direto de Thread ajuda a controlar os gastos.
Q5: Como acessar esses modelos na China?
Você pode se cadastrar na APIYI · apiyi.com e obter uma chave API. Novos usuários recebem créditos gratuitos para testes. Depois, altere o base_url do cliente para o endereço mencionado acima e informe, no parâmetro de modelo, o identificador que consta na tabela. Esses modelos DeepSeek e Claude são compatíveis com os endpoints chat e messages. Antes de colocar em produção, é recomendável testar com um volume pequeno de requisições.
Resumo
O valor deste artigo sobre o Super Agente da DeepSeek está em aplicar conceitos clássicos de engenharia de sistemas aos agentes. Estes são os principais pontos:
- O problema: em tarefas individuais, os modelos precisam cada vez menos de intervenção humana. Já em multitarefas, o gargalo está se deslocando para a atenção das pessoas.
- Cinco módulos: arquitetura em duas camadas, orientação a eventos, múltiplos canais full-duplex, separação entre estado da computação e ambiente, e Watchdog. Juntos, eles sustentam quatro características: continuidade, eficiência, proatividade e persistência.
- Limites das evidências: os dois experimentos usam cargas sintéticas e resultados relatados pelo próprio autor. Por isso, servem apenas como referência de projeto.
- Ordem de implementação: comece separando Router e Worker, depois adicione a filtragem por Trigger e, por fim, o Watchdog. Mantenha os limites de segurança como prioridade em todas as etapas.
Você não precisa definir a combinação de modelos de uma vez. Com a APIYI · apiyi.com, é possível comparar as opções em pequena escala usando o mesmo conjunto de tarefas e, depois, escolher a configuração com base na taxa de sucesso e nos custos.
Primeiro, deixe de ser um “Router humano”. Só depois pense em adicionar mais agentes.
Autor: Equipe técnica da APIYI
Troca de ideias sobre tecnologia: Entre em contato conosco pela página inicial da APIYI. Para mais informações, acesse a documentação em docs.apiyi.com.