Note de l’auteur : dans DeepSeek Harness, lorsque le niveau de raisonnement est réglé sur Max, comment choisir entre V4.1-Flash et V4-Pro ? Cet article les compare sous trois angles — intelligence, prix et vitesse — et explique pourquoi Flash est le choix par défaut pour coder, ainsi que les situations où Pro peut être préférable.
En ouvrant le menu déroulant des modèles de DeepSeek Harness, vous verrez deux options : DeepSeek-V4.1-Flash et DeepSeek-V4-Pro. À première vue, le modèle dont le nom contient « Pro » et qui compte davantage de paramètres devrait être plus intelligent. Mais une fois le niveau de raisonnement réglé sur Max, ce que veulent vraiment savoir les développeurs, c’est : lequel est le plus performant pour coder ? Et quelle différence y a-t-il en matière de prix et de vitesse ?
Cet article ne cherche pas à ménager la chèvre et le chou en concluant que « chacun a ses avantages ». Nous avons vérifié la page officielle des tarifs de DeepSeek, le journal des mises à jour, les benchmarks officiels et des tests indépendants. La conclusion est sans appel : pour coder dans DeepSeek Harness, choisissez Flash par défaut ; Pro convient surtout comme modèle d’appoint pour rechercher des connaissances ou des faits, ou lire de longs documents.
Ce que vous allez apprendre : à la fin de cet article, vous saurez à quelles versions correspondent Pro et Flash dans DeepSeek Harness, lequel est le plus performant en génération de code avec le raisonnement réglé sur Max, quelle différence il y a entre les deux en matière de coût et de vitesse, et comment passer de l’un à l’autre selon la tâche.
Quelles versions de Pro et Flash trouve-t-on dans DeepSeek Harness ?
Avant de se demander « lequel est le plus intelligent », il faut identifier le checkpoint auquel correspondent réellement les deux entrées de la liste DeepSeek Harness. Beaucoup gardent de Pro l’image d’une version antérieure, mais le nom d’un modèle et sa version réelle ne sont pas toujours mis à jour en même temps.
| Nom affiché dans Harness | ID API | Checkpoint réel | Statut |
|---|---|---|---|
| DeepSeek-V4.1-Flash | deepseek-flash |
V4.1-Flash-1017 (mise à jour du 17 octobre) | Modèle principal actuel, optimisé spécialement pour Harness |
| DeepSeek-V4-Pro | deepseek-v4-pro |
V4-Pro-0813 (GA du 13 août) | Toujours disponible, avec un positionnement de transition |
DeepSeek V4 Pro va-t-il être retiré ?
La rumeur selon laquelle « Pro va être retiré » circule depuis un moment, et elle a bien une origine. Lors de la sortie de V4.1 Flash, le 10 septembre, l’équipe avait effectivement annoncé l’arrêt du service V4 Pro après le 14 septembre. Mais la même note de mise à jour précisait juste après qu’à la demande de nombreux utilisateurs, l’API DeepSeek V4 Pro resterait disponible après le 14 septembre 2026, sans changement de tarification.
Pro reste donc utilisable normalement, mais son positionnement est désormais celui d’un produit de transition. V4.1 Pro n’a toujours pas été officiellement publié. À la fin octobre, une seule supposition a circulé au sujet d’un changement de nom du modèle sur le site officiel. Par ailleurs, les premières critiques selon lesquelles « Pro n’est pas à la hauteur » visaient surtout les problèmes de surapprentissage de la version préliminaire de V4-Pro. La version GA d’août les a nettement corrigés, mais ses capacités de codage restent globalement inférieures à celles de Flash.
Différence de taille entre DeepSeek Pro et Flash
Les deux modèles sont de tailles très différentes, ce qui explique pourquoi beaucoup pensent spontanément que Pro est plus puissant :
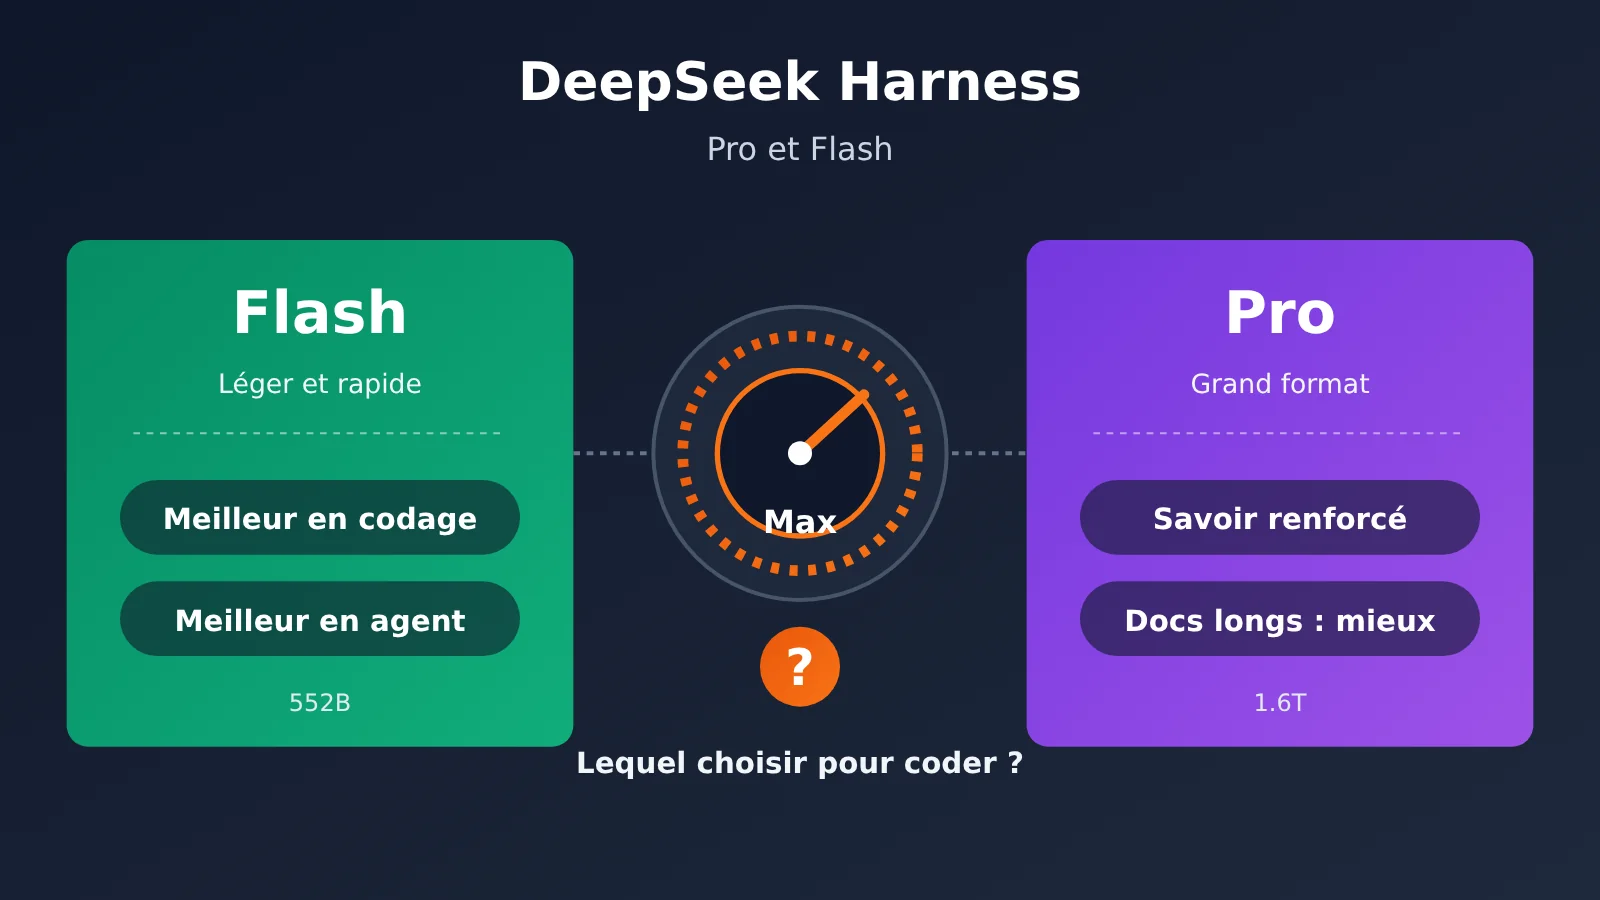
- Flash : architecture MoE de 552B de paramètres au total, environ 8B de paramètres activés en entrée et 16B en sortie, avec une fenêtre de contexte de 1M
- Pro : 1,6T de paramètres au total, environ 49B activés
V4.1 Flash appartient à une nouvelle famille d’architectures (CSA+HCA) et en est le modèle le plus compact. Il n’a pas été distillé à partir de Pro : grâce à sa nouvelle architecture et à un post-entraînement plus poussé, il a rattrapé puis dépassé Pro en codage et dans les tâches d’agent. Un plus grand nombre de paramètres ne signifie pas forcément de meilleures capacités de codage : c’est le principe à garder en tête pour comprendre toutes les conclusions de la suite.
DeepSeek Pro vs Flash : quelles différences clés, et lequel est le plus intelligent pour coder ?
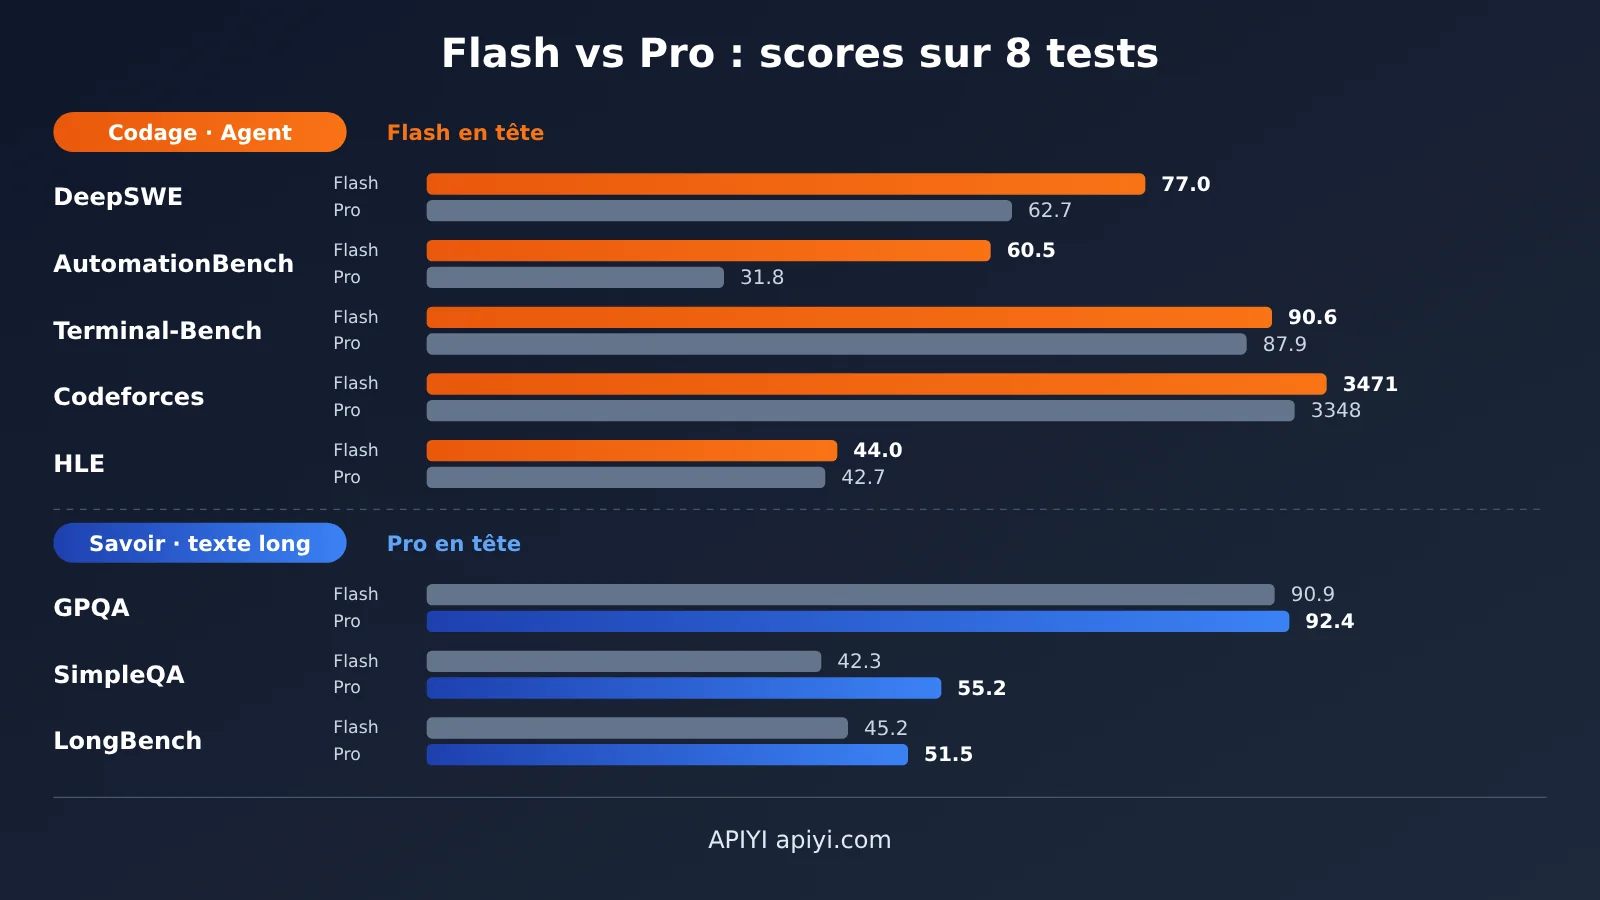
L’intelligence est le critère le plus important pour choisir un modèle, mais aussi celui qui risque le plus d’être faussé par la taille des paramètres. Voici les résultats des deux modèles sur des benchmarks officiels et publics :
| Benchmark | Capacité évaluée | V4.1-Flash-1017 | V4-Pro-0813 | Gagnant |
|---|---|---|---|---|
| DeepSWE v1.1 | Ingénierie logicielle sur de vrais dépôts | 77.0 | 62.7 | Flash (+14.3) |
| AutomationBench | Automatisation et flux de travail d’agents | 60.5 | 31.8 (43.2 selon une autre méthode de calcul) | Flash, largement |
| Terminal-Bench 2.1 | Utilisation du terminal et des outils | 90.6 | 87.9 | Flash |
| Codeforces | Concours d’algorithmique | 3471 | 3348 | Flash |
| HLE (texte uniquement) | Raisonnement général de haut niveau | 44.0 | 42.7 | Flash, de peu |
| GPQA Diamond | Questions scientifiques de niveau universitaire avancé | 90.9 | 92.4 | Pro |
| SimpleQA-Verified | Rappel de faits et taux d’hallucination | 42.3 | 55.2 | Pro (+12.9) |
| LongBench-V2 | Compréhension de longs documents | 45.2 | 51.5 | Pro |
DeepSeek Flash domine en code et pour les agents
Le tableau montre que dès qu’il s’agit d’écrire du code, d’utiliser des outils ou d’exécuter des boucles d’agent, Flash est généralement en tête. Son avance de plus de 14 points sur DeepSWE indique qu’il est nettement meilleur pour repérer des problèmes dans de vrais dépôts, modifier plusieurs fichiers et faire passer les tests. Son avance encore plus marquée sur AutomationBench correspond aux flux de travail Harness qui reposent sur plusieurs appels d’outils.
L’écart est moins important sur Terminal-Bench et Codeforces, mais la tendance reste la même. C’est aussi la conclusion des comparaisons indépendantes : dans les propres évaluations de DeepSeek, le modèle le moins cher l’emporte sur le plus grand pour la plupart des tâches de code et d’agent.
DeepSeek Pro reste meilleur pour les connaissances et les longs documents
Pro n’est pas sans intérêt. Son nombre total de paramètres, plus élevé, lui apporte un stock de connaissances générales plus important. Avec environ 13 points d’avance sur SimpleQA-Verified, il a moins tendance à halluciner sur des faits peu connus, des noms de personnes, des numéros de version ou des détails d’API. Il devance aussi Flash d’environ 6 points sur LongBench-V2 et obtient un résultat légèrement supérieur sur GPQA Diamond : la lecture approfondie de longs documents et les questions de connaissances à caractère universitaire font partie de ses points forts.
Une autre différence facile à oublier : Flash est le seul des deux modèles à prendre en charge les entrées visuelles. Pro ne peut pas lire les images. Dans Harness, si vous devez joindre une capture d’écran, une interface affichant une erreur ou une maquette, vous devez utiliser Flash.
DeepSeek Harness est optimisé spécialement pour Flash
Dans les notes de mise à jour de la version 1017, DeepSeek indique explicitement que cette mise à jour a été spécialement optimisée pour DeepSeek Harness et recommande de passer à Harness 0.2.1-rc.1 ou à une version ultérieure. Autrement dit, dans cette interface graphique, le format des appels d’outils de Flash, la gestion du contexte et son comportement en fin de tâche ont été adaptés spécifiquement. Pro, lui, ne bénéficie pas de cette optimisation.
Comparaison des prix de DeepSeek Pro et Flash : l’écart se creuse encore avec le raisonnement Max
Voici les tarifs unitaires indiqués sur la page officielle, en dollars par million de tokens. Le tarif de pointe figure avant la barre oblique, celui des heures creuses après :
| Poste facturé | Flash | Pro | Pro par rapport à Flash |
|---|---|---|---|
| Entrée (cache utilisé) | 0.006 / 0.003 | 0.044 / 0.022 | Environ 7,3× |
| Entrée (cache non utilisé) | 0.30 / 0.15 | 1.32 / 0.66 | Environ 4,4× |
| Sortie | 1.20 / 0.60 | 3.96 / 1.98 | Environ 3,3× |
| Limite de requêtes simultanées | 2500 | 500 | Flash est 5× plus élevé |
Le tarif hors pointe correspond à la moitié du tarif de pointe. Les heures de pointe sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine, soit de 09:00 à 12:00 et de 14:00 à 18:00, heure de Pékin. Le week-end, le tarif hors pointe s’applique toute la journée. Pour les tâches qui ne sont pas urgentes — comme une refactorisation ou la génération de tests en lot — les lancer le soir ou le week-end permet de diviser directement la facture par deux.
Pourquoi la facture de Pro augmente davantage avec le mode Max
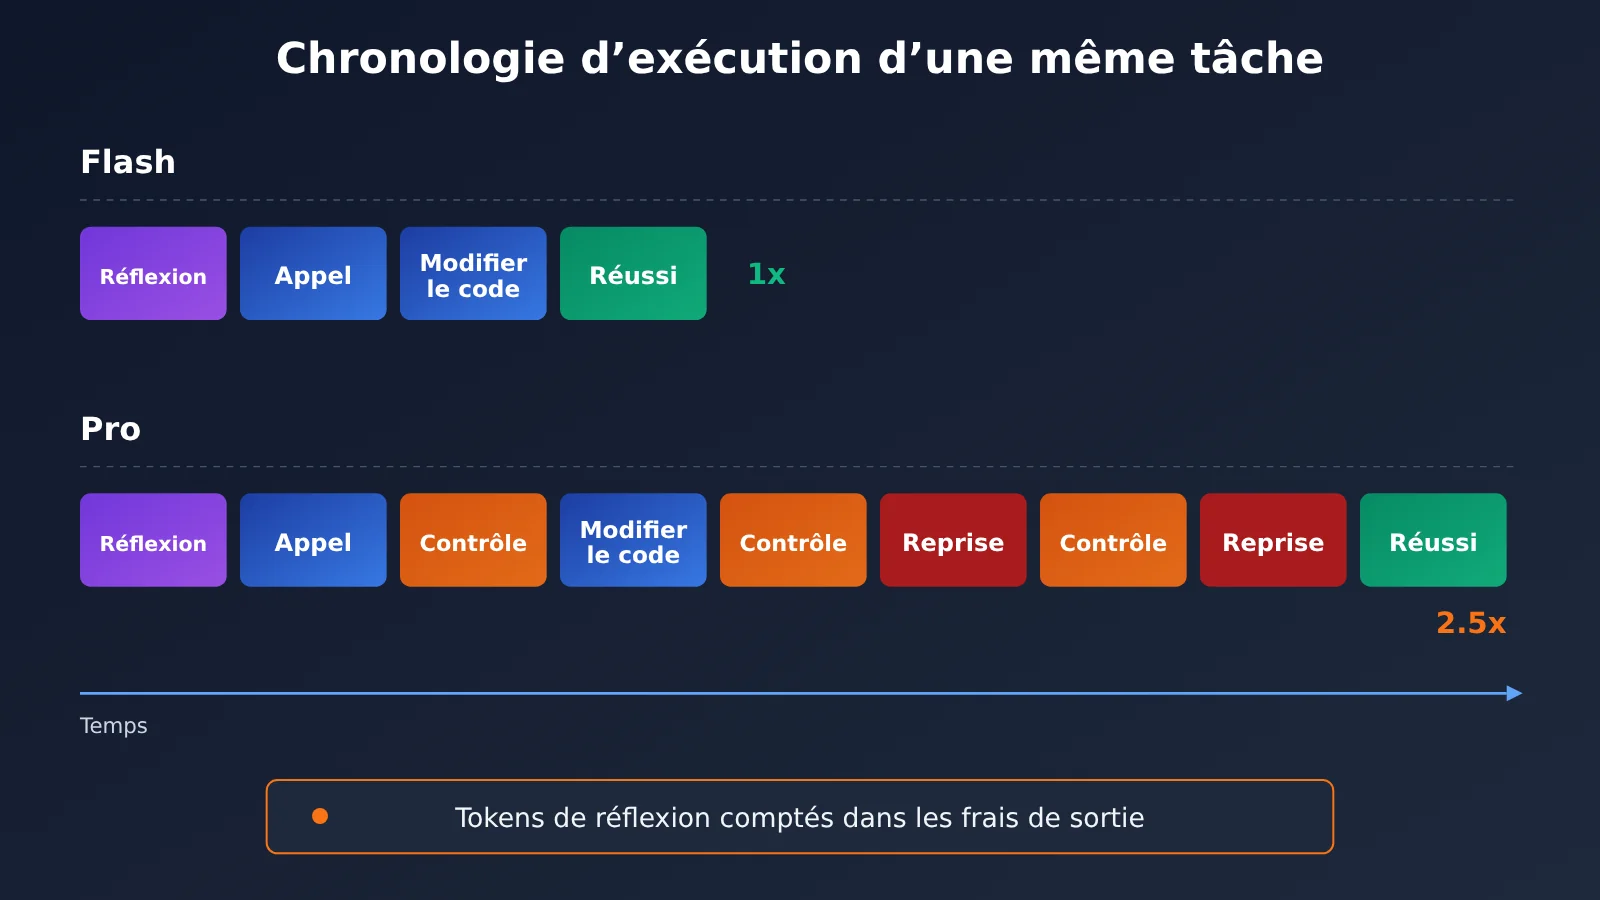
Le tableau des tarifs ne montre qu’une partie de l’écart. Lorsque le niveau de raisonnement est réglé sur Max, les tokens générés pendant la réflexion sont aussi facturés au tarif de sortie. Or, en mode Max, Pro a davantage tendance à réfléchir et à vérifier ses réponses à plusieurs reprises avant de donner un résultat final. Lors de tests indépendants, Pro a mis plus de 2,5 fois plus de temps que Flash à accomplir la même tâche, et a aussi nécessité davantage de reprises.
En pratique, l’écart de facture est donc souvent supérieur aux 3,3× d’écart indiqué dans le tableau pour le prix des sorties : Pro coûte plus cher à l’unité et génère aussi plus de tokens. Dans les boucles d’outils du Harness, qui peuvent facilement compter des dizaines d’itérations, ces coûts s’accumulent rapidement.
💰 Réduire les coûts : si vous utilisez DeepSeek dans plusieurs projets, ainsi que d’autres modèles comme Claude, GPT ou Gemini, vous pouvez centraliser la gestion des appels et des factures avec APIYI, sur apiyi.com. La plateforme propose une interface compatible avec OpenAI et une facturation à l’usage, ce qui facilite le choix des modèles selon les tâches et le contrôle des dépenses totales.
Comparaison de la vitesse de DeepSeek Flash et Pro
Flash dispose d’environ dix fois moins de paramètres actifs que Pro, tandis que sa limite de concurrence est cinq fois plus élevée. Résultat : la latence avant le premier token et la durée totale des tâches sont nettement plus courtes. Des mesures réelles ont même atteint environ 363 tok/s. Dans des scénarios comme Harness, qui enchaînent les appels d’outils et les itérations, gagner un peu de temps à chaque étape finit par accélérer considérablement l’ensemble de la tâche.
À noter : si Pro est plus lent, c’est surtout parce qu’il prend plus de temps pour réfléchir, et non parce qu’il manque de puissance de calcul. Le mode Max accentue sa tendance à peser le pour et le contre à répétition. Dans une boucle d’utilisation d’outils, il est donc souvent à la fois plus lent et sans meilleur résultat en contrepartie.
Le tableau ci-dessous récapitule les trois dimensions pour vous aider à vous faire rapidement une idée :
| Critère de comparaison | DeepSeek V4.1 Flash | DeepSeek V4 Pro | Gagnant |
|---|---|---|---|
| Programmation / refactorisation sur plusieurs fichiers | DeepSWE 77.0 | DeepSWE 62.7 | Flash |
| Agent / chaîne d’outils | AutomationBench 60.5 | AutomationBench 31.8 | Flash |
| Connaissances factuelles / faible taux d’hallucinations | SimpleQA 42.3 | SimpleQA 55.2 | Pro |
| Compréhension de longs documents | LongBench 45.2 | LongBench 51.5 | Pro |
| Entrées visuelles | Pris en charge | Non pris en charge | Flash |
| Prix | Environ trois fois moins cher que Pro en sortie | Prix unitaire élevé et réflexion plus longue | Flash |
| Vitesse et concurrence | Rapide, concurrence de 2500 | Lent, concurrence de 500 | Flash |
| Compatibilité avec Harness | Optimisé spécialement par le fabricant | Aucune optimisation spécifique | Flash |
Recommandations de scénarios pour DeepSeek Harness : quand choisir Pro ou Flash
Quand choisir DeepSeek Flash + Max
- Coder au quotidien et corriger des bugs : DeepSWE a 14 points d’avance, c’est l’indicateur le plus direct.
- Refactoriser plusieurs fichiers et modifier plusieurs modules : il faut une compréhension fiable du code et des boucles d’utilisation des outils assez longues.
- Utiliser le terminal, lancer des tests et exécuter des scripts : Flash est en tête sur Terminal-Bench et AutomationBench.
- Poser des questions à partir d’images : pour analyser une capture d’écran d’erreur, reproduire une interface ou examiner une maquette, seul Flash prend les images en charge.
- Poser des questions au quotidien et itérer rapidement : Flash est rapide et peu coûteux ; c’est avec lui que l’offre Max apporte le gain le plus net.
Quand choisir DeepSeek Pro + Max
- Rechercher des connaissances ou des faits peu connus : noms de personnes, versions de bibliothèques, paramètres précis d’une API ou événements historiques.
- Lire attentivement de longs documents ou des articles de recherche : Pro a environ 6 points d’avance sur LongBench-V2.
- Rédiger des textes non techniques fondés sur des connaissances : à privilégier si vous voulez des réponses s’appuyant sur davantage de références et contenant moins d’erreurs factuelles.
- Vérifier les réponses factuelles de Flash en les recoupant.
Quand éviter Pro
N’utilisez pas Pro pour de longues boucles d’utilisation des outils. En offre Max, il sera simplement plus lent et plus coûteux, sans avantage sur Terminal-Bench ni sur DeepSWE. C’est l’erreur la plus courante : croire qu’une tâche complexe nécessite un grand modèle de langage, puis constater que le temps d’exécution a doublé et que le résultat est moins bon.
Comment basculer entre DeepSeek Pro et Flash selon la tâche via l’API
Dans Harness, changer de modèle en cours de conversation n’entraîne aucun coût supplémentaire : les deux modèles utilisent la même interface compatible avec OpenAI. Si vous créez votre propre agent de codage en dehors de Harness, vous pouvez aussi mettre en place la même logique de routage avec du code. Voici l’exemple d’appel le plus simple :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible avec OpenAI d’APIYI
)

response = client.chat.completions.create(
    model="deepseek-flash",  # Flash est le modèle utilisé par défaut pour coder ; le nom du modèle dépend de la liste des modèles de la plateforme
    messages=[{"role": "user", "content": "用 Python 写一个带重试机制的 HTTP 请求函数"}]
)
print(response.choices[0].message.content)
Afficher le code complet : choisir automatiquement Pro ou Flash selon le type de tâche
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Correspondance entre les types de tâches et les modèles : Flash pour le code, les agents et la vision ; Pro pour les connaissances et les longs documents
TASK_MODEL_MAP = {
    "code": "deepseek-flash",
    "agent": "deepseek-flash",
    "vision": "deepseek-flash",      # Pro ne prend pas en charge les images en entrée
    "knowledge": "deepseek-v4-pro",  # Rappel factuel plus précis, hallucinations moins fréquentes
    "long_doc": "deepseek-v4-pro",   # Meilleure compréhension des longs documents
}

def ask_deepseek(
    prompt: str,
    task_type: str = "code",
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000,
) -> str:
    """Choisit un modèle DeepSeek selon le type de tâche et l'appelle."""
    model = TASK_MODEL_MAP.get(task_type, "deepseek-flash")

    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error ({model}): {e}"

# Pour coder : utiliser Flash
print(ask_deepseek("重构这段函数,拆分为三个职责单一的方法:...", task_type="code"))

# Pour consulter des détails sur une API : utiliser Pro
print(ask_deepseek("requests 库 Session 对象的 mount 方法有哪些参数?", task_type="knowledge"))
Cette logique de routage correspond à la conclusion de l’article : Flash comme modèle principal, et Pro réservé aux tâches liées aux connaissances. À la sortie de V4.1 Pro, il suffira de modifier une ligne dans la table de correspondance.
🚀 Pour commencer rapidement : nous vous recommandons d’obtenir une clé API et des crédits gratuits pour tester le service auprès d’APIYI, sur apiyi.com. Une seule clé permet d’appeler DeepSeek ainsi que les principaux modèles d’OpenAI, Claude, Gemini et d’autres. Vous pouvez utiliser directement le code ci-dessus pour comparer Flash et Pro sur votre propre dépôt.
DeepSeek Pro ou Flash : recommandations pour faire le bon choix
En tenant compte de l’intelligence, du prix et de la vitesse, voici comment choisir un modèle dans DeepSeek Harness :
- Utilisez Flash + Max par défaut : pour coder, refactoriser plusieurs fichiers, utiliser des outils, analyser des images ou répondre aux questions du quotidien. C’est aussi la configuration par défaut la plus adaptée dans Harness.
- Passez à Pro pour les tâches liées aux connaissances : connaissances pointues, numéros de version, détails d’API, faits historiques ou lecture approfondie de longs documents. C’est dans ces cas que Pro prend l’avantage, avec 13 points de plus sur SimpleQA et 6 points de plus sur LongBench.
- Évitez Pro pour les longues boucles d’utilisation d’outils : en mode Max, il est plus lent et plus cher, sans avantage sur les benchmarks de codage.
- Utilisez Flash pour tout tour où vous joignez une image : Pro ne prend pas en charge la vision.
- Gardez Pro comme solution de secours : avant la sortie officielle de V4.1 Pro, l’entrée Pro sert uniquement d’outil complémentaire pour les recherches de connaissances. Réévaluez ce choix à la sortie de la nouvelle version.
💡 Conseil : les scores des benchmarks ne donnent qu’une tendance générale. Selon votre base de code et votre logique métier, l’écart peut être plus ou moins important. Avec la même interface via APIYI (apiyi.com), testez Flash et Pro sur quelques tâches réelles de votre projet, puis comparez le taux de réussite, le temps d’exécution et la consommation de tokens pour choisir la configuration par défaut de votre équipe.
FAQ : questions fréquentes
Q1 : Quels modèles correspondent à Pro et Flash dans DeepSeek Harness ?
Flash correspond à `deepseek-flash`, qui est en réalité le modèle V4.1-Flash-1017 : un modèle MoE de 552B de paramètres au total, compatible avec les images et doté d’une fenêtre de contexte de 1M. Pro correspond à `deepseek-v4-pro`, qui est en réalité la version GA V4-Pro-0813 : 1,6T de paramètres au total, dont environ 49B activés, sans prise en charge des images en entrée.
Q2 : Pro a davantage de paramètres que Flash. Pourquoi est-il moins performant pour coder ?
Flash appartient à une famille d’architectures plus récente et a bénéficié d’un post-entraînement plus poussé. La version 1017 a également été optimisée spécifiquement pour Harness. Pro se distingue surtout par la quantité de connaissances que lui apporte son grand nombre de paramètres, et non par ses capacités de programmation ou d’utilisation d’outils. C’est pourquoi Flash est en tête sur DeepSWE, AutomationBench et Terminal-Bench, tandis que Pro l’emporte sur SimpleQA et LongBench.
Q3 : DeepSeek V4 Pro va-t-il être retiré ? Quand V4.1 Pro sera-t-il publié ?
L’annonce officielle indiquait d’abord que le service V4 Pro prendrait fin après le 14 septembre. Le même journal des modifications a ensuite précisé que le service API serait maintenu, sans changement de tarification. Le modèle reste donc disponible normalement. À ce jour, V4.1 Pro n’a pas encore été publié officiellement. Les seules informations évoquant son arrivée, fin octobre, reposent sur des suppositions liées à un changement d’identifiant de modèle sur le site officiel. Mieux vaut se fier au journal des modifications officiel.
Q4 : Avec le niveau de raisonnement réglé sur Max, quelle est la différence de coût entre Pro et Flash ?
À l’unité, les sorties de Pro coûtent environ 3,3 fois plus cher que celles de Flash. Pour les entrées sans correspondance dans le cache, le prix est environ 4,4 fois plus élevé ; pour les entrées reconnues par le cache, environ 7,3 fois plus élevé. Au niveau Max, les jetons de réflexion sont facturés comme des jetons de sortie. Or, Pro a davantage tendance à réfléchir plusieurs fois et à vérifier ses réponses : lors des tests, il a mis plus de 2,5 fois plus de temps que Flash. L’écart réel sur la facture dépasse donc souvent la différence de prix unitaire.
Q5 : Comment appeler DeepSeek Flash et Pro via une API, sans passer par Harness ?
Les deux modèles utilisent une interface compatible avec OpenAI. Il suffit de remplacer le paramètre `model` pour passer de l’un à l’autre :
1. Créez un compte sur APIYI, à l’adresse apiyi.com.
2. Récupérez votre clé API et le crédit gratuit offert aux nouveaux utilisateurs pour faire des essais.
3. Reprenez le code de cet article, définissez `base_url` sur `https://api.apiyi.com/v1` et indiquez le nom du modèle Flash ou Pro dans `model`.
Consultez la liste des modèles de la plateforme pour connaître les noms disponibles.
Q6 : Peut-on passer de Flash à Pro au milieu d’une même session ?
Oui, le changement n’entraîne aucun coût supplémentaire et les deux modèles utilisent la même interface. Une méthode courante consiste à coder avec Flash, puis à passer sur Pro pour vérifier un détail d’API ou un numéro de version incertain, avant de revenir à Flash pour poursuivre le développement. Seule précaution : pour un tour qui contient une image, Pro ne peut pas être utilisé.
Q7 : Quels sont les points faibles de DeepSeek Flash ?
Les limites de Flash concernent surtout ses connaissances : il obtient 42,3 sur SimpleQA-Verified, soit environ 13 points de moins que Pro. Il risque donc davantage d’inventer des réponses lorsqu’on l’interroge sur des faits peu connus ou des numéros de version précis. Sa compréhension des longs documents est également un peu moins bonne que celle de Pro. Pour y remédier, faites vérifier les faits importants par Pro ou fournissez directement les extraits de la documentation officielle dans l’invite. Si vous souhaitez aussi comparer les modèles d’autres fournisseurs, vous pouvez les tester sur APIYI, à l’adresse apiyi.com, en utilisant la même clé API.
Points clés pour choisir entre DeepSeek Pro et Flash
- Pour coder, choisissez Flash par défaut : 77,0 contre 62,7 sur DeepSWE ; Flash est nettement meilleur en programmation et en capacités d’agent.
- Pro se distingue par ses connaissances : il devance Flash d’environ 13 points sur SimpleQA et de 6 points sur LongBench. Il convient mieux aux recherches factuelles et à la lecture de textes longs.
- Un plus grand nombre de paramètres ne signifie pas forcément de meilleures capacités en programmation : Flash dépasse Pro grâce à une nouvelle architecture et à un post-entraînement optimisé ; ce n’est pas une version distillée de Pro.
- L’écart de coût s’accentue avec le mode Max : Pro réfléchit plus longtemps, et la facture réelle dépasse l’écart de 3,3 fois entre leurs tarifs de sortie.
- Flash l’emporte en vitesse et en concurrence : il mobilise un ordre de grandeur de paramètres en moins et son plafond de requêtes simultanées est cinq fois supérieur à celui de Pro.
- Pour traiter des images, seul Flash convient : Pro ne prend pas en charge les entrées visuelles.
- Vérifiez avec des tâches réelles : vous pouvez comparer les deux modèles sur votre propre projet grâce à l’interface unifiée d’APIYI.
En résumé
Dans DeepSeek Harness, lorsque le niveau de raisonnement est réglé sur Max, le choix entre Pro et Flash est simple :
- Capacités : Flash est meilleur pour coder, exécuter des agents et utiliser des outils ; Pro est plus performant pour les recherches documentaires et la lecture de longs documents.
- Prix : le tarif de Flash représente environ un tiers à un septième de celui de Pro. En mode Max, l’écart est encore plus marqué, et les tarifs peuvent être divisés par deux aux heures creuses.
- Vitesse : Flash génère le premier token et termine les requêtes nettement plus vite. Son plafond de requêtes simultanées est cinq fois supérieur à celui de Pro, et il bénéficie d’optimisations spécifiques à Harness.
En bref : faites de Flash votre modèle principal par défaut et utilisez Pro en complément pour les recherches documentaires. Réévaluez ce choix à la sortie officielle de V4.1 Pro. Pour vérifier cette conclusion sur votre propre base de code, vous pouvez utiliser APIYI (apiyi.com) : une seule clé API suffit pour appeler les deux modèles, les comparer sur des tâches réelles, puis choisir la configuration par défaut de votre équipe.
📚 Références
- Journal des mises à jour officiel de DeepSeek : lancement de V4.1 Flash, maintien du service V4 Pro et recommandations d’optimisation de la version 1017 pour Harness
- Lien :
api-docs.deepseek.com/updates -
À retenir : une source de première main pour vérifier les versions des modèles, leur disponibilité et les versions recommandées de Harness
-
Page officielle des tarifs de DeepSeek : prix des entrées et sorties pour Flash et Pro, plages horaires creuses et de pointe, limites de concurrence
- Lien :
api-docs.deepseek.com/quick_start/pricing -
À retenir : une référence pour calculer le coût réel des appels et planifier les traitements par lots pendant les heures creuses
-
Comparatif des modèles DeepSeek de Respan pour 2026 : évaluation comparative réalisée par un tiers
- Lien :
respan.ai/articles/deepseek-model-comparison - À retenir : un point de vue indépendant qui confirme que « les modèles moins chers obtiennent de meilleurs résultats dans la plupart des tâches de codage et d’agent »
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel d’APIYI. Pour en savoir plus sur l’intégration des modèles, consultez le centre de documentation à l’adresse docs.apiyi.com.