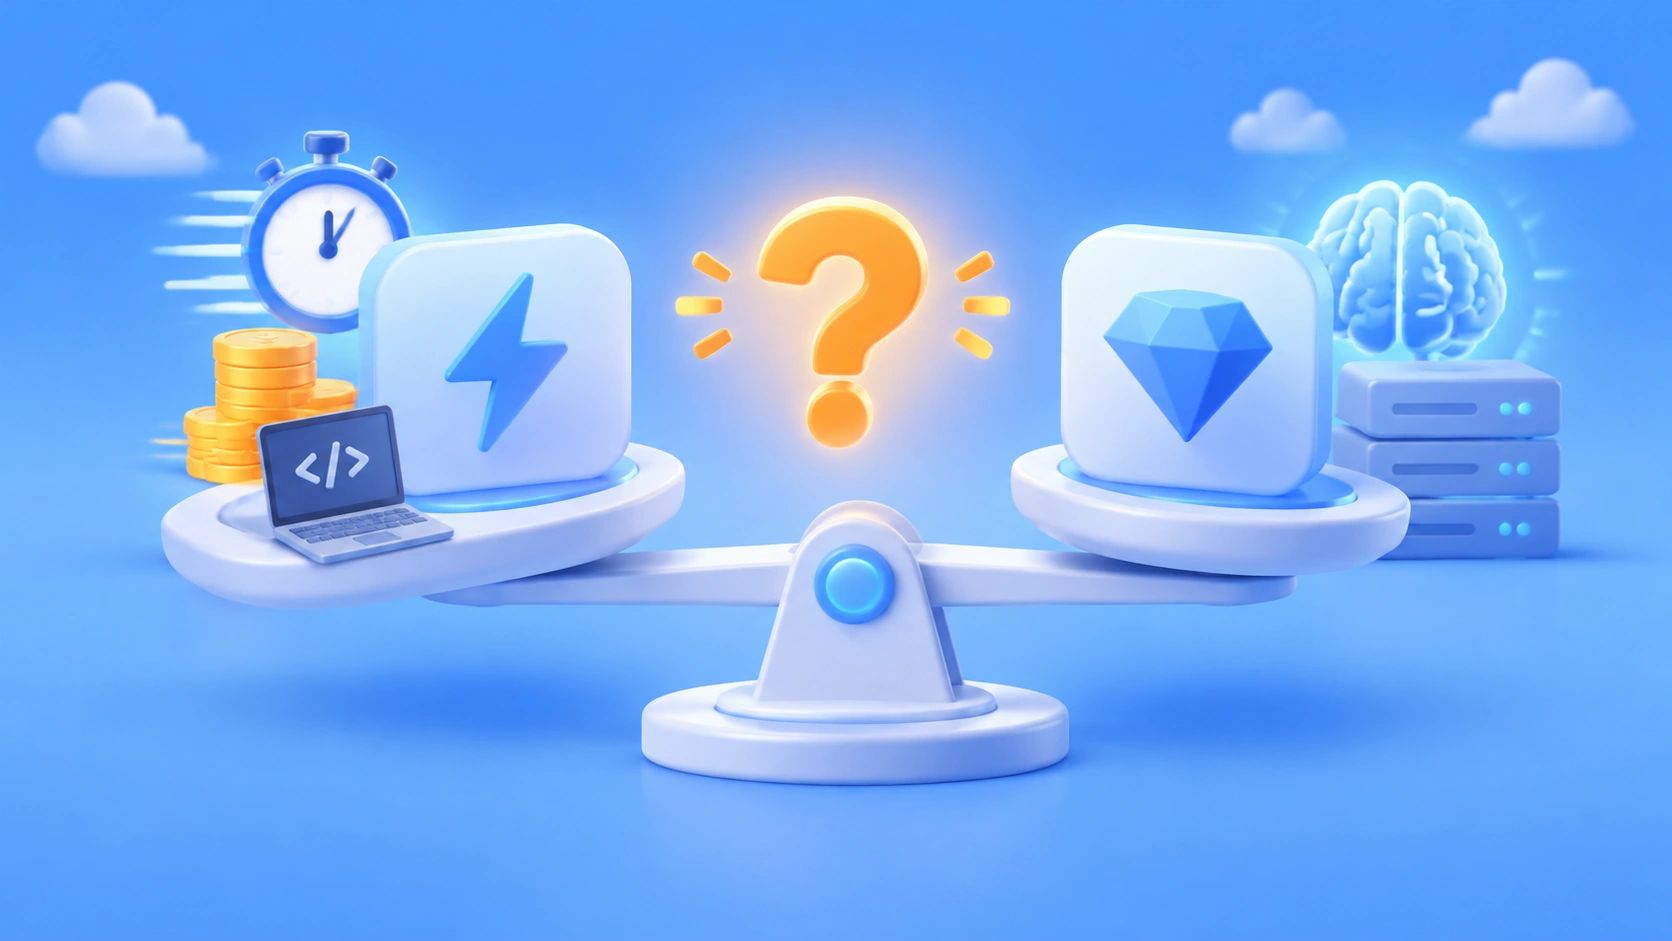
Примечание автора: если в DeepSeek Harness выставить максимальный уровень рассуждений, что выбрать — V4.1-Flash или V4-Pro? В этой статье сравним их по интеллектуальным возможностям, цене и скорости. Разберёмся, почему для написания кода по умолчанию стоит выбирать Flash и в каких случаях лучше переключиться на Pro.
В раскрывающемся списке моделей DeepSeek Harness вы увидите два варианта: DeepSeek-V4.1-Flash и DeepSeek-V4-Pro. По привычке можно решить, что модель с пометкой Pro и большим числом параметров должна быть умнее. Но если выставить максимальный уровень рассуждений, разработчиков в первую очередь волнует другое: какая модель лучше пишет код? И насколько они различаются по цене и скорости?
Это не компромиссный разбор в духе «у каждой свои плюсы». Мы сверили официальную страницу цен DeepSeek, журнал обновлений, официальные результаты тестов и сторонние замеры. Вывод однозначный: для написания кода в DeepSeek Harness по умолчанию выбирайте Flash; Pro подойдёт только как вспомогательная модель для поиска знаний и фактов, а также чтения длинных документов.
Главное: прочитав статью, вы узнаете, каким версиям соответствуют Pro и Flash в DeepSeek Harness, какая модель лучше пишет код при максимальном уровне рассуждений, насколько различаются стоимость и скорость и как переключаться между ними в зависимости от задачи.
Какие версии Pro и Flash представлены в DeepSeek Harness
Прежде чем обсуждать, «кто умнее», нужно разобраться, каким контрольным точкам (checkpoint) соответствуют две модели в списке DeepSeek Harness. Многие до сих пор судят о Pro по ранним версиям, хотя название модели и её фактическая версия обновляются не всегда одновременно.
| Название в списке Harness | API ID | Фактическая контрольная точка | Статус выпуска |
|---|---|---|---|
| DeepSeek-V4.1-Flash | deepseek-flash |
V4.1-Flash-1017 (обновлена 17 октября) | Основная актуальная модель, специально оптимизированная для Harness |
| DeepSeek-V4-Pro | deepseek-v4-pro |
V4-Pro-0813 (GA 13 августа) | По-прежнему доступна, но теперь скорее переходный вариант |
DeepSeek V4 Pro снимут с обслуживания?
В сообществе давно ходят разговоры о том, что Pro собираются отключить, и у них есть основания. Когда 10 сентября вышла V4.1 Flash, компания действительно объявила, что после 14 сентября перестанет обслуживать V4 Pro. Однако в той же записи об обновлении вскоре появилось уточнение: по многочисленным просьбам пользователей API DeepSeek V4 Pro продолжит работать и после 14 сентября 2026 года, а условия оплаты останутся прежними.
Поэтому Pro пока можно использовать как обычно, но теперь это переходный продукт. V4.1 Pro до сих пор официально не выпущена. В конце октября лишь появились предположения, основанные на изменении обозначений моделей на официальном сайте. Кроме того, ранняя критика Pro была связана в основном с проблемой переобучения в предварительной версии V4-Pro. В версии GA, вышедшей в августе, ситуация заметно улучшилась, но по общим возможностям программирования модель всё ещё уступает Flash.
Разница в размере параметров DeepSeek Pro и Flash
Модели сильно различаются по размеру — поэтому многие и считают, что Pro должна быть мощнее:
- Flash: архитектура MoE с 552B параметров в общей сложности; во входном режиме активируется около 8B, в выходном — около 16B; поддерживает контекстное окно 1M
- Pro: 1.6T параметров в общей сложности, активируется около 49B
V4.1 Flash относится к новому семейству архитектур (CSA+HCA) и представляет в нём самый компактный вариант. Её не дистиллировали из Pro: благодаря новой архитектуре и более полноценной посттренировке Flash сравнялась с Pro и превзошла её в задачах программирования и работы с агентами. Больше параметров не значит, что модель лучше пишет код — это ключевой тезис для всех выводов ниже.
DeepSeek Pro и Flash: ключевые отличия и выбор модели для программирования
При выборе модели интеллект — один из важнейших критериев. И именно здесь проще всего ошибиться, ориентируясь только на размер модели. Ниже — сравнение результатов двух моделей в официальных и общедоступных бенчмарках:
| Бенчмарк | Проверяемые способности | V4.1-Flash-1017 | V4-Pro-0813 | Победитель |
|---|---|---|---|---|
| DeepSWE v1.1 | Разработка ПО в реальных репозиториях | 77.0 | 62.7 | Flash (+14.3) |
| AutomationBench | Автоматизация и процессы Agent | 60.5 | 31.8 (по другой методике — 43.2) | Flash с большим отрывом |
| Terminal-Bench 2.1 | Работа с терминалом и инструментами | 90.6 | 87.9 | Flash |
| Codeforces | Соревнования по алгоритмам | 3471 | 3348 | Flash |
| HLE (только текст) | Сложные комплексные рассуждения | 44.0 | 42.7 | Flash, с небольшим отрывом |
| GPQA Diamond | Ответы на научные вопросы уровня аспирантуры | 90.9 | 92.4 | Pro |
| SimpleQA-Verified | Воспроизведение фактов и частота галлюцинаций | 42.3 | 55.2 | Pro (+12.9) |
| LongBench-V2 | Понимание длинных документов | 45.2 | 51.5 | Pro |
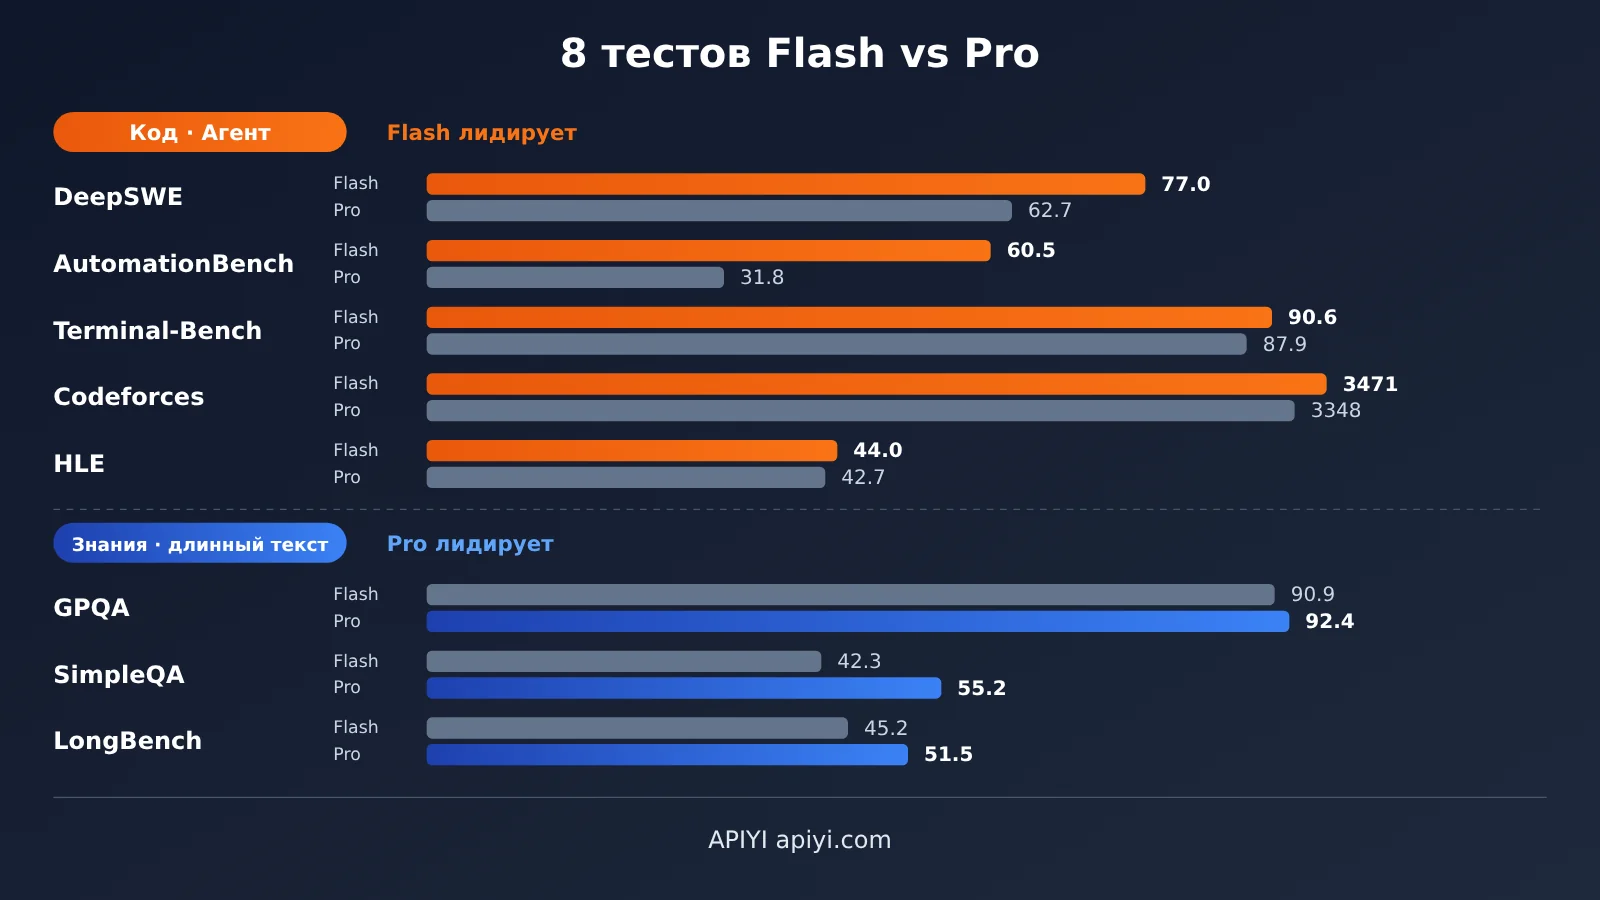
DeepSeek Flash заметно лучше справляется с кодом и задачами Agent
Как видно из таблицы, Flash выигрывает почти во всех задачах, связанных с написанием кода, вызовом инструментов и циклами работы Agent. Преимущество более чем в 14 баллов на DeepSWE говорит о том, что Flash гораздо лучше находит проблемы в реальных репозиториях, вносит изменения в нескольких файлах и проходит тесты. Ещё заметнее разрыв на AutomationBench — этот результат соответствует работе Harness с многоэтапными вызовами инструментов.
Разрыв в Terminal-Bench и Codeforces не такой большой, но тенденция та же. К такому же выводу пришли и сторонние сравнения: по собственным тестам DeepSeek более дешёвая модель превосходит более крупную в большинстве задач на написание кода и Agent.
DeepSeek Pro сохраняет преимущество в знаниях и работе с длинными документами
Pro тоже полезна. Больший общий размер модели даёт ей более обширный запас знаний о мире. Преимущество примерно в 13 баллов на SimpleQA-Verified означает, что Pro реже галлюцинирует, отвечая на вопросы о малоизвестных фактах, именах, версиях и деталях API. Она также примерно на 6 баллов опережает Flash на LongBench-V2 и немного превосходит её на GPQA Diamond. Это показывает, что её сильные стороны — внимательное чтение длинных документов и ответы на вопросы из академических областей.
Есть и ещё одно различие, которое легко упустить: Flash — единственная из двух моделей, которая поддерживает визуальный ввод. Pro не умеет читать изображения, поэтому, если в Harness нужно приложить скриншот, окно с ошибкой или макет, придётся использовать Flash.
DeepSeek Harness специально оптимизировали для Flash
В примечаниях к обновлению версии 1017 официально указано, что в этот раз оптимизации были специально направлены на DeepSeek Harness. Пользователям рекомендуют обновиться до Harness 0.2.1-rc.1 или более новой версии. Это значит, что в этом GUI формат вызова инструментов, управление контекстом и завершение работы Flash специально адаптировали, а Pro такой оптимизации не получил.
Сравнение цен на DeepSeek Pro и Flash: с режимом Max разница ещё больше
Ниже указаны цены с официальной страницы. Стоимость приведена в долларах за миллион токенов: до косой черты — цена в часы пик, после неё — в непиковое время.
| Статья расходов | Flash | Pro | Во сколько раз Pro дороже Flash |
|---|---|---|---|
| Ввод (попадание в кэш) | 0.006 / 0.003 | 0.044 / 0.022 | примерно в 7.3 раза |
| Ввод (промах кэша) | 0.30 / 0.15 | 1.32 / 0.66 | примерно в 4.4 раза |
| Вывод | 1.20 / 0.60 | 3.96 / 1.98 | примерно в 3.3 раза |
| Лимит параллельных запросов | 2500 | 500 | у Flash в 5 раз выше |
В непиковое время цены вдвое ниже, чем в часы пик. Пиковые часы — с 01:00 до 04:00 и с 06:00 до 10:00 UTC в рабочие дни, то есть с 09:00 до 12:00 и с 14:00 до 18:00 по пекинскому времени. По выходным весь день действует непиковый тариф. Если у вас есть срочности с массовым рефакторингом или генерацией тестов нет, запускайте такие задачи вечером или в выходные — расходы сразу сократятся вдвое.
Почему с включённым Max счета за Pro становятся выше
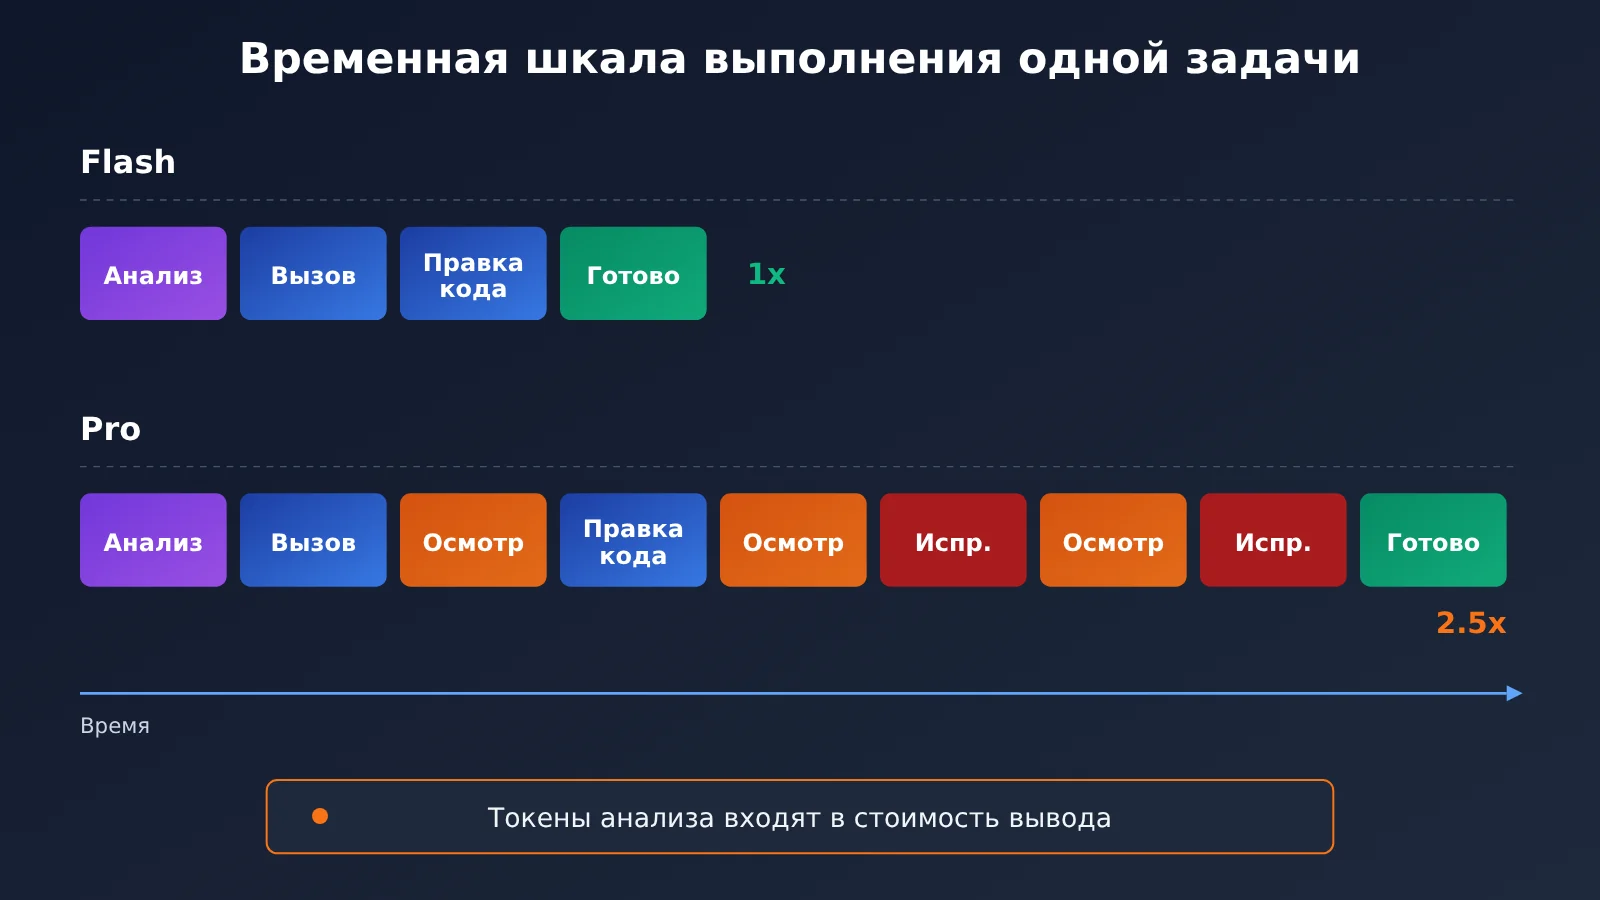
Таблица цен отражает лишь часть разницы. При максимальном уровне рассуждений токены, потраченные на ход рассуждений, тоже тарифицируются как вывод. В режиме Max Pro чаще обдумывает задачу и перепроверяет себя, прежде чем выдать итоговый результат. По результатам сторонних тестов, выполнение одной и той же задачи на Pro занимало более чем в 2.5 раза больше времени, чем на Flash, а переделок было больше.
Поэтому фактическая разница в счетах обычно превышает 3.3-кратную разницу в цене за вывод, указанную в таблице: у Pro выше не только цена за токен, но и самих токенов генерируется больше. В циклах работы с инструментами в Harness, которые легко растягиваются на десятки итераций, эти расходы постоянно растут.
💰 Как сократить расходы: если вы используете DeepSeek сразу в нескольких проектах, а также другие модели — Claude, GPT, Gemini и т. д. — можно управлять вызовами и расходами из одного места через APIYI apiyi.com. Платформа поддерживает совместимый с OpenAI интерфейс и оплату по фактическому использованию. Это позволяет выбирать модели под разные задачи и контролировать общие расходы.
Сравнение скорости DeepSeek Flash и Pro
У Flash примерно на порядок меньше активных параметров, а лимит параллельных запросов в 5 раз выше, чем у Pro. Поэтому и задержка до первого токена, и общее время выполнения задачи заметно меньше. В тестах скорость достигала примерно 363 токенов/с. В сценариях вроде Harness, где нужно многократно вызывать инструменты и проходить несколько итераций, даже небольшое ускорение каждого цикла в итоге существенно сокращает время всей задачи.
Важно учитывать: Pro медленнее главным образом потому, что дольше размышляет, а не из-за нехватки вычислительных ресурсов. Тариф Max усиливает склонность модели многократно всё обдумывать, поэтому в циклах работы с инструментами она часто оказывается одновременно медленнее и не даёт лучшего результата.
В таблице сведены три ключевых аспекта — так проще быстро сравнить модели:
| Критерий | DeepSeek V4.1 Flash | DeepSeek V4 Pro | Победитель |
|---|---|---|---|
| Написание кода / рефакторинг нескольких файлов | DeepSWE 77.0 | DeepSWE 62.7 | Flash |
| Агентные сценарии / цепочки инструментов | AutomationBench 60.5 | AutomationBench 31.8 | Flash |
| Фактические знания / низкий уровень галлюцинаций | SimpleQA 42.3 | SimpleQA 55.2 | Pro |
| Понимание длинных документов | LongBench 45.2 | LongBench 51.5 | Pro |
| Визуальный ввод | Поддерживается | Не поддерживается | Flash |
| Цена | Стоимость вывода — примерно треть от Pro | Высокая цена за токен и более длительные размышления | Flash |
| Скорость и параллельные запросы | Быстро, лимит — 2500 | Медленно, лимит — 500 | Flash |
| Оптимизация для Harness | Специально оптимизирована разработчиками | Специальной оптимизации нет | Flash |
Рекомендации по выбору DeepSeek Harness: для каких задач подходят Pro и Flash
Когда выбирать DeepSeek Flash + Max
- Повседневное программирование и исправление багов: DeepSWE опережает конкурентов на 14 баллов — это самый наглядный аргумент
- Рефакторинг нескольких файлов и изменения в разных модулях: здесь важно стабильное понимание кода и длительные циклы работы с инструментами
- Работа в терминале, запуск тестов и выполнение скриптов: модели лидируют и в Terminal-Bench, и в AutomationBench
- Вопросы по изображениям: анализ скриншотов с ошибками, воссоздание интерфейса и работа с макетами — только Flash умеет обрабатывать изображения
- Повседневные вопросы и быстрая итерация: высокая скорость и низкая стоимость; переход на тариф Max особенно заметно повышает качество Flash
Когда выбирать DeepSeek Pro + Max
- Поиск редких знаний и фактов: имена, версии библиотек, конкретные параметры API, исторические события
- Внимательное изучение длинных документов и научных статей: в LongBench-V2 модель опережает конкурентов примерно на 6 баллов
- Неформальные тексты на темы, требующие знаний, но не связанные с кодом: подходит, когда нужны более разнообразные источники и меньше фактических ошибок
- Перекрёстная проверка фактических ответов Flash
Когда Pro использовать не стоит
Не запускайте на Pro длительные циклы работы с инструментами. На тарифе Max модель будет только медленнее и дороже, а преимущества в Terminal-Bench и DeepSWE у неё нет. Это самая распространённая ошибка: считать, что для сложной задачи обязательно нужна большая языковая модель, — в итоге время выполнения удваивается, а результат становится хуже.
Как переключать DeepSeek Pro и Flash через API в зависимости от задачи
В Harness переключать модели в середине одной сессии можно без дополнительных затрат: обе используют один и тот же интерфейс, совместимый с OpenAI. Если вы создаёте кодового агента самостоятельно, вне Harness, такую же логику маршрутизации можно реализовать в коде. Вот самый простой пример вызова:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI — интерфейс, совместимый с OpenAI
)

response = client.chat.completions.create(
    model="deepseek-flash",  # Для написания кода по умолчанию используется Flash; название модели уточняйте в списке моделей платформы
    messages=[{"role": "user", "content": "用 Python 写一个带重试机制的 HTTP 请求函数"}]
)
print(response.choices[0].message.content)
Посмотреть полный пример: автоматический выбор Pro или Flash в зависимости от типа задачи
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Соответствие типов задач и моделей: программирование / агент / зрение — Flash, знания / длинные документы — Pro
TASK_MODEL_MAP = {
    "code": "deepseek-flash",
    "agent": "deepseek-flash",
    "vision": "deepseek-flash",      # Pro не поддерживает ввод изображений
    "knowledge": "deepseek-v4-pro",  # Точнее вспоминает факты, реже галлюцинирует
    "long_doc": "deepseek-v4-pro",   # Лучше понимает длинные документы
}

def ask_deepseek(
    prompt: str,
    task_type: str = "code",
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000,
) -> str:
    """Выбирает модель DeepSeek в зависимости от типа задачи и отправляет запрос"""
    model = TASK_MODEL_MAP.get(task_type, "deepseek-flash")

    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error ({model}): {e}"

# Для написания кода используем Flash
print(ask_deepseek("重构这段函数,拆分为三个职责单一的方法:...", task_type="code"))

# Для поиска деталей API используем Pro
print(ask_deepseek("requests 库 Session 对象的 mount 方法有哪些参数?", task_type="knowledge"))
Логика маршрутизации соответствует выводам статьи: основная модель — Flash, а Pro используется только для задач, связанных со знаниями. Когда выйдет Pro версии V4.1, достаточно будет изменить одну строку в таблице соответствий.
🚀 Быстрый старт: рекомендуем получить API-ключ и бесплатный тестовый лимит для новых пользователей на APIYI apiyi.com. С одним ключом можно вызывать DeepSeek, а также ведущие модели OpenAI, Claude, Gemini и других компаний. Используйте код выше, чтобы сравнить Flash и Pro на собственном проекте.
DeepSeek Pro или Flash: рекомендации по выбору
Если учитывать три фактора — интеллект, цену и скорость, — выбор модели в DeepSeek Harness можно свести к нескольким рекомендациям:
- По умолчанию используйте Flash + Max: для написания кода, рефакторинга нескольких файлов, работы с инструментами, анализа изображений и повседневных вопросов. Это оптимальная конфигурация по умолчанию для Harness.
- Для задач, требующих знаний, переключайтесь на Pro: редкие сведения, номера версий, особенности API, исторические факты и подробный анализ длинных документов — именно в таких сценариях Pro опережает Flash на 13 баллов в SimpleQA и на 6 баллов в LongBench.
- Не используйте Pro для длительных циклов работы с инструментами: в режиме Max он медленнее и дороже, а в бенчмарках для программирования преимуществ у него нет.
- Для запросов с изображениями обязательно используйте Flash: у Pro нет возможностей компьютерного зрения.
- Держите Pro как запасной вариант: до официального выхода V4.1 Pro используйте его только как вспомогательный инструмент для поиска знаний. После выхода новой версии оцените его заново.
💡 Рекомендация: результаты тестов показывают лишь общую тенденцию. На вашей кодовой базе и в вашей бизнес-логике разница может оказаться как больше, так и меньше. Попробуйте через APIYI — apiyi.com — выполнить несколько реальных задач своего проекта с помощью Flash и Pro через один и тот же интерфейс. Сравните долю успешных выполнений, время и расход токенов, а затем выберите конфигурацию по умолчанию для команды.
Часто задаваемые вопросы
Вопрос 1. Какие модели стоят за Pro и Flash в DeepSeek Harness?
Flash — это `deepseek-flash`, фактически V4.1-Flash-1017: MoE-модель с 552 млрд параметров, поддержкой изображений и контекстным окном на 1 млн токенов. Pro — это `deepseek-v4-pro`, фактически версия V4-Pro-0813 GA с 1,6 трлн параметров, из которых активны около 49 млрд. Она не поддерживает ввод изображений.
Вопрос 2. Почему Pro с бо́льшим количеством параметров пишет код хуже, чем Flash?
Flash относится к более новому семейству архитектур и прошёл более основательное постобучение. Версию 1017 также специально оптимизировали для Harness. Сильная сторона Pro — обширные знания, обеспеченные большим количеством параметров, а не написание кода и работа с инструментами. Поэтому Flash лидирует в DeepSWE, AutomationBench и Terminal-Bench, а Pro — в SimpleQA и LongBench.
Вопрос 3. Отключат ли DeepSeek V4 Pro? Когда выйдет V4.1 Pro?
Ранее компания сообщила, что после 14 сентября прекратит обслуживание V4 Pro. Позже в том же журнале обновлений объявили, что API останется доступным, а тарифы не изменятся. Поэтому сейчас моделью можно пользоваться как обычно. На данный момент V4.1 Pro официально не выпущена. В конце октября появились лишь предположения, связанные с изменением обозначений моделей на официальном сайте. Ориентируйтесь на официальный журнал обновлений.
Вопрос 4. Насколько различаются расходы на Pro и Flash при максимальном уровне рассуждений?
Цена вывода у Pro примерно в 3,3 раза выше, чем у Flash. Ввод без попадания в кэш обходится примерно в 4,4 раза дороже, а ввод с попаданием в кэш — примерно в 7,3 раза. На уровне Max токены рассуждений учитываются в стоимости вывода. Кроме того, Pro чаще повторно обдумывает ответ и проверяет себя: по результатам тестов, он работает более чем в 2,5 раза дольше Flash. Поэтому фактическая разница в счёте обычно превышает разницу в цене за токен.
Вопрос 5. Как вызывать DeepSeek Flash и Pro через API вне Harness?
Обе модели используют совместимый с OpenAI интерфейс. Чтобы переключиться между ними, достаточно изменить параметр model:
1. Зарегистрируйтесь на APIYI — apiyi.com.
2. Получите API-ключ и бесплатный тестовый лимит для новых пользователей.
3. Используйте код из этой статьи, укажите `https://api.apiyi.com/v1` в `base_url`, а в `model` — название нужной модели Flash или Pro.
Актуальные названия моделей смотрите в списке моделей на платформе.
Вопрос 6. Можно ли переключиться с Flash на Pro в середине одного диалога?
Да, переключение не требует дополнительных действий: обе модели используют один и тот же интерфейс. Например, код можно писать с помощью Flash, при необходимости переключиться на Pro, чтобы уточнить детали API или номер версии, а затем вернуться к Flash и продолжить работу. Учтите только, что запрос с изображением нельзя отправить в Pro.
Вопрос 7. Какие недостатки есть у DeepSeek Flash?
Flash уступает в основном в знаниях: результат SimpleQA-Verified — всего 42,3, примерно на 13 баллов ниже, чем у Pro. На редкие факты, конкретные номера версий и подобные вопросы Flash чаще отвечает галлюцинациями. Он также немного хуже Pro справляется с пониманием длинных документов. Важные факты стоит перепроверять с помощью Pro или сразу добавлять в промпт текст официальной документации. Если нужно сравнить модели разных компаний, можно переключаться между ними с одним и тем же ключом через APIYI (apiyi.com).
DeepSeek Pro и Flash: ключевые выводы
- Для написания кода по умолчанию выбирайте Flash: 77,0 против 62,7 в DeepSWE — Flash значительно лучше справляется с кодированием и задачами Agent
- Сильная сторона Pro — знания: примерно на 13 баллов выше результат SimpleQA и на 6 баллов — LongBench. Pro лучше подходит для проверки фактов и чтения длинных текстов
- Больше параметров — не значит лучше пишет код: Flash обходит Pro благодаря новой архитектуре и дообучению, а не потому, что это дистиллированная версия Pro
- Режим Max увеличивает разницу в стоимости: Pro дольше обдумывает ответ, поэтому итоговый счёт может оказаться выше, чем следует из разницы в 3,3 раза между ценами за вывод
- По скорости и параллельной обработке выигрывает Flash: активируемых параметров на порядок меньше, а лимит параллельных запросов в 5 раз выше, чем у Pro
- Изображения принимает только Flash: Pro не поддерживает визуальный ввод
- Проверяйте модели на реальных задачах: сравнить их в собственном проекте можно через единый интерфейс APIYI
Итоги
В DeepSeek Harness выбрать между Pro и Flash несложно, если для обеих моделей установить максимальный уровень рассуждений:
- Интеллект: для написания кода, работы с агентами и вызова инструментов лучше подходит Flash; для поиска знаний и чтения длинных документов — Pro.
- Цена: базовая стоимость Flash примерно в 3–7 раз ниже, чем у Pro. На максимальном уровне рассуждений разница ещё заметнее, а в непиковые часы цена может снизиться вдвое.
- Скорость: у Flash значительно короче время до первого токена и общее время ответа. Лимит параллельных запросов в 5 раз выше, чем у Pro; кроме того, Flash получил специальные оптимизации для Harness.
Итог: используйте Flash как основную модель по умолчанию, а Pro — как дополнительный вариант для поиска знаний. Пересмотрите этот выбор после официального выхода V4.1 Pro. Чтобы проверить вывод на собственном коде, рекомендуем через APIYI apiyi.com вызывать обе модели с одним API-ключом, сравнить их на реальных задачах и уже после этого выбрать настройки по умолчанию для команды.
📚 Источники
- Официальный журнал обновлений DeepSeek: выход V4.1 Flash, продолжение обслуживания V4 Pro и сведения об оптимизациях версии 1017 для Harness
- Ссылка:
api-docs.deepseek.com/updates -
Примечание: первоисточник для проверки версий моделей, статуса их выпуска и рекомендаций по версиям Harness
-
Официальная страница цен DeepSeek: стоимость входных и выходных токенов Flash и Pro, пиковые и непиковые часы, лимиты параллельных запросов
- Ссылка:
api-docs.deepseek.com/quick_start/pricing -
Примечание: источник для расчёта фактической стоимости вызовов и планирования пакетных задач на непиковое время
-
Сравнение моделей DeepSeek от Respan за 2026 год: независимая оценка моделей
- Ссылка:
respan.ai/articles/deepseek-model-comparison - Примечание: независимое подтверждение того, что «более дешёвая модель превосходит конкурентов в большинстве задач по программированию и работе с агентами»
Автор: техническая команда APIYI
Техническое обсуждение: будем рады пообщаться — свяжитесь с нами через главную страницу сайта APIYI. Дополнительные материалы по подключению моделей доступны в центре документации: docs.apiyi.com