No fim de setembro e no início de outubro, os principais modelos de linguagem receberam atualizações em sequência: a Anthropic lançou o Claude Opus 5.5 em 22 de setembro e, apenas oito dias depois, o Google apresentou o Gemini 4 Argon. Os dois modelos têm propostas muito parecidas: ambos priorizam raciocínio em várias etapas, programação com agentes e trabalho corporativo com conhecimento. Seus preços oficiais também são iguais: US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída. Por isso, Gemini 4 Argon vs Claude Opus 5.5 virou uma das comparações mais comuns entre desenvolvedores que precisam escolher um modelo.
As informações públicas ainda são limitadas. Os dados primários mais completos estão em uma tabela do Google, incluída na documentação de avaliação do Argon, que compara 19 benchmarks e também inclui o Claude Opus 5.5. Este artigo usa essa tabela como ponto de partida e analisa cada item, além de trazer avaliações independentes de terceiros, como Artificial Analysis e Vals, e considerar fatores de engenharia, como preço, limite de saída e disponibilidade. Assim, você pode avaliar para quais cenários cada modelo é mais adequado.
Principal benefício: ao terminar este artigo, você vai entender quais números da tabela de avaliação do Google são confiáveis e quais merecem ressalvas. Também poderá escolher entre Gemini 4 Argon e Claude Opus 5.5 de acordo com as necessidades do seu negócio.
Comparação das especificações básicas: Gemini 4 Argon vs Claude Opus 5.5
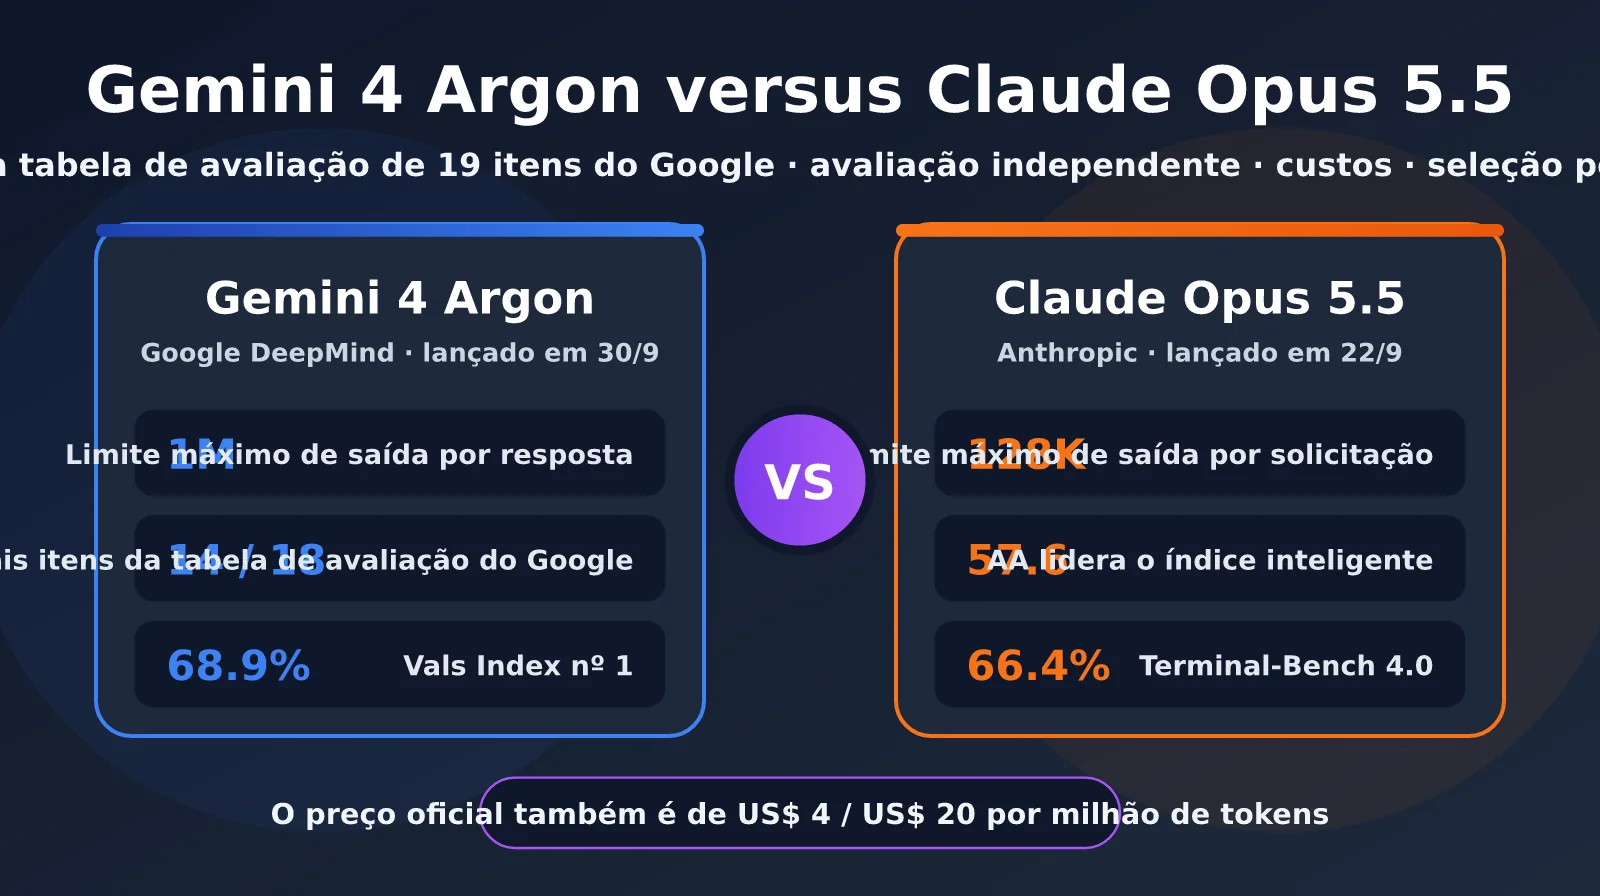
Antes de analisar as pontuações das avaliações, vale comparar as especificações básicas dos dois modelos. Os preços oficiais são idênticos; as diferenças mais importantes estão no limite de saída, na disponibilidade e no preço promocional.
| Item | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Data de lançamento | 30 de setembro de 2026 | 22 de setembro de 2026 |
| Disponibilidade atual | Programa Fairwind + liberação gradual no Vertex AI; API paga ainda não está amplamente disponível | Disponível em geral: Claude API, Bedrock, Vertex AI e Foundry |
| ID do modelo | Ainda não divulgado oficialmente | claude-opus-5-5 |
| Preço (entrada/saída) | Promocional: US$ 2/US$ 10; preço oficial: US$ 4/US$ 20 | US$ 4/US$ 20 |
| Leitura em cache | Desconto de 95% sobre o preço de entrada (a partir de US$ 0,10) | US$ 0,20 |
| Preço para processamento em lote (Batch) | Não divulgado | US$ 2/US$ 10 |
| Janela de contexto | Não divulgada oficialmente (terceiros mencionam 1M) | 1M, sem custo adicional para contexto longo |
| Limite de saída por solicitação | 1M de tokens | 128 mil tokens |
| Controle de raciocínio | Níveis como High | Cinco níveis de effort, de low a max, com raciocínio adaptativo |
A tabela mostra que a maior vantagem técnica do Argon é o limite de saída de 1M de tokens, cerca de oito vezes maior que o do Opus 5.5. Isso pode ser útil para gerar grandes volumes de código e realizar migrações em larga escala. Já a principal vantagem do Opus 5.5 é que já está disponível para uso estável: seu ID é conhecido, ele está nos principais provedores de nuvem e oferece processamento em lote pela metade do preço, além de cinco níveis de controle de effort. Em termos de maturidade para uso em produção, está claramente mais avançado.
🎯 Recomendação para a comparação: os preços oficiais dos dois modelos são iguais, então a escolha depende principalmente do tipo de tarefa. Recomendamos usar a plataforma APIYI, em apiyi.com, para acessar o Claude Opus 5.5 e os modelos da família Gemini pela mesma interface e comparar os resultados com tarefas reais. Esse teste lado a lado é mais confiável do que olhar apenas os rankings.
Gemini 4 Argon vs Claude Opus 5.5: análise detalhada da tabela de avaliação do Google
Abaixo estão os dados comparativos divulgados pelo Google no documento de avaliação do Argon. Mantivemos apenas as colunas do Argon e do Opus 5.5 e organizamos os resultados por categoria. Vale lembrar que esta é uma tabela publicada pelo próprio Google: os resultados do Argon foram obtidos pela empresa, enquanto a maioria dos resultados do Opus 5.5 vem de rankings públicos ou do system card da Anthropic. Alguns benchmarks foram executados novamente pelo Google para padronizar a comparação.
| Categoria | Benchmark | Gemini 4 Argon | Claude Opus 5.5 | Líder |
|---|---|---|---|---|
| Trabalho do conhecimento | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| Trabalho do conhecimento | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| Trabalho do conhecimento | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| Trabalho do conhecimento | Agent jurídico Harvey | 19.6% | 3.8% | Argon +15.8 |
| Programação com agentes | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| Programação com agentes | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| Programação com agentes | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| Programação com agentes | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| Engenharia de ML | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| Ciência e matemática | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| Ciência e matemática | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| Ciência e matemática | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| Contexto longo | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| Contexto longo | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| Operação de computadores | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| Multimodal | Chartography | 71.6% | 66.3% | Argon +5.3 |
| Multimodal | LVBench (vídeos longos) | 91.7% | 83.7% | Argon +8.0 |
| Cibersegurança | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
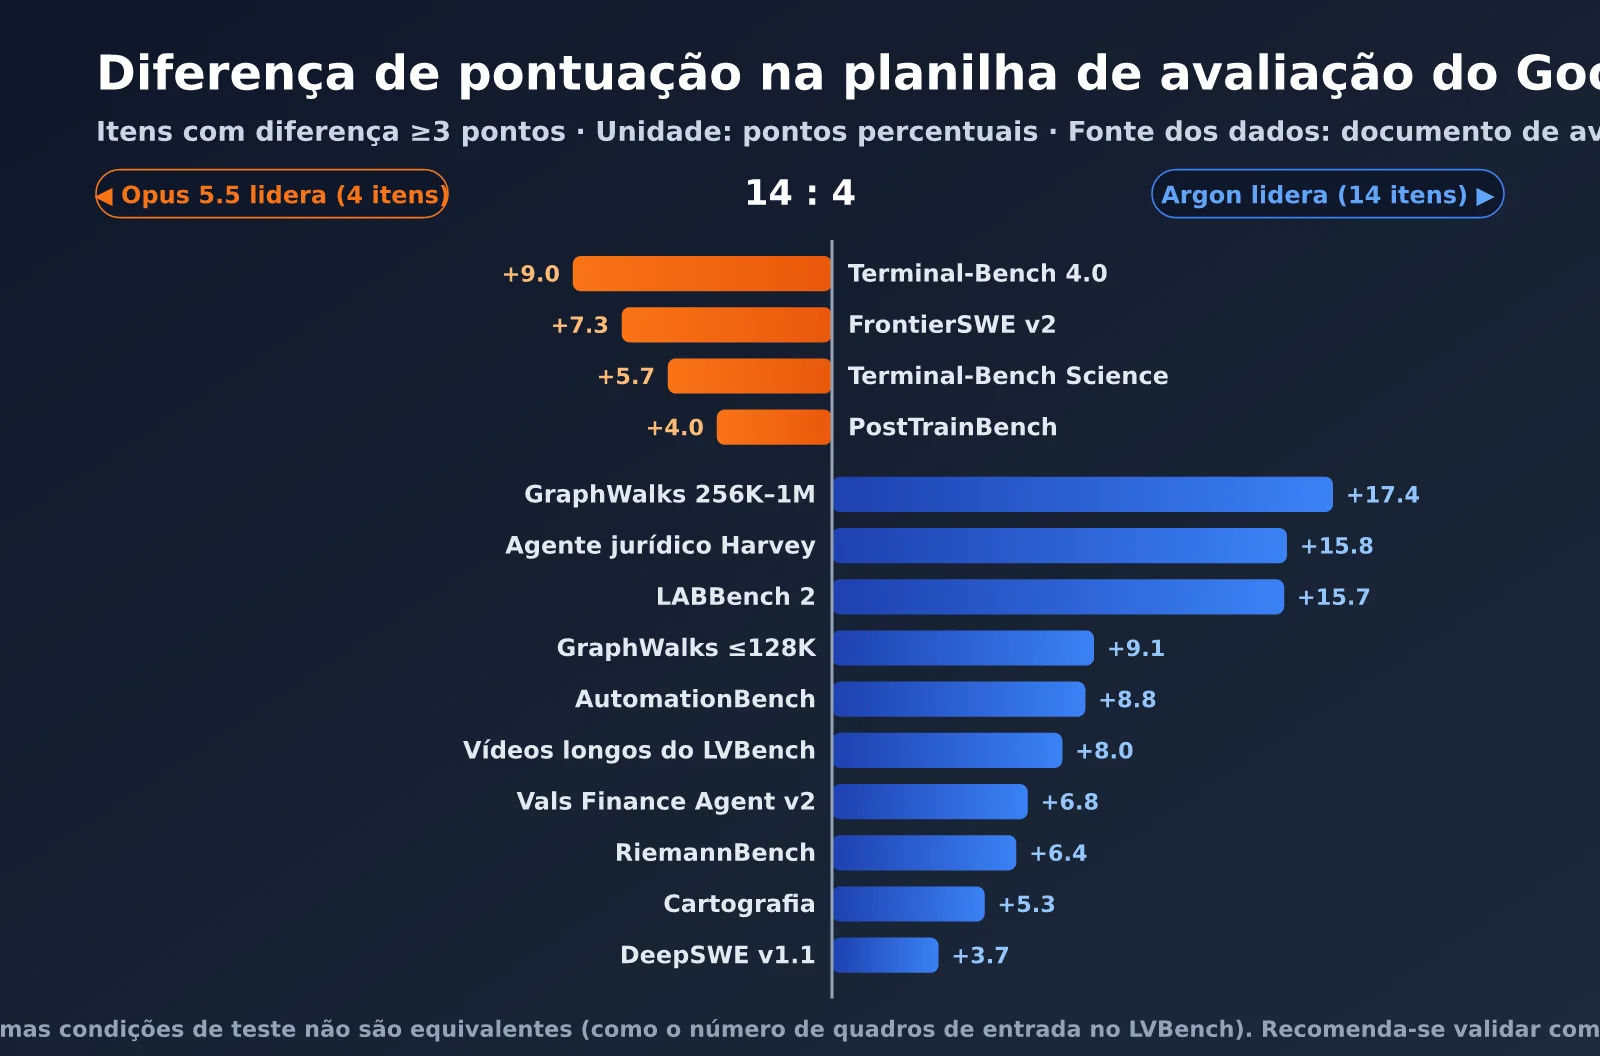
Nos 18 benchmarks em que ambos têm resultados, o Argon lidera em 14 e o Opus 5.5, em 4. As quatro vitórias do Opus 5.5 seguem um padrão: FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench e Terminal-Bench Science são tarefas que exigem operação prolongada em ambientes de terminal reais, com execução repetida de comandos. Já as maiores vantagens do Argon se concentram em contexto longo — no GraphWalks 256K–1M, a diferença é de 17.4 pontos —, em agentes jurídicos e em ciências da vida (LABBench 2).
Pontos da avaliação do Google que merecem ressalvas
É natural que uma tabela de avaliação publicada por uma empresa favoreça o próprio modelo. As notas de rodapé também trazem alguns detalhes importantes. Entender essas nuances ajuda a interpretar corretamente as diferenças entre Gemini 4 Argon e Claude Opus 5.5:
- Número de quadros de entrada diferente no LVBench: o Argon processa o vídeo inteiro a 1 quadro por segundo, enquanto o Opus 5.5, por limitações da API, só pode receber 600 quadros. Parte da diferença nos resultados com vídeos longos pode ser explicada pelas condições desiguais de entrada.
- Limite de tempo ampliado no Terminal-Bench Science: o tempo limite de validação do Argon foi configurado para seis vezes o valor padrão. Mesmo assim, o Argon ficou 5.7 pontos atrás do Opus 5.5.
- Frameworks diferentes no teste DeepSWE: o Argon foi avaliado pelo próprio Google usando o framework mini-swe agent, enquanto o resultado do Claude veio do system card da Anthropic. Portanto, os frameworks de teste não são iguais.
- Diferenças em relação aos dados publicados pela Anthropic: nos resultados divulgados pela própria Anthropic para o Opus 5.5, o AutomationBench fica em 40.0%, o Chartography com ferramentas chega a 89.0% e o OSWorld 2.0 marca 81.8%. Na tabela do Google, o Chartography aparece com apenas 66.3%, e a coluna do OSWorld foi deixada em branco.
Em outras palavras, quando as condições de teste são equivalentes, a diferença entre os dois é menor do que a tabela sugere. A vantagem do Argon em contexto longo, tarefas jurídicas e ciências da vida é grande o bastante para ser considerada relevante. Já resultados com diferença de apenas 1 ou 2 pontos, como Vals Index, Vibe Code e CWE-bench, podem ser considerados praticamente empatados.
Resultados de avaliações independentes: Gemini 4 Argon vs. Claude Opus 5.5
As conclusões das avaliações independentes de terceiros não coincidem com os dados divulgados pelo Google — e chegam até a apontar direções opostas no índice geral de inteligência. A tabela abaixo reúne dados públicos das organizações Artificial Analysis (AA) e Vals.
| Avaliação independente | Gemini 4 Argon | Claude Opus 5.5 | Líder |
|---|---|---|---|
| Índice de Inteligência AA v4.3 | 52.6 | 57.6 | Opus +5.0 |
| Posição no Vals Index | 68.90% (1º) | 66.97% (3º) | Argon +1.9 |
| AA Terminal-Bench 4.0 | 57.1% | 59.6% | Opus +2.5 |
| AA Humanity’s Last Exam | 57.1% | 61.4% | Opus +4.3 |
| AA SciCode | 61.8% | 66.9% | Opus +5.1 |
| Raciocínio com janela de contexto longa (AA) | 79.7% | 84.7% | Opus +5.0 |
| AA GDPval (Elo) | 1611 | 1846 | Opus +235 |
| AA AutomationBench | 77.5% | 69.5% | Argon +8.0 |
| Velocidade de saída (AA) | 48.9 tokens/s | 92.2 tokens/s | Opus cerca de 1,9 vez mais rápido |
Nos testes da AA, o Opus 5.5 lidera em raciocínio, programação científica, raciocínio com janela de contexto longa e tarefas profissionais do GDPval. O Argon se destaca claramente apenas na automação de processos de negócios do AutomationBench. No entanto, a comparação da AA não é totalmente justa: o Argon foi testado apenas no nível High, enquanto o Opus 5.5 usou o nível Max, com raciocínio adaptativo. Parte da diferença pode vir da configuração da intensidade de raciocínio, e não necessariamente de uma diferença de capacidade.
Já no Vals Index, o Argon aparece em primeiro lugar entre 41 modelos, enquanto o Opus 5.5 fica em terceiro. A diferença entre eles é de cerca de 1,5 erro padrão, o que indica uma pequena vantagem do Argon, mas sem que ela seja conclusiva. No geral, Gemini 4 Argon e Claude Opus 5.5 estão no mesmo patamar de capacidade geral; não há um vencedor que domine claramente o outro.
💡 Dica sobre avaliações: diferentes instituições podem chegar a conclusões opostas. No fim das contas, o ideal é testar com seus próprios dados. A plataforma APIYI apiyi.com permite alternar entre modelos das famílias Claude, Gemini, GPT e outras usando uma interface unificada, o que facilita a criação rápida de um pequeno conjunto de avaliações próprio.
Principais diferenças entre Gemini 4 Argon e Claude Opus 5.5
Deixando as pontuações de lado, as diferenças na filosofia de projeto dos dois modelos ajudam mais na escolha do que as diferenças em benchmarks isolados.
Duas abordagens para tarefas de longa duração
A abordagem do Gemini 4 Argon é ampliar o espaço disponível para uma única resposta. O limite de saída de 1 milhão de tokens permite gerar, em uma única solicitação, centenas de milhares de linhas de código ou relatórios muito extensos. Internamente, o Google usou o modelo para migrar mais de 800 mil linhas de código C/C++ do kernel Fuchsia Zircon para Rust e substituir 32 mil linhas de código SIMD na biblioteca libgav1, entre outras tarefas. Esse projeto reduz a necessidade de dividir tarefas e concatenar contextos, sendo especialmente adequado para situações em que é preciso “produzir uma grande quantidade de conteúdo de uma só vez”.
A abordagem do Claude Opus 5.5 é tornar o processo de raciocínio mais controlável. Em vez de buscar uma saída gigantesca, ele oferece cinco níveis de esforço, de low a max, e mantém o raciocínio adaptativo sempre ativado. Assim, os desenvolvedores podem ajustar a profundidade do raciocínio e o custo de acordo com a dificuldade da tarefa. Em conjunto com frameworks de agentes como o Claude Code, o Opus 5.5 se sai melhor em ciclos com várias chamadas a ferramentas, nos quais executa, observa e corrige repetidamente. Isso também ajuda a explicar por que ele lidera com folga em tarefas de interação com terminal, como as do Terminal-Bench.
Velocidade, latência e estabilidade
Os testes da Artificial Analysis mostram que a velocidade de saída do Opus 5.5 é de cerca de 92 tokens/s, quase o dobro dos 48,9 tokens/s do Argon. Para assistentes de programação e agentes de atendimento que precisam interagir em tempo real, essa diferença afeta diretamente a experiência do usuário. A vantagem do Argon é conseguir concluir mais trabalho em uma única solicitação, sendo adequado para tarefas em segundo plano muito extensas, mas que não exigem resposta imediata.
Além disso, o Opus 5.5 já está funcionando de forma estável em várias plataformas de nuvem há algumas semanas, com documentação consolidada sobre cotas, limites de uso e tratamento de erros. O Argon ainda está no início da expansão de acesso, e suas políticas de cotas e limites de uso não estão claras. Em sistemas de produção com requisitos rigorosos de SLA, esse fator não deve pesar menos do que as pontuações dos benchmarks.
Segurança e proteção contra injeção de comandos
As duas empresas tratam a segurança de agentes como prioridade. O Google afirma que o Argon é seu modelo mais resistente até hoje a ataques indiretos de injeção de comandos e que lidera o benchmark Gray Swan IPI, mas não divulgou as pontuações específicas. Já as análises de empresas de segurança terceirizadas indicam que, no mesmo benchmark, o Opus 5.5 está empatado com o Claude Fable 5.1 com a menor taxa de sucesso de injeção. Em outras palavras, ambos estão entre os melhores na proteção contra injeção de comandos e podem afirmar que lideram. Para agentes que precisam ler páginas da web, e-mails ou documentos externos, seja qual for o modelo escolhido, ainda é essencial restringir as permissões das ferramentas e implementar mecanismos de confirmação humana fora do modelo.
Comparação de custos: Gemini 4 Argon vs. Claude Opus 5.5
Os preços oficiais dos dois modelos são iguais, mas a quantidade de tokens consumida para realizar a mesma tarefa varia, o que gera uma diferença significativa no custo real. A tabela abaixo mostra o custo por tarefa medido por instituições terceirizadas.
| Critério de custo | Gemini 4 Argon | Claude Opus 5.5 | Diferença |
|---|---|---|---|
| Custo médio por tarefa no AA | US$ 1,99 (preço promocional) | US$ 5,98 | Argon custa cerca de 1/3 |
| Custo total para executar todo o índice do AA | US$ 2.407 | US$ 8.708 | Argon custa cerca de 28% |
| Custo por teste no Vals | US$ 15,68 | US$ 32,14 | Argon custa cerca de 49% |
| Custo por tarefa no AA, calculado pelo preço oficial | Cerca de US$ 3,98 | US$ 5,98 | Argon ainda é cerca de 1/3 mais barato |
| Tarefas em lote (Batch) | Não divulgado | Metade do preço: US$ 2/US$ 10 | Opus oferece desconto definido para processamento em lote |
Mesmo calculando com o preço oficial de US$ 4/US$ 20, o custo por tarefa do Argon no teste AA ainda é cerca de um terço menor que o do Opus 5.5. Um dos motivos é que, na configuração Max, o Opus 5.5 pode passar mais tempo raciocinando. Reduzir o esforço do Opus 5.5 para medium ou high diminui bastante o custo — esse é também o valor prático dos cinco níveis de controle de esforço do modelo. Além disso, para tarefas de processamento em lote offline, o desconto de 50% do Batch no Opus 5.5 já está confirmado e oferece mais previsibilidade do que o preço ainda não divulgado para processamento em lote do Argon.
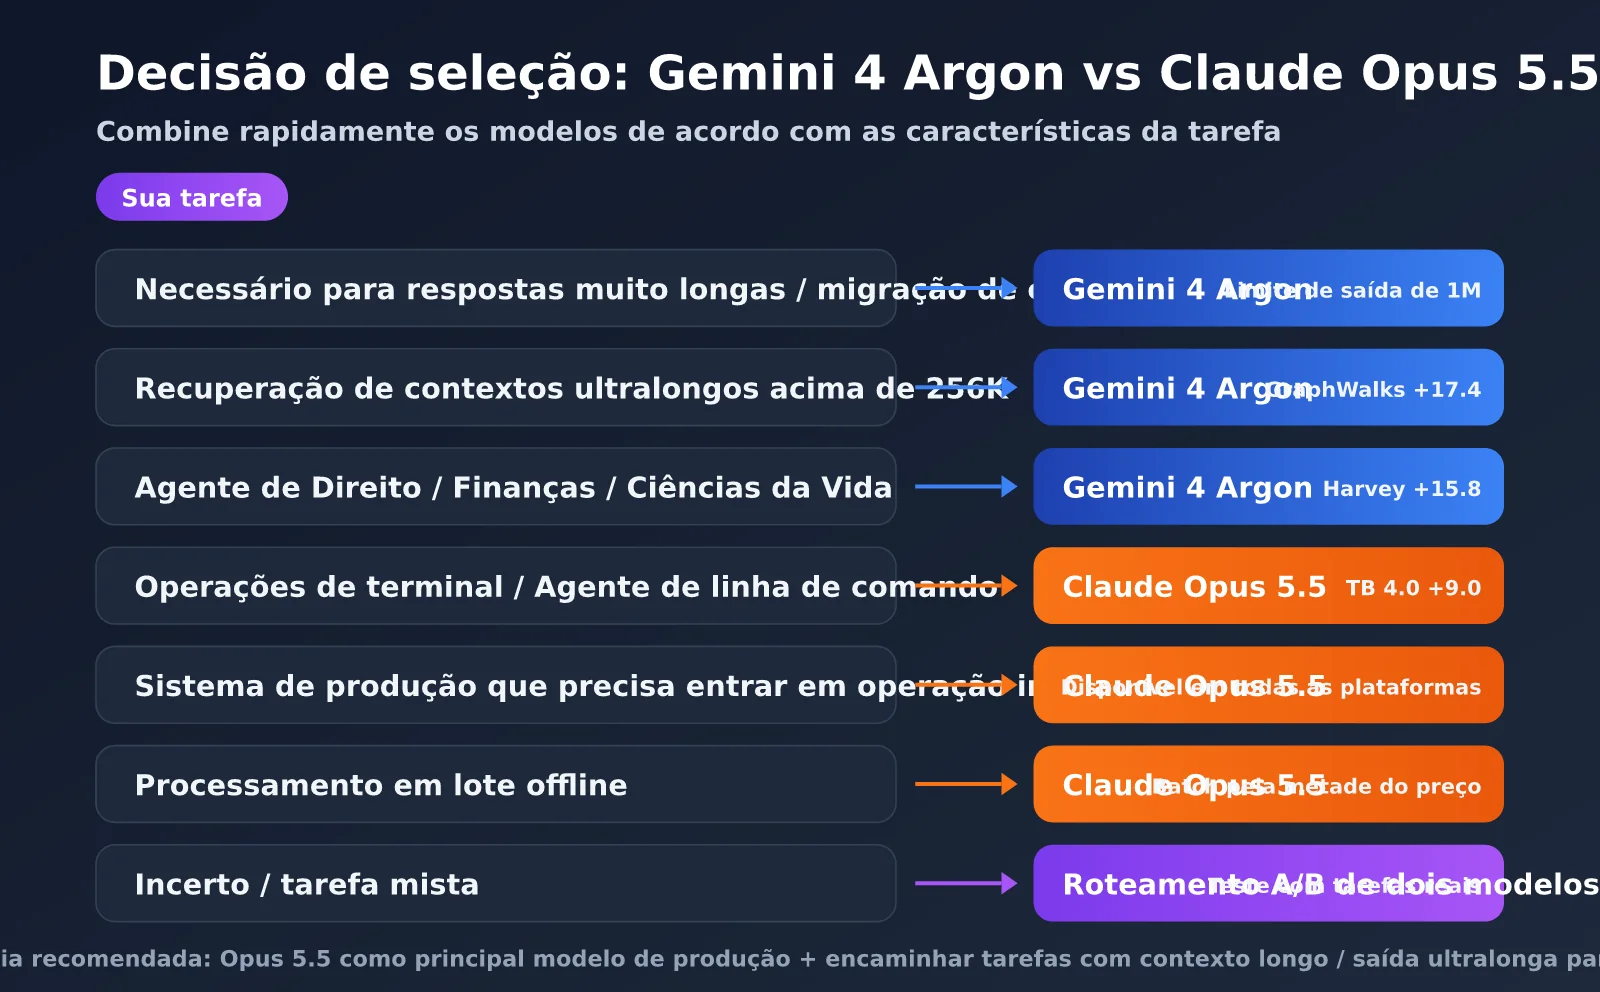
Recomendações por cenário e sugestões para escolher entre Gemini 4 Argon e Claude Opus 5.5
Com base nas avaliações do Google, em testes independentes, nos custos e na disponibilidade, é possível fazer recomendações bem claras para cada tipo de tarefa:
| Cenário de uso | Modelo recomendado | Principal motivo |
|---|---|---|
| Migração de código em larga escala / geração de código muito extensa | Gemini 4 Argon | Limite de saída de 1 milhão de tokens; vantagem de 3,7 pontos no DeepSWE |
| Busca em contextos muito longos, acima de 256 mil tokens | Gemini 4 Argon | Vantagem de 17,4 pontos no GraphWalks, entre 256 mil e 1 milhão de tokens |
| Agentes especializados em direito e finanças | Gemini 4 Argon | Vantagem de 15,8 pontos no Harvey e de 6,8 pontos no Finance Agent |
| Compreensão de vídeos longos e gráficos | Gemini 4 Argon | Lidera no LVBench e no Chartography |
| Operações em terminal e agentes de linha de comando | Claude Opus 5.5 | Vantagem de 9 pontos no Terminal-Bench 4.0 |
| Programação científica e raciocínio complexo | Claude Opus 5.5 | Lidera no SciCode, HLE e CritPt do AA |
| Sistemas de produção que precisam entrar no ar imediatamente | Claude Opus 5.5 | Disponível em todas as plataformas, com ID de modelo e cotas bem definidos |
| Processamento offline em lote | Claude Opus 5.5 | Desconto de 50% no Batch já confirmado: US$ 2/US$ 10 |
Prática de roteamento entre Gemini 4 Argon e Claude Opus 5.5
Para a maioria das equipes, a estratégia mais prática não é escolher apenas um dos modelos, mas usar o roteamento entre os dois: começar com o Opus 5.5 como modelo principal em produção e, aos poucos, direcionar para o Argon as tarefas de contexto longo e de geração de saídas muito extensas, que são seus pontos fortes. Veja a seguir um exemplo simples baseado em uma interface compatível com a OpenAI.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # 以平台实际上线 ID 为准

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 超长上下文或超长输出走 Argon,其余默认 Opus 5.5
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
Ver o código completo: comparação A/B entre dois modelos na mesma tarefa
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
Esse script A/B registra a latência, a quantidade de tokens de saída e o custo de cada modelo na mesma tarefa. Recomendamos preparar de 30 a 50 tarefas reais que representem seu negócio e, depois de avaliá-las manualmente ou com um modelo avaliador, decidir a proporção de roteamento entre os dois modelos.
🚀 Comece rápido: você pode se cadastrar primeiro no APIYI apiyi.com para obter créditos de teste e usar o Claude Opus 5.5 para executar o script A/B acima. Quando o Argon for lançado oficialmente na plataforma, basta alterar o nome do modelo na variável de ambiente para fazer os testes comparativos.
Perguntas frequentes
Q1: Afinal, qual é mais poderoso: Gemini 4 Argon ou Claude Opus 5.5?
Não existe uma resposta absoluta. Na tabela de avaliações do Google, Argon lidera em 14 itens, enquanto Opus 5.5 lidera em 4. Já no índice geral de inteligência da Artificial Analysis, Opus 5.5 fica à frente, com 57,6 contra 52,6. Os dois estão no mesmo nível: Argon se destaca pela janela de contexto longa, pelas saídas muito extensas e por agentes especializados; Opus 5.5 se sobressai em operações no terminal, raciocínio complexo e maturidade de engenharia.
Q2: Os dados da tabela de avaliações do Google são confiáveis?
Servem como referência, mas devem ser analisados com ressalvas. A tabela foi publicada pelo Google, e as condições de teste de alguns benchmarks não são equivalentes — por exemplo, o número de quadros de entrada no LVBench e as configurações de tempo limite do Terminal-Bench Science. Em comparação com os dados divulgados pela própria Anthropic, algumas pontuações do Opus 5.5 também são mais baixas. Recomendamos dar mais atenção aos resultados com uma vantagem superior a 5 pontos; diferenças de 1 ou 2 pontos podem ser consideradas um empate.
Q3: Já é possível usar os dois modelos?
Claude Opus 5.5 já está totalmente disponível pela Claude API, Bedrock, Vertex AI e Foundry. Gemini 4 Argon ainda está sendo liberado gradualmente. Ele já pode ser acessado pelo Vertex AI, mas a API paga ainda não foi disponibilizada de forma geral. Recomendamos conectar primeiro ao Opus 5.5 e aos modelos da família Gemini pelo APIYI apiyi.com. Quando Argon for lançado oficialmente, basta trocar o parâmetro `model` para comparar os resultados.
Q4: Os dois modelos custam o mesmo. Qual sai mais barato na prática?
De acordo com testes de terceiros, o custo por tarefa do Argon é de aproximadamente um terço a metade do custo do Opus 5.5, com uma vantagem ainda maior durante o período inicial de experimentação. Mas é possível reduzir bastante os custos do Opus 5.5 diminuindo o nível de esforço e usando o Batch, que custa metade do preço. A forma mais precisa de comparar é registrar o `usage` em tarefas reais e calcular os custos. A fatura unificada da plataforma APIYI apiyi.com facilita a comparação dos gastos efetivos com os dois modelos.
Resumo
Gemini 4 Argon vs Claude Opus 5.5 é uma disputa equilibrada. Pela tabela de avaliações do Google, Argon tem vantagens claras em janela de contexto longa, agentes para as áreas jurídica e financeira, ciências da vida e recursos multimodais. O limite de 1 milhão de tokens de saída é uma capacidade sem igual. Já nas avaliações independentes, Opus 5.5 leva vantagem em raciocínio, programação científica e operações no terminal, além de já estar disponível em todas as plataformas e ter uma engenharia mais madura.
A recomendação para o momento é: usar Claude Opus 5.5 como modelo principal em produção e incorporar Gemini 4 Argon gradualmente para tarefas que exigem contexto longo e saídas muito extensas. Enquanto isso, compare os dois continuamente com seu próprio conjunto de tarefas reais usando testes A/B. Quando a API paga de Argon estiver disponível para todos e mais avaliações independentes forem publicadas, ajuste a proporção de uso com base nos dados.
Recomendamos conectar os modelos das famílias Claude e Gemini pela plataforma APIYI apiyi.com. Assim, você pode comparar vários modelos e encaminhar as solicitações usando uma única interface e uma só fatura, tomando decisões de seleção com base em dados reais.
Referências:
- Artigo oficial do Google sobre o lançamento do Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Anúncio de lançamento do Claude Opus 5.5 pela Anthropic: anthropic.com/news
- Índice de inteligência e comparação de modelos da Artificial Analysis: artificialanalysis.ai
- Ranking de avaliações de modelos da Vals AI: vals.ai
- Tabela completa de avaliações do Gemini 4 Argon, compilada pelo ToolScout: toolscout.ai/news/gemini-4-argon-benchmarks
Autor: APIYI Team | Acompanhamos continuamente as avaliações e a seleção dos modelos de linguagem mais avançados. Para saber mais sobre a integração de modelos, acesse APIYI apiyi.com.