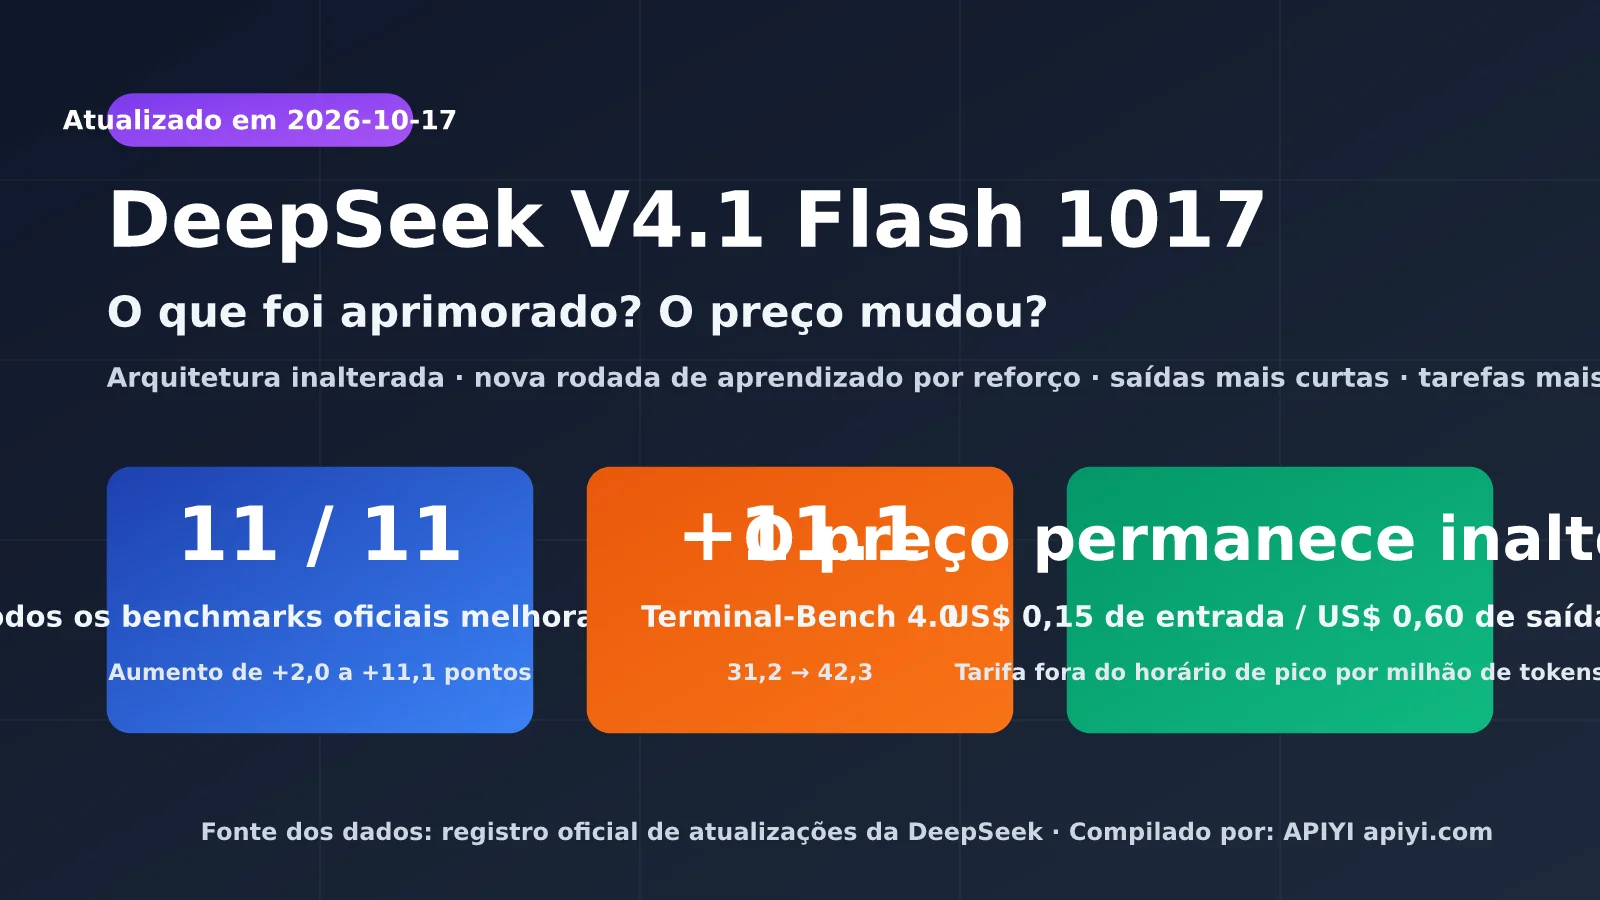
Em 17 de outubro de 2026, a DeepSeek atualizou discretamente o V4.1 Flash para o DeepSeek-V4.1-Flash-1017. A empresa apresentou a novidade como uma pequena atualização, mas, pelos dados divulgados, todos os 11 benchmarks listados pela própria DeepSeek melhoraram, e o Terminal-Bench 4.0 subiu 11,1 pontos. Isso já está longe de ser apenas um ajuste pequeno.
Para muitos desenvolvedores, as duas perguntas mais importantes são: o que exatamente melhorou no DeepSeek V4.1 Flash 1017? O preço mudou? Este artigo responde com base apenas nos dados do registro oficial de atualizações da DeepSeek, da página de preços e do cartão do modelo no Hugging Face. As informações de terceiros serão identificadas separadamente.
O principal: ao terminar de ler, você vai saber qual foi a melhora real da versão 1017, por que “preço inalterado” significa, na prática, pagar menos, e como reduzir pela metade os custos da API DeepSeek usando horários de menor demanda.
O que é o DeepSeek V4.1 Flash 1017: uma atualização menor, sem mudanças na arquitetura
O DeepSeek V4.1 Flash é o menor modelo da nova família de arquiteturas lançada em 10 de setembro de 2026 e oferece suporte nativo à compreensão de imagens. A versão 1017 foi a primeira iteração, cerca de um mês após o lançamento. O registro oficial de atualizações é bem direto: o modelo foi atualizado para DeepSeek-V4.1-Flash-1017, com atualização simultânea na versão web e no aplicativo. O modo de invocação da API e os preços não mudaram.
Pelas informações técnicas do Hugging Face, a versão 1017 mantém a mesma arquitetura: 552B de parâmetros no modelo-base, cerca de 8B de parâmetros ativados por token na etapa de pré-preenchimento e cerca de 16B na etapa de decodificação, além de 196B de memória condicional Engram. As análises da comunidade em inglês apontam, em geral, que as mudanças vieram de uma nova rodada de pós-treinamento com aprendizado por reforço. Os arquivos de configuração, o tokenizador e a codificação dos comandos permaneceram iguais; portanto, não é preciso alterar o código existente.
| Item | DeepSeek V4.1 Flash 1017 | Observações |
|---|---|---|
| Data de lançamento | 2026-10-17 | Primeira iteração da versão lançada em 10 de setembro |
| Nome do modelo na API | deepseek-flash |
O alias aponta automaticamente para a versão mais recente |
| Nomes antigos do modelo | deepseek-v4-flash etc. |
Continuam disponíveis, direcionam para a versão 1017 e são cobrados pelo preço do Flash |
| Arquitetura | MoE, modelo-base de 552B, 8B/16B ativados | Igual à versão inicial |
| Contexto / saída máxima | 1M / 384K | Dados da página oficial de preços |
| Modo de raciocínio | Com raciocínio (padrão) e sem raciocínio | Os dois modos estão disponíveis |
| Multimodalidade | Aceita imagens como entrada | A versão Pro ainda não oferece suporte visual |
| Licença de código aberto | MIT | Pesos publicados no Hugging Face e no ModelScope |
| Limite de concorrência | 2.500 | Na versão Pro, é 500 |
Vale destacar um ponto mencionado explicitamente pela DeepSeek: a versão 1017 foi otimizada para DeepSeek Harness, Tencent CodeBuddy e WorkBuddy. A empresa recomenda usar o DeepSeek Harness 0.2.1-rc.1 ou uma versão mais recente. Isso indica que o treinamento desta vez teve como foco cenários de programação com agentes. Se você usa seu próprio ciclo de agente, o ganho real pode ser menor do que o indicado pelos números oficiais.
🎯 Dica técnica: o alias do modelo aponta automaticamente para a versão mais recente. Antes de direcionar o tráfego de produção para ela, vale fazer testes de regressão com amostras dos seus próprios casos de uso. Com a APIYI apiyi.com, você pode chamar a DeepSeek e outros modelos populares usando a mesma chave, o que facilita compará-los lado a lado com o mesmo conjunto de scripts de avaliação.
O que mudou no DeepSeek V4.1 Flash 1017: comparação item a item de 11 benchmarks
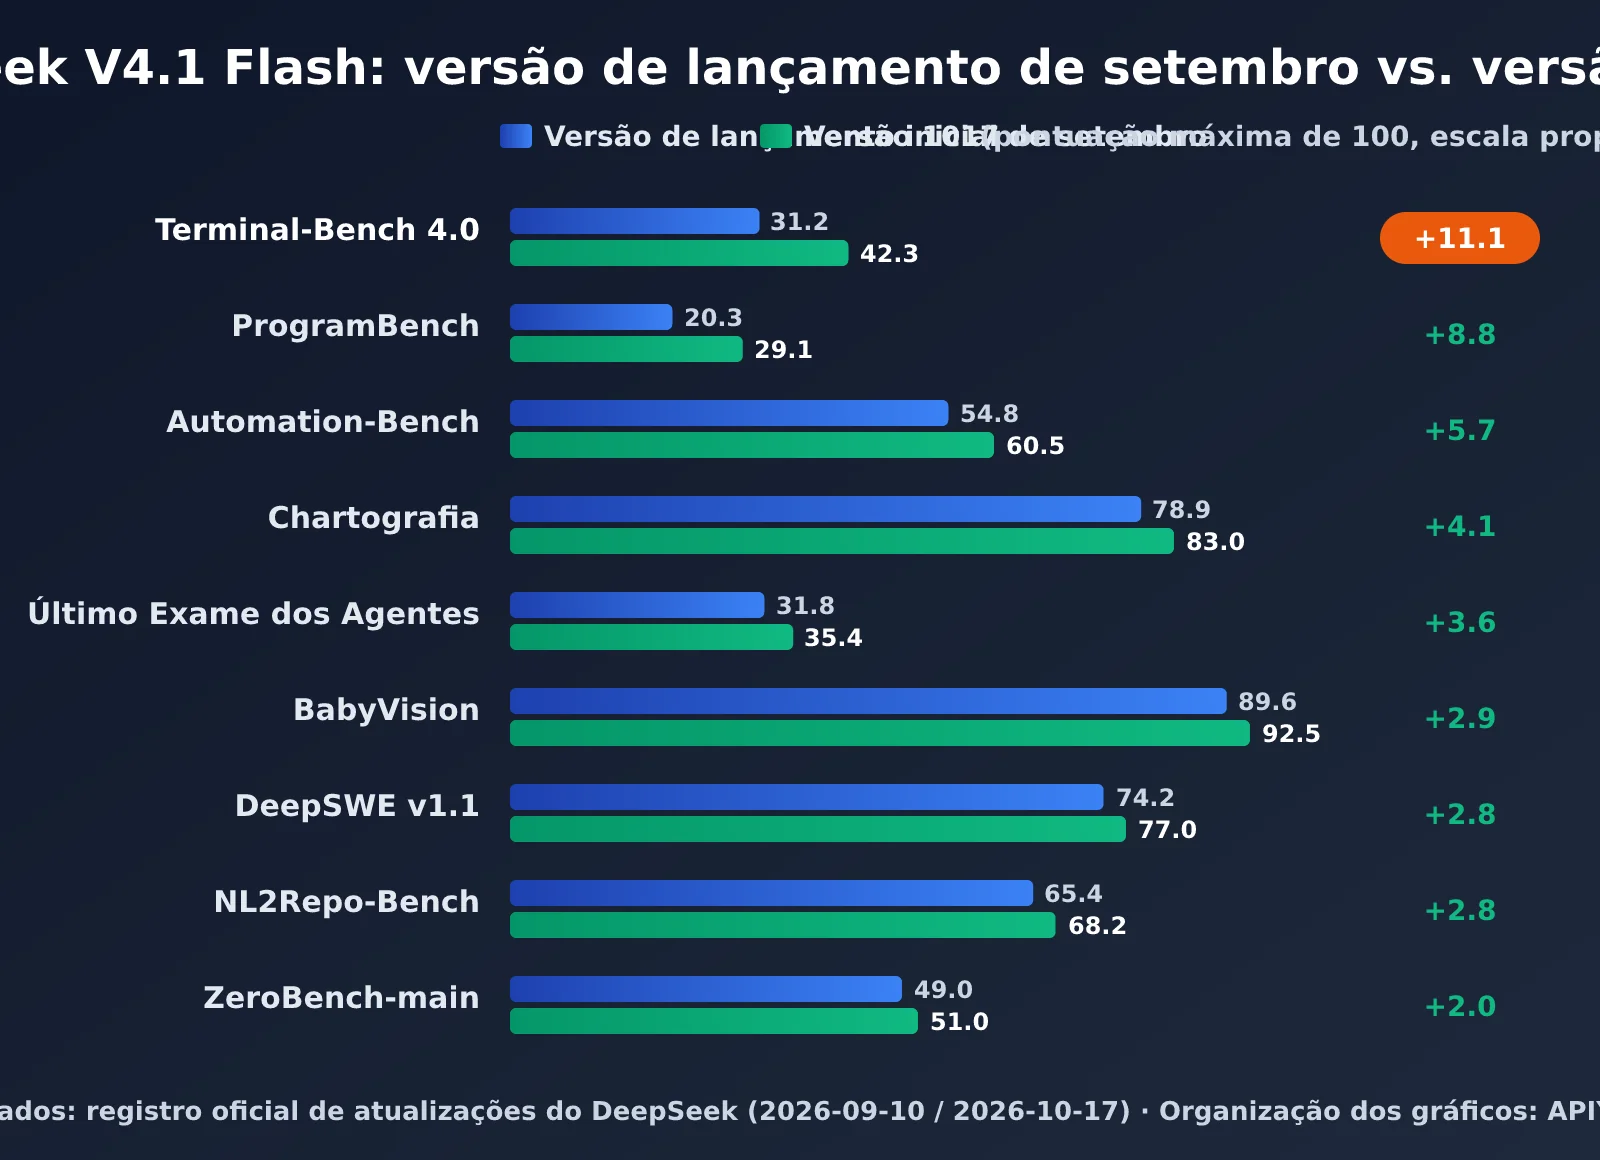
A maneira mais direta de responder “o que mudou?” é comparar os resultados da versão de lançamento oficial de setembro com os da versão 1017, de outubro. Os dados da tabela abaixo vêm do changelog oficial da DeepSeek. Como o changelog não informa a pontuação antiga do Apex Bench, o valor foi obtido de uma compilação da comunidade em inglês e deve ser considerado apenas uma referência.
| Benchmark | Dimensão avaliada | Versão de lançamento de setembro | Versão 1017 | Melhora |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Tarefas de agente no terminal | 31.2 | 42.3 | +11.1 |
| ProgramBench | Geração de programas | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | Raciocínio geral (pontuação antiga de fonte externa) | 64.6 | 72.1 | +7.5 |
| HLE (sem ferramentas) | Raciocínio com conhecimento de alta dificuldade | 36.8 | 42.6 | +5.8 |
| Automation-Bench | Fluxos de trabalho automatizados | 54.8 | 60.5 | +5.7 |
| Chartography (com ferramentas) | Compreensão de gráficos | 78.9 | 83.0 | +4.1 |
| Agents’ Last Exam | Agente de uso geral | 31.8 | 35.4 | +3.6 |
| BabyVision (com ferramentas) | Compreensão visual | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | Engenharia de software | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | Geração de repositórios a partir de linguagem natural | 65.4 | 68.2 | +2.8 |
| ZeroBench-main (com ferramentas) | Raciocínio visual | 49.0 | 51.0 | +2.0 |
A tabela revela três sinais. Primeiro, os maiores avanços aparecem justamente nas tarefas de agente e programação: os aumentos relativos no Terminal-Bench 4.0 e no ProgramBench superam 35%, o que está de acordo com a afirmação oficial de que houve otimizações para Harness e CodeBuddy. Segundo, os benchmarks visuais também avançaram de forma consistente, entre 2 e 4 pontos, indicando que o pós-treinamento não sacrificou as capacidades multimodais. Terceiro, os critérios de avaliação de alguns benchmarks não são totalmente consistentes entre as versões. Por exemplo, a versão mais recente do Automation-Bench está identificada como v1.0.6, enquanto a versão de lançamento do HLE não especifica se usava ferramentas. Por isso, não é recomendável tirar conclusões com base em um único número.
Ganhos de eficiência do DeepSeek V4.1 Flash 1017: respostas mais curtas e tarefas mais rápidas
Além das pontuações, a DeepSeek destaca uma mudança fácil de passar despercebida: a versão 1017 conclui as tarefas mais rápido e gera respostas mais curtas. Para APIs cobradas por Token, isso importa tanto quanto a pontuação: se a resposta para uma mesma tarefa usar menos Tokens, a conta também fica menor.
Vale lembrar que a DeepSeek não divulgou exatamente em que percentual houve redução, e a comunidade em inglês ainda não publicou medições confiáveis comparando as duas versões. Uma abordagem mais segura é acompanhar a variação de usage.completion_tokens em amostras do seu próprio negócio e usar os dados reais para avaliar quanto o custo diminuiu.
A comunidade em inglês resumiu o método de treinamento como “programação orientada por desejos” (Wish-Driven Programming): primeiro, o modelo conclui um projeto de ponta a ponta; depois, avalia o próprio resultado comparando-o com o objetivo e faz novas iterações. Entre os exemplos apresentados oficialmente estão uma reconstrução 3D da Cidade Proibida, um jogo de corrida para navegador e uma recriação de Portal 2 com Godot. Projetos longos desse tipo correspondem justamente a benchmarks como Terminal-Bench e ProgramBench, o que também ajuda a explicar por que os maiores ganhos apareceram nas pontuações de tarefas com agentes.
O preço do DeepSeek V4.1 Flash 1017 mudou? Entenda a cobrança em horários de pico e fora de pico
A resposta direta: o preço da API do DeepSeek V4.1 Flash 1017 não mudou e continua igual ao da versão lançada em setembro. Mas é importante considerar dois detalhes: o preço já havia sido reduzido no lançamento de setembro, e atualmente o DeepSeek cobra valores diferentes nos horários de pico e fora de pico. O preço por unidade pode variar em até 2 vezes, dependendo do horário.
| Item de cobrança (por milhão de tokens) | Flash fora de pico | Flash no pico | V4 Pro fora de pico | V4 Pro no pico |
|---|---|---|---|---|
| Entrada (acerto de cache) | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada (sem acerto de cache) | $0.15 | $0.30 | $0.66 | $1.32 |
| Saída | $0.60 | $1.20 | $1.98 | $3.96 |
Segundo a definição oficial, os horários de pico são de segunda a sexta-feira, das 01:00 às 04:00 e das 06:00 às 10:00 UTC. No horário de Pequim, isso corresponde a dias úteis, das 09:00 às 12:00 e das 14:00 às 18:00. Feriados nacionais chineses não são considerados horários de pico. Nos demais períodos — incluindo a noite, o horário de almoço, os fins de semana e os feriados — vale o preço fora de pico, que corresponde à metade do preço de pico.
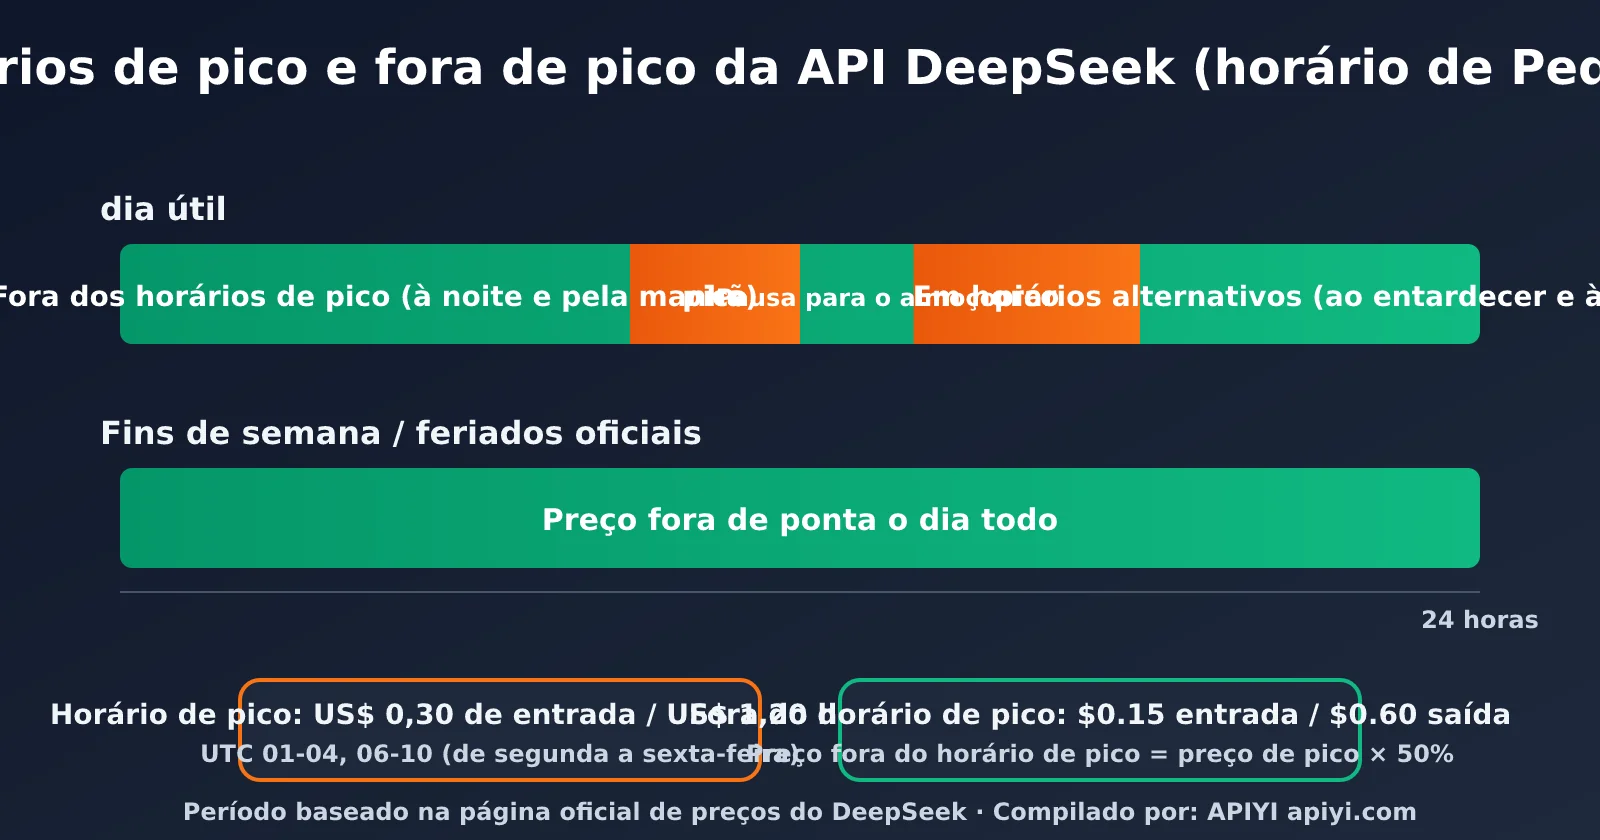
Essa divisão de horários afeta diretamente as equipes no Brasil: o período de pico coincide quase totalmente com o horário comercial local. Se você tem tarefas que não exigem resposta em tempo real — como traduções em lote, rotulagem de dados offline ou análise de repositórios de código — pode programá-las para depois das 18h ou para o fim de semana. O preço cai imediatamente pela metade: um efeito mais direto do que qualquer otimização de comandos.
Linha do tempo das mudanças de preço do DeepSeek V4.1 Flash
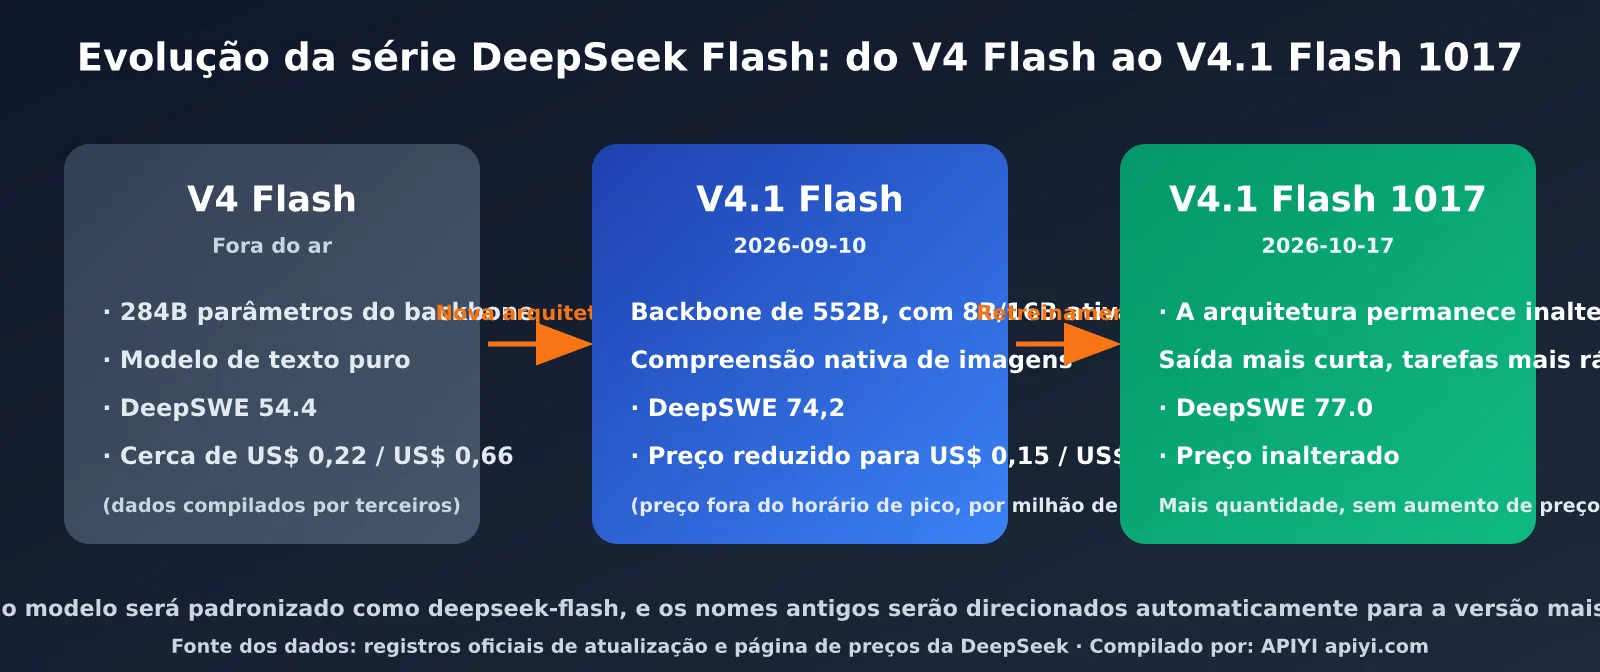
Olhando para o período como um todo, a série Flash passou por duas etapas em dois meses: primeiro, uma redução de preço; depois, mais capacidade pelo mesmo valor. Os preços da época do V4 Flash foram compilados por comunidades de língua inglesa e servem apenas como referência. Os dados das versões de setembro e outubro são oficiais.
| Versão | Data de lançamento | Entrada (sem acerto de cache) | Entrada (acerto de cache) | Saída | Mudança |
|---|---|---|---|---|---|
| V4 Flash | Antes de setembro de 2026 | Cerca de $0.22 | Cerca de $0.007 | Cerca de $0.66 | Descontinuado |
| V4.1 Flash | 2026-09-10 | $0.15 | $0.003 | $0.60 | Redução de preço anunciada oficialmente |
| V4.1 Flash 1017 | 2026-10-17 | $0.15 | $0.003 | $0.60 | Preço mantido; capacidade aprimorada |
Os preços da série V4.1 na tabela são os de fora de pico. Nos horários de pico, eles dobram.
Por que “preço mantido” significa, na prática, uma redução
O preço por unidade não mudou, mas o custo total de cada tarefa depende do “preço por unidade × quantidade de tokens”. A confirmação oficial de que o 1017 gera respostas mais curtas significa que a mesma tarefa consome menos tokens de saída. Como o preço da saída é 4 vezes maior que o da entrada, reduzir o tamanho das respostas gera uma economia mais significativa do que reduzir o volume de entrada.
Veja um exemplo ilustrativo: uma tarefa de Agent consome, fora de pico, 1 milhão de tokens de entrada sem acerto de cache e 200 mil tokens de saída. O custo fica em cerca de $0.15 + $0.12 = $0.27. Se o volume de saída cair 20% — apenas uma hipótese; o resultado real depende das suas medições —, o custo de saída passa de $0.12 para aproximadamente $0.096. Com a reutilização de contextos longos usando o preço de $0.003 para acertos de cache, o custo real pode cair ainda mais.
💰 Como reduzir custos: em projetos com chamadas em lote ou orçamento limitado, programe as tarefas que não precisam de resposta em tempo real para os horários fora de pico e reutilize comandos de sistema fixos sempre que possível para aumentar a taxa de acerto do cache. Ao fazer chamadas pela plataforma APIYI apiyi.com, você também pode consultar em um só lugar os detalhes de uso de cada modelo e calcular o custo real de cada tipo de tarefa.
APIs Search e Fetch: novos itens de cobrança liberados com o 1017
Outra novidade lançada junto com o 1017: o DeepSeek abriu para desenvolvedores externos seus recursos de Search (busca na internet) e Fetch (captura de páginas da web). Os dois são cobrados separadamente por solicitação: $0.75 por mil solicitações bem-sucedidas, sem relação com os custos de tokens do modelo.
A página oficial de preços também informa um período de transição: por enquanto, essas solicitações são gratuitas quando iniciadas pelo DeepSeek Harness, Claude Code ou Codex. A cobrança por solicitação começa à meia-noite de 1º de novembro de 2026, no horário de Pequim. Se seu fluxo de trabalho com Agent depende bastante de buscas na internet, vale contabilizar as chamadas antes de novembro e estimar esse novo custo com antecedência.
DeepSeek V4.1 Flash 1017: primeiros passos rápidos e exemplos de chamadas à API
Como a versão 1017 mantém o nome de modelo deepseek-flash, o código existente passa a usar a nova versão automaticamente, sem nenhuma alteração. Veja abaixo um exemplo mínimo de chamada compatível com o SDK da OpenAI:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

resp = client.chat.completions.create(
    model="deepseek-flash",  # 实际可用模型名以平台模型列表为准
    messages=[{"role": "user", "content": "用 Python 写一个读取 CSV 并按列求和的函数"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # 记录 Token 用量,便于对比新旧版本输出长度
Ver o código completo: script para comparar o tamanho das respostas das versões antiga e nova
import time
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 调用多个模型
)

PROMPTS = [
    "解释 Python 中生成器和迭代器的区别,并给出示例",
    "写一个带重试和指数退避的 HTTP 请求函数",
    "把下面的 SQL 改写成 pandas 代码:SELECT city, AVG(price) FROM orders GROUP BY city",
]

def run(model: str, prompts: list[str]) -> dict:
    out_tokens, latency = [], []
    for p in prompts:
        start = time.time()
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": p}],
        )
        latency.append(time.time() - start)
        out_tokens.append(resp.usage.completion_tokens)
    return {
        "model": model,
        "avg_output_tokens": statistics.mean(out_tokens),
        "avg_latency_s": round(statistics.mean(latency), 2),
    }

if __name__ == "__main__":
    # 将历史记录中的 completion_tokens 与本次结果对比,即可估算 1017 的输出缩短幅度
    print(run("deepseek-flash", PROMPTS))
Algumas dicas práticas para você começar a usar mais rápido:
- Modo de raciocínio:
deepseek-flashvem com o modo de raciocínio ativado por padrão. Em tarefas simples de perguntas e respostas ou conversão de formatos, você pode mudar para o modo sem raciocínio e economizar ainda mais tokens de saída. Consulte a documentação oficial para saber como configurar esse parâmetro. - Parâmetros de amostragem: o cartão do modelo no Hugging Face recomenda
temperature=1.0etop_p=0.95. Se você ajustou a temperatura para a versão anterior, vale a pena testar novamente. - Nome do modelo antigo:
deepseek-v4-flashainda pode ser usado, mas agora direciona as chamadas para a versão 1017. Recomendamos padronizar o uso dedeepseek-flashpara evitar problemas caso o nome alternativo seja descontinuado no futuro. - Testes de regressão: respostas mais curtas podem afetar sistemas downstream que dependem de formatos ou comprimentos fixos. Antes de migrar, teste com amostras reais.
🚀 Comece agora: recomendamos usar a plataforma APIYI, em apiyi.com, para criar protótipos rapidamente. A interface compatível com a OpenAI funciona imediatamente: em poucos minutos, você integra o DeepSeek V4.1 Flash 1017 ao seu projeto e faz testes A/B com outros modelos.
Para quais cenários o DeepSeek V4.1 Flash 1017 é indicado: comparação com o V4 Pro
Após a atualização 1017, surge uma dúvida prática: ainda vale a pena usar o V4 Pro, que é mais caro? De acordo com a página oficial de preços, o Flash leva vantagem em preço, concorrência e recursos visuais. O Pro, por sua vez, continua sendo o modelo maior oferecido atualmente pela DeepSeek.
| Critério | deepseek-flash (V4.1 Flash 1017) | deepseek-v4-pro (V4 Pro 0813) | Recomendação |
|---|---|---|---|
| Preço de saída (fora do horário de pico) | US$ 0,60 / milhão de tokens | US$ 1,98 / milhão de tokens | O Flash custa cerca de 30% do preço do Pro |
| Contexto / saída máxima | 1M / 384K | 1M / 384K | Empate |
| Compreensão visual | Compatível | Não compatível | Escolha o Flash para entradas com imagens |
| Limite de chamadas simultâneas | 2.500 | 500 | Escolha o Flash para processamento em lote com alta concorrência |
| Otimização para programação com agentes | Otimizado especificamente para Harness e CodeBuddy | Uso geral | Priorize os testes com o Flash para agentes de programação |
| Plataformas disponíveis | DeepSeek oficial, APIYI em apiyi.com e outras | As mesmas | Uma interface unificada facilita a troca |
Com base nessas informações, veja algumas sugestões de escolha conforme o cenário:
- Agentes de programação e automação de terminal: dê preferência ao Flash 1017. Foi nessa área que a atualização trouxe os avanços mais significativos, e o preço é cerca de um terço do Pro.
- Compreensão de gráficos, capturas de tela e documentos: só o Flash serve, pois o Pro ainda não aceita entradas visuais.
- Tarefas offline em grande escala: o limite de 2.500 chamadas simultâneas do Flash, combinado com o preço fora do horário de pico, oferece a melhor relação custo-benefício.
- Tarefas complexas de raciocínio que exigem respostas de altíssima qualidade: compare o Flash e o Pro com as mesmas amostras antes de decidir. Não se baseie apenas nas pontuações de benchmarks.
💡 Dica para escolher: a escolha do modelo depende principalmente do tipo de tarefa e do nível de qualidade esperado. Recomendamos testar o Flash e o Pro com as mesmas amostras reais pela plataforma APIYI, em apiyi.com. Como a interface unificada permite trocar de modelo alterando apenas o nome, fica fácil chegar a uma conclusão rapidamente.
Perguntas frequentes
Q1: Preciso alterar o código para usar o DeepSeek V4.1 Flash 1017?
Não. A DeepSeek confirmou que a forma de chamar a API continua a mesma. deepseek-flash passará a apontar automaticamente para a versão 1017, e o nome antigo, deepseek-v4-flash, também será direcionado para a nova versão. A única recomendação é fazer testes de regressão para confirmar que a análise nos sistemas downstream continua funcionando normalmente com as respostas mais curtas. Na plataforma APIYI apiyi.com, você pode obter créditos para testes e verificar rapidamente o desempenho da nova versão no seu negócio.
Q2: Afinal, o preço do DeepSeek V4.1 Flash 1017 mudou?
O preço por unidade não mudou: nos horários fora de pico, a entrada custa US$ 0,15 por milhão de tokens quando o cache não é usado e US$ 0,003 quando há acerto de cache; a saída custa US$ 0,60. Nos horários de pico, os preços dobram. Como a versão 1017 gera respostas mais curtas, o custo total da mesma tarefa geralmente diminui. A única novidade é a cobrança por uso das APIs Search e Fetch: US$ 0,75 por mil solicitações bem-sucedidas para cada uma.
Q3: Quais são os horários de pico no horário de Pequim?
Nos dias úteis, o horário de pico é das 09h às 12h e das 14h às 18h, no horário de Pequim — equivalente a 01h–04h e 06h–10h UTC. Os feriados nacionais da China não são considerados horários de pico. Nos demais períodos, vale o preço fora de pico, que corresponde à metade do preço de pico.
Q4: É confiável o aumento de desempenho nos benchmarks da versão 1017?
As pontuações foram divulgadas oficialmente pela DeepSeek, mas a reprodução independente por terceiros ainda está em andamento. Alguns benchmarks dependem de frameworks específicos: o Terminal-Bench 4.0, por exemplo, usa o framework Claude Code, enquanto o DeepSWE usa o Mini-SWE-V2. Os resultados podem variar com um ciclo de Agent próprio. A forma mais confiável de avaliar é testar a versão com seus próprios dados e framework antes de decidir se vale a pena migrar.
Q5: Posso implantar o DeepSeek V4.1 Flash 1017 localmente?
Sim. Os pesos estão disponíveis sob a licença MIT no Hugging Face e no ModelScope, com suporte a frameworks de inferência como vLLM, SGLang e Transformers. No entanto, os 552 bilhões de parâmetros do modelo principal exigem muita memória de GPU. Para equipes pequenas e médias, chamar a API costuma ser mais vantajoso.
Principais conclusões
- O que melhorou: a arquitetura continua igual, mas houve uma nova rodada de aprendizado por reforço. Todos os 11 benchmarks oficiais tiveram aumento, e o Terminal-Bench 4.0 subiu de 31,2 para 42,3.
- Mudanças na eficiência: as tarefas são concluídas mais rápido e as respostas são mais curtas, reduzindo diretamente o custo por tarefa quando a cobrança é feita por token.
- O preço mudou?: o preço por unidade continua igual: US$ 0,15 por milhão de tokens de entrada e US$ 0,60 de saída fora do horário de pico. Nos horários de pico, os valores dobram. O pico ocorre nos dias úteis, das 9h às 12h e das 14h às 18h, no horário de Pequim.
- Nova cobrança: as APIs Search e Fetch custam US$ 0,75 por mil solicitações cada. A cobrança pelo uso via Harness, Claude Code e Codex começa em 1º de novembro.
- Como integrar: continue usando
deepseek-flash; não é preciso alterar o código. Basta fazer um teste de regressão antes da migração.
Resumo
Voltando às duas perguntas do título, a resposta pode ser resumida em três pontos:
- O que melhorou: o DeepSeek V4.1 Flash 1017 passou por um novo treinamento na mesma arquitetura. O maior avanço foi na capacidade de programação de agentes; a compreensão visual também melhorou de forma consistente. Além disso, as respostas ficaram mais curtas e rápidas.
- O preço mudou? Não. Continua no mesmo nível definido após a redução de setembro. Como as respostas ficaram mais curtas, o custo real diminui; nos horários de menor demanda, o preço cai pela metade.
- O que fazer? Não é preciso alterar o código, mas vale fazer um teste de regressão e avaliar o impacto da cobrança por chamada de Search/Fetch nos fluxos de trabalho de agentes a partir de novembro.
Para equipes que já usam ou pretendem usar o DeepSeek em agentes de programação, processamento em lote ou compreensão de gráficos, o 1017 é uma atualização que oferece mais sem aumentar o preço e merece ser testada em breve. Recomendamos validar os resultados rapidamente pela APIYI, em apiyi.com. Com uma interface unificada, você pode comparar o DeepSeek V4.1 Flash 1017 com outros modelos populares usando o mesmo conjunto de amostras e, então, decidir como distribuir o tráfego de produção.
Para saber mais Related Articles
Se você tem interesse na série DeepSeek, recomendamos estas leituras:
- 📘 DeepSeek V4.1 Flash: análise do lançamento, nova arquitetura e multimodalidade nativa — entenda as mudanças na arquitetura da versão lançada em setembro
- 📊 Guia de otimização de custos da API DeepSeek: acertos de cache e agendamento em horários de menor demanda — aprenda técnicas práticas para reduzir os custos com tokens
- 🚀 Como escolher modelos para agentes de programação: comparação entre Flash, Pro e os principais modelos proprietários — explore as melhores combinações para diferentes cenários
Referências
- Notas de atualização da API DeepSeek: comunicados oficiais de lançamento e dados de benchmark das versões V4.1 Flash e 1017
- Link:
api-docs.deepseek.com/updates -
Observação: principal fonte dos resultados de benchmark e das informações sobre versões apresentados neste artigo
-
Modelos e preços da DeepSeek: preços oficiais, horários de pico e regras de cobrança para Search/Fetch
- Link:
api-docs.deepseek.com/quick_start/pricing -
Observação: consulte a página oficial para ver os preços atualizados em tempo real
-
Cartão do modelo no Hugging Face: arquitetura, parâmetros e parâmetros de amostragem recomendados para o DeepSeek-V4.1-Flash
- Link:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash -
Observação: referência para implantação local e configuração de parâmetros
-
Artigo comparativo da Regolo: comparação de preços e resultados de benchmark do V4 Flash e do V4.1 Flash
- Link:
regolo.ai - Observação: o preço antigo do V4 Flash citado neste artigo vem dessa compilação de terceiros
Autor: Equipe técnica da APIYI
Discussão técnica: participe da conversa nos comentários. Para consultar mais materiais, acesse o centro de documentação da APIYI em docs.apiyi.com.