Nota do autor: os dois modelos custam o mesmo no horário de pico, mas se destacam em tarefas diferentes. Neste artigo, quatro tabelas comparam parâmetros, preços, benchmarks e divisão de tarefas para ajudar você a escolher o modelo certo.
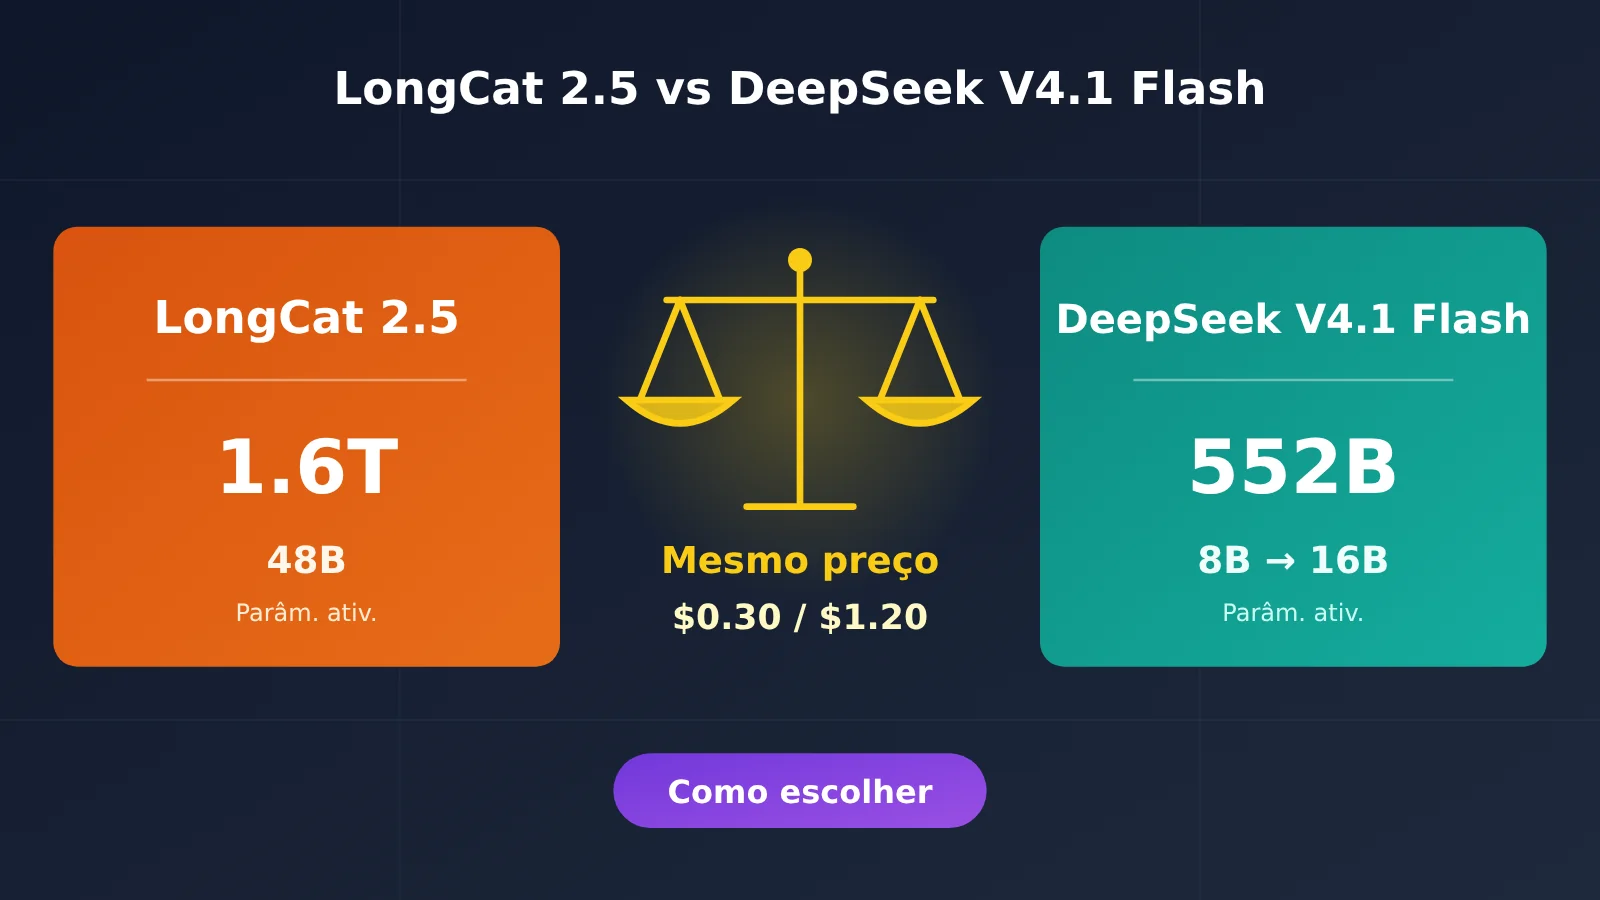
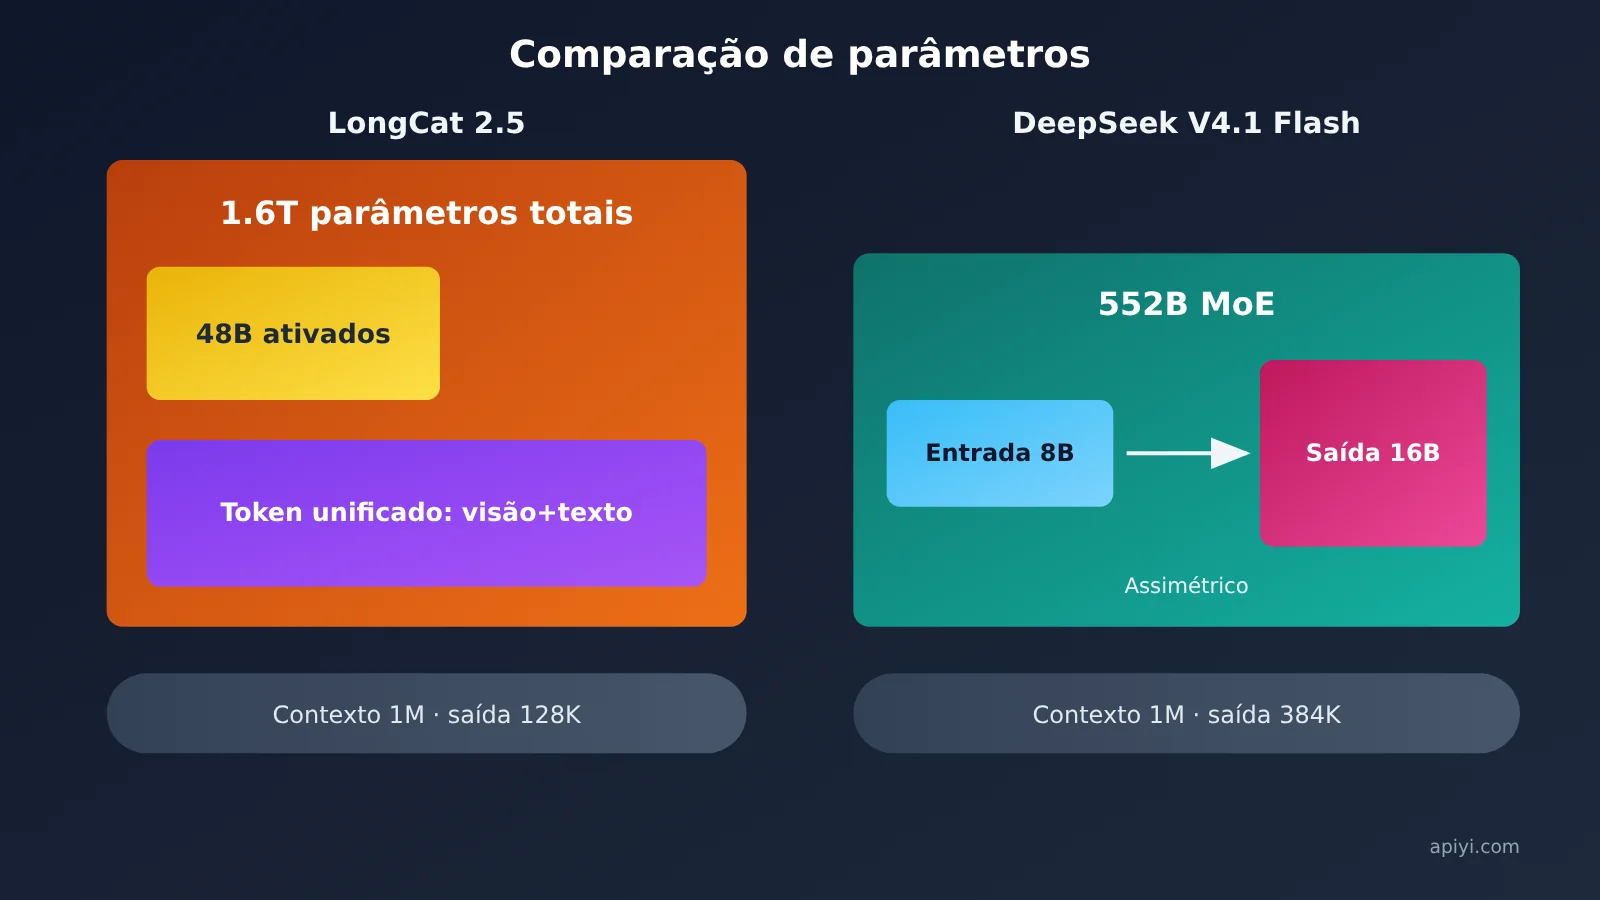
No horário de pico, os preços são idênticos: US$ 0,30 para entrada, US$ 0,006 para cache e US$ 1,20 para saída (por 1 milhão de tokens). A diferença está nas tarefas em que cada um se destaca. O LongCat 2.5 é um modelo multimodal nativo com 1,6 trilhão de parâmetros no total e cerca de 48 bilhões ativados por token. O DeepSeek V4.1 Flash é um MoE assimétrico com 552 bilhões de parâmetros, dos quais 8 bilhões são ativados na entrada e 16 bilhões na saída. Seus pesos já foram disponibilizados abertamente.
Este não é um artigo conciliador do tipo «cada um tem seus pontos fortes». Todos os números abaixo vêm dos blogs oficiais, relatórios técnicos e páginas de preços das duas empresas. Os resultados de benchmarks foram medidos pelas próprias empresas. Aqui, servem apenas como referência entre modelos da mesma categoria: não há ranking geral nem testes práticos que não tenham sido realizados.
O que você vai levar deste artigo: ao terminar a leitura, você poderá comparar cada tarefa do seu projeto, decidir qual modelo usar como principal e qual usar como complemento, além de calcular quanto pode economizar ao transferir tarefas em lote para horários fora do pico.
LongCat 2.5 vs. DeepSeek V4.1 Flash: os modelos em resumo
A conclusão é direta: o LongCat 2.5 tem mais parâmetros totais e ativa mais parâmetros a cada token. O DeepSeek V4.1 Flash é menor e ativa menos parâmetros, além de ter um limite de saída maior e pesos disponíveis para download. Ambos têm janela de contexto de 1M. Na hora de escolher, três fatores fazem a diferença: saída máxima de 128K contra 384K, disponibilidade dos pesos e quantidade de parâmetros ativados.
| Critério | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Parâmetros totais | 1,6T (1,6 trilhão) | 552B |
| Parâmetros ativados | Cerca de 48B por token | 8B na entrada e 16B na saída |
| Arquitetura | Modelo multimodal nativo voltado para agentes, com processamento unificado de tokens visuais e textuais | MoE, arquitetura assimétrica Causal-Encoder-Decoder |
| Janela de contexto | 1M | 1M |
| Saída máxima | 128K | 384K |
| Visão nativa | Sim, com sinais visuais representados por tokens discretos em vários níveis | Sim (Vision) |
| Pesos abertos | Pesos ainda não disponibilizados; GitHub e HuggingFace indicam que serão lançados em breve | Pesos abertos e publicados no HuggingFace, acompanhados de relatório técnico |
| Modo de raciocínio | Resultados das avaliações oficiais obtidos com o modo thinking ativado | Ativado por padrão, com ajuste pelo parâmetro reasoning_effort |
Principais aspectos da arquitetura do LongCat 2.5
O posicionamento do LongCat 2.5 é direto: tarefas de agentes de longa duração. Em relação à versão 2.0, ele reforça principalmente a compreensão visual nativa e a programação por agentes. Na parte visual, as imagens passam por uma discretização na resolução nativa (SAE+RVQ) e são pré-processadas offline em tokens visuais. Depois, esses tokens são usados no treinamento conjunto com o modelo principal. Como o modelo usa o mesmo conjunto de tokens para processar imagens e texto, ele é considerado multimodal nativo.
No treinamento, o LongCat 2.5 usa extensivamente dados de trajetórias longas e aprendizado por reforço (RL) de longa duração em larga escala. O blog oficial destaca alguns detalhes: trajetórias de falha de agentes reais são transformadas em tarefas verificáveis; o RL assíncrono usa rollouts parciais e filtra grupos de amostras em que todas as respostas estão corretas ou incorretas, produzindo gradiente zero; e há penalidades para raciocínios e chamadas de ferramentas repetitivos. Esse último ponto é importante para quem desenvolve agentes: o modelo tende a ficar menos preso em ciclos de chamadas de ferramentas, desperdiçando menos tokens.
Na engenharia de inferência, o W4A4, em comparação com o W8A8 INT8, aumenta a vazão do prefill em 43,3% e a do decode em 42,77%, além de reduzir o TTFT em 15,91% e o TPOT em 19,72%. No treinamento, o FSDP com particionamento duplo aumenta a vazão por GPU no SFT de sequências longas em 86% em relação à referência com DDP. Esses números mostram que o modelo de 1,6T passou por uma compressão específica para execução no servidor, mas a equipe oficial não divulgou limites de taxa.
Principais pontos da arquitetura do DeepSeek V4.1 Flash
O DeepSeek V4.1 Flash é o menor modelo da nova família de arquiteturas. Sua principal característica é a assimetria entre entrada e saída: ele ativa apenas 8B de parâmetros ao ler a entrada e 16B ao gerar a saída. Em cenários com agentes, a entrada costuma ser muito maior que a saída — como na leitura de repositórios, logs e retornos de ferramentas. Esse design reduz justamente o processamento necessário na etapa de leitura.
A mudança nos custos é ainda maior. O KV Cache da nova geração ficou bem menor: a necessidade de HBM caiu para 1/4 da geração anterior, e a de SSD, para 1/8. Em relação ao modelo de primeira geração, o KV Cache encolheu 437 vezes no total. Há outra mudança importante: a partir de 14/09/2026 às 12h, as solicitações para deepseek-v4-pro serão encaminhadas para o V4.1 Flash e cobradas pelo preço do Flash. Essa medida continuará em vigor até o lançamento do V4.1 Pro. Projetos que ainda usam o nome do modelo antigo passarão a chamar o Flash.
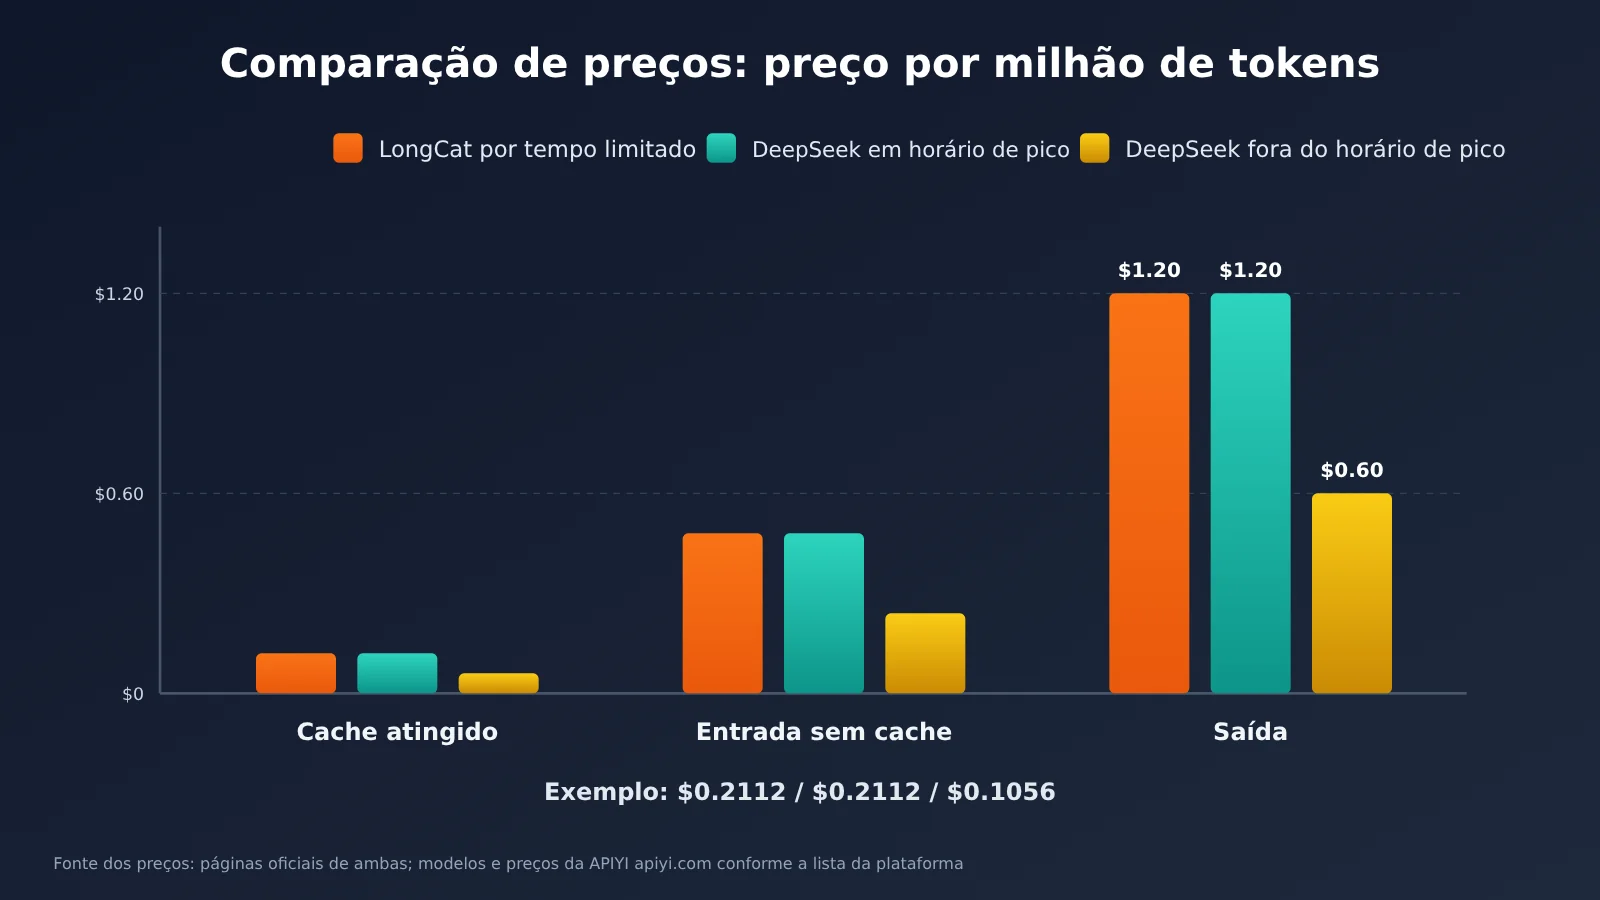
Preço do LongCat 2.5 vs. DeepSeek V4.1 Flash: o empate só vale no horário de pico
A conclusão: o preço promocional por tempo limitado do LongCat 2.5 é igual ao preço do DeepSeek V4.1 Flash no horário de pico, em cada categoria. Fora do pico, o DeepSeek oferece 50% de desconto, então a mesma tarefa custa metade. Portanto, dizer que os dois têm o mesmo preço só faz sentido durante o horário de pico nos dias úteis.
| Por 1 milhão de tokens (dólares) | LongCat 2.5 (promoção por tempo limitado) | DeepSeek no pico | DeepSeek fora do pico |
|---|---|---|---|
| Entrada encontrada no cache | $0.006 | $0.006 | $0.003 |
| Entrada não encontrada no cache | $0.30 | $0.30 | $0.15 |
| Saída | $1.20 | $1.20 | $0.60 |
Vamos fazer as contas. Suponha que uma tarefa de agente consuma 500 mil tokens de entrada (300 mil não encontrados no cache e 200 mil encontrados) e 100 mil tokens de saída:
- LongCat 2.5 (promoção por tempo limitado): 0.3×0.30 + 0.2×0.006 + 0.1×1.20 = $0.2112
- DeepSeek no pico: o cálculo é o mesmo, $0.2112
- DeepSeek fora do pico: 0.3×0.15 + 0.2×0.003 + 0.1×0.60 = $0.1056
A diferença por tarefa é de cerca de 10 centavos de dólar, o que não parece muito. Mas, com 1.000 tarefas do mesmo tamanho por dia, LongCat e DeepSeek no pico custam $211.2, enquanto o DeepSeek fora do pico sai por $105.6. Para equipes que processam tarefas em lote, a diferença ao longo de um mês é considerável.
O horário de pico do DeepSeek vai das 09:00 às 12:00 e das 14:00 às 18:00, nos dias úteis, no horário de Pequim. Isso corresponde a 01:00-04:00 e 06:00-10:00 UTC, de segunda a sexta, exceto nos feriados nacionais chineses. Todo o restante é considerado fora do pico, com preço pela metade: o intervalo do almoço, a noite e a madrugada nos dias úteis, além de fins de semana e feriados inteiros. Em outras palavras, das 168 horas de uma semana, o pico ocupa apenas 7 horas por dia útil.
Também vale anotar alguns detalhes da cobrança do LongCat 2.5:
- Só há cobrança para HTTP 200. Respostas 401, 403, 429 e 500 não são cobradas, então tentativas malsucedidas não custam nada.
- Pacotes de créditos são vendidos em ofertas relâmpago com quantidade limitada, diariamente às 10:00, 16:00, 21:00 e 23:00 no horário de Pequim. Valem por 30 dias, e o saldo não utilizado pode ser reembolsado integralmente; entradas encontradas no cache não consomem tokens do pacote.
- Créditos gratuitos: 10M de tokens para novos usuários e 5M para usuários existentes, adicionados automaticamente. Entradas encontradas no cache não consomem esses créditos.
- O preço está marcado como promoção por tempo limitado. Para saber se houve alterações, consulte a página oficial de preços.
No caso do DeepSeek, a busca na web e a extração de páginas são APIs cobradas separadamente, a $0.75 por 1.000 requisições bem-sucedidas, com o mesmo preço para ambas. Se seu agente acessa a web com frequência, inclua esse custo no orçamento.
💰 Dica sobre custos: se você invocar o DeepSeek V4.1 Flash pela APIYI apiyi.com, a cobrança seguirá a lista de modelos da plataforma e não necessariamente os preços oficiais de pico e fora de pico. Para ter uma estimativa mais precisa, execute primeiro um pequeno lote de tarefas no console, confira a fatura e só então planeje o processamento em escala.
Comparação dos resultados oficiais: LongCat 2.5 vs. DeepSeek V4.1 Flash
Conclusão: os dois modelos apresentam uma diferença de menos de 3 pontos na maioria dos benchmarks de agentes, ficando basicamente no mesmo patamar. O LongCat 2.5 lidera em Terminal Bench v4.0, Program Bench, JobBench e geração 3D; o DeepSeek V4.1 Flash lidera em DeepSWE, NL2Repo e AutomationBench, com uma vantagem maior.
| Benchmark | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 90.6 |
| Terminal Bench v4.0 | 38.5 | 31.2 |
| Program Bench | 25.5 | 20.3 |
| DeepSWE v1.1 | 64.6 | 74.2 |
| NL2Repo | 60.5 | 65.4 |
| BrowseComp | 91.9 | 91.5 |
| HLE w/tools | 63.1 | 63.9 |
| AutomationBench | 51.8 | 54.8 |
| MCP Atlas | 83.1 | 84.4 |
| JobBench | 65.4 | 63.2 |
| 3DCodeBench(Texto para 3D) | 55.4 | 53.3 |
| Vision2Web | 78.6 | 79.2 |
Sobre os critérios de avaliação (leitura obrigatória): os números dos dois modelos vêm de testes conduzidos pelas próprias empresas. Os resultados do LongCat 2.5 foram obtidos com seu próprio harness, com o modo thinking ativado, temperature=1.0 e top_p=0.95. A maioria dos resultados do DeepSeek vem de seu relatório técnico público e foi obtida com o harness da própria DeepSeek e o nível de inferência Max. Como os harnesses, as datas das avaliações e os níveis de inferência são diferentes, a tabela serve apenas como referência entre modelos de uma mesma categoria e não constitui um ranking.
Como interpretar os resultados
As duas maiores diferenças apontam em direções opostas. No Terminal Bench v4.0, o LongCat 2.5 supera o DeepSeek em 7,3 pontos (38,5 contra 31,2); no DeepSWE v1.1, o DeepSeek supera o LongCat em 9,6 pontos (74,2 contra 64,6). O primeiro avalia tarefas de terminal mais difíceis e longas; o segundo, a correção de bugs em repositórios reais. É aí que os pontos fortes dos modelos se separam: um se destaca em operações de terminal com muitas etapas, enquanto o outro é melhor em fazer alterações precisas em bases de código existentes.
Na versão anterior do Terminal Bench, a v2.1, o DeepSeek fica 2,2 pontos à frente. Isso indica que a vantagem do LongCat aparece quando a dificuldade aumenta. No Program Bench, o LongCat lidera por 5,2 pontos; no NL2Repo, o DeepSeek fica à frente por 4,9 pontos. O NL2Repo avalia a geração de um repositório inteiro a partir de uma descrição em linguagem natural, algo mais próximo da capacidade de criar projetos do zero.
Nas avaliações relacionadas à visão, as diferenças são pequenas. No Vision2Web, o DeepSeek lidera por 0,6 ponto; no 3DCodeBench, o LongCat fica à frente por 2,1 pontos. Na tabela oficial, o LongCat marca 90,2 contra 87,7 no CharXiv-RQ com ferramentas; já no MathVision com ferramentas, o DeepSeek marca 97,4 contra 96,5. Considerando apenas a compreensão visual, os dois estão bem próximos. A vantagem do LongCat aparece principalmente na combinação dessa compreensão com a geração de conteúdo 3D e páginas interativas. Entre as oito demonstrações oficiais estão uma simulação de fluidos em tempo real, uma exposição interativa de artefatos em 3D, uma maquete urbana e elementos para cenários em miniatura — deixando claro o foco do modelo.
No BrowseComp, no HLE com ferramentas e no MCP Atlas, as diferenças ficam abaixo de 1,3 ponto. Portanto, em capacidades gerais de agentes, como pesquisa na internet e uso de ferramentas MCP, os dois podem ser considerados empatados.
Os níveis de raciocínio do DeepSeek ajudam a controlar os custos
A seção 5.3.3 do relatório técnico da DeepSeek traz dados bastante úteis. Ao aumentar o reasoning effort de 25 para 100, a média de Pass@1 em oito benchmarks de raciocínio sobe de 67,1% para 76,3%, e a pontuação no DeepSWE v1.1 vai de 66,0 para 74,2. Em contrapartida, a quantidade de tokens de saída aumenta cerca de 2,5 vezes. Os níveis de 60 a 80 já chegam perto da precisão máxima, usando menos da metade do orçamento de tokens do nível máximo. Ao subir até 100, a trajetória do agente fica de 1,6 a 1,8 vez mais longa, em troca de ganhos marginais.
Outro detalhe: o valor padrão de reasoning_effort na API da DeepSeek é high, mas os resultados oficiais foram obtidos no nível Max. Para reproduzir as pontuações da coluna DeepSeek na tabela acima, é preciso defini-lo explicitamente como max. Para tarefas do dia a dia, use um nível intermediário e reserve o máximo para as mais difíceis. Os tokens de saída são o item mais caro na cobrança das duas empresas ($1.20), então essa configuração afeta diretamente os custos.
LongCat 2.5 vs. DeepSeek V4.1 Flash: como dividir as tarefas
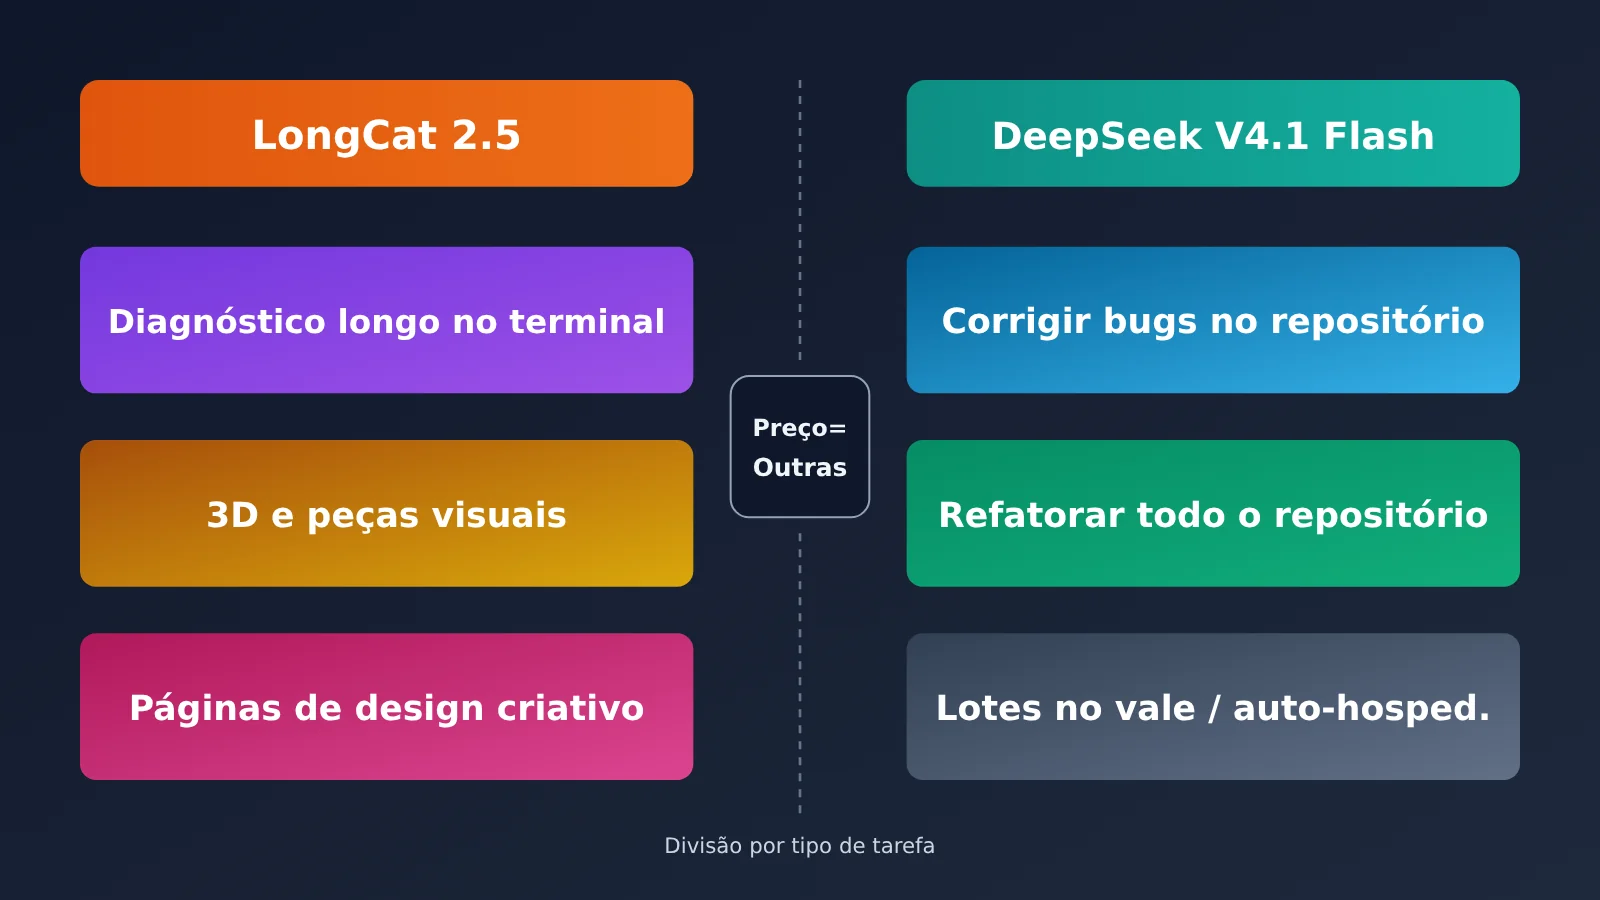
A conclusão é simples: mesmo preço, trabalhos diferentes. Deixe tarefas longas no terminal, projetos visuais e 3D e páginas de design criativo com o LongCat 2.5. Para alterações em repositórios reais, correção de bugs de software, pipelines de automação e cenários que exigem implantação própria, escolha o DeepSeek V4.1 Flash.
| Mais adequado para o LongCat 2.5 | Mais adequado para o DeepSeek V4.1 Flash |
|---|---|
| Diagnóstico prolongado no terminal: acessar servidores, consultar logs, alterar configurações, reiniciar e validar em várias etapas (7,3 pontos à frente no Terminal Bench v4.0) | Correção de bugs em repositórios reais: ler issues, localizar arquivos, fazer alterações e passar nos testes (9,6 pontos à frente no DeepSWE) |
| Assets 3D e projetos visuais: gerar cenas 3D a partir de texto e criar páginas interativas de apresentação (55,4 no 3DCodeBench) | Refatoração de repositórios inteiros e criação do zero: gerar projetos com vários arquivos a partir da descrição dos requisitos (4,9 pontos à frente no NL2Repo) |
| Páginas de design criativo: convites para eventos, páginas com cores estilizadas e relatórios de visualização de dados (casos mostrados nas demonstrações oficiais) | Pipelines de automação e processamento em lote: tarefas noturnas, limpeza de dados e geração de relatórios (3,0 pontos à frente no AutomationBench, metade do preço fora do horário de pico) |
| Construção de programas no estilo de desafios de programação e tarefas profissionais abrangentes (lidera no Program Bench e no JobBench) | Cenários que exigem implantação própria ou privada: pesos disponíveis em código aberto no HuggingFace; saída longa em uma única resposta (máximo de 384K) |
Por que escolher o LongCat 2.5
O resultado mais convincente do LongCat 2.5 está no Terminal Bench v4.0. Na v2.1, ele ficava 2,2 pontos atrás; na v4.0, passou a liderar por 7,3 pontos. Isso sugere que, quanto mais longa e difícil a tarefa, maior sua vantagem relativa. O resultado faz sentido considerando o uso intensivo de trajetórias longas no treinamento e a aplicação de penalidades por chamadas repetidas de ferramentas. Se o seu agente costuma executar dezenas de etapas seguidas no terminal, vale a pena testar o LongCat 2.5 primeiro.
Outro motivo são as tarefas que combinam visão e geração. A capacidade multimodal nativa, junto com o treinamento voltado a 3D e páginas interativas, torna o modelo mais adequado para trabalhos como criar layouts a partir de imagens ou gerar modelos 3D a partir de texto. Além disso, novos usuários recebem 10 milhões de tokens, e as requisições atendidas pelo cache não descontam dessa cota. Assim, o custo inicial para testar é baixo.
Por que escolher o DeepSeek V4.1 Flash
O número mais forte do DeepSeek V4.1 Flash é a pontuação de 74,2 no DeepSWE, a maior diferença entre os itens comparados das duas empresas. No dia a dia da programação, uma das tarefas mais comuns é modificar um repositório existente — justamente o ponto forte do modelo. Seu limite máximo de saída de 384K é três vezes maior que o do LongCat, reduzindo o risco de truncamento ao gerar arquivos longos ou patches extensos.
O terceiro motivo é a estrutura de custos. O preço cai pela metade fora do horário de pico e, junto com os níveis de raciocínio ajustáveis, oferece muito mais flexibilidade de custos para tarefas em lote do que o preço fixo por tempo limitado do LongCat. O limite de 2.500 requisições simultâneas também está na documentação oficial, dando uma referência clara para planejar a capacidade de processamento. Equipes que precisam de implantação privada podem baixar os pesos diretamente. Porém, segundo a documentação oficial, uma implantação em grande escala exige recursos na ordem de 2 mil GPUs. Equipes pequenas devem avaliar o hardware necessário antes de hospedar o modelo por conta própria.
💡 Como escolher: a tabela ajuda a restringir as opções, mas a decisão final depende das suas tarefas. Escolha de 10 a 20 tarefas representativas do seu projeto, execute-as nos dois modelos e compare a taxa de sucesso e o consumo de tokens. Para testar o DeepSeek V4.1 Flash, você pode começar usando a APIYI apiyi.com, sem precisar criar uma conta separada.
Como integrar o LongCat 2.5 e o DeepSeek V4.1 Flash
Em resumo: ambos são compatíveis com os formatos de interface da OpenAI e da Anthropic. Para usar com o Claude Code, basta alterar algumas variáveis de ambiente em ~/.claude/settings.json. O DeepSeek também oferece suporte à Responses API.
Integração do LongCat 2.5
- Formato OpenAI (qualquer SDK da OpenAI): defina base_url como
https://api.longcat.ai/openaie o nome do modelo comoLongCat-2.5. - Formato Anthropic (SDK da Anthropic): defina base_url como
https://api.longcat.ai/anthropic. - Claude Code (edite o campo env de
~/.claude/settings.json): configure as quatro variáveis: - Defina
ANTHROPIC_AUTH_TOKENcom sua chave do LongCat - Defina
ANTHROPIC_BASE_URLcomohttps://api.longcat.ai/anthropic - Defina
ANTHROPIC_MODELcomoLongCat-2.5 - Defina
CLAUDE_CODE_MAX_OUTPUT_TOKENScomo131072 - Tratamento de limite de requisições (no seu código de chamada): ao exceder o limite, a API retorna 429 (rate_limit_exceeded, retry_after 60). A recomendação oficial é usar espera exponencial entre tentativas. A documentação não divulga valores de RPM/TPM, e respostas 429 não são cobradas.
Integração do DeepSeek V4.1 Flash
- Formato OpenAI (qualquer SDK da OpenAI): defina o nome do modelo como
deepseek-flash. Os nomes antigosdeepseek-v4-flashedeepseek-v4-flash-vision-expainda funcionam e são direcionados para o V4.1-Flash-1017, com cobrança pelo preço do Flash. - Claude Code (edite o campo env de
~/.claude/settings.json): - Defina
ANTHROPIC_AUTH_TOKENcom sua chave do DeepSeek - Defina
ANTHROPIC_BASE_URLcomohttps://api.deepseek.com/anthropic - Defina
ANTHROPIC_MODELcomodeepseek-flash - Nível de raciocínio (parâmetro da requisição no SDK da OpenAI): no dia a dia, defina
reasoning_effortno nível intermediário; para problemas difíceis, usemax. - Ferramentas prontas: WorkBuddy (incluindo CodeBuddy) e OpenCode são ferramentas parceiras oficiais e já oferecem integração completa.
Invocação unificada pela APIYI
Se você precisa executar vários modelos para compará-los, a APIYI permite alternar entre eles com uma única conta e uma chave API, sem precisar criar uma conta em cada provedor.
- Configuração do SDK da OpenAI (no código do seu projeto): defina base_url como
https://api.apiyi.com/v1e api_key com a chave gerada no console da APIYI. - Nome do modelo (alterado no mesmo parâmetro da requisição): para o DeepSeek V4.1 Flash, use
deepseek-v4.1-flashoudeepseek-v4.1-flash-1017. A cobrança segue a lista de modelos da plataforma. - Testes comparativos (com o mesmo código): basta alterar o parâmetro model para executar o mesmo conjunto de tarefas lado a lado com outros modelos da plataforma. O base_url continua sendo
https://api.apiyi.com/v1.
Consulte a lista de modelos da plataforma para conferir modelos e preços. O LongCat-2.5 ainda não está disponível na APIYI, mas será lançado em breve. Até lá, use o endpoint oficial para o LongCat 2.5 e gerencie o DeepSeek pela APIYI em apiyi.com.
🚀 Comece agora: novos usuários recebem créditos gratuitos para testes ao se cadastrar na APIYI em apiyi.com. Integre o DeepSeek V4.1 Flash ao seu projeto existente com o SDK da OpenAI: basta alterar uma linha do base_url para começar.
Perguntas frequentes sobre LongCat 2.5 e DeepSeek V4.1 Flash
P1: Os preços dos dois são mesmo iguais?
Só nos horários de pico do DeepSeek. O preço promocional por tempo limitado do LongCat 2.5 é de $0.30 / $0.006 / $1.20, igual ao do DeepSeek no horário de pico em cada item. Fora do pico, todos os preços do DeepSeek caem pela metade. Esse desconto vale em todos os horários, exceto nos dias úteis das 09:00 às 12:00 e das 14:00 às 18:00. Além disso, o preço do LongCat é uma promoção por tempo limitado e pode mudar no futuro.
P2: A tabela de benchmarks mostra qual é o melhor?
Não dá para classificá-los diretamente. Os resultados são de testes feitos pelas próprias empresas, com ferramentas de teste, datas e níveis de raciocínio diferentes. Além disso, a coluna do DeepSeek mostra resultados no nível Max. A melhor forma de ler a tabela é observar os testes com diferenças maiores: no Terminal Bench v4.0, o LongCat lidera por 7,3 pontos; no DeepSWE, o DeepSeek lidera por 9,6 pontos. Nos testes com diferença de até 1 ou 2 pontos, vale considerar um empate.
P3: Quando o LongCat 2.5 será disponibilizado como código aberto?
A empresa não divulgou um cronograma. Por enquanto, tanto no GitHub quanto no Hugging Face consta a mensagem “em breve”, sem disponibilização dos pesos. Para projetos que exigem implantação própria, a única opção no momento é o DeepSeek V4.1 Flash, cujos pesos e relatório técnico já foram publicados.
P4: É possível usar os dois modelos na APIYI?
No momento, só é possível usar o DeepSeek V4.1 Flash, nas versões `deepseek-v4.1-flash` e `deepseek-v4.1-flash-1017`, com cobrança conforme a lista de modelos da plataforma. O LongCat-2.5 ainda não está disponível na APIYI, mas será lançado na plataforma o mais rápido possível. Consulte a lista de modelos da APIYI em apiyi.com para conferir as versões e os preços atualizados.
P5: Como reduzir os custos de tarefas em lote?
Ao usar o DeepSeek, aproveite duas configurações: programe as tarefas para horários fora do pico, quando o preço cai pela metade, e defina reasoning_effort em um nível intermediário. Segundo o relatório, a faixa de 60 a 80 já oferece precisão próxima à do nível máximo, usando menos da metade do orçamento de tokens. O preço com acerto de cache é apenas 1/50 do preço sem acerto. Para aumentar a taxa de acerto, coloque os comandos de sistema fixos e as definições de ferramentas no início da requisição.
Resumo: como escolher entre LongCat 2.5 e DeepSeek V4.1 Flash
A conclusão é simples: o preço é parecido, mas cada modelo se destaca em tarefas diferentes. Escolha conforme o trabalho e execute tarefas em lote fora do horário de pico.
- Escala: 1,6T de parâmetros, com 48B ativados, contra 552B, com 8B ativados na entrada e 16B na saída. Ambos têm janela de contexto de 1M.
- Limite de saída: 128K para o LongCat e 384K para o DeepSeek. Para respostas longas, escolha o DeepSeek.
- Preço: o preço promocional por tempo limitado do LongCat é igual ao preço do DeepSeek no horário de pico. Fora do pico, o DeepSeek custa metade: no exemplo, US$ 0,2112 contra US$ 0,1056.
- Benchmarks: o LongCat fica 7,3 pontos à frente em tarefas prolongadas no terminal; o DeepSeek lidera por 9,6 pontos na correção de bugs em repositórios. Na maioria dos outros testes, há empate.
- Código aberto: o DeepSeek já é aberto; o LongCat não disponibilizou os pesos.
- Integração: ambos são compatíveis com os formatos OpenAI e Anthropic. No Claude Code, basta alterar as variáveis de ambiente para trocar de modelo.
Em resumo: escolha um modelo principal conforme a tabela de tarefas e deixe o outro como complemento. Sempre que possível, execute tarefas em lote fora do horário de pico. Para o DeepSeek V4.1 Flash, você pode fazer uma validação em pequena escala pela APIYI apiyi.com, usando uma interface unificada, antes de decidir qual será seu modelo principal.
📚 Referências
- Blog oficial do LongCat-2.5: proposta do modelo, arquitetura, treinamento e detalhes de engenharia
- Link:
longcat.ai/blog/longcat-2.5 -
Conteúdo: escala de parâmetros, solução para tokens visuais, dados de inferência W4A4 e tabela oficial de avaliações
-
Documentação da plataforma aberta LongCat: preços, endpoints e integração com Claude Code
- Link:
longcat.ai/platform/docs -
Conteúdo: preço promocional por tempo limitado, tratamento de erros 429, pacotes de créditos e regras de créditos gratuitos
-
Anúncio do DeepSeek V4.1 Flash: arquitetura, código aberto e mudanças na API
- Link:
deepseek.com/news/deepseek-v4-1-flash -
Conteúdo: MoE assimétrico, compressão do KV Cache e orientações para migração dos nomes dos modelos
-
Página de preços da API DeepSeek: preços nos horários de pico e fora de pico e limites de concorrência
- Link:
api-docs.deepseek.com/quick_start/pricing -
Conteúdo: definição dos horários de pico e fora de pico, limite de 2.500 chamadas simultâneas e cobrança separada por buscas e extração de conteúdo
-
Repositório de pesos do DeepSeek-V4.1-Flash: pesos abertos e relatório técnico
- Link:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash - Conteúdo: resultados dos benchmarks na Tabela 3 e análise dos níveis de inferência na seção 5.3.3
Autor: equipe técnica da APIYI
Contato técnico: entre em contato pela página inicial da APIYI em apiyi.com. Para mais informações sobre integração, acesse o centro de documentação em docs.apiyi.com.