作者注:DeepSeek Harnessで推論レベルをどちらもMaxに設定した場合、V4.1-FlashとV4-Proのどちらを選ぶべきでしょうか?本記事では、知能、価格、速度の3つの観点から比較し、コーディングでFlashをデフォルトにする理由と、Proに切り替えるのが適した場面を解説します。
DeepSeek Harnessのモデル選択メニューを開くと、DeepSeek-V4.1-FlashとDeepSeek-V4-Proの2つが表示されます。一般的には、名前にProが付いていて、パラメーター数も多いモデルのほうが賢いと思うかもしれません。推論レベルをどちらもMaxにした場合、開発者が本当に知りたいのは、どちらがより賢くコードを書けるのか? 価格や速度にはどれほど差があるのか、という点です。
これは「どちらにも一長一短がある」という折衷的な分析ではありません。 DeepSeek公式の価格ページ、更新履歴、公式ベンチマーク、第三者による実測データを確認した結果、結論は明確です。DeepSeek Harnessでコーディングをするなら、デフォルトはFlash。Proは知識や事実の確認、長文ドキュメントの読解を補助するモデルとして使うのが適しています。
この記事でわかること:DeepSeek HarnessのProとFlashがそれぞれどのバージョンに対応するのか、推論レベルをMaxにしたときにどちらのコーディング能力が高いのか、料金と速度にどれほど差があるのか、タスクに応じてどう使い分ければよいのかを解説します。
DeepSeek Harness の Pro と Flash はそれぞれどのバージョン?
「どちらが賢いか」を議論する前に、DeepSeek Harness の一覧にある2つの項目が、実際にはどのチェックポイントに対応しているのかを確認しましょう。Pro については古いバージョンの印象を持つ人も多いですが、モデル名と実際のバージョンが常に同時に更新されるとは限りません。
| Harness の表示名 | API ID | 実際のチェックポイント | リリース状況 |
|---|---|---|---|
| DeepSeek-V4.1-Flash | deepseek-flash |
V4.1-Flash-1017(10 月 17 日更新) | 現在の主力。Harness 向けに専用最適化 |
| DeepSeek-V4-Pro | deepseek-v4-pro |
V4-Pro-0813(8 月 13 日 GA) | 引き続き提供中。移行期の位置づけ |
DeepSeek V4 Pro は提供終了する?
コミュニティでは以前から「Pro が提供終了する」という話が出ていましたが、これには根拠があります。9 月 10 日に V4.1 Flash がリリースされた際、公式からも、9 月 14 日以降に V4 Pro のサービスを停止するという告知がありました。しかし、同じ更新履歴の続きには、ユーザーからの要望を受け、2026 年 9 月 14 日以降も DeepSeek V4 Pro の API サービスを継続し、料金体系も変更しないと記載されています。
そのため、Pro は現在も通常どおり利用できますが、位置づけはすでに移行期の製品となっています。V4.1 Pro は今のところ正式リリースされておらず、10 月末には公式サイトのモデル表記の変更をめぐる憶測が一度出た程度です。また、初期の「Pro はいまひとつ」という評価は、主に V4-Pro プレビュー版の過学習に関するものでした。8 月の GA 版では大きく改善されましたが、コーディング能力全体では依然として Flash を上回っていません。
DeepSeek Pro と Flash のパラメーター規模の違い
2つのモデルの規模には大きな差があります。そのため、Pro のほうが強いと考える人が多いのも無理はありません。
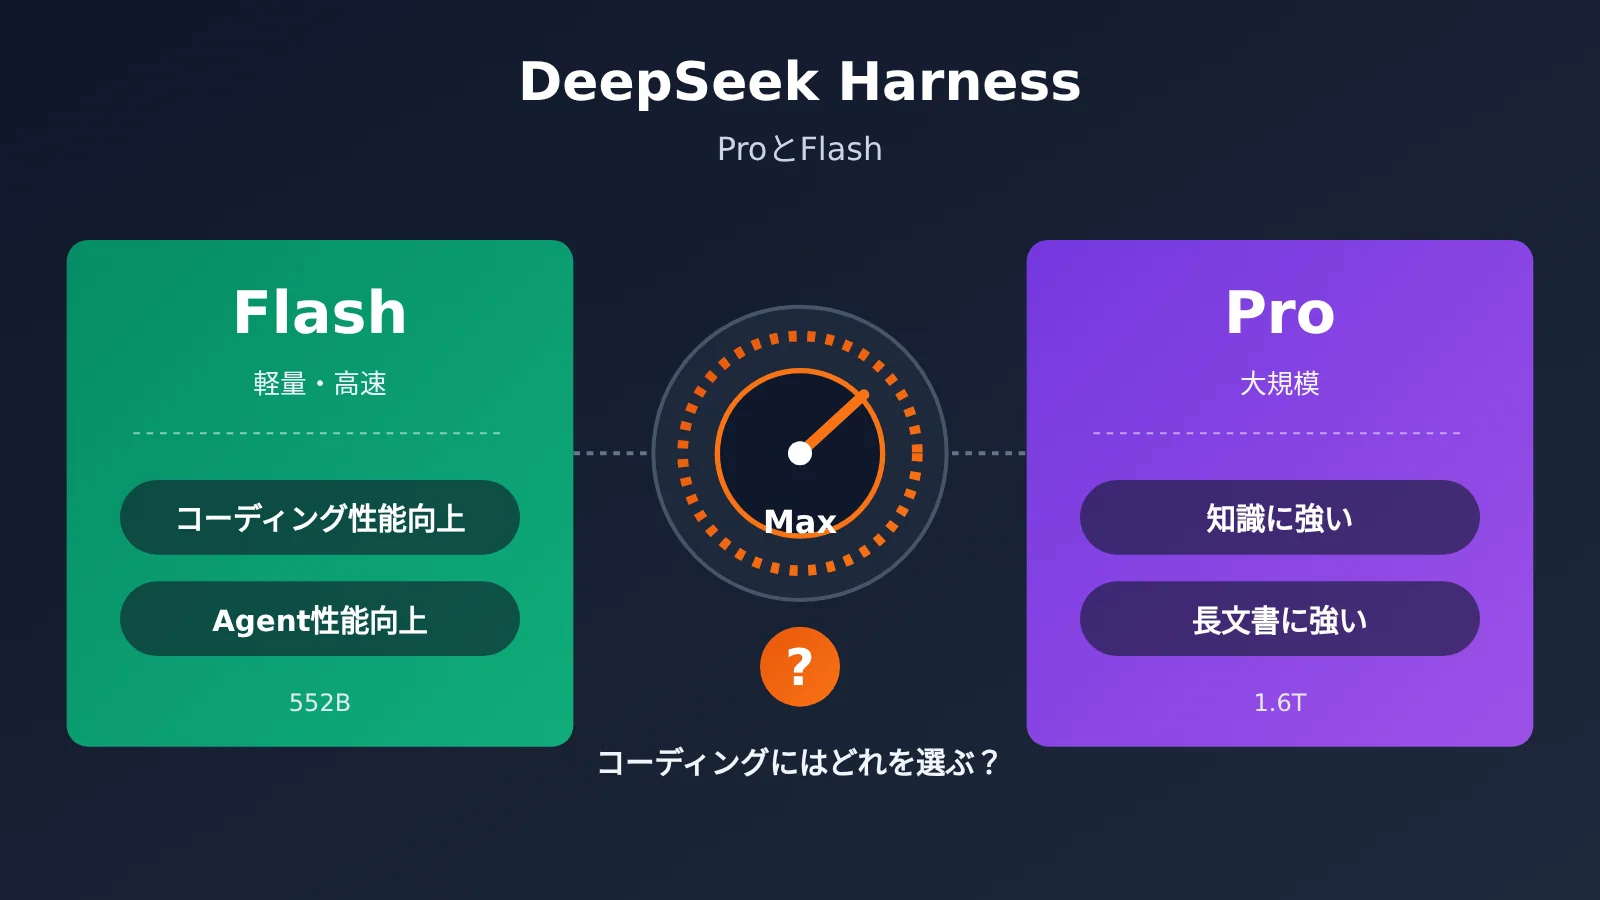
- Flash:総パラメーター数 552B の MoE アーキテクチャ。入力時のアクティブパラメーターは約 8B、出力時は約 16B。1M コンテキストに対応
- Pro:総パラメーター数 1.6T、アクティブパラメーターは約 49B
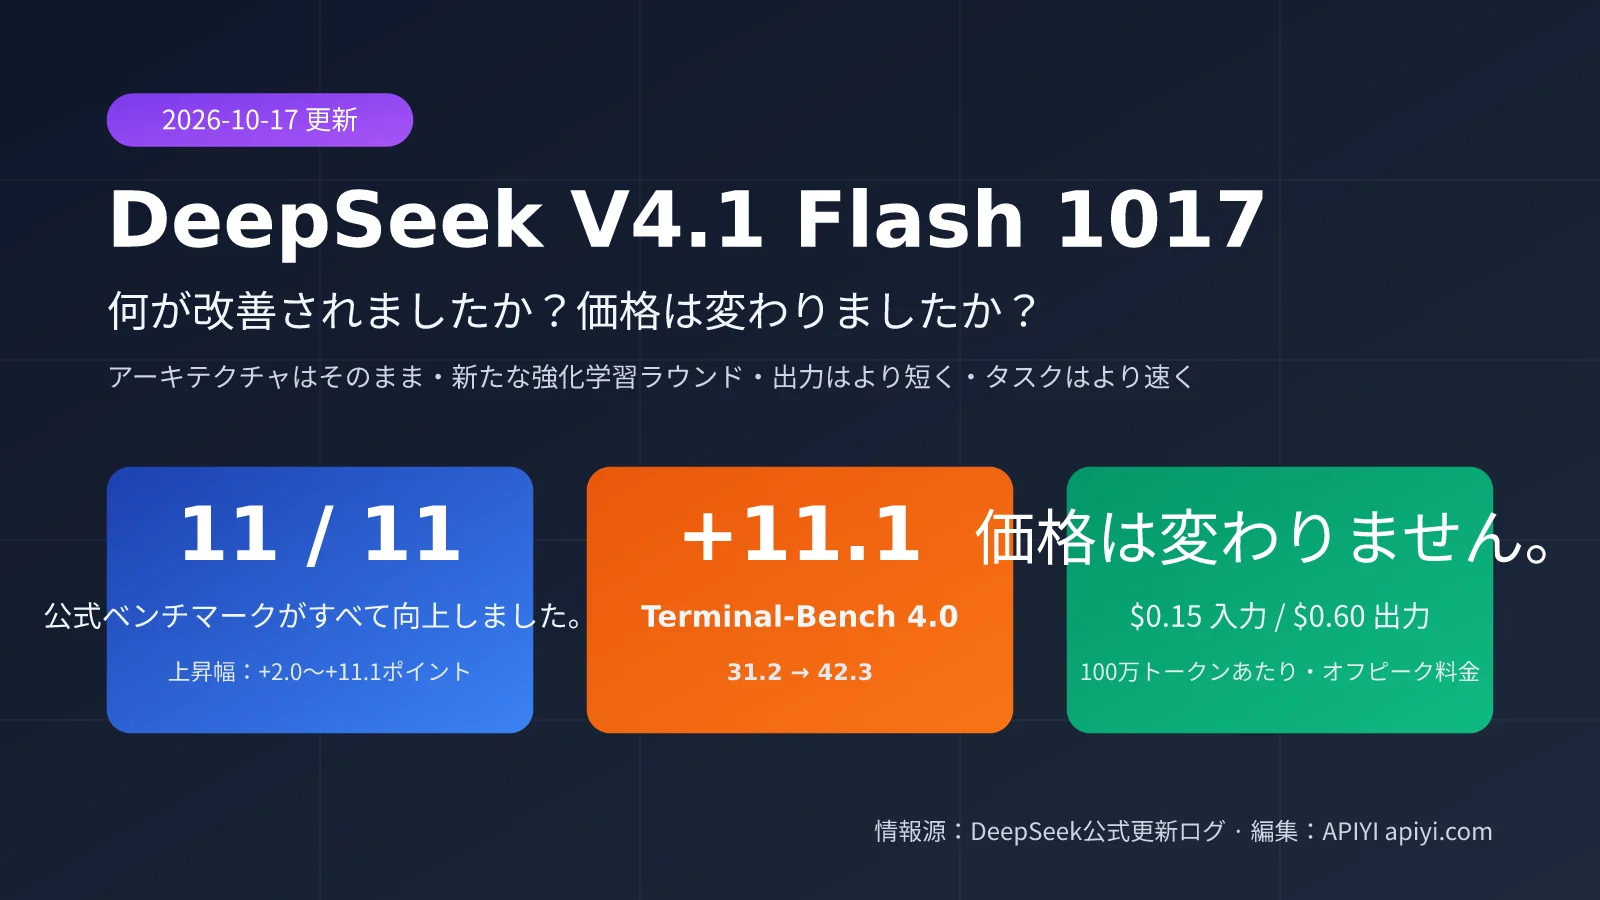
V4.1 Flash は新しいアーキテクチャファミリー(CSA+HCA)に属し、その中では最も小規模なモデルです。Pro から蒸留されたモデルではありません。新しいアーキテクチャと、より充実した post-training によって、コーディングや Agent タスクで Pro に追いつき、さらに上回りました。パラメーター数が多いからといって、コードを書く能力も高いとは限りません。これが、この記事の後半で述べるすべての結論の前提です。
DeepSeek ProとFlashの主な違い:コード生成に優れているのはどちら?
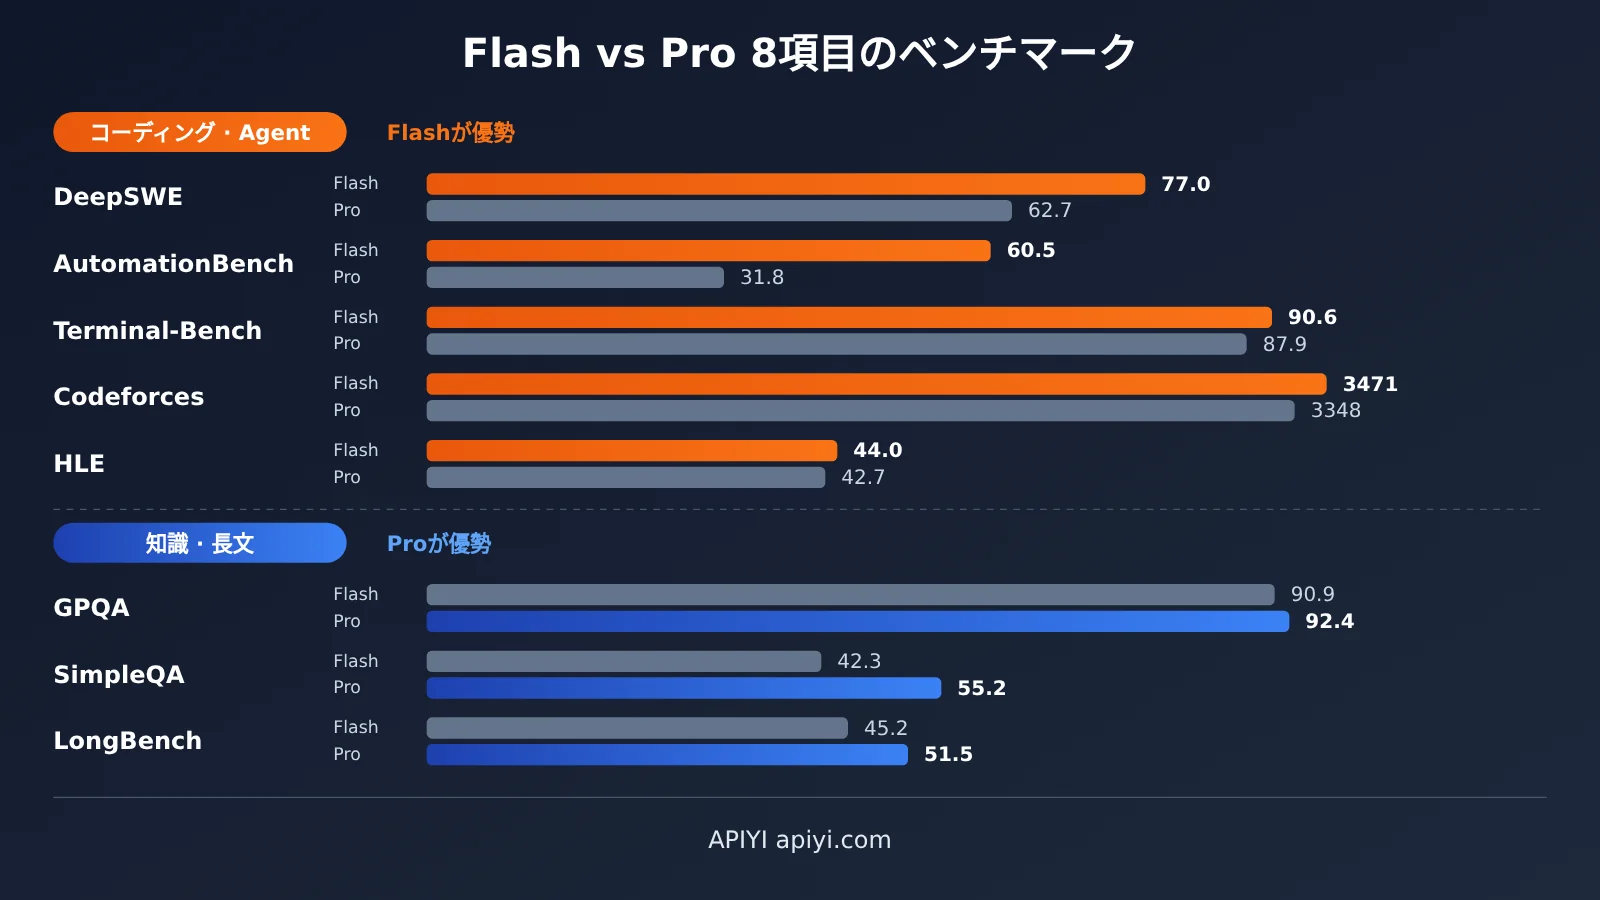
モデルを選ぶうえで、性能は最も重要な判断材料です。同時に、パラメーター数に惑わされやすいポイントでもあります。以下は、公式および公開ベンチマークにおける両モデルの成績比較です。
| ベンチマーク | 評価する能力 | V4.1-Flash-1017 | V4-Pro-0813 | 優勢なモデル |
|---|---|---|---|---|
| DeepSWE v1.1 | 実際のリポジトリでのソフトウェアエンジニアリング | 77.0 | 62.7 | Flash(+14.3) |
| AutomationBench | 自動化とAgentワークフロー | 60.5 | 31.8(別の集計では43.2) | Flashが大きくリード |
| Terminal-Bench 2.1 | ターミナルとツールチェーンの操作 | 90.6 | 87.9 | Flash |
| Codeforces | アルゴリズム競技 | 3471 | 3348 | Flash |
| HLE(テキストのみ) | 高難度の総合的な推論 | 44.0 | 42.7 | Flashがわずかに優勢 |
| GPQA Diamond | 大学院レベルの科学分野の質疑応答 | 90.9 | 92.4 | Pro |
| SimpleQA-Verified | 事実の想起とハルシネーション率 | 42.3 | 55.2 | Pro(+12.9) |
| LongBench-V2 | 長文書の理解 | 45.2 | 51.5 | Pro |
DeepSeek FlashはコーディングとAgentで全般的に優勢
表からわかるように、コーディング、ツール呼び出し、Agentの実行ループに関わるタスクでは、Flashがほぼ一貫して優勢です。DeepSWEでは14ポイント以上の差があり、実際のリポジトリで問題を特定し、複数ファイルを修正して、テストに合格させる能力がFlashのほうが明らかに高いことを示しています。AutomationBenchでのリードはさらに大きく、Harnessにおける複数ステップのツール呼び出しに対応する能力が表れています。
Terminal-BenchとCodeforcesの差はそれほど大きくありませんが、傾向は同じです。第三者による比較でも、DeepSeek自身のベンチマークでは、より安価なモデルがコーディングとAgentの大半のタスクで、より大規模なモデルを上回るとまとめられています。
DeepSeek Proは知識と長文書で優位性を維持
Proにも、もちろん活躍の場はあります。総パラメーター数が多いぶん、幅広い世界知識を備えており、SimpleQA-Verifiedでは約13ポイント上回っています。つまり、専門性の高い事実、人名、バージョン番号、APIの詳細などを尋ねたとき、Proのほうがハルシネーションを起こしにくいということです。LongBench-V2では約6ポイント、GPQA Diamondでもわずかに上回っており、長文書を丁寧に読み解く作業や、学術寄りの知識を問う質疑応答が得意です。
見落とされがちな違いもあります。Flashは、視覚入力に対応する唯一のモデルです。Proは画像を読み取れないため、Harnessでスクリーンショット、エラー画面、デザイン案などを共有する場合は、Flashを使う必要があります。
DeepSeek HarnessはFlash向けに最適化
公式の1017バージョンの更新説明では、今回のアップデートでDeepSeek Harness向けに特別な最適化を実施したと明記されており、Harness 0.2.1-rc.1以降へのアップグレードも推奨されています。つまり、このGUIではFlashのツール呼び出し形式、コンテキスト管理、処理の締めくくり方が専用に調整されています。一方、Proには同様の最適化がありません。
DeepSeek Pro と Flash の価格比較:Max 推論では差がさらに拡大
以下は公式価格ページに掲載されている単価です。単位は100万トークンあたりの米ドルで、スラッシュの前がピーク時、後がオフピーク時の価格です。
| 課金項目 | Flash | Pro | Pro は Flash の何倍か |
|---|---|---|---|
| 入力(キャッシュヒット) | 0.006 / 0.003 | 0.044 / 0.022 | 約 7.3× |
| 入力(キャッシュミス) | 0.30 / 0.15 | 1.32 / 0.66 | 約 4.4× |
| 出力 | 1.20 / 0.60 | 3.96 / 1.98 | 約 3.3× |
| 同時実行上限 | 2500 | 500 | Flash は Pro の 5× |
オフピーク料金はピーク時料金の半額です。ピーク時間は平日の UTC 01:00~04:00 と 06:00~10:00、つまり日本時間の 10:00~13:00 と 15:00~19:00です。週末は終日オフピーク料金が適用されます。大量のコードリファクタリングやテスト生成など、急ぎでないタスクを夜間や週末に実行すれば、費用を半額に抑えられます。
Max を有効にすると Pro の請求額が高くなる理由
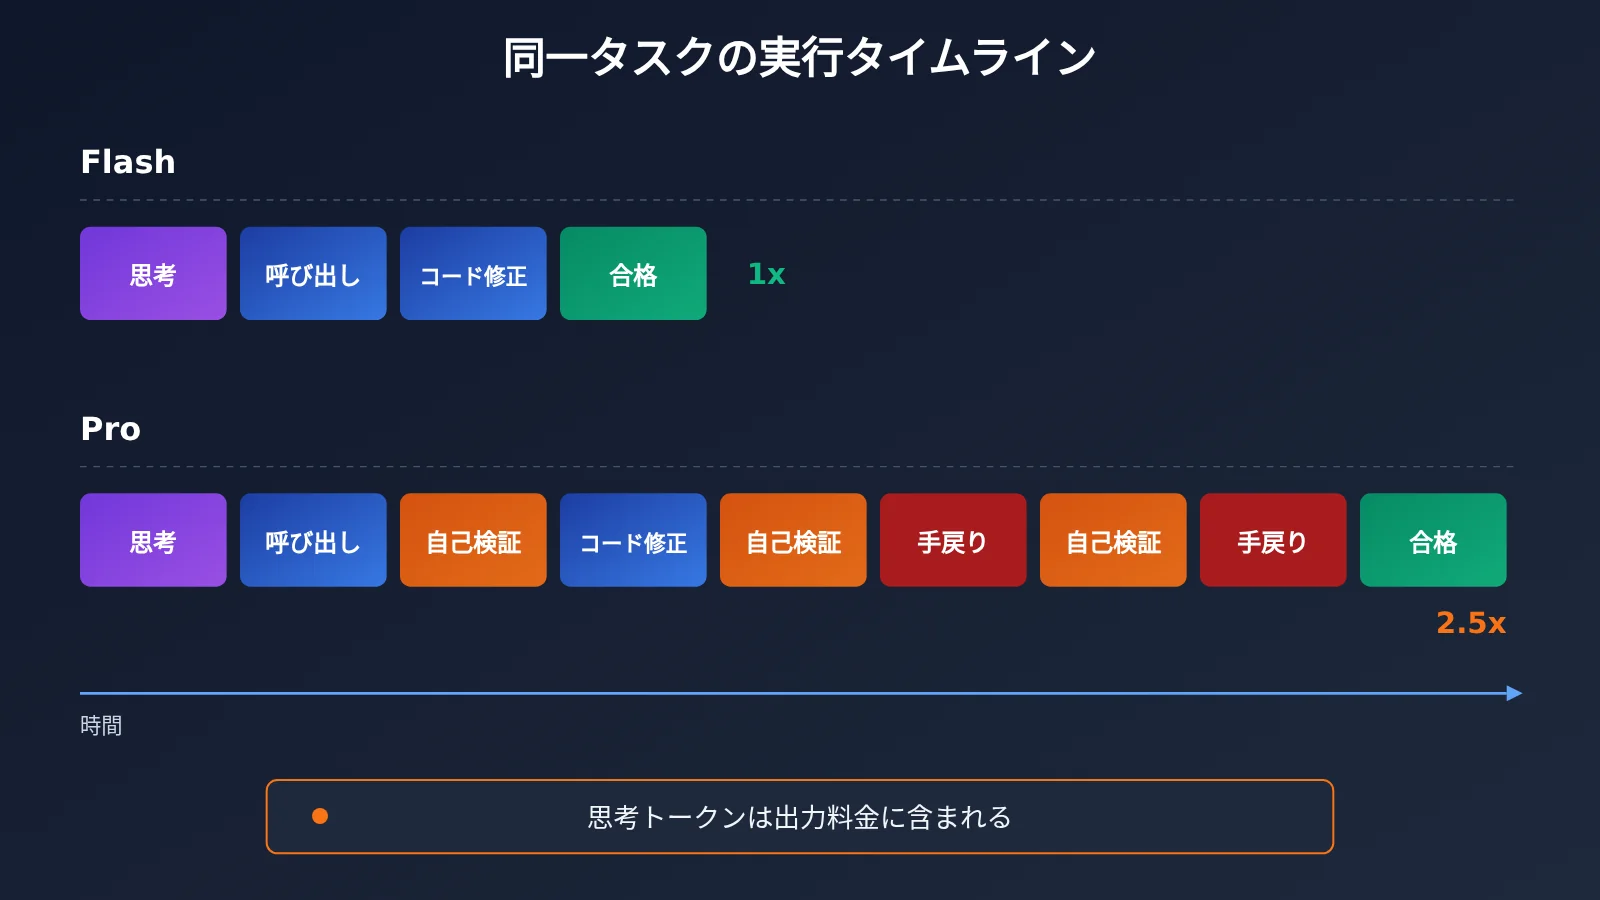
単価表だけでは、価格差の一面しかわかりません。推論レベルを Max にすると、思考過程で生成されたトークンも出力として課金されます。さらに Pro は Max で思考や自己チェックを繰り返しやすく、最終結果がなかなか出ないことがあります。第三者による実測では、同じタスクで Pro の所要時間は Flash の2.5倍以上となり、手戻りも多く発生しました。
そのため、実際の請求額の差は通常、表に示された出力単価の3.3倍を上回ります。Pro は単価が高いだけでなく、生成するトークン数も多くなります。Harness で何十回も繰り返されるツール呼び出しでは、こうしたコストが積み重なっていきます。
💰 コストを抑えるには:DeepSeek に加えて、Claude、GPT、Gemini などのモデルも複数のプロジェクトで利用している場合は、APIYI apiyi.com を使うと、呼び出しと請求を一元管理できます。OpenAI 互換のインターフェースと従量課金に対応しているため、タスクに応じたモデルの使い分けや、総コストの管理に便利です。
DeepSeek FlashとProの速度比較
FlashはProよりアクティブパラメーターが約1桁少なく、同時実行数の上限はProの5倍です。そのため、初回トークンの遅延もタスク全体の所要時間も大幅に短く、実測で約363 tok/sに達した例もあります。Harnessのように、ツールを連続して呼び出し、何度も反復する場面では、1回ごとのわずかな速度差が積み重なり、タスク全体の時間に大きな差が生まれます。
注意したいのは、Proの遅さの主な原因は推論に時間がかかることであり、計算能力が足りないわけではない点です。Maxプランでは、何度も考え直す傾向が強まります。そのため、ツールを繰り返し使う場面では、時間がかかる一方で、結果の質が向上しないこともよくあります。
3つの観点を下表にまとめました。すばやく判断する際に参考にしてください。
| 比較項目 | DeepSeek V4.1 Flash | DeepSeek V4 Pro | 優位 |
|---|---|---|---|
| コーディング/複数ファイルのリファクタリング | DeepSWE 77.0 | DeepSWE 62.7 | Flash |
| エージェント/ツールチェーン | AutomationBench 60.5 | AutomationBench 31.8 | Flash |
| 事実知識/低い幻覚率 | SimpleQA 42.3 | SimpleQA 55.2 | Pro |
| 長文書の理解 | LongBench 45.2 | LongBench 51.5 | Pro |
| 画像入力 | 対応 | 非対応 | Flash |
| 価格 | 出力料金はProの約3分の1 | 単価が高く、推論時間も長い | Flash |
| 速度と同時実行数 | 高速、同時実行数2,500 | 低速、同時実行数500 | Flash |
| Harnessとの適合性 | 公式に最適化 | 専用の最適化なし | Flash |
DeepSeek Harnessの用途別おすすめ:ProとFlashはそれぞれどんな場面に向いている?
DeepSeek Flash + Maxを選ぶ場面
- 日常的なコーディングやバグ修正:DeepSWEで14ポイントリードしており、最も分かりやすい判断材料です
- 複数ファイルのリファクタリングやモジュールをまたぐ修正:安定したコード理解と、長めのツール実行サイクルが求められます
- ターミナル操作、テストの実行、スクリプトの実行:Terminal-BenchとAutomationBenchの両方でリードしています
- 画像を使った質問:エラー画面のスクリーンショット、UIの再現、デザイン案の確認などに対応しているのはFlashだけです
- 日常的な質問や素早い試行錯誤:高速で低コストです。Maxモードの効果もFlashで最も顕著です
DeepSeek Pro + Maxを選ぶ場面
- ニッチな知識や事実の調査:人名、ライブラリのバージョン、特定のAPIパラメーター、歴史的な出来事など
- 長文ドキュメントや論文の精読:LongBench-V2で約6ポイントリードしています
- 知識重視のコード以外の文章作成:幅広い情報を盛り込み、事実誤認を減らしたい場合
- Flashが出した事実ベースの回答を照合するとき
Proをおすすめしない場面
長いツール実行サイクルにはProを使わないでください。 Maxモードでは遅く、コストも高くなるだけで、Terminal-BenchとDeepSWEのどちらでも優位性はありません。よくある誤解は、「タスクが複雑だから大規模言語モデルを使うべきだ」と考えることです。その結果、時間は倍かかるのに、成果はむしろ悪くなってしまいます。
APIでタスクに応じてDeepSeek ProとFlashを切り替える方法
Harnessでは、同じセッション内で途中からモデルを切り替えても、追加コストはかかりません。どちらも同じOpenAI互換インターフェースを利用します。Harnessを使わずに独自のコーディングAgentを構築する場合も、コードで同様のルーティングを実装できます。最もシンプルな呼び出し例を紹介します。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

response = client.chat.completions.create(
    model="deepseek-flash",  # コード作成ではデフォルトでFlashを使用。モデル名はプラットフォームのモデル一覧を参照
    messages=[{"role": "user", "content": "用 Python 写一个带重试机制的 HTTP 请求函数"}]
)
print(response.choices[0].message.content)
実装コード全体を表示:タスクの種類に応じてPro / Flashを自動選択
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# タスクの種類とモデルの対応表:コード作成 / Agent / 画像認識にはFlash、知識検索 / 長文書にはProを使用
TASK_MODEL_MAP = {
    "code": "deepseek-flash",
    "agent": "deepseek-flash",
    "vision": "deepseek-flash",      # Proは画像入力に非対応
    "knowledge": "deepseek-v4-pro",  # 事実の想起精度が高く、幻覚が少ない
    "long_doc": "deepseek-v4-pro",   # 長文書の理解に優れている
}

def ask_deepseek(
    prompt: str,
    task_type: str = "code",
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000,
) -> str:
    """タスクの種類に応じてDeepSeekモデルを選択し、呼び出す"""
    model = TASK_MODEL_MAP.get(task_type, "deepseek-flash")

    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error ({model}): {e}"

# コード作成ではFlashを使用
print(ask_deepseek("重构这段函数,拆分为三个职责单一的方法:...", task_type="code"))

# APIの詳細確認ではProを使用
print(ask_deepseek("requests 库 Session 对象的 mount 方法有哪些参数?", task_type="knowledge"))
このルーティングの考え方は、この記事の結論と同じです。Flashをメインに使い、知識を問うタスクだけProに切り替えます。今後V4.1 Proがリリースされた場合も、対応表の設定を1行変更するだけで済みます。
🚀 すぐに始める:APIYI(apiyi.com)でAPIキーを取得し、新規ユーザー向けの無料テスト枠を利用するのがおすすめです。1つのキーでDeepSeekのほか、OpenAI、Claude、Geminiなどの主要モデルも呼び出せます。上記のコードを使って、自分のリポジトリでFlashとProの実際の性能を比較できます。
DeepSeek Pro と Flash:選び方のポイント
知能レベル、価格、速度の3つの観点から、DeepSeek Harnessでのモデル選びは次のようにまとめられます。
- 基本は Flash + Max:コード作成、複数ファイルのリファクタリング、ツールの実行、画像の読み取り、日常的な質問には Flash + Max を使いましょう。Harnessで最も適したデフォルト設定です。
- 知識が必要なタスクでは Pro に切り替える:ニッチな知識、バージョン番号、APIの詳細、歴史的事実、長文ドキュメントの精読などが該当します。SimpleQAで13ポイント、LongBenchで6ポイント上回る強みが生きる場面です。
- 長時間のツール実行には Pro を使わない:Max設定では遅く、料金も高いうえ、コーディングベンチマークでも優位性はありません。
- 画像を添付するターンでは Flash を使う:Proには画像を扱う機能がありません。
- Proは予備の選択肢として扱う:V4.1 Proの正式リリース前は、Proを知識検索の補助ツールとして使いましょう。新バージョンのリリース後に、あらためて評価してください。
💡 選び方のアドバイス:ベンチマークのスコアから分かるのは全体的な傾向です。実際のコードベースや業務ロジックでは、差がさらに大きくなることも、小さくなることもあります。APIYI apiyi.com で同じインターフェースを使い、自分のプロジェクトでよく使うタスクをいくつか Flash と Pro の両方で実行してみましょう。成功率、所要時間、トークン消費量を比較してから、チームのデフォルト設定を決めるのがおすすめです。
よくある質問(FAQ)
Q1:DeepSeek Harness の Pro と Flash は、それぞれどのモデルですか?
Flash は `deepseek-flash` に対応し、実際のモデルは V4.1-Flash-1017 です。総パラメーター数 552B の MoE モデルで、画像入力と 1M のコンテキストに対応しています。Pro は `deepseek-v4-pro` に対応し、実際のモデルは V4-Pro-0813 GA 版です。総パラメーター数は 1.6T、アクティブパラメーター数は約 49B で、画像入力には対応していません。
Q2:DeepSeek Pro はパラメーター数が多いのに、なぜコーディングでは Flash に劣るのですか?
Flash はより新しいアーキテクチャファミリーに属し、ポストトレーニングもより十分に行われています。1017 版では、Harness 向けに特別な最適化も施されています。Pro の強みは、大規模なパラメーター数による豊富な知識であり、コーディングやツール呼び出しではありません。そのため、DeepSWE、AutomationBench、Terminal-Bench では Flash が優位に立ち、SimpleQA、LongBench では Pro が優位です。
Q3:DeepSeek V4 Pro は提供終了になりますか?V4.1 Pro はいつ公開されますか?
公式は一度、9 月 14 日以降に V4 Pro のサービスを終了すると告知しました。その後、同じ更新履歴の中で、API サービスを継続し、料金も変更しないと発表しています。そのため、現在も通常どおり利用できます。V4.1 Pro は、現時点ではまだ正式に公開されていません。10 月末に公式サイトのモデル表記が変更されたことを受けて憶測が広がりましたが、公式の更新履歴を確認することをおすすめします。
Q4:推論レベルを Max にした場合、Pro と Flash の料金にはどれくらい差がありますか?
単価を比べると、Pro の出力料金は Flash の約 3.3 倍、キャッシュにヒットしない入力料金は約 4.4 倍、キャッシュにヒットする入力料金は約 7.3 倍です。Max では思考トークンも出力料金に含まれます。また、Pro は思考や自己チェックを繰り返しやすく、実測では Flash の 2.5 倍以上の時間がかかります。そのため、実際の請求額の差は、通常、単価の倍率を上回ります。
Q5:Harness を使わずに、API 経由で DeepSeek Flash と Pro を呼び出すには?
どちらも OpenAI 互換のインターフェースを使用しているため、`model` パラメーターを変更するだけで切り替えられます。
1. APIYI(apiyi.com)にアクセスしてアカウントを登録します。
2. APIキーと、新規ユーザー向けの無料お試し枠を取得します。
3. この記事のコードを使い、`base_url` に `https://api.apiyi.com/v1` を設定します。`model` には Flash または Pro のモデル名を指定してください。
利用可能なモデル名は、プラットフォームのモデル一覧でご確認ください。
Q6:同じ会話の途中で Flash から Pro に切り替えられますか?
はい。切り替えによる追加コストはなく、どちらも同じインターフェースを使用します。よくある使い方は、コーディングには Flash を使い、API の細かな仕様やバージョン番号が不確かな場合は Pro に切り替えて確認し、その後 Flash に戻ってコーディングを続ける方法です。ただし、画像を含むターンでは Pro を選べない点に注意してください。
Q7:DeepSeek Flash の弱点は何ですか?
Flash の主な弱点は知識面です。SimpleQA-Verified のスコアは 42.3 で、Pro より約 13 ポイント低く、ニッチな事実や具体的なバージョン番号などについて、幻覚が起きやすくなっています。長文書の理解も、Pro にやや劣ります。重要な事実は Pro で照合するか、プロンプトに公式ドキュメントの内容を直接含めるとよいでしょう。他社モデルとも比較したい場合は、APIYI(apiyi.com)で同じ APIキーを使って切り替えながらテストできます。
DeepSeek ProとFlashの選び方:要点
- コードを書くなら、まずはFlash:DeepSWEでは77.0対62.7。コーディングとエージェント能力の両面で優れています。
- 知識面ではProが優位:SimpleQAで約13ポイント、LongBenchで約6ポイント上回っており、事実確認や長文読解に適しています。
- パラメーター数が多くても、コーディングが得意とは限らない:Flashは新しいアーキテクチャと後学習によって逆転しており、Proの蒸留版ではありません。
- Maxではコスト差がさらに広がる:Proはより長く思考するため、実際の料金差は出力単価の3.3倍を超えます。
- 速度と同時実行性能はFlashが優位:アクティブパラメーター数は1桁少なく、同時実行の上限はProの5倍です。
- 画像を入力できるのはFlashだけ:Proは画像入力に対応していません。
- 実際のタスクで検証する:APIYIの統一インターフェースを使えば、自分のプロジェクトで両モデルを比較できます。
まとめ
DeepSeek Harnessで推論レベルをどちらもMaxに設定した場合、ProとFlashの選び方はシンプルです。
- 能力:コーディング、エージェントの実行、ツールの呼び出しではFlashが優位です。一方、知識の確認や長文書の読解ではProが優れています。
- 価格:Flashの単価はProの約3分の1〜7分の1です。Maxでは差がさらに広がり、オフピーク料金なら半額になります。
- 速度:Flashは初回トークンの生成も全体の処理時間も明らかに短く、同時実行の上限はProの5倍です。さらにHarness向けの専用最適化も受けています。
結論として、Flashを主力モデルにし、Proは知識を調べるための補助として使うのがおすすめです。V4.1 Proの正式リリース後に、あらためて評価するとよいでしょう。自分のコードベースでこの結論を確かめたい場合は、APIYI(apiyi.com)で1つのAPIキーから両モデルを呼び出し、実際のタスクで比較してから、チームのデフォルト設定を決めてください。
📚 参考資料
- DeepSeek公式アップデートログ:V4.1 Flashのリリース、V4 Proのサービス継続、1017バージョンにおけるHarness向け最適化の説明
- リンク:
api-docs.deepseek.com/updates -
説明:モデルのバージョン、リリース状況、推奨されるHarnessバージョンを確認できる一次情報です。
-
DeepSeek公式料金ページ:FlashとProの入出力単価、ピーク時間・オフピーク時間、同時実行上限
- リンク:
api-docs.deepseek.com/quick_start/pricing -
説明:実際の呼び出しコストの計算や、オフピーク時間帯にバッチ処理を実行する際の参考になります。
-
Respanによる2026年版DeepSeekモデル比較:第三者による横断評価
- リンク:
respan.ai/articles/deepseek-model-comparison - 説明:「より低価格なモデルが、多くのコーディングタスクやAgentタスクで優れた結果を出している」という見方を、独立した視点から検証しています。
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI公式サイトのトップページからお気軽にご連絡ください。モデル連携に関する資料は、docs.apiyi.comのドキュメントセンターでもご覧いただけます。