작성자 주: DeepSeek Harness에서 추론 수준을 모두 Max로 설정했을 때 V4.1-Flash와 V4-Pro 중 무엇을 선택해야 할까요? 이 글에서는 지능, 가격, 속도 세 가지 측면에서 비교하고, 코딩에는 왜 기본적으로 Flash를 선택해야 하는지, 어떤 상황에서 Pro로 전환하면 좋은지 설명해요.
DeepSeek Harness의 모델 드롭다운을 열면 DeepSeek-V4.1-Flash와 DeepSeek-V4-Pro 두 가지 옵션이 보여요. 일반적으로는 이름에 Pro가 붙고 매개변수가 더 큰 모델이 더 똑똑할 거라고 생각하기 쉽죠. 하지만 추론 수준을 모두 Max로 설정한 뒤 개발자들이 실제로 궁금해하는 건 어떤 모델이 코딩을 더 잘하느냐예요. 가격과 속도는 얼마나 차이 날까요?
이 글은 “각자 장단점이 있다”는 식의 절충 분석이 아니에요. DeepSeek 공식 가격 페이지와 업데이트 로그, 공식 벤치마크, 제3자 테스트 결과를 확인해 내린 결론은 명확해요. DeepSeek Harness에서 코딩할 때는 기본적으로 Flash를 선택하세요. Pro는 지식이나 사실을 확인하고 긴 문서를 읽는 보조 모델로 적합해요.
핵심 내용: 이 글을 읽고 나면 DeepSeek Harness의 Pro와 Flash가 각각 어떤 버전에 해당하는지, Max 추론에서 어떤 모델의 코딩 능력이 더 뛰어난지, 비용과 속도는 얼마나 차이 나는지 알 수 있어요. 작업에 따라 두 모델을 어떻게 전환할지도 살펴볼게요.
DeepSeek Harness의 Pro와 Flash는 각각 어떤 버전인가요?
“어느 모델이 더 똑똑한가”를 논하기 전에 DeepSeek Harness 목록의 두 항목이 실제로 어떤 체크포인트(checkpoint)에 해당하는지 먼저 확인해야 해요. 많은 사람이 Pro를 초기 버전으로 기억하지만, 모델 이름과 실제 버전이 항상 함께 업데이트되는 것은 아니에요.
| Harness 목록에 표시되는 이름 | API ID | 실제 체크포인트 | 출시 상태 |
|---|---|---|---|
| DeepSeek-V4.1-Flash | deepseek-flash |
V4.1-Flash-1017(10월 17일 업데이트) | 현재 주력 모델, Harness에 맞춰 특별히 최적화됨 |
| DeepSeek-V4-Pro | deepseek-v4-pro |
V4-Pro-0813(8월 13일 GA) | 계속 제공 중이며, 과도기 모델에 가까움 |
DeepSeek V4 Pro는 서비스가 종료되나요?
커뮤니티에서는 “Pro가 서비스 종료된다”는 이야기가 꾸준히 나왔는데, 실제로 근거가 있는 내용이에요. 9월 10일 V4.1 Flash를 출시하면서 공식적으로 9월 14일 이후 V4 Pro 서비스를 중단한다고 공지한 적이 있어요. 하지만 같은 업데이트 로그에서 곧바로 다음과 같이 안내했어요. 많은 사용자의 요청에 따라 2026년 9월 14일 이후에도 DeepSeek V4 Pro API 서비스를 계속 제공하며, 요금은 변경되지 않는다고요.
따라서 Pro는 지금도 정상적으로 사용할 수 있지만, 이제는 과도기 제품에 가까운 위치가 됐어요. V4.1 Pro는 아직 정식 출시되지 않았고, 10월 말에는 공식 사이트의 모델 표기가 바뀌었다는 추측만 한 차례 나왔어요. 또 초기에 나온 “Pro가 별로다”라는 평가는 주로 V4-Pro 프리뷰 버전의 과적합 문제를 가리킨 거예요. 8월에 출시된 GA 버전에서는 이 문제가 크게 개선됐지만, 전반적인 코딩 능력은 여전히 Flash를 넘지 못했어요.
DeepSeek Pro와 Flash의 파라미터 규모 차이
두 모델은 규모 차이가 상당히 커요. 이 때문에 많은 사람이 기본적으로 Pro가 더 강하다고 생각하죠.
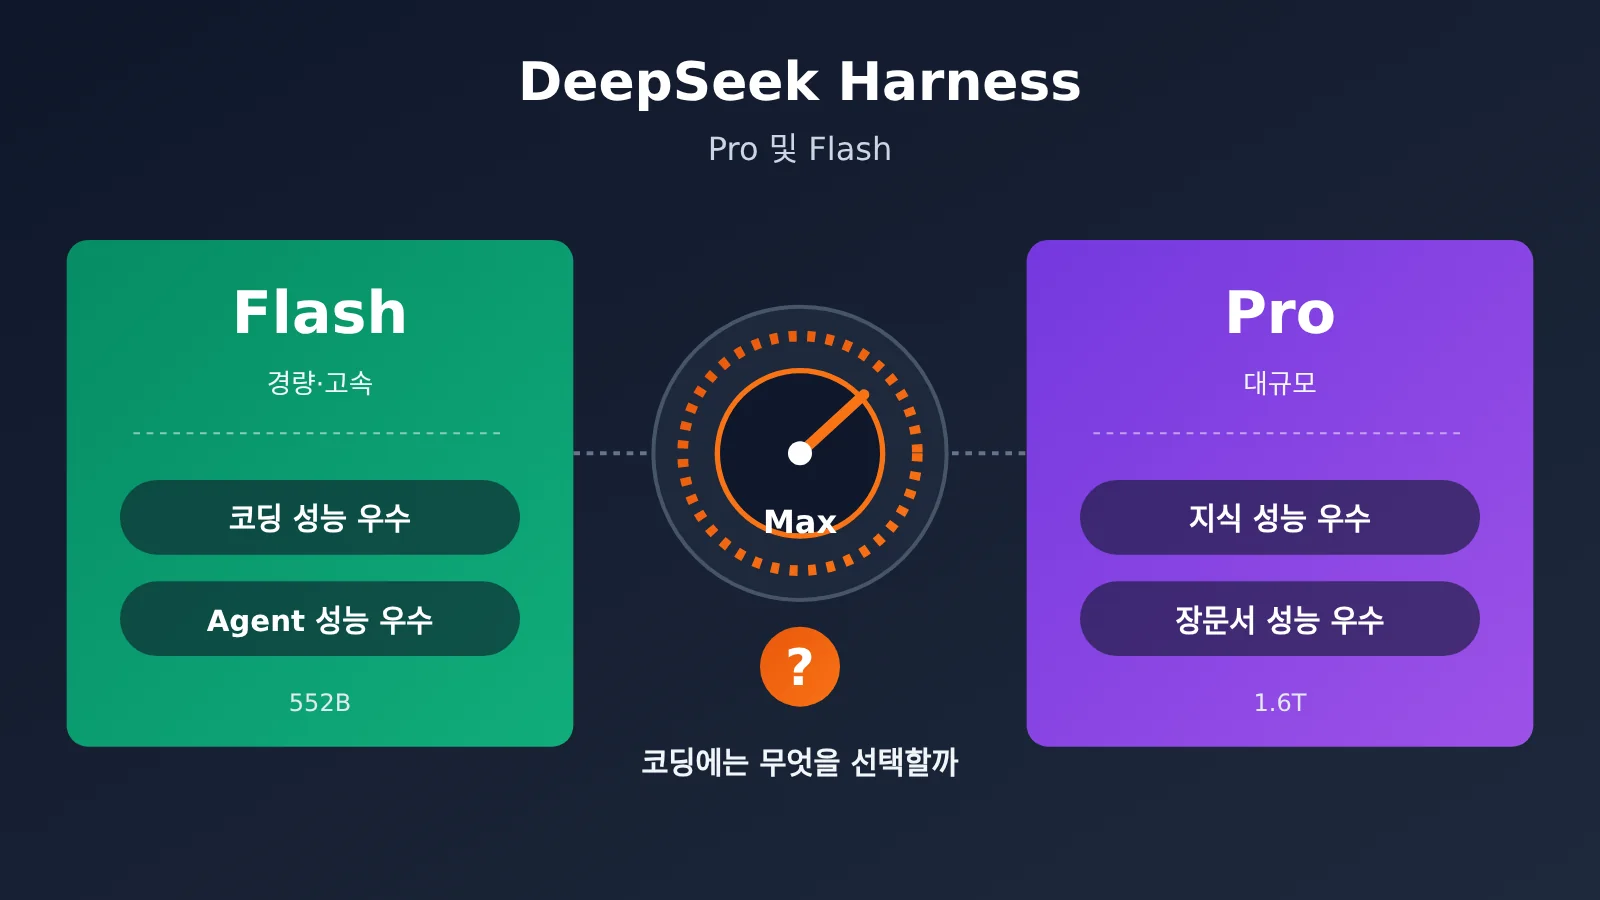
- Flash: 총 파라미터 552B의 MoE 아키텍처. 입력 활성 파라미터는 약 8B, 출력 활성 파라미터는 약 16B이며, 1M 컨텍스트를 지원해요.
- Pro: 총 파라미터 1.6T, 활성 파라미터 약 49B예요.
V4.1 Flash는 새로운 아키텍처 계열(CSA+HCA)에 속하며, 그중 가장 작은 모델이에요. Pro를 증류해 만든 모델이 아니라, 새로운 아키텍처와 더욱 충실한 사후 학습을 바탕으로 코딩 및 에이전트 작업에서 Pro를 따라잡고 앞질렀어요. 파라미터가 많다고 코딩을 더 잘하는 것은 아니에요. 이 점이 이 글의 모든 결론을 이해하는 출발점이에요.
DeepSeek Pro와 Flash의 핵심 차이: 코딩에는 어느 모델이 더 뛰어날까요?
지능은 모델을 선택할 때 가장 중요한 기준이지만, 매개변수 규모만 보고 판단하기 쉽습니다. 아래는 두 모델의 공식 및 공개 벤치마크 성적을 비교한 표예요.
| 벤치마크 | 평가 능력 | V4.1-Flash-1017 | V4-Pro-0813 | 우세 모델 |
|---|---|---|---|---|
| DeepSWE v1.1 | 실제 저장소 소프트웨어 엔지니어링 | 77.0 | 62.7 | Flash (+14.3) |
| AutomationBench | 자동화 및 Agent 워크플로 | 60.5 | 31.8 (다른 기준으로는 43.2) | Flash 크게 우세 |
| Terminal-Bench 2.1 | 터미널 및 도구 체인 작업 | 90.6 | 87.9 | Flash |
| Codeforces | 알고리즘 경시대회 | 3471 | 3348 | Flash |
| HLE (텍스트 전용) | 고난도 종합 추론 | 44.0 | 42.7 | Flash 근소 우세 |
| GPQA Diamond | 대학원 수준 과학 질의응답 | 90.9 | 92.4 | Pro |
| SimpleQA-Verified | 사실 회상 및 환각률 | 42.3 | 55.2 | Pro (+12.9) |
| LongBench-V2 | 장문서 이해 | 45.2 | 51.5 | Pro |
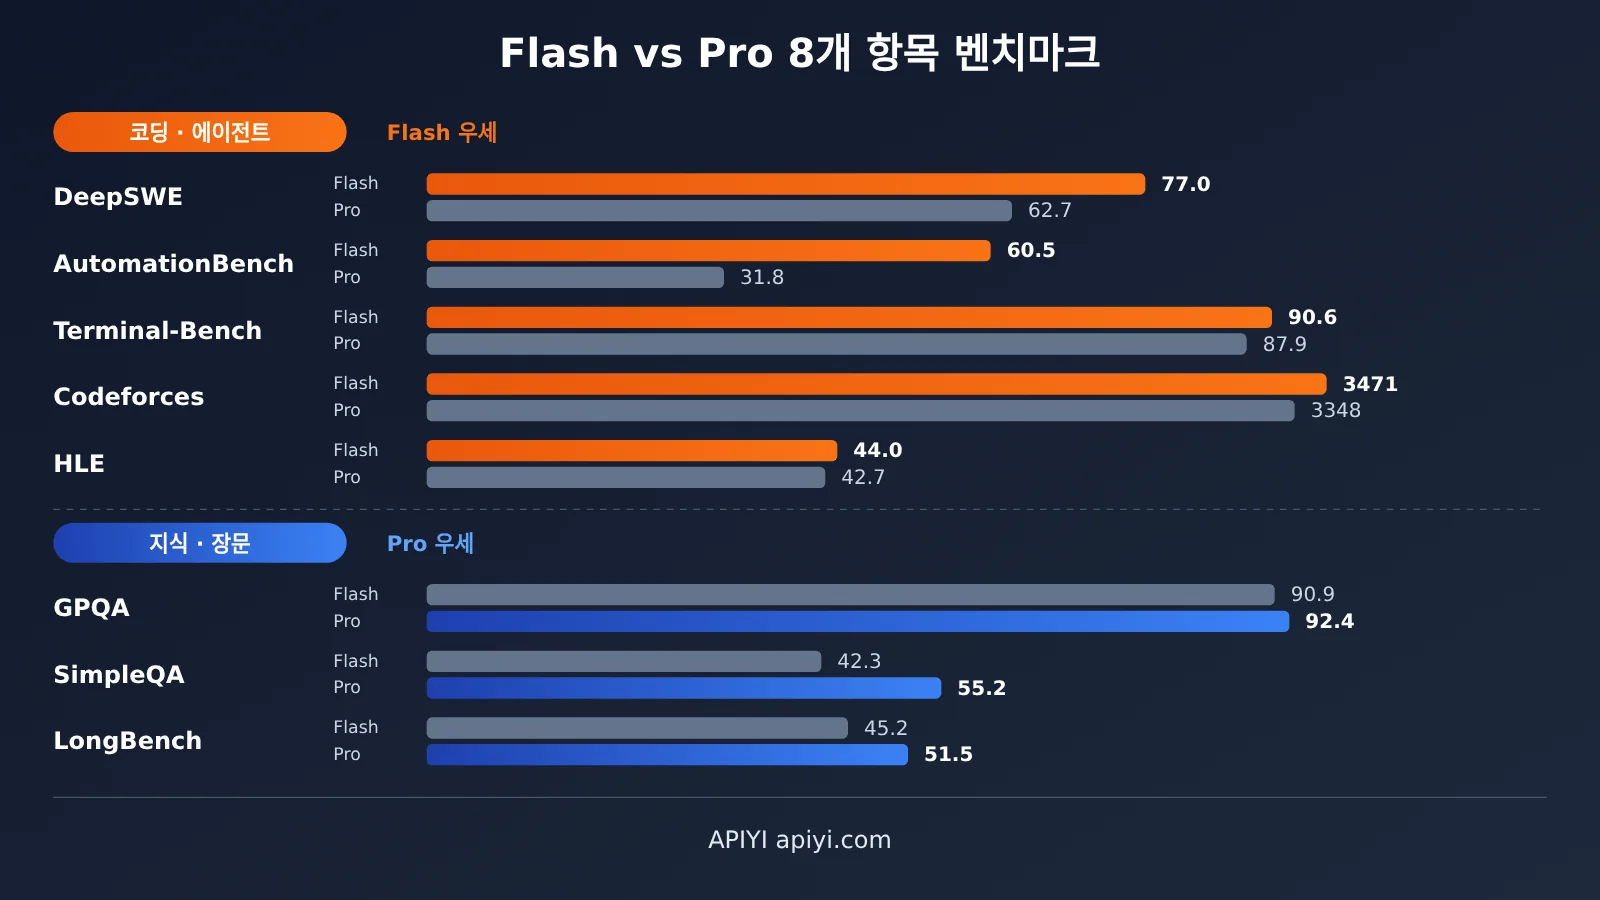
코딩과 Agent 작업에서는 DeepSeek Flash가 전반적으로 우세해요
표를 보면 코딩, 도구 호출, Agent 루프 실행과 관련된 작업에서는 Flash가 대부분 우세해요. DeepSWE에서 14점 이상 앞선 것은 실제 저장소에서 문제를 찾고, 여러 파일을 수정하고, 테스트를 통과하는 능력이 훨씬 뛰어나다는 뜻이에요. AutomationBench에서 더 크게 앞선 것은 Harness의 다단계 도구 호출 방식과도 맞닿아 있어요.
Terminal-Bench와 Codeforces의 격차는 그리 크지 않지만, 우세한 방향은 같아요. 서드파티 비교 결과도 비슷해요. DeepSeek 자체 벤치마크에서는 더 저렴한 모델이 대부분의 코딩 및 Agent 작업에서 더 큰 모델을 앞섰어요.
지식과 장문서 처리에서는 DeepSeek Pro가 앞서요
그렇다고 Pro가 쓸모없는 것은 아니에요. 전체 매개변수 규모가 더 큰 만큼 폭넓은 세계 지식을 갖추고 있어요. SimpleQA-Verified에서 약 13점 앞선다는 것은 잘 알려지지 않은 사실, 인명, 버전 번호, API 세부 사항 등을 묻는 질문에서 Pro가 환각을 일으킬 가능성이 더 낮다는 뜻이에요. LongBench-V2에서는 약 6점, GPQA Diamond에서도 근소하게 앞서므로 장문서를 꼼꼼히 읽거나 학술적인 지식 질문에 답하는 데 강점이 있어요.
간과하기 쉬운 차이도 하나 있어요. 두 모델 중 시각 입력을 지원하는 것은 Flash뿐이에요. Pro는 이미지를 읽을 수 없으므로 Harness에 스크린샷, 오류 화면 또는 디자인 시안을 첨부하려면 Flash를 사용해야 해요.
DeepSeek Harness는 Flash에 맞춰 최적화되어 있어요
1017 버전 업데이트 안내에서 공식적으로 DeepSeek Harness에 맞춰 특별히 최적화했다고 밝혔으며, Harness 0.2.1-rc.1 이상으로 업그레이드할 것을 권장했어요. 즉, 이 GUI에서는 Flash의 도구 호출 형식, 컨텍스트 관리, 작업 마무리 동작이 별도로 최적화되어 있지만 Pro에는 이런 최적화가 적용되지 않았어요.
DeepSeek Pro와 Flash 가격 비교: Max 추론에서는 격차가 더 커요
아래는 공식 가격 페이지에 공개된 단가예요. 단위는 토큰 100만 개당 미국 달러이며, 슬래시 앞은 피크 시간 요금, 뒤는 비피크 시간 요금이에요.
| 과금 항목 | Flash | Pro | Pro는 Flash의 몇 배인가요? |
|---|---|---|---|
| 입력(캐시 적중) | 0.006 / 0.003 | 0.044 / 0.022 | 약 7.3배 |
| 입력(캐시 미적중) | 0.30 / 0.15 | 1.32 / 0.66 | 약 4.4배 |
| 출력 | 1.20 / 0.60 | 3.96 / 1.98 | 약 3.3배 |
| 동시 요청 한도 | 2500 | 500 | Flash가 Pro의 5배 |
비피크 시간 요금은 피크 시간 요금의 절반이에요. 피크 시간은 평일 UTC 01:00–04:00 및 06:00–10:00, 즉 한국 시간 10:00–13:00 및 15:00–19:00예요. 주말에는 하루 종일 비피크 요금이 적용돼요. 대량 리팩터링이나 테스트 생성처럼 급하지 않은 작업이 있다면 저녁이나 주말에 실행해 비용을 절반으로 줄일 수 있어요.
Max를 켜면 Pro 요금이 더 많이 나오는 이유
단가표만으로는 차이의 일부만 알 수 있어요. 추론 수준을 Max로 설정하면 사고 과정에서 생성된 토큰도 출력 요금으로 계산돼요. 그런데 Pro는 Max 설정에서 생각과 자체 검증을 반복하는 경향이 더 강해 최종 결과를 내놓기까지 오래 걸려요. 제3자 실측에서는 같은 작업을 수행할 때 Pro의 소요 시간이 Flash보다 2.5배 이상 길었고, 재작업도 더 많이 발생했어요.
따라서 실제 요금 차이는 보통 표에 나온 출력 단가 차이인 3.3배보다 더 커요. Pro는 단가도 더 높고 생성하는 토큰 수도 더 많아요. 수십 차례 반복되는 Harness의 도구 호출 루프에서는 이 비용이 계속 불어나요.
💰 비용 최적화: 여러 프로젝트에서 DeepSeek와 Claude, GPT, Gemini 등 다른 모델도 함께 사용한다면 APIYI apiyi.com에서 호출과 청구 내역을 통합 관리할 수 있어요. OpenAI 호환 인터페이스와 사용량 기반 과금을 제공해 작업 유형에 따라 모델을 배정하고 총비용을 관리하기 편리해요.
DeepSeek Flash와 Pro 속도 비교
Flash는 활성화되는 파라미터 수가 Pro보다 약 한 자릿수 적고, 최대 동시 처리량은 Pro의 5배예요. 따라서 첫 토큰 지연 시간과 작업 전체 소요 시간이 모두 크게 짧으며, 실제 측정에서 약 363 tok/s를 기록하기도 했어요. Harness처럼 도구를 연속으로 호출하며 여러 차례 반복하는 작업에서는 한 번의 실행이 조금만 빨라도, 누적되면 전체 작업 시간이 크게 줄어들어요.
Pro가 느린 주된 이유는 연산 성능이 부족해서가 아니라 생각하는 데 시간이 오래 걸리기 때문이에요. Max 등급에서는 반복해서 숙고하는 경향이 더 강해져요. 그래서 도구를 반복해서 사용하는 과정에서 속도는 느려지지만, 결과가 더 좋아지지는 않는 경우가 많아요.
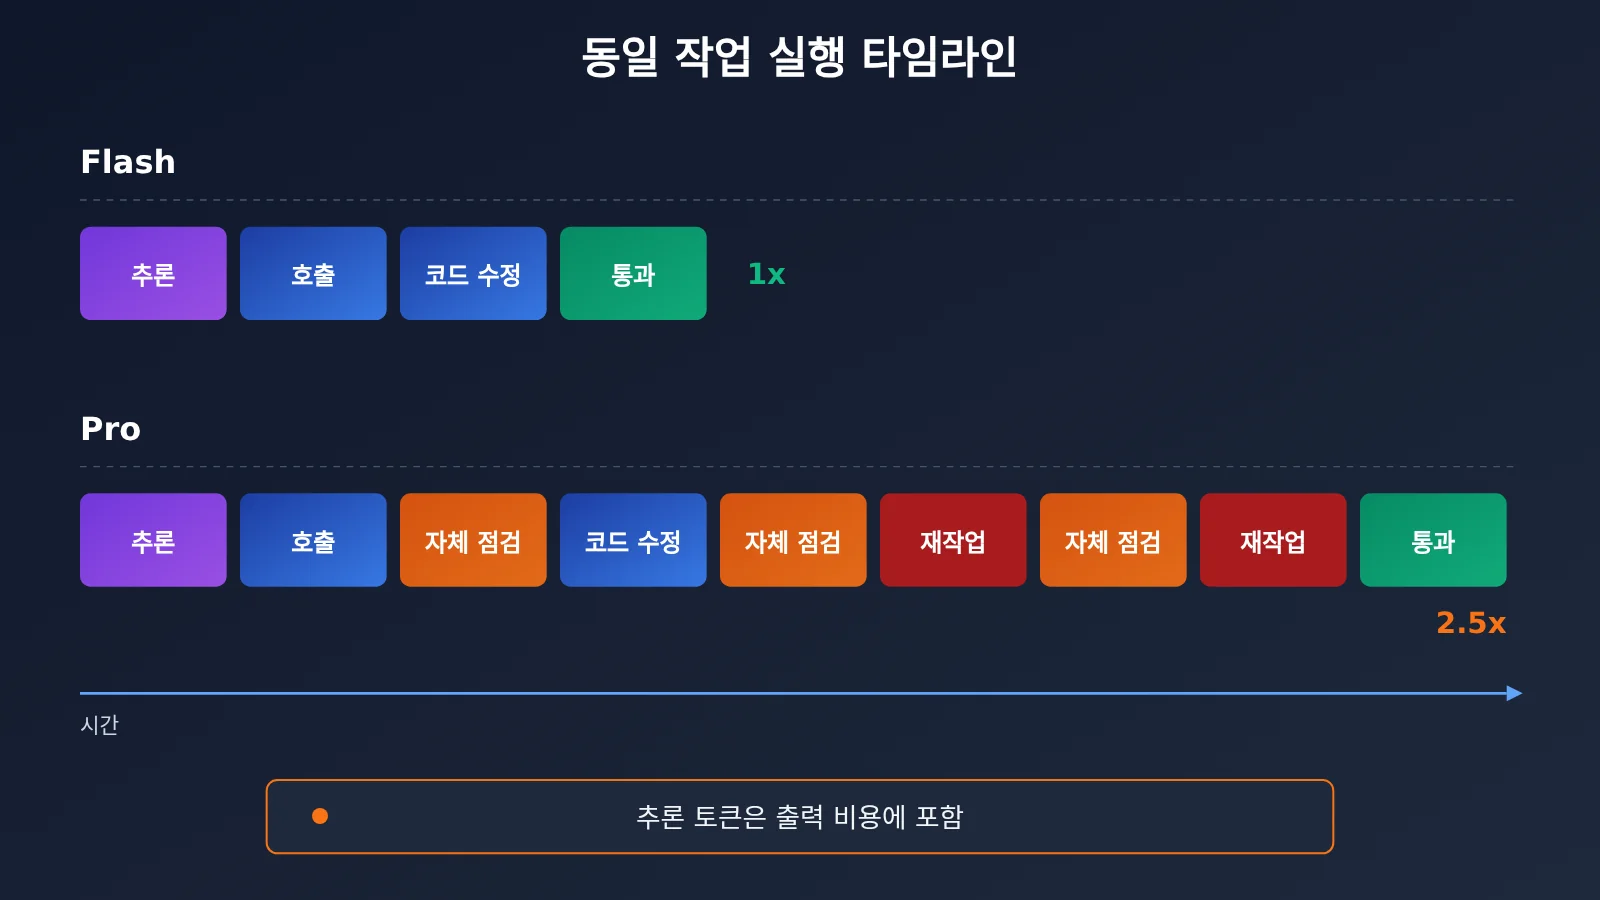
아래 표에 세 가지 측면을 정리했어요. 빠르게 판단할 때 참고하세요.
| 비교 항목 | DeepSeek V4.1 Flash | DeepSeek V4 Pro | 우세 모델 |
|---|---|---|---|
| 코드 작성 / 여러 파일 리팩터링 | DeepSWE 77.0 | DeepSWE 62.7 | Flash |
| Agent / 도구 체인 | AutomationBench 60.5 | AutomationBench 31.8 | Flash |
| 사실 지식 / 낮은 환각률 | SimpleQA 42.3 | SimpleQA 55.2 | Pro |
| 긴 문서 이해 | LongBench 45.2 | LongBench 51.5 | Pro |
| 시각 입력 | 지원 | 지원하지 않음 | Flash |
| 가격 | 출력 가격이 Pro의 약 3분의 1 | 단가가 높고 생각하는 시간도 더 김 | Flash |
| 속도와 동시 처리량 | 빠름, 동시 처리량 2500 | 느림, 동시 처리량 500 | Flash |
| Harness 적합성 | 공식적으로 전용 최적화 적용 | 전용 최적화 없음 | Flash |
DeepSeek Harness 시나리오 추천: Pro와 Flash는 각각 어떤 작업에 적합할까요?
DeepSeek Flash + Max를 선택할 상황
- 일상적인 코딩과 버그 수정: DeepSWE에서 14점 앞서 가장 직접적인 근거가 돼요.
- 여러 파일 리팩터링과 모듈 간 수정: 안정적인 코드 이해와 긴 도구 호출 과정이 필요해요.
- 터미널 작업, 테스트 실행, 스크립트 실행: Terminal-Bench와 AutomationBench 모두에서 앞서요.
- 이미지를 첨부해 질문하는 작업: 오류 스크린샷 분석, UI 구현, 디자인 시안 검토에는 Flash만 지원돼요.
- 일상적인 질의응답과 빠른 반복 작업: 속도가 빠르고 비용이 낮아요. Flash에서는 Max 등급의 성능 향상이 가장 두드러져요.
DeepSeek Pro + Max를 선택할 상황
- 잘 알려지지 않은 지식과 사실 확인: 인명, 라이브러리 버전, 특정 API의 매개변수, 역사적 사건 등을 확인할 때
- 긴 문서와 논문 정독: LongBench-V2에서 약 6점 앞서요.
- 지식 중심의 비코딩 글쓰기: 더 다양한 출처를 참고하고 사실 오류를 줄이고 싶을 때
- Flash가 제시한 사실 기반 답변을 교차 검증할 때
Pro를 권장하지 않는 상황
긴 도구 호출 작업에는 Pro를 사용하지 마세요. Max 등급에서도 더 느리고 비싸기만 한 데다, Terminal-Bench와 DeepSWE 두 항목 모두에서 우위를 보이지 않아요. 가장 흔한 오해는 작업이 복잡하니 대규모 언어 모델을 써야 한다고 생각하는 거예요. 그러다 보면 시간은 두 배로 들고 결과는 오히려 나빠질 수 있어요.
API를 통해 작업별로 DeepSeek Pro와 Flash 전환하기
Harness에서는 같은 세션 중간에 모델을 전환해도 추가 비용이 들지 않아요. 두 모델 모두 동일한 OpenAI 호환 인터페이스를 사용하기 때문이에요. Harness 외부에서 직접 코딩 Agent를 구축하는 경우에도 코드로 같은 라우팅 로직을 구현할 수 있어요. 가장 간단한 호출 예시는 다음과 같아요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

response = client.chat.completions.create(
    model="deepseek-flash",  # 코드 작성에는 기본적으로 Flash 사용. 모델명은 플랫폼의 모델 목록을 기준으로 확인하세요
    messages=[{"role": "user", "content": "用 Python 写一个带重试机制的 HTTP 请求函数"}]
)
print(response.choices[0].message.content)
전체 구현 코드 보기: 작업 유형에 따라 Pro / Flash 자동 선택
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 작업 유형과 모델 매핑: 코딩 / Agent / 비전은 Flash, 지식 / 장문서는 Pro 사용
TASK_MODEL_MAP = {
    "code": "deepseek-flash",
    "agent": "deepseek-flash",
    "vision": "deepseek-flash",      # Pro는 이미지 입력을 지원하지 않음
    "knowledge": "deepseek-v4-pro",  # 사실 회상 정확도가 더 높고 환각이 적음
    "long_doc": "deepseek-v4-pro",   # 장문서 이해 능력이 더 뛰어남
}

def ask_deepseek(
    prompt: str,
    task_type: str = "code",
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000,
) -> str:
    """작업 유형에 따라 DeepSeek 모델을 선택해 호출합니다."""
    model = TASK_MODEL_MAP.get(task_type, "deepseek-flash")

    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error ({model}): {e}"

# 코드 작성에는 Flash 사용
print(ask_deepseek("重构这段函数,拆分为三个职责单一的方法:...", task_type="code"))

# API 세부 사항 확인에는 Pro 사용
print(ask_deepseek("requests 库 Session 对象的 mount 方法有哪些参数?", task_type="knowledge"))
이 라우팅 방식은 이 글의 결론과 같아요. Flash를 주력으로 사용하고, 지식 관련 작업에만 Pro를 활용하는 거예요. 추후 V4.1 Pro가 출시되면 매핑 표의 설정 한 줄만 바꾸면 돼요.
🚀 빠른 시작: APIYI apiyi.com에서 API 키와 신규 사용자 무료 테스트 크레딧을 받아보세요. 키 하나로 DeepSeek뿐 아니라 OpenAI, Claude, Gemini 등 주요 모델도 호출할 수 있어요. 위 코드를 사용해 자신의 저장소에서 Flash와 Pro의 실제 성능을 비교해 보세요.
DeepSeek Pro와 Flash: 선택 가이드
지능, 가격, 속도 세 가지 측면을 종합하면 DeepSeek Harness에서 모델을 선택할 때 다음 기준을 참고할 수 있어요.
- 기본값은 Flash + Max: 코드 작성, 여러 파일 리팩터링, 도구 실행, 이미지 읽기, 일상적인 질문에는 모두 Flash + Max를 사용하세요. Harness에서 가장 적합한 기본 설정이기도 해요.
- 지식 기반 작업은 Pro로 전환: 잘 알려지지 않은 지식, 버전 번호, API 세부 정보, 역사적 사실, 긴 문서 정독처럼 SimpleQA에서 13점, LongBench에서 6점 앞선 분야에 적합해요.
- 도구를 오래 반복해서 호출할 때는 Pro를 사용하지 마세요: Max 등급에서는 더 느리고 비용도 더 많이 들며, 코딩 벤치마크에서도 우위가 없어요.
- 이미지를 첨부한 차례에는 반드시 Flash를 사용하세요: Pro는 비전 기능을 지원하지 않아요.
- Pro는 보조 경로로 활용하세요: V4.1 Pro가 정식 출시되기 전까지 Pro 항목은 지식 검색을 위한 보조 도구로만 사용하세요. 새 버전이 출시되면 다시 평가하면 돼요.
💡 선택 가이드: 벤치마크 점수는 전반적인 경향만 보여줘요. 실제 코드베이스와 비즈니스 로직에 따라 차이는 더 클 수도, 작을 수도 있어요. APIYI apiyi.com에서 동일한 인터페이스를 사용해 프로젝트의 실제 작업 몇 가지를 Flash와 Pro로 각각 실행해 보세요. 성공률, 소요 시간, 토큰 사용량을 비교한 뒤 팀의 기본 설정을 정하는 것을 권장해요.
자주 묻는 질문 FAQ
Q1: DeepSeek Harness의 Pro와 Flash는 각각 어떤 모델인가요?
Flash는 `deepseek-flash`에 해당하며, 실제 모델은 V4.1-Flash-1017입니다. 총 파라미터가 552B인 MoE 모델로, 비전 기능과 1M 컨텍스트를 지원해요. Pro는 `deepseek-v4-pro`에 해당하며, 실제 모델은 V4-Pro-0813 GA 버전입니다. 총 파라미터는 1.6T, 활성 파라미터는 약 49B이며 이미지 입력은 지원하지 않아요.
Q2: DeepSeek Pro가 더 큰데, 코딩 성능은 왜 Flash보다 떨어지나요?
Flash는 더 최신 아키텍처 계열에 속하고, post-training도 더 충분히 거쳤어요. 1017 버전은 Harness에 맞춰 특별히 최적화되기도 했습니다. Pro의 강점은 많은 파라미터에서 비롯되는 지식 보유량이지, 코딩이나 도구 호출 성능은 아니에요. 따라서 DeepSWE, AutomationBench, Terminal-Bench에서는 Flash가 앞서고, SimpleQA와 LongBench에서는 Pro가 앞섭니다.
Q3: DeepSeek V4 Pro는 서비스가 중단되나요? V4.1 Pro는 언제 출시되나요?
공식적으로 9월 14일 이후 V4 Pro 서비스를 중단한다고 공지한 적이 있지만, 이후 같은 업데이트 로그에서 API 서비스를 계속 제공하고 요금도 그대로 유지한다고 정정했어요. 따라서 현재는 정상적으로 사용할 수 있습니다. 현재까지 V4.1 Pro는 정식 출시되지 않았어요. 10월 말에는 공식 웹사이트의 모델 표기 변경을 두고 추측이 있었을 뿐이므로, 공식 업데이트 로그를 확인하는 것이 좋습니다.
Q4: 추론 수준을 Max로 설정하면 Pro와 Flash의 비용 차이는 얼마나 나나요?
단가 기준으로 Pro의 출력 비용은 Flash의 약 3.3배, 캐시 미적중 입력 비용은 약 4.4배, 캐시 적중 입력 비용은 약 7.3배예요. Max 설정에서는 사고 토큰도 출력 비용에 포함됩니다. Pro는 반복해서 생각하고 자체 검증을 하는 경향이 더 강해, 실제 사용 시간은 Flash의 2.5배를 넘기도 해요. 따라서 실제 청구 금액 차이는 보통 단가 배수보다 더 커집니다.
Q5: Harness를 사용하지 않고 API로 DeepSeek Flash와 Pro를 호출하려면 어떻게 해야 하나요?
두 모델 모두 OpenAI 호환 인터페이스를 사용하므로, `model` 매개변수만 바꾸면 전환할 수 있어요.
1. APIYI apiyi.com에 접속해 계정을 등록합니다.
2. API 키와 신규 사용자 무료 테스트 크레딧을 받습니다.
3. 이 글의 코드를 사용하고 `base_url`을 `https://api.apiyi.com/v1`로 설정한 다음, `model`에 Flash 또는 Pro의 모델명을 입력합니다.
사용할 수 있는 정확한 모델명은 플랫폼의 모델 목록을 확인하세요.
Q6: 같은 대화 중간에 Flash에서 Pro로 바꿀 수 있나요?
네. 전환에 추가 비용은 없고, 두 모델 모두 같은 인터페이스를 사용해요. 흔히 코딩할 때는 Flash를 사용하고, 확실하지 않은 API 세부 사항이나 버전 번호를 확인해야 할 때는 Pro로 바꿔 검증한 다음 다시 Flash로 돌아와 코딩을 이어갑니다. 단, 이미지가 포함된 턴에서는 Pro를 선택할 수 없어요.
Q7: DeepSeek Flash의 단점은 무엇인가요?
Flash의 주요 약점은 지식 측면에 있어요. SimpleQA-Verified 점수는 42.3으로 Pro보다 약 13점 낮으며, 잘 알려지지 않은 사실이나 구체적인 버전 번호를 물으면 환각이 발생할 가능성이 더 높습니다. 긴 문서 이해 능력도 Pro보다 약간 떨어져요. 중요한 사실은 Pro로 교차 검증하거나, 프롬프트에 공식 문서 내용을 직접 제공하면 보완할 수 있습니다. 다른 업체 모델과도 비교하고 싶다면 APIYI apiyi.com에서 같은 API 키로 모델을 바꿔가며 테스트할 수 있어요.
DeepSeek Pro와 Flash 선택 핵심 요약
- 코딩에는 기본적으로 Flash를 선택하세요: DeepSWE 점수가 77.0으로 Pro의 62.7보다 높고, 코딩과 에이전트 능력 전반에서 앞서요.
- Pro는 지식 작업에 강해요: SimpleQA에서 약 13점, LongBench에서 약 6점 앞서 사실 확인이나 긴 글 읽기에 적합해요.
- 파라미터가 많다고 코딩을 더 잘하는 건 아니에요: Flash는 새로운 아키텍처와 후처리 학습으로 성능을 역전했으며, Pro의 증류 버전이 아니에요.
- Max 모드에서는 비용 격차가 더 커져요: Pro는 더 오래 추론하기 때문에 실제 청구 금액은 출력 단가 차이인 3.3배보다 더 높아요.
- 속도와 동시 처리에서는 Flash가 우세해요: 활성화 파라미터가 한 자릿수 배만큼 적고, 동시 처리 한도는 Pro의 5배예요.
- 이미지 입력은 Flash만 지원해요: Pro는 시각 입력을 지원하지 않아요.
- 실제 작업으로 검증해 보세요: APIYI의 통합 인터페이스를 통해 두 모델을 직접 비교할 수 있어요.
요약
DeepSeek Harness에서 추론 수준을 모두 Max로 설정했을 때 Pro와 Flash 중 선택하는 방법은 간단해요.
- 성능: 코딩, 에이전트 실행, 도구 호출에는 Flash가 더 강하고, 지식 검색과 긴 문서 읽기에는 Pro가 더 강해요.
- 가격: Flash의 단가는 Pro의 약 3분의 1에서 7분의 1 수준이에요. Max 모드에서는 격차가 더 커지고, 비수기 가격을 적용하면 다시 절반으로 낮출 수 있어요.
- 속도: Flash는 첫 토큰 응답과 전체 처리 시간이 모두 훨씬 짧아요. 동시 처리 한도는 Pro의 5배이며, Harness에 맞춘 최적화도 적용됐어요.
결론적으로 Flash를 기본 모델로 사용하고, Pro는 지식 검색용 보조 모델로 활용하는 것을 추천해요. V4.1 Pro가 정식 출시되면 다시 평가해 보세요. 자체 코드베이스에서 이 결론을 검증하고 싶다면 APIYI apiyi.com에서 API 키 하나로 두 모델을 모두 호출해 실제 작업으로 비교한 뒤 팀의 기본 설정을 정하면 돼요.
📚 참고 자료
- DeepSeek 공식 업데이트 로그: V4.1 Flash 출시, V4 Pro 서비스 연장, 1017 버전의 Harness 최적화 안내
- 링크:
api-docs.deepseek.com/updates -
설명: 모델 버전과 출시 상태, Harness 버전 권장 사항을 확인할 수 있는 공식 자료예요.
-
DeepSeek 공식 가격 페이지: Flash와 Pro의 입력·출력 단가, 피크·비피크 시간대, 동시 실행 한도
- 링크:
api-docs.deepseek.com/quick_start/pricing -
설명: 실제 호출 비용을 계산하고 비피크 시간대에 일괄 작업을 예약할 때 참고할 수 있어요.
-
Respan 2026 DeepSeek 모델 비교: 제3자 모델 간 비교 평가
- 링크:
respan.ai/articles/deepseek-model-comparison - 설명: “더 저렴한 모델이 대부분의 코딩 및 Agent 작업에서 더 나은 성능을 보인다”는 내용을 독립적인 관점에서 검증해요.
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지에서 문의해 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.