Nota do autor: com base em um conjunto de testes de recriação do site oficial da Agrumea Farm, este artigo compara o Gemini 4 Carbon, o Claude Opus 5.5 e o GPT-6 Astra em 3 dimensões (fidelidade do design, requisitos de interação, tempo gasto e custo equivalente em API). Também mostra como escolher o modelo por cenário e como refazer o teste por conta própria.
Se você entregar o mesmo site de marca para três modelos de ponta recriarem, quanta diferença vai aparecer? Em 11 de novembro de 2026, o avaliador independente Pat Simmons (AI for Mortals) publicou um conjunto de testes. Ele pediu ao Gemini 4 Carbon, ao Claude Opus 5.5 e ao GPT-6 Astra que recriassem o site oficial da marca italiana de alimentos Agrumea Farm, e divulgou os resultados, as capturas de tela, os comandos, o tempo de execução e o custo equivalente em API.
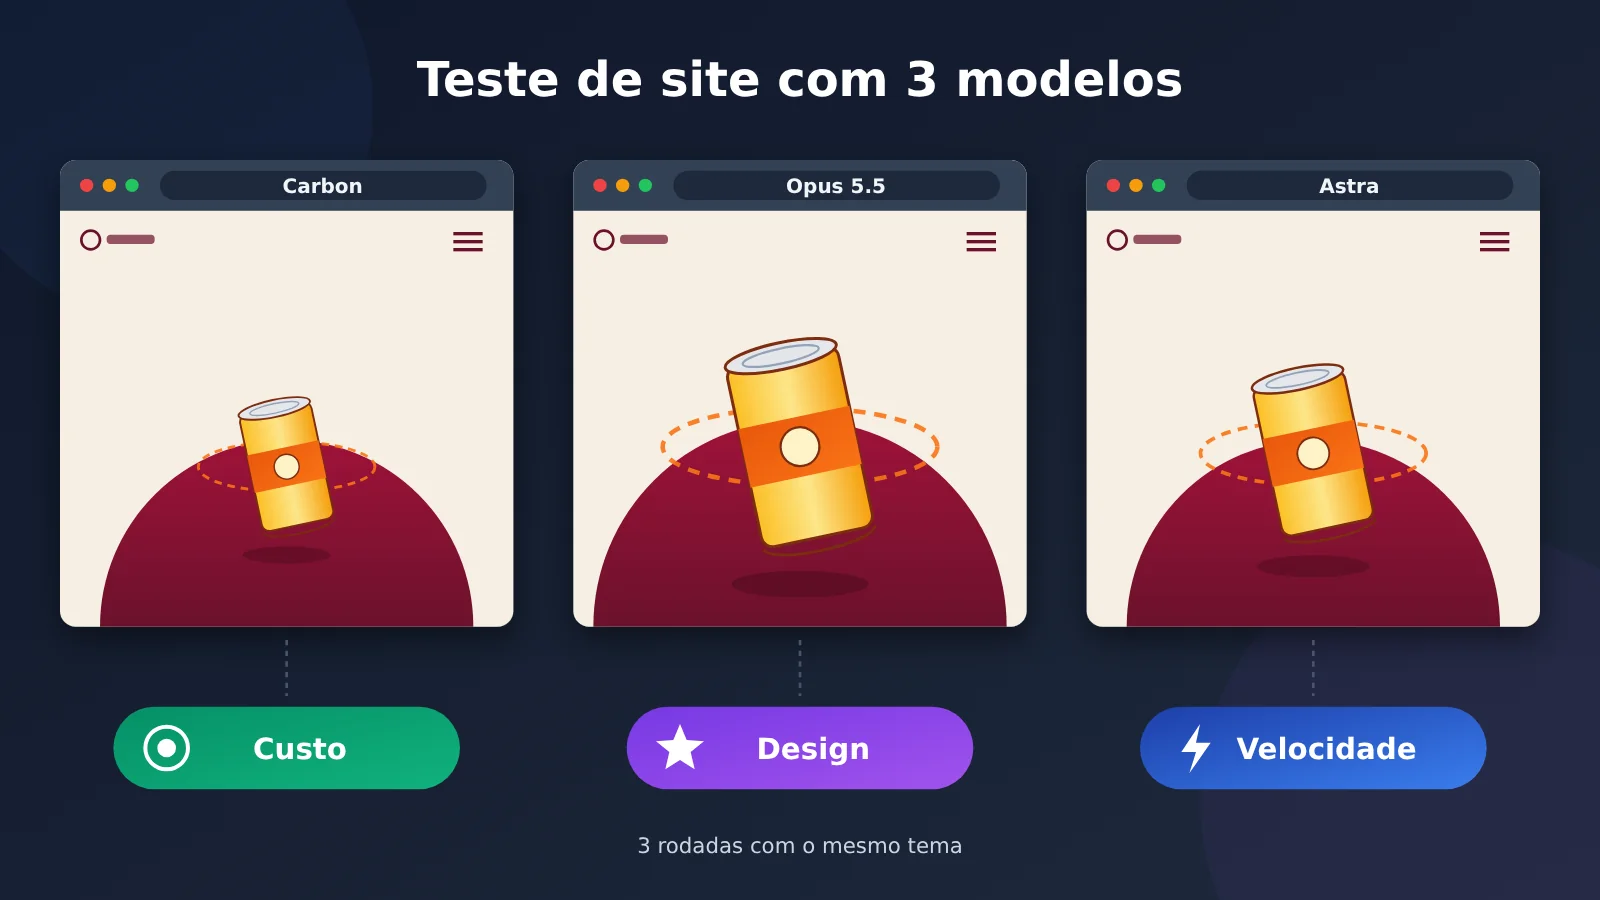
Não é uma daquelas análises em que “cada um tem seu mérito”. Nesta tarefa, o vencedor de cada dimensão ficou bem claro: o Carbon teve o menor custo, o Astra levou menos tempo e o Opus recebeu do avaliador a melhor nota de qualidade. Vale ressaltar que cada modelo foi executado uma única vez, e que o ambiente de ferramentas e a data do teste também foram diferentes. Por isso, esses resultados não podem ser generalizados diretamente como um ranking para todos os cenários de desenvolvimento web.
O que você leva daqui: depois de ler o artigo, você vai saber onde cada um desses três fluxos de trabalho (“modelo + ferramenta”) se destaca em resultado, velocidade e custo, e vai poder usar o método descrito para validar tudo de novo nos seus próprios projetos.
Primeiro, como era o site original: o teste de recriação com Carbon, Opus e Astra
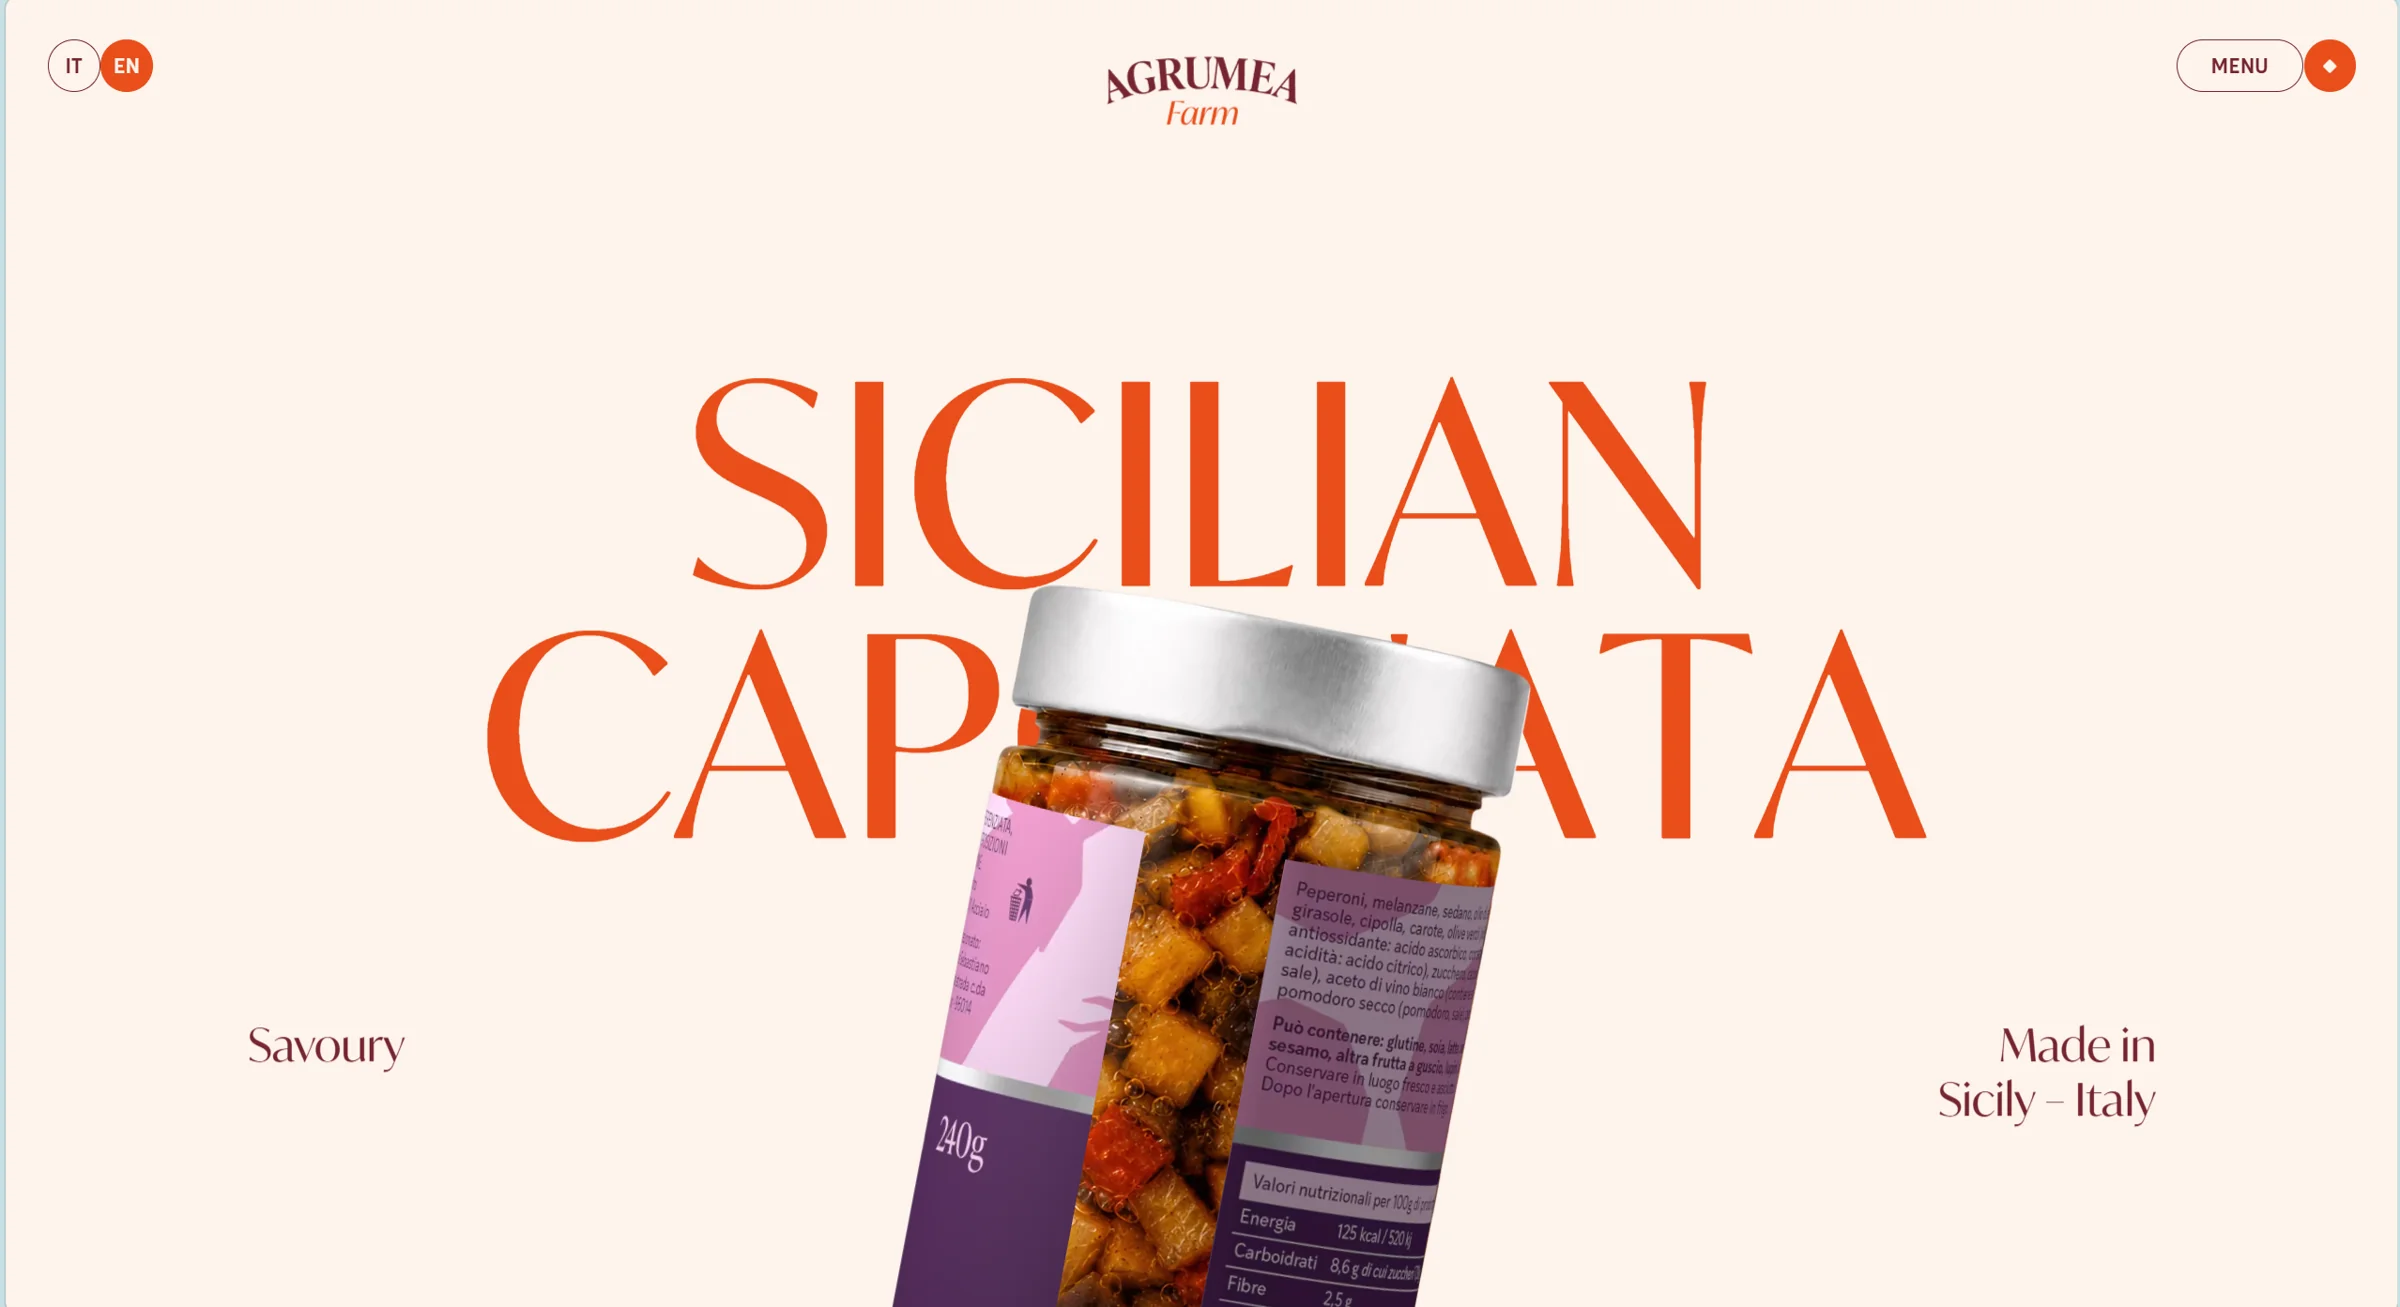
Antes de ver os resultados, vale entender as condições do teste. O valor dessa avaliação está em usar “o mesmo site, o mesmo comando e o mesmo objetivo de desenvolvimento”. Só que ela compara fluxos de trabalho completos, e não o modelo isolado em laboratório.
| Item do teste | Configuração | Impacto na conclusão |
|---|---|---|
| Alvo do teste | Site oficial da Agrumea Farm (versão em inglês) | Compara a capacidade de reproduzir um design, não o senso estético original |
| Requisitos da tarefa | Recriar a estrutura da página, o estilo visual, o carrossel 3D de latas, rolagem e arrasto, animação de carregamento, animações de hover e transições de página | Além do print estático, a interação também conta como métrica de qualidade |
| Tamanhos verificados | Desktop 1440×900, mobile 390×844 | Exige pensar no layout responsivo ao mesmo tempo |
| Forma de validação | Ler os estilos pelo navegador e fazer verificação visual, garantindo que o site funcione | A capacidade de autoverificação no navegador afeta o resultado final |
| Ambiente de ferramentas | Carbon no Google Antigravity, Opus no Claude Code, Astra no Codex, todos com raciocínio em nível alto | O resultado é fruto do modelo e da cadeia de ferramentas juntos |
| Execuções e datas | Apenas 1 execução por modelo; Opus e Astra em 6 de novembro, Carbon de 10 a 11 de novembro | Há variação de uma única execução e diferenças de ambiente |
Três premissas importantes dos testes com Carbon, Opus e Astra
A primeira premissa é que se trata de “recriação”, e não de “design livre”. Os três modelos precisavam seguir a linguagem de design da marca original, então o foco da comparação está na fidelidade, nos detalhes e no grau de acabamento. Se a sua necessidade é criar uma identidade visual original do zero, esse teste serve apenas como referência.
A segunda premissa é o critério de custo. Todos os valores citados no texto foram calculados pelo autor da avaliação com base nos preços dos modelos e nos logs de uso, ou seja, são o equivalente em API, e não o valor realmente cobrado numa assinatura. Se você rodar a mesma tarefa numa ferramenta de plano mensal, a cobrança será completamente diferente.
A terceira premissa é que a avaliação tem, na verdade, quatro modelos. O autor também incluiu o Claude Fable 5.2, que ficou em primeiro lugar na avaliação subjetiva. Por isso, quando o texto abaixo falar em “2º, 3º e 4º lugar”, está se referindo ao ranking com os quatro modelos.
Nota sobre as imagens: os prints da primeira dobra dos três trabalhos mostrados neste texto vêm de AI for Mortals / Pat Simmons, publicados em 11/11/2026, e correspondem às recriações do Gemini 4 Carbon, do Claude Opus 5.5 e do GPT-6 Astra, respectivamente.
Primeira rodada: Carbon, Opus e Astra — quem recriou melhor o design do site?
Vamos começar pelo visual. Pelas capturas de tela públicas da primeira dobra, os três trabalhos pegaram os elementos centrais do site original: fundo off-white, a lata de comida flutuando, o fundo curvo em vinho, o texto laranja circulando a lata e, no topo, a marca, o seletor de idioma e o botão de menu. Ou seja, nenhum deles entregou aquela página de template genérico que foge do original. A diferença está nas proporções, nas camadas e nos detalhes.
As imagens abaixo mostram, de cima para baixo, os trabalhos do Opus 5.5, do Astra e do Carbon.
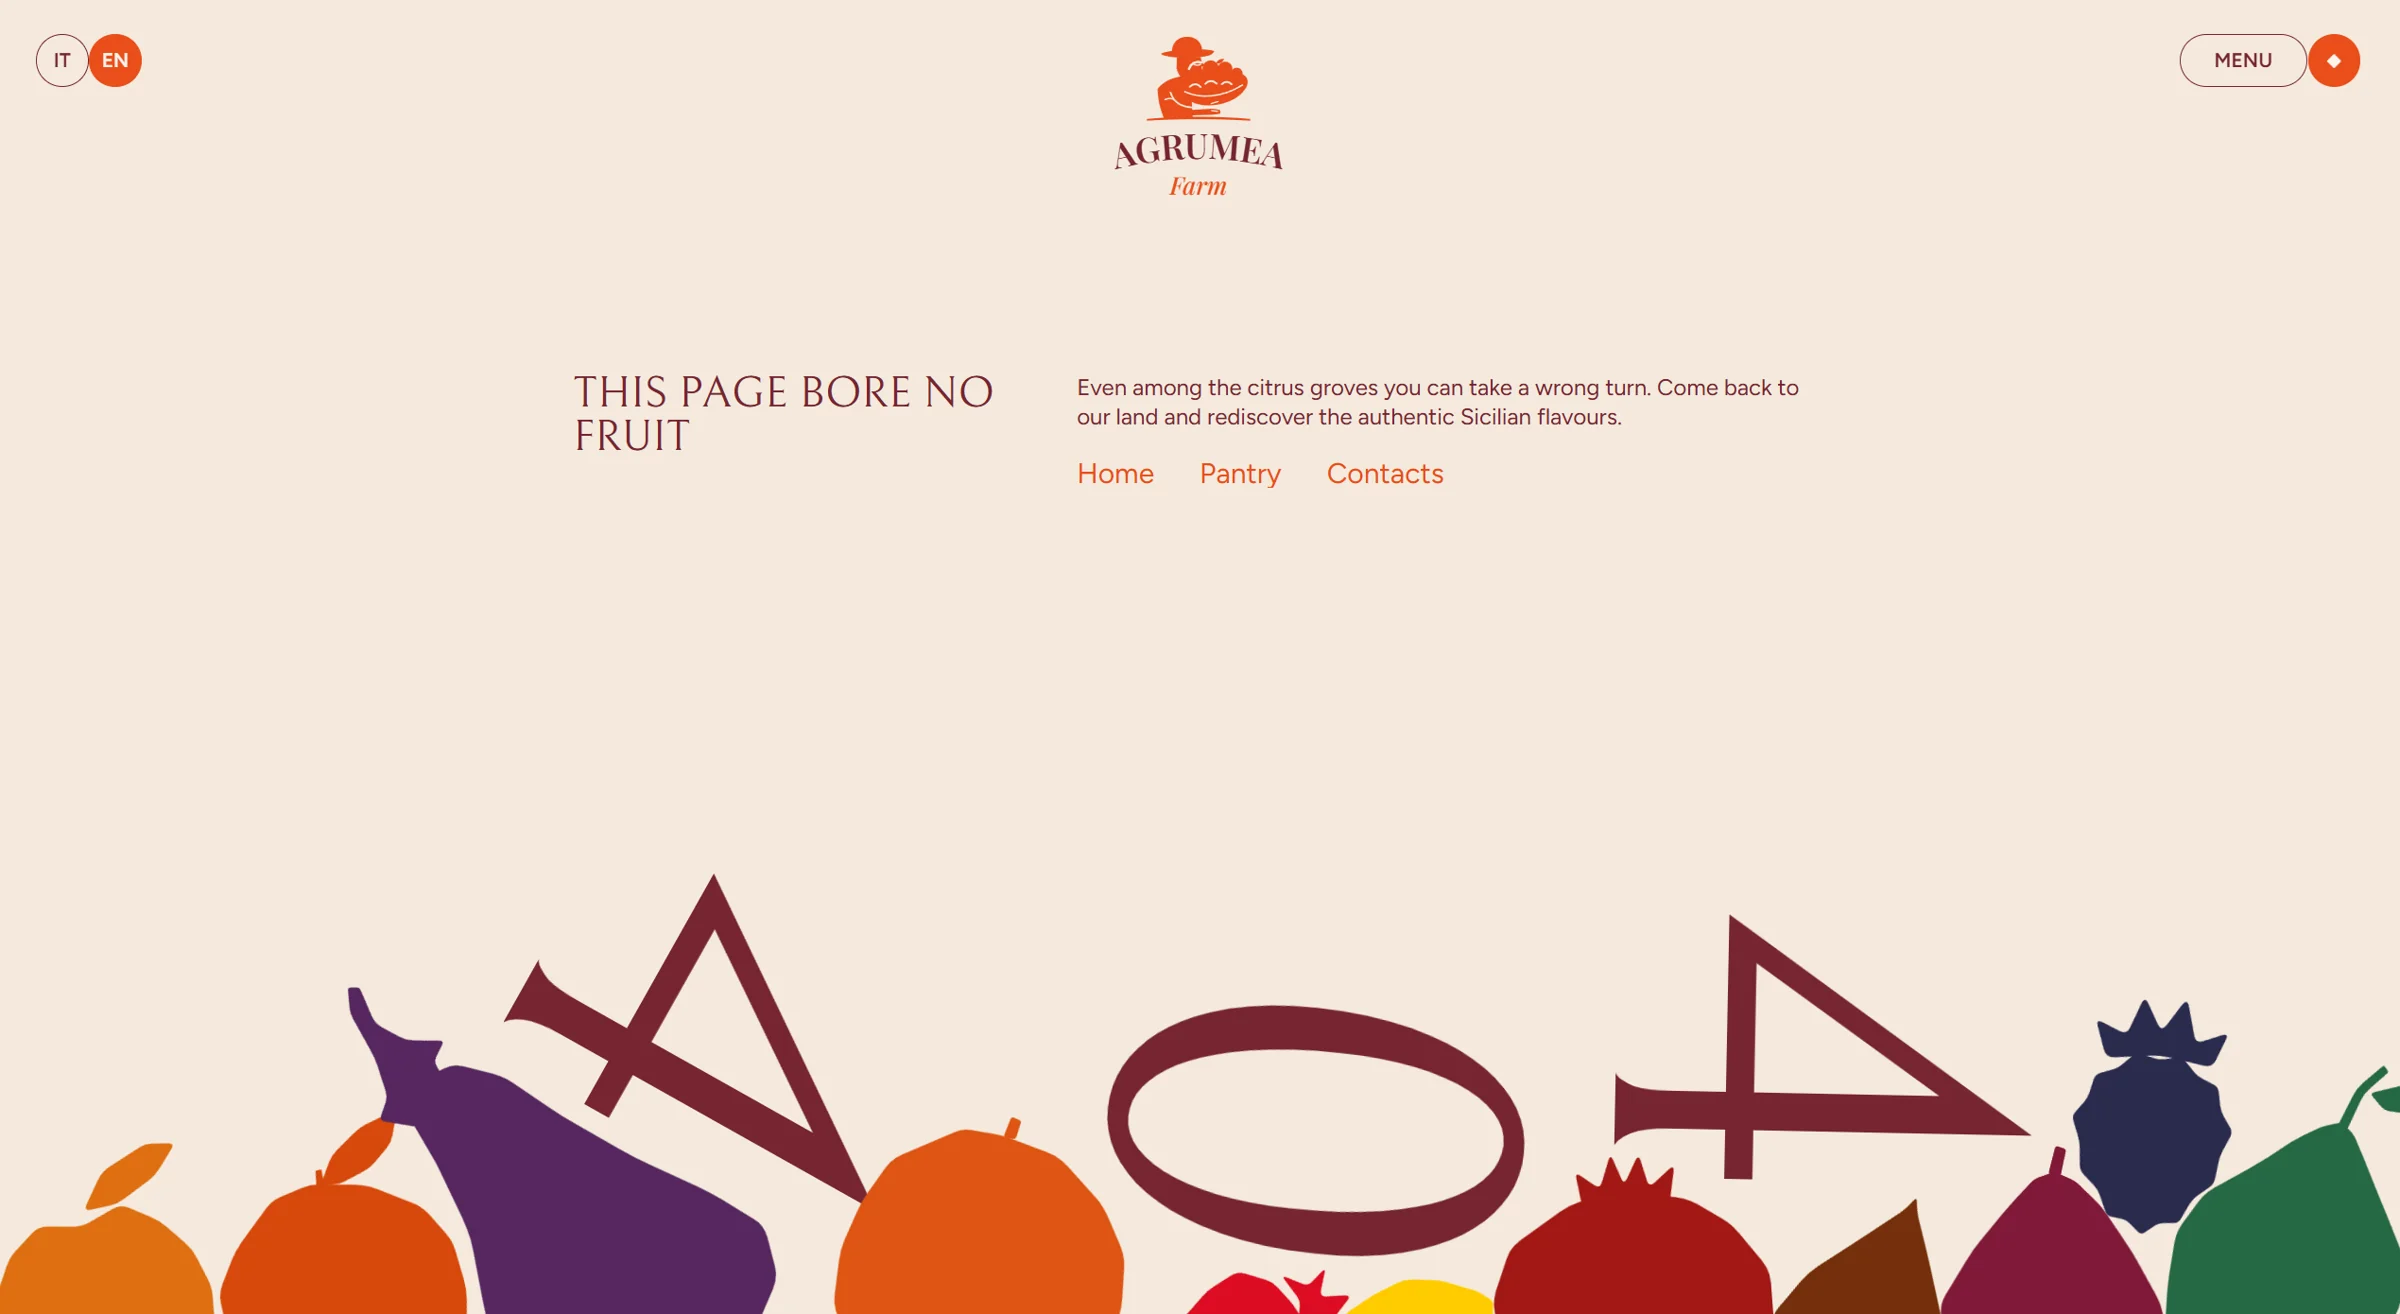
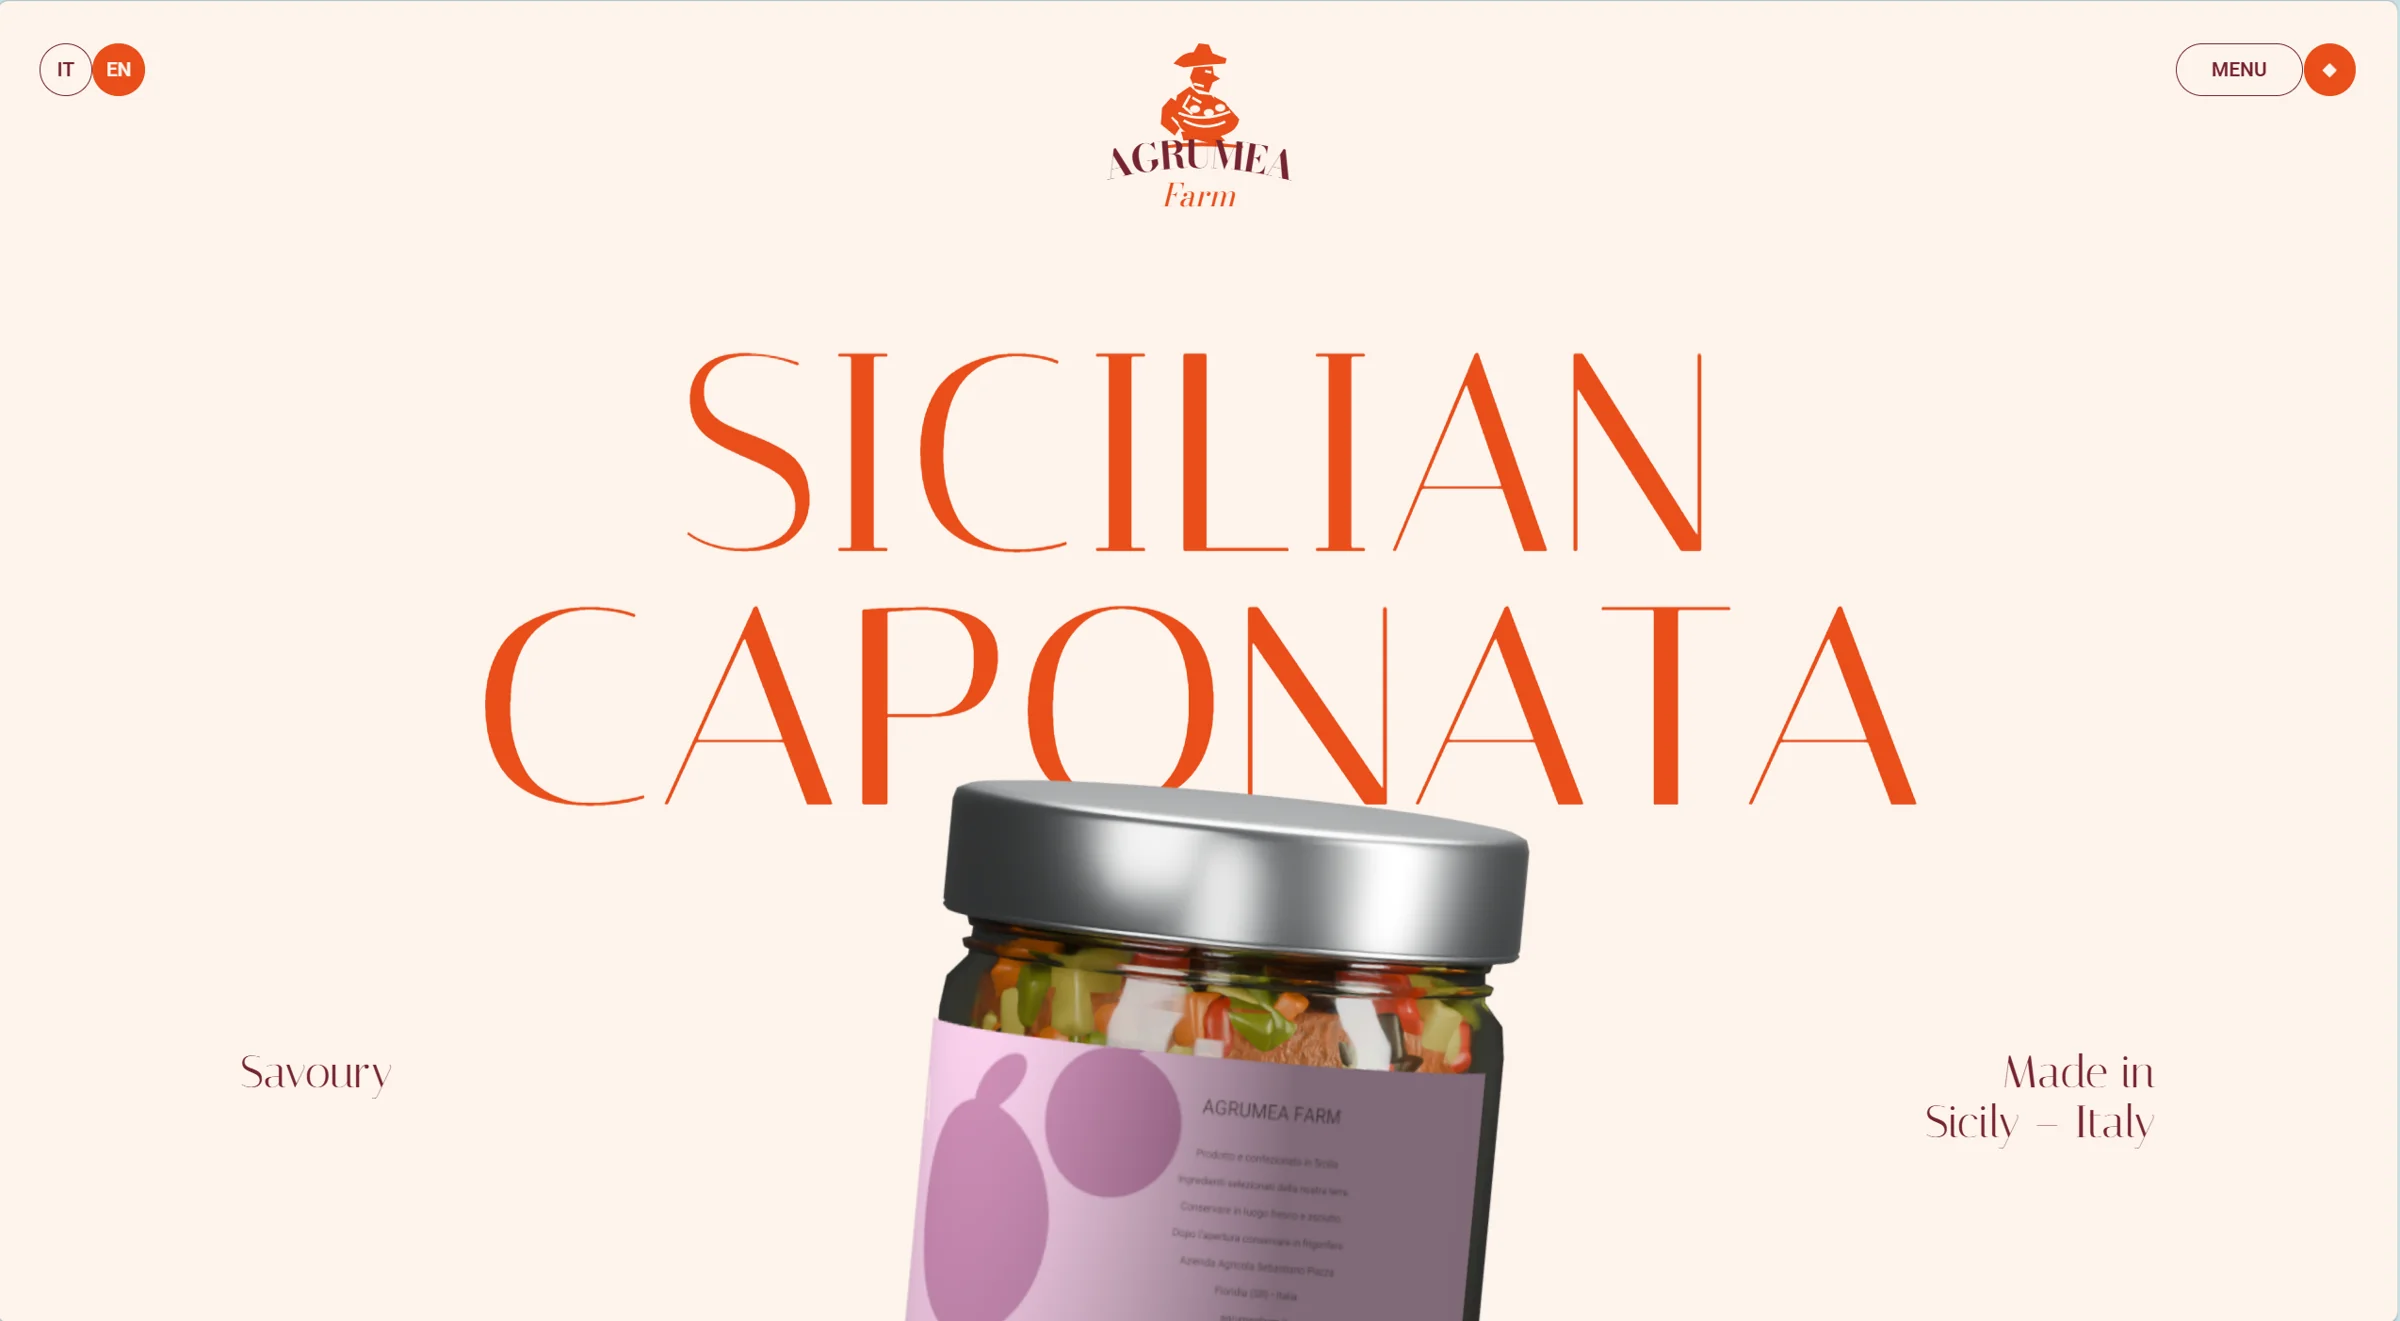
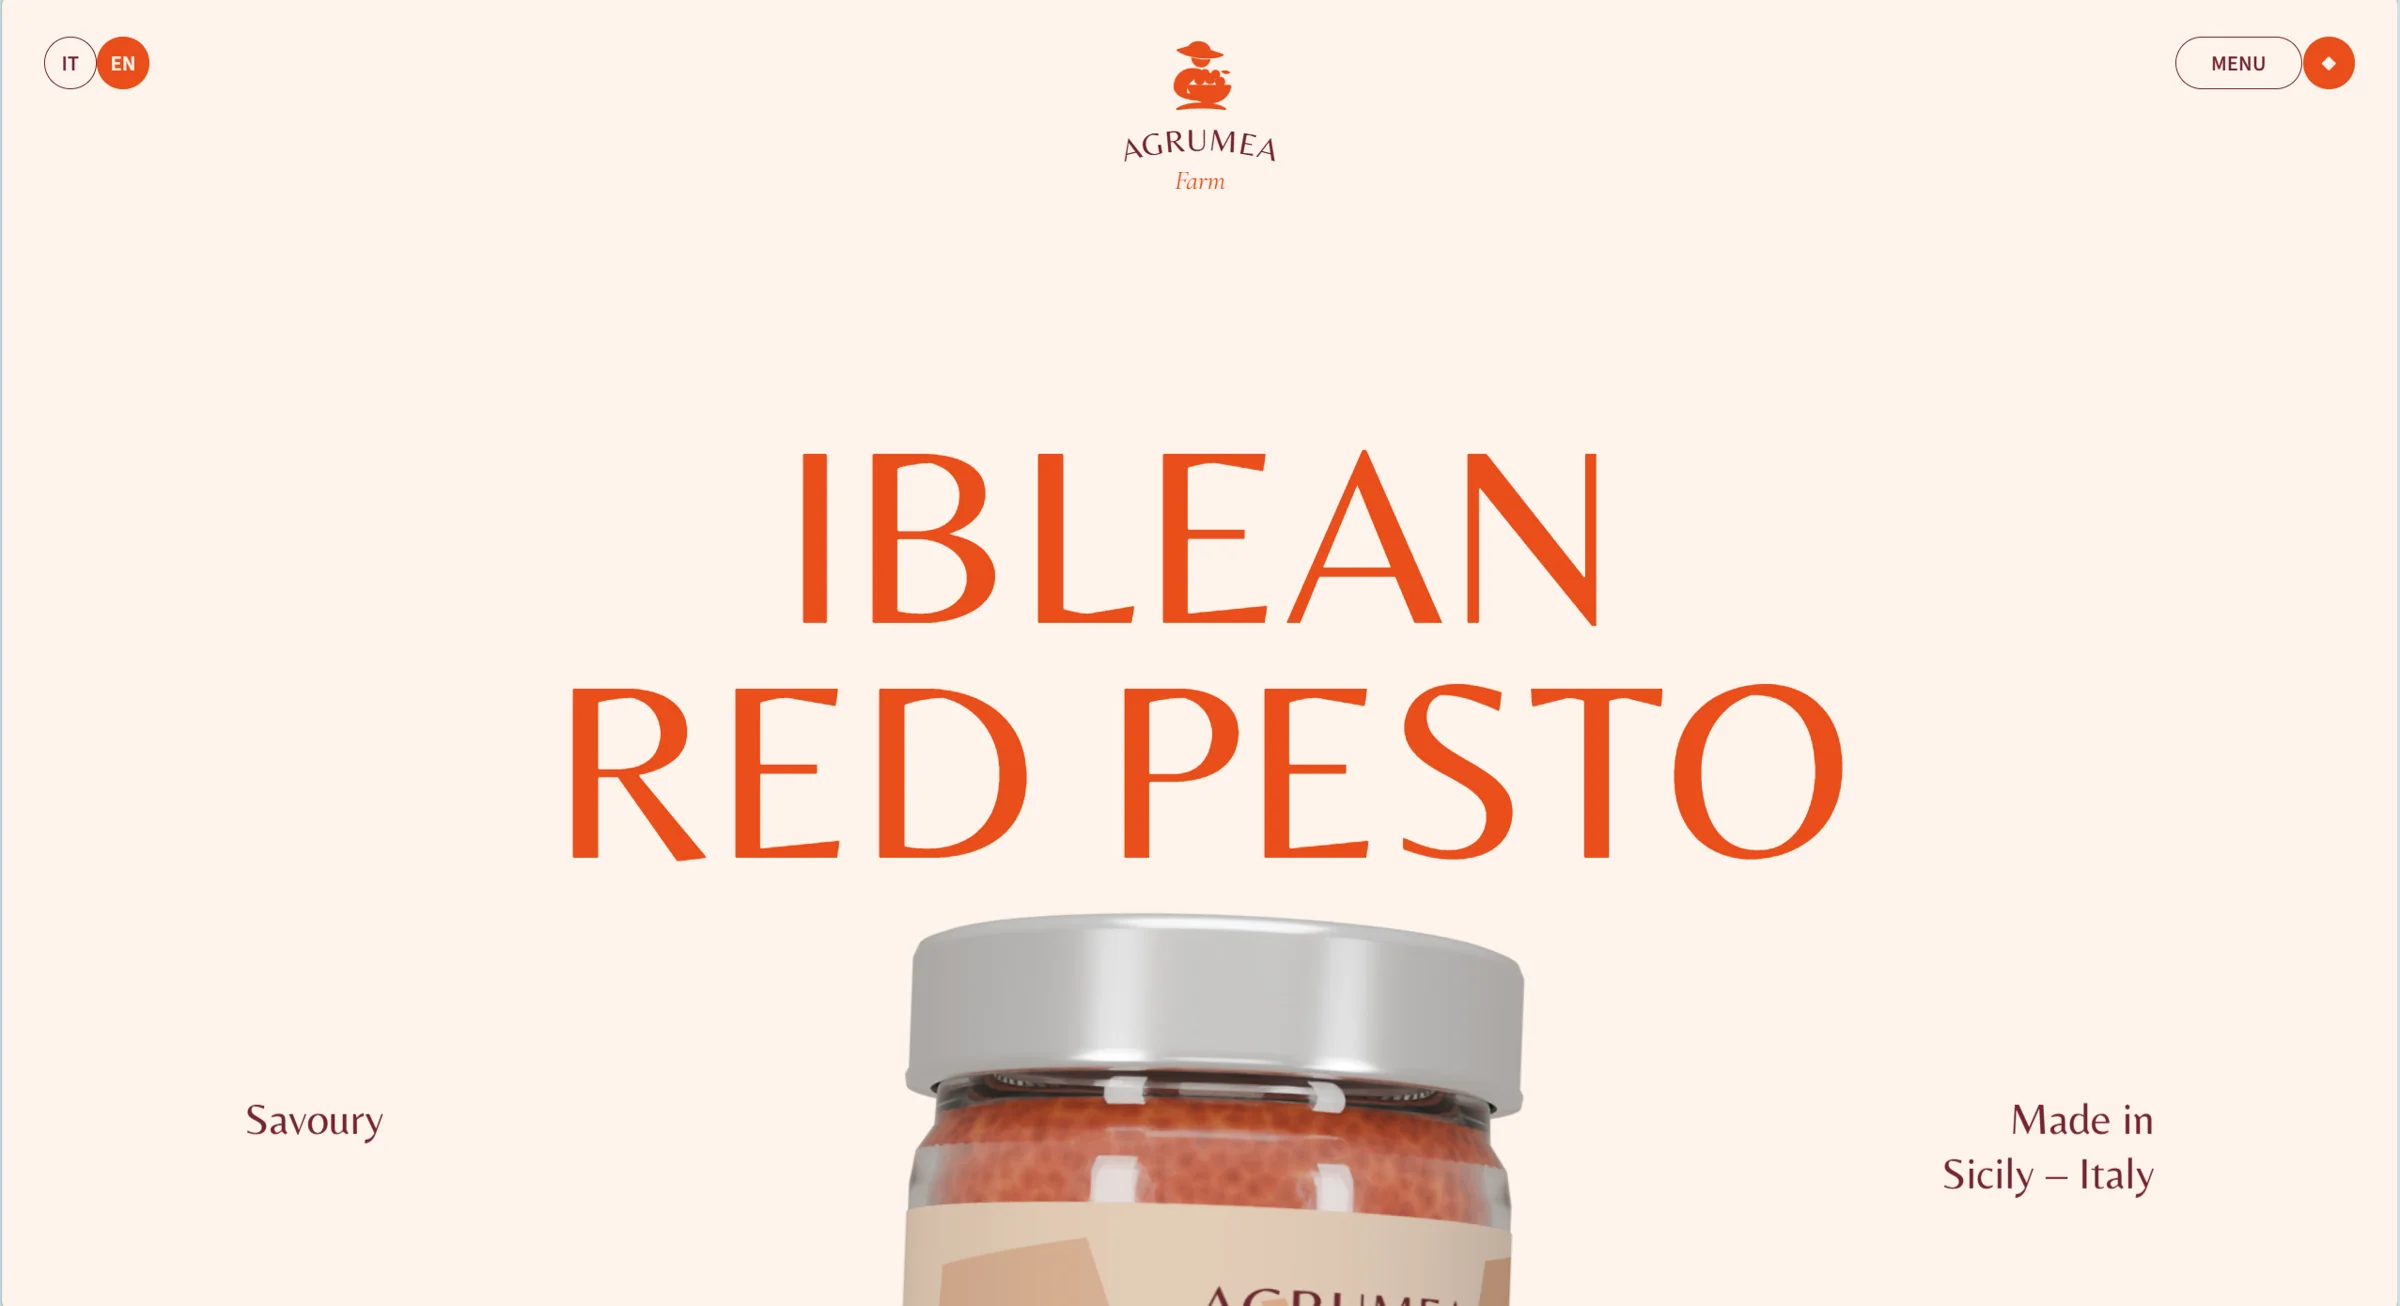
| Critério observado | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Composição da primeira dobra | Muito espaço em branco, layout mais arejado | Produto principal maior, com forte impacto visual | Disposição completa, layout mais compacto |
| Proporção da lata | Lata central relativamente pequena | Lata em destaque, ponto focal absoluto | Ponto focal bem definido |
| Fundo e camadas | Fundo curvo reproduzido | Sobreposição entre a lata e a curva do fundo mais evidente | Camadas completas |
| Rótulo e texto | Alguns detalhes de rótulo e texto mais fracos | Rótulo e tipografia mais ricos | Rótulo da lata com ornamentos gráficos marcantes |
| Ranking subjetivo do autor (entre quatro modelos) | 4º | 2º | 3º |
Por que o Opus foi mais bem avaliado na recriação do design
Primeiro, vale separar dois tipos de informação: as quatro primeiras linhas da tabela são observações visuais feitas a partir das capturas públicas, e só a última linha é o ranking subjetivo do autor da avaliação. Entre os três modelos em questão, o autor ficou mais satisfeito com o Opus, depois com o Astra e, por último, com o Carbon.
Pelas capturas, a vantagem do Opus está principalmente na “hierarquia de um site de marca”. Na primeira dobra de um site de marca de alimentos, o protagonista é o produto. O Opus deixou a lata maior e fez com que ela e a curva em vinho se sobrepusessem de forma clara, com a lata na frente, além de deixar o texto do rótulo mais nítido. O layout arejado do Carbon não é errado em si, mas a lata menor e alguns detalhes de texto mais fracos acabam pesando contra ele quando o critério é a fidelidade ao original.
O Astra fica no meio-termo. A composição é completa, o ponto focal é claro e o rótulo da lata tem um ar decorativo bem forte, só que o conjunto é mais compacto. Numa tarefa de recriação, “parecer com o site original” importa mais do que “ficar bonito”, e isso explica por que os três trabalhos não são ruins, mas ainda assim há uma diferença clara de colocação.
Segunda rodada: por que a fidelidade da interação em Carbon, Opus e Astra não pode ser avaliada só por screenshots
A maior diferença entre um site e um layout de design é que o site precisa “ganhar vida”. A tarefa original pedia explicitamente a reprodução de um carrossel 3D de latas de produto, interações de rolagem e arrastar, animação de carregamento, animações de hover e transições de página. Essas capacidades quase não aparecem em capturas de tela estáticas, mas determinam diretamente a experiência de quem abre o site.
Por isso, um screenshot só mostra o layout e os detalhes visuais; ele não prova que as interações foram totalmente implementadas. Para saber se a lata 3D arrasta com fluidez, se o feedback de hover parece natural ou se o layout quebra no mobile, é preciso abrir as três páginas públicas e testar na prática. Este texto não trata screenshots como resultado de teste de interação, nem inventa notas de interação que o autor original não deu.
Esta rodada também deixa clara a diferença entre desenvolver páginas web e gerar imagens estáticas. Um modelo pode desenhar uma primeira dobra linda, mas colocar em código executável um carrossel 3D, animações guiadas por rolagem e um layout responsivo ainda exige cuidar da ordem de carregamento, do desempenho e do comportamento em diferentes tamanhos de tela. A exigência da avaliação de “ler os estilos no navegador e fazer a verificação visual” serve justamente para transformar “terminou de escrever” em “realmente funciona”.
Num projeto real, você pode conferir um site gerado por IA seguindo esta ordem:
- Abra a página em dois tamanhos, 1440×900 e 390×844, e confirme que o layout não transborda nem tem elementos sobrepostos.
- Dispare uma a uma as interações de arrastar, rolar, hover e troca de página, e observe se as animações travam ou deixam de funcionar.
- Abra o console do navegador e verifique se há erros, falhas no carregamento de recursos ou animações em loop infinito.
- Por fim, compare tela a tela com o site original ou o design e registre as diferenças visuais.
Terceira rodada: quanto Carbon, Opus e Astra diferem em custo e tempo
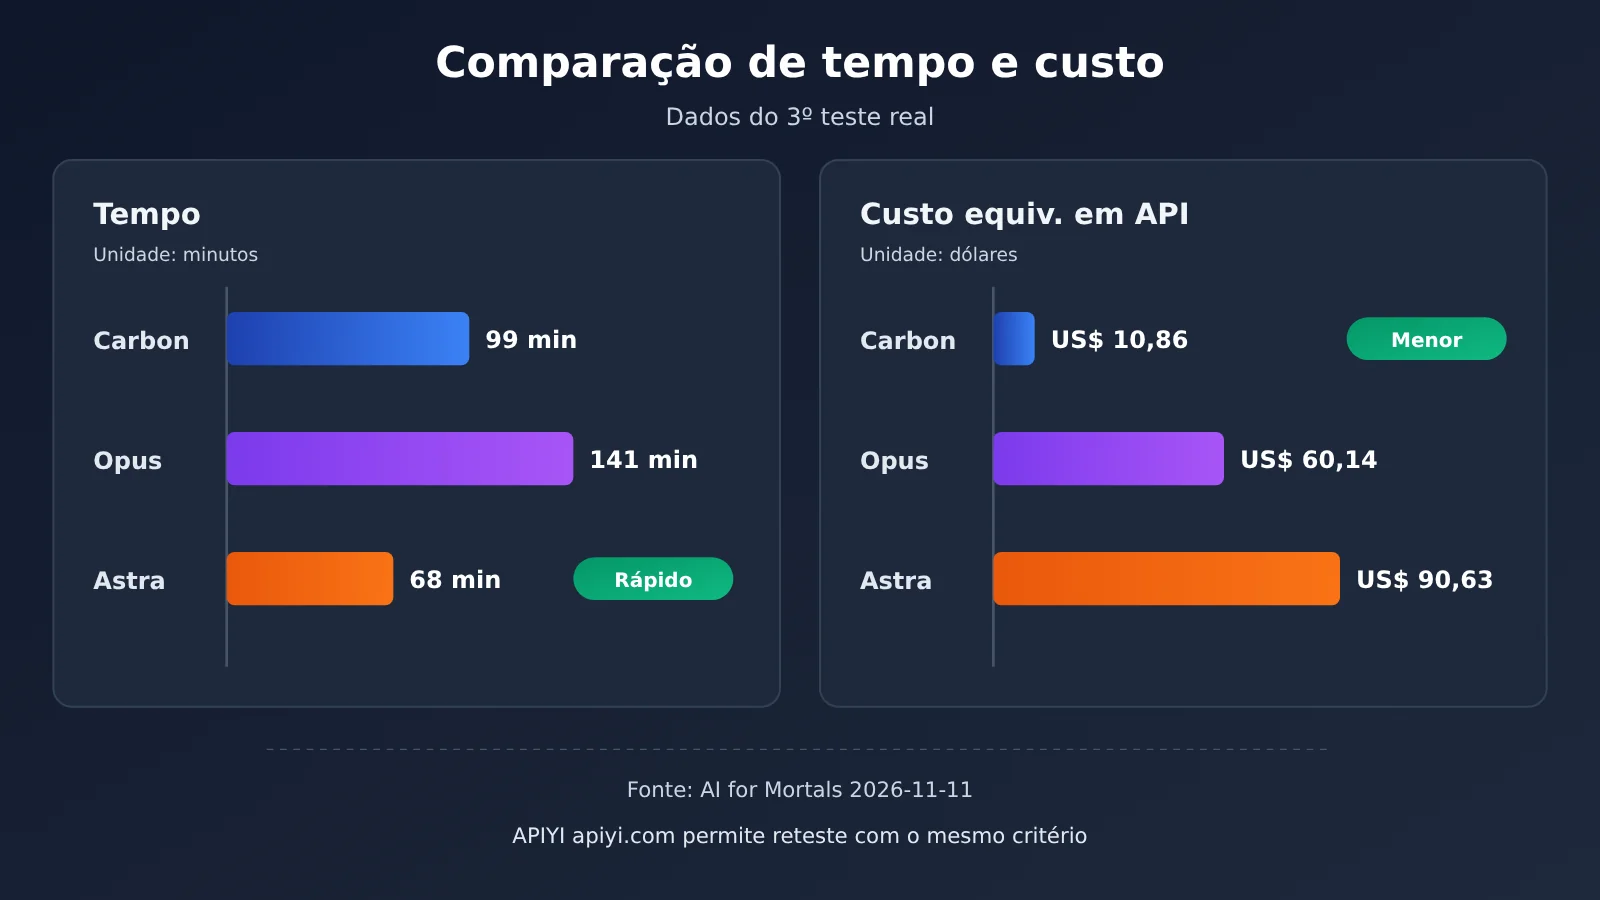
Esta rodada mostra melhor a diferença entre os três fluxos de trabalho. Todos os dados abaixo vêm da avaliação original, e os custos são equivalentes em API.
| Métrica | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Tempo | 99 minutos | 141 minutos | 68 minutos (mais rápido) |
| Custo equivalente em API | US$ 10,86 (menor) | US$ 60,14 | US$ 90,63 |
| Tokens de entrada | 27,7 milhões | 197,9 milhões | 70,4 milhões |
| Tokens de saída | 430 mil | 483 mil | 211 mil |
| Custo equivalente por minuto (estimado) | cerca de US$ 0,11 | cerca de US$ 0,43 | cerca de US$ 1,33 |
| Ranking subjetivo do autor (entre os quatro modelos) | 4º | 2º | 3º |
Uma leitura mais a fundo dos custos de Carbon, Opus e Astra
O custo equivalente em API do Carbon é cerca de 18% do Opus e 12% do Astra. Se o seu jeito de trabalhar envolve muita tentativa e erro e iterações repetidas, essa diferença vai se ampliando a cada rodada de tarefas. O Astra levou 68 minutos, menos da metade do tempo do Opus, o que o torna uma boa opção quando a velocidade de entrega é crítica. O Opus foi o mais demorado e ficou no meio em custo, mas entregou o trabalho que o autor mais gostou entre os três.
Tem um detalhe na tabela que passa batido com facilidade: nos três casos, os tokens de entrada são muito maiores que os de saída. Pelos números da tabela, a proporção entrada/saída é de cerca de 64:1 no Carbon, 410:1 no Opus e 334:1 no Astra. Isso tem a ver com o jeito como o desenvolvimento com agentes funciona: a cada rodada o modelo relê o código, os estilos, o estado da página e outros contextos, e o código que ele realmente “escreve” é só uma fração pequena. A entrada do Opus chegou perto de 200 milhões de tokens, sinal de que ele fez muitas idas e vindas de contexto nessa tarefa.
Outro ponto que vale atenção: a quantidade de tokens não é proporcional ao custo. Os tokens de entrada do Astra são cerca de um terço dos do Opus, mas o custo equivalente dele é maior. Isso mostra que o preço unitário, a cobrança de cache e outros fatores também pesam bastante. Na hora de avaliar custos, não basta olhar quem usou menos tokens: é preciso calcular de acordo com as regras de cobrança reais de cada modelo. Este artigo não entra nos preços unitários; para esses valores, consulte as páginas oficiais de preços de cada fornecedor.
Por que Carbon, Opus e Astra dão resultados diferentes com o mesmo comando
Rodar o mesmo comando e obter três resultados diferentes não depende só do modelo. Nesta bateria de testes, cada modelo rodou na sua própria ferramenta de desenvolvimento. O resultado final saiu da combinação de capacidade do modelo, forma de chamar ferramentas, mecanismo de autoverificação no navegador e gerenciamento de contexto.
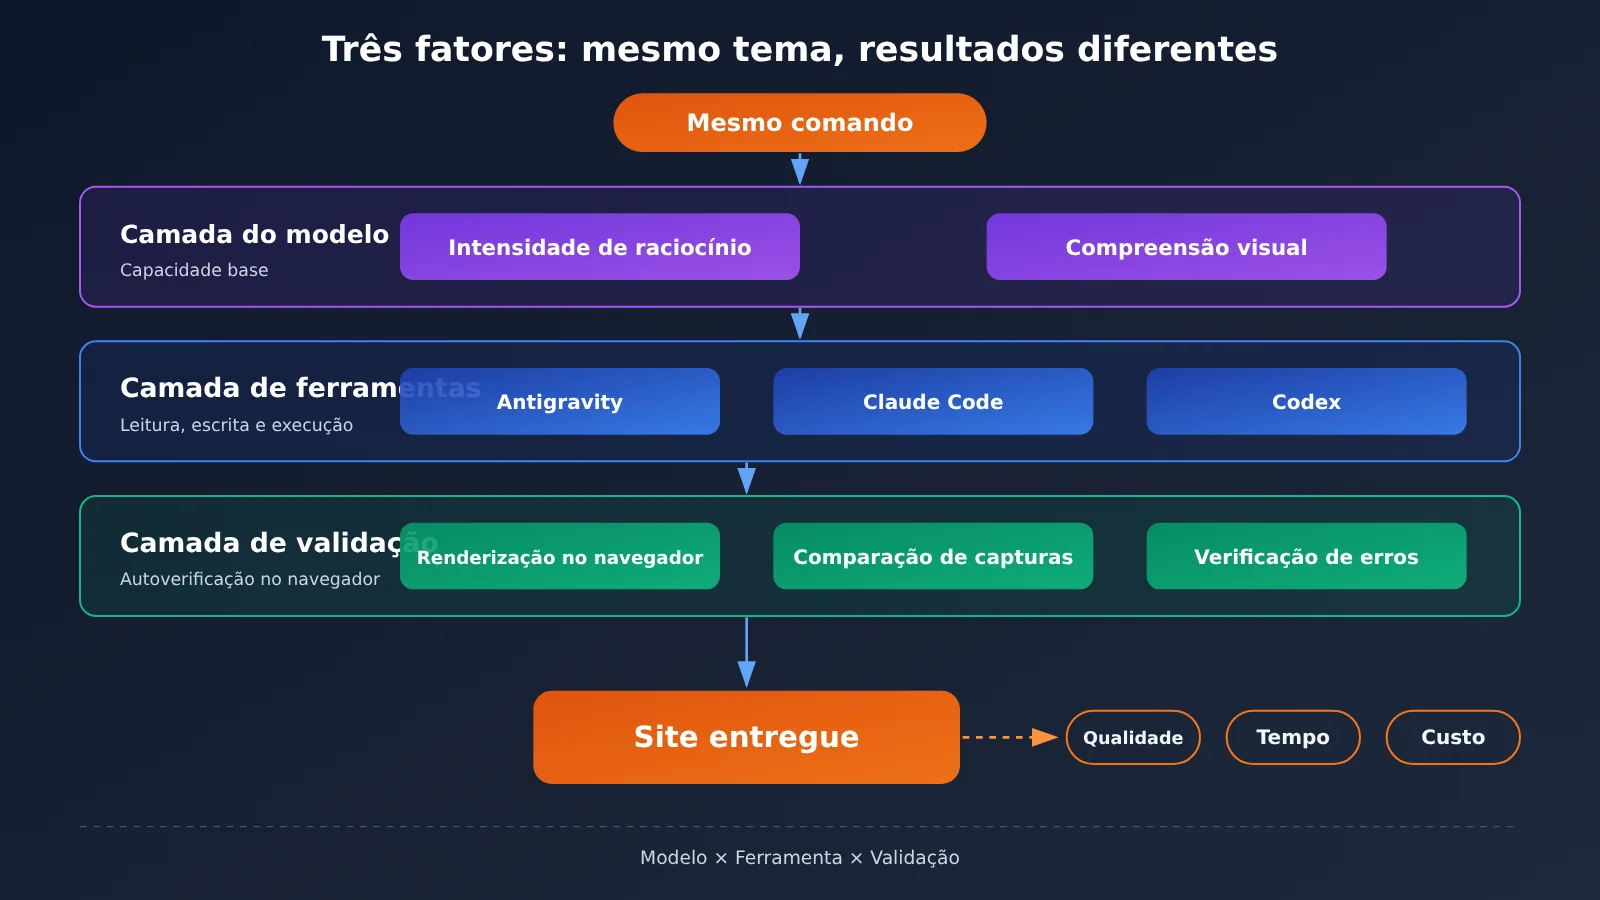
Pelos materiais oficiais, cada uma das três empresas enfatiza um aspecto diferente do desenvolvimento web:
- Google (Carbon + Antigravity): destaca design de front-end, verificação no navegador, efeitos dinâmicos, conteúdo 3D complexo e desenvolvimento com múltiplos agentes. Entre os casos oficiais estão o redesign da Google Merchandise Store com apenas dois comandos e uma experiência interativa em 3D feita com Three.js.
- OpenAI (Astra + Codex): na apresentação oficial do Astra, o foco é a capacidade de desenvolver sites, aplicativos e jogos, além de um fluxo de trabalho que roda verificações de qualidade do front-end depois da geração.
- Anthropic (Opus + Claude Code): os materiais oficiais não trazem uma comparação com o mesmo problema. Mas, num teste de terceiros feito pela Proofyard/Woofocus em 24 de outubro de 2026, o Opus 5.5 fez o primeiro design e as revisões da página inicial de um estúdio de móveis, ao custo de US$ 4,34 pelo preço da API. Esse teste não é uma comparação direta com o Carbon e o Astra deste artigo.
Como interpretar os dados de ranking de Carbon, Opus e Astra
Além do teste individual, vale olhar os rankings que consolidam várias tarefas. Todos os dados da tabela abaixo trazem a data de coleta. As pontuações Elo dependem do método de teste de cada plataforma, então não dá para comparar um ranking com outro diretamente.
| Ranking (data) | Tipo de teste | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| Arena WebDev (2026-11-10) | Votação em confrontos de desenvolvimento web | 1814 (Max) | 1764 (Max) | 1768 (High, classificação preliminar) |
| DesignArena, ranking geral Agentic (2026-11-11) | Front-end, full-stack, jogos, mobile, documentos de escritório etc. | 1440 (High), 1º lugar | 1385 (Max), 3º lugar | 1291, 7º lugar |
O Opus lidera nos dois rankings, o que bate com a ordem subjetiva que o autor deu neste teste de recriação. No ranking WebDev, o Carbon fica muito perto do Astra, mas cai de posição no ranking geral do DesignArena, que cobre mais tipos de tarefa. Isso mostra que “desenvolver uma página web única” e “tarefas complexas de design com agentes” são dimensões de capacidade diferentes, e na hora de escolher o modelo você precisa olhar para o tipo de tarefa que vai fazer.
Como retestar Carbon, Opus e Astra por conta própria usando a API
O teste isolado de outra pessoa serve apenas como ponto de partida. A referência mais confiável é rodar os modelos nas suas próprias tarefas. O exemplo abaixo usa uma interface compatível com a OpenAI para enviar o mesmo comando, em sequência, a vários modelos, registrando o tempo de resposta e o consumo de tokens. Vale lembrar que isso mede apenas a etapa em que o modelo gera o código diretamente. Não inclui as chamadas de ferramentas em várias rodadas nem a autoverificação no navegador que aparecem na avaliação original, feitas com Antigravity, Claude Code e Codex.
Exemplo mínimo
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface da APIYI compatível com OpenAI
)

resp = client.chat.completions.create(
    model="your-model-id",  # Use o nome real que aparece na lista de modelos da plataforma
    messages=[{"role": "user", "content": "输出一个单文件 HTML 食品品牌官网首屏,米白背景、居中悬浮产品罐头、酒红色弧形背景"}]
)
print(resp.choices[0].message.content[:500])
print(resp.usage)  # Confira os tokens de entrada e saída
Ver o script completo de reteste com vários modelos na mesma tarefa
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Uma única chave para invocar vários modelos
)

# Os IDs dos modelos seguem a lista de modelos da plataforma; a unidade de preço é "dólares / milhão de tokens", preencha conforme a página oficial de preços
MODELS = {
    "model-a": {"input_price": 0.0, "output_price": 0.0},
    "model-b": {"input_price": 0.0, "output_price": 0.0},
    "model-c": {"input_price": 0.0, "output_price": 0.0},
}

PROMPT = """请复刻一个食品品牌官网首屏,输出单文件 HTML:
1. 米白色背景,中央悬浮产品罐头,酒红色弧形背景,橙色环绕文字;
2. 顶部包含品牌标志、语言切换和菜单按钮;
3. 罐头支持鼠标拖动旋转,悬停时有缩放反馈;
4. 同时适配 1440x900 和 390x844 两种尺寸。
只输出完整代码。"""

def run(model: str, price: dict) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": PROMPT}],
    )
    elapsed = time.time() - start
    usage = resp.usage
    cost = (usage.prompt_tokens * price["input_price"]
            + usage.completion_tokens * price["output_price"]) / 1_000_000
    html = resp.choices[0].message.content
    with open(f"{model}.html", "w", encoding="utf-8") as f:
        f.write(html)
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "input_tokens": usage.prompt_tokens,
        "output_tokens": usage.completion_tokens,
        "api_equivalent_cost": round(cost, 4),
    }

if __name__ == "__main__":
    for name, price in MODELS.items():
        try:
            print(run(name, price))
        except Exception as e:
            print(name, "调用失败:", e)
Depois que o script rodar, você terá um arquivo HTML para cada modelo. Aí é só seguir a checklist de quatro passos da segunda rodada: abra cada arquivo no navegador, confira o layout, as interações e os erros no console, e depois cruze isso com o tempo de resposta e o custo equivalente para tomar sua decisão. Para reduzir a variação de uma execução para outra, o ideal é rodar cada modelo pelo menos três vezes.
🚀 Dica para começar rápido: ao fazer comparações com a mesma tarefa, o mais chato costuma ser pedir uma chave para cada provedor e adaptar SDKs diferentes. Uma saída prática é usar a APIYI (apiyi.com): com uma única chave API você invoca OpenAI, Claude, Gemini e outros modelos populares, tudo por uma interface compatível com OpenAI. Novos usuários ainda ganham créditos gratuitos para teste, o que ajuda bastante a validar o fluxo de comparação com uma amostra pequena antes de escalar.
Recomendações por cenário e dicas de decisão: Carbon, Opus e Astra
Juntando os dados deste teste com os dados dos rankings, dá para fazer uma triagem inicial de acordo com o seu objetivo de desenvolvimento. Na coluna “Base” da tabela abaixo, indiquei sempre que possível o tipo de fonte, para você avaliar quanto aquela informação realmente vale como referência.
| Objetivo de desenvolvimento | Prioridade | Base | Como validar |
|---|---|---|---|
| Custo de invocação sensível, com muita exploração e iteração | Gemini 4 Carbon | Menor custo equivalente em API neste teste (dados medidos) | Comparar o custo acumulado em várias rodadas de tarefas pequenas |
| Fidelidade visual, interações complexas e alto nível de acabamento | Claude Opus 5.5 | Melhor dos três na avaliação subjetiva do autor, e líder nos dois rankings | Conferir a fidelidade tela por tela e validar as interações |
| Velocidade de entrega e eficiência de execução | GPT-6 Astra | Menor tempo neste teste (dados medidos) | Cronometrar a mesma tarefa + validação de qualidade |
| Não sabe qual escolher e quer sondar primeiro | Reteste dos três com uma amostra pequena e o mesmo problema | Um único teste não basta para concluir nada | Comparar em lote pela interface unificada do APIYI (apiyi.com) |
Quando escolher o Carbon
- Fase de exploração de protótipos: você precisa testar várias propostas de página rapidamente, e um custo baixo por execução significa poder rodar mais rodadas.
- Projetos pessoais ou equipes com orçamento limitado: se a qualidade for aceitável, a diferença no gasto com invocações a longo prazo fica bem evidente.
- Desenvolvimento principal + revisão humana: use o Carbon para gerar a primeira versão e deixe uma pessoa (ou outro modelo) fazer a checagem final.
Quando escolher o Opus
- Sites institucionais de marca e landing pages de marketing: quando a exigência de fidelidade visual e de detalhes é alta, o custo do retrabalho pesa mais que o custo de invocação.
- Páginas com interações complexas: com muita exibição 3D, arrastar e soltar e animações guiadas por rolagem, o acabamento final conta mais.
Quando escolher o Astra
- Prazo de entrega apertado: você precisa de uma página completa e funcionando em pouco tempo.
- Foco no processo de QA de front-end: a documentação oficial dá ênfase à checagem de qualidade após a geração, o que combina com quem quer deixar a etapa de validação a cargo do fluxo de trabalho.
💡 Dica de escolha: este teste traz uma observação comparativa de um fluxo de trabalho real, e não um ranking absoluto. O critério final deve ser este: com a sua própria tarefa, qual solução realmente funcionou, e quanto custou em dinheiro e em tempo. Recomendamos fazer um reteste em pequena escala, usando o mesmo comando, pelo APIYI (apiyi.com) e só depois decidir qual será o seu modelo principal.
Perguntas frequentes (FAQ)
Q1: O que o teste do mesmo site com Carbon, Opus e Astra está comparando?
Compara a capacidade de três fluxos de trabalho “modelo + ferramenta de desenvolvimento” de replicar o site oficial da Agrumea Farm: estrutura da página, estilo visual, carrossel 3D das latas, rolagem e arrastar, animações de carregamento e de hover, transições de página e layout responsivo. O que se mede é a fidelidade da reprodução do design, não o senso estético original.
Q2: Por que o Carbon é o mais barato, mas ficou na última posição no ranking do autor da avaliação?
Custo e qualidade são dimensões independentes. O Carbon usa menos tokens de entrada e tem o menor custo equivalente, mas, pelas capturas de tela, as latas ficaram em proporção menor e alguns detalhes de texto ficaram mais fracos, então ele não pontua bem no critério de “fidelidade”. Barato não significa ruim: nessa tarefa de replicação, o autor simplesmente valorizou mais o acabamento do Opus.
Q3: Quando esses testes foram feitos? Os resultados podem ficar desatualizados?
A avaliação foi publicada em 11 de novembro de 2026. Os testes do Opus e do Astra foram concluídos em 6 de novembro, e o do Carbon foi feito entre 10 e 11 de novembro, coincidindo com a ampliação do acesso ao Carbon em 10 de novembro. Modelos e ferramentas evoluem rápido, então o ideal é tratar as conclusões como uma referência do momento atual.
Q4: Qual é a diferença entre o custo equivalente em API e o valor da assinatura?
O custo equivalente em API é uma estimativa baseada no uso de tokens e no preço unitário da API, refletindo o consumo real do modelo. Já a assinatura é o preço mensal fixo, calculado por cota e regras de renovação. Numa mesma tarefa, uma ferramenta de assinatura pode consumir só parte da cota, enquanto a cobrança por uso gera uma fatura direta. Na hora de escolher, faça as contas de acordo com a sua forma real de cobrança.
Q5: Como usar a API para comparar rapidamente o desempenho desses três tipos de modelo no desenvolvimento web?
Você pode seguir o script de reteste deste artigo:
1. Cadastre-se no APIYI (apiyi.com) e obtenha sua chave API e a cota gratuita de testes;
2. Defina `base_url` como `https://api.apiyi.com/v1` e confirme na lista de modelos da plataforma os nomes dos modelos que quer comparar;
3. Faça as invocações em sequência usando o mesmo comando, registre o tempo gasto e o uso de tokens e, depois, valide no navegador as páginas geradas.
Q6: Uma única chamada de API consegue reproduzir o resultado da avaliação original?
Não totalmente. A avaliação original foi executada no Antigravity, no Claude Code e no Codex, com várias rodadas de leitura e escrita de arquivos e autoverificação no navegador, e todas levaram mais de uma hora. Uma chamada única só testa a capacidade do modelo de gerar código diretamente, o que serve para uma triagem inicial. Para chegar perto do teste original, é preciso montar um fluxo de Agent com validação no navegador.
Q7: Quais são as limitações desses testes?
Há três principais: cada modelo foi executado apenas uma vez, então há margem para acaso; os três usaram ambientes de ferramentas e datas de teste diferentes, o que impede isolar o modelo em si; e o ranking vem da avaliação subjetiva do autor. Além disso, capturas de tela estáticas não provam que as interações foram totalmente implementadas. Por isso, o teste serve como caso de referência, não como um ranking geral.
Carbon, Opus e Astra: Principais pontos (Key Takeaways)
- Natureza do teste: a mesma tarefa de recriar um site oficial foi executada uma vez em cada um dos três fluxos de trabalho, uma observação comparativa em cenário real.
- Fidelidade de design: o autor aprovou mais o Opus, depois o Astra, e deixou o Carbon em último.
- Velocidade: o Astra foi o mais rápido, com 68 minutos, cerca de metade do tempo do Opus.
- Custo: o custo equivalente do Carbon foi de US$ 10,86, cerca de 18% do Opus e 12% do Astra.
- Estrutura de custo: no desenvolvimento com Agents, a maior parte é Token de entrada, então o preço unitário e as regras de cache também pesam na fatura.
- Referência de rankings: o Opus lidera tanto no Arena WebDev quanto no ranking geral do DesignArena, mas cada ranking usa critérios diferentes.
- Como começar: use uma única chave no APIYI (apiyi.com) para refazer o mesmo teste em pequena escala e só então definir o modelo principal.
Resumo
Na comparação entre Carbon, Opus e Astra criando o mesmo site, há três conclusões principais:
- Resultado: nesta tarefa de recriação, o trabalho do Opus recebeu a melhor avaliação do autor do teste, com o produto principal e a hierarquia visual mais bem destacados.
- Velocidade: o Astra terminou a tarefa em apenas 68 minutos, o que combina com projetos de prazo apertado.
- Custo: o custo equivalente em API do Carbon ficou bem abaixo dos outros dois, ótimo para iterações frequentes e cenários com orçamento limitado.
Os três modelos já conseguem entregar um desenvolvimento web de alta qualidade. A diferença está no equilíbrio entre fidelidade visual, implementação das interações, tempo gasto e custo. Em vez de perguntar qual modelo é o melhor de todos, vale mais a pena definir seu objetivo de desenvolvimento e rodar a mesma tarefa na prática. Recomendamos usar o APIYI (apiyi.com) para testar vários modelos por uma interface unificada e escolher com base no que realmente funcionou e no quanto você gastou.
📚 Referências
- Gemini 4 Carbon: No-Hype Full Review & Testing: Pat Simmons / AI for Mortals, avaliação com o mesmo desafio de recriar um site, 11/11/2026
- Link:
aiformortals.co/blog/gemini-4-carbon-review -
Observação: principal fonte dos dados deste artigo sobre configuração dos testes, tempo gasto, tokens e custo equivalente em API
-
Três páginas com os projetos recriados: trabalhos públicos do Carbon, do Opus 5.5 e do Astra
- Links:
aiformortals.co/builds/agrumea-clone-gemini-4-carbon,aiformortals.co/builds/agrumea-clone-opus-5-5,aiformortals.co/builds/agrumea-clone-gpt-6-astra -
Observação: dá para abrir no navegador e conferir as interações por conta própria
-
Site oficial da Agrumea Farm: o site original usado como alvo do teste
- Link:
agrumeafarm.it/en -
Observação: serve para comparar o quanto cada recriação ficou fiel ao original
-
Ranking Arena WebDev: ranking de votação em batalhas de desenvolvimento web
- Link:
arena.ai/leaderboard/code/webdev -
Observação: este artigo cita os dados de 10/11/2026
-
Ranking DesignArena: ranking geral de design com agentes
- Link:
designarena.ai/leaderboard -
Observação: este artigo cita os dados de 11/11/2026, que cobrem vários tipos de tarefas de design
-
Blog oficial do Google: anúncio da disponibilidade do Gemini 4 Carbon
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ -
Observação: posicionamento oficial do Carbon em design de front-end e verificação no navegador
-
Apresentação oficial da OpenAI: GPT-6 Astra
- Link:
openai.com/index/gpt-6-astra/ -
Observação: descreve os fluxos do Astra para desenvolvimento web e QA de front-end
-
Teste da Woofocus: comparação de diferentes modelos Claude em design web, 24/10/2026
- Link:
app.woofocus.com/blog/best-claude-model-for-web-design - Observação: referência complementar sobre o Opus 5.5 em tarefas de design e de edição; não é uma comparação direta entre os três modelos
Autor: equipe técnica da APIYI
Troca de ideias técnicas: fale com a gente na página inicial do site da APIYI; mais materiais de integração estão na central de documentação em docs.apiyi.com