Note de l’auteur : Alphabet indique que les API de ses modèles propriétaires traitent près de 32 milliards de tokens par minute. Cet article compare Gemini 4 Argon, 3.8 Flash et 3.5 Flash-Lite sous trois angles : les tarifs officiels, les évaluations indépendantes et les simulations de coûts. L’objectif : calculer le « coût total par tâche réussie ».
Le 28 octobre 2026, lors de la présentation des résultats du troisième trimestre d’Alphabet, son PDG Sundar Pichai a annoncé que les API des modèles propriétaires de l’entreprise traitaient actuellement près de 32 milliards de tokens par minute, en hausse de plus de 400 % sur un an. Ce chiffre reflète l’utilisation globale de l’API Gemini par les développeurs et les entreprises : il ne correspond pas aux performances d’un modèle en particulier.
Ce n’est pas un énième article qui recommande systématiquement le modèle le plus puissant. Quand le volume d’appels augmente, les questions de coût et de choix du modèle prennent beaucoup plus d’importance. Choisir une gamme inadaptée peut multiplier la facture mensuelle ou, si le modèle manque de capacités, obliger à réessayer plusieurs fois et finir par coûter plus cher.
Ce que vous allez en tirer : à la fin de cet article, vous comprendrez les différences entre les trois modèles Gemini Argon, Flash et Flash-Lite en matière de capacités, de prix, de vitesse et de cas d’usage. Vous y trouverez aussi une méthode de test directement applicable à votre activité pour faire un premier choix.
Forte hausse des appels à l’API Gemini : l’essentiel en bref
| Information | Détail |
|---|---|
| Date de publication | 28 octobre 2026 (résultats d’Alphabet pour le 3e trimestre 2026) |
| Annonceur | Sundar Pichai, PDG d’Alphabet |
| Chiffres clés | L’API des modèles propriétaires traite près de 32 milliards de tokens par minute, soit environ 40 % de plus que le chiffre communiqué au trimestre précédent et plus de quatre fois le niveau de l’année précédente |
| Principaux modèles API actuels | Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite |
| Public concerné | Tous les développeurs et toutes les entreprises qui créent des applications avec la Gemini Developer API |
Que signifient 32 milliards de tokens par minute pour les développeurs utilisant l’API Gemini ?
Cette forte hausse montre que les modèles sont désormais utilisés à grande échelle en production. Mais cela ne veut pas dire que chaque projet doit utiliser le modèle phare le plus cher. Pour faire son choix, il faut au minimum tenir compte de la complexité des tâches, de la qualité attendue, du volume de requêtes, de la rapidité des réponses, de la consommation de tokens, de la tolérance aux erreurs du projet, du besoin éventuel d’un contexte long et d’appels d’outils, ainsi que des futures variations de prix.
À noter : dans cet article, Flash désigne Gemini 3.8 Flash et Flash-Lite désigne Gemini 3.5 Flash-Lite. Ne les confondez pas avec l’ancienne gamme Gemini 2.5 Flash. Par ailleurs, même si le volume d’appels mondial est très élevé, les développeurs individuels restent soumis à des quotas. Nous reviendrons sur les limites d’appels plus loin.
Positionnement des trois modèles Gemini : Argon, Flash et Flash-Lite
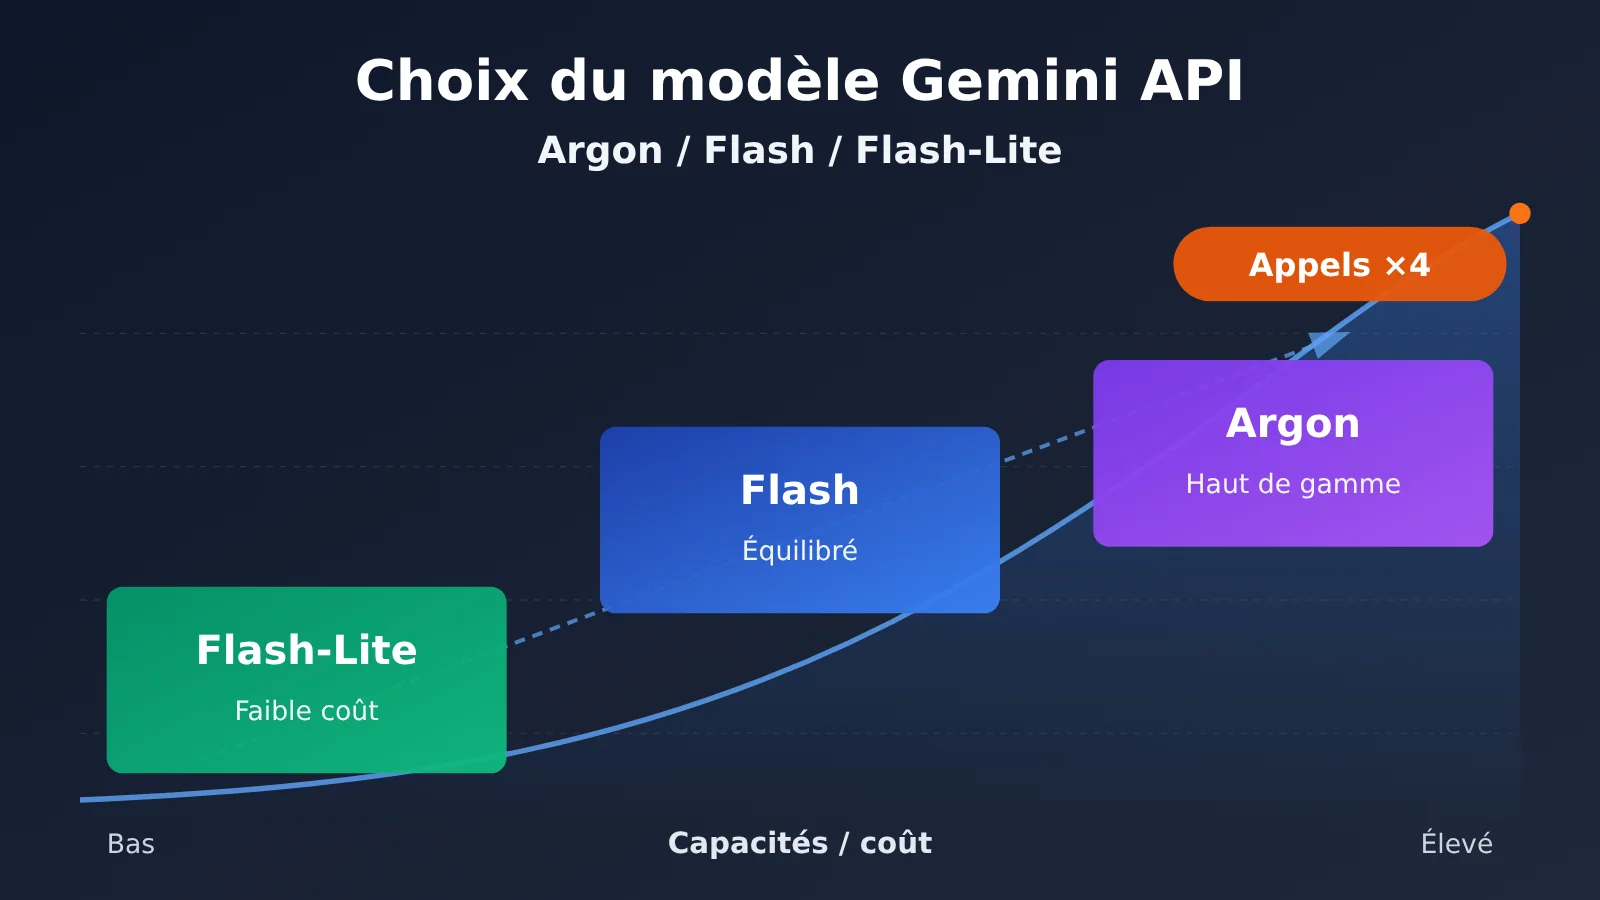
Google propose actuellement trois niveaux de modèles pour répondre à différents besoins en matière de coût et de capacités. Le tableau ci-dessous s’appuie sur les pages officielles des spécifications :
| Critère | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| ID API | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| Positionnement officiel | Modèle phare de raisonnement | Équilibre entre efficacité et capacités | Faible latence, faible coût et débit élevé |
| Contexte | Environ 1 million de tokens | 1048576 tokens en entrée | 1048576 tokens en entrée |
| Limite de sortie par défaut | 65536 tokens (extensible grâce à un mécanisme de sortie longue) | 65536 tokens | 65536 tokens |
| Niveau de réflexion | low / medium / high, medium par défaut | low / medium / high, medium par défaut | minimal / low / medium / high, minimal par défaut |
| Outils disponibles | Appel de fonctions, sorties structurées, Search Grounding, exécution de code | Appel de fonctions, sorties structurées, exécution de code, recherche dans les fichiers, Search Grounding | Sorties structurées, appel de fonctions, mise en cache |
| Modalités d’entrée | Texte, images, audio, vidéo, PDF | Texte, images, audio, vidéo, PDF | Texte, images, audio, vidéo, PDF |
| Offre API gratuite | Non disponible | Offre gratuite limitée | Offre gratuite limitée |
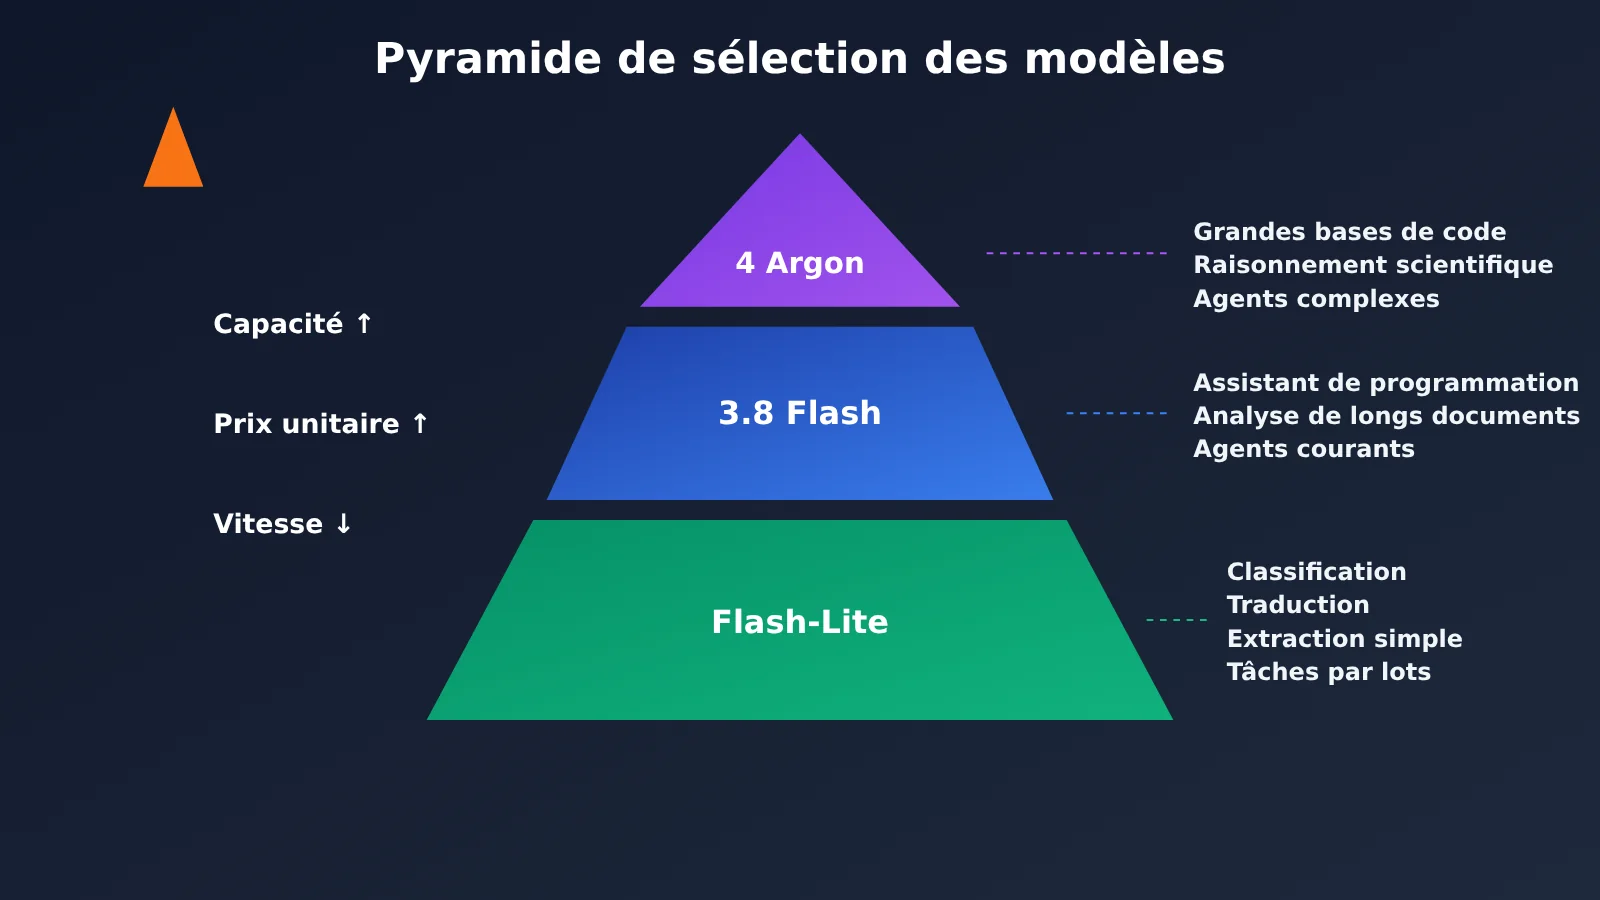
Les limites des trois modèles Gemini
Argon a été officiellement lancé le 13 octobre 2026. Il vise principalement l’ingénierie logicielle complexe, le raisonnement mathématique et scientifique, les agents autonomes à plusieurs étapes et la génération de sorties longues. Cette dernière nécessite un mécanisme et une configuration d’exécution spécifiques : chaque requête ne peut pas directement renvoyer 1 million de tokens.
3.8 Flash possède lui aussi des capacités de raisonnement : ce n’est pas une « version bon marché incapable de réfléchir ». Il convient aux assistants de programmation courants, à l’analyse de documents longs, à la rédaction de contenu et aux flux de travail d’agents classiques. Lancé le 21 juillet 2026, 3.5 Flash-Lite est optimisé pour la classification, la traduction, l’extraction simple, l’analyse de documents et les sous-tâches simples au sein d’un agent. Il peut aussi traiter certaines tâches de programmation et de raisonnement. La différence avec les modèles haut de gamme tient surtout aux capacités et à la stabilité sur les tâches complexes, ainsi qu’au rapport coût-bénéfice.
Prix officiels de l’API Gemini : les niveaux de coût d’Argon, Flash et Flash-Lite
Voici les tarifs officiels du niveau payant standard de Gemini Developer API, en dollars par million de tokens. Ils ne comprennent pas les majorations des plateformes tierces, les contrats d’entreprise ni les frais d’appel aux outils :
| Modèle | Entrée | Sortie | Entrée avec cache utilisé | Période de validité |
|---|---|---|---|---|
| Gemini 4 Argon (actuel) | $2.00 | $10.00 | $0.10 | Jusqu’au 2026-11-30 |
| Gemini 4 Argon (après ajustement) | $4.00 | $20.00 | $0.20 | À partir du 2026-12-01 |
| Gemini 3.8 Flash (actuel) | $0.75 | $3.75 | $0.075 | Jusqu’au 2026-12-31 |
| Gemini 3.8 Flash (après ajustement) | $1.50 | $7.50 | $0.15 | À partir du 2027-01-01 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | Aucune date de doublement annoncée |
Aux tarifs actuels, le prix d’entrée d’Argon est environ 2,67 fois supérieur à celui de Flash, celui de Flash est 2,5 fois supérieur à celui de Flash-Lite, et le prix de sortie d’Argon est quatre fois supérieur à celui de Flash-Lite. Argon et Flash bénéficient actuellement de tarifs promotionnels, qui prennent fin respectivement le 30 novembre et le 31 décembre 2026. Leurs tarifs doubleront ensuite. Pour établir le budget annuel d’un projet à long terme, il faut donc utiliser les tarifs ajustés.
Un autre détail facile à manquer : Google facture les tokens de réflexion internes du modèle comme des tokens de sortie. La facture ne dépend donc pas uniquement de la longueur de la réponse visible par l’utilisateur : un niveau de réflexion élevé peut faire grimper nettement les frais de sortie. Si votre tâche ne nécessite pas de réponse en temps réel, vous pouvez utiliser la Batch API : les tarifs d’entrée et de sortie des trois modèles sont 50 % moins élevés que les tarifs standards. En revanche, le mode d’exécution et les limites de file d’attente diffèrent de ceux des requêtes en temps réel.
Tests indépendants et comparaison des vitesses des trois modèles Gemini
Les données ci-dessous proviennent de la plateforme d’évaluation indépendante Artificial Analysis. Elles utilisent toutes l’Intelligence Index v5.0, sans mélange avec les scores de l’ancienne version v4.x :
| Indicateur | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| Indice de capacités globales v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78 % | 60 % | 25 % |
| Terminal-Bench 4.0 | 57 % | 20 % | 1 % |
| FrontierCode 2.0 | 26 % | 19 % | 6 % |
| Vitesse de génération observée | Un peu plus de 80 jetons/s | Environ 120 à 140 jetons/s | Un peu plus de 400 jetons/s |
| Accès aux modèles | API officielle Google, APIYI apiyi.com | API officielle Google, APIYI | API officielle Google, APIYI |
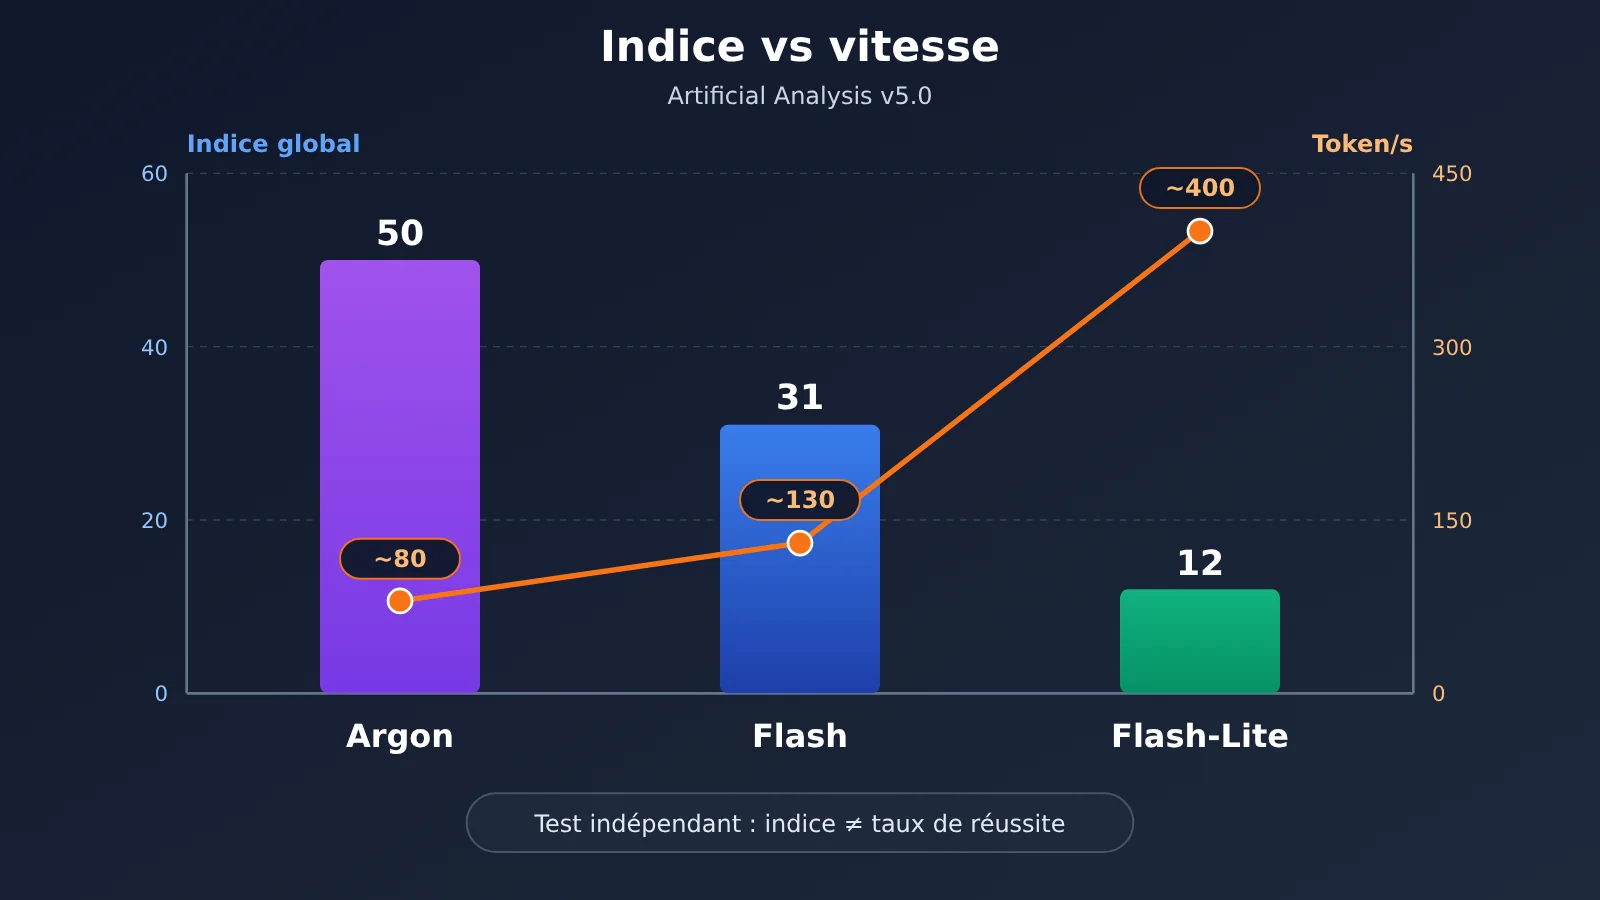
Pour bien interpréter ces données, trois points sont à garder en tête :
- L’indice n’est pas un taux de réussite : 50, 31 et 12 sont des scores propres au système d’évaluation. Un score de 50 ne signifie pas que le modèle donne 50 % de bonnes réponses.
- Les écarts sont nets sur les tâches complexes : dans les tests de programmation complexe et d’automatisation, Argon est le plus performant, Flash se situe au milieu et Flash-Lite est en retrait. Cela ne prouve pas pour autant qu’Argon soit meilleur pour chaque tâche simple : les trois modèles peuvent suffire pour de la classification ou de la mise en forme.
- La vitesse ne permet pas de déduire directement la durée : le débit varie selon l’état du service. La durée réelle dépend aussi du temps de réflexion, de la latence avant le premier jeton, des appels d’outils, de l’attente en file et des fluctuations du réseau.
💡 À propos de la comparaison : les scores donnent seulement une idée générale des écarts de capacité entre les modèles. Ce sont les résultats sur vos propres cas d’usage qui comptent. Avec APIYI apiyi.com, vous pouvez utiliser une même clé API pour passer d’un modèle Gemini à l’autre et refaire la comparaison sur vos propres échantillons.
Simulation des coûts de l’API Gemini : quelle différence de facture entre Argon, Flash et Flash-Lite ?
Voici des exemples théoriques, et non des factures réelles. On suppose que les tokens de sortie incluent tous les tokens de raisonnement et que les frais de cache, d’outils de recherche et de nouvelles tentatives ne sont pas pris en compte. Tous les calculs utilisent les tarifs standard d’octobre 2026 :
| Hypothèse | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A : 1 000 requêtes par jour, chacune avec 5 000 tokens en entrée et 1 000 en sortie (coût quotidien) | $20.00 | $7.50 | $4.00 |
| A : même utilisation pendant 30 jours consécutifs | Environ $600 | Environ $225 | Environ $120 |
| B : classification de 100 000 éléments, avec 1 000 tokens en entrée et 200 en sortie par élément | $400 | $150 | $80 |
| B avec la Batch API (tarif unitaire réduit de moitié) | Environ $200 | Environ $75 | Environ $40 |
Le scénario B montre uniquement la différence de tarif à volume de tokens égal. En pratique, le nombre de tokens de raisonnement, la longueur des réponses et le nombre de nouvelles tentatives varient selon le modèle. On ne peut donc pas supposer que $80 dépensés avec Flash-Lite donneront la même qualité que $400 dépensés avec Argon. De plus, à la fin des tarifs promotionnels d’Argon et de Flash, les montants de ces deux colonnes doubleront.
Analyse des impacts : pourquoi le prix par token ne suffit pas à évaluer Gemini API
Pour les développeurs
Le « prix » d’un modèle comporte au moins trois niveaux. D’abord, le prix unitaire des tokens. Ensuite, le nombre de tokens réellement consommés par une tâche : entrée, sortie, raisonnement, répétition du contexte et nouvelles tentatives. Enfin, le coût total pour mener une tâche à bien, en tenant compte du taux de réussite, de la vérification humaine, des échecs, du temps nécessaire et des pertes commerciales dues aux erreurs.
Si Flash-Lite répond déjà aux exigences métier pour une classification simple, passer à Argon revient à gaspiller des ressources. À l’inverse, si Flash-Lite échoue à plusieurs reprises sur une tâche de programmation complexe, mais qu’Argon la termine avec moins de tentatives, ce dernier peut offrir un meilleur rapport coût-efficacité. Il s’agit d’un raisonnement conditionnel pour guider le choix d’un modèle, pas d’une conclusion statistique sur les taux de réussite réels des trois modèles.
Les retours de la communauté illustrent aussi ce point. Un utilisateur de Reddit a utilisé Argon High dans l’environnement OpenCode pour faire de la rétro-ingénierie : une seule exécution a consommé environ 900 000 tokens, sans pour autant terminer la tâche. Ce test personnel ne représente pas une moyenne du secteur, mais il rappelle qu’un workflow d’agent complexe peut consommer beaucoup de tokens sans garantie de succès. D’autres utilisateurs indiquent qu’Argon atteint rapidement les plafonds d’utilisation dans les abonnements grand public. Il s’agit toutefois d’une expérience liée aux abonnements Gemini, qui ne peut pas être assimilée aux limites de la Developer API.
Pour le secteur
- L’architecture à plusieurs niveaux de modèles devient la norme : Google Cloud a déjà présenté publiquement l’orchestration multimodèle et Smart Routing, qui réduisent les coûts des entreprises en répartissant les tâches entre différents modèles.
- Le critère d’évaluation passe du « prix unitaire » au « coût par tâche réussie » : plus le volume d’appels augmente, plus il est important de choisir les modèles à partir de jeux de tests métier plutôt que de classements.
- Les cycles budgétaires se raccourcissent : les tarifs promotionnels arrivant progressivement à échéance, les équipes doivent revoir chaque trimestre leur combinaison de modèles et leur budget.
Comment choisir entre Argon, Flash et Flash-Lite ?
Les recommandations ci-dessous dépendent du contexte : aucun modèle n’est le meilleur dans tous les cas.
- Classification de données à grande échelle (par exemple, répartir 100 000 actualités sur l’IA entre les catégories publications, mises à jour, prix et politiques) : commencez par Flash-Lite, à condition que les tests sur échantillon montrent une précision et un taux de conformité du format suffisants. Sinon, passez à 3.8 Flash.
- Structuration de documents volumineux (transformer des rapports financiers ou des documents techniques en tableaux de faits) : commencez par 3.8 Flash. Il comprend mieux les contenus que Lite, tout en coûtant moins cher qu’Argon. Faites appel à Argon de façon ciblée pour repérer les contradictions entre documents ou résoudre des problèmes de raisonnement difficiles.
- Projets de code complexes (compréhension d’une grande base de code, refactorisation en plusieurs étapes) : commencez par Argon. Son positionnement officiel et ses résultats aux benchmarks indépendants de programmation sont plus solides, mais il faut quand même vérifier son taux de réussite, l’exécution des outils et son coût sur vos projets réels.
- Traduction simple en gros volumes : commencez par Flash-Lite. Pour les contenus très spécialisés, notamment juridiques ou médicaux, ajoutez impérativement un contrôle qualité. Un prix bas ne justifie pas une utilisation sans relecture.
- Agents d’entreprise : mieux vaut ne pas se limiter à un seul modèle. Flash-Lite peut gérer la classification, l’extraction et la normalisation des formats ; 3.8 Flash, la planification courante et les workflows en plusieurs étapes ; Argon, les raisonnements difficiles et la résolution de problèmes complexes. Il s’agit d’une stratégie d’ingénierie recommandée, pas d’une obligation imposée par Google.
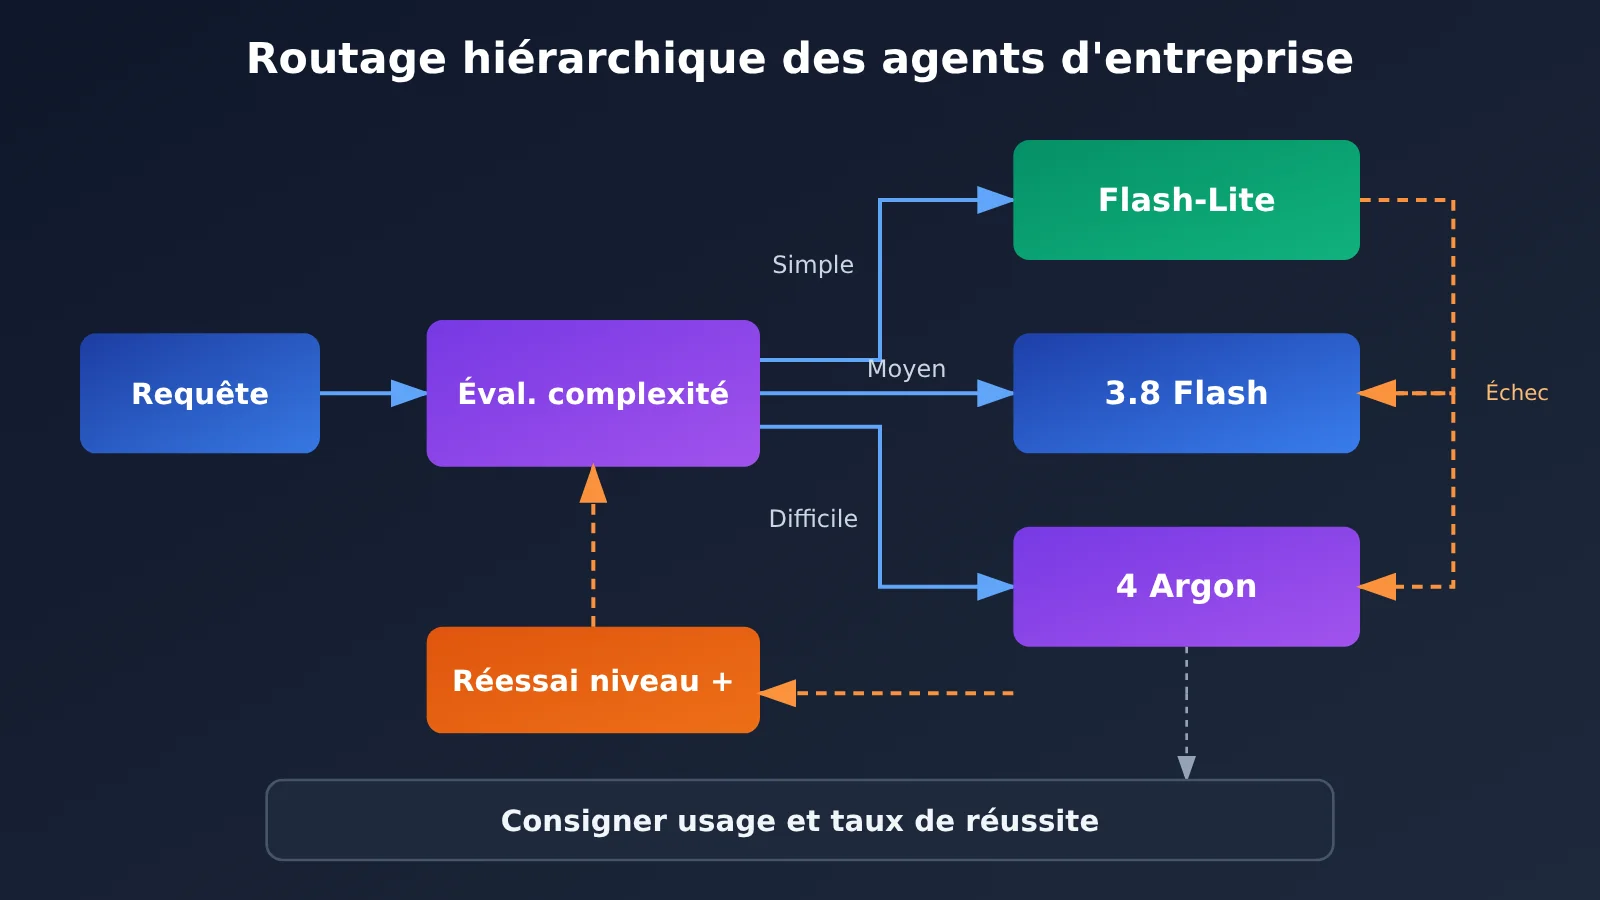
🎯 Conseil de choix : le routage par niveaux repose sur la possibilité de passer d’un modèle à l’autre à faible coût. APIYI apiyi.com propose une interface compatible avec OpenAI : il suffit de modifier le paramètre
modelpour changer de niveau, ce qui facilite les premiers tests comparatifs à petite échelle.
Prise en main rapide : appeler les trois modèles Gemini via l’API
Exemple minimal
Le SDK OpenAI suffit : modifiez model pour passer d’Argon à Flash ou Flash-Lite.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
Voir le code complet de routage par paliers et d’estimation des coûts
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 Pour commencer : récupérez d’abord les crédits d’essai gratuits pour les nouveaux utilisateurs sur APIYI apiyi.com. Comparez ensuite les trois paliers de modèles sur 100 à 300 exemples représentatifs avant de choisir celui à utiliser par défaut en production. Attention : les tarifs, les crédits et la prise en charge du cache sur les plateformes tierces peuvent différer de ceux de l’accès direct à Google. Consultez les conditions de la plateforme utilisée.
Points à vérifier avant la mise en production de Gemini API
- Limites d’utilisation : Gemini API applique des limites en RPM, TPM et RPD au niveau du projet, et non de chaque clé API. Le dépassement de l’une de ces limites entraîne une erreur.
- Tokens de raisonnement : le prix des tokens de sortie inclut les tokens de raisonnement. Consultez les métadonnées d’utilisation plutôt que d’estimer le coût d’après la longueur de la réponse visible.
- Cache : Argon prend uniquement en charge le cache implicite, pas le cache explicite. Flash et Flash-Lite prennent en charge le cache, dont la facturation dépend de la configuration.
- Données de l’offre gratuite : les données de l’offre gratuite peuvent être utilisées pour améliorer les produits. N’y envoyez pas de données sensibles d’entreprise et vérifiez les conditions d’utilisation avant la mise en production.
- Indicateurs de test : consignez le taux de réussite, l’exactitude factuelle, le taux de conformité à la structure attendue, le nombre d’hallucinations, la latence moyenne et en fin de distribution, les tokens réellement utilisés, le nombre de tentatives et le coût par tâche réussie. Les niveaux de raisonnement par défaut varient : précisez donc la configuration réellement utilisée dans vos rapports.
FAQ : comment choisir son modèle Gemini API
Q1 : Que sont Gemini 4 Argon, 3.8 Flash et 3.5 Flash-Lite ?
Ce sont les trois principales gammes de modèles actuellement proposées par Google dans Gemini API : Argon est le modèle phare pour le raisonnement, 3.8 Flash offre un équilibre entre capacités et efficacité, et 3.5 Flash-Lite privilégie une faible latence, un faible coût et un débit élevé. Les trois acceptent une fenêtre de contexte d’environ un million de tokens en entrée et produisent du texte en sortie.
Q2 : Quand les tarifs promotionnels d’Argon et de Flash prennent-ils fin ?
Les tarifs actuels d’Argon sont valables jusqu’au 30 novembre 2026. À partir du 1er décembre, les prix unitaires des tokens en entrée, en sortie et en cache doubleront. Pour 3.8 Flash, les tarifs actuels sont valables jusqu’au 31 décembre 2026 et doubleront le 1er janvier 2027. Pour Flash-Lite, Google n’a pour l’instant annoncé aucune date de doublement comparable.
Q3 : Un score de 50 chez Artificial Analysis signifie-t-il que le modèle répond correctement dans 50 % des cas ?
Non. Les scores de 50, 31 et 12 sont des scores composites de l’Intelligence Index v5.0, pas des pourcentages de réponses correctes. Ils permettent de comparer les modèles dans les grandes lignes, mais ne se convertissent pas directement en taux de réussite pour votre activité.
Q4 : Comment comparer les trois modèles Gemini à moindre coût ?
Utilisez une interface compatible avec OpenAI qui prend en charge plusieurs modèles. Après vous être inscrit sur APIYI apiyi.com et avoir obtenu une clé API et un crédit gratuit, remplacez successivement le `model` de l’exemple de cet article par chacun des trois identifiants API. Il suffit ensuite de mesurer l’utilisation et le taux de réussite sur le même jeu d’échantillons.
Q5 : Sur Reddit, certains disent qu’Argon épuise le quota après quelques échanges. Est-ce aussi le cas avec l’API ?
Ce retour concerne l’abonnement grand public à Gemini, dont les limites ne sont pas celles de l’API développeur. Les quotas de l’API dépendent du niveau de facturation, de l’état du projet et du modèle, et sont calculés en RPM, TPM et RPD. Si vous passez par une plateforme d’agrégation, ses propres règles de quota s’appliquent également. Vous pouvez consulter les modèles disponibles et leurs modes de facturation dans la console d’APIYI apiyi.com.
Q6 : Quelles sont les limites connues de chacun des trois modèles ?
Argon est le plus cher et le plus lent. Il n’est pas proposé dans l’offre gratuite standard et peut consommer beaucoup de tokens sur les tâches complexes d’agents. 3.8 Flash accuse un retard notable sur Argon dans les tests les plus difficiles liés au terminal et à la programmation. Flash-Lite est moins performant pour les tâches complexes de programmation et d’automatisation ; ses traductions dans des domaines spécialisés nécessitent une révision humaine.
Choisir une API Gemini : les points clés
- Contexte : les API des modèles propriétaires de Google traitent près de 32 milliards de tokens par minute. Ce chiffre représente la croissance globale, pas celle d’un seul modèle.
- Trois positionnements : Argon prend en charge le raisonnement complexe, 3.8 Flash est le modèle polyvalent, et Flash-Lite traite les tâches légères à haut débit.
- Échelle de prix : les tarifs d’entrée actuels sont de 2 $ / 0,75 $ / 0,30 $. Ceux d’Argon et de Flash doubleront à la fin de leurs promotions.
- Interprétation des évaluations : les scores AA v5.0 de 50 / 31 / 12 sont des indices, pas des taux de réussite. Sur les tâches simples, l’écart peut être moins marqué.
- Coûts cachés : les tokens de raisonnement sont facturés comme tokens de sortie. Le cache, les nouvelles tentatives et les frais d’outils influencent aussi la facture finale.
- Pour commencer : APIYI apiyi.com permet de passer d’un modèle à l’autre avec une seule clé API et de les comparer sur un échantillon de 100 à 300 cas.
En résumé
L’explosion du volume d’appels à l’API Gemini montre que les grands modèles de langage sont désormais utilisés en production à grande échelle. Mais la question centrale reste la même : quel modèle choisir ?
- Répartir les tâches par niveau : testez d’abord Flash-Lite pour la classification et la traduction, 3.8 Flash pour la structuration de documents, et Argon pour le code complexe et les agents les plus exigeants.
- Examiner le coût par tâche réussie : l’objectif est d’optimiser le coût total de chaque tâche réussie, pas de trouver le tarif le plus bas par million de tokens.
- Surveiller la fin des promotions : le tarif promotionnel d’Argon prend fin le 30 novembre, celui de Flash le 31 décembre. Calculez votre budget sur la base des tarifs révisés.
Les développeurs n’ont pas besoin du modèle le plus puissant ou le moins cher en toute circonstance, mais d’une combinaison de modèles capable de réaliser les tâches métier de façon fiable, à un coût acceptable. Nous recommandons de commencer par comparer les trois modèles avec le crédit gratuit d’APIYI apiyi.com, puis de définir votre stratégie de routage en production.
📚 Sources
- Message du PDG sur les résultats d’Alphabet au troisième trimestre 2026 : source du chiffre de 32 milliards de tokens par minute
- Lien :
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Contenu : contexte de l’annonce et publication initiale des chiffres sur la croissance de l’utilisation de l’API
-
Tarifs officiels de l’API Gemini : tarifs standards, tarifs du cache et tarifs Batch des trois modèles
- Lien :
ai.google.dev/gemini-api/docs/pricing -
Contenu : date de fin des tarifs promotionnels et explications sur la facturation des tokens de réflexion
-
Documentation des modèles Gemini : Argon / 3.8 Flash / 3.5 Flash-Lite
- Lien :
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
Contenu : fenêtre de contexte, limite de sortie, niveaux de réflexion et capacités d’utilisation des outils
-
Comparaison de modèles par Artificial Analysis : évaluation indépendante v5.0
- Lien :
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
Contenu : indice global, benchmarks spécialisés et mesures de vitesse
-
Limites d’utilisation et mécanisme de réflexion de l’API Gemini : RPM/TPM/RPD et configuration de la réflexion
- Lien :
ai.google.dev/gemini-api/docs/rate-limits -
Contenu : règles relatives aux quotas et aux tokens de réflexion à consulter avant la mise en production
-
Orchestration multimodèle sur Google Cloud : Smart Routing et gestion des coûts des agents
- Lien :
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Contenu : approche officielle du routage par niveaux pour les entreprises
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel APIYI. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.