
Tests d’écriture GPT, Claude, Kimi : le verdict d’abord
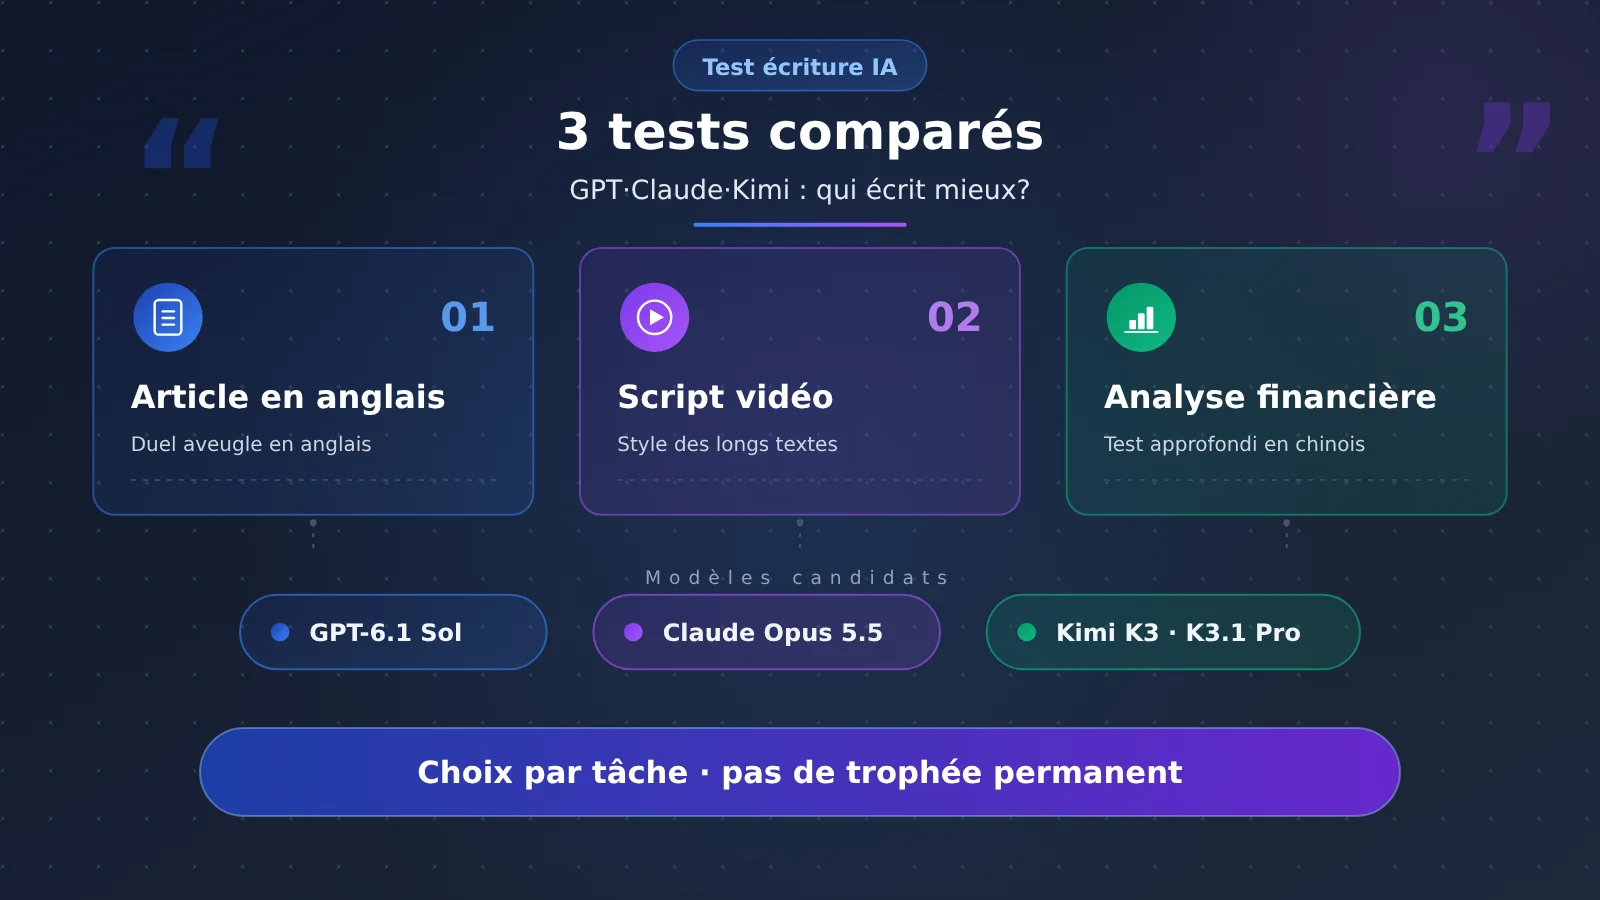
Pour un article en anglais, essayez d’abord GPT-6.1 Sol ; pour un long texte où le style compte, essayez d’abord Claude Opus 5.5 ; pour des explications de vulgarisation, Kimi K3 mérite sa place. Kimi K3.1 Pro affiche aussi de très bonnes performances globales en anglais, proche de GPT dans ToneBench.
Les trois tests portent sur des tâches, des langues et des méthodes d’évaluation différentes. La conclusion la plus utile : établir une liste de candidats, puis vérifier avec ses propres textes, plutôt que de décerner un trophée permanent à trois familles de modèles.
Conseil pour démarrer : vous pouvez appeler les modèles candidats via l’interface unifiée d’APIYI apiyi.com et comparer les premiers jets à partir du même dossier de documents. Les crédits d’essai gratuits pour les nouveaux utilisateurs dépendent des règles actuellement en vigueur sur la plateforme.
Tests d’écriture GPT, Claude, Kimi : que dira la suite ?
Cet article décompose successivement le classement de l’écriture en anglais, un test de longs scripts vidéo stylisés et un test réel d’articles financiers approfondis en chinois. Enfin, il présente le choix des scénarios, les étapes du test à l’aveugle et un exemple d’appel, en se concentrant sur la qualité des articles et le coût d’édition humaine.
Commençons par définir deux termes : le benchmark d’écriture est un test qui évalue les sorties selon une tâche donnée ; l’évaluation à l’aveugle consiste à comparer des textes en masquant l’identité du modèle. L’évaluation à l’aveugle peut être réalisée par un humain ou par un modèle : en lisant les résultats, il faut bien distinguer qui est le juge.
Test d’écriture GPT, Claude, Kimi n°1 : pour l’anglais, regardez GPT
AI Writing Benchmark est un projet d’écriture en anglais maintenu par Johannes Eva, qui déclare n’avoir reçu aucun paiement de la part des fournisseurs de modèles. Cet article reprend les résultats mis à jour le 11 novembre 2026 et consultés le 12 novembre.
Le projet couvre 115 modèles et enregistre 131,507 comparaisons publiques à l’aveugle. Il évalue l’écriture par comparaison de textes anonymisés, et présente séparément le classement des juges IA et celui des votes humains.
| Modèle | Score global en anglais | Base du résultat |
|---|---|---|
| GPT-6.1 Sol | 95.3 | 1er du classement général |
| Claude Opus 5.5 | 92.9 | 2e du classement général |
| Kimi K3.1 Pro | 91.9 | 3e du classement général |
Le score global agrège plusieurs types de tâches ; le score par catégorie de tâche ne reflète qu’un seul type de sujet. Dans les contenus de type article, blog et édition, GPT-6.1 Sol obtient un score de catégorie de 98.5, qu’il faut consigner séparément du score global de 95.3.
Ce sont des scores relatifs internes au benchmark. Le projet définit 50 comme la probabilité estimée d’une chance sur deux de battre le modèle moyen actuel de la langue et de la catégorie : les lecteurs doivent donc se concentrer sur la position concurrentielle, et non prendre le score pour une proportion de contenu publiable.
Autrement dit : si la tâche est un blog ou un article éditorial en anglais, GPT-6.1 Sol a de bonnes raisons d’entrer dans le premier tour de test. Pour les articles en chinois, il faut en revanche chercher des preuves côté chinois.
Un autre résultat mérite l’attention : Kimi K3 mène dans la catégorie explication et vulgarisation scientifique avec 94.9. Ici, c’est bien K3 qui gagne, tandis que la troisième place du classement général revient à K3.1 Pro : il faut conserver le nom de version en même temps que le score.
Test d’écriture GPT, Claude, Kimi, deuxième partie : la prose longue, avantage à Claude
ToneBench demande au modèle de lire un brief créatif, un dossier de recherche et un guide de style, puis de produire un script YouTube complet. Le modèle ne voit jamais le texte final du créateur original, et il ne peut ni naviguer sur le web ni appeler des outils externes.
Cet article s’appuie sur des données mises à jour le 10 novembre 2026. La tâche porte sur un script vidéo long destiné à un créateur précis ; les documents fournis n’énumèrent pas toutes les langues de la tâche, on l’interprète donc ici comme un scénario de script.
Le test couvre 87 modèles et 151 configurations ; chaque configuration réalise 10 tâches, et chaque tâche est générée indépendamment 5 fois. Au total, 7 550 scripts ont été produits, et quatre évaluateurs IA ont signé 30 200 notations.
L’accent est mis en particulier sur la correspondance de style, autrement dit la proximité de ton, de rythme et de mode d’expression avec le créateur visé. La correspondance de style pèse 19 %, la profondeur du contenu, l’exactitude et la valeur 15 % ; la cohérence et la maîtrise de la longueur sont également notées.
Le tableau ci-dessous reprend le Writing Score de la meilleure configuration de chaque modèle, ainsi que le classement donné dans les données. Pour Claude, il s’agit de xhigh ; les données ne précisent pas le nom exact de la configuration de raisonnement des deux autres modèles, à compléter lors d’un nouveau test.
| Modèle | Classement | Writing Score | Coût estimé par script (test) |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Le Writing Score est l’indicateur qui résume la performance d’écriture dans ce test, tandis que le classement suit un barème Elo. Donc, quand Kimi affiche 0.1 point de plus mais une place de moins, il faut y voir deux performances très proches.
Claude arrive en tête sur ce jeu de résultats, avec un coût estimé par test d’environ 4.2 fois celui de GPT. Il s’agit de l’estimation de coût de ToneBench : on ne peut pas la transposer directement en tarif d’article sur d’autres plateformes.
Pour bien lire le classement, le plus simple est de mettre les tâches et l’évaluation dans le même cadre. Si vous refaites le test via APIYI apiyi.com, je conseille de garder la trace des configurations, puis de revenir au classement d’origine pour vérifier que la comparaison porte bien sur les mêmes mesures.
Les intervalles de confiance du premier et du deuxième de ToneBench se recoupent, et retirer ne serait-ce qu’un seul script de référence suffit à changer le leader. L’étude relève aussi une certaine préférence d’éditeur chez les évaluateurs ; mais une fois les évaluations unitaires exclues, Claude reste en tête.
Le jugement central : pour un texte long qui doit absorber des sources tout en gardant la voix du créateur, Claude mérite d’être essayé en priorité. Ce résultat aide à choisir des candidats ; l’ampleur de l’avantage demande encore à être validée sur vos propres scripts.
À noter également : le score Least Slop de GPT-6 Sol relève d’une autre version et d’un autre indicateur, il ne peut donc pas remplacer le Writing Score de GPT-6.1 Sol.
Test d’écriture GPT, Claude, Kimi, troisième volet : que regarder dans un article de fond en chinois ?
Le test d’OmniTools s’est déroulé du 26 octobre au 3 novembre 2026, sur des articles de fond économiques en chinois publiés par PANews. Il compare 10 modèles sur 26 articles.
| Modèle | Score AI en aveugle | Nombre d’articles testés | Score de naturel |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
Dans ce test, Claude obtient une note globale et un score de naturel plus élevés. Pour les articles de fond économiques en chinois, Claude Opus 5.5 est donc le candidat à essayer en priorité.
Mais l’échantillon est réduit, le nombre d’articles varie d’un modèle à l’autre, et surtout Kimi n’a pas participé. Ces données ne peuvent donc qu’enrichir les preuves concernant GPT et Claude sur des scénarios en chinois ; elles ne permettent pas d’établir un classement complet des trois modèles en chinois.
L’évaluation a été réalisée avec Claude Opus 5.5 et DeepSeek V4 Pro, selon une règle interdisant à un modèle de s’auto-évaluer. L’éditeur du test a un arrière-plan commercial dans les services de routage API : il faut garder cette information en tête à la lecture.
Les évaluations éditoriales constituent un autre type de relevé. Le taux d’adoption éditoriale de 100 % obtenu par Claude ne correspond qu’à 1 tour sur 1 : c’est un cas à observer, mais la confirmation d’une adoption sur la durée demandera encore davantage de manuscrits.
En une phrase : on trouve ici un signal positif sur la capacité de Claude à écrire des articles économiques de fond en chinois, et la portée des preuves se limite à ce scénario précis.
Tests d’écriture GPT, Claude, Kimi : choisir le candidat selon le scénario
En réunissant les trois résultats, on doit obtenir un tableau de sélection, et non une simple addition de scores. La langue de l’article, la tâche et le style visé déterminent quelles preuves vous concernent.
| Scénario d’écriture | Candidat prioritaire | Critère de sélection |
|---|---|---|
| Blogs en anglais, articles éditoriaux | GPT-6.1 Sol | En tête dans la catégorie articles en anglais |
| Scripts vidéo longs dans un style de créateur | Claude Opus 5.5 | Actuellement en tête sur ToneBench |
| Articles financiers approfondis en chinois | Claude Opus 5.5 | En tête lors d’un test sur un petit échantillon en chinois |
| Explications et vulgarisation en anglais | Kimi K3 | En tête dans les catégories explication et vulgarisation |
| Contenus longs pilotés par un dossier de sources | Test à l’aveugle commun aux trois | GPT et Kimi sont proches sur ToneBench |
| Plateforme de validation des appels | APIYI apiyi.com | Interface unifiée pour faciliter le changement de modèle |
Les tutoriels techniques en chinois, les présentations produit et autres scénarios du même genre ne sont pas entièrement couverts par les trois sources de preuves actuelles. L’approche la plus prudente consiste à tester les candidats en parallèle, pour voir lequel explique clairement la technique et rapporte les faits avec exactitude.
Tests d’écriture GPT, Claude, Kimi : comment faire sa propre comparaison ?
Je recommande de choisir un vrai sujet et de donner à chaque modèle exactement les mêmes documents, le même plan, la même longueur et les mêmes autorisations d’outils. Générez au moins trois fois avec chaque modèle, de façon indépendante, puis masquez le nom du modèle avant de soumettre le résultat à l’évaluation des éditeurs.
L’évaluation peut partir de cinq critères : exactitude des faits, exécution du plan, naturel de l’expression, clarté de la structure et valeur du contenu. Les pondérations dépendent des tâches de l’équipe, et il faut préciser qu’il s’agit de règles maison.
Enregistrez aussi le coût d’édition humaine : le travail nécessaire pour amener le texte à un état publiable. L’idéal est de noter en même temps le temps de modification, les paragraphes réécrits, les erreurs factuelles et le sort final du texte.
Conseil de configuration : chez APIYI apiyi.com, utiliser une seule clé API pour changer de modèle réduit le travail d’intégration répétitif. Pendant les tests, conservez la version du modèle, les paramètres et la consommation réelle de tokens, pour faciliter la reproduction.
Voici un exemple d’appel minimal. Placez le même dossier de sources réel dans brief, puis changez le nom du modèle pour générer un brouillon de comparaison ; la clé doit être fournie de manière sécurisée par l’environnement d’exécution.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
Ce code sert de point de départ ; pour un véritable test à l’aveugle, il faut aussi répéter les générations, présenter les résultats de façon anonyme et consigner la configuration. Si vous voulez vérifier le modèle leader dans la catégorie explication, il faut ajouter Kimi K3 en plus.
FAQ sur le test d’écriture GPT, Claude et Kimi
Dans le test d’écriture GPT, Claude et Kimi, quelle version de Kimi faut-il tester ?
Pour les contenus de vulgarisation, privilégiez Kimi K3 ; pour comparer le classement général de cet article avec les résultats de ToneBench, utilisez K3.1 Pro. Avant tout appel via APIYI apiyi.com, vérifiez la liste des modèles et le nom exact du modèle concerné, histoire d’éviter de mélanger les versions.
Dans le test d’écriture GPT, Claude et Kimi, comment comparer le coût réel ?
Comparez le « coût par article publiable » : le coût cumulé des appels, plus la charge de travail éditoriale. Lors des tests sur APIYI apiyi.com, notez l’usage réel et le nombre de tentatives, puis calculez d’après les tarifs du moment. C’est bien plus proche de la réalité de production que de regarder uniquement le coût du premier jet.
Conclusion du test d’écriture GPT, Claude et Kimi : choisir le modèle qui épargne le plus d’édition
Pour un article en anglais, commencez par GPT ; pour un long texte à fort style ou un article financier chinois approfondi, commencez par Claude ; pour de la vulgarisation, ajoutez Kimi. Ce sont des ordres de priorité pour des tâches précises, pas un classement définitif de toute une famille de modèles.
Je conseille de valider les résultats via APIYI apiyi.com avec le même dossier de matériel. Au final, choisissez celui qui mène le plus fidèlement la planification et qui laisse le plus de paragraphes exploitables — pour que l’éditeur n’ait pas à remettre une couche de relecture.
Références pour les tests d’écriture GPT, Claude et Kimi
-
AI Writing Benchmark : aiwritingbenchmark.com
Classement général et classements par catégorie en anglais, selon la mise à jour du 11 novembre 2026. -
Towards AI ToneBench : benchmark.towardsai.com/models/
Tests de scripts vidéo, classement des modèles, configuration et estimation des coûts, d’après les données du 10 novembre 2026. -
Test approfondi d’écriture longue d’OmniTools : omnitools.ai/evals/longform-writing
Test d’articles financiers approfondis en chinois mené par PANews, sur la période du 26 octobre au 3 novembre 2026.
Auteur : équipe de contenu technique APIYI. N’hésitez pas à échanger avec nous via APIYI apiyi.com sur la configuration des modèles, les méthodes de test à l’aveugle et les bonnes pratiques éditoriales.


