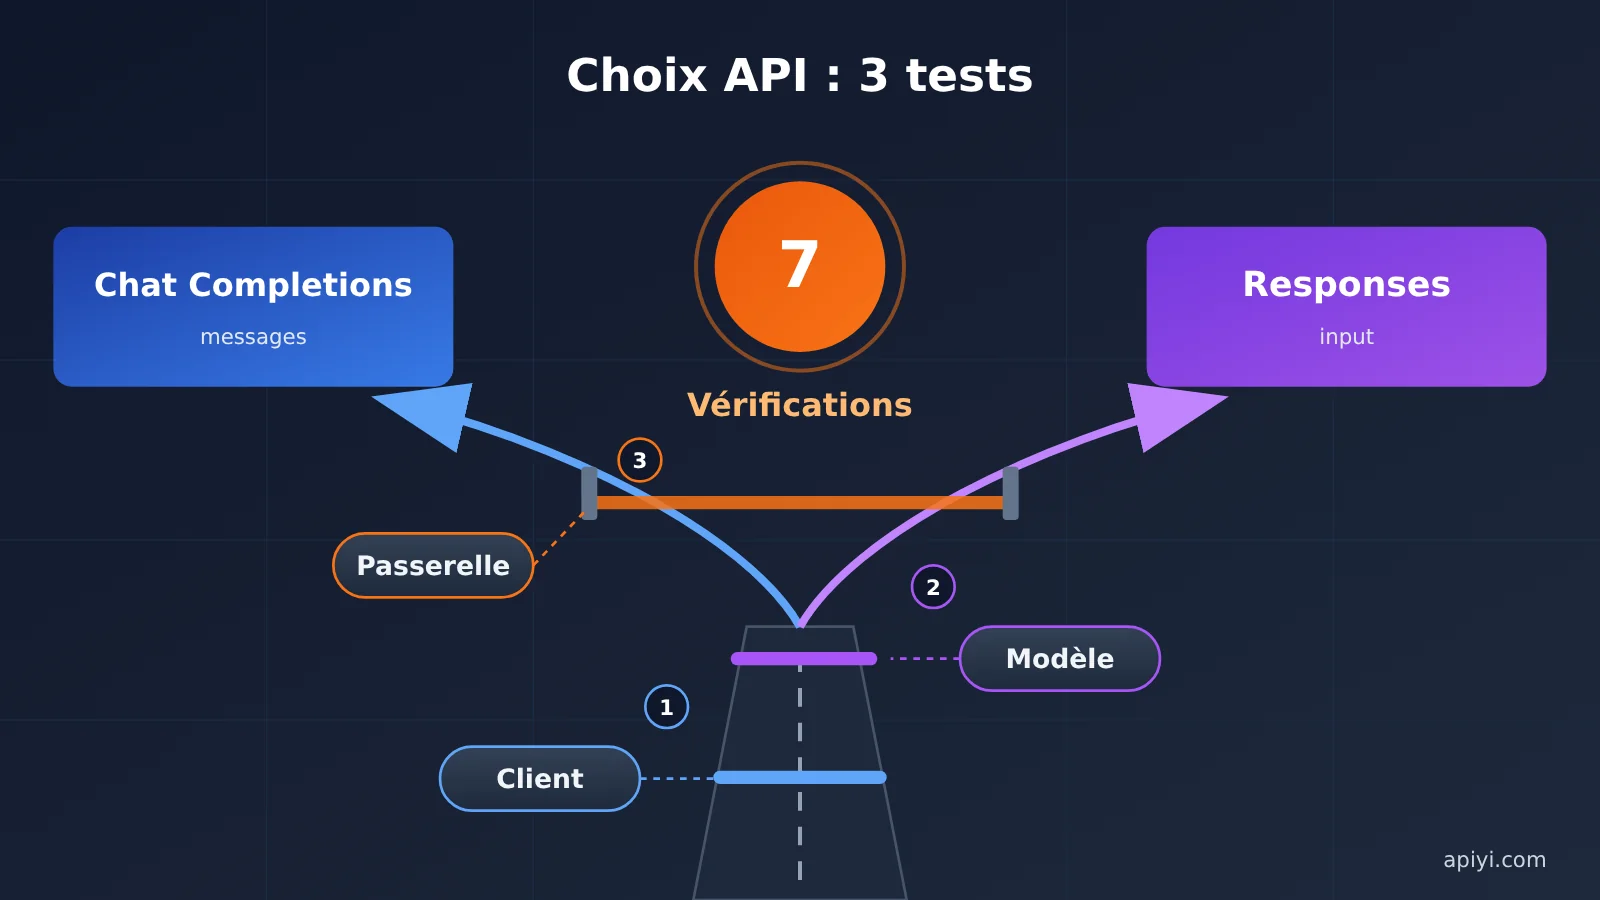
Allons droit au but : choisir entre Responses et Chat Completions ne dépend pas de l’interface la plus récente, mais du client, du modèle et de la passerelle, ensemble. Le client détermine les requêtes que vous pouvez envoyer, le modèle détermine quel point de terminaison offre les fonctionnalités nécessaires, et la passerelle détermine si la requête peut atteindre le service en amont sans être modifiée.
Ne changez donc pas d’interface à tout prix pour intégrer un nouveau modèle. Retenez ceci : si le client ne prend pas en charge une interface, ne l’utilisez pas, aussi récente soit-elle ; si le modèle ne prend en charge qu’un seul point de terminaison, ne forcez pas l’utilisation d’un autre. Les 7 vérifications, le tableau de décision par scénario et la liste de contrôle pour le retour arrière ci-dessous vous aideront à détecter les incompatibilités liées aux appels d’outils, aux paramètres de raisonnement ou aux événements de streaming avant la mise en production.
Responses et Chat Completions : quelles différences ?
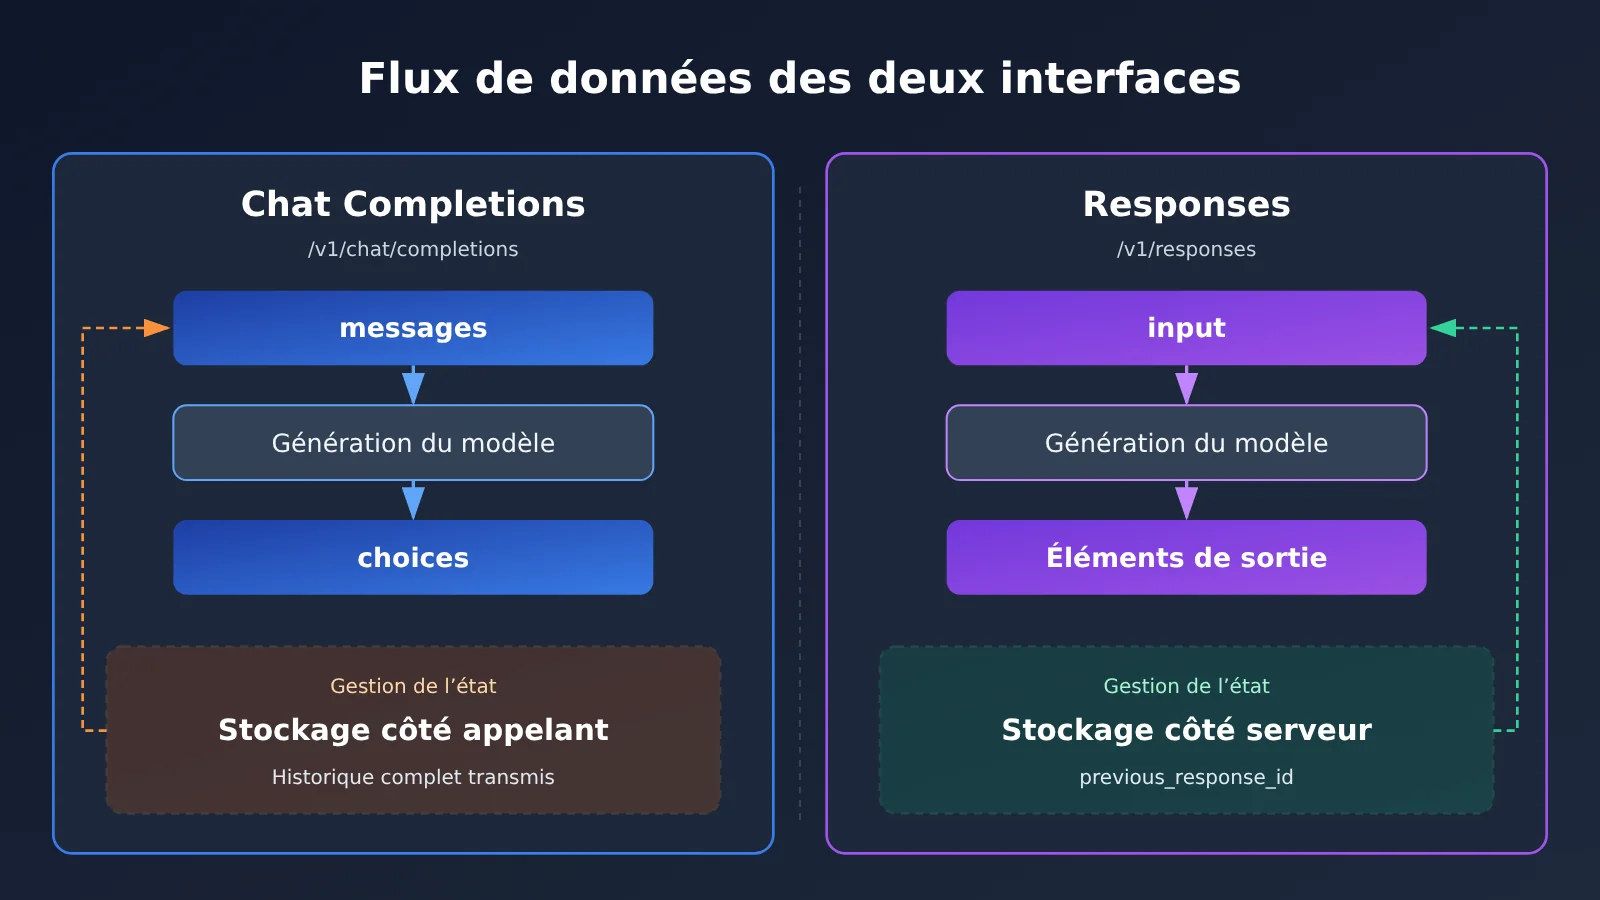
La différence principale entre les deux interfaces tient à leur modèle de données : Chat Completions s’articule autour d’un tableau de messages, tandis que Responses s’articule autour d’un objet de réponse.
Les requêtes Chat Completions sont centrées sur messages. Chaque message contient un role et un content ; parmi les autres champs courants figurent temperature, max_tokens, tools et stream. L’interface est sans état : l’appelant gère lui-même l’historique. Dans la réponse, message et finish_reason se trouvent dans choices, et la consommation dans usage. C’est aussi l’interface la plus largement prise en charge par les SDK et les clients.
Les requêtes Responses sont centrées sur input et peuvent inclure tools, reasoning et previous_response_id. La réponse contient un tableau output, ainsi que output_text, status, id et usage. Certains nouveaux modèles de raisonnement et certaines fonctionnalités d’outils ne sont disponibles que via Responses, mais tous les modèles, SDK, clients et passerelles ne prennent pas cette interface en charge.
| Point à vérifier | Chat Completions | Responses | Risque lors de la migration |
|---|---|---|---|
| Endpoint et structure de la requête | /v1/chat/completions, avec messages |
/v1/responses, avec input |
Chemin ou corps de requête incompatible, code d’analyse inutilisable |
| État des conversations à plusieurs tours | L’appelant transmet tout l’historique | previous_response_id permet de référencer le tour précédent |
Expiration de l’état, incohérence du contexte |
| Paramètres de raisonnement et de tokens | max_tokens ou max_completion_tokens |
Configuration du raisonnement avec reasoning |
Paramètres ignorés ou erreur immédiate |
| Appels d’outils | tools et résultats des outils dans les messages |
Éléments d’outil dans output et éléments de résultat correspondants |
Identifiants d’appel mal associés, interruption de la boucle de l’agent |
| Événements en streaming | Fragments SSE incrémentaux | Événements SSE typés | Fin prématurée, erreurs d’assemblage du texte |
| Entrées multimodales | Fragments de contenu image_url courants |
Éléments d’entrée comme input_image courants |
Images ou fichiers refusés |
| Compatibilité | Large prise en charge par les clients et les passerelles | Dépend du client, de la passerelle et du modèle | Base URL configurable, mais endpoint inaccessible |
Pour choisir, procédez dans cet ordre. En cas de conflit entre les critères, assurez-vous d’abord que le client et le modèle fonctionnent ensemble :
- Vérifiez d’abord le client : prend-il en charge Chat Completions, Responses ou le format natif du fournisseur ?
- Examinez ensuite le modèle : est-il disponible uniquement sur un endpoint ? Dépend-il d’outils intégrés ou d’options de raisonnement ?
- Vérifiez la passerelle : relaie-t-elle l’endpoint cible ? Peut-elle faire la correspondance entre les modèles et enregistrer les journaux ?
- Évaluez enfin les coûts : pour une même tâche, les coûts liés aux tokens, au cache et aux nouvelles tentatives diffèrent-ils entre les deux interfaces ?
Conseil d’intégration : le tableau comparatif aide à repérer les risques, mais il faut vérifier dans votre environnement quels endpoints sont pris en charge par chaque modèle. Vous pouvez commencer par consulter le modèle cible dans la console APIYI sur apiyi.com, puis choisir votre méthode de validation.
Comment examiner la couche des requêtes : contrôles 1 à 3 pour l’intégration de Responses
La conclusion est simple : si le point de terminaison, l’état et les paramètres ne sont pas alignés, inutile de tester les outils et le streaming.
Contrôle 1 : point de terminaison et structure des requêtes Responses et Chat Completions
Il faut vérifier que la requête est envoyée au bon chemin et que le corps de la requête comme l’analyse de la réponse utilisent la structure correspondante.
- Différence : l’un utilise
/v1/chat/completions, l’autre/v1/responses; le premier reçoitmessageset renvoiechoices, le second reçoitinputet renvoieoutput. - Piège courant : modifier le chemin sans adapter l’analyse de la réponse. La requête peut réussir, mais le code applicatif ne trouve pas
choices[0].message: on a alors l’impression que le modèle n’a rien renvoyé. - Comment vérifier : envoyez une requête textuelle minimale à chacun des deux points de terminaison. Notez le code d’état, les champs de premier niveau de la réponse et
usage. Avec l’interface compatible OpenAI d’APIYI, utilisezhttps://api.apiyi.com/v1comme URL de base. Consultez la console et la documentation pour vérifier la disponibilité du point de terminaison et du modèle visés. - Comment choisir : si le modèle prend en charge les deux interfaces et que votre application n’a besoin que de texte, conservez l’interface existante. Si le modèle n’est accessible que par un seul point de terminaison, adaptez votre intégration en conséquence.
Contrôle 2 : gestion de l’état des conversations à plusieurs tours avec Chat Completions et Responses
L’endroit où l’état est conservé détermine la façon de diagnostiquer les problèmes et le niveau de contrôle sur le contexte.
- Différence : avec Chat Completions, vous transmettez l’intégralité de
messagesà chaque tour. Avec Responses, vous pouvez utiliserprevious_response_idpour référencer la réponse précédente et confier une partie de l’état au serveur. - Piège courant : supposer que transmettre moins de contenu coûte forcément moins cher. Pour savoir si le contexte historique reste comptabilisé dans les tokens d’entrée, consultez la documentation officielle et votre facture. Autre piège : l’expiration de l’état. Lors de la reprise d’une tâche longue, un ancien identifiant de réponse peut ne plus être utilisable.
- Comment vérifier : exécutez une conversation sur trois tours et vérifiez que le troisième peut faire référence aux informations du premier. Testez ensuite le cas d’échec avec un identifiant ancien, pour voir si l’erreur est reconnaissable. Si la passerelle s’appuie sur plusieurs connexions en amont, vérifiez aussi si l’identifiant reste utilisable d’une requête à l’autre, selon les fonctionnalités prises en charge par la passerelle.
- Comment choisir : si vous devez maîtriser entièrement le contexte et faciliter son audit et sa réduction, transmettre tout l’historique est plus direct. Pour les longues conversations ou les boucles d’agent qui peuvent réellement bénéficier de l’état côté serveur, évaluez Responses.
Contrôle 3 : paramètres de raisonnement et de tokens lors de la migration vers Responses
Le principal risque avec les paramètres n’est pas toujours une erreur : ils peuvent être ignorés silencieusement. La requête réussit, mais la configuration du raisonnement n’est pas appliquée.
- Différence : sur certains modèles récents,
max_tokensa été remplacé parmax_completion_tokens; l’ancien champ peut être ignoré ou provoquer une erreur. Le nom du paramètre qui règle l’intensité du raisonnement varie aussi selon le fournisseur et l’interface : on rencontre notamment reasoning effort etthinking. - Piège courant : utiliser le même modèle de paramètres pour tous les modèles. Si le client ou la passerelle écarte les champs inconnus, la réponse peut sembler normale alors que la profondeur du raisonnement et la limite de sortie ne correspondent pas aux valeurs définies.
- Comment vérifier : modifiez un à un la limite de sortie et le niveau de raisonnement, puis comparez la longueur des réponses,
usageet les messages d’erreur. Si rien ne change, vérifiez d’abord si le paramètre a bien été transmis et s’il est pris en charge par le modèle, puis consultez la documentation officielle et celle de la passerelle. - Comment choisir : maintenez une table de correspondance des paramètres par combinaison « modèle + point de terminaison », plutôt que de les regrouper approximativement par fournisseur. Si votre application dépend de la configuration
reasoning, privilégiez une interface qui transmet ce champ sans modification.
Comment vérifier les capacités : points 4 à 6 de la migration depuis Chat Completions
Côté capacités, les deux interfaces peuvent prendre en charge une même fonctionnalité, mais le code d’analyse des réponses est rarement réutilisable tel quel.
Vérification 4 : l’appel d’outils avec Chat Completions et Responses
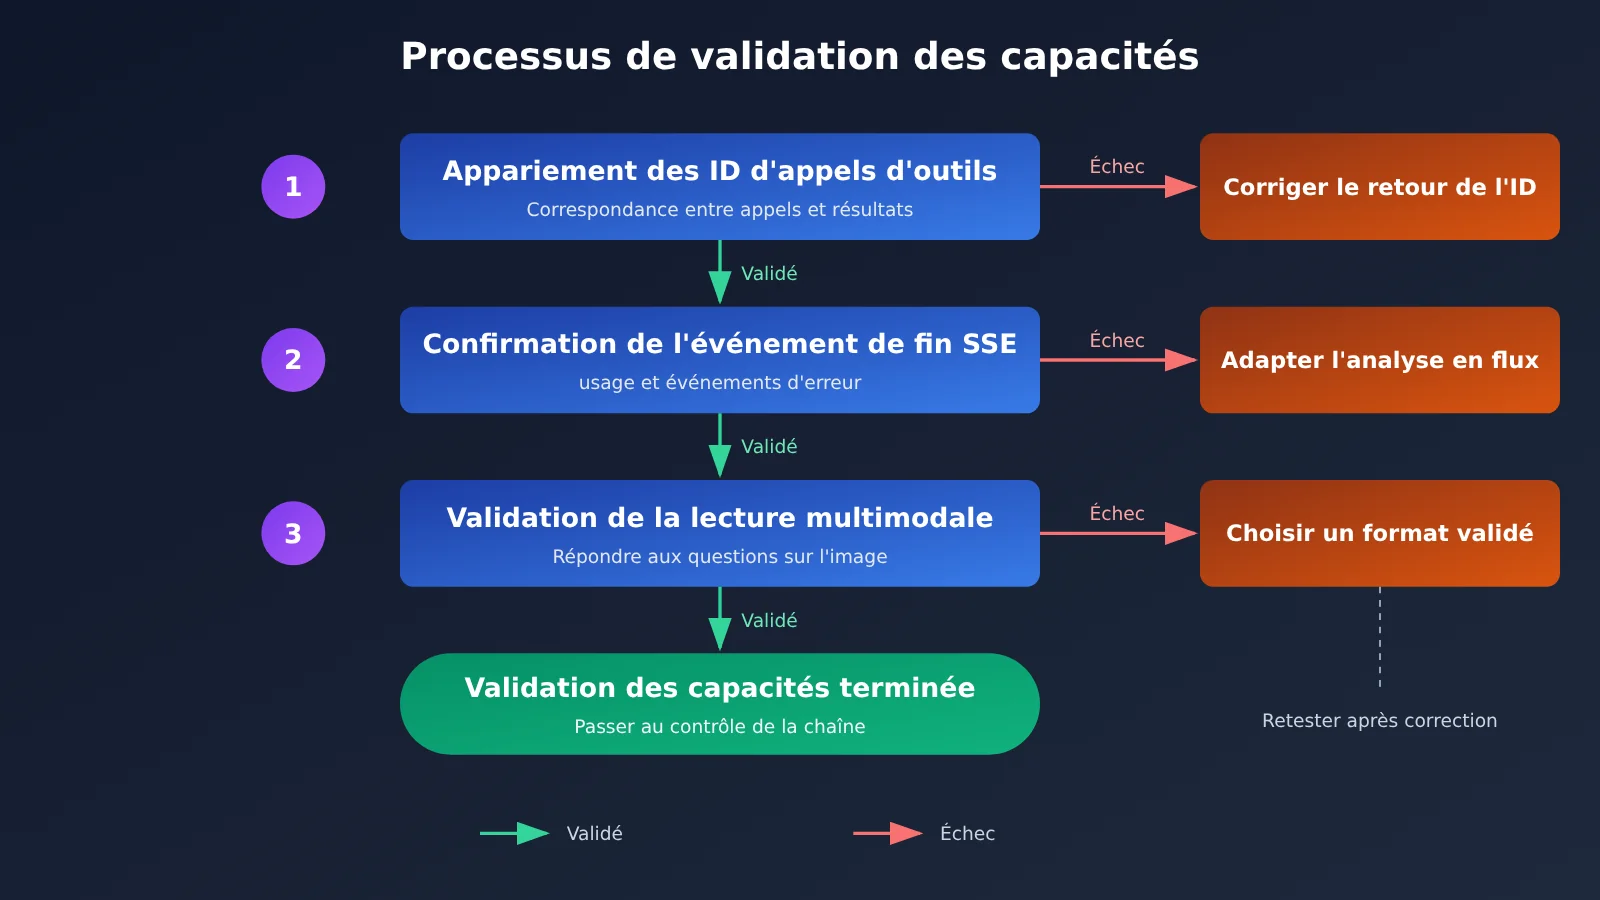
Chat Completions prend en charge l’appel d’outils. La migration concerne surtout le schéma des outils, les ID d’appel et la façon de renvoyer les résultats.
- Différence : les deux interfaces permettent de définir des outils, mais leur structure diffère. Avec Chat Completions, les appels apparaissent généralement dans
tool_callsau sein d’un message assistant. Avec Responses, ils sont renvoyés comme éléments deoutput, et les résultats doivent être transmis dans les éléments d’entrée correspondants. Pour les champs exacts, consultez la documentation officielle. - Piège courant : lors d’appels parallèles, ne traiter que le premier outil ou modifier les ID d’appel avant de les renvoyer. Le modèle peut alors produire une erreur au tour suivant ou poursuivre son raisonnement avec le mauvais résultat, ce qui est plus difficile à détecter.
- Comment vérifier : préparez un cas avec un seul outil et un autre avec des outils appelés en parallèle. Vérifiez que chaque ID d’appel est renvoyé tel quel et que chaque résultat correspond au bon appel. Faites ensuite échouer volontairement un outil pour vérifier que la boucle de l’agent se termine correctement.
- Comment choisir : si votre chaîne d’outils actuelle est stable et que vous n’avez pas besoin d’outils intégrés, restez sur Chat Completions. Si les outils intégrés du modèle cible ne sont proposés que dans Responses, migrez et réécrivez la couche d’analyse.
Vérification 5 : les événements de streaming dans Responses et Chat Completions
Pour le streaming, il ne suffit pas de vérifier que du texte s’affiche : il faut aussi tester la gestion de la fin et des erreurs.
- Différence : les deux interfaces reposent sur SSE, mais leurs types d’événements et leurs marqueurs de fin diffèrent. Chat Completions utilise principalement des fragments incrémentaux, tandis que Responses distingue le texte, les outils et l’état d’achèvement par différents types d’événements.
- Piège courant : considérer que le flux est terminé dès qu’un
dataest reçu, ou ne concaténer que les fragments de texte sans traiter ceux des paramètres d’outils ni les événements d’erreur. La réponse risque alors d’être tronquée et les paramètres d’outils incomplets. - Comment vérifier : capturez le flux SSE brut complet et contrôlez l’ordre des fragments, l’événement de fin, l’emplacement de
usageet le comportement en cas d’erreur en cours de route. Si la passerelle transforme ou met les événements en mémoire tampon, effectuez une deuxième capture sur le trajet qui la traverse. - Comment choisir : si l’analyseur de streaming du client ne reconnaît que le format Chat Completions, ne passez pas directement à Responses. Pour effectuer la transition, mettez d’abord à jour le SDK ou adaptez la couche d’analyse.
Vérification 6 : les entrées multimodales lors de l’intégration de Responses
Les champs multimodaux dépendent à la fois de l’interface et du fournisseur. Le fait que le texte fonctionne ne garantit pas que les images et les fichiers fonctionneront aussi.
- Différence : le champ d’image peut utiliser
image_url,input_imageou base64. Les méthodes d’entrée pour les fichiers et l’audio varient elles aussi selon l’interface et le fournisseur. - Piège courant : conserver l’ancienne structure des fragments de contenu ou supposer que les URL et base64 sont tous deux pris en charge. Lorsqu’une passerelle convertit le format, des différences de taille, d’encodage ou de type de fichier peuvent aussi poser problème.
- Comment vérifier : envoyez des requêtes minimales distinctes avec une image par URL, une image en base64 et le type de fichier cible. Vérifiez que le modèle a réellement lu le contenu. Lui poser une question à laquelle il ne peut répondre qu’en voyant l’image est plus fiable que de se fier au seul code de statut.
- Comment choisir : si vous avez seulement besoin de comprendre des images, privilégiez le format déjà validé avec votre client actuel. Si les capacités de traitement des fichiers ou de l’audio dépendent d’un point d’accès précis, fiez-vous à la documentation officielle et aux fonctionnalités prises en charge par la passerelle.
Comment vérifier la chaîne d’intégration : contrôle 7 de la compatibilité avec Responses
La conclusion est simple : pouvoir renseigner une Base URL ne signifie pas que le client, le SDK et la passerelle prennent tous en charge Responses.
Contrôle 7 : compatibilité du SDK, du client et de la passerelle avec Responses
Une requête traverse quatre couches : le client, le SDK, la passerelle et le modèle. Si l’une d’elles ne prend pas en charge la nouvelle interface, celle-ci ne pourra pas fonctionner.
| Couche de la chaîne | Points à vérifier | Erreur d’interprétation fréquente |
|---|---|---|
| Client | Prend-il en charge le point de terminaison cible ? Sa version est-elle assez récente ? | Supposer que Responses est pris en charge parce qu’un champ Base URL est disponible |
| SDK | Fournit-il la méthode et les types d’événements visés ? | Supposer que le streaming et les outils peuvent être interprétés parce que la requête est envoyée |
| Passerelle | Transmet-elle les requêtes au point de terminaison cible ? Faut-il l’activer séparément ? | Supposer que tous les points de terminaison OpenAI sont couverts parce que la passerelle est compatible avec OpenAI |
| Correspondance des modèles | L’ID du modèle figure-t-il dans la liste ? Faut-il établir une correspondance ? | Supposer que le nom est identique dans la passerelle parce que le nom officiel du modèle fonctionne |
- La différence : Chat Completions offre la compatibilité la plus large ; la disponibilité de Responses dépend de la combinaison du client, du SDK, de la passerelle et du modèle.
- Le piège courant : le client construit discrètement le chemin
/chat/completions, ou la passerelle ne transmet qu’une partie des champs. Si vous ne vérifiez que le nom du modèle, vous risquez d’attribuer à tort le problème à ses capacités. - Comment vérifier : commencez par contourner le code applicatif et envoyez une requête minimale avec un outil de test d’API. Envoyez ensuite la même requête depuis le client, puis comparez le chemin réellement utilisé, le corps de la requête et la réponse.
- Comment choisir : si une couche de la chaîne ne prend pas en charge le point de terminaison cible, conservez l’interface existante ou utilisez un format qu’elle prend effectivement en charge.
Dans un environnement multimodèle, une passerelle doit idéalement limiter les modifications à apporter aux clients. APIYI apiyi.com permet d’utiliser une seule clé pour accéder à des modèles de plusieurs fournisseurs, dont OpenAI, Claude et Gemini. Le service est compatible avec la norme OpenAI API ainsi qu’avec les formats natifs de Claude et de Gemini. Chaque client peut donc utiliser le protocole qu’il prend en charge, sans devoir créer une configuration d’intégration distincte pour chaque modèle.
Ne renseignez pas l’ID d’un modèle de mémoire et ne reprenez pas directement les noms utilisés sur d’autres plateformes. Avant la migration, consultez la liste des modèles dans la console APIYI apiyi.com pour vérifier l’ID et les points de terminaison disponibles. Pour les prix et la disponibilité, référez-vous également à la console et à la documentation. Cette vérification ne prend que peu de temps et permet d’écarter toute une catégorie d’erreurs, comme « modèle inexistant » ou « point de terminaison non pris en charge ».
Responses ou Chat Completions : comment choisir selon le cas d’usage
Pour la plupart des tâches simples, Chat Completions suffit. Passez à Responses lorsque vous avez réellement besoin de ses nouvelles fonctionnalités.
| Cas d’usage | Interface recommandée | Pourquoi | Points à vérifier |
|---|---|---|---|
| Agent de programmation (Claude Code, Codex CLI, Cline, etc.) | Choisir un format pris en charge par le client | L’implémentation du protocole par le client détermine les options disponibles. La plupart utilisent encore principalement Chat Completions ou Anthropic Messages | Configuration du protocole dans la version actuelle, appels d’outils et analyse du flux |
| Nouveau modèle de raisonnement OpenAI avec outils intégrés | Privilégier Responses | Certaines fonctionnalités de raisonnement et certains outils ne sont proposés que dans Responses | Prise en charge du point de terminaison par la passerelle et disponibilité des outils intégrés |
| Conversation longue ou boucle d’agent | Envisager Responses | La gestion de l’état côté serveur peut réduire les transmissions répétées | Délai d’expiration de l’état, cohérence et coût réel en tokens |
| Appels d’outils personnalisés | Conserver l’interface stable existante | Chat Completions prend aussi en charge les appels d’outils. Le coût de migration concerne surtout la couche d’analyse | Appels parallèles, correspondance des ID d’appel et remontée des erreurs |
| Accès unifié à plusieurs modèles | Privilégier une passerelle compatible avec plusieurs formats | Évite de modifier le client pour chaque modèle | Correspondance des modèles, journaux et différences de paramètres entre modèles |
| Questions-réponses sans modification ou classification simple | Chat Completions | Fonctionnalités suffisantes, large compatibilité et faible coût d’adaptation | Compatibilité du paramètre de limite de sortie avec le modèle cible |
Pour utiliser ce tableau, repérez d’abord votre cas d’usage, puis consultez la dernière colonne. Par exemple, si le modèle visé ne propose que Responses et que votre client ne prend en charge que Chat Completions, ne forcez pas la conversion des champs : mettez à jour le client, changez-en ou choisissez un modèle compatible avec l’interface utilisée.
Examinez le coût en dernier. Responses n’est pas forcément moins cher : les accès au cache, le nombre de nouvelles tentatives et la consommation réelle de tokens influencent tous le résultat. Seule une comparaison des factures pour une même tâche permet de tirer une conclusion utile.
Conseil pour choisir : si vous hésitez entre plusieurs modèles, comparez-les avec le même jeu d’invites et les mêmes cas d’utilisation des outils. Avec APIYI apiyi.com, vous pouvez passer d’un modèle à l’autre avec une seule clé API, puis utiliser le crédit de test gratuit offert aux nouveaux utilisateurs pour une validation à petite échelle. Cela réduit le travail initial d’intégration et de configuration.
FAQ : Responses et Chat Completions
La réponse à toutes ces questions est la même : examinez d’abord le parcours réel de la requête avant de tirer des conclusions.
Q1 : Les nouveaux modèles fonctionnent-ils uniquement avec Responses ?
Pas forcément. Cela dépend du modèle et de la passerelle. Certains nouveaux modèles de raisonnement ou certaines fonctionnalités d’outils ne sont disponibles que dans Responses, tandis que d’autres modèles prennent toujours en charge Chat Completions. Avant l’intégration, vérifiez la documentation officielle et la description du modèle fournie par la passerelle.
Q2 : Peut-on encore appeler des outils avec Chat Completions ?
Oui. Chat Completions prend en charge l’appel d’outils. Les différences concernent la structure des champs, le format de retour des résultats et la gestion de l’état. Lors d’une migration vers Responses, il faut généralement adapter le code qui analyse les appels d’outils : on ne peut pas le réutiliser tel quel.
Q3 : Que faire si la passerelle ne prend pas en charge Responses ?
Vérifiez d’abord si le modèle cible fonctionne aussi avec Chat Completions ou le format natif du fournisseur. Si c’est le cas, conservez votre chemin actuel. Si le modèle ne propose que Responses, utilisez une passerelle compatible avec ce point de terminaison ou connectez-vous directement. Avec APIYI apiyi.com, vous pouvez vérifier les points de terminaison pris en charge par le modèle cible dans la console et la documentation.
Q4 : Pourquoi la facturation a-t-elle changé après la migration ?
Les causes courantes comprennent une modification de la transmission du contexte, du nombre de tokens de raisonnement ou du taux d’utilisation du cache, ainsi que des tours supplémentaires liés aux appels d’outils et aux nouvelles tentatives après échec. Pour comprendre l’écart, comparez d’abord les données `usage` pour une même tâche, puis vérifiez le modèle, le nombre de requêtes et la consommation de tokens dans les journaux d’utilisation d’APIYI apiyi.com.
Q5 : Quand faut-il revenir en arrière ?
Il faut revenir en arrière si le parcours principal échoue, si les résultats des outils sont associés aux mauvais appels, si les réponses en streaming sont fréquemment tronquées, ou si le taux de réussite, la latence ou les coûts s’écartent nettement des valeurs de référence sans explication rapide. Définissez les critères de retour en arrière avant la migration pour éviter d’en débattre une fois la mise en production effectuée.
Liste de vérification pour la migration vers Responses et le retour arrière
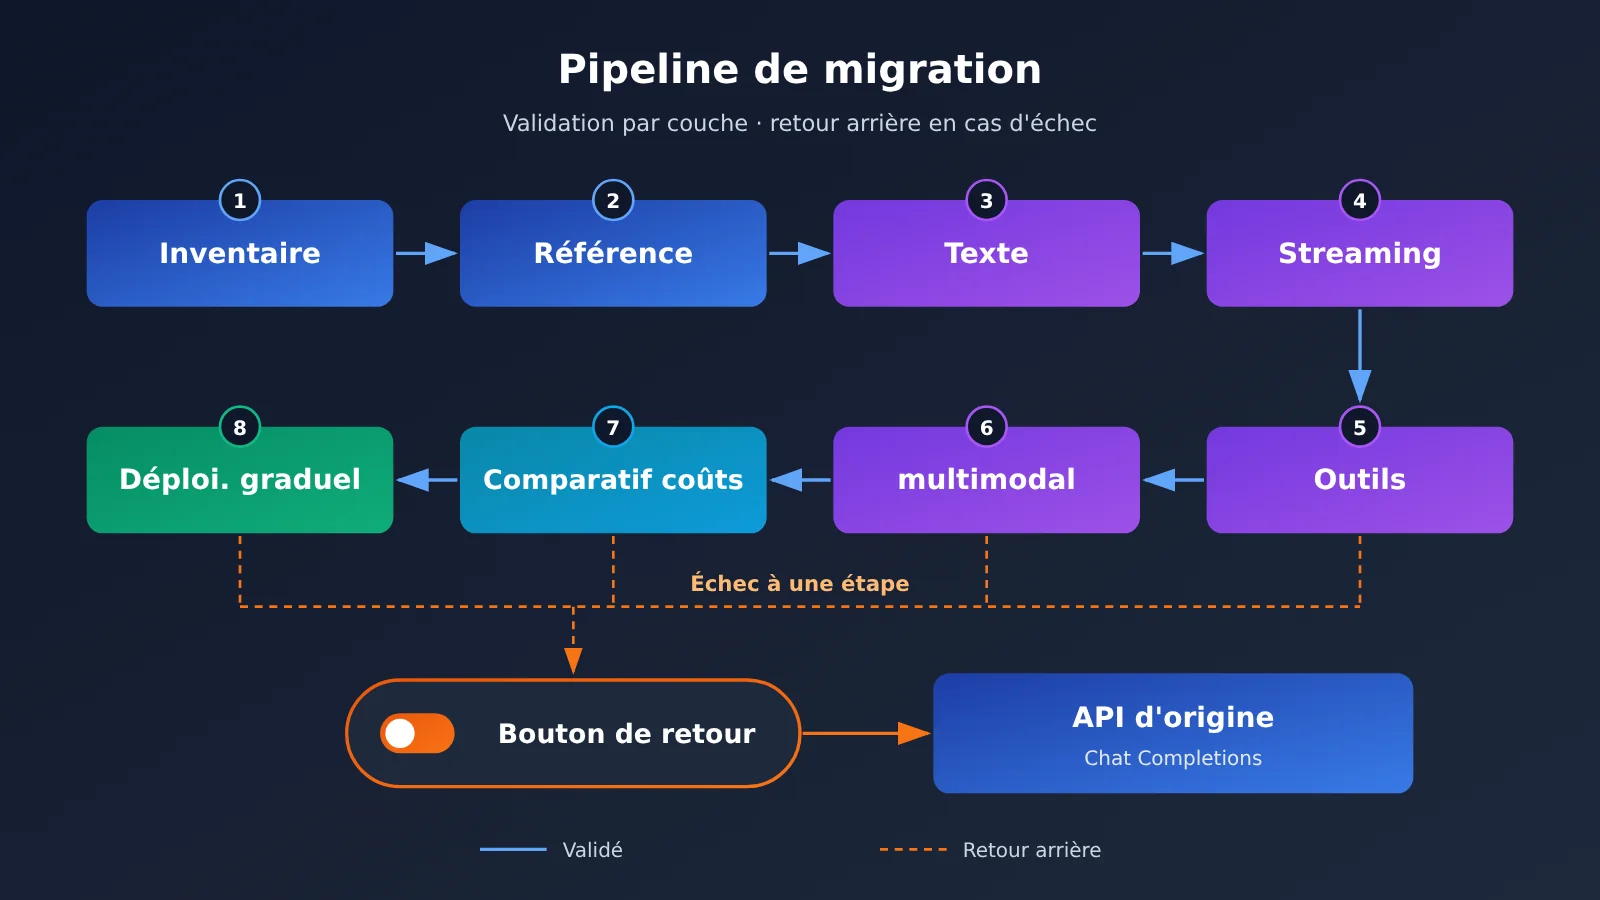
La règle est simple : valider par petites étapes, conserver l’ancien chemin et s’appuyer sur une référence pour décider de poursuivre ou non.
Liste de vérification avant et après la migration vers Responses
- Inventorier les versions : répertorier les versions du client, du SDK et de la passerelle, puis vérifier que le point de terminaison cible est pris en charge.
- Vérifier la correspondance : contrôler le point de terminaison, l’ID du modèle, les paramètres de raisonnement et ceux des tokens.
- Établir une référence : enregistrer le taux de réussite, la latence et le coût en tokens de l’ancienne interface.
- Conserver l’ancien chemin : garder la configuration et l’ID du modèle de l’ancienne interface, et utiliser un commutateur ou une variable d’environnement pour basculer entre les deux, sans les coder en dur.
- Valider d’abord le texte : vérifier qu’une requête textuelle minimale fonctionne et que la réponse est correctement analysée.
- Valider ensuite le streaming : vérifier que les fragments sont assemblés intégralement et que les événements de fin et d’erreur sont bien traités.
- Valider ensuite les outils : vérifier qu’un outil unique et plusieurs outils en parallèle fonctionnent, et que les ID d’appel correspondent aux bons résultats.
- Valider enfin le multimodal : vérifier que le modèle lit correctement les entrées réellement utilisées, comme les images et les fichiers.
- Expliquer la facturation : comparer la facturation des tokens et le cache, puis s’assurer que les écarts sont explicables.
- Déployer progressivement sur un faible trafic : commencer par une petite quantité de trafic non critique, tout en consignant les écarts et les cas d’échec.
Pendant la validation, comparez les résultats des requêtes envoyées aux deux interfaces. La console APIYI sur apiyi.com permet de consulter l’utilisation et la facturation. Les journaux permettent de vérifier que le modèle et la consommation des requêtes du déploiement progressif correspondent aux attentes. En cas d’anomalie, revenez à la configuration de l’ancienne interface, puis reproduisez le problème à partir des cas d’échec.
Conditions de retour arrière vers Chat Completions
| Point observé | Action recommandée | Critère de retour arrière |
|---|---|---|
| Échec des requêtes texte | Suspendre le déploiement progressif, vérifier le point de terminaison et l’analyse des réponses | Revenir en arrière si le problème ne peut pas être résolu rapidement |
| Flux tronqué ou qui ne se termine pas | Comparer les événements SSE bruts | Revenir immédiatement en arrière si la sortie utilisateur est affectée |
| Appels d’outils mal associés | Vérifier les ID d’appel et le format des réponses | Revenir immédiatement en arrière si des actions incorrectes risquent de se produire |
| Paramètres de raisonnement sans effet | Vérifier leur transmission et leur prise en charge par le modèle | Revenir en arrière si la qualité des réponses est affectée et qu’aucune configuration alternative n’est disponible |
| Coût différent de la référence | Analyser les tokens, le cache et les nouvelles tentatives | Revenir en arrière si l’écart dépasse le seuil fixé par l’équipe et reste inexpliqué |
Responses ou Chat Completions : les points essentiels
- Ordre de choix : d’abord le client, puis le modèle, ensuite la passerelle et enfin la comparaison des coûts.
- Limites des capacités : Responses convient aux modèles qui dépendent de ses fonctions exclusives, mais tous les modèles ne le prennent pas en charge.
- Appels d’outils : Chat Completions les prend en charge ; lors de la migration, il faut surtout vérifier les champs et l’association des appels à leurs réponses.
- Ordre de validation : d’abord le texte, puis le streaming, les outils et enfin le multimodal.
- Préparation du retour arrière : conserver l’ancienne configuration, enregistrer les valeurs de référence à l’avance et effectuer la bascule à l’aide d’un commutateur.
Conclusion : Responses ou Chat Completions, comment trancher ?
Si votre intégration Chat Completions est stable, répond à vos besoins et prend en charge le nouveau modèle, inutile de changer d’interface pour le principe. Si le modèle visé ou les outils intégrés nécessitent Responses, passez en revue les 7 points de vérification, étape par étape. Retenez ceci : si le client ne prend pas en charge une interface, ne l’utilisez pas, aussi récente soit-elle ; si le modèle ne prend en charge qu’un seul endpoint, ne forcez pas l’utilisation d’un autre.
Pour commencer, vous pouvez vérifier l’ID du modèle et les endpoints pris en charge sur APIYI, apiyi.com. Parcourez ensuite la liste avec une requête minimale avant de décider si vous passez à plus grande échelle.
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.