Note de l’auteur : le classement Search Index d’Artificial Analysis du 2026-11-09 montre qu’en fixant un modèle de réponse et en ne changeant que la configuration de recherche, le score global peut passer de 33 à 83 points. Pour choisir, il faut toutefois aussi prendre en compte le coût de la tâche, sa durée et les limites de l’évaluation.
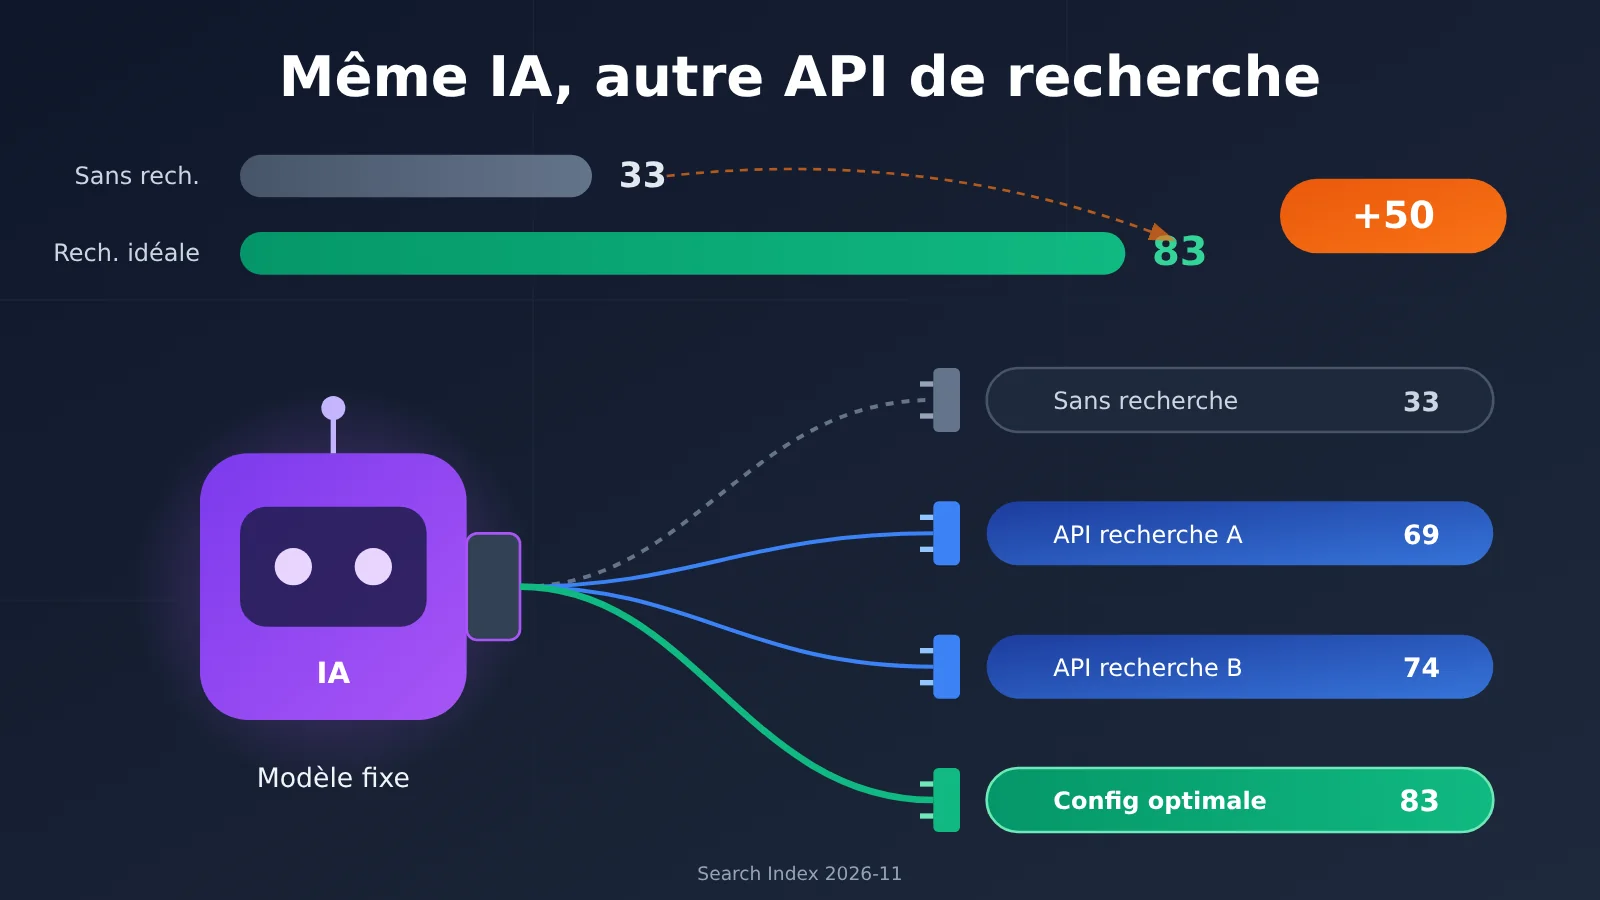
Quand on construit un agent, on commence souvent par choisir le modèle, puis on lui ajoute un outil de recherche au passage. Pour beaucoup d’équipes, la recherche n’est qu’un accessoire : « du moment que ça peut aller sur Internet, ça suffit ». Le Search Index mis à jour par Artificial Analysis le 9 novembre 2026 aboutit à un constat différent : un même modèle obtient 33 points sans recherche et peut atteindre 83 points avec la meilleure configuration d’API de recherche.
Ce n’est pas une énième reprise d’un classement où « chacun a ses points forts ». Cet article détaille la méthode de calcul du score de 83 points et les conditions de test, puis compare côte à côte la qualité, le temps total d’exécution d’une tâche, les frais de recherche et les frais de modèle. Enfin, il explique, selon les scénarios, à quelles décisions ce classement peut servir et dans quels cas il ne faut pas le transposer directement.
Valeur clé : après avoir lu cet article, vous saurez utiliser un classement public pour sélectionner des candidats d’API de recherche, puis les comparer une deuxième fois en fonction de vos propres tâches, afin d’éviter de décider uniquement sur le score le plus élevé.
Les termes à connaître avant de lire le classement des API de recherche
En une phrase : le Search Index compare les performances d’un même modèle sous différentes configurations de recherche, avec un écart pouvant atteindre 50 points. Mais « un score élevé » ne veut pas dire « le plus adapté à votre cas » : il faut aussi regarder le coût, la durée d’exécution et la couverture de l’évaluation.
Avant de plonger dans le classement, mettons-nous d’accord sur quelques termes :
- Search Index : un score global calculé selon des règles définies à partir d’un benchmark de recherche donné. Dans cet article, il désigne précisément l’indice d’évaluation des API de recherche d’Artificial Analysis, noté sur 100.
- F1 : la moyenne harmonique de la précision et du rappel. Quand la réponse attendue est « un ensemble d’entités », cette mesure indique si la réponse est juste et complète.
- Harness : un cadre de test qui organise l’entrée du modèle, l’exécution des outils et la notation des tâches. La boucle d’Agent utilisée par Artificial Analysis s’appelle Stirrup.
- Search API : une interface qui renvoie, pour une requête, des résultats de recherche comme des liens web, des titres ou des extraits pertinents — par exemple Exa, Brave ou Perplexity Search API.
- Token : l’unité de mesure du texte traité par un modèle. Plus les résultats de recherche sont verbeux, plus le nombre de Tokens envoyés au modèle augmente, et plus la facture grimpe.
Une API de recherche peut-elle vraiment créer 50 points d’écart pour le même AI ?
Artificial Analysis a lancé son benchmark d’API de recherche le 18 août 2026. Les dernières données publiques ont été mises à jour le 9 novembre 2026 et couvrent 14 fournisseurs ainsi que 26 produits ou configurations de Search API. Ce n’est pas le modèle qui est évalué, mais l’effet réel obtenu lorsqu’un service de recherche est intégré dans un Agent.
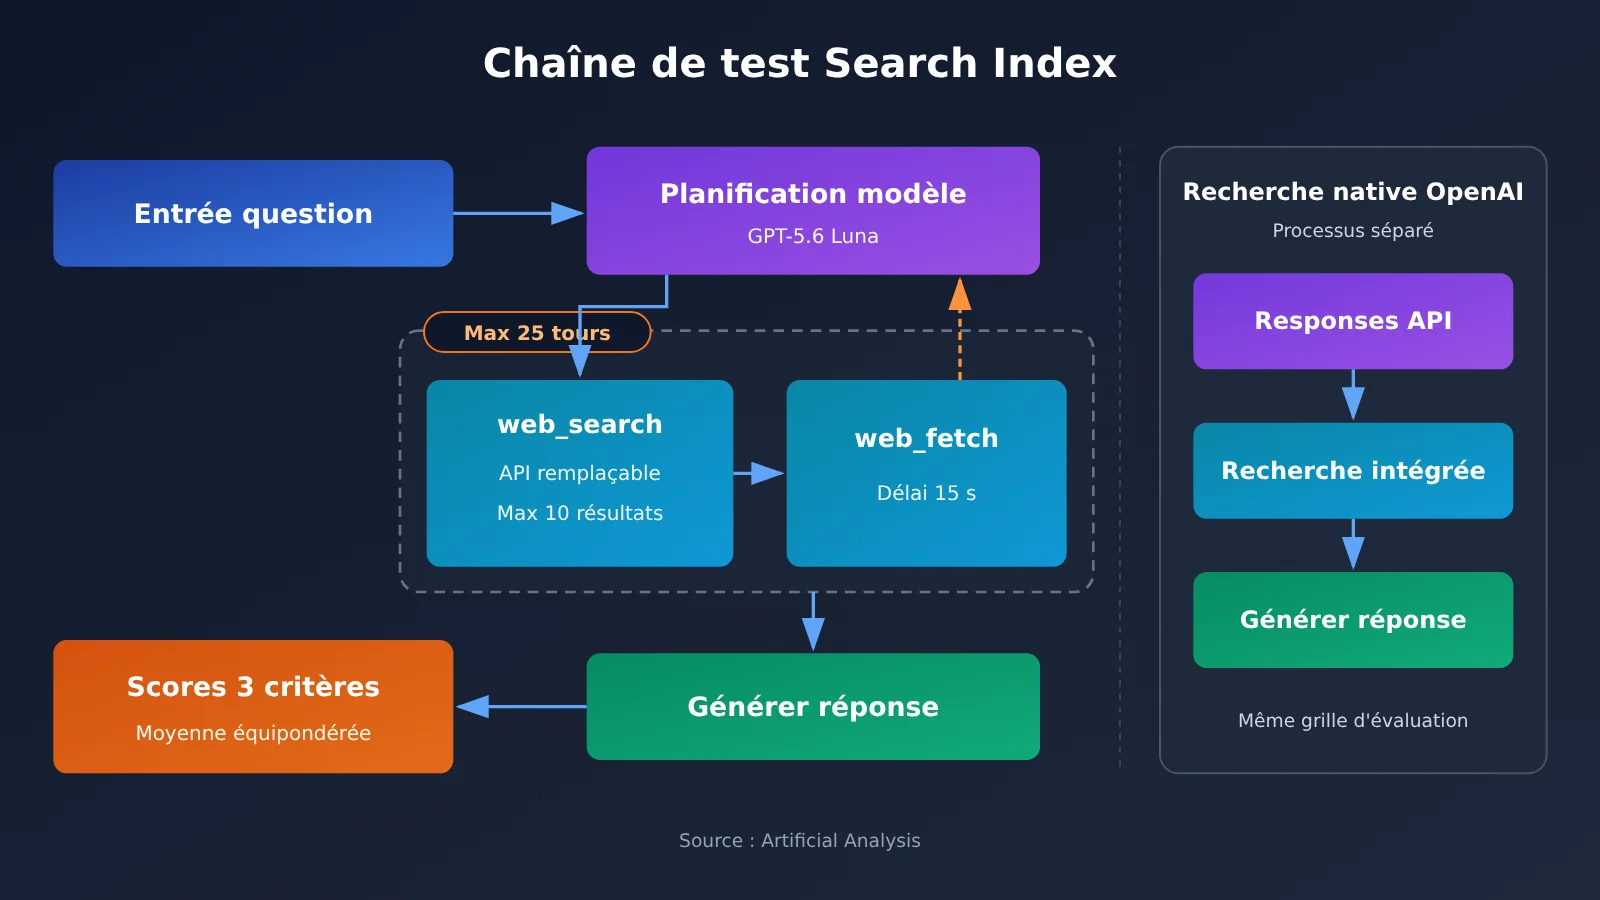
Le point clé du protocole expérimental, c’est le contrôle des variables. Le modèle de réponse candidat est fixé à GPT-5.6 Luna (medium), le cadre d’Agent reste lui aussi identique, et seule la service de recherche est remplacée. Dans ces conditions, la baseline sans outil de recherche n’obtient que 33 points, tandis que Keenable Pro, classé premier, atteint 83 points : soit 50 points d’index d’écart. Même entre configurations équipées de la recherche, l’écart reste de 14 points, allant des 69 points de DeepSeek Search Summary aux 83 points de Keenable Pro.
Une exception mérite d’être précisée à part : le Web Search natif d’OpenAI fonctionne différemment. Les autres Search API indépendantes tournent dans la boucle d’Agent externe d’Artificial Analysis. Le Web Search d’OpenAI utilise en revanche le flux d’outil intégré à la Responses API : le nombre de recherches et le mode d’exécution sont décidés par OpenAI lui-même. Ses 74 points sont donc une indication utile, mais on ne peut pas les lire comme une expérience de « changement d’API » dans des conditions strictement identiques.
À noter également : ces 50 points mesurent l’apport de la recherche au sein d’un même système d’évaluation. Cela ne signifie pas que n’importe qui, avec n’importe quel modèle, gagnera 50 points en branchant une recherche.
Comment le score de 83 de Search Index est-il vraiment calculé ?
Les trois benchmarks de Search Index et le mode de calcul
Le score composite est la moyenne équipondérée de trois benchmarks, chacun comptant pour un tiers :
| Benchmark | Nombre de tâches | Type de tâche | Métrique d’évaluation |
|---|---|---|---|
| DeepSearchQA | 900 | Recherche factuelle complexe, réponses souvent sous forme d’ensemble | F1 de l’ensemble de réponses |
| BrowseComp | 200 | Questions-réponses avec recherche web, niveau difficile | Précision de la réponse exacte |
| AA-Omniscience | 600 | Questions-réponses factuelles | Précision des réponses factuelles |
Cela représente 1 700 tâches au total, mais le score composite n’est pas un taux de bonnes réponses calculé sur les 1 700 questions réunies. Pour Keenable Pro, les trois scores sont 88, 87 et 73, soit une moyenne d’environ 82,67, arrondie à 83. Donc, un score de 83 ne signifie pas « 83 % de bonnes réponses ».
Les conditions de test de Search Index
Voici les configurations clés publiées dans la méthodologie :
| Élément de l’expérience | Configuration réelle |
|---|---|
| Modèle de réponse candidat / modèle d’évaluation | GPT-5.6 Luna (medium) |
| Nombre maximal de tours d’agent | 25 tours, nombre d’appels d’outils illimité par tour |
| Outils disponibles | web_search, web_fetch (lecture indépendante de pages web) |
| Résultats par recherche | 10 au maximum |
| Délai d’expiration pour l’extraction du contenu principal | 15 secondes par page |
| Contenu renvoyé au modèle | Réponse native du fournisseur |
| Référence sans recherche | Même modèle, sans outils de recherche |
Deux points ressortent de ce tableau. Premièrement, ce qui est renvoyé au modèle est la « réponse native du fournisseur ». La longueur des extraits, la méthode de synthèse et l’organisation des passages surlignés entrent dans le contexte du modèle. Le score ne reflète donc pas seulement la qualité de l’index web sous-jacent, mais aussi la façon dont l’information est organisée. Deuxièmement, les erreurs fatales comme les 429, les 5xx ou les dépassements de délai sont réessayées jusqu’à réussir, et ces erreurs ne sont pas comptées dans le résultat final. Le classement mesure donc la qualité « quand ça fonctionne », pas la disponibilité ni le taux de panne de chaque fournisseur en production.
Dernier classement Search Index : quelle API de recherche obtient les meilleurs résultats ?
Dans le tableau ci-dessous, le score de qualité et BrowseComp proviennent du classement du 2026-11-09. Les durées utilisent les valeurs du classement lu le 2026-11-13 ; elles désignent le temps moyen d’une tâche de test standard, du début à la fin, et non la latence réseau d’une requête unique vers l’API de recherche.
| Configuration de recherche | Score global (11-09) | BrowseComp | Durée moyenne de la tâche (11-13) |
|---|---|---|---|
| Keenable Pro | 83 | 87 % | 16.6 secondes |
| Keenable Realtime | 82 | 86 % | 16.0 secondes |
| Exa Auto + Dynamic Highlights | 80 | 83 % | 36.7 secondes |
| Perplexity Search Medium | 80 | 87 % | 31.1 secondes |
| Exa Lite + Dynamic Highlights | 79 | 81 % | 19.4 secondes |
| Parallel Advanced | 75 | 77 % | Non listé dans cette mise à jour des durées |
| Brave LLM Context | 75 | 77 % | Non listé dans cette mise à jour des durées |
| OpenAI Web Search Medium (flux intégré à Responses) | 74 | 74 % | 33.1 secondes |
| DeepSeek Search Summary | 69 | 63 % | 22.4 secondes |
| Aucune recherche (référence) | 33 | 17 % | — |
Trois écarts typiques dans le classement des API de recherche
Même score, vitesses différentes. Exa Auto et Perplexity Medium affichent tous deux 80 points, mais la tâche complète prend respectivement 36.7 secondes et 31.1 secondes. Keenable Pro obtient un meilleur score, avec une durée d’environ 16.6 secondes seulement. Pour un agent qui doit répondre en temps réel, l’utilisateur perçoit directement cet écart.
BrowseComp ne suit pas exactement le score global. Le BrowseComp de Perplexity Medium atteint 87 %, à égalité avec Keenable Pro, alors que son score global est inférieur de 3 points. L’écart vient surtout des deux autres benchmarks. Si votre activité ressemble davantage à de la « recherche de pages web sur des questions difficiles », vous pouvez consulter la colonne BrowseComp séparément.
Les différents modes d’un même fournisseur peuvent être très différents. Exa Lite et Exa Auto ne sont séparés que d’un point, mais leur durée est presque du double. Il faut donc interpréter les résultats par mode de produit précis, et ne pas fusionner Exa Lite et Exa Auto en un seul « score Exa ».
💡 Note sur les données : les scores ci-dessus proviennent de l’évaluation tierce d’Artificial Analysis, et les durées sont celles de tâches standard. Si vous souhaitez reproduire une comparaison similaire sur vos propres cas d’usage, vous pouvez figer un modèle de réponse via le service APIYI (apiyi.com), puis brancher tour à tour différents outils de recherche pour un test A/B.
Le score le plus élevé d’une API de recherche est-il vraiment le plus rentable ?
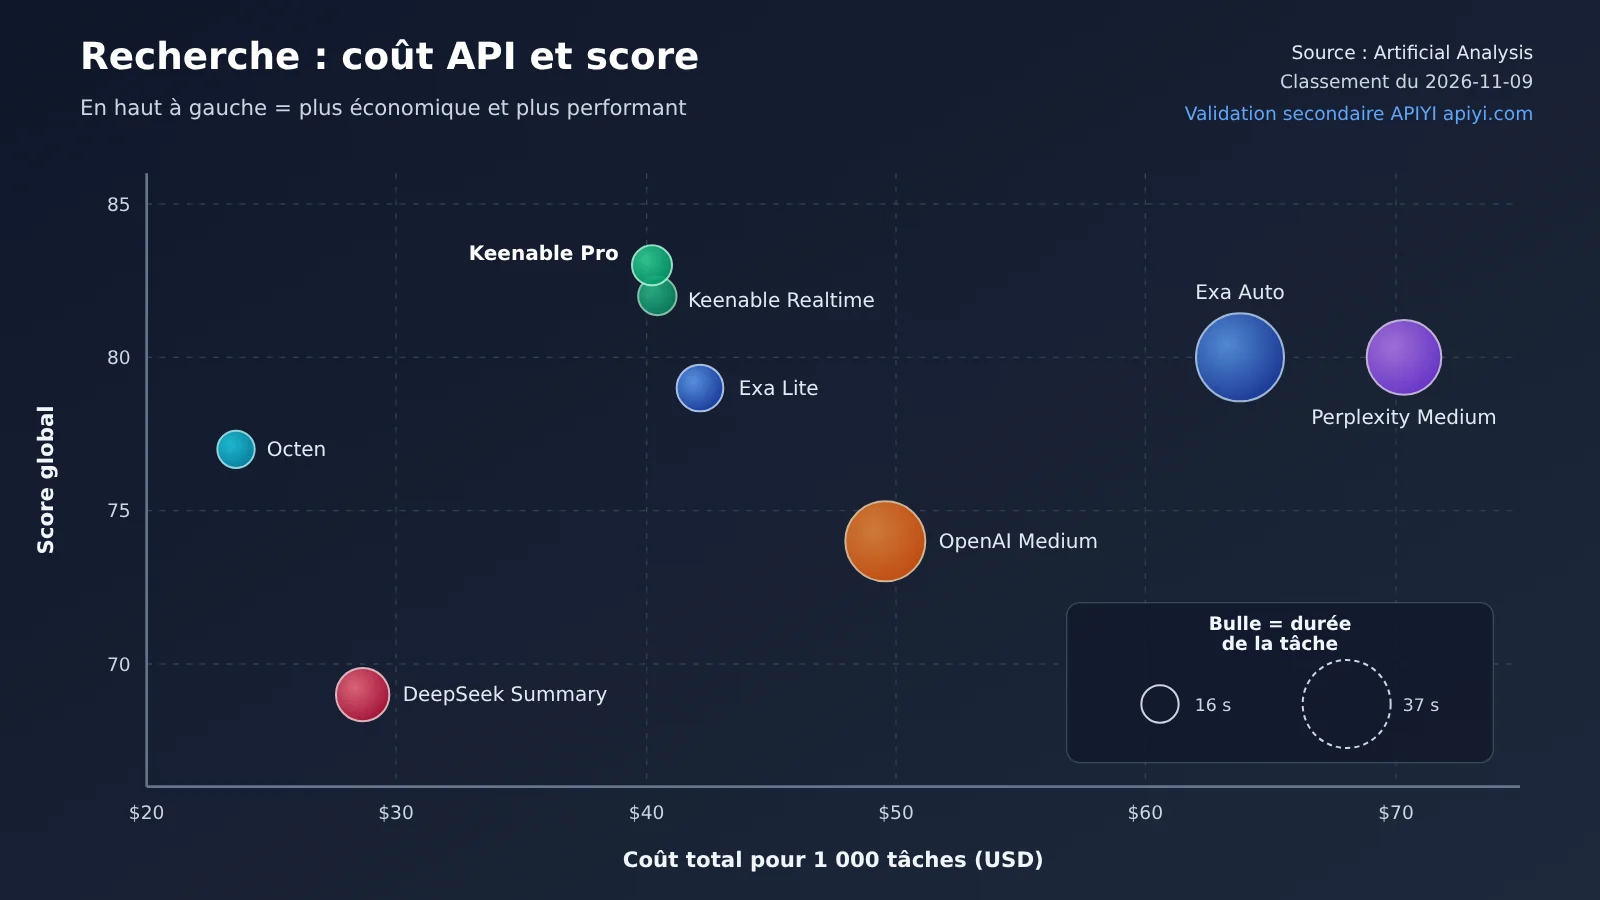
Artificial Analysis publie aussi une estimation du coût pour 1 000 tâches de référence, en le décomposant entre frais de recherche et frais de modèle (classement du 2026-11-09, en dollars américains). La colonne « coût par point » a été calculée approximativement par la rédaction de cet article selon la formule « coût total ÷ score global » ; elle ne sert que de repère en comparatif et ne constitue pas un indicateur officiel.
| Configuration de recherche | Score qualité | Frais de recherche + frais de modèle | Coût total / 1 000 tâches | Coût par point (calcul rédaction) | Durée de la tâche (11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | environ $0.48 | 16.6 s |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | environ $0.49 | 16.0 s |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | environ $0.80 | 36.7 s |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | environ $0.88 | 31.1 s |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | environ $0.53 | 19.4 s |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | environ $0.31 | 15.6 s |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | environ $0.67 | 33.1 s |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | environ $0.42 | 22.4 s |
Trois enseignements à tirer du tableau des coûts des API de recherche
Le meilleur score n’est pas forcément le plus cher. Keenable Pro arrive en tête avec 83 points, pour environ $40.22 les mille tâches, soit à peu près $0.04 par tâche : une position moyenne dans l’échantillon. Perplexity Medium obtient 3 points de moins, mais son coût total dépasse d’environ 75 %.
Un point d’écart peut représenter plus de 30 % de surcoût. Exa Lite + Highlights affiche 79 points pour $42.15 / 1 000 tâches, Exa Auto + Highlights 80 points pour $63.77 / 1 000 tâches : le premier est environ 34 % moins cher, et plus rapide en prime. D’après la page tarifaire officielle d’Exa (données au 2026-11-13), l’offre Lite est à $4 pour 1 000 requêtes et l’offre Auto à $7 pour 1 000 requêtes. Les écarts de frais de recherche observés dans le classement collent bien à cette structure de prix.
Des frais de recherche bas peuvent cacher des frais de modèle plus élevés. DeepSeek Search Summary ne facture que $8.47 de frais de recherche, mais ses frais de modèle atteignent $20.19, le montant le plus élevé du tableau. Octen affiche le coût total le plus bas, mais ses frais de modèle restent supérieurs à ceux de Keenable, Exa et Perplexity. Si les résultats de recherche ne sont pas assez pertinents, l’agent enchaîne les recherches et lit davantage de pages, ce qui fait grimper la consommation de tokens. Mieux vaut donc raisonner en « coût total pour accomplir une tâche » plutôt que de s’arrêter au prix unitaire affiché par l’API de recherche.
Quels choix concrets ce classement Search Index peut-il guider ?
Search Index est une évaluation généraliste de recherche factuelle, principalement en anglais ; ce n’est pas un benchmark spécifique à l’Internet chinois. Nous allons maintenant le mettre en regard des scénarios Agent courants, en signalant ceux dont on peut s’inspirer directement et ceux qui exigent des tests complémentaires.
| Scénario Agent | Indicateurs les plus importants | Utilité du classement comme référence | Candidats recommandés |
|---|---|---|---|
| Questions-réponses factuelles | Taux d’exactitude, taux de citations correctes | Élevée, à consulter directement via AA-Omniscience | Keenable, Exa Lite, Perplexity |
| Recherche complexe multi-sources | Récupération multi-sauts, rappel d’ensemble | Élevée, examiner en priorité DeepSearchQA et BrowseComp | Keenable Pro, Exa Auto, Perplexity Medium |
| Agent à faible latence | Durée complète de la tâche, latence P95 | Moyenne, la durée de la tâche ne peut servir que d’indice | Keenable Realtime, Octen, Exa Lite |
| Recherche d’informations en chinois | Couverture des sources en chinois, accessibilité des sites chinois | Faible, nécessite de créer son propre jeu de tests en chinois | Ajouter Baidu Qianfan, Bocha et Alibaba Cloud Bailian comme points de comparaison |
| Recherche de documentation de programmation | Couverture de la documentation officielle, informations de version | Faible à moyenne, nécessite de retester avec de vraies questions techniques | Exa, Perplexity, Parallel |
Comment utiliser Search Index pour comparer plus finement des API de recherche
L’approche la plus rationnelle consiste à considérer le classement public comme un « outil de présélection », puis à mener un deuxième tour de comparaison avec vos propres tâches :
- Sur la base de trois critères — qualité, durée, coût total — sélectionnez 3 à 4 configurations candidates dans le classement ;
- Préparez 50 à 100 questions issues de votre activité, couvrant des faits simples, des actualités récentes, des questions multi-sauts, des requêtes en chinois et des requêtes multilingues ;
- Fixez le même modèle de réponse, le même nombre maximal de tours et le même nombre de résultats, en ne changeant que l’outil de recherche ;
- Notez le taux d’exactitude, le taux de citations correctes, le coût total par tâche, les temps P50/P95 ainsi que le nombre de résultats vides et de dépassements de délai ;
- La stabilité en production doit faire l’objet de tests de charge à part, car le classement écarte déjà les erreurs fatales après nouvelles tentatives.
Recommandations de choix pour l’API de recherche et prise en main rapide
🎯 Conseil de choix : si vous recherchez la qualité globale et la vitesse, testez en priorité Keenable Pro/Realtime ; si vous êtes sensible au coût tout en voulant une qualité proche de 80 points, Exa Lite + Highlights et Octen méritent d’être testés en priorité ; les équipes déjà bien ancrées dans l’écosystème OpenAI peuvent utiliser directement le Web Search intégré, mais doivent accepter que son déroulé d’exécution ne soit pas maîtrisable. En pratique, nous recommandons de passer par APIYI apiyi.com pour appeler de manière unifiée le modèle de réponse, et de transformer l’outil de recherche en module enfichable : ainsi, changer d’API de recherche ne vous oblige pas à modifier le code côté modèle.
Exemple minimal : le côté modèle passe par une interface unifiée
Le code ci-dessous fixe le modèle de réponse et déclare l’outil de recherche comme une fonction ; c’est dans le code local qu’on remplace l’implémentation par telle ou telle API de recherche :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, modèle interchangeable
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "Recherche en ligne, renvoie au maximum 10 résultats",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Remplacez par le modèle que vous voulez évaluer
    messages=[{"role": "user", "content": "Quel jour Exa 3.0 est-il sorti ?"}],
    tools=tools,
)
print(resp.choices[0].message)
Voir le code complet : comparer en A/B plusieurs API de recherche avec le même modèle
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # Modèle de réponse fixe, pour garder les variables contrôlées
MAX_TURNS = 25          # Plafond de tours identique à celui du Search Index

# Fonctions d'adaptation pour chaque API de recherche, à implémenter d'après la doc officielle
def search_provider_a(query: str) -> list:
    return []  # Renvoie [{"title":..., "url":..., "snippet":...}]

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "Recherche en ligne, renvoie au maximum 10 résultats",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Quand Perplexity a-t-il lancé une Search API indépendante ?", fn))
🚀 Démarrage rapide : les nouveaux utilisateurs peuvent récupérer un quota de test gratuit sur APIYI apiyi.com, faire tourner le script A/B ci-dessus sur quelques questions métier, puis décider quelle API de recherche intégrer à la solution définitive.
FAQ — Questions fréquentes
Q1 : qu’est-ce que le Search Index ?
Le Search Index est un indice d’évaluation des API de recherche lancé par Artificial Analysis. Il fixe le modèle de réponse et le framework d’Agent, ne remplace que le service de recherche, et mesure l’efficacité de la recherche par la moyenne à pondération égale de trois benchmarks — DeepSearchQA, BrowseComp et AA-Omniscience — sur une échelle de 100 points.
Q2 : un score de 83 signifie-t-il un taux de bonnes réponses de 83 % ?
Non. 83 est la moyenne des scores des trois benchmarks, et les indicateurs ne sont pas les mêmes d’un benchmark à l’autre : DeepSearchQA utilise le F1, les deux autres utilisent la précision (accuracy). Pour Keenable Pro, les trois scores valent respectivement 88, 87 et 73, soit une moyenne d’environ 82,67, affichée comme 83.
Q3 : de quand datent les données du classement ?
Les scores de qualité et les données de coût proviennent de la mise à jour du classement du 2026-11-09 ; la durée complète de tâche reprend les valeurs lues le 2026-11-13. Le classement étant mis à jour en continu, il faut préciser la date quand on le cite.
Q4 : la durée indiquée dans le classement peut-elle servir de vitesse de réponse pour une API de recherche ?
Non. La durée du tableau correspond au temps complet d’une tâche standard, incluant les recherches en plusieurs tours, la lecture des pages web et l’inférence du modèle. La latence d’une requête HTTP unique doit être mesurée séparément, de préférence en enregistrant à la fois le P50 et le P95.
Q5 : comment comparer rapidement l’efficacité de différentes API de recherche dans mon propre contexte métier ?
Fixez un modèle de réponse et ne remplacez que l’outil de recherche. Vous pouvez appeler le modèle via APIYI apiyi.com avec une interface compatible OpenAI, en définissant le base_url sur `https://api.apiyi.com/v1`, puis en reprenant le script A/B de cet article. Si vous voulez aussi observer l’évolution de l’efficacité de la recherche après changement de modèle, la même clé API permet de basculer entre OpenAI, Claude, Gemini et autres modèles.
Q6 : quelles sont les limites du Search Index ?
Il y en a principalement quatre : ce n’est pas un benchmark dédié à l’internet chinois ; le déroulement de la recherche native d’OpenAI diffère des autres configurations ; les erreurs 429, 5xx, timeouts et autres, une fois retentées, ne sont pas comptabilisées dans les résultats et ne reflètent donc pas la stabilité en production ; les coûts sont estimés à partir des tâches d’évaluation et peuvent ne pas correspondre à votre facture réelle. Pour la recherche d’actualités chinoises et de documentation technique chinoise, je conseille de construire un jeu de test séparé et de valider conjointement via APIYI apiyi.com avec des modèles chinois.
Search Index : points clés pour choisir une API de recherche
- La recherche est une variable indépendante : pour un même modèle, on passe de 33 à 83 points ; le choix de l’API de recherche influence directement la qualité de l’Agent.
- 83 points ne sont pas un taux d’exactitude : c’est la moyenne à poids égal de trois benchmarks, dont les méthodes de notation diffèrent.
- La durée doit s’apprécier sur la tâche complète : Keenable environ 16 secondes, Exa Auto environ 37 secondes ; il ne s’agit pas de la latence d’un seul appel API.
- Le coût doit être décomposé : des frais de recherche bas peuvent s’accompagner de frais de modèle élevés ; comparez le coût total par tâche.
- 1 point peut représenter 34 % d’écart : Exa Lite et Auto ne diffèrent que d’1 point, mais le premier est environ un tiers moins cher.
- Le classement ne sert que de premier filtre : pour le chinois, la documentation de programmation, etc., il faut refaire un test A/B avec ses propres tâches.
En résumé
Ce qui fait surtout la valeur de ce classement Search Index, c’est sa conception « même modèle, outils de recherche différents », qui permet d’isoler l’impact de la qualité de la recherche sur l’Agent :
- Qualité : sans recherche, 33 points ; au mieux, 83 points. Même avec une recherche branchée, il peut y avoir environ 14 points d’écart entre configurations ;
- Vitesse : à 80 points, la durée d’une tâche complète peut varier de plus de 5 secondes ; une configuration bien notée peut aussi être rapide ;
- Coût : Keenable Pro offre la meilleure qualité pour un coût intermédiaire ; Exa Lite et Octen se distinguent en efficacité-coût ; l’exemple de DeepSeek Summary montre que des frais de recherche faibles ne garantissent pas un coût total faible.
Je recommande de commencer par sélectionner 3 à 4 candidats dans le classement, puis de mener des tests A/B sur votre propre jeu de questions avec un modèle fixe. Pour l’invocation unifiée du modèle de réponse, je recommande de passer par APIYI apiyi.com, en faisant de l’outil de recherche un module interchangeable, puis de choisir la solution finale sur la base de trois indicateurs : qualité, vitesse et coût.
Références
- Classement Artificial Analysis Search API : scores de qualité, coûts et temps d’exécution
- Lien :
artificialanalysis.ai/agents/search-api -
Description : principale source des scores, coûts et temps d’exécution utilisés dans cet article
-
Méthodologie d’évaluation Artificial Analysis Search API : configuration des tests et règles de notation
- Lien :
artificialanalysis.ai/methodology/search-api -
Description : précise les modèles, le nombre de tours, le nombre de résultats, les règles de nouvelle tentative, etc.
-
Exa Pricing : tarifs des paliers Lite, Auto, etc.
- Lien :
exa.ai/pricing -
Description : utile pour comprendre les écarts de frais de recherche entre les différents modes d’Exa dans le classement
-
Annonce Exa 3.0 : mode Lite et Dynamic Highlights
- Lien :
exa.ai/blog/exa-3 -
Description : publiée le 2026-10-19, elle contient des données d’auto-évaluation du fournisseur
-
Documentation OpenAI Web Search : outil de recherche intégré à l’API Responses
- Lien :
developers.openai.com/api/docs/guides/tools-web-search -
Description : pour comprendre le fonctionnement et les paramètres de la recherche native d’OpenAI
-
Tarification de Perplexity Search API : paliers Standard et Fast
- Lien :
docs.perplexity.ai/docs/getting-started/pricing - Description : pour comprendre les règles de facturation par requête
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com