Note de l’auteur : Google a publié Gemini 4 Hydrogen le 12 novembre 2026. Cet article passe en revue le tableau comparatif à 10 critères de la fiche modèle officielle, les améliorations par rapport à Gemini 3.8 Flash, les spécifications et le tarif standard, en précisant pour chaque point la base de calcul des chiffres.
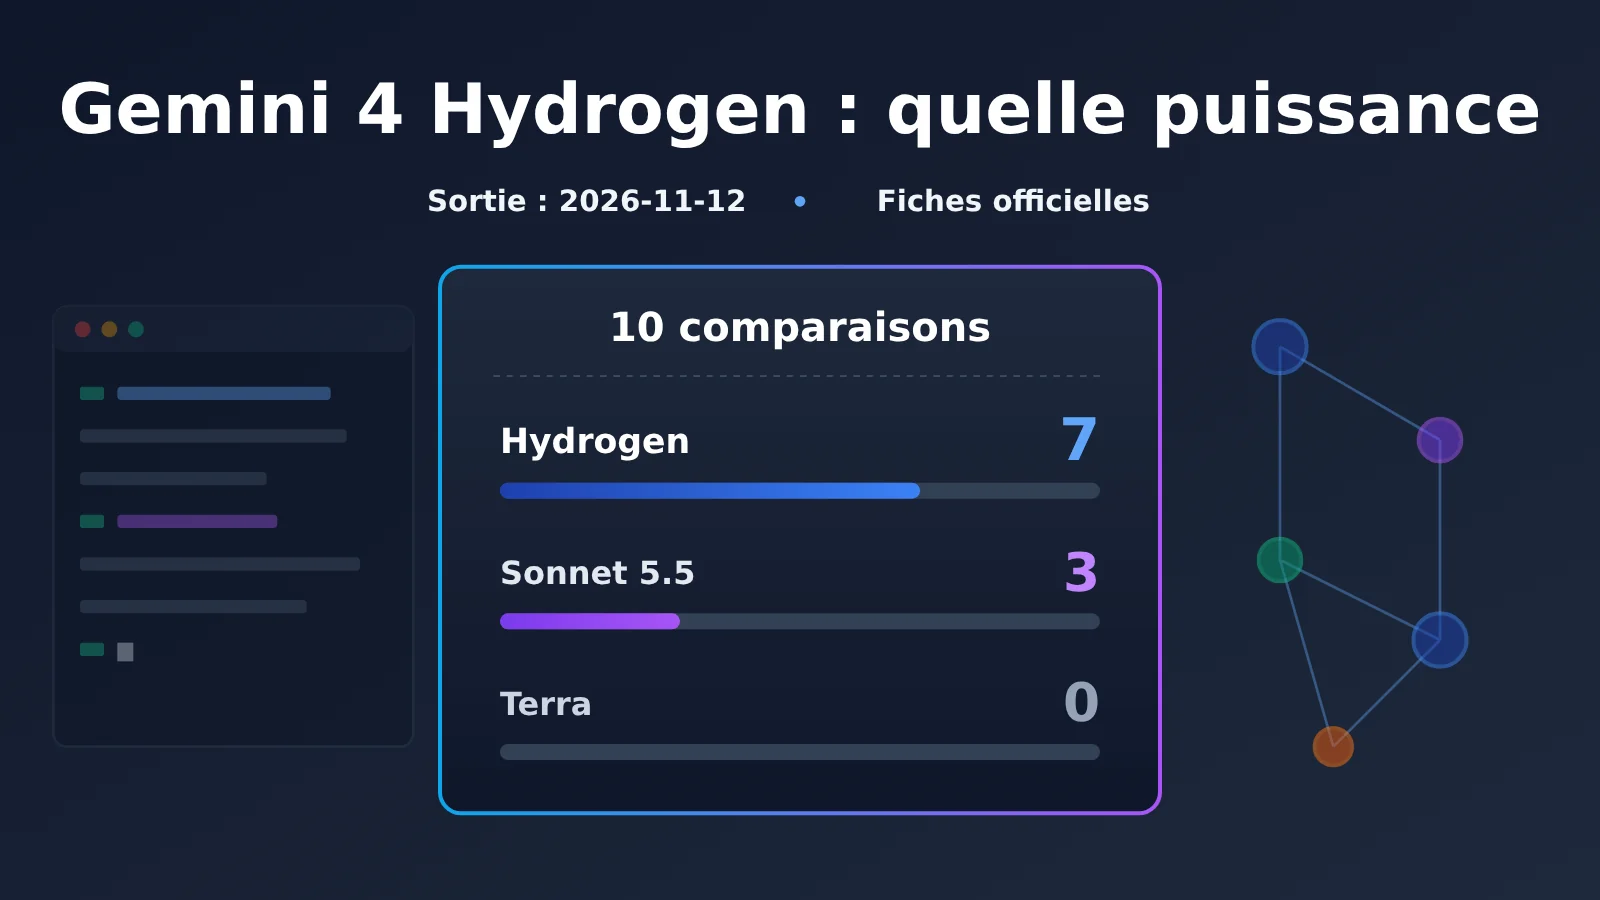
Google a officiellement publié Gemini 4 Hydrogen le 12 novembre 2026, avec l’ID de modèle gemini-4-hydrogen. Son positionnement : un codage quotidien plus rapide et l’exécution de divers agents, pas un modèle comme Carbon ou Argon chargé des raisonnements longs et les plus difficiles. Le tarif standard mondial officiel est de $1.50 en entrée et $7.50 en sortie (par million de tokens). Dans le tableau comparatif à 10 critères de la fiche modèle DeepMind, il obtient le meilleur score sur 7 d’entre eux.
Il ne s’agit pas d’une rumeur de nom de code d’avant lancement. Le blog de Google, le brief destiné aux développeurs et la fiche modèle DeepMind sont déjà en ligne, et le lien d’essai dans AI Studio utilise bien l’ID gemini-4-hydrogen. Précisons que tous les scores cités dans cet article proviennent d’autodéclarations officielles ou de la synthèse de la fiche modèle officielle, et non de re-tests menés par APIYI.
L’essentiel : après la lecture, vous saurez sur quelles tâches Gemini 4 Hydrogen est en avance et sur lesquelles il est en retard par rapport à Claude Sonnet 5.5, ainsi que comment lire ces chiffres.
Gemini 4 Hydrogen : l’essentiel en un coup d’œil
Commençons par les faits. Les informations du tableau ci-dessous proviennent du blog Google, des notes aux développeurs et de la fiche modèle DeepMind (publiée en novembre 2026) ; vérification effectuée le 2026-11-13.
| Élément | Détails de Gemini 4 Hydrogen |
|---|---|
| Date de sortie | 2026-11-12, déploiement mondial dès ce jour |
| Éditeur | Google / Google DeepMind |
| ID du modèle | gemini-4-hydrogen |
| Origine | La fiche modèle précise « adapted from Gemini 4 Carbon », autrement dit un dérivé de Carbon |
| Positionnement officiel | Codage quotidien, exécution d’agents ; utilisable seul ou comme moteur d’exécution dans des workflows multi-modèles |
| Niveaux de réflexion | low, medium, high (par défaut), xhigh — soit quatre niveaux |
| Coupure des connaissances | Mars 2026, certaines domaines pouvant être plus anciens |
| Canaux officiels | AI Studio (tous les niveaux), Gemini API, Android Studio, Gemini for business, Gemini App, Google Search |
Google décrit assez franchement la répartition des rôles dans la famille Gemini 4 : Carbon et Argon se chargent du raisonnement longue portée le plus difficile, Hydrogen des tâches quotidiennes plus rapides. Il n’est donc pas pertinent de comparer Hydrogen et Carbon comme s’il s’agissait de « l’ancienne et la nouvelle version d’un modèle de même niveau ». Leur relation ressemble plutôt à deux spécialisations reposant sur un même socle.
Côté canaux d’accès, les utilisateurs payants de Google AI Pro / Ultra peuvent aussi utiliser Hydrogen dans Google Antigravity. Sheets l’ouvre d’abord aux offres Pro / Ultra et aux abonnements entreprise éligibles. AI Studio confirme officiellement l’accès à tous les niveaux ; les limites précises du niveau gratuit n’ont pas été vérifiées cette fois, on ne s’y attarde donc pas ici.
Les quatre niveaux de réflexion de Gemini 4 Hydrogen
Les quatre niveaux de réflexion sont un point d’usage important de Hydrogen. Selon la communication officielle, la qualité, la latence et le coût augmentent de façon progressive et régulière d’un niveau à l’autre, ce qui permet aux développeurs de ne payer que pour la profondeur de raisonnement dont ils ont besoin. Le niveau par défaut est high, ce qui a un impact direct sur la facture — on y revient dans la partie sur les prix plus bas.
Tableau comparatif officiel des 10 benchmarks de Gemini 4 Hydrogen
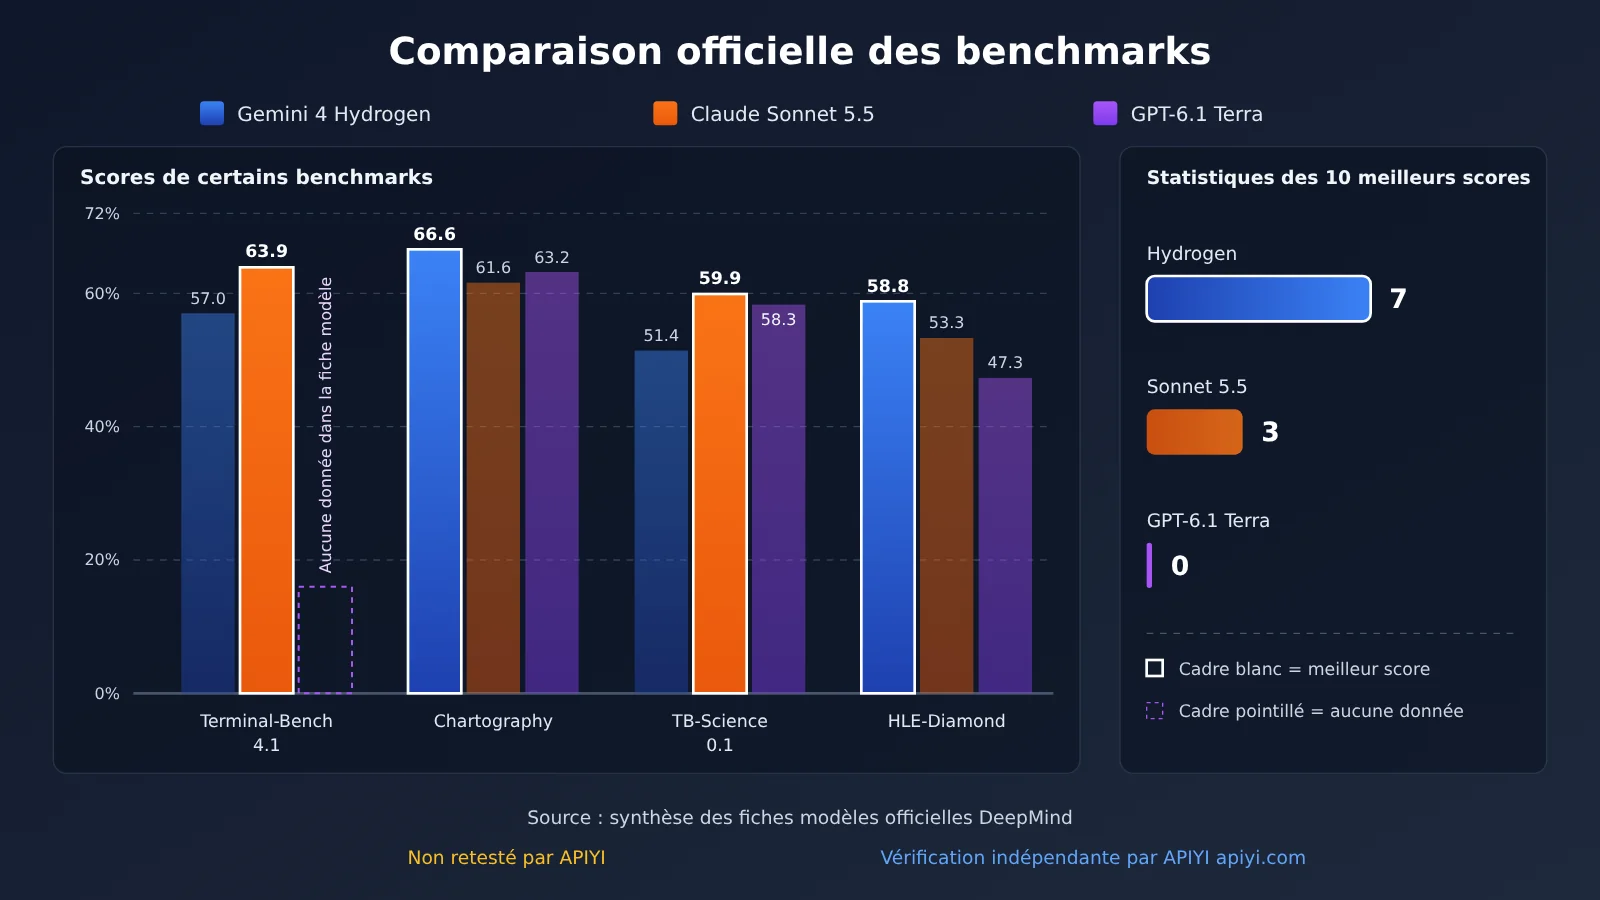
C’est le cœur de cet article. La carte modèle de DeepMind fournit un tableau comparatif de 10 benchmarks, avec Gemini 4 Hydrogen, Claude Sonnet 5.5 et GPT-6.1 Terra.
| Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Meilleur |
|---|---|---|---|---|
| SWE-sweep | 13,5 % | 3,1 % | 5,8 % | Hydrogen |
| Terminal-Bench 4.1 (ajusté pour la triche) | 57,0 % | 63,9 % | Aucune donnée | Sonnet |
| Agents’ Last Exam v1.1 | 71,6 % | 60,4 % | 69,8 % | Hydrogen |
| AutomationBench-AA | 76,1 % | 71,8 % | 60,2 % | Hydrogen |
| Vending-Bench 2 (solde du compte, USD) | 14549 | 11165 | 9107 | Hydrogen |
| OSWorld-2.1 (sous-ensemble hors ligne) | 77,6 % | 83,9 % | 74,2 % | Sonnet |
| MKA (précision Climb WSR) | 53,4 % | 52,0 % | 43,8 % | Hydrogen |
| Chartography | 66,6 % | 61,6 % | 63,2 % | Hydrogen |
| Terminal-Bench-Science 0.1 | 51,4 % | 59,9 % | 58,3 % | Sonnet |
| HLE-Diamond | 58,8 % | 53,3 % | 47,3 % | Hydrogen |
Le décompte est le suivant : Hydrogen arrive en tête sur 7 épreuves, Sonnet 5.5 sur 3 — Terminal-Bench 4.1, OSWorld-2.1 (utilisation de l’ordinateur) et Terminal-Bench-Science. GPT-6.1 Terra ne décroche la première place dans aucune case où un score est renseigné.
Deux points méritent une attention particulière. Premièrement, la case Terminal-Bench 4.1 est vide pour Terra : la carte modèle ne donne aucun chiffre, on ne peut donc pas en conclure que « Terra est moins performant sur les tâches de terminal ». Deuxièmement, « 7 victoires sur 10 » ne veut pas dire supériorité totale : Hydrogen reste derrière Sonnet 5.5 sur les tâches de terminal et d’utilisation de l’ordinateur, deux catégories très liées à l’exécution par un agent.
Comment lire ce tableau comparatif de Gemini 4 Hydrogen
La méthodologie décrite dans la carte modèle détermine jusqu’où on peut interpréter ce tableau. Sauf mention contraire, les scores de Hydrogen correspondent au niveau de réflexion maximal, pass@1, une seule tentative, exécutée via l’API Gemini. Pour Sonnet 5.5 et GPT-6.1 Terra, on prend par défaut leur niveau maximal public de réflexion ou d’inférence ; quand aucun résultat public n’est disponible, on utilise le meilleur résultat accessible.
Autrement dit, il ne s’agit pas d’une réexécution des trois modèles le même jour avec le même script. Le cas de SWE-sweep est particulièrement explicite : les scores des concurrents proviennent de classements publics, Google ne les a pas retestés avec le même harnais. Ce tableau permet donc de dégager une tendance générale, pas de traiter chaque écart de point de pourcentage comme une conclusion exacte.
Autre point à garder en tête : Hydrogen est ici évalué au niveau de réflexion maximal, alors que son niveau par défaut est « high ». Si vous utilisez le niveau par défaut en production, les performances réelles peuvent différer des chiffres du tableau — cela vaut la peine d’être vérifié sur vos propres tâches.
Ce que Gemini 4 Hydrogen apporte par rapport à Gemini 3.8 Flash
Pour les développeurs qui utilisent déjà Gemini 3.8 Flash, cette section vaut peut-être plus la peine que la comparaison transversale. Tous les chiffres ci-dessous sont des chiffres officiels communiqués par Google.
| Dimension | Gemini 3.8 Flash | Gemini 4 Hydrogen | Commentaire |
|---|---|---|---|
| Vitesse d’exécution des tâches (niveau high par défaut) | référence | 2,5 fois plus rapide | chiffre officiel |
| Terminal-Bench 4.1 | 18,2 % | 57 % | plus du triple |
| Affirmations inventées | référence | réduites de plus de 5 fois | chiffre officiel |
| Quand un outil échoue / que la recherche ne renvoie rien | — | change de cap de sa propre initiative | description qualitative officielle |
| Vitesse en test anticipé chez les partenaires | référence | 2 à 2,8 fois plus rapide | graphiques, SQL, workflows gourmands en données |
| Consommation de tokens en test anticipé chez les partenaires | référence | 12 % à 23 % de moins | rapporté par Google, pas un classement public |
Le bond des tâches en terminal, de 18,2 % à 57 %, est le changement le plus visible de cette annonce. Il montre que Hydrogen a franchi un seuil d’utilisabilité sur la question « un petit modèle peut-il vraiment exécuter des tâches en ligne de commande ? ». Mais si on le remet dans le tableau comparatif, 57 % reste sous les 63,9 % de Sonnet 5.5.
Les données de test anticipé des partenaires doivent aussi être lues à part. Ce sont des résultats de partenaires rapportés par Google, pas un classement public, et les scénarios portent sur des graphiques complexes, du SQL et des workflows gourmands en données : ils ne se transposent pas forcément à toutes les activités.
Les autres résultats officiels de Gemini 4 Hydrogen
Au-delà du tableau à 10 entrées, le blog et la fiche modèle citent quelques résultats supplémentaires, également officiels :
- Artificial Analysis Intelligence Index : 51 au niveau high par défaut, 50 pour Argon, et 54 pour le niveau xhigh. Ce sont les chiffres d’AA cités par Google. Carbon avait annoncé 59 points sur AA Index v5, mais l’annonce ne dit pas si Hydrogen utilise la même version de l’index : mieux vaut ne pas soustraire directement les deux.
- Agent Arena : 5e place au classement des tâches agent ouvertes.
- Vals Tax Agent Bench : 52,3 %, que Google présente comme la 1re place au classement général.
- Vals Legal Research Bench : 55,8 %, ex æquo à la 1re place selon Google.
- HLE-Diamond : 58,8 %, en tête de sa catégorie selon Google.
Le rôle de Gemini 4 Hydrogen dans les workflows multi-modèles
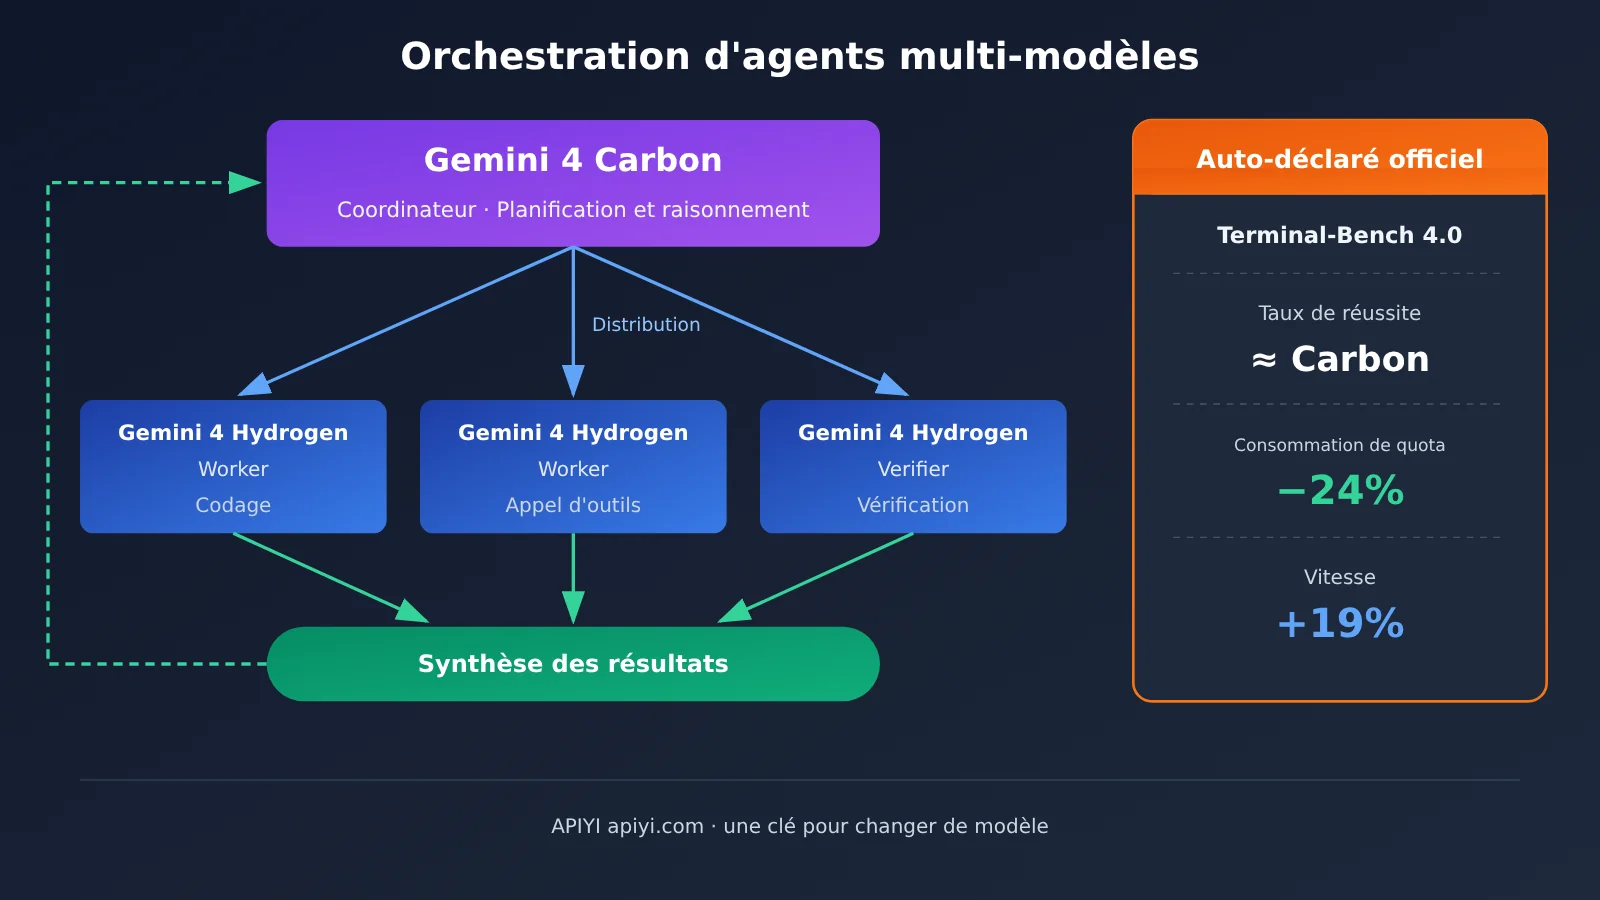
Google a aussi publié des chiffres sur l’usage combiné. Dans Antigravity Orchestrator, le système bascule entre Carbon et Hydrogen : sur Terminal-Bench 4.0, le taux de réussite des tâches est proche de celui du Carbon seul, avec en moyenne 24 % de quota en moins et 19 % de rapidité en plus. En mode parallèle, Carbon joue le coordinateur, Hydrogen le worker ou le verifier.
Ces chiffres disent assez bien ce que Google veut faire de Hydrogen : il ne s’agit pas de remplacer Carbon, mais d’absorber une grande partie de l’exécution concrète, en réservant le raisonnement coûteux aux étapes qui en ont vraiment besoin.
Spécifications et tarifs de Gemini 4 Hydrogen
Fenêtre de contexte : deux versions, fiche modèle et blog
Sur ce point, la fiche modèle et le blog ne disent pas exactement la même chose. Voici les deux versions côte à côte :
- Fiche modèle : fenêtre de contexte entrée-sortie combinée allant jusqu’à 1M (combined input-output token context window of up to 1M), soit un maximum de 1 million de tokens en entrée et en sortie confondues ; un appel synchrone produit par défaut jusqu’à 64 000 tokens en sortie ; le long decode en arrière-plan peut produire jusqu’à 1 million de tokens en sortie.
- Blog : 1 million de tokens en entrée natif, et jusqu’à 1 million de tokens en sortie.
En développement, mieux vaut budgéter selon la lecture plus prudente de la fiche modèle — la fenêtre « combinée » — et garder en tête la limite par défaut de 64 000 tokens en sortie pour les appels synchrones. Les sorties très longues doivent passer par le long decode en arrière-plan. Côté modalités d’entrée, Hydrogen prend en charge le texte, les images, l’audio et la vidéo.
Tarifs officiels du niveau standard de Gemini 4 Hydrogen
Le blog parle d’un tarif unique pour toute la fenêtre de 1 million de tokens. Le tableau ci-dessous vient de la page tarifaire de Google Cloud (consultée le 13/11/2026) ; il ne présente que le niveau standard, en dollars US par million de tokens.
| Élément de facturation | Niveau standard mondial | Non mondial |
|---|---|---|
| Entrée (texte, images, vidéo, audio) | $1.50 | $1.65 |
| Lecture du cache | $0.075 | $0.0825 |
| Sortie (réponse et raisonnement combinés) | $7.50 | $8.25 |
| Écriture du cache | Prix affiché $1.875, facturation à partir du 12/01/2027 | — |
Un point qu’on oublie facilement : le prix de sortie couvre ensemble la réponse et le raisonnement. Hydrogen utilise par défaut le niveau de réflexion high, donc la facture de sortie inclut les tokens de réflexion. La fiche modèle rappelle aussi que des niveaux de réflexion plus élevés peuvent consommer davantage de tokens. Pour les tâches simples, on peut envisager de descendre à low ou medium pour maîtriser les coûts.
Où appeler Gemini 4 Hydrogen aujourd’hui
Côté canaux officiels, Google AI Studio et l’API Gemini sont déjà disponibles ce jour-là. Chez APIYI, nous avons vérifié le 2026-11-13 le tableau général de la documentation docs.apiyi.com/models, la page du modèle ainsi que l’interface de tarification api.apiyi.com/api/pricing : gemini-4-hydrogen n’y figure pas, la page du modèle renvoie une erreur 404, et une recherche sur « hydrogen » parmi les 282 modèles de l’interface tarifaire du jour ne donne aucun résultat. Le modèle n’est donc pas encore référencé ; nous le mettrons en ligne dès que possible. Les modèles et les prix font foi sur la liste des modèles de la plateforme.
Avant la mise en ligne de Hydrogen, APIYI apiyi.com permet déjà d’appeler les deux concurrents du tableau à 10 entrées, ainsi que Carbon, le « parent » de Hydrogen — de quoi mettre en place dès maintenant le processus de comparaison :
| ID du modèle | Entrée | Sortie | Lecture cache | Point de terminaison | Plateforme disponible |
|---|---|---|---|---|---|
gemini-4-carbon |
$2 | $10 | $0.1 | chat, gemini | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | chat, messages | APIYI |
gpt-6.1-terra |
$1 | $5 | $0.05 | responses (recommandé), chat | APIYI |
Une précision sur le prix de Carbon : la documentation d’APIYI indique que $2 / $10 correspond au prix promotionnel temporaire de Google, valable jusqu’au 2026-11-30 ; à partir du 2026-12-01, il s’alignera sur l’ajustement officiel à $4 / $20, avec une lecture cache à $0.10.
L’intégration passe par une interface compatible OpenAI : il suffit de définir base_url sur https://api.apiyi.com/v1 et de renseigner le champ modèle avec gemini-4-carbon, claude-sonnet-5-5 ou gpt-6.1-terra. Une fois Hydrogen disponible, il suffira de remplacer le champ modèle par gemini-4-hydrogen pour reproduire, dans le même code, les types de tâches couverts par le tableau à 10 entrées ci-dessus.
🎯 Conseil technique : les scores des concurrents dans les fiches modèles officielles proviennent des résultats publics de chaque fournisseur et ne correspondent pas forcément à votre contexte métier. Je vous conseille de comparer d’abord Sonnet 5.5 et Terra via APIYI apiyi.com sur un même lot de tâches réelles, puis d’ajouter une colonne une fois Hydrogen disponible, pour obtenir votre propre tableau des vainqueurs.
Analyse d’impact de Gemini 4 Hydrogen
Conséquences pour les développeurs
- Une option de plus au niveau de la couche d’exécution des agents : sur des tâches d’agent comme AutomationBench-AA, Agents’ Last Exam ou Vending-Bench 2, les résultats officiels de Hydrogen sont en tête, ce qui en fait un bon candidat pour prendre en charge une grande partie des étapes d’exécution dans un workflow.
- Les opérations sur terminal et sur ordinateur restent à évaluer : sur Terminal-Bench 4.1 et OSWorld-2.1, c’est Sonnet 5.5 qui mène. Si votre cœur de métier, ce sont les agents en ligne de commande ou l’automatisation du bureau, ne vous contentez pas d’un « 7 victoires ».
- Les utilisateurs de 3.8 Flash ont intérêt à évaluer une migration : vitesse, taux de réussite sur terminal et taux de fabrication s’améliorent nettement selon les chiffres officiels, mais il faut le confirmer avec vos propres données.
- Le coût dépend du palier de réflexion : le palier
highpar défaut facture les tokens de réflexion en sortie, et le choix du palier détermine directement la facture.
Conséquences sur la répartition des rôles entre modèles
La sortie de Hydrogen renforce encore l’usage en couches « coordinateur + exécutant ». Les données officielles d’Orchestrator montrent qu’en confiant l’exécution à un modèle bon marché et la planification à un modèle plus cher, on obtient un taux de réussite proche en économisant du quota. Autrement dit, l’orchestration multi-modèles passe du statut d’approche expérimentale à celui de recommandation officielle des éditeurs, et une couche d’accès capable de basculer d’un modèle à l’autre de façon unifiée va devenir de plus en plus importante.
Limites connues de Gemini 4 Hydrogen
Sans esquiver les points faibles, la carte de modèle liste ces limites :
- Le modèle produit encore des hallucinations ; il peut ralentir ou dépasser le délai d’attente ; les paliers de réflexion élevés consomment davantage de tokens ; les connaissances s’arrêtent en mars 2026.
- Sur l’évaluation automatique de sécurité, deux indicateurs se dégradent par rapport à 3.8 Flash : le ton du refus recule de 0,65 point de pourcentage, et la proportion de refus dans les cas où il ne faudrait pas refuser augmente de 5,57 points de pourcentage (plus ce chiffre est bas, mieux c’est).
- Côté sécurité de pointe, aucun saut de capacité majeur par rapport à Argon ; ni le CBRN ni la cybersécurité n’atteignent le CCL, mais le seuil d’alerte est franchi. Cela ne signifie pas pour autant qu’il n’existe « aucun risque associé ». Le rapport de sécurité complet sera publié plus tard, selon l’éditeur.
Les chiffres positifs existent aussi : les comportements hors limites des agents diminuent jusqu’à 81 %, l’évaluation interne d’honnêteté atteint 96,7 %, la résistance à l’injection indirecte d’invite de Gray Swan progresse de plus de 2,3 fois, et le taux de refus erroné sur HealthBench Pro est inférieur à 0,4 %. Là encore, ce sont des chiffres auto-déclarés par l’éditeur.
FAQ — Questions fréquentes
Q1 : Quel est ce modèle, Gemini 4 Hydrogen ?
C’est un membre de la famille Gemini 4, publié par Google le 2026-11-12, dont l’ID de modèle est `gemini-4-hydrogen`. Il dérive de Gemini 4 Carbon et se positionne comme un modèle plus rapide pour le codage au quotidien et l’exécution d’agents. Le raisonnement longue portée le plus difficile reste confié à Carbon et Argon.
Q2 : Entre Gemini 4 Hydrogen et Claude Sonnet 5.5, lequel est le plus fort ?
D’après les 10 tableaux de la fiche modèle officielle, Hydrogen l’emporte sur 7 catégories et Sonnet 5.5 sur 3 ; les points forts de Sonnet se concentrent sur les tâches en terminal, l’utilisation de l’ordinateur et le terminal scientifique. Les scores des concurrents correspondent aux résultats publics de leur niveau de réflexion le plus élevé, et non à une réexécution avec le même script. Le mieux est de faire vos propres tests comparatifs sur vos tâches via APIYI apiyi.com.
Q3 : Ce « 7 victoires sur 10 » vient-il d’un test tiers ?
Non. Il s’agit du récapitulatif officiel de la fiche modèle de DeepMind, avec Hydrogen au niveau de réflexion maximal et en pass@1, une seule tentative. Ce n’est pas non plus un résultat de re-test d’APIYI : il faut le prendre pour des données auto-déclarées par l’éditeur.
Q4 : Dans quels cas Gemini 4 Hydrogen est-il le plus adapté ?
Les scénarios où les résultats officiels sont les meilleurs incluent : les workflows d’automatisation multi-étapes (AutomationBench-AA), la compréhension de graphiques (Chartography), les agents de connaissances multimodaux (MKA), ainsi que les rôles de worker ou de verifier dans les pipelines multi-modèles. Pour les agents en ligne de commande et les manipulations du bureau, nous conseillons d’évaluer aussi Sonnet 5.5.
Q5 : Peut-on déjà appeler Gemini 4 Hydrogen via APIYI ?
Au 2026-11-13, le modèle n’est pas encore listé ; nous le mettrons en ligne dès que possible, le nom du modèle et le prix étant ceux de la liste des modèles de la plateforme. En attendant, vous pouvez appeler `gemini-4-carbon`, `claude-sonnet-5-5` et `gpt-6.1-terra` sur APIYI apiyi.com, avec `base_url` réglé sur `https://api.apiyi.com/v1`, histoire de mettre en place votre processus de comparaison.
Q6 : Pourquoi la sortie de Gemini 4 Hydrogen peut-elle coûter plus cher que prévu ?
Le prix officiel de sortie de $7.50 facture ensemble la réponse et le raisonnement, et comme le niveau de réflexion par défaut est high, les tokens de réflexion atterrissent sur la facture de sortie. Pour les tâches simples, vous pouvez basculer sur low ou medium pour maîtriser les coûts.
Gemini 4 Hydrogen : les points clés à retenir
- Positionnement clair : publié le 12/11/2026, axé sur le codage au quotidien et l’exécution d’agents, dérivé de Carbon.
- Tableau officiel : 7 victoires sur 10 : Sonnet 5.5 remporte 3 catégories (terminal, contrôle d’ordinateur, terminal scientifique), Terra n’obtient aucune première place.
- Attention aux méthodologies : les scores sont auto-déclarés par l’éditeur, ceux des concurrents proviennent de leurs résultats publics au niveau de réflexion maximal, et non d’un nouveau passage avec le même script.
- Un saut net par rapport à 3.8 Flash : 2,5 fois plus rapide, Terminal-Bench 4.1 passe de 18,2 % à 57 %.
- Tarif du niveau standard : 1,50 $ en entrée et 7,50 $ en sortie au niveau mondial, les tokens de réflexion étant inclus dans la sortie.
- Deux versions pour la fenêtre : la fiche modèle indique 1 million au total ; le blog parle de 1 million en entrée et jusqu’à 1 million en sortie.
- Disponibilité actuelle : pas encore référencé sur APIYI ; en attendant, vous pouvez monter une comparaison avec Carbon, Sonnet et Terra sur apiyi.com.
En résumé
Les points clés de Gemini 4 Hydrogen :
- Fort sur l’exécution d’agents : 7 victoires sur les 10 lignes du tableau officiel, en tête sur l’automatisation, l’examen pour agents, les graphiques et HLE-Diamond.
- Plus faible sur le terminal et le contrôle d’ordinateur : Terminal-Bench 4.1, OSWorld-2.1 et le terminal scientifique — trois catégories où Claude Sonnet 5.5 fait mieux.
- Des chiffres à lire selon la méthodologie : tout vient de déclarations officielles ou de synthèses de fiches modèle ; les scores des concurrents proviennent de résultats publics, pas d’un passage effectué en même temps.
Si vous travaillez sur des workflows d’agents, Hydrogen mérite une place dans votre liste de candidats, en particulier comme couche d’exécution dans un pipeline multi-modèles. Au final, c’est le résultat sur vos propres tâches qui tranchera. Le conseil : établissez d’abord une base avec Carbon, Sonnet 5.5 et Terra via APIYI (apiyi.com) ; dès que Hydrogen sera disponible, il suffira de compléter les tests.
📚 Références
- Blog Google : Introducing Gemini 4 Hydrogen : annonce de lancement et positionnement
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen -
Description : positionnement officiel, AA Index, amélioration par rapport à 3.8 Flash
-
Brève développeurs Google : Build with Gemini 4 Hydrogen : informations d’intégration pour les développeurs
- Lien :
blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-4-hydrogen -
Description : canaux disponibles et informations destinées aux développeurs
-
Fiche modèle DeepMind : Gemini 4 Hydrogen : spécifications, tableau comparatif de 10 points, évaluation de sûreté
- Lien :
deepmind.google/models/model-cards/gemini-4-hydrogen -
Description : source principale du tableau de 10 points et des limitations présentés dans cet article
-
Méthodologie d’évaluation DeepMind : cadre méthodologique du tableau comparatif
- Lien :
deepmind.google/models/evals-methodology/gemini-4-hydrogen -
Description : niveaux de réflexion, pass@1, origine des scores des concurrents
-
Page tarifaire Google Cloud : prix du niveau standard
- Lien :
cloud.google.com/vertex-ai/generative-ai/pricing - Description : tarif unitaire du niveau standard global et non global, date d’entrée en vigueur des écritures de cache
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; davantage de ressources sont disponibles sur le centre de documentation docs.apiyi.com