Nota do autor: este artigo separa, por rótulo de origem, as três contas de Gemini 4 Neon e GPT-6.2 Astra — pontuação de inteligência, tempo por tarefa, preço unitário e custo por tarefa — e lista o preço de tabela, as faixas e o endereço de invocação dos modelos já disponíveis na APIYI.
Em 18 de novembro de 2026, o Google lançou o Gemini 4 Neon. Naquele dia, Sundar Pichai anunciou que ele começava a ser liberado no Gemini API do Google AI Studio, no Gemini for business, no Google Antigravity e no Gemini App. No mesmo dia, um artigo do Artificial Analysis colocou o Neon xhigh em 3º lugar no índice geral de inteligência, com apenas GPT-6.2 Astra (max) e Claude Fable 5.2 (max) à frente. Quando se colocam Neon e Astra lado a lado, o que mais se confunde é preço unitário com custo por tarefa: o primeiro é o preço de tabela por milhão de tokens; o segundo é o dinheiro que de fato se gasta para resolver uma questão.
As três contas abaixo vêm todas da página de modelo do Artificial Analysis (leitura em 2026-11-19, índice v5.0.1), com o nível indicado entre parênteses; níveis diferentes aparecem em linhas separadas:
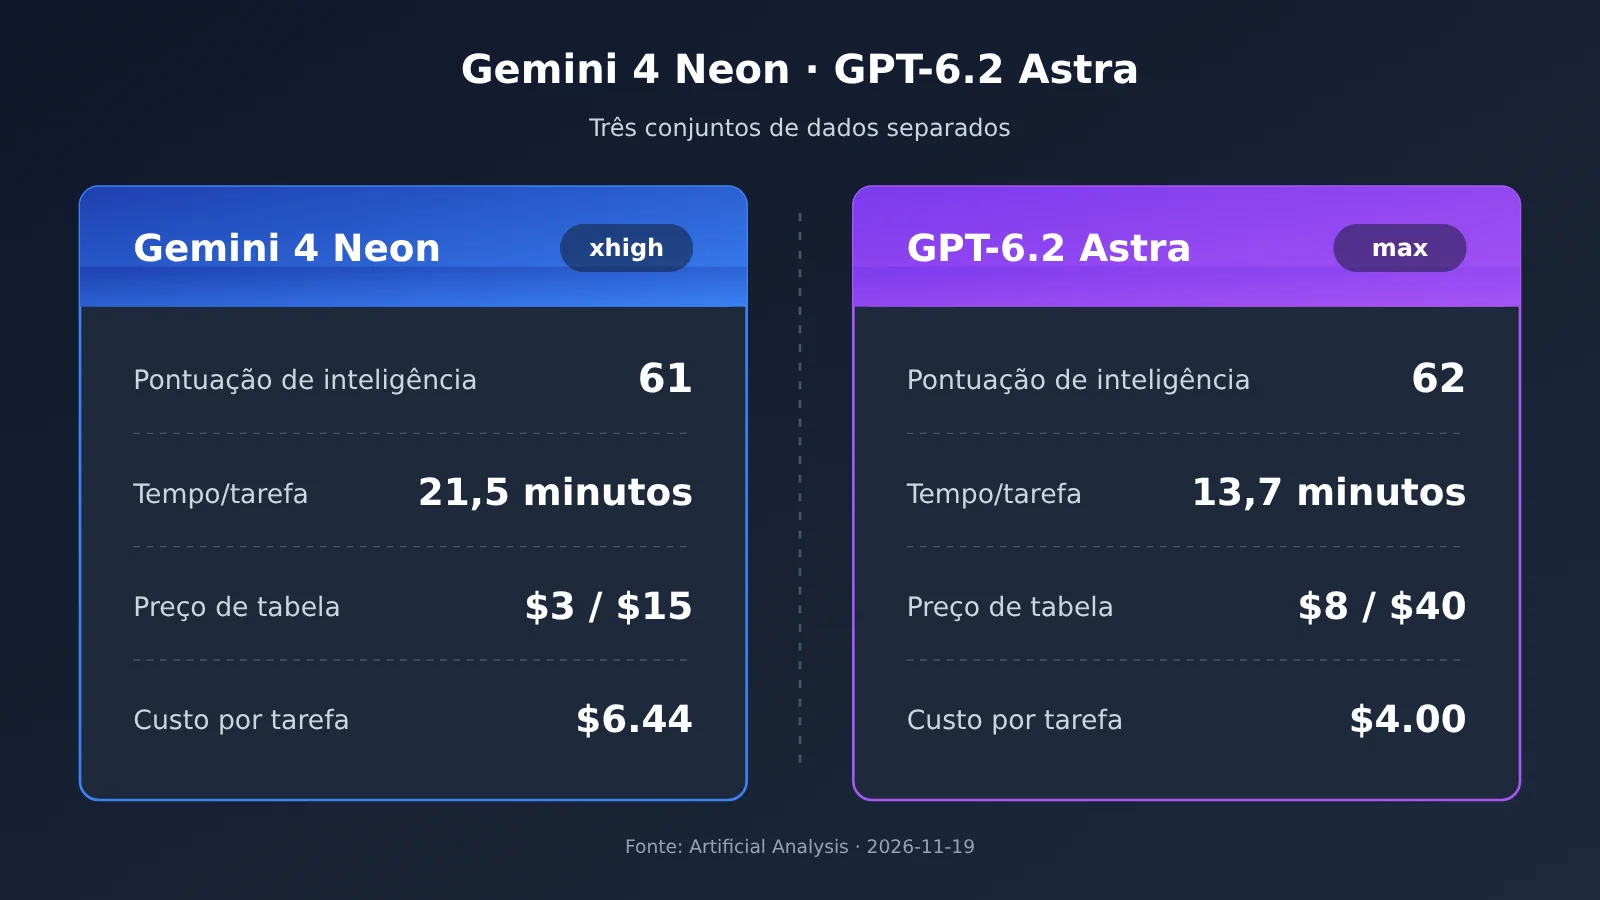
- Pontuação de inteligência: GPT-6.2 Astra (max) 62, Gemini 4 Neon (xhigh) 61. O nível xhigh do Astra também é 62.
- Tempo por tarefa: Astra (max) 13.7 minutos, Astra (xhigh) 7.4 minutos, Neon (xhigh) 21.5 minutos.
- Preço unitário e custo por tarefa: o Astra tem preço de tabela de 8 na entrada e 40 na saída (USD por milhão de tokens); o Neon, 3/15. O custo por tarefa do Astra (max) é 4.00 USD, e o do Neon (xhigh), 6.44 USD.
O que faz preço unitário e custo por tarefa caminharem em direções opostas é o consumo de tokens. Ao rodar o mesmo conjunto de índices, o Astra (max) gerou 65,8 milhões de tokens de saída, e o Neon (xhigh), 283 milhões; em velocidade, o Neon faz cerca de 110 tokens por segundo e leva 56.51 segundos até o primeiro token da resposta, enquanto o Astra faz 50 tokens por segundo e leva 197.65 segundos até o primeiro token. Este artigo só se encarrega de organizar esses números em colunas; qual conta importa mais para você depende da estrutura das suas tarefas.
Valor central: depois de ler este artigo, você vai saber de qual conta e de qual nível vem cada número de Gemini 4 Neon e GPT-6.2 Astra, e vai saber quais modelos dá para chamar diretamente na APIYI e onde o preço muda de faixa.
Diferenças centrais entre Gemini 4 Neon e GPT-6.2 Astra
A tabela abaixo vem toda da página de modelo do Artificial Analysis: Neon usa xhigh e Astra usa max, que são os níveis máximos nas duas páginas. A tabela comparativa do model card do DeepMind traz apenas três colunas — Gemini 4 Neon, Claude Opus 5.5 e GPT-6.2 Sol — e não inclui Astra; por isso, o lado do Astra usa somente os números da página de modelo do Artificial Analysis.
| Dimensão de comparação | Gemini 4 Neon (xhigh) | GPT-6.2 Astra (max) | Fonte |
|---|---|---|---|
| Pontuação de inteligência | 61 | 62 (xhigh também é 62) | Página de modelo do Artificial Analysis |
| Tempo por tarefa | 21,5 minutos | 13,7 minutos (xhigh é 7,4 minutos) | Página de modelo do Artificial Analysis |
| Preço de tabela (entrada/saída, USD/milhão de tokens) | 3,00 / 15,00 | 8,00 / 40,00 | Página de modelo do Artificial Analysis |
| Custo por tarefa | 6,44 USD | 4,00 USD | Página de modelo do Artificial Analysis |
| Tokens de saída no índice de execução | 283 milhões | 65,8 milhões | Página de modelo do Artificial Analysis |
| Velocidade de saída | 110 tokens/segundo | 50 tokens/segundo | Página de modelo do Artificial Analysis |
| Primeiro token da resposta | 56,51 segundos | 197,65 segundos | Página de modelo do Artificial Analysis |
| Desconto de cache / preço misto | 95% / 2,21 | 95% / 5,88 | Página de modelo do Artificial Analysis |
O mais seguro é ler esta tabela linha por linha. As três duplas — pontuação de inteligência, tempo de execução e preço — são independentes entre si; não há contradição em uma mesma coluna aparecer com “pontuação alta”, “tempo curto” e “preço unitário alto”.
Por que o GPT-6.2 Astra tem preço unitário mais alto e ainda assim custo por tarefa menor
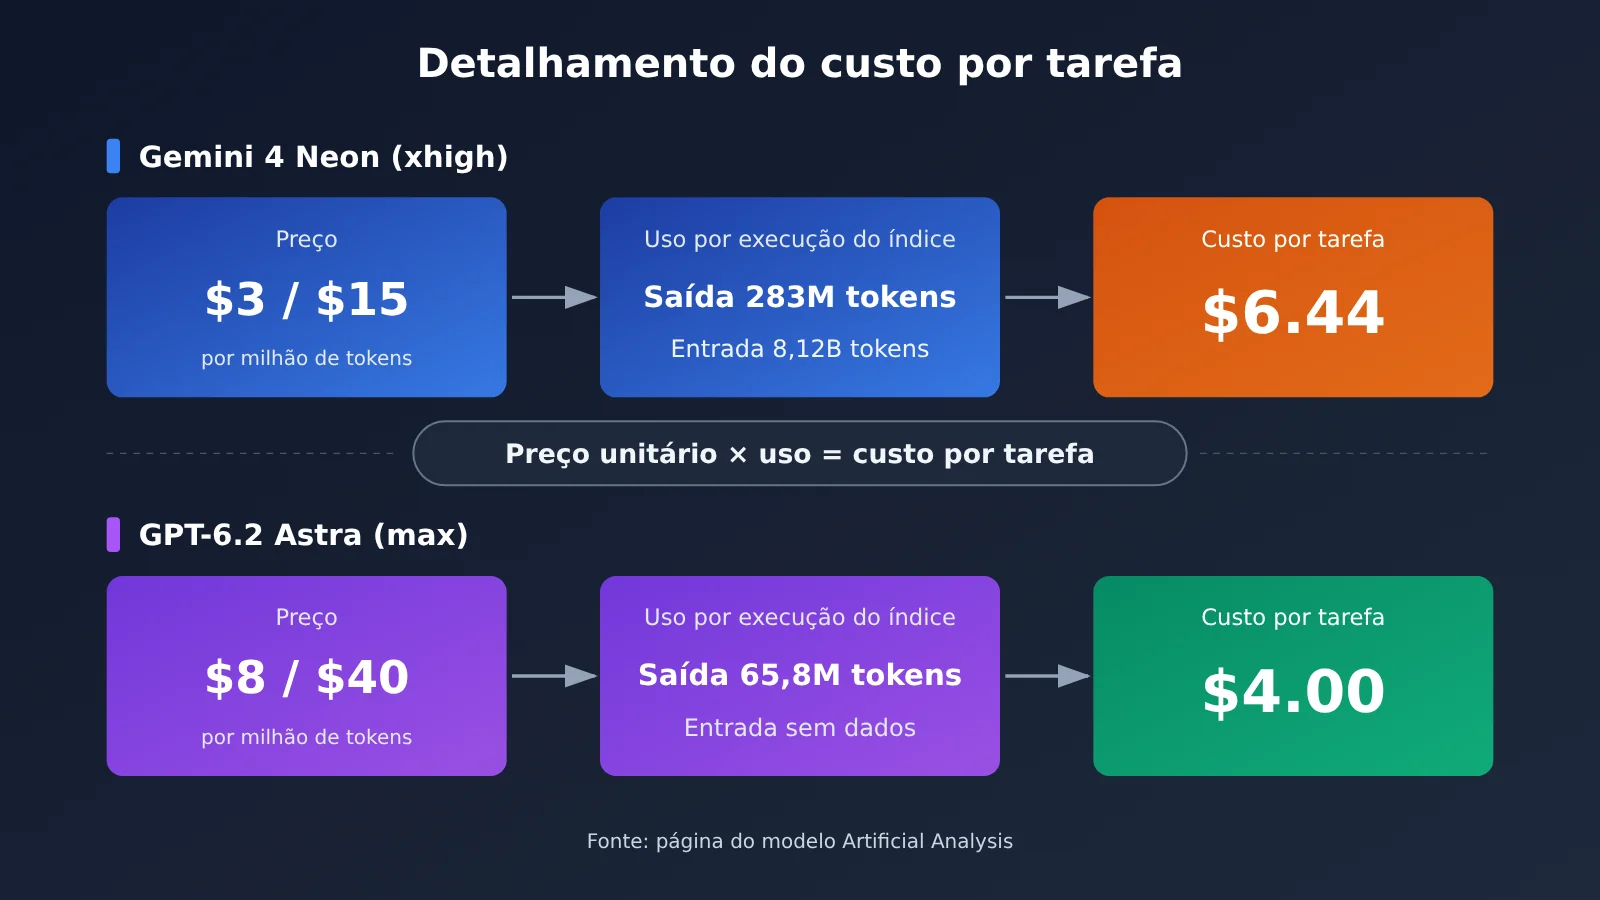
O custo por tarefa pode ser entendido, grosso modo, como “quantos tokens foram consumidos × preço de cada token”. O preço de saída do Astra é de US$ 40 por milhão de tokens, mais que o dobro dos US$ 15 do Neon; mas o volume de saída do run de índice registrado na página do modelo no Artificial Analysis é de 65,8 milhões de tokens para o Astra, menos de um quarto dos 283 milhões do Neon. Como o lado do consumo fica bem menor, o modelo com preço unitário mais alto acaba com custo por tarefa de US$ 4,00, contra US$ 6,44 do Neon.
O lado da entrada merece uma ressalva. A página do modelo Neon registra 8,12 bilhões de tokens de entrada no run de índice; os materiais de referência não trazem o número de tokens de entrada do Astra, então aqui decompomos apenas o lado da saída, sem tentar reconstruir a fatura completa. O preço combinado é 2,21 para o Neon e 5,88 para o Astra, e isso também reflete só o nível de preço de tabela — para estimar a sua própria conta, ainda é preciso multiplicar pela sua estrutura de tokens.
Quando o assunto é um negócio específico, a estrutura de tokens muda. Em tarefas com entrada muito longa e saída curta, o peso do preço de entrada, 8 contra 3, cresce; já em tarefas com saída muito longa, o termo de consumo de saída passa a dominar o resultado. O custo por tarefa no índice é o resultado de um conjunto fixo de questões; antes de transportar isso para o seu cenário, o melhor é rodar uma amostra sua.
A conta de tempo do Gemini 4 Neon: velocidade de saída e velocidade de conclusão são coisas diferentes
Na página do modelo, o Neon entrega cerca de 110 tokens por segundo — mais que o dobro dos 50 tokens/s do Astra — e o primeiro token de resposta sai em apenas 56,51 segundos, contra 197,65 segundos do Astra. Só que o tempo por tarefa é de 21,5 minutos no Neon (xhigh), enquanto o Astra (max) leva 13,7 minutos e 7,4 minutos no xhigh. A explicação, de novo, está no volume de tokens: um modelo que escreve mais, por mais rápido que despeje tokens a cada segundo, vai demorar mais para terminar.
No Astra, xhigh e max têm a mesma pontuação de inteligência, 62, mas um leva 7,4 minutos e o outro 13,7 minutos — na hora de citar, é obrigatório informar o nível. Do lado do Neon, o FAQ da página do modelo no Artificial Analysis traz ainda o tempo até o primeiro token nos níveis mais baixos: high 40,64 segundos, medium 20,14 segundos e low 13,93 segundos. Esses números vêm do FAQ e não ficam na mesma coluna da tabela-resumo.
Dados por nível: Gemini 4 Neon e GPT-6.2 Astra
| Modelo | Nível | Pontuação de inteligência | Tempo por tarefa | Velocidade de saída |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21,5 min | 110 tokens/s |
| Gemini 4 Neon | high (padrão) | 60 | 14,8 min | 101 tokens/s |
| Gemini 4 Neon | medium | 55 | 8,3 min | 101 tokens/s |
| Gemini 4 Neon | low | 44 | 3,7 min | 97 tokens/s |
| GPT-6.2 Astra | max | 62 | 13,7 min | 50 tokens/s |
| GPT-6.2 Astra | xhigh | 62 | 7,4 min | 50 tokens/s |
| GPT-6.2 Astra | high | 60 | 5,9 min | 50 tokens/s |
| GPT-6.2 Astra | medium | 57 | 4,5 min | 49 tokens/s |
| GPT-6.2 Astra | low | 46 | 1,8 min | 48 tokens/s |
Todos os dados vêm da página do modelo no Artificial Analysis, e o high do Neon é o nível padrão conforme indicado no guia do desenvolvedor do Google. O Neon não tem nível max; já no Astra a velocidade de saída fica estável entre 48 e 50 tokens/s em todos os níveis, e a diferença de tempo vem principalmente da quantidade de tokens escritos em cada nível. A página do modelo só informa o custo por tarefa do nível mais alto — os custos dos demais níveis não são estimados aqui.
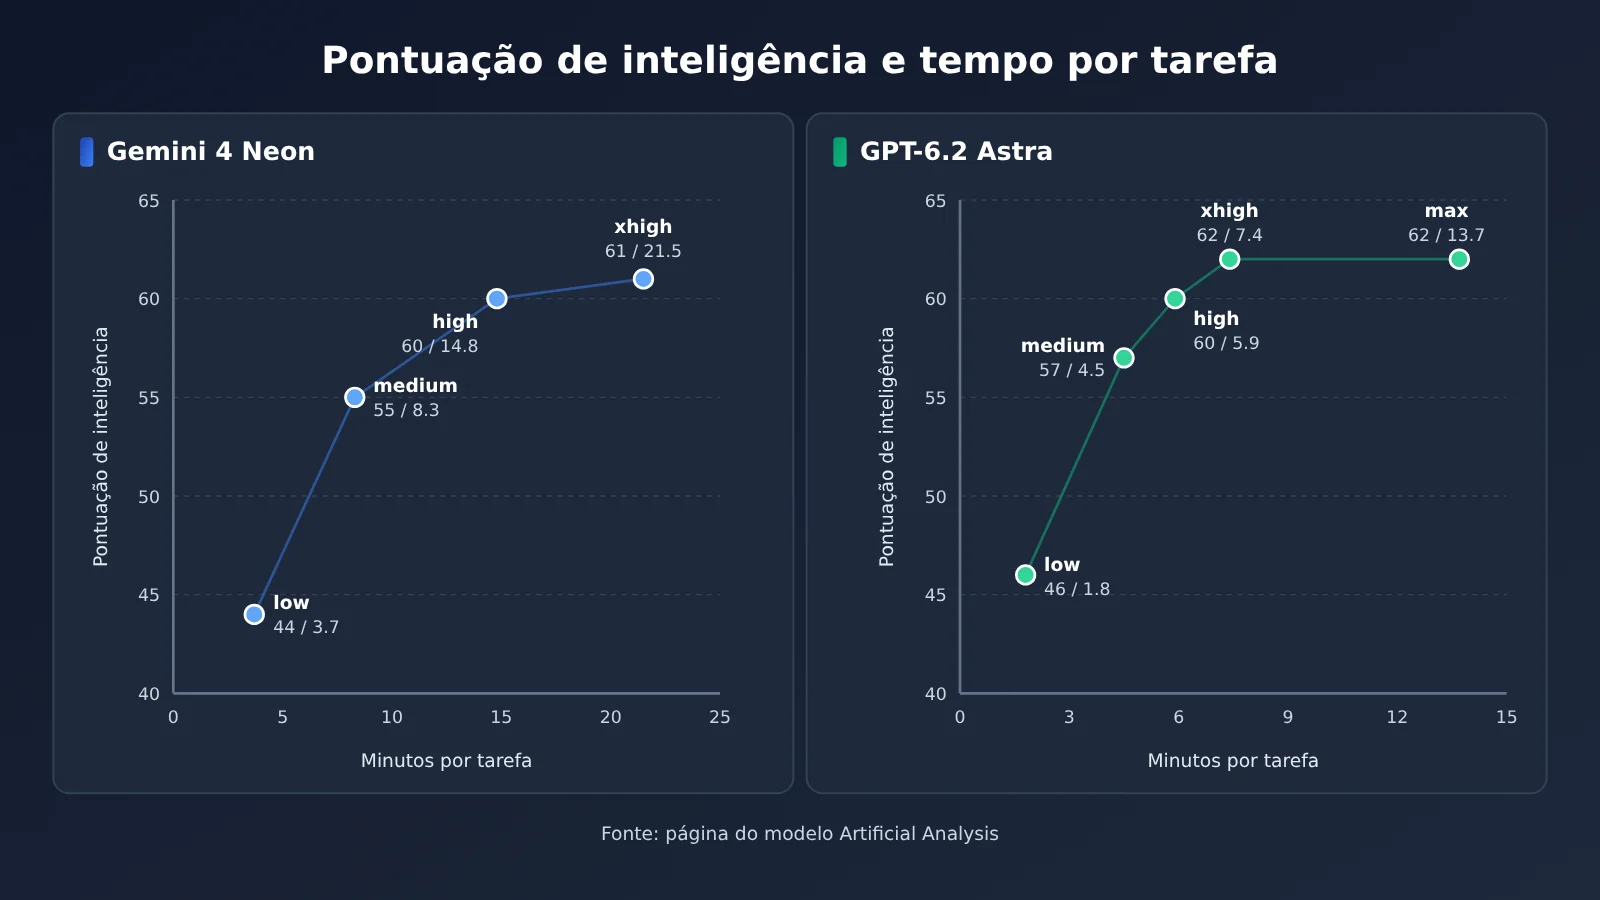
Nota sobre a comparação: os números do gráfico e da tabela acima vêm da página do modelo no Artificial Analysis. Se quiser validar o consumo de tokens com as suas próprias tarefas, é só usar a mesma chave API na APIYI e alternar entre os modelos disponíveis para comparar.
Gemini 4 Neon: números autodeclarados oficiais, model card e comparação com números de terceiros
Do lado do Neon, há três tipos de fontes, com critérios distintos. Todo o trecho do blog do Google é autodeclaração oficial: ele traz o Artificial Analysis Intelligence Index em xhigh como 61, o 3º lugar geral, o Vals Index em 70.9% e o Arena Agent Arena Index em 1336. O model card do DeepMind também registra o AA Index v5.0.1 como 61, e a nota de avaliação esclarece que os resultados de modelos não-Gemini vêm, por padrão, da autodeclaração de cada empresa — ou seja, é um compilado oficial. O artigo e a página do modelo do Artificial Analysis são medições de terceiros.
| Métrica | Autodeclarado oficial (blog do Google) | Model card | Artigo do Artificial Analysis |
|---|---|---|---|
| Índice de Inteligência (xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | Não listado | 59 (Antigravity CLI, xhigh) |
| MKA | Não listado | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | Não listado |
| SWE-sweep | mini-SWE 12.8%, Antigravity 39.0% | harness do fabricante 39.0%, mini-SWE 12.8% | Não listado |
| Custo por tarefa (alegação) | high padrão 32% mais barato que Carbon | Não listado | US$ 6.44, cerca de 17% a menos que os US$ 7.76 do Carbon sem desconto |
Os números que não batem ficam todos na tabela: Coding Agent Index autodeclarado oficial 58.6, artigo do Artificial Analysis 59; MKA model card 56.5%, artigo do Artificial Analysis 56%. Os 12.8% e 39.0% do SWE-sweep vêm de dois harness diferentes, e o blog do Google atribui a diferença a uma melhoria proporcionada pelo harness.
O critério de custo também se divide em três contas. O “32% mais barato” do Google é cálculo próprio, e o blog não diz se o Carbon usa o preço de introdução ou o preço padrão; o “cerca de 17% a menos” do artigo do Artificial Analysis é calculado com base no preço padrão do Carbon 4/20, chegando a US$ 7.76; já os US$ 4.90 do Carbon high na página do modelo do Artificial Analysis são calculados com base no preço de introdução atual da página, 2/10. Esses três conjuntos de números se sustentam cada um por si, e não podem ser convertidos entre si.
Recomendações por cenário: qual métrica considerar para Gemini 4 Neon ou GPT-6.2 Astra
Cenários em que vale olhar primeiro para os números do GPT-6.2 Astra
- Orçamento por tarefa: se você monta o orçamento pensando em “quanto custa cada problema”, comece pelo custo por tarefa na página do modelo no Artificial Analysis. O Astra (max) sai por 4.00 dólares.
- Tempo total de conclusão: o nível xhigh do Astra leva 7.4 minutos e tem pontuação de inteligência 62; o nível max leva 13.7 minutos. Como a pontuação é a mesma, mas o tempo muda bastante entre os dois níveis, vale avaliar cada um separadamente na hora de escolher.
- Tarefas em lote e saídas curtas: ao rodar o índice, o Astra gerou 65,8 milhões de tokens de saída; o volume de saída pesa pouco na conta dele.
Cenários em que vale olhar primeiro para os números do Gemini 4 Neon
- Interfaces interativas e espera pelo primeiro token: o Neon (xhigh) leva 56.51 segundos até o primeiro token da resposta; no FAQ, o nível low aparece com 13.93 segundos.
- Entrada multimodal: a ficha do modelo do DeepMind indica que a entrada pode ser texto, imagem, áudio e vídeo, com janela unificada de até 1 milhão de tokens e conhecimento até março de 2026.
- Orquestração com subtarefas: o guia do desenvolvedor do Google menciona que dá para usar
gemini-4-neoncomo modelo orquestrador e passar oprevious_interaction_idpara ogemini-4-hydrogenexecutar subtarefas mais rápidas. - Cálculo pelo preço por token: a página de preços do Google AI Studio lista o Neon com entrada a 3.00, cache a 0.15 e saída a 15.00 dólares por milhão de tokens. A saída inclui tokens de raciocínio e não há nível gratuito.
Consultar modelos e preços do Gemini 4 Neon e do GPT-6.2 Astra no APIYI
A página da tabela geral do APIYI indica atualização em 2026-11-16 09:39 (UTC+8). Em 2026-11-19, também conferimos a API de preços (versão shell-api-modelmak-v1, com 285 modelos no total). Dá para comparar item por item na lista de modelos em apiyi.com. Na API de preços, model_ratio 1 corresponde a entrada de 2 dólares por milhão de tokens, e completion_ratio 5 indica que a saída custa 5 vezes a entrada, o que bate com a primeira faixa da tabela geral.
| Modelo ID | Entrada | Leitura de cache | Saída | Endpoint | Observação |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | entrada 16 acima de 272000 tokens; saída na faixa superior da API de preços cerca de 60; a tabela geral não inclui essa faixa de saída |
gpt-6.2-sol |
2 | 0.1 | 10 | responses (recomendado), chat | entrada 3 acima de 272000 tokens; saída na faixa superior da API de preços cerca de 11.25 |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | corresponde ao preço introdutório do Google até 2026-11-30 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | grupos Default, SVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat, messages | há também a versão -thinking |
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | há também a versão -thinking |
gemini-4-neon |
— | — | — | — | não consta na tabela geral nem na API de preços |
As unidades são dólares por milhão de tokens. Os valores 2/0.1/10 do gemini-4-carbon são o preço atual de catálogo no APIYI, batem com o preço introdutório do Google e devem ser vistos separadamente do preço padrão posterior do Google, 4/20. Os nomes dos grupos têm pequenas diferenças de grafia entre os dois lugares: por exemplo, a tabela geral escreve Default, SVIP e a API de preços escreve default, svip; para a série Claude, a tabela geral escreve Claude_Reverse, Claude_Enterprise e a API de preços escreve ClaudeCodeReverse, ClaudeOfficial. Em ambos os casos, vale o que a plataforma exibe.
O preço oficial do Gemini 4 Neon vem da página de preços do Google AI Studio: entrada 3.00, cache 0.15 e saída 15.00 dólares por milhão de tokens; suporta apenas cache implícito. O gemini-4-neon não aparece na tabela geral nem na API de preços do APIYI, e também não tem página de modelo independente; ele ainda não foi disponibilizado. Vamos disponibilizar esse modelo o quanto antes. Modelos e preços devem ser confirmados na lista de modelos da plataforma.
Início rápido: chamar o GPT-6.2 Astra pela APIYI
O gpt-6.2-astra roda no endpoint responses compatível com OpenAI. Seguindo os quatro passos abaixo, você já consegue colocá-lo para funcionar:
- Cadastre-se em apiyi.com, crie uma chave API e coloque o valor na variável de ambiente
APIYI_API_KEY. No código, leia apenas da variável de ambiente — nunca deixe a chave em texto puro. - Inicialize o cliente com o SDK da OpenAI:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). - Chame o endpoint responses:
resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别")e depois leiaresp.output_text. - Confira a cobrança: na primeira faixa da tabela geral da APIYI, a entrada é 8, a leitura de cache 0.4 e a saída 40 dólares por milhão de tokens. Quando a entrada de uma única requisição passa de 272000 tokens, a entrada sobe para 16, o
CompletionRatiodessa faixa na interface de preços é 3.75 e a saída fica em torno de 60 dólares por milhão de tokens — o texto da tabela geral não informa a saída dessa faixa.
Em tarefas de contexto longo, preste atenção especial ao passo 4. Acima de 272000 tokens, entrada e saída mudam de faixa ao mesmo tempo, e o custo por tarefa se afasta bastante da estimativa da primeira faixa. Vale a pena levantar primeiro a contagem de tokens das suas requisições típicas e só então definir o orçamento.
Os modelos Gemini já disponíveis têm duas formas de acesso: gemini-4-carbon e gemini-4-hydrogen podem usar o mesmo endereço compatível com OpenAI pelo endpoint chat, ou o endereço nativo do Gemini https://api.apiyi.com, com versão de API v1beta. As regras de parâmetros do Neon podem ser consultadas primeiro no guia para desenvolvedores do Google: os níveis de raciocínio são apenas low, medium, high e xhigh, com padrão high; enviar thinking_budget ou MINIMAL retorna HTTP 400; cache de contexto explícito não é suportado, e prefixos compartilhados acima de 4096 tokens passam automaticamente pelo cache implícito; a saída padrão de um segmento é de no máximo 65536 tokens.
🚀 Início rápido: uma boa ideia é resgatar primeiro a cota gratuita de teste para novos usuários em APIYI apiyi.com e, com a mesma chave, chamar em sequência
gpt-6.2-astra,gpt-6.2-solegemini-4-carbon, anotando os tokens de entrada e saída de cada um. Depois é só encaixar esses números na tabela de preços acima para calcular o custo por tarefa.
Recomendações de decisão para Gemini 4 Neon vs GPT-6.2 Astra
| Qual é a sua preocupação | Qual coluna olhar primeiro | Gemini 4 Neon (xhigh) | GPT-6.2 Astra | Fonte |
|---|---|---|---|---|
| Pontuação de inteligência | Pontuação de inteligência | 61 | max 62, xhigh 62 | Página do modelo no Artificial Analysis |
| Quanto tempo leva para resolver uma questão | Tempo por tarefa | 21,5 minutos | max 13,7 minutos, xhigh 7,4 minutos | Página do modelo no Artificial Analysis |
| Quanto tempo esperar pelo primeiro token | Token da primeira resposta | 56,51 segundos | max 197,65 segundos | Página do modelo no Artificial Analysis |
| Preço por milhão de tokens | Preço unitário | 3 / 15 | 8 / 40 | Página do modelo no Artificial Analysis, tabela geral da APIYI |
| Quanto custa rodar o benchmark | Custo por tarefa | US$ 6,44 | max US$ 4,00 | Página do modelo no Artificial Analysis |
| Como é cobrado input longo | Faixa de preço | Materiais de referência não listam faixas | Entrada acima de 272000 tokens: 16; saída cerca de 60 | Tabela geral da APIYI, interface de preços |
Na hora de decidir, primeiro identifique qual linha é mais importante para o seu negócio e depois olhe os números e as fontes dessa linha. A diferença na pontuação de inteligência é de apenas 1 ponto; as diferenças em tempo de execução, primeiro token, preço unitário e custo por tarefa apontam em direções distintas, e nenhuma linha substitui as outras.
💡 Sugestão de escolha: As questões do benchmark e as suas tarefas reais costumam ter estruturas de tokens diferentes. Recomendamos colocar suas próprias amostras no apiyi.com e fazer um comparativo com os modelos já disponíveis no catálogo, registrando o consumo de tokens e o tempo de execução antes de definir a faixa e o modelo.
Perguntas frequentes sobre Gemini 4 Neon e GPT-6.2 Astra
P1: O que é o Gemini 4 Neon?
O Gemini 4 Neon é um modelo lançado pelo Google em 18 de novembro de 2026, com ID de modelo `gemini-4-neon`. O model card do DeepMind informa que ele foi adaptado do Gemini 4 Carbon e que, dentro da família, ele fica entre Hydrogen (execução rápida do dia a dia) e Carbon (tarefas complexas de longo alcance), com janela de contexto unificada de 1048576 tokens.
P2: Qual é a diferença de pontuação de inteligência entre o Gemini 4 Neon e o GPT-6.2 Astra?
Na página de modelo da Artificial Analysis, o Neon (xhigh) marca 61, o Astra (max) marca 62, e o Astra (xhigh) também marca 62. O Astra tem a mesma pontuação nos dois níveis, com tempos de 13,7 minutos e 7,4 minutos respectivamente; ao citar, é preciso indicar o nível utilizado.
P3: Quando o Gemini 4 Neon estará disponível?
Sundar Pichai declarou no dia do lançamento que o Neon está disponível a partir de 18 de novembro de 2026 no Gemini API do Google AI Studio, no Gemini for business, no Google Antigravity das versões pagas Google AI Pro e Ultra, e no Gemini App das versões Pro e Ultra. A página de preços do Google AI Studio informa que ele não tem nível gratuito.
P4: O GPT-6.2 Astra tem preço unitário mais alto, então por que o custo por tarefa é de US$ 4,00?
O custo por tarefa é determinado tanto pelo preço unitário quanto pelo volume de uso. A página de modelo da Artificial Analysis registra que o Astra (max) gerou 65,8 milhões de tokens de saída ao rodar o índice, enquanto o Neon (xhigh) gerou 283 milhões; embora o preço de saída do Astra seja 40 contra 15, o volume de uso é muito menor, por isso o custo por tarefa fica em US$ 4,00 para o Astra e US$ 6,44 para o Neon.
P5: Como invocar o GPT-6.2 Astra rapidamente via API?
1. Cadastre-se no APIYI apiyi.com e obtenha a chave API e a cota gratuita de testes;
2. Defina o base_url do SDK da OpenAI com o endereço compatível com OpenAI mostrado no guia rápido acima;
3. Use o endpoint responses e preencha o modelo com `gpt-6.2-astra`.
No momento, o `gemini-4-neon` não aparece na tabela geral nem na interface de preços do APIYI; quando for lançado, vale a lista de modelos da plataforma.
P6: Quais são as limitações ao citar esses números?
– **Critério**: dados autodeclarados oficiais, model card, artigos e páginas de modelo da Artificial Analysis vêm de fontes diferentes; o Coding Agent Index tem dois valores, 58,6 e 59, e o MKA tem dois valores, 56,5% e 56%.
– **Custo**: o “32% mais baixo” do Google, o “cerca de 17% menos” do artigo da Artificial Analysis e os US$ 4,90 do Carbon na página de modelo são três conjuntos de contas distintos, que não podem ser combinados.
– **Migração**: o custo por tarefa do índice vem de um conjunto fixo de questões; a estrutura de tokens das suas tarefas é diferente, então os resultados também serão.
Gemini 4 Neon e GPT-6.2 Astra: principais takeaways
- Pontuação de inteligência: na página do modelo no Artificial Analysis, Astra (max) 62, Astra (xhigh) 62 e Neon (xhigh) 61.
- Tempo de execução: Neon (xhigh) 21,5 minutos; Astra max 13,7 minutos e xhigh 7,4 minutos — cada nível precisa ser citado separadamente.
- Preço unitário: Astra 8/40, Neon 3/15 dólares por milhão de tokens; o preço do Neon vem da página de preços do Google AI Studio.
- Custo por tarefa: Astra (max) US$ 4,00 e Neon (xhigh) US$ 6,44; a diferença vem do volume de tokens de saída.
- Velocidade e primeiro token: Neon 110 tokens/segundo, primeiro token em 56,51 segundos; Astra 50 tokens/segundo, primeiro token em 197,65 segundos.
- Catálogo da APIYI:
gpt-6.2-astrana primeira faixa 8/0,4/40; acima de 272.000 tokens de entrada, 16; saída pela interface de preços em torno de 60;gemini-4-neonainda não foi incluído.
Resumo comparativo: Gemini 4 Neon vs GPT-6.2 Astra
Na comparação entre Gemini 4 Neon e GPT-6.2 Astra, o ponto-chave é manter as contas separadas:
- Conta da inteligência: 61 contra 62; o xhigh e o max do Astra têm ambos 62, com base na página do modelo no Artificial Analysis.
- Conta do tempo: 21,5 minutos contra 13,7 minutos (o Astra xhigh fica em 7,4 minutos); a velocidade de saída e o tempo até o primeiro token são outra série de números.
- Conta do preço: preço unitário 3/15 contra 8/40; custo por tarefa US$ 6,44 contra US$ 4,00, com 283 milhões contra 65,8 milhões de tokens de saída no meio.
Ao escolher, primeiro defina por qual conta você vai liquidar e depois confirme o consumo de tokens com seus próprios samples. Recomendamos usar a APIYI apiyi.com com uma única chave API para fazer testes comparativos entre os modelos já disponíveis; quando o gemini-4-neon for disponibilizado, ele pode entrar direto no mesmo fluxo.
📚 Referências
-
Post de lançamento de Sundar Pichai: lançamento do Gemini 4 Neon e canais de disponibilização
- Link:
x.com/sundarpichai/status/2123167780988125621 - Descrição: data de lançamento e ponto de acesso
- Link:
-
Blog do Google “Introducing Gemini 4 Neon”: benchmarks, preços e posicionamento declarados oficialmente
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descrição: números oficiais como Coding Agent Index 58.6 e custo 32% menor
- Link:
-
Model card do Gemini 4 Neon no DeepMind: tabela comparativa e especificações do modelo
- Link:
deepmind.google/models/model-cards/gemini-4-neon/ - Descrição: a tabela comparativa tem apenas três colunas: Neon, Claude Opus 5.5 e GPT-6.2 Sol
- Link:
-
Guia do desenvolvedor do Google Cloud: parâmetros e regras de cache do
gemini-4-neon- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descrição: níveis de raciocínio, condições de
HTTP 400, cache implícito
- Link:
-
Página de preços do Google AI Studio: preços oficiais da família Gemini 4
- Link:
aistudio.google.com/docs/pricing - Descrição: Neon 3/0.15/15, preço de introdução do Carbon válido até 2026-11-30
- Link:
-
Artigo da Artificial Analysis: análise da pontuação de inteligência e do custo do Neon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Descrição: medição de terceiros, incluindo o critério de cerca de 17% a menos no preço padrão do Carbon
- Link:
-
Página de modelos da Artificial Analysis: Gemini 4 Neon e GPT-6.2 Astra
- Link:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-astra - Descrição: principal fonte de dados das três contas deste artigo, consultada em 2026-11-19
- Link:
Autor: equipe técnica da APIYI
Contato técnico: fique à vontade para falar com a gente pela página inicial do site oficial da APIYI; para modelos e preços, consulte a lista de modelos e o centro de documentação da plataforma.