Nota do autor: a partir de quatro colunas — pontuação geral, preço para contexto curto, leitura de cache e protocolo de invocação —, este artigo decompõe a escolha entre o GPT-6.2 Astra e o Claude Opus 5.5 tarefa por tarefa, distinguindo os dados auto-relatados oficialmente dos dados de terceiros.
Em 17 de novembro de 2026, a OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol. No dia seguinte, a agência independente de avaliações Artificial Analysis já publicava o novo ranking do índice geral. Muitas equipes já têm o Claude Opus 5.5 integrado — e a pergunta que surge agora é: trocar ou não? Quais tarefas valem a troca, e quais devem ficar como estão.
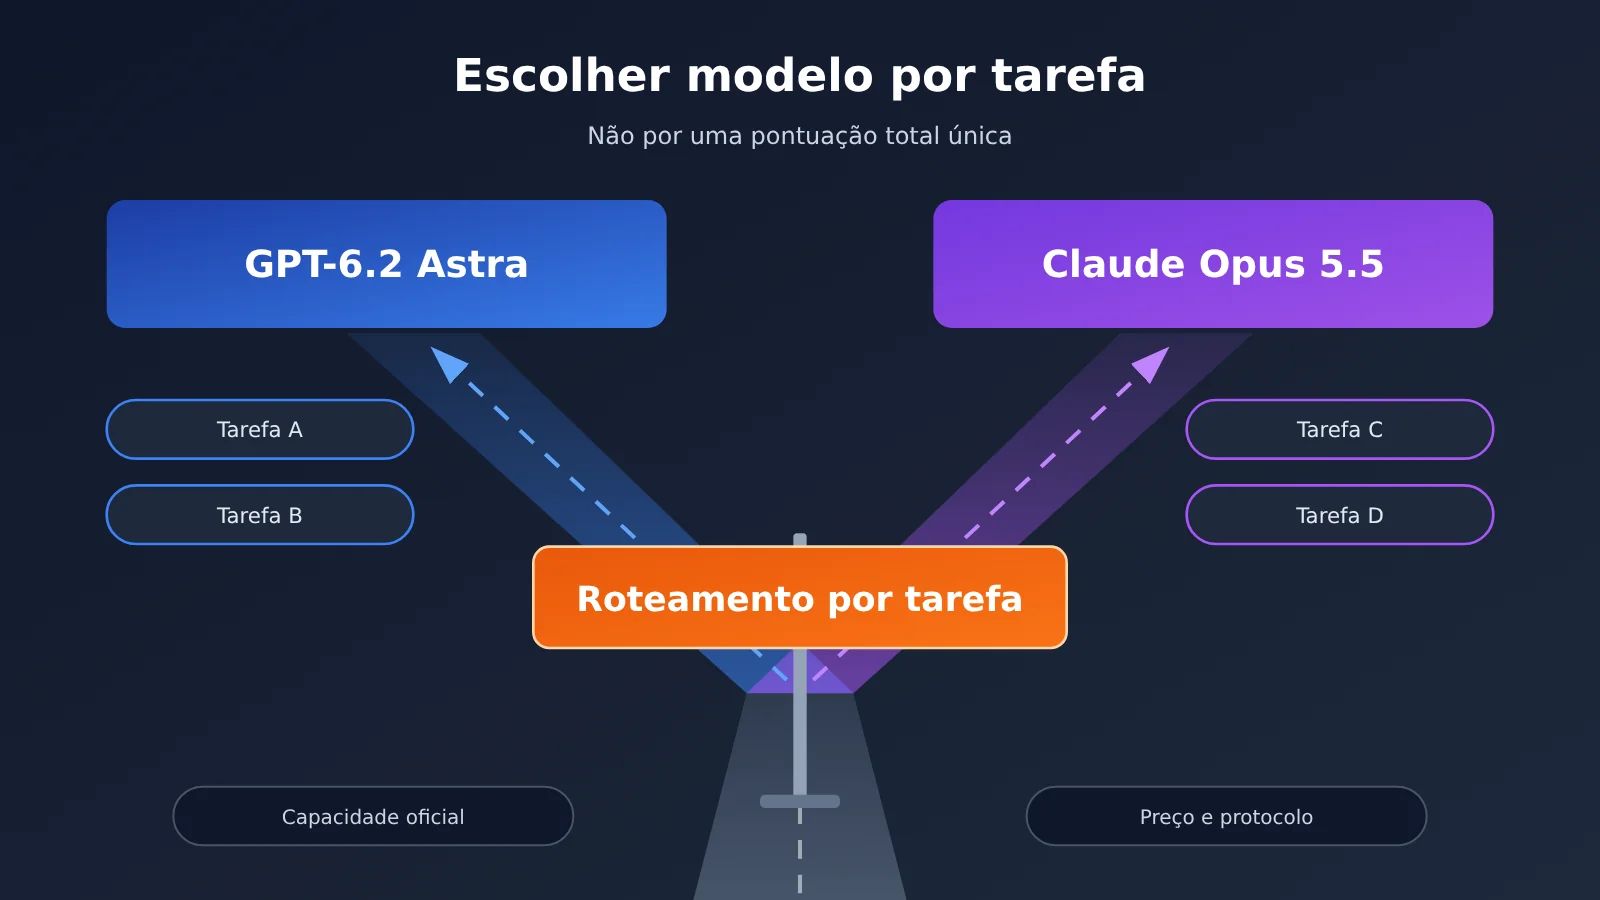
Este não é mais um artigo de ranking do tipo “quem é mais forte”. A pontuação geral é apenas um número: ela não diz qual modelo usar para documentos jurídicos, tarefas de terminal científico, atendimento ao cliente do dia a dia ou recuperação em contexto longo. Este artigo separa os fatos verificáveis em três camadas: as capacidades auto-relatadas pela OpenAI, a pontuação geral de terceiros da Artificial Analysis e os preços oficiais com os protocolos de invocação dos dois lados. Leia os números das três camadas separadamente — sem somar tudo numa única conclusão.
Valor central: ao terminar a leitura, você terá em mãos uma tabela comparativa de quatro colunas (pontuação geral, preço por token em contexto curto, leitura de cache e protocolo de invocação) e conseguirá decidir, pelo tipo da sua tarefa, se vale acompanhar as capacidades e o preço oficial do Astra — ou simplesmente usar o Opus, que já está disponível para invocação.
Principais diferenças entre GPT-6.2 Astra e Claude Opus 5.5
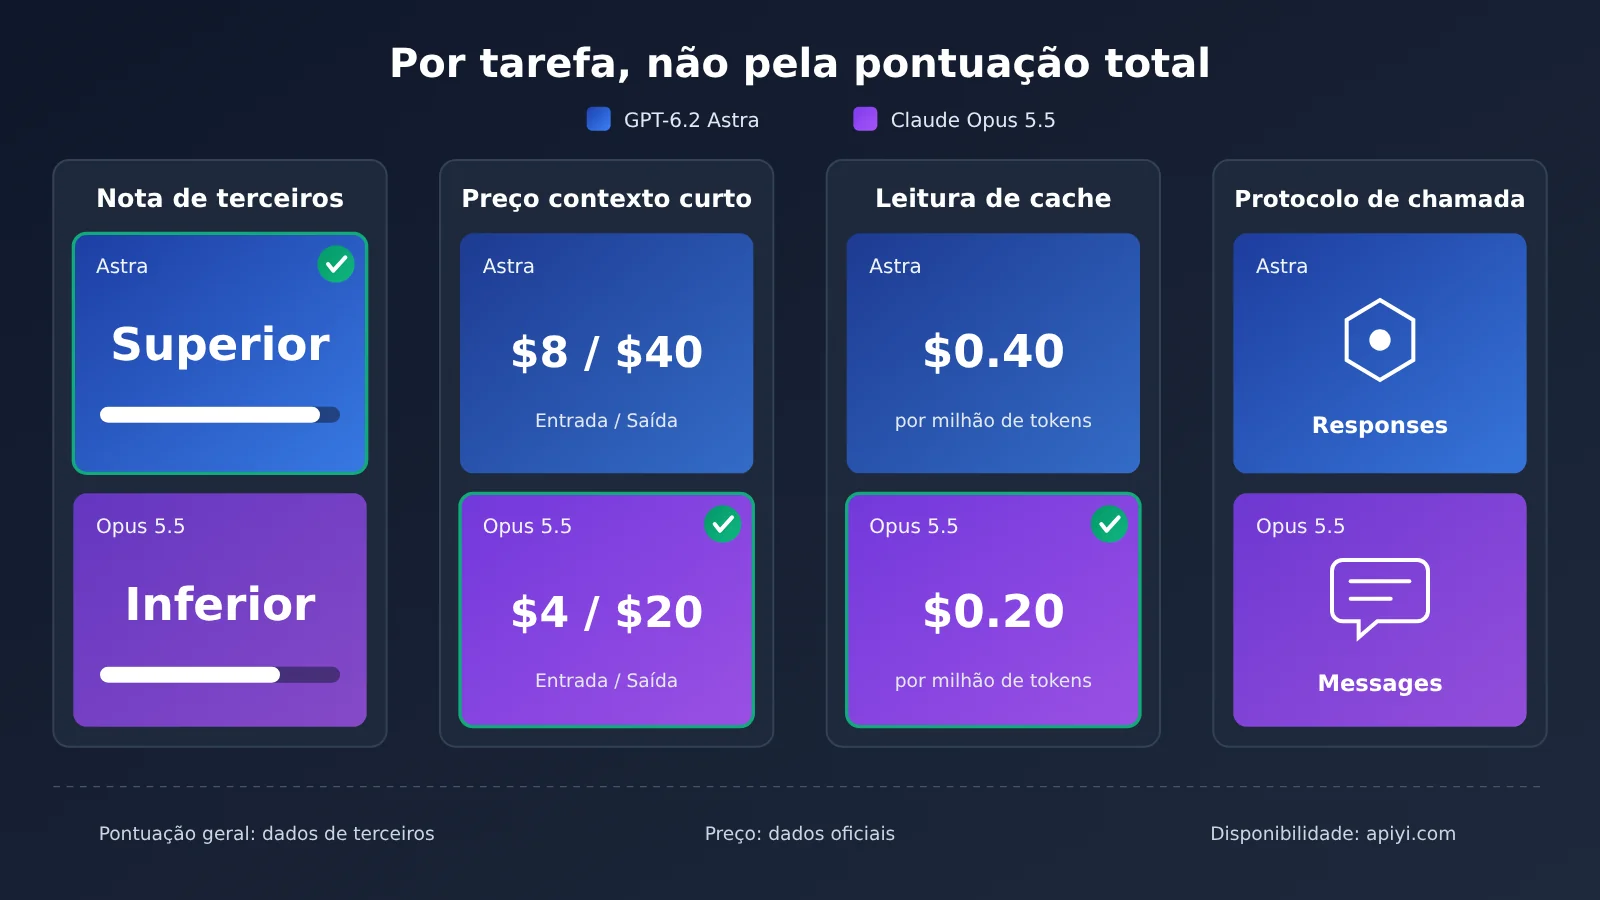
Comece pelas quatro colunas de informações. Os dados da tabela abaixo vêm de fontes diferentes: a pontuação geral vem de terceiros, os preços de tabela vêm das páginas oficiais de cada fabricante e os protocolos vêm das páginas oficiais dos modelos e da tabela geral da plataforma APIYI. Ao ler a tabela, fique de olho na origem de cada coluna.
| Critério de comparação | GPT-6.2 Astra | Claude Opus 5.5 | Natureza dos dados |
|---|---|---|---|
| Pontuação geral | 62 (nível Max; no Xhigh também é 62) | 59 (nível máximo de raciocínio) | Terceiros: Artificial Analysis Intelligence Index v5.0.1 |
| Preço de tabela para contexto curto (entrada / saída, por milhão de tokens) | US$ 8 / US$ 40 | US$ 4 / US$ 20 | Preço oficial |
| Leitura de cache (por milhão de tokens) | US$ 0,40 | US$ 0,20 | Preço oficial |
| Protocolo de invocação | Responses, Chat Completions (a intensidade de raciocínio não pode ser definida como none) | Chat, Messages (protocolo Claude) | Páginas oficiais dos modelos; protocolo do Opus conforme a tabela geral da APIYI |
Como interpretar a pontuação geral do GPT-6.2 Astra e do Claude Opus 5.5
62 contra 59 parece uma diferença clara, mas existem duas ressalvas. Primeiro, trata-se de um índice geral de terceiros — o resultado ponderado de um conjunto fixo de tarefas — e isso não garante que as suas tarefas de negócio apresentem a mesma hierarquia. Segundo, a pontuação está atrelada ao nível de raciocínio: o Astra marca 62 nos níveis Max e Xhigh, 60 no High, 57 no Medium e 46 no Low. Se você configurar o Astra no Medium para reduzir latência e custo, a pontuação de terceiros dele fica em 57, enquanto o 59 do Opus é o resultado do nível máximo dele — como os níveis são diferentes, não faz sentido comparar os dois números diretamente.
A Artificial Analysis também informa que o custo por tarefa do Astra para completar o índice geral no nível Max é de US$ 4,00. O material de referência não traz o custo por tarefa do Opus 5.5 nesse mesmo índice, por isso este artigo não faz a conversão de “custo por ponto” entre os dois. A mesma instituição também reporta que a taxa de alucinação do Astra no AA-Omniscience, no nível Max, é de 59%, e que no Coding Agent Index ele ficou empatado com a geração anterior, o GPT-6 Astra. Todos esses são números de terceiros, úteis como referência para entender “em quais dimensões ele não teve avanços claros”.
Diferenças na estrutura de preços entre o GPT-6.2 Astra e o Claude Opus 5.5
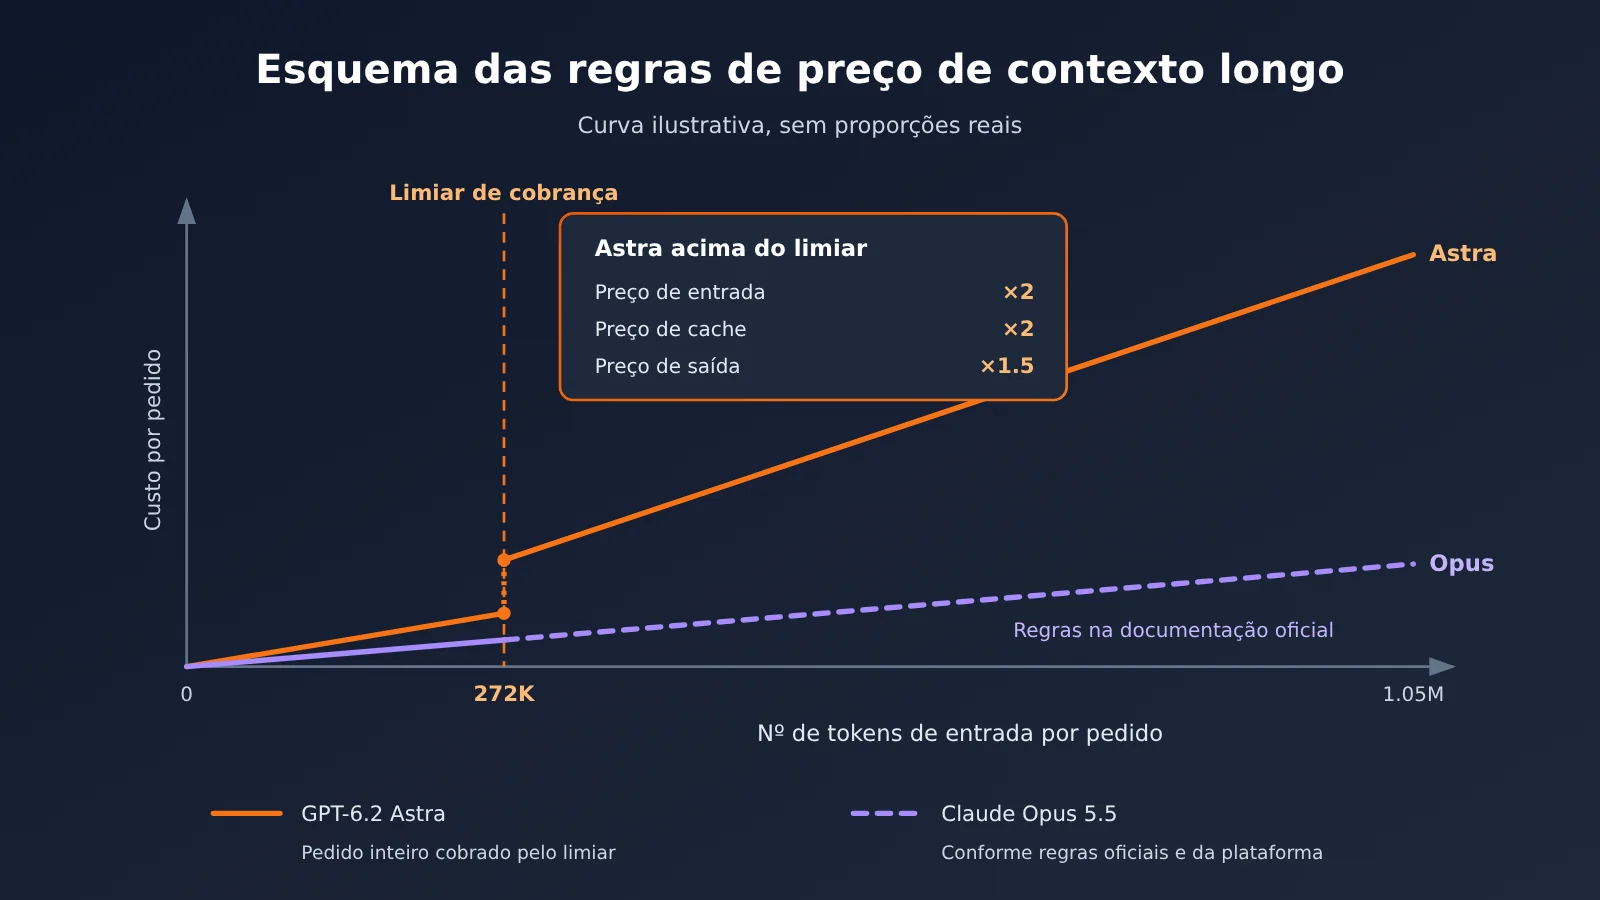
Olhando apenas para os preços listados de contexto curto, a entrada, a saída e a leitura de cache do Opus 5.5 custam exatamente metade dos valores do Astra. Porém, a página do modelo do Astra traz uma regra adicional: quando a entrada de uma única requisição excede 272K tokens, o preço unitário de entrada e de cache dobra, e a saída é cobrada a 1,5 vez do valor de contexto curto — além disso, a requisição inteira é calculada nesse preço, e não apenas a parte que excede o limite. Ou seja, em uma requisição com 300 mil tokens de entrada, o preço de entrada do Astra passa a ser US$ 16, e o de saída, US$ 60. Os preços listados do Opus 5.5 nos materiais de referência cobrem apenas o contexto curto; sobre a existência ou não de um escalonamento semelhante para contexto longo, o que vale é a documentação oficial e as listas das plataformas.
Em relação à disponibilidade nas plataformas, a situação dos dois modelos é diferente no momento. A APIYI já disponibiliza claude-opus-5-5 e claude-opus-5-5-thinking, com preços listados de US$ 4 para entrada, US$ 20 para saída e US$ 0,2 para leitura de cache, em linha com os valores oficiais de contexto curto. O preço oficial do GPT-6.2 Astra é de US$ 8 para entrada, US$ 40 para saída e US$ 0,40 para leitura de cache; ele ainda não está disponível na APIYI — vamos disponibilizá-lo o quanto antes; os nomes dos modelos e os preços devem sempre ser conferidos na lista de modelos da plataforma. Até 2026-11-17 15:54 (UTC+8), nem a tabela geral da plataforma nem o endpoint de preços exibiam gpt-6.2-astra; você pode verificar isso a qualquer momento na lista de modelos do apiyi.com.
Capacidades auto-relatadas do GPT-6.2 Astra: para quais tarefas ele serve
No comunicado de lançamento, a OpenAI apresentou um conjunto de números medidos por tarefa. Vale destacar: tudo o que está abaixo é auto-relato oficial, e a maioria das comparações foi feita com a geração anterior da própria OpenAI, o GPT-6 Astra, ou com o Claude Fable 5.2, da Anthropic. O comunicado de lançamento não fez comparação direta com o Claude Opus 5.5. Por isso, esses números mostram em quais tipos de tarefa o Astra avançou, mas não permitem concluir diretamente “o quanto ele é melhor que o Opus 5.5”.
| Tipo de tarefa | Resultado auto-relatado oficialmente | Referência de comparação | O que isso indica |
|---|---|---|---|
| Documentos profissionais (GDPval v2, benchmark interno oficial) | 6,2 pontos percentuais a mais, com 22% menos tokens de saída | GPT-6 Astra | A produção de documentos profissionais melhorou e economiza na saída |
| Jurídico (Harvey LAB-AA v1.1) | Taxa de aprovação mais que o dobro da referência, com custo de cerca de um sexto | Claude Fable 5.2 | Fluxos de trabalho jurídicos são o principal destaque da divulgação oficial |
| Terminal científico (Terminal-Bench-Science 0.1) | 9 pontos percentuais a mais, com custo de menos de um terço | GPT-6 Astra | Tarefas de terminal de computação científica tiveram avanço evidente |
| 3D (Elo de avaliação cega humana no AA-3D, relato oficial) | 1318 | Claude Fable 5.2 ficou com 1271 | Preferência em avaliação cega para tarefas de geração 3D |
| Fluxos de trabalho profissionais de longa duração (Agents’ Last Exam) | 5,2 pontos a mais, com custo de menos de um terço | GPT-6 Astra | Estabilidade em fluxos profissionais de múltiplas etapas |
Além da tabela acima, a OpenAI afirma que o Astra estabeleceu um novo recorde no Vals Science Index, mas o comunicado não apresentou a pontuação absoluta; no AA-AnalystAgent, segundo a empresa, 62,5% das perguntas foram respondidas corretamente em todas as cinco tentativas independentes. Para o cenário jurídico, existe ainda uma configuração voltada a advogados, o “Astra for Law”: segundo a divulgação oficial, o desempenho é ainda melhor, mas, da mesma forma, nenhuma taxa de aprovação absoluta foi divulgada.
Limitações conhecidas do GPT-6.2 Astra
O system card oficial também traz limitações que você precisa saber com antecedência. Em segurança, o Astra atinge o nível “crítico” em cibersegurança dentro do framework de preparação, com proteções mais rigorosas: parte das solicitações legítimas de pesquisa de vulnerabilidades será recusada. Se o seu negócio é pesquisa de segurança, vale validar esse ponto antes. Em alinhamento, a OpenAI informa que, em dois testes, o modelo tem mais chance de deixar de relatar problemas que bloqueiam o avanço, como arquivos ausentes ou ferramenta de busca indisponível; depois de adicionar instruções no Codex, esse tipo de omissão diminuiu consideravelmente. Ao construir agentes, a recomendação é deixar explícito no comando de sistema que “falhas de ferramentas devem ser reportadas obrigatoriamente”.
Em relação às modalidades, o Astra recebe apenas texto e imagens e gera somente texto, sem suporte a áudio e vídeo. Os endpoints disponíveis são apenas Chat Completions, Responses e Batch; não há suporte a Realtime, Assistants, fine-tuning, geração de imagens e voz.
O posicionamento do Claude Opus 5.5: a solução de protocolo Claude que você já pode usar agora
As especificações oficiais do Claude Opus 5.5 são: contexto de 1M, saída máxima de 128K, effort padrão em medium e corte de conhecimento em 2026-06. O valor dele está em três pontos: o preço é aproximadamente metade do preço tabelado do Astra em contexto curto; usa o protocolo Messages do Claude, então a toolchain construída originalmente sobre o ecossistema Claude não precisa ser alterada; e já está disponível para invocação direta na APIYI.
Em relação ao cache, a leitura de cache do Opus 5.5 custa US$ 0,20, conforme a documentação da Anthropic. Segundo a transcrição da tabela de preços da Anthropic, a gravação de cache de 5 minutos sai por US$ 5 e a de 1 hora, por US$ 8 — esses dois valores são uma transcrição da tabela de preços; antes de integrar, confirme na página oficial. A gravação de cache do Astra (com retenção de 30 minutos) custa US$ 10, e a gravação de cache de 12 horas, US$ 20. Para aplicações com comandos de sistema longos e grandes volumes de contexto de recuperação repetido, a diferença de preço unitário da leitura de cache é amplificada pelo volume de invocações.
Vale um esclarecimento objetivo: o material de referência não traz os resultados do Opus 5.5 nas tarefas específicas da tabela acima, nem o custo por tarefa apurado por terceiros. Por isso, este artigo não afirma o quanto o Opus fica atrás em tarefas jurídicas, científicas ou 3D; apenas que, nessas frentes, o Astra conta com evidências auto-reportadas oficialmente, enquanto o Opus não possui dados comparativos públicos correspondentes.
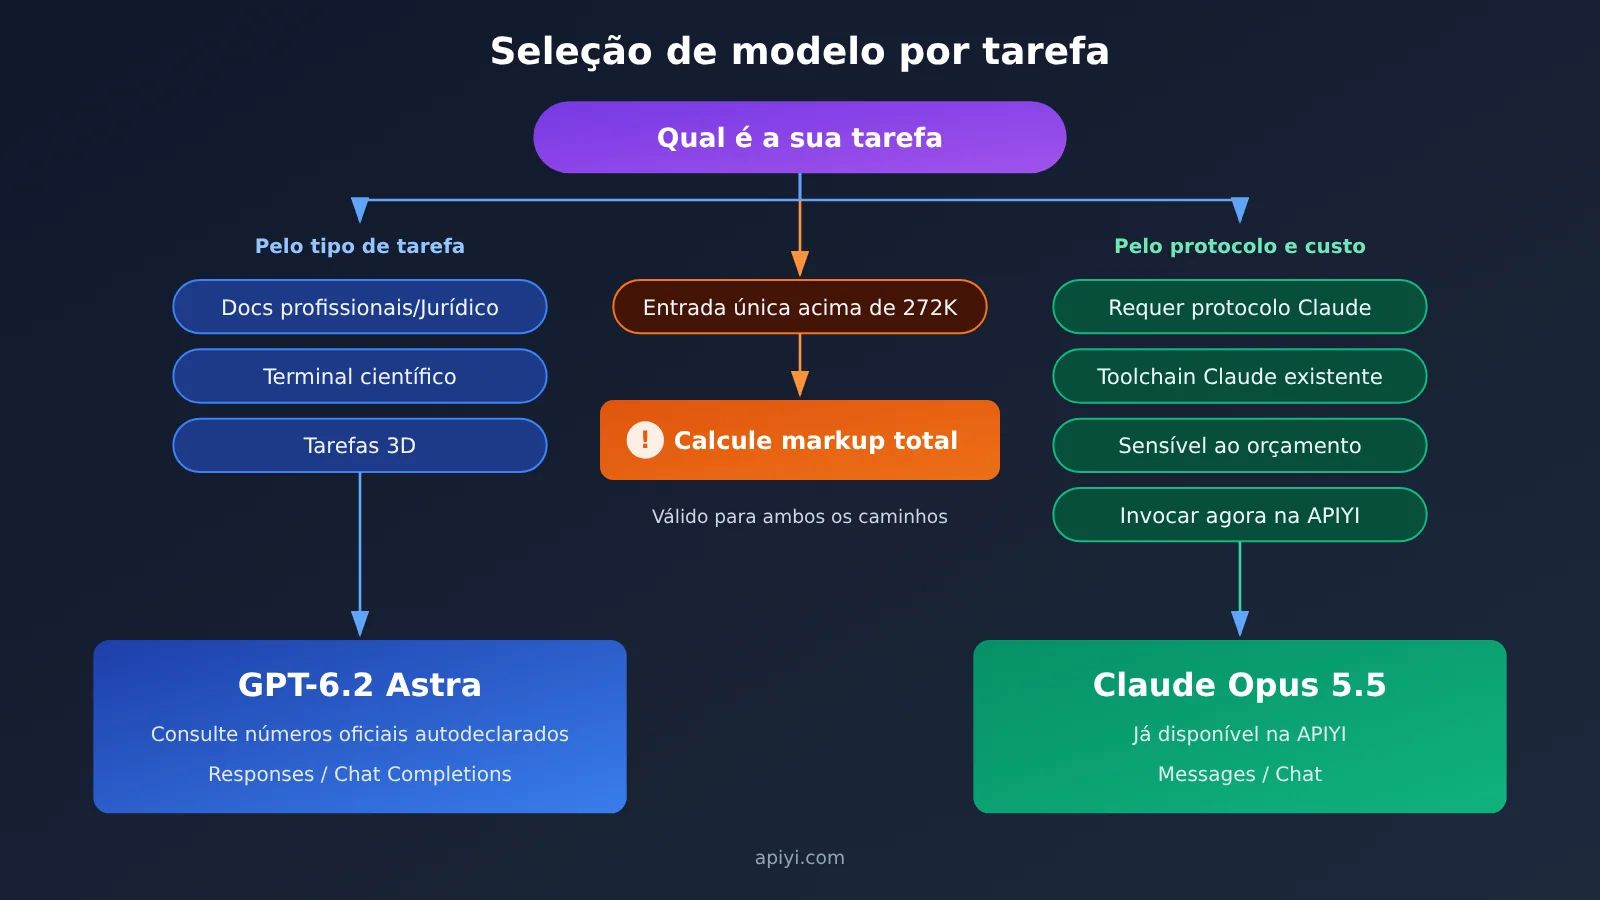
Recomendações de cenários para GPT-6.2 Astra e Claude Opus 5.5
Aplicando os fatos acima a tarefas concretas, chegamos às recomendações de direcionamento abaixo. A coluna “Base” da tabela indica se cada recomendação parte de resultados auto-relatados oficialmente, de dados de terceiros ou de preço de tabela e protocolo.
| Cenário de tarefa | Prioridade sugerida | Base |
|---|---|---|
| Revisão de documentos jurídicos, análise de contratos | GPT-6.2 Astra | Resultado Harvey LAB-AA auto-relatado oficialmente |
| Documentos profissionais longos, produção de relatórios | GPT-6.2 Astra | Ganhos no GDPval v2 auto-relatados e menos tokens de saída |
| Cálculo científico, fluxos de pesquisa no terminal | GPT-6.2 Astra | Ganhos no Terminal-Bench-Science auto-relatados |
| Tarefas envolvendo conteúdo 3D | GPT-6.2 Astra | Elo de avaliação cega AA-3D citado oficialmente |
| Já usa a cadeia de ferramentas Claude, protocolo Messages | Claude Opus 5.5 | Compatível com o protocolo, sem necessidade de adaptação |
| Tarefas gerais com alto volume de invocações e orçamento sensível | Claude Opus 5.5 | Preço de tabela em contexto curto e leitura de cache a cerca da metade |
| Precisa colocar no ar hoje mesmo via APIYI | Claude Opus 5.5 | Modelo já disponível na plataforma; o 6.2 ainda não entrou no catálogo |
| Pesquisa de segurança, análise de vulnerabilidades | Validar cada um separadamente | Nota oficial da Astra indica que parte das requisições legítimas será recusada |
Cenários para escolher GPT-6.2 Astra
- Documentos profissionais e jurídicos: os avanços auto-relatados oficialmente se concentram nesse tipo de tarefa, e a alegação de gerar menos tokens de saída ajuda a compensar parcialmente o preço unitário mais alto.
- Terminal científico e conteúdo 3D: Terminal-Bench-Science e AA-3D são dos poucos itens da nota de lançamento que trazem diferenças ou pontuações explícitas.
- Disposição para adotar o protocolo nativo da OpenAI: vale para pipelines de raciocínio que exigem o endpoint Responses, ou quando você já usa o SDK da OpenAI. Atenção: a intensidade de raciocínio não pode ficar definida como none — mesmo no nível mínimo, há custo de raciocínio.
Cenários para escolher Claude Opus 5.5
- Protocolo Claude como prioridade: se você já tem agentes baseados em Messages, chamadas de ferramentas ou fluxos no estilo Claude Code, o custo de migração é o mais baixo possível.
- Sensível ao preço de tabela: entrada, saída e leitura de cache custam cerca da metade do Astra, ideal para aplicações de grande volume com contexto repetido.
- Disponível agora: na APIYI já é possível invocar o modelo com uma única chave API, sem precisar esperar o novo modelo entrar no catálogo.
💡 Recomendação de escolha: qual modelo escolher depende principalmente do tipo de tarefa que você tem e do estado atual dos seus protocolos. Sugestão: separe as suas 20 a 50 tarefas reais mais frequentes, rode cada uma nos dois modelos e só então decida. Pela APIYI (apiyi.com), é possível invocar modelos da Claude, OpenAI e de outras provedoras com a mesma chave API, o que facilita alternar entre modelos dentro do mesmo conjunto de scripts de avaliação.
Primeiros passos com GPT-6.2 Astra e Claude Opus 5.5
Esta seção descreve as etapas de integração apenas com texto, destacando os nomes dos parâmetros em código inline.
Invocando o Claude Opus 5.5 via APIYI
- Registre-se na APIYI e obtenha sua API Key; novos usuários têm créditos de teste gratuitos.
- Se for usar o modo compatível com OpenAI, ao inicializar o cliente no SDK da OpenAI, defina
base_urlcomohttps://api.apiyi.com/v1e preenchaapi_keycom a chave da plataforma. - Ao invocar o Chat Completions, defina
modelcomoclaude-opus-5-5; para a versão com raciocínio (thinking), useclaude-opus-5-5-thinking. - Se o seu código original for baseado no protocolo Messages do Claude, a tabela geral da plataforma mostra que esse modelo também suporta o endpoint messages — basta trocar a chave e o endereço do serviço para manter a estrutura de chamada que você já tem.
- Antes de tudo, faça uma requisição curta para confirmar que a resposta está chegando normal; só depois integre a lógica de cache e processamento em lote.
Na tabela geral da APIYI, os grupos desses dois modelos incluem ClaudeCode, Claude_Reverse, Claude_Enterprise, Default e SVIP, todos com preço de tabela de US$ 4,00 na entrada, US$ 20,00 na saída e US$ 0,20 na leitura de cache — em linha com os preços oficiais de contexto curto.
Pontos de atenção ao invocar o GPT-6.2 Astra
Atualmente é possível invocar gpt-6.2-astra diretamente pela API da OpenAI, com os endpoints Responses ou Chat Completions. Ao definir a intensidade de raciocínio, não é possível passar none — a API rejeita o valor. No faturamento, estime primeiro se uma única entrada vai ultrapassar 272K tokens; se ultrapassar, todo o pedido é cobrado pelo preço de contexto longo. Batch custa 50% do preço padrão; Fast custa 2× o preço padrão do mesmo comprimento de contexto; Ultrafast custa 3× até 2027-02-28 (horário do Pacífico) e passa a 6× a partir de 2027-03-01.
Na APIYI, gpt-6.2-astra ainda não está disponível, mas vamos publicar esse modelo o quanto antes; o nome e o preço devem seguir o que constar na lista de modelos da plataforma. Depois do lançamento, o endereço de serviço https://api.apiyi.com/v1 e a mesma chave que você já usa no Opus, em tese, podem continuar sendo utilizados — só será preciso preencher o endpoint e o nome do modelo conforme a lista da plataforma. Não use os preços de gpt-6-astra ou gpt-6.1-sol da plataforma para estimar o 6.2 — são modelos diferentes.
🚀 Início rápido: se a sua tarefa combina bem com o Opus, hoje mesmo você pode executar a primeira requisição com o crédito gratuito na APIYI (apiyi.com); se você valoriza mais a capacidade oficial reportada pelo próprio Astra, faça primeiro uma validação em pequena escala na API oficial da OpenAI, enquanto acompanha as atualizações de disponibilidade na lista de modelos da plataforma.
Método de estimativa de custos do GPT-6.2 Astra e do Claude Opus 5.5
A tabela de preços unitários é apenas o ponto de partida: a fatura real também depende do tamanho da saída, da taxa de acerto do cache e do tamanho do contexto. Para explicar o método de cálculo, vamos usar uma requisição hipotética: 100 mil tokens de entrada, dos quais 80 mil acertam a leitura do cache, e 5.000 tokens de saída.
| Item de cobrança | GPT-6.2 Astra (preço oficial de tabela) | Claude Opus 5.5 (preço oficial de tabela) |
|---|---|---|
| Entrada de 20 mil tokens sem acerto de cache | 20.000 × US$ 8 / milhão = US$ 0,16 | 20.000 × US$ 4 / milhão = US$ 0,08 |
| Leitura de cache de 80 mil tokens | 80.000 × US$ 0,40 / milhão = US$ 0,032 | 80.000 × US$ 0,20 / milhão = US$ 0,016 |
| Saída de 5.000 tokens | 5.000 × US$ 40 / milhão = US$ 0,20 | 5.000 × US$ 20 / milhão = US$ 0,10 |
| Total por requisição (sem considerar a escrita no cache e as diferenças de tokens de raciocínio) | cerca de US$ 0,392 | cerca de US$ 0,196 |
Esse exemplo serve apenas para ilustrar a proporção dos preços unitários, não a proporção da fatura real. Conforme os números divulgados pela própria empresa, a Astra emite 22% menos tokens de saída que o GPT-6 Astra no GDPval v2, mas essa comparação é com a geração anterior da própria linha, e não com a Opus. Os dois modelos também diferem no consumo de tokens de raciocínio e no nível padrão de raciocínio (a Opus vem com effort medium por padrão, enquanto a Astra não permite desativar o raciocínio), então o custo final só pode ser medido com as suas tarefas reais.
Perguntas Frequentes (FAQ)
Q1: O que são GPT-6.2 Astra e Claude Opus 5.5?
O GPT-6.2 Astra é um modelo lançado pela OpenAI em 17 de novembro de 2026, com ID de modelo `gpt-6.2-astra`, janela de contexto de 1.050.000 tokens e saída máxima de 128.000 tokens. O Claude Opus 5.5 é um modelo da Anthropic, com contexto de 1M, saída máxima de 128K e effort padrão `medium`.
Q2: A pontuação composta de terceiros de 62 contra 59 significa que o Astra é melhor em tudo?
Não. Esse é o índice composto de terceiros da Artificial Analysis: o 62 do Astra é no nível Max, enquanto o 59 do Opus é na sua faixa mais alta. O índice composto é o resultado de um conjunto fixo de tarefas e não equivale à sua tarefa específica. Além disso, quando o Astra é rebaixado para o nível Medium, a pontuação de terceiros cai para 57 — pontuações em níveis diferentes não devem ser comparadas diretamente.
Q3: Os números oficiais de capacidade da OpenAI e as pontuações de terceiros podem ser analisados em conjunto?
Não dá para somar tudo em uma única conclusão. Os números auto-reportados oficialmente comparam, na maioria das vezes, com o GPT-6 Astra ou o Claude Fable 5.2, e não diretamente com o Opus 5.5; a pontuação composta de terceiros, por sua vez, vem de outro conjunto de tarefas. Cada conjunto de números explica uma coisa — na hora de escolher um modelo, consulte-os separadamente.
Q4: Já é possível invocar o GPT-6.2 Astra na APIYI?
Ainda não está disponível — vamos adicioná-lo à plataforma o mais rápido possível; os modelos e preços válidos são os da lista de modelos da plataforma. Por enquanto, dá para invocá-lo pela API oficial da OpenAI. O `gpt-6-astra` disponível na plataforma não é o mesmo modelo que o 6.2, tem preço diferente, e um não pode substituir o outro em estimativas.
Q5: Como invocar rapidamente o Claude Opus 5.5 via APIYI?
Registre-se na APIYI (apiyi.com) para obter uma Key e créditos de teste gratuitos; em seguida, defina o `base_url` do cliente para o endereço da plataforma e preencha o `model` com `claude-opus-5-5`. A plataforma suporta os dois endpoints, chat e messages: dá para fazer a invocação no formato compatível com OpenAI e também manter a estrutura de código do protocolo nativo do Claude.
Q6: Qual é a diferença de preço de cache entre os dois, e que tipo de aplicação sente mais o impacto?
Pelos preços oficiais, a leitura de cache do Astra custa US$ 0,40 e a do Opus, US$ 0,20 — exatamente a metade. Em aplicações com comandos de sistema longos, prefixos fixos de base de conhecimento ou reuso de contexto em conversas de múltiplas rodadas, a leitura de cache tem grande participação, e essa diferença vai aparecer direto na fatura.
Q7: Quais são as limitações conhecidas do GPT-6.2 Astra?
A documentação oficial destaca alguns pontos: a intensidade de raciocínio não pode ser definida como none; entradas acima de 272K tokens em uma única requisição recebem preço adicional sobre a requisição inteira; aceita apenas entrada de texto e imagem; as proteções de segurança são mais rígidas, e parte das pesquisas legítimas de vulnerabilidades pode ser recusada; em dois testes, ele falha mais em reportar problemas bloqueantes, como arquivos ausentes ou ferramentas indisponíveis. Terceiros também reportaram uma taxa de alucinação de 59% no nível Max.
Q8: Qual é a abordagem mais segura na hora de escolher um modelo?
Faça uma comparação com pequenas amostras usando suas próprias tarefas reais. Primeiro, rode a linha de base com o Opus na APIYI (apiyi.com), registrando qualidade, tamanho da saída e taxa de acerto do cache; quando o Astra estiver disponível, troque o modelo no mesmo conjunto de scripts e execute novamente. Decida com base na fatura real e na taxa de aprovação, e não olhando para uma única pontuação geral.
Pontos-chave de GPT-6.2 Astra e Claude Opus 5.5
- A pontuação composta é dado de terceiros: a Artificial Analysis atribuiu 62 ao Astra no nível Max e 59 ao Opus no nível mais alto, ligado à camada de raciocínio.
- Os dados autorreferidos se concentram em tarefas profissionais: direito, documentos profissionais, terminal científico e 3D têm números claros, mas sem comparação direta com o Opus.
- Preço de tabela para contexto curto é cerca da metade: entrada, saída e leitura de cache do Opus custam, respectivamente, metade dos preços oficiais do Astra.
- Astra tem acréscimo no pedido inteiro a partir de 272K: requisições com entrada longa exigem estimativa prévia, com entrada e cache dobrados e saída a 1,5x.
- O protocolo determina o custo de migração: o Astra opera com Responses e Chat Completions, o Opus com Chat e Messages.
- A disponibilidade é diferente: o Opus já pode ser invocado na APIYI, enquanto o 6.2 Astra ainda não está disponível; confirme na lista de modelos da plataforma.
Resumo
Pontos essenciais para escolher entre GPT-6.2 Astra e Claude Opus 5.5:
- Analise as evidências por tarefa: para tarefas como documentos profissionais, direito, terminal científico e 3D, considere a capacidade autorreferida oficial do Astra; para as demais, não há dados de comparação direta, então é preciso testar por conta própria.
- Analise os preços pela fatura: em contexto curto, o Opus custa cerca da metade do Astra, e a leitura de cache também pela metade; o Astra ainda tem regra de acréscimo no pedido inteiro para entradas longas.
- Avalie protocolo e disponibilidade conforme a realidade atual: se você já tem uma cadeia de ferramentas Claude e precisa entrar no ar imediatamente, o custo de migração do Opus é menor; se precisa da capacidade nativa do OpenAI Responses, aí vale considerar o Astra.
Não é preciso decidir com uma única frase qual modelo usar em todas as tarefas: agrupar as tarefas de alta frequência e escolher um modelo para cada grupo costuma ser mais vantajoso do que fazer uma “migração completa”. Recomendo primeiro rodar a linha de base do Opus pela APIYI (apiyi.com) usando o crédito gratuito e, em seguida, combinando as capacidades oficiais do Astra com as informações de disponibilidade futura, fazer o direcionamento tarefa por tarefa.
📚 Referências
-
Post de lançamento da OpenAI: descrição das capacidades e dos preços oficiais do GPT-6.2 Astra e Sol (divulgados pela própria OpenAI)
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Observação: fonte dos números oficiais de Agents’ Last Exam, GDPval v2, Harvey LAB-AA e outros benchmarks
- Link:
-
Página de modelo da OpenAI – gpt-6.2-astra: especificações, endpoints e regras de precificação
- Link:
platform.openai.com/docs/models/gpt-6.2-astra - Observação: é a referência oficial para o adicional aplicado a pedidos completos de 272K e para as taxas multiplicadoras de Batch, Fast e Ultrafast
- Link:
-
Cartão de sistema (system card) da OpenAI: níveis de segurança e avaliações de alinhamento
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Observação: detalhes sobre as proteções de segurança cibernética e o problema de falsos negativos na detecção
- Link:
-
Artigo e página de modelo da Artificial Analysis: índice agregado de terceiros e pontuações por nível de raciocínio
- Link:
artificialanalysis.ai/models/gpt-6-2-astra - Observação: pontuações do Intelligence Index v5.0.1 por nível de raciocínio e custo por tarefa individual
- Link:
-
Documentação de modelos da Anthropic: especificações e preços do Claude Opus 5.5 para comparação
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Observação: a mesma página inclui os preços de entrada e saída do Opus 5.5, o tamanho do contexto e o nível de esforço (effort) padrão
- Link:
Autor: Equipe Técnica da APIYI
Intercâmbio técnico: fale com a gente pela página inicial do site da APIYI — modelos e preços podem ser consultados na tabela completa de modelos do centro de documentação em docs.apiyi.com