Catatan penulis: Artikel ini memecah tiga catatan terpisah—skor kecerdasan, waktu per tugas, serta harga satuan dan biaya per tugas—antara Gemini 4 Neon dan GPT-6.2 Astra sesuai label sumbernya, sekaligus mencantumkan harga resmi, tingkatan harga, dan alamat pemanggilan untuk model-model yang sudah tersedia di APIYI.
Pada 18 November 2026, Google merilis Gemini 4 Neon. Sundar Pichai hari itu mengumumkan bahwa model ini mulai diluncurkan di Gemini API pada Google AI Studio, Gemini for business, Google Antigravity, dan Gemini App. Di hari yang sama, artikel Artificial Analysis menempatkan Neon xhigh di peringkat ke-3 indeks kecerdasan gabungan, dengan GPT-6.2 Astra (max) dan Claude Fable 5.2 (max) di atasnya. Saat Neon dan Astra disandingkan, hal yang paling mudah tertukar adalah harga satuan dan biaya per tugas: yang pertama adalah harga per juta token, yang kedua adalah uang yang benar-benar dihabiskan untuk menyelesaikan satu soal.
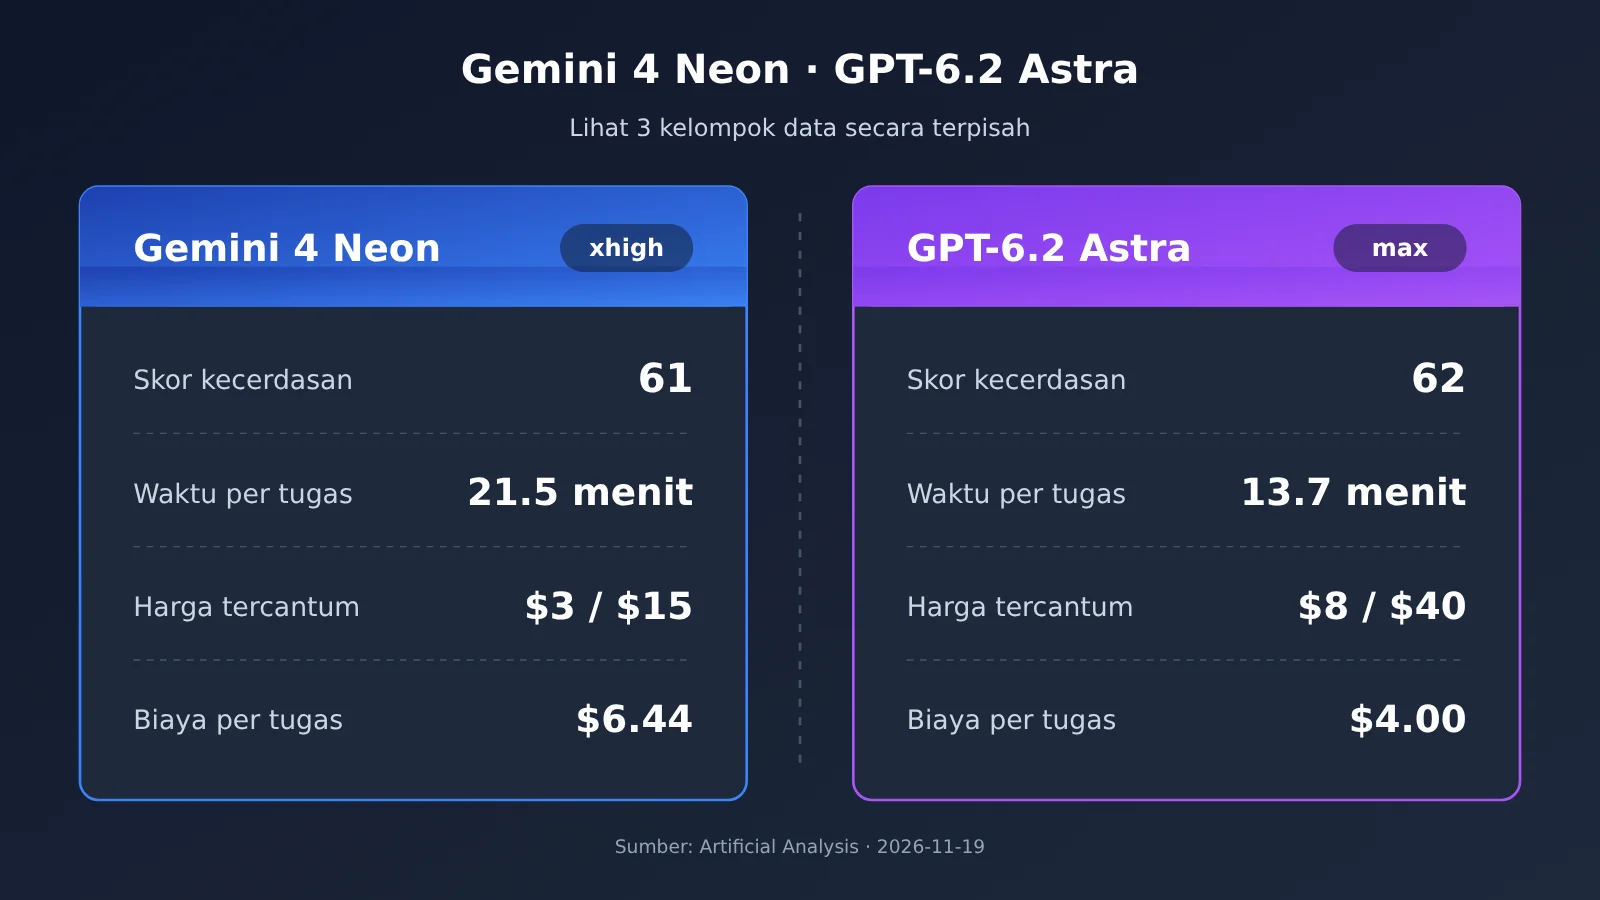
Tiga catatan di bawah ini semuanya diambil dari halaman model Artificial Analysis (dibaca 2026-11-19, indeks v5.0.1), tingkatannya ditulis dalam tanda kurung, dan tingkat yang berbeda dipisahkan:
- Skor kecerdasan: GPT-6.2 Astra (max) 62, Gemini 4 Neon (xhigh) 61. Tingkat xhigh Astra juga 62.
- Waktu per tugas: Astra (max) 13.7 menit, Astra (xhigh) 7.4 menit, Neon (xhigh) 21.5 menit.
- Harga satuan dan biaya per tugas: harga resmi Astra adalah input 8, output 40 dolar/juta token, sedangkan Neon 3/15; biaya per tugas Astra (max) 4.00 dolar, Neon (xhigh) 6.44 dolar.
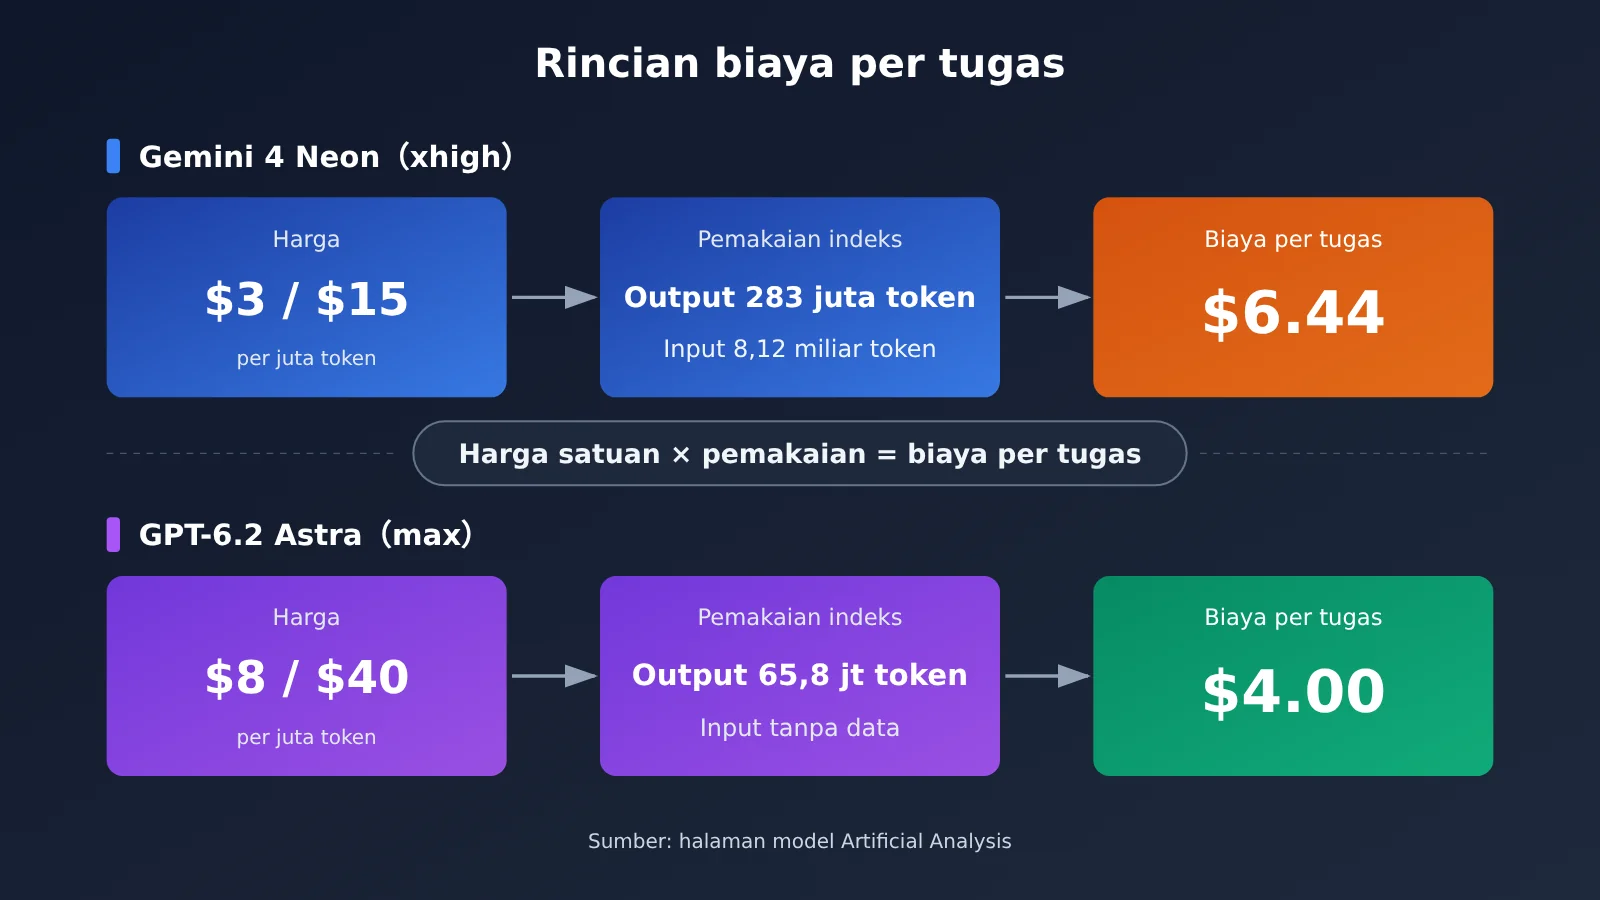
Yang membuat harga satuan dan biaya per tugas bergerak ke arah berlawanan adalah jumlah token yang dipakai. Pada rangkaian indeks yang sama, Astra (max) menghasilkan 65,8 juta token output, Neon (xhigh) 283 juta token output; dari sisi kecepatan, Neon sekitar 110 token per detik dengan token jawaban pertama 56.51 detik, sedangkan Astra 50 token per detik dengan token jawaban pertama 197.65 detik. Artikel ini hanya bertugas menata angka-angka itu ke dalam kolomnya masing-masing—catatan mana yang lebih penting bagi Anda bergantung pada struktur tugas Anda.
Nilai inti: Setelah membaca artikel ini, Anda bisa membedakan dari catatan mana dan tingkat mana setiap angka Gemini 4 Neon dan GPT-6.2 Astra berasal, serta mengetahui model mana di APIYI yang bisa dipanggil langsung dan di titik mana harganya berpindah tingkat.
Perbedaan Utama Gemini 4 Neon dan GPT-6.2 Astra
Seluruh angka di tabel berikut berasal dari halaman model Artificial Analysis: Neon diambil pada setelan xhigh dan Astra pada setelan max, yang merupakan tingkat tertinggi di masing-masing halaman. Tabel perbandingan di kartu model DeepMind hanya memuat tiga kolom—Gemini 4 Neon, Claude Opus 5.5, dan GPT-6.2 Sol—tanpa Astra, sehingga untuk sisi Astra kami hanya memakai angka dari halaman model Artificial Analysis.
| Dimensi perbandingan | Gemini 4 Neon (xhigh) | GPT-6.2 Astra (max) | Sumber |
|---|---|---|---|
| Skor kecerdasan | 61 | 62 (xhigh juga 62) | Halaman model Artificial Analysis |
| Waktu per tugas | 21,5 menit | 13,7 menit (xhigh 7,4 menit) | Halaman model Artificial Analysis |
| Harga terdaftar (input/output, USD/juta token) | 3,00 / 15,00 | 8,00 / 40,00 | Halaman model Artificial Analysis |
| Biaya per tugas | 6,44 USD | 4,00 USD | Halaman model Artificial Analysis |
| Token output untuk menjalankan indeks | 283 juta | 65,8 juta | Halaman model Artificial Analysis |
| Kecepatan output | 110 token/detik | 50 token/detik | Halaman model Artificial Analysis |
| Token jawaban pertama | 56,51 detik | 197,65 detik | Halaman model Artificial Analysis |
| Diskon cache / harga campuran | 95% / 2,21 | 95% / 5,88 | Halaman model Artificial Analysis |
Cara paling aman membaca tabel ini adalah baris demi baris. Skor kecerdasan, durasi, dan harga merupakan tiga kelompok yang berdiri sendiri; melihat “skor tinggi”, “waktu singkat”, dan “harga satuan tinggi” dalam satu kolom yang sama bukanlah sebuah kontradiksi.
Alasan GPT-6.2 Astra lebih mahal per token tetapi lebih murah per tugas
Biaya per tugas kira-kira bisa dipahami sebagai “berapa banyak token yang dipakai × harga per token”. Harga output Astra tercatat 40 dolar per juta token, lebih dari dua kali lipat harga Neon yang 15 dolar. Namun, jumlah output indeks benchmark yang tercatat di halaman model Artificial Analysis untuk Astra adalah 65,8 juta token, kurang dari seperempat jumlah Neon yang 283 juta token. Karena sisi penggunaan ditekan jauh lebih rendah, pihak dengan harga satuan lebih tinggi justru mencatat biaya per tugas 4,00 dolar, sedangkan Neon 6,44 dolar.
Sisi input perlu dijelaskan terpisah. Halaman model Neon mencantumkan input indeks benchmark sebesar 8,12 miliar token, sementara data referensi tidak memuat jumlah token input Astra. Jadi di sini kita hanya membedah sisi output dan tidak menurunkan tagihan lengkap secara terbalik. Harga campuran Neon 2,21 dan Astra 5,88 juga hanya mencerminkan tingkat harga resmi; saat dipakai untuk memperkirakan tagihan Anda sendiri, angka itu masih perlu dikalikan dengan struktur token Anda.
Kalau dipindahkan ke bisnis konkret, struktur token akan berubah. Pada tugas dengan input sangat panjang dan output sangat pendek, bobot harga input 8 berbanding 3 akan membesar; pada tugas dengan output sangat panjang, komponen penggunaan output akan mendominasi hasil. Biaya per tugas pada indeks adalah hasil dari satu set soal yang tetap; sebelum menerapkannya ke skenario Anda, sebaiknya jalankan sendiri dengan sampel Anda.
Hitungan waktu Gemini 4 Neon: output cepat dan selesai cepat itu dua hal berbeda
Di halaman model, Neon mengeluarkan sekitar 110 token per detik — lebih dari dua kali lipat Astra yang 50 token/detik — dan token jawaban pertamanya hanya butuh 56.51 detik, sedangkan Astra 197.65 detik. Namun waktu per tugasnya justru Neon (xhigh) 21.5 menit, sementara Astra (max) 13.7 menit dan xhigh 7.4 menit. Penyebabnya lagi-lagi kembali ke jumlah token: pada model yang menghasilkan lebih banyak token, secepat apa pun token itu dikeluarkan, menulis sampai selesai tetap memakan waktu lebih lama.
Astra dengan xhigh dan max sama-sama punya skor kecerdasan 62, tetapi waktunya 7.4 menit dan 13.7 menit, jadi saat mengutip angkanya wajib menyertakan tingkatannya. Di sisi Neon, FAQ halaman model Artificial Analysis memberikan angka token jawaban pertama untuk tingkat yang lebih rendah: high 40.64 detik, medium 20.14 detik, dan low 13.93 detik. Angka-angka ini berasal dari FAQ dan tidak berada di kolom yang sama dengan tabel ringkasan.
Data per tingkat Gemini 4 Neon dan GPT-6.2 Astra
| Model | Tingkat | Skor kecerdasan | Waktu per tugas | Kecepatan output |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21.5 menit | 110 token/detik |
| Gemini 4 Neon | high (default) | 60 | 14.8 menit | 101 token/detik |
| Gemini 4 Neon | medium | 55 | 8.3 menit | 101 token/detik |
| Gemini 4 Neon | low | 44 | 3.7 menit | 97 token/detik |
| GPT-6.2 Astra | max | 62 | 13.7 menit | 50 token/detik |
| GPT-6.2 Astra | xhigh | 62 | 7.4 menit | 50 token/detik |
| GPT-6.2 Astra | high | 60 | 5.9 menit | 50 token/detik |
| GPT-6.2 Astra | medium | 57 | 4.5 menit | 49 token/detik |
| GPT-6.2 Astra | low | 46 | 1.8 menit | 48 token/detik |
Semua data diambil dari halaman model Artificial Analysis. Tingkat high pada Neon adalah default yang secara tertulis disebutkan di panduan developer Google. Neon tidak punya tingkat max, sedangkan kecepatan output Astra di semua tingkat stabil antara 48 sampai 50 token/detik, sehingga perbedaan waktunya terutama berasal dari jumlah token yang ditulis di masing-masing tingkat. Halaman model hanya menyediakan biaya per tugas untuk tingkat teratas saja; biaya tingkat lainnya tidak dihitung ulang di sini.
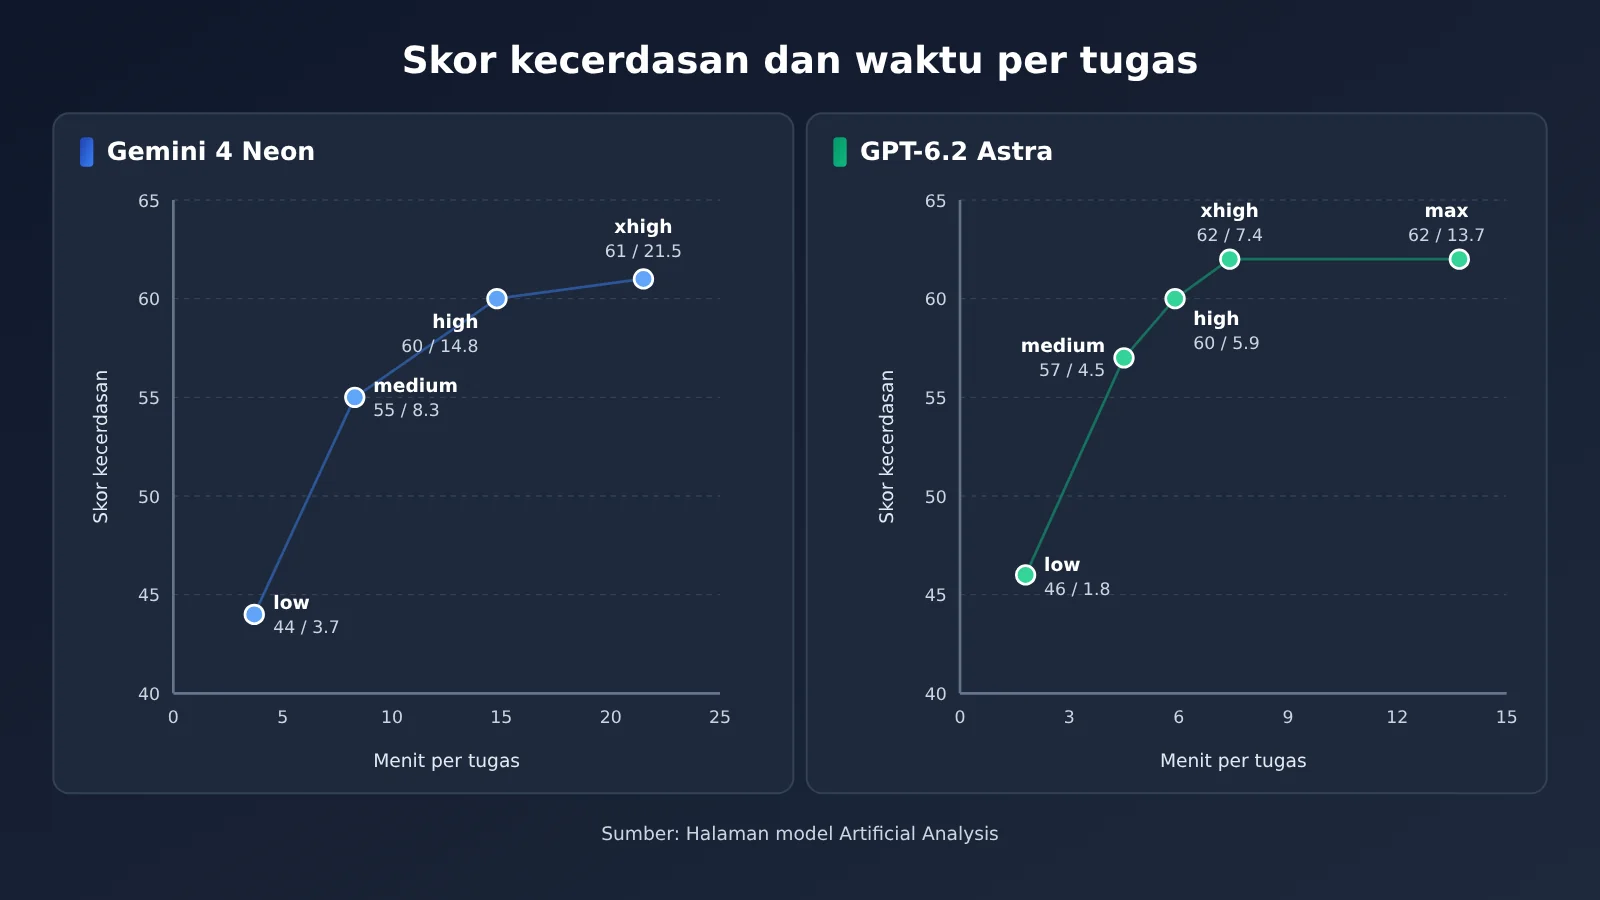
Catatan perbandingan: Angka pada gambar dan tabel di atas semuanya diambil dari halaman model Artificial Analysis. Kalau ingin memverifikasi pemakaian token dengan tugas Anda sendiri, Anda bisa memakai APIYI dengan Key yang sama untuk berganti-ganti model yang sudah tersedia sebagai pembanding.
Gemini 4 Neon: laporan resmi sendiri, kartu model, dan perbandingan angka pihak ketiga
Di sisi Neon ada tiga jenis sumber dengan dasar pengukuran yang berbeda. Seluruh bagian blog Google termasuk laporan resmi dari pihak mereka sendiri: disebutkan Artificial Analysis Intelligence Index pada xhigh bernilai 61 dan peringkat 3 secara keseluruhan, Vals Index 70.9%, serta Arena Agent Arena Index 1336. Kartu model DeepMind juga mencantumkan AA Index v5.0.1 sebesar 61; pada bagian penjelasan evaluasi disebutkan bahwa hasil non-Gemini secara default berasal dari laporan masing-masing pihak, sehingga termasuk ringkasan resmi. Artikel dan halaman model Artificial Analysis merupakan pengukuran pihak ketiga.
| Indikator | Laporan resmi sendiri (blog Google) | Kartu model | Artikel Artificial Analysis |
|---|---|---|---|
| Indeks kecerdasan (xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | Tidak tercantum | 59 (Antigravity CLI, xhigh) |
| MKA | Tidak tercantum | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | Tidak tercantum |
| SWE-sweep | mini-SWE 12.8%, Antigravity 39.0% | harness vendor 39.0%, mini-SWE 12.8% | Tidak tercantum |
| Klaim biaya per tugas | high bawaan 32% lebih rendah daripada Carbon | Tidak tercantum | 6.44 dolar, sekitar 17% lebih sedikit dibanding harga non-diskon Carbon 7.76 dolar |
Angka yang tidak cocok tetap dipertahankan di tabel: Coding Agent Index pada laporan resmi sendiri 58.6, sedangkan artikel Artificial Analysis 59; MKA pada kartu model 56.5%, sedangkan artikel Artificial Analysis 56%. Angka 12.8% dan 39.0% pada SWE-sweep berasal dari dua harness berbeda; blog Google mengaitkan selisih tersebut dengan peningkatan yang dibawa oleh harness.
Dasar penghitungan biaya juga punya tiga versi. Klaim “32% lebih rendah” dari Google memakai perhitungan mereka sendiri; blog tidak menyebut apakah Carbon menggunakan harga perkenalan atau harga standar. Klaim “sekitar 17% lebih sedikit” dalam artikel Artificial Analysis dihitung dari harga standar Carbon 4/20 sehingga menghasilkan 7.76 dolar. Angka 4.90 dolar untuk Carbon high di halaman model Artificial Analysis dihitung berdasarkan harga perkenalan saat ini di halaman tersebut, yaitu 2/10. Ketiga kelompok angka tersebut masing-masing berdiri sendiri dan tidak dapat saling dikonversi.
Rekomendasi skenario: Gemini 4 Neon atau GPT-6.2 Astra dilihat dari catatan biaya mana
Skenario saat Anda melihat angka GPT-6.2 Astra lebih dulu
- Menghitung berdasarkan anggaran per tugas: Jika Anda menyusun anggaran berdasarkan “berapa biaya untuk satu soal”, lihat dulu biaya per tugas di halaman model Artificial Analysis. Astra (max) sebesar USD 4,00.
- Peduli pada total waktu penyelesaian: Tingkat xhigh Astra 7,4 menit dengan skor kecerdasan 62, sedangkan tingkat max 13,7 menit. Dua tingkat dengan skor sama ini punya perbedaan durasi yang jelas, jadi saat memilih tingkat, keduanya perlu dinilai terpisah.
- Tugas batch dengan output pendek: Astra menghasilkan output indeks 65,8 juta token. Penggunaan output termasuk rendah dalam tagihannya.
Skenario saat Anda melihat angka Gemini 4 Neon lebih dulu
- Antarmuka interaktif dan waktu tunggu token pertama: Neon (xhigh) membutuhkan 56,51 detik untuk token jawaban pertama, sedangkan tingkat low yang tercantum di FAQ adalah 13,93 detik.
- Input multimodal: Kartu model DeepMind menyebutkan bahwa input dapat berupa teks, gambar, audio, dan video, dengan jendela terpadu maksimal 1 juta token dan batas pengetahuan Maret 2026.
- Orkestrasi plus subtugas: Panduan pengembang Google menyebutkan bahwa
gemini-4-neondapat dipakai sebagai model orkestrasi, laluprevious_interaction_idditeruskan kegemini-4-hydrogenuntuk menjalankan subtugas yang lebih cepat. - Menghitung berdasarkan harga per token: Halaman harga Google AI Studio mencantumkan Neon dengan input 3,00, cache 0,15, dan output 15,00 dolar per juta token. Output mencakup token pemikiran, dan tidak ada tingkat gratis.
Memeriksa model dan harga Gemini 4 Neon serta GPT-6.2 Astra di APIYI
Halaman tabel ringkasan APIYI mencantumkan waktu pembaruan 2026-11-16 09:39 (UTC+8), lalu pada 2026-11-19 kami memverifikasi ulang endpoint harga (versi shell-api-modelmak-v1, total 285 model). Anda bisa membandingkannya satu per satu di daftar model pada apiyi.com. Di endpoint harga, model_ratio 1 berarti input 2 USD per juta token, sedangkan completion_ratio 5 berarti output 5 kali input, sesuai dengan tingkat pertama di tabel ringkasan.
| ID Model | Input | Baca cache | Output | Endpoint | Keterangan |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | Input 16 untuk lebih dari 272000 token; output tingkat tinggi di endpoint harga sekitar 60, tabel ringkasan tidak menuliskan output tingkat ini |
gpt-6.2-sol |
2 | 0.1 | 10 | responses (direkomendasikan), chat | Input 3 untuk lebih dari 272000 token; output tingkat tinggi di endpoint harga sekitar 11.25 |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | Sesuai harga perkenalan Google hingga 2026-11-30 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | Grup Default, SVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat, messages | Tersedia juga versi -thinking |
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | Tersedia juga versi -thinking |
gemini-4-neon |
— | — | — | — | Tidak tercantum di tabel ringkasan maupun endpoint harga |
Satuannya USD per juta token. Angka 2/0.1/10 untuk gemini-4-carbon adalah harga rak APIYI saat ini, cocok dengan harga perkenalan Google, dan perlu dibedakan dari harga standar Google setelahnya, yaitu 4/20. Penulisan nama grup sedikit berbeda di dua tempat, misalnya tabel ringkasan menulis Default, SVIP, sedangkan endpoint harga menulis default, svip; untuk seri Claude, tabel ringkasan menulis Claude_Reverse, Claude_Enterprise, sedangkan endpoint harga menulis ClaudeCodeReverse, ClaudeOfficial. Kedua set nama tersebut mengikuti yang ditampilkan platform.
Harga resmi Gemini 4 Neon berasal dari halaman harga Google AI Studio: input 3.00, cache 0.15, output 15.00 USD per juta token, dan hanya mendukung cache implisit. gemini-4-neon tidak ada di tabel ringkasan maupun endpoint harga APIYI, juga tidak punya halaman model tersendiri, jadi belum tersedia; kami akan segera menayangkan model ini. Model dan harga mengikuti daftar model di platform.
Mulai Cepat: Memanggil GPT-6.2 Astra melalui APIYI
gpt-6.2-astra menggunakan endpoint responses yang kompatibel dengan OpenAI. Ikuti empat langkah berikut untuk menjalankannya:
- Daftar di apiyi.com dan buat Kunci API, lalu simpan di variabel lingkungan
APIYI_API_KEY. Kode hanya membaca dari variabel lingkungan, jangan menulis kunci dalam teks polos. - Inisialisasi klien dengan OpenAI SDK:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). - Panggil endpoint responses:
resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别"), lalu bacaresp.output_text. - Periksa penagihan: tier pertama tabel utama APIYI adalah input 8, cache read 0.4, output 40 USD/juta token. Jika input per permintaan melewati 272000 token, input menjadi 16;
CompletionRatiopada endpoint harga di tier ini adalah 3.75, dan output sekitar 60 USD/juta token. Badan tabel utama tidak mencantumkan output untuk tier ini.
Untuk tugas dengan konteks panjang, perhatikan langkah 4. Setelah melewati 272000 token, input dan output sama-sama naik tier, sehingga biaya per tugas bisa cukup jauh dari perkiraan tier pertama. Sebaiknya hitung dulu jumlah token pada permintaan tipikal sebelum menentukan anggaran.
Model Gemini yang sudah tersedia memiliki dua cara akses: gemini-4-carbon dan gemini-4-hydrogen dapat memakai alamat yang sama yang kompatibel dengan OpenAI melalui endpoint chat, atau memakai alamat native Gemini https://api.apiyi.com dengan versi API v1beta. Aturan parameter Neon dapat dipelajari lebih dulu dari panduan developer Google: tingkat thinking hanya low, medium, high, dan xhigh, dengan default high; mengirim thinking_budget atau MINIMAL akan mengembalikan HTTP 400; cache konteks eksplisit tidak didukung, sedangkan prefix bersama di atas 4096 token otomatis memakai cache implisit; output default per segmen maksimal 65536 token.
🚀 Mulai Cepat: Sebaiknya klaim dulu kuota uji coba gratis untuk pengguna baru di APIYI apiyi.com, lalu gunakan Kunci API yang sama untuk memanggil
gpt-6.2-astra,gpt-6.2-sol, dangemini-4-carbonsecara berurutan. Catat jumlah token input dan output masing-masing, lalu masukkan ke tabel harga di atas untuk menghitung biaya per tugas.
Saran Keputusan Gemini 4 Neon dan GPT-6.2 Astra
| Aspek yang Anda perhatikan | Kolom yang perlu dilihat lebih dulu | Gemini 4 Neon (xhigh) | GPT-6.2 Astra | Sumber |
|---|---|---|---|---|
| Skor kecerdasan | Skor kecerdasan | 61 | max 62, xhigh 62 | Halaman model Artificial Analysis |
| Berapa lama menyelesaikan satu soal | Waktu per tugas | 21.5 menit | max 13.7 menit, xhigh 7.4 menit | Halaman model Artificial Analysis |
| Berapa lama menunggu token pertama | Token jawaban pertama | 56.51 detik | max 197.65 detik | Halaman model Artificial Analysis |
| Harga per juta token | Harga satuan | 3 / 15 | 8 / 40 | Halaman model Artificial Analysis, tabel lengkap APIYI |
| Berapa biaya menjalankan indeks | Biaya per tugas | 6.44 USD | max 4.00 USD | Halaman model Artificial Analysis |
| Cara penagihan input panjang | Tingkat harga | Referensi tidak mencantumkan tingkat harga | Input di atas 272000 token: 16, output sekitar 60 | Tabel lengkap APIYI, antarmuka harga |
Saat mengambil keputusan, tentukan dulu baris mana yang paling penting bagi bisnis Anda, lalu lihat angka dan sumber pada baris itu. Selisih skor kecerdasan hanya 1 poin; arah perbedaan pada baris waktu, token jawaban pertama, harga satuan, dan biaya per tugas tidak sama, sehingga satu baris tidak bisa menggantikan baris lainnya.
💡 Saran pemilihan: Kumpulan soal indeks dan tugas nyata Anda sering berbeda dalam struktur token. Kami menyarankan Anda menguji sampel sendiri di apiyi.com terhadap model yang sudah terdaftar, catat penggunaan token dan waktu eksekusi, lalu tentukan tier dan model.
Tanya Jawab Umum Gemini 4 Neon dan GPT-6.2 Astra
Q1: Apa itu Gemini 4 Neon?
Gemini 4 Neon adalah model yang dirilis Google pada 18 November 2026 dengan ID model `gemini-4-neon`. Kartu model DeepMind menyatakan bahwa model ini diadaptasi dari Gemini 4 Carbon; dalam keluarga tersebut, posisinya berada di antara Hydrogen (eksekusi cepat untuk penggunaan sehari-hari) dan Carbon (tugas panjang yang kompleks), dengan jendela konteks terpadu 1048576 token.
Q2: Berapa selisih skor kecerdasan Gemini 4 Neon dan GPT-6.2 Astra?
Di halaman model Artificial Analysis, Neon (xhigh) mendapat 61, Astra (max) 62, dan Astra (xhigh) juga 62. Kedua level Astra memiliki skor yang sama, dengan waktu masing-masing 13.7 menit dan 7.4 menit; saat mengutip, sertakan levelnya.
Q3: Kapan Gemini 4 Neon tersedia?
Sundar Pichai menulis pada hari peluncuran bahwa Neon tersedia mulai 18 November 2026 di Gemini API pada Google AI Studio, Gemini for business, Google Antigravity untuk Google AI Pro dan Ultra berbayar, serta Gemini App untuk Pro dan Ultra. Halaman harga Google AI Studio menyatakan bahwa model ini tidak memiliki tier gratis.
Q4: Harga satuan GPT-6.2 Astra lebih tinggi, mengapa biaya per tugasnya 4.00 dolar?
Biaya per tugas ditentukan oleh harga satuan dan jumlah penggunaan. Halaman model Artificial Analysis mencatat Astra (max) menjalankan indeks dengan output 65,8 juta token, sedangkan Neon (xhigh) 283 juta token. Meskipun harga satuan output Astra 40 berbanding 15, penggunaannya jauh lebih sedikit, sehingga biaya per tugas Astra 4.00 dolar AS dan Neon 6.44 dolar AS.
Q5: Bagaimana cara cepat memanggil GPT-6.2 Astra melalui API?
1. Daftar di APIYI apiyi.com dan dapatkan kunci API serta kuota uji gratis;
2. Atur base_url di OpenAI SDK ke alamat kompatibel OpenAI pada panduan cepat di atas;
3. Gunakan endpoint responses, isi model dengan `gpt-6.2-astra`.
`gemini-4-neon` saat ini belum ada di tabel utama maupun endpoint harga APIYI; setelah tersedia, gunakan daftar model platform sebagai acuan.
Q6: Apa saja batasan saat mengutip angka-angka ini?
– **Dasar pengukuran**: laporan resmi, kartu model, artikel Artificial Analysis, dan halaman model berasal dari sumber yang berbeda; Coding Agent Index memiliki dua nilai, 58.6 dan 59; MKA memiliki dua nilai, 56.5% dan 56%.
– **Biaya**: klaim Google “32% lebih rendah”, artikel Artificial Analysis “sekitar 17% lebih sedikit”, dan Carbon 4.90 dolar AS di halaman model merupakan tiga perhitungan terpisah dan tidak dapat digabungkan.
– **Penerapan**: biaya per tugas dari indeks berasal dari kumpulan soal tetap; struktur token tugas Anda berbeda, sehingga hasilnya juga akan berbeda.
Poin-Poin Utama Gemini 4 Neon dan GPT-6.2 Astra
- Skor kecerdasan: Pada halaman model Artificial Analysis, Astra (max) 62, Astra (xhigh) 62, Neon (xhigh) 61.
- Durasi: Neon (xhigh) 21.5 menit, Astra max 13.7 menit, xhigh 7.4 menit — tingkatannya harus dikutip secara terpisah.
- Harga satuan: Astra 8/40, Neon 3/15 dolar per juta token; harga Neon bersumber dari halaman penetapan harga Google AI Studio.
- Biaya per tugas: Astra (max) 4.00 dolar, Neon (xhigh) 6.44 dolar; selisihnya berasal dari jumlah token output yang terpakai.
- Kecepatan dan token pertama: Neon 110 token/detik dengan token pertama 56.51 detik; Astra 50 token/detik dengan token pertama 197.65 detik.
- Etalase APIYI:
gpt-6.2-astratingkat pertama 8/0.4/40, untuk input di atas 272000 token menjadi 16, output pada antarmuka penetapan harga sekitar 60;gemini-4-neonbelum tersedia.
Ringkasan Perbandingan Gemini 4 Neon dan GPT-6.2 Astra
Kunci perbandingan Gemini 4 Neon dan GPT-6.2 Astra adalah mencatat pembukuannya secara terpisah:
- Pembukuan skor kecerdasan: 61 berbanding 62; Astra xhigh dan max sama-sama 62, bersumber dari halaman model Artificial Analysis.
- Pembukuan durasi: 21.5 menit berbanding 13.7 menit (Astra xhigh 7.4 menit); kecepatan output dan waktu token pertama adalah rangkaian angka yang berbeda lagi.
- Pembukuan harga: harga satuan 3/15 berbanding 8/40, biaya per tugas 6.44 berbanding 4.00 dolar, dengan selisih di antaranya berasal dari 283 juta berbanding 65.8 juta token output.
Saat memilih model, tentukan dulu pembukuan mana yang Anda pakai untuk menghitung, lalu verifikasi ulang pemakaian token dengan sampel Anda sendiri. Disarankan melakukan uji banding model yang sudah tersedia melalui APIYI apiyi.com dengan satu Key; setelah gemini-4-neon tersedia, model tersebut bisa langsung dimasukkan ke alur yang sama.
📚 Referensi
-
Postingan Sundar Pichai: Peluncuran Gemini 4 Neon dan saluran peluncurannya
- Tautan:
x.com/sundarpichai/status/2123167780988125621 - Keterangan: tanggal peluncuran dan pintu masuk peluncuran
- Tautan:
-
Blog Google “Introducing Gemini 4 Neon”: benchmark, harga, dan positioning versi resmi
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Keterangan: Coding Agent Index 58.6, biaya 32% lebih rendah, dan angka-angka resmi lainnya
- Tautan:
-
Kartu Model DeepMind Gemini 4 Neon: tabel perbandingan dan spesifikasi model
- Tautan:
deepmind.google/models/model-cards/gemini-4-neon/ - Keterangan: tabel perbandingan hanya memuat tiga kolom: Neon, Claude Opus 5.5, dan GPT-6.2 Sol
- Tautan:
-
Panduan Developer Google Cloud: parameter
gemini-4-neondan aturan cache- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Keterangan: tingkat pemikiran, kondisi
HTTP 400, cache implisit
- Tautan:
-
Halaman Harga Google AI Studio: harga resmi keluarga Gemini 4
- Tautan:
aistudio.google.com/docs/pricing - Keterangan: Neon 3/0.15/15, harga perkenalan Carbon berlaku hingga 2026-11-30
- Tautan:
-
Artikel Artificial Analysis: skor kecerdasan dan analisis biaya Neon
- Tautan:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Keterangan: pengukuran pihak ketiga, termasuk angka harga standar Carbon yang sekitar 17% lebih rendah
- Tautan:
-
Halaman Model Artificial Analysis: Gemini 4 Neon dan GPT-6.2 Astra
- Tautan:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-astra - Keterangan: sumber data utama untuk tiga perhitungan dalam artikel ini, dibaca pada 2026-11-19
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda situs resmi APIYI. Untuk model dan harga, mohon mengacu pada daftar model platform dan pusat dokumentasi.