作者注:本文按来源标签拆开 Gemini 4 Neon 与 GPT-6.2 Astra 的智力分、单任务耗时、单价与单任务费用三本账,并列出 API易 已上架型号的标价、阶梯与调用地址。
2026 年 11 月 18 日,Google 发布 Gemini 4 Neon。Sundar Pichai 当天宣布它在 Google AI Studio 的 Gemini API、Gemini for business、Google Antigravity 和 Gemini App 开始推出。同一天,Artificial Analysis 文章把 Neon xhigh 排在智力指数综合第 3,排在它前面的是 GPT-6.2 Astra(max)和 Claude Fable 5.2(max)。把 Neon 和 Astra 放在一起时,最容易混在一起的是 单价 和 单任务费用:前者是每百万 token 的标价,后者是跑完一道题实际花掉的钱。
下面三本账全部取自 Artificial Analysis 模型页(2026-11-19 读取,指数 v5.0.1),档位写在括号里,不同档位分开列:
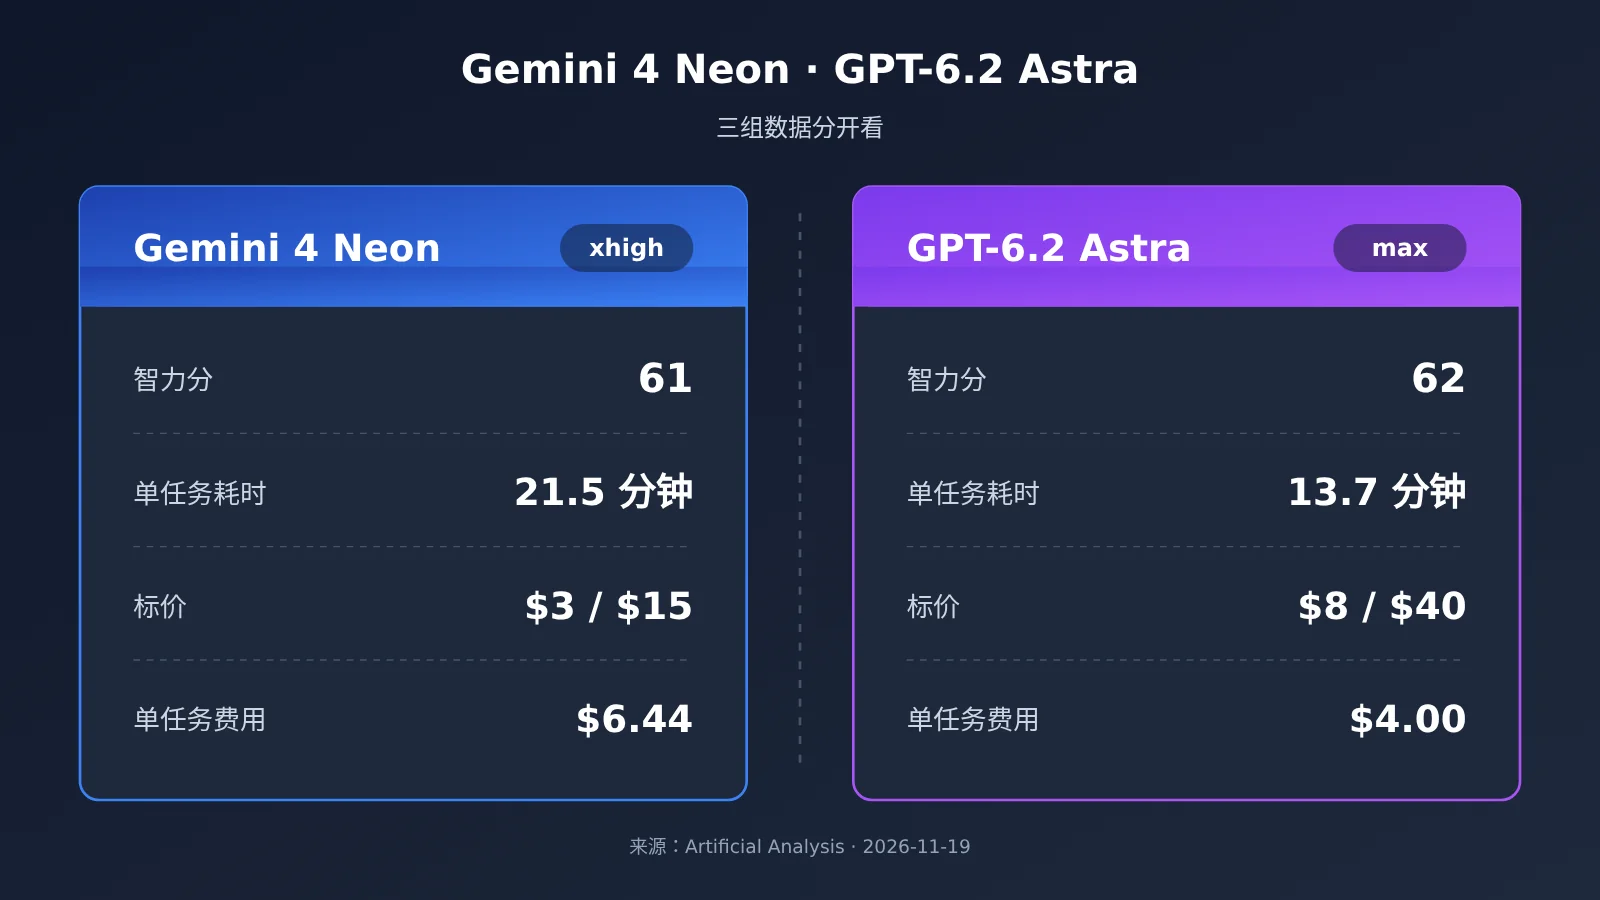
- 智力分:GPT-6.2 Astra(max)62,Gemini 4 Neon(xhigh)61。Astra 的 xhigh 档同样是 62。
- 单任务耗时:Astra(max)13.7 分钟,Astra(xhigh)7.4 分钟,Neon(xhigh)21.5 分钟。
- 单价与单任务费用:Astra 标价输入 8、输出 40 美元/百万 token,Neon 为 3/15;单任务费用 Astra(max)4.00 美元,Neon(xhigh)6.44 美元。
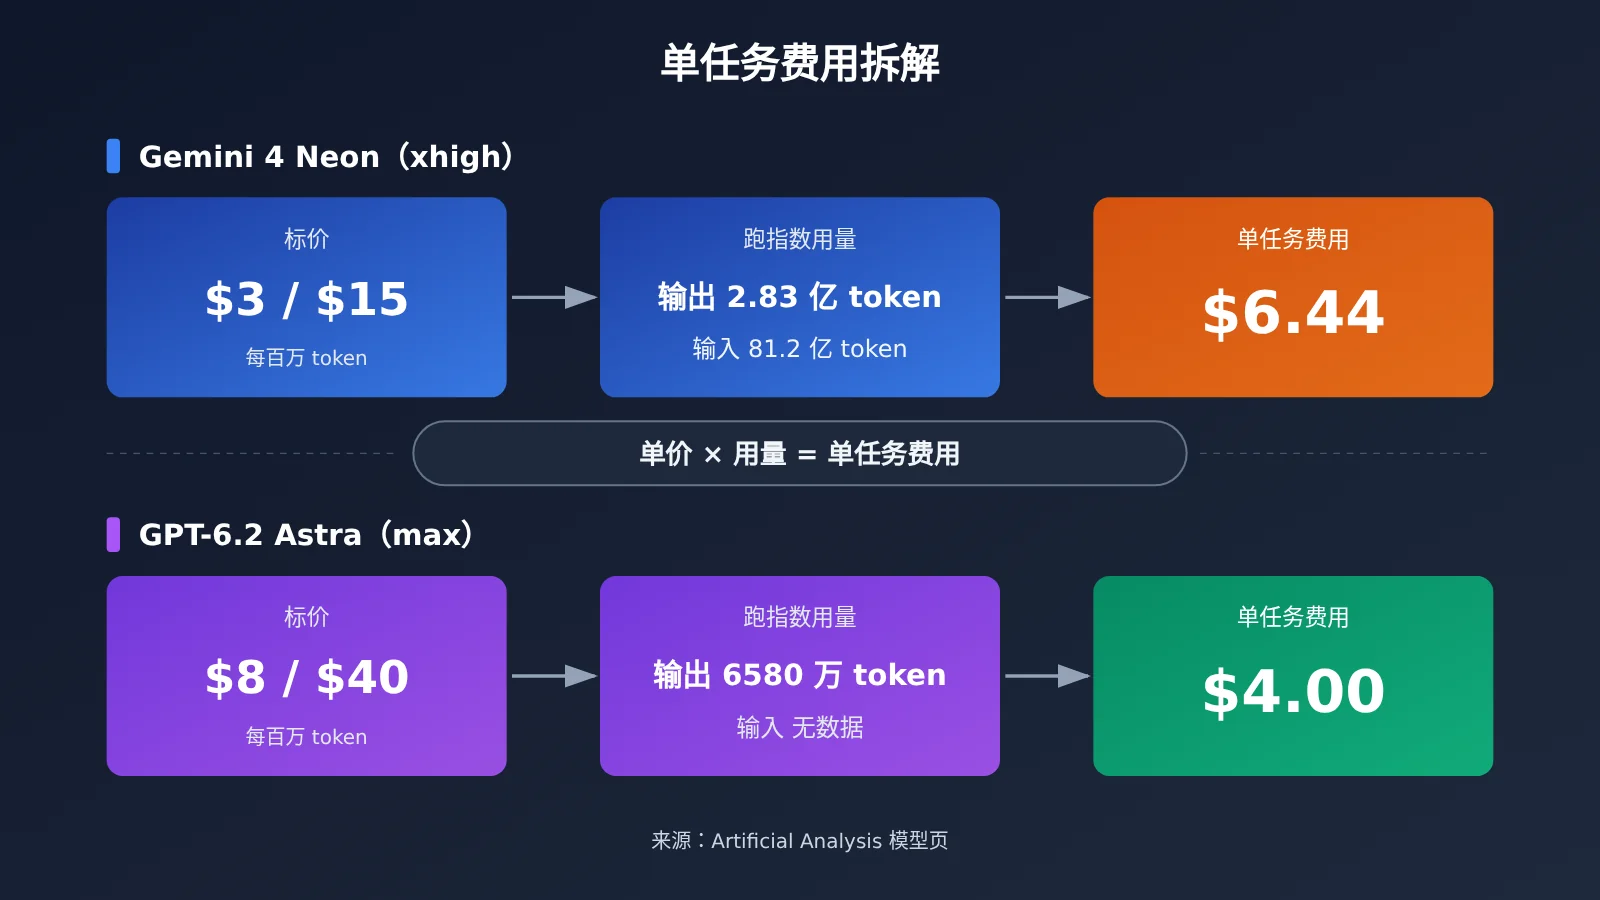
让单价和单任务费用走向相反的,是 token 用量。跑同一套指数,Astra(max)输出 6580 万 token,Neon(xhigh)输出 2.83 亿 token;速度上 Neon 每秒约 110 token、首个答案 token 56.51 秒,Astra 每秒 50 token、首个答案 token 197.65 秒。本文只负责把这些数字分栏摆清楚,哪本账对你更重要,要看你的任务结构。
核心价值:读完本文,你能分清 Gemini 4 Neon 与 GPT-6.2 Astra 每个数字出自哪本账、哪个档位,并知道 API易 上哪些型号可直接调用、价格在哪里跳档。
Gemini 4 Neon 与 GPT-6.2 Astra 核心差异
下表全部来自 Artificial Analysis 模型页,Neon 取 xhigh,Astra 取 max,这两档分别是两个页面上的顶档。DeepMind 模型卡的对照表只有 Gemini 4 Neon、Claude Opus 5.5、GPT-6.2 Sol 三列,没有 Astra,所以 Astra 一侧只用 Artificial Analysis 模型页的数字。
| 对比维度 | Gemini 4 Neon(xhigh) | GPT-6.2 Astra(max) | 来源 |
|---|---|---|---|
| 智力分 | 61 | 62(xhigh 也是 62) | Artificial Analysis 模型页 |
| 单任务时间 | 21.5 分钟 | 13.7 分钟(xhigh 为 7.4 分钟) | Artificial Analysis 模型页 |
| 标价(输入/输出,美元/百万 token) | 3.00 / 15.00 | 8.00 / 40.00 | Artificial Analysis 模型页 |
| 单任务费用 | 6.44 美元 | 4.00 美元 | Artificial Analysis 模型页 |
| 跑指数输出 token | 2.83 亿 | 6580 万 | Artificial Analysis 模型页 |
| 输出速度 | 110 token/秒 | 50 token/秒 | Artificial Analysis 模型页 |
| 首个答案 token | 56.51 秒 | 197.65 秒 | Artificial Analysis 模型页 |
| 缓存折扣 / 混合价 | 95% / 2.21 | 95% / 5.88 | Artificial Analysis 模型页 |
这张表按行读最稳妥。智力分、耗时、价格三组各自独立,同一列里出现“分高”“时间短”“单价高”并不矛盾。
GPT-6.2 Astra 单价更高、单任务费用更低的原因
单任务费用可以粗略理解为“用掉多少 token × 每个 token 的价格”。Astra 的输出标价 40 美元/百万 token,是 Neon 15 美元的两倍多;可 Artificial Analysis 模型页记录的跑指数输出量,Astra 为 6580 万 token,不到 Neon 2.83 亿 token 的四分之一。用量那一头压得更低,单价高的一方单任务费用落在 4.00 美元,Neon 落在 6.44 美元。
输入侧要单独说明。Neon 模型页写了跑指数输入 81.2 亿 token,参考资料里没有 Astra 的输入 token 数,所以这里只拆输出侧,不倒推完整账单。混合价 Neon 2.21、Astra 5.88,同样只反映标价层面,用来估算你自己的账单时还要乘上你的 token 结构。
换到具体业务,token 结构会变。输入很长、输出很短的任务,输入单价 8 对 3 的权重会变大;输出很长的任务,输出用量那一项会主导结果。指数上的单任务费用是一次固定题集的结果,迁移到你的场景前,最好用自己的样本跑一遍。
Gemini 4 Neon 的耗时账:输出快和做完快分开看
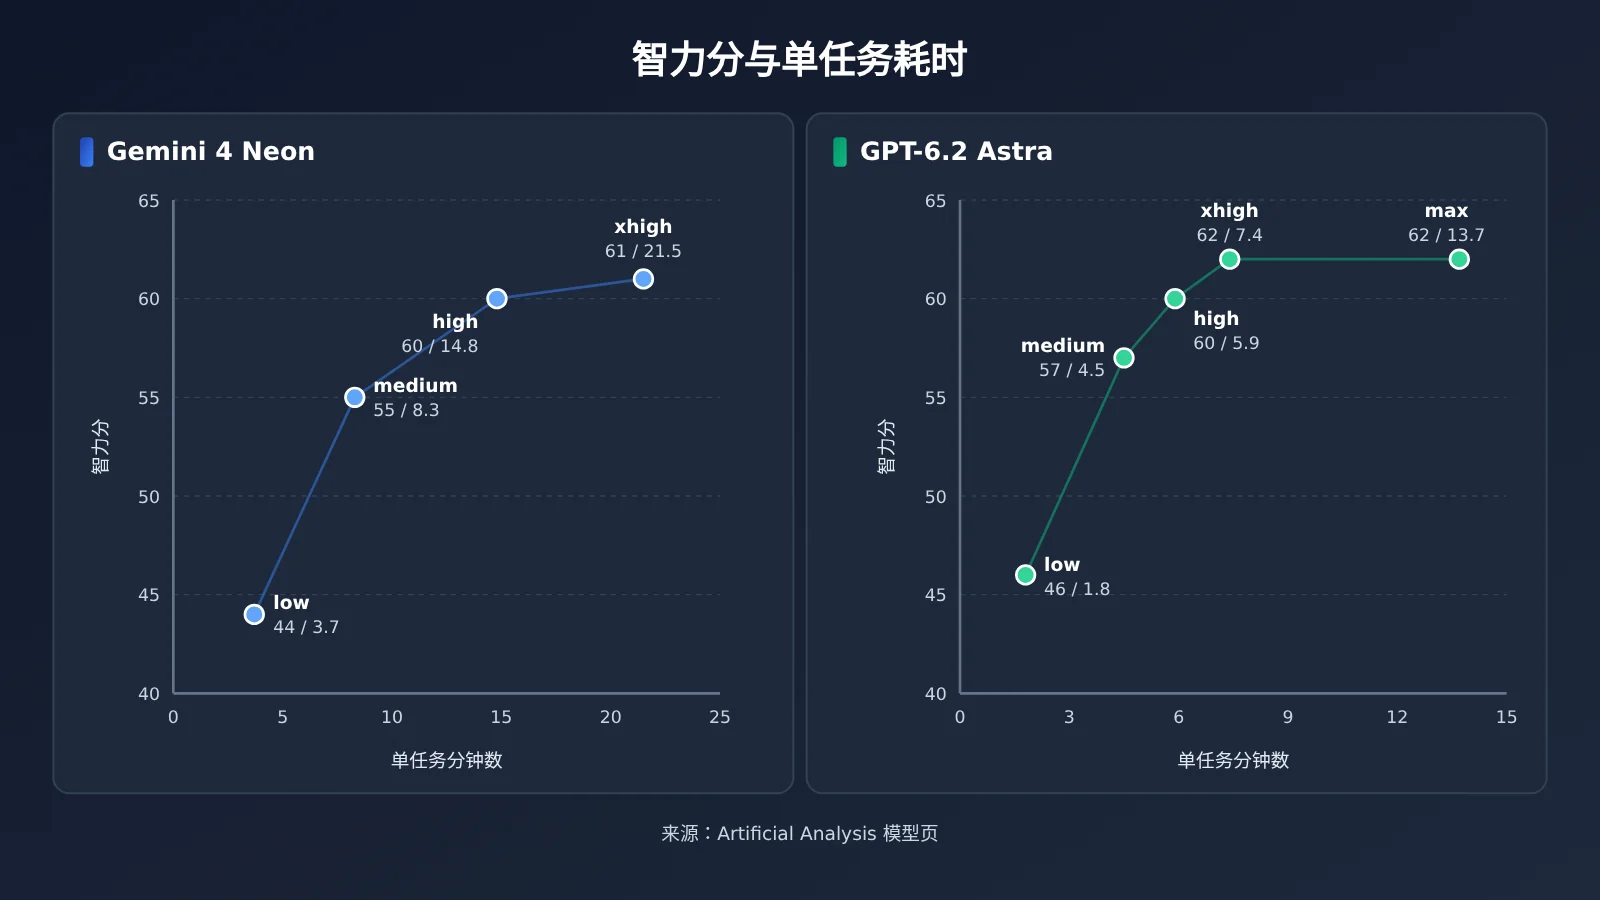
Neon 在模型页上每秒输出约 110 token,是 Astra 50 token/秒的两倍多,首个答案 token 只要 56.51 秒,Astra 要 197.65 秒。单任务时间却是 Neon(xhigh)21.5 分钟,Astra(max)13.7 分钟、xhigh 7.4 分钟。原因同样回到 token 量:输出更多的模型,每秒吐得再快,写完也要更久。
Astra 的 xhigh 与 max 智力分同为 62,耗时一个 7.4 分钟、一个 13.7 分钟,引用时必须带上档位。Neon 一侧,Artificial Analysis 模型页 FAQ 另给了较低档位的首个答案 token:high 40.64 秒、medium 20.14 秒、low 13.93 秒,这组数字来自 FAQ,和汇总表不在同一栏。
Gemini 4 Neon 与 GPT-6.2 Astra 分档位数据
| 模型 | 档位 | 智力分 | 单任务时间 | 输出速度 |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21.5 分钟 | 110 token/秒 |
| Gemini 4 Neon | high(默认) | 60 | 14.8 分钟 | 101 token/秒 |
| Gemini 4 Neon | medium | 55 | 8.3 分钟 | 101 token/秒 |
| Gemini 4 Neon | low | 44 | 3.7 分钟 | 97 token/秒 |
| GPT-6.2 Astra | max | 62 | 13.7 分钟 | 50 token/秒 |
| GPT-6.2 Astra | xhigh | 62 | 7.4 分钟 | 50 token/秒 |
| GPT-6.2 Astra | high | 60 | 5.9 分钟 | 50 token/秒 |
| GPT-6.2 Astra | medium | 57 | 4.5 分钟 | 49 token/秒 |
| GPT-6.2 Astra | low | 46 | 1.8 分钟 | 48 token/秒 |
数据均来自 Artificial Analysis 模型页,Neon 的 high 是 Google 开发者指南写明的默认档。Neon 没有 max 档,Astra 各档的输出速度稳定在 48 到 50 token/秒之间,时间差异主要来自各档写出的 token 数。模型页只给了顶档的单任务费用,其他档位的费用这里不补算。
对比说明:上图与上表数字均取自 Artificial Analysis 模型页。想用自己的任务复核 token 用量,可以在 API易 用同一个 Key 切换已上架型号做对照。
Gemini 4 Neon 官方自报、模型卡与第三方数字对照
Neon 一侧有三类来源,口径各不相同。Google 博客整段属于官方自报,写了 Artificial Analysis Intelligence Index 在 xhigh 为 61、综合第 3,Vals Index 70.9%,Arena Agent Arena Index 1336。DeepMind 模型卡同样写 AA Index v5.0.1 为 61,评估说明注明非 Gemini 的结果默认来自各家自报,属于官方汇总。Artificial Analysis 文章和模型页属于第三方测量。
| 指标 | 官方自报(Google 博客) | 模型卡 | Artificial Analysis 文章 |
|---|---|---|---|
| 智力指数(xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | 未列 | 59(Antigravity CLI,xhigh) |
| MKA | 未列 | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | 未列 |
| SWE-sweep | mini-SWE 12.8%,Antigravity 39.0% | 厂商 harness 39.0%,mini-SWE 12.8% | 未列 |
| 单任务成本说法 | 默认 high 比 Carbon 低 32% | 未列 | 6.44 美元,比 Carbon 非折扣价 7.76 美元约少 17% |
对不上的数字在表里都保留:Coding Agent Index 官方自报 58.6、Artificial Analysis 文章 59;MKA 模型卡 56.5%、Artificial Analysis 文章 56%。SWE-sweep 的 12.8% 与 39.0% 来自两个不同 harness,Google 博客把差距归为 harness 带来的提升。
成本口径也是三本账。Google 的“低 32%”是自家算法,博客没写 Carbon 用的是介绍价还是标准价;Artificial Analysis 文章的“约少 17%”按 Carbon 标准价 4/20 算出 7.76 美元;Artificial Analysis 模型页上 Carbon high 的 4.90 美元按页面当前介绍价 2/10 计算。这三组数字各自成立,不能互相换算。
场景推荐:按哪本账看 Gemini 4 Neon 或 GPT-6.2 Astra
先看 GPT-6.2 Astra 数字的场景
- 按单任务预算核算:如果你按“一道题花多少钱”做预算,可以先看 Artificial Analysis 模型页的单任务费用,Astra(max)为 4.00 美元。
- 关心整体完成时间:Astra xhigh 档 7.4 分钟、智力分 62,max 档 13.7 分钟,同分两档耗时差别明显,选档时要分开评估。
- 批量任务、输出要短:Astra 跑指数输出 6580 万 token,输出用量这一项在它的账单里占比较低。
先看 Gemini 4 Neon 数字的场景
- 交互界面、在意首字等待:Neon(xhigh)首个答案 token 56.51 秒,FAQ 给出的 low 档为 13.93 秒。
- 多模态输入:DeepMind 模型卡写明输入可为文本、图像、音频、视频,统一窗口最多 100 万 token,知识截止 2026 年 3 月。
- 编排加子任务:Google 开发者指南提到可以把
gemini-4-neon当编排模型,把previous_interaction_id交给gemini-4-hydrogen做更快的子任务。 - 按每 token 标价核算:Google AI Studio 定价页写 Neon 输入 3.00、缓存 0.15、输出 15.00 美元/百万 token,输出含思考 token,没有免费档。
在 API易 查 Gemini 4 Neon 与 GPT-6.2 Astra 的型号和价格
API易总表页面标注更新于 2026-11-16 09:39(UTC+8),2026-11-19 又核对了定价接口(版本 shell-api-modelmak-v1,共 285 个模型),可在 apiyi.com 的型号列表里逐项比对。定价接口中 model_ratio 1 对应输入每百万 token 2 美元,completion_ratio 5 表示输出是输入的 5 倍,和总表首档一致。
| 型号 ID | 输入 | 缓存读 | 输出 | 端点 | 说明 |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | 超过 272000 token 输入 16;定价接口高档输出约 60,总表未写这档输出 |
gpt-6.2-sol |
2 | 0.1 | 10 | responses(推荐)、chat | 超过 272000 token 输入 3;定价接口高档输出约 11.25 |
gemini-4-carbon |
2 | 0.1 | 10 | chat、gemini | 对应 Google 到 2026-11-30 的介绍价 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat、gemini | 分组 Default、SVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat、messages | 另有 -thinking 版本 |
claude-fable-5-2 |
8 | 0.2 | 40 | chat、messages | 另有 -thinking 版本 |
gemini-4-neon |
— | — | — | — | 总表与定价接口均未收录 |
单位均为美元/百万 token。gemini-4-carbon 的 2/0.1/10 是 API易当前货架价,对得上 Google 的介绍价,和 Google 之后的标准价 4/20 分开看。分组名称两处写法略有出入,例如总表写 Default、SVIP,定价接口写 default、svip;Claude 系列总表写 Claude_Reverse、Claude_Enterprise,定价接口写 ClaudeCodeReverse、ClaudeOfficial,两套名字都以平台显示为准。
Gemini 4 Neon 的官方标价来自 Google AI Studio 定价页:输入 3.00、缓存 0.15、输出 15.00 美元/百万 token,只支持隐式缓存。gemini-4-neon 在 API易总表和定价接口里都没有,也没有独立型号页,暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。
快速上手:通过 API易 调用 GPT-6.2 Astra
gpt-6.2-astra 走 OpenAI 兼容的 responses 端点,按下面四步即可跑通:
- 在 apiyi.com 注册并创建 API Key,写入环境变量
APIYI_API_KEY,代码里只从环境变量读取,不写明文钥匙。 - 用 OpenAI SDK 初始化客户端:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")。 - 调用 responses 端点:
resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别"),再读取resp.output_text。 - 核对计费:API易总表首档输入 8、缓存读 0.4、输出 40 美元/百万 token;单次输入超过 272000 token 时输入变为 16,定价接口在这一档的
CompletionRatio为 3.75,输出约 60 美元/百万 token,总表正文没写这档输出。
长上下文任务要特别留意第 4 步。超过 272000 token 后输入和输出同时跳档,单任务费用会明显偏离首档估算,建议先把典型请求的 token 数统计出来再定预算。
已上架的 Gemini 型号有两种接法:gemini-4-carbon、gemini-4-hydrogen 可以用同一个 OpenAI 兼容地址走 chat 端点,也可以用 Gemini 原生地址 https://api.apiyi.com,API 版本 v1beta。Neon 的参数规则可以先从 Google 开发者指南了解:思考档只有 low、medium、high、xhigh,默认 high;传 thinking_budget 或 MINIMAL 会返回 HTTP 400;显式上下文缓存不支持,4096 token 以上的共享前缀自动走隐式缓存;单段默认输出最多 65536 token。
🚀 快速开始:建议先在 API易 apiyi.com 领取新用户免费测试额度,用同一个 Key 依次调用
gpt-6.2-astra、gpt-6.2-sol、gemini-4-carbon,记录各自的输入输出 token 数,再套进上面的价格表算单任务费用。
Gemini 4 Neon 与 GPT-6.2 Astra 决策建议
| 你关心的问题 | 先看哪一列 | Gemini 4 Neon(xhigh) | GPT-6.2 Astra | 来源 |
|---|---|---|---|---|
| 智力分 | 智力分 | 61 | max 62,xhigh 62 | Artificial Analysis 模型页 |
| 做完一题要多久 | 单任务时间 | 21.5 分钟 | max 13.7 分钟,xhigh 7.4 分钟 | Artificial Analysis 模型页 |
| 等首字要多久 | 首个答案 token | 56.51 秒 | max 197.65 秒 | Artificial Analysis 模型页 |
| 每百万 token 标价 | 单价 | 3 / 15 | 8 / 40 | Artificial Analysis 模型页、API易总表 |
| 跑完指数花多少钱 | 单任务费用 | 6.44 美元 | max 4.00 美元 | Artificial Analysis 模型页 |
| 长输入如何计费 | 价格阶梯 | 参考资料未列阶梯 | 超过 272000 token 输入 16、输出约 60 | API易总表、定价接口 |
决策时先确定哪一行对你的业务最重要,再看那一行的数字和来源。智力分只差 1 分,耗时、首字、单价、单任务费用几行的差距方向各不相同,任何一行都不能代替其他几行。
💡 选择建议:指数题集和你的真实任务在 token 结构上往往不同。我们建议把自己的样本放到 apiyi.com 上对已上架型号做一轮对照,记录 token 用量和耗时后再定档位与型号。
Gemini 4 Neon 与 GPT-6.2 Astra 常见问题
Q1:什么是 Gemini 4 Neon?
Gemini 4 Neon 是 Google 2026 年 11 月 18 日发布的模型,模型 ID 为 `gemini-4-neon`。DeepMind 模型卡写明它由 Gemini 4 Carbon 改编,家族里位于 Hydrogen(日常快执行)和 Carbon(复杂长程)之间,统一上下文 1048576 token。
Q2:Gemini 4 Neon 和 GPT-6.2 Astra 的智力分差多少?
Artificial Analysis 模型页上,Neon(xhigh)61,Astra(max)62,Astra(xhigh)也是 62。Astra 两档同分,耗时分别为 13.7 分钟和 7.4 分钟,引用时要带档位。
Q3:Gemini 4 Neon 何时可用?
Sundar Pichai 在发布当天写明,Neon 从 2026 年 11 月 18 日起在 Google AI Studio 的 Gemini API、Gemini for business、付费 Google AI Pro 与 Ultra 的 Google Antigravity,以及 Pro 与 Ultra 的 Gemini App 推出。Google AI Studio 定价页写明它没有免费档。
Q4:GPT-6.2 Astra 单价更高,单任务费用为什么是 4.00 美元?
单任务费用由单价和用量共同决定。Artificial Analysis 模型页记录 Astra(max)跑指数输出 6580 万 token,Neon(xhigh)为 2.83 亿 token,Astra 输出单价虽是 40 对 15,用量少得多,所以单任务费用为 4.00 美元,Neon 为 6.44 美元。
Q5:如何通过 API 快速调用 GPT-6.2 Astra?
1. 在 API易 apiyi.com 注册并获取 API Key 与免费测试额度;
2. OpenAI SDK 的 base_url 设为上文快速上手中的 OpenAI 兼容地址;
3. 走 responses 端点,模型填 `gpt-6.2-astra`。
`gemini-4-neon` 目前在 API易总表和定价接口里都没有,上架后以平台型号列表为准。
Q6:引用这些数字时有哪些限制?
– **口径**:官方自报、模型卡、Artificial Analysis 文章与模型页来源不同,Coding Agent Index 有 58.6 和 59 两个值,MKA 有 56.5% 和 56% 两个值。
– **成本**:Google 的“低 32%”、Artificial Analysis 文章的“约少 17%”、模型页的 Carbon 4.90 美元是三本账,不能合成。
– **迁移**:指数单任务费用来自固定题集,你的任务 token 结构不同,结果也会不同。
Gemini 4 Neon 与 GPT-6.2 Astra 核心要点 Key Takeaways
- 智力分:Artificial Analysis 模型页上 Astra(max)62、Astra(xhigh)62、Neon(xhigh)61。
- 耗时:Neon(xhigh)21.5 分钟,Astra max 13.7 分钟、xhigh 7.4 分钟,档位要分开引用。
- 单价:Astra 8/40,Neon 3/15 美元/百万 token,Neon 价格来自 Google AI Studio 定价页。
- 单任务费用:Astra(max)4.00 美元,Neon(xhigh)6.44 美元,差异来自输出 token 用量。
- 速度与首字:Neon 110 token/秒、首字 56.51 秒;Astra 50 token/秒、首字 197.65 秒。
- API易 货架:
gpt-6.2-astra首档 8/0.4/40,超过 272000 token 输入 16、定价接口输出约 60;gemini-4-neon暂未收录。
Gemini 4 Neon 与 GPT-6.2 Astra 对比总结
Gemini 4 Neon 与 GPT-6.2 Astra 的对比,关键在于把账分开记:
- 智力分账:61 对 62,Astra 的 xhigh 与 max 同为 62,来源是 Artificial Analysis 模型页。
- 耗时账:21.5 分钟对 13.7 分钟(Astra xhigh 为 7.4 分钟),输出速度和首字时间又是另一组数字。
- 价格账:单价 3/15 对 8/40,单任务费用 6.44 对 4.00 美元,中间隔着 2.83 亿对 6580 万的输出 token。
选型时先确定你按哪本账结算,再用自己的样本复核 token 用量。推荐通过 API易 apiyi.com 用一个 Key 对已上架型号做对照测试,gemini-4-neon 上架后可直接加入同一套流程。
📚 参考资料
-
Sundar Pichai 发布帖:Gemini 4 Neon 发布与推出渠道
- 链接:
x.com/sundarpichai/status/2123167780988125621 - 说明:发布日期与上线入口
- 链接:
-
Google 博客 Introducing Gemini 4 Neon:官方自报的基准、价格与定位
- 链接:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 说明:Coding Agent Index 58.6、成本低 32% 等官方口径
- 链接:
-
DeepMind Gemini 4 Neon 模型卡:对照表与模型规格
- 链接:
deepmind.google/models/model-cards/gemini-4-neon/ - 说明:对照表只含 Neon、Claude Opus 5.5、GPT-6.2 Sol 三列
- 链接:
-
Google Cloud 开发者指南:
gemini-4-neon参数与缓存规则- 链接:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 说明:思考档、
HTTP 400条件、隐式缓存
- 链接:
-
Google AI Studio 定价页:Gemini 4 家族官方标价
- 链接:
aistudio.google.com/docs/pricing - 说明:Neon 3/0.15/15,Carbon 介绍价至 2026-11-30
- 链接:
-
Artificial Analysis 文章:Neon 智力分与成本分析
- 链接:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 说明:第三方测量,含约少 17% 的 Carbon 标准价口径
- 链接:
-
Artificial Analysis 模型页:Gemini 4 Neon 与 GPT-6.2 Astra
- 链接:
artificialanalysis.ai/models/gemini-4-neon、artificialanalysis.ai/models/gpt-6-2-astra - 说明:本文三本账的主要数据来源,2026-11-19 读取
- 链接:
作者:APIYI 技术团队
技术交流:欢迎通过 API易 官网首页联系我们,型号与价格请以平台型号列表和文档中心为准。