著者注:本記事は情報源のタグごとに、Gemini 4 Neon と GPT-6.2 Astra のインテリジェンススコア、1タスクあたりの所要時間、単価、そして1タスクあたりのコストという3つの帳簿を分けて整理し、あわせて APIYI に掲載済みのモデルの定価、段階制の料金、呼び出しエンドポイントを一覧にします。
2026年11月18日、Google は Gemini 4 Neon を発表しました。Sundar Pichai は当日、Google AI Studio の Gemini API、Gemini for business、Google Antigravity、Gemini App での提供を開始すると述べています。同じ日、Artificial Analysis の記事は Neon xhigh をインテリジェンス指数の総合で3位に位置づけ、その上位には GPT-6.2 Astra(max)と Claude Fable 5.2(max)が並びました。Neon と Astra を並べて見るときに最も混同しやすいのが 単価 と 1タスクあたりのコスト です。前者は100万トークンあたりの定価、後者は1問を解き終えるまでに実際にかかった費用を指します。
以下の3つの帳簿はすべて Artificial Analysis のモデルページから取得したものです(2026-11-19 時点で参照、指数 v5.0.1)。料金プランは括弧内に記し、プランごとに分けて記載します。
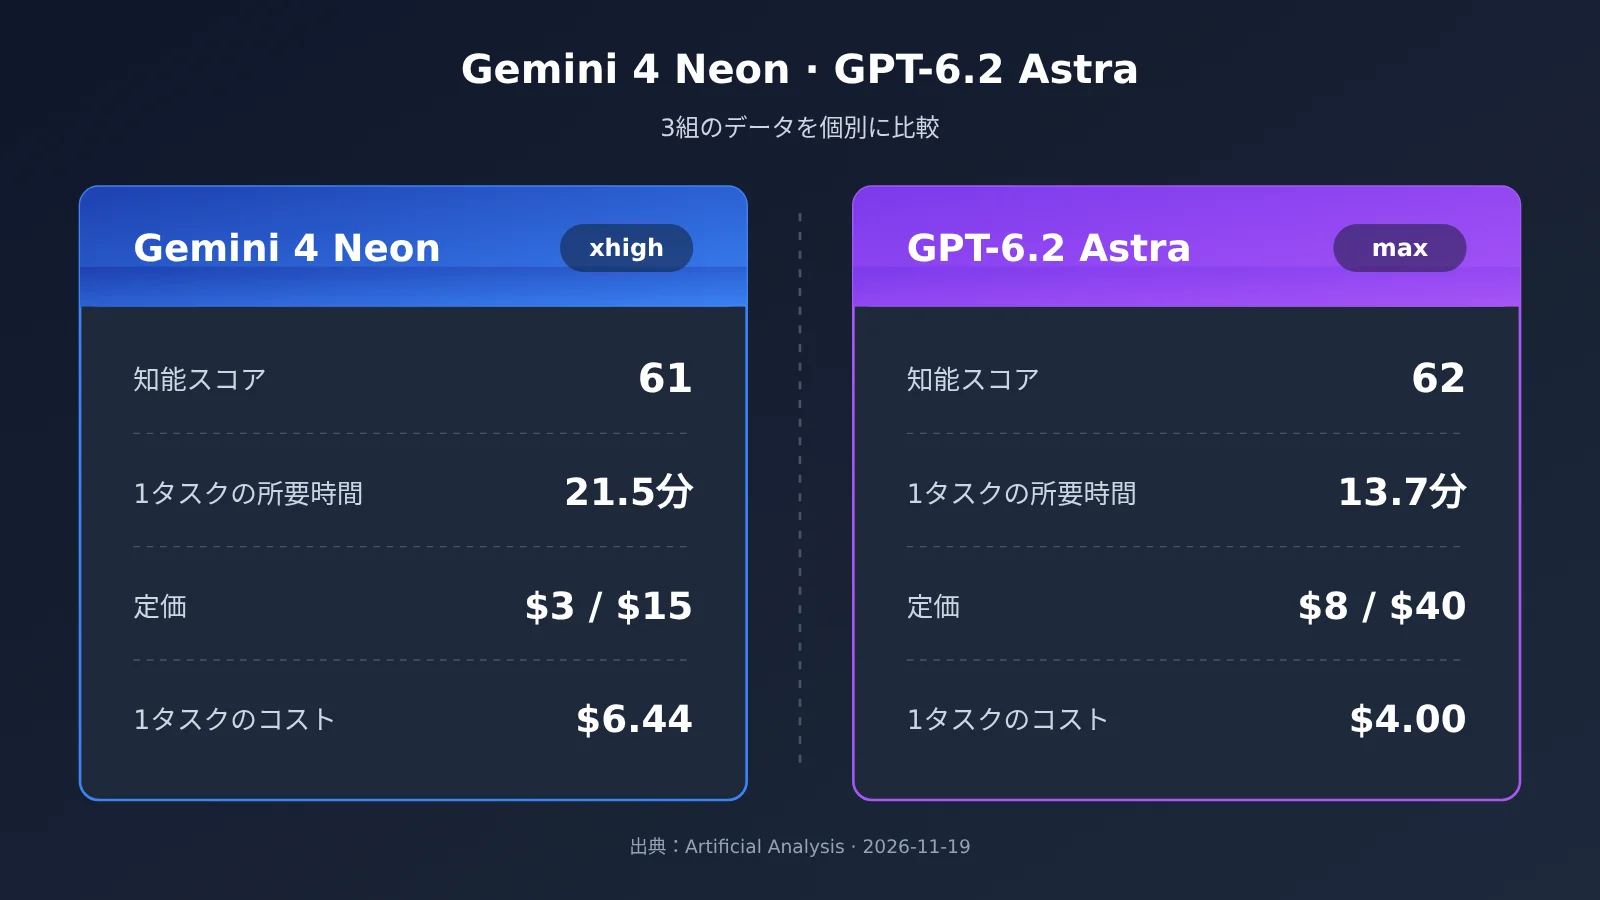
- インテリジェンススコア:GPT-6.2 Astra(max)が62、Gemini 4 Neon(xhigh)が61。Astra の xhigh プランも同じく62です。
- 1タスクあたりの所要時間:Astra(max)が13.7分、Astra(xhigh)が7.4分、Neon(xhigh)が21.5分。
- 単価と1タスクあたりのコスト:Astra の定価は入力8ドル/出力40ドル(100万トークンあたり)、Neon は3/15。1タスクあたりのコストは Astra(max)が4.00ドル、Neon(xhigh)が6.44ドルです。
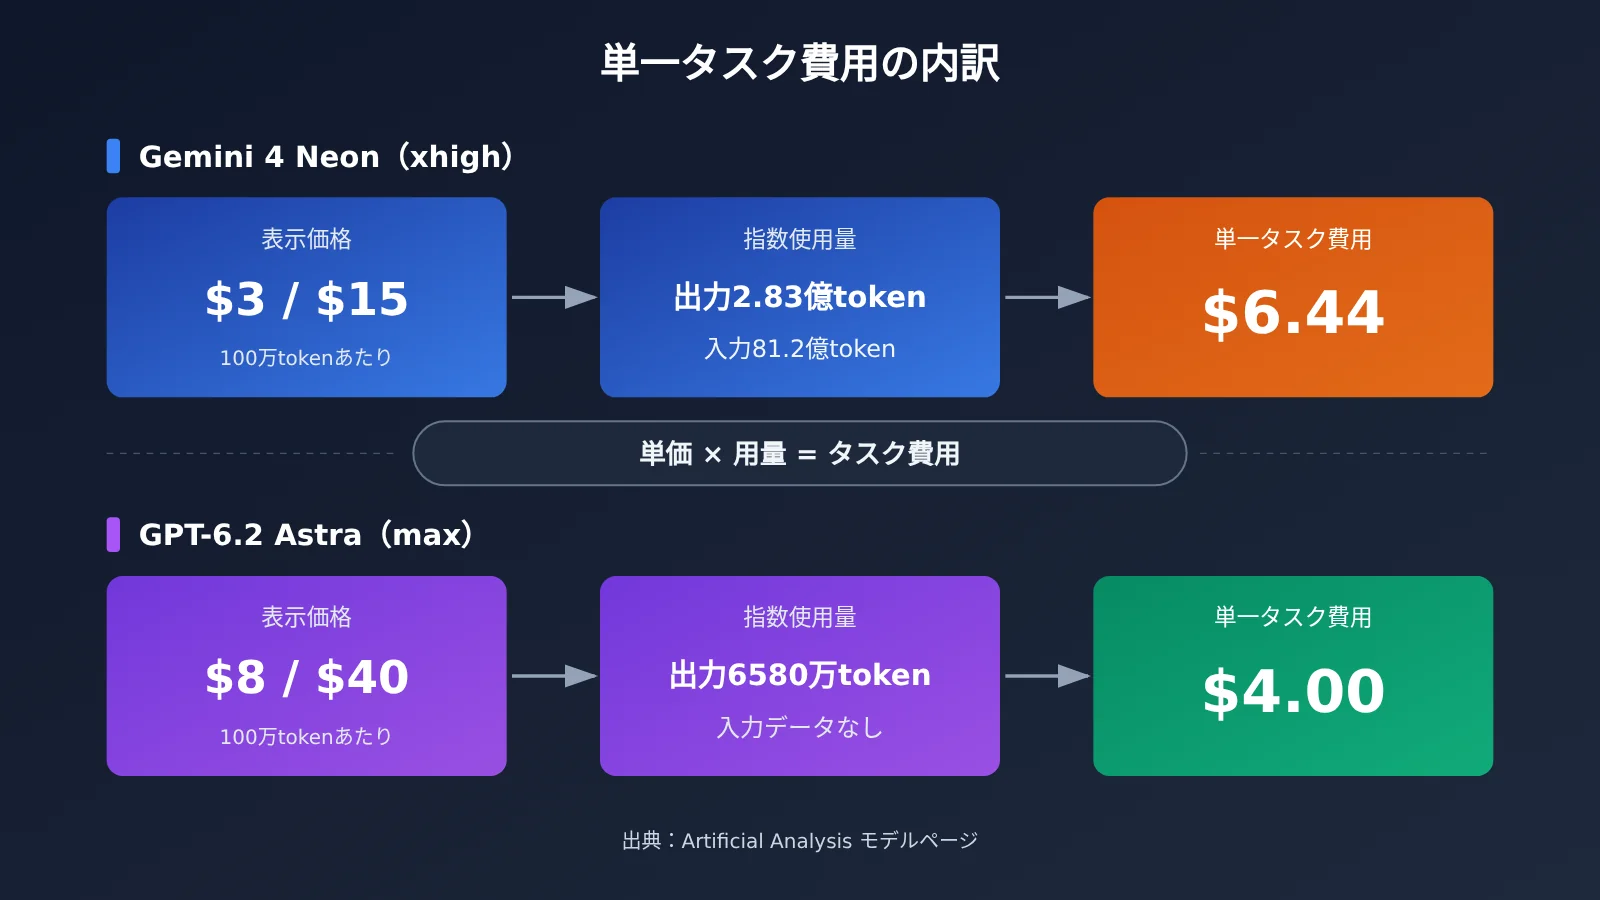
単価と1タスクあたりのコストが逆方向に動くのは、トークン使用量の違いによるものです。同じ指数セットを走らせたとき、Astra(max)の出力は6580万トークン、Neon(xhigh)の出力は2.83億トークンでした。速度面では Neon が毎秒約110トークン、最初のトークンまでの時間が56.51秒、Astra が毎秒50トークン、最初のトークンまでの時間が197.65秒です。本記事の役割はこれらの数字を項目ごとに整理して示すことまでで、どの帳簿を重視すべきかは、あなたのタスク構成によって変わります。
本記事の価値:読み終えたとき、Gemini 4 Neon と GPT-6.2 Astra の各数値がどの帳簿の、どのプランに由来するのかを区別でき、APIYI 上でどのモデルがそのまま呼び出せるのか、価格がどこで段階的に切り替わるのかも把握できるようになります。
Gemini 4 Neon と GPT-6.2 Astra の主な違い
以下の表はすべて Artificial Analysis のモデルページに基づいています。Neon は xhigh、Astra は max を採用しており、これらはそれぞれのページで最上位の設定です。DeepMind のモデルカードにある比較表には Gemini 4 Neon、Claude Opus 5.5、GPT-6.2 Sol の3列しかなく、Astra は含まれていません。そのため、Astra 側は Artificial Analysis モデルページの数値のみを使用しています。
| 比較項目 | Gemini 4 Neon(xhigh) | GPT-6.2 Astra(max) | 出典 |
|---|---|---|---|
| 知能スコア | 61 | 62(xhigh も 62) | Artificial Analysis モデルページ |
| タスクあたりの時間 | 21.5分 | 13.7分(xhigh は7.4分) | Artificial Analysis モデルページ |
| 料金(入力/出力、米ドル/100万トークン) | 3.00 / 15.00 | 8.00 / 40.00 | Artificial Analysis モデルページ |
| タスクあたりのコスト | 6.44米ドル | 4.00米ドル | Artificial Analysis モデルページ |
| インデックス実行時の出力トークン数 | 2.83億 | 6580万 | Artificial Analysis モデルページ |
| 出力速度 | 110トークン/秒 | 50トークン/秒 | Artificial Analysis モデルページ |
| 最初の回答トークンまでの時間 | 56.51秒 | 197.65秒 | Artificial Analysis モデルページ |
| キャッシュ割引 / 混合価格 | 95% / 2.21 | 95% / 5.88 | Artificial Analysis モデルページ |
この表は行ごとに読むのが最も確実です。知能スコア、所要時間、価格の3グループはそれぞれ独立しており、同じ列に「スコアが高い」「時間が短い」「単価が高い」が同時に現れても矛盾しません。
GPT-6.2 Astra の単価が高いのに、タスクあたりの費用が低い理由
タスクあたりの費用は、おおまかに「どれだけトークンを使ったか × トークンあたりの価格」と捉えられます。Astra の出力の表示価格は 100万トークンあたり 40 ドルで、Neon の 15 ドルの2倍以上です。一方、Artificial Analysis のモデルページに記録されている指数実行時の出力量は、Astra が 6580 万トークンで、Neon の 2.83 億トークンの4分の1未満です。使用量の側がより低く抑えられているため、単価が高い側のタスクあたりの費用は 4.00 ドル、Neon は 6.44 ドルになります。
入力側は別に説明が必要です。Neon のモデルページには指数実行時の入力 81.2 億トークンと記載されていますが、参考資料には Astra の入力トークン数がないため、ここでは出力側だけを分解し、請求額全体を逆算しません。混合価格は Neon 2.21、Astra 5.88で、これも表示価格のレベルだけを反映したもので、自分の請求額を見積もる際には自分のトークン構成を掛ける必要があります。
具体的な業務に移ると、トークン構成は変わります。入力が長く出力が短いタスクでは、入力単価 8 対 3 の重みが大きくなります。出力が非常に長いタスクでは、出力使用量の項が結果を支配します。指数上のタスクあたりの費用は、固定の課題セットでの結果です。自分のシナリオに移す前に、自分のサンプルで一度実行するのがよいでしょう。
Gemini 4 Neon の所要時間を読み解く:出力の速さと「終わるまで」の速さは分けて考える
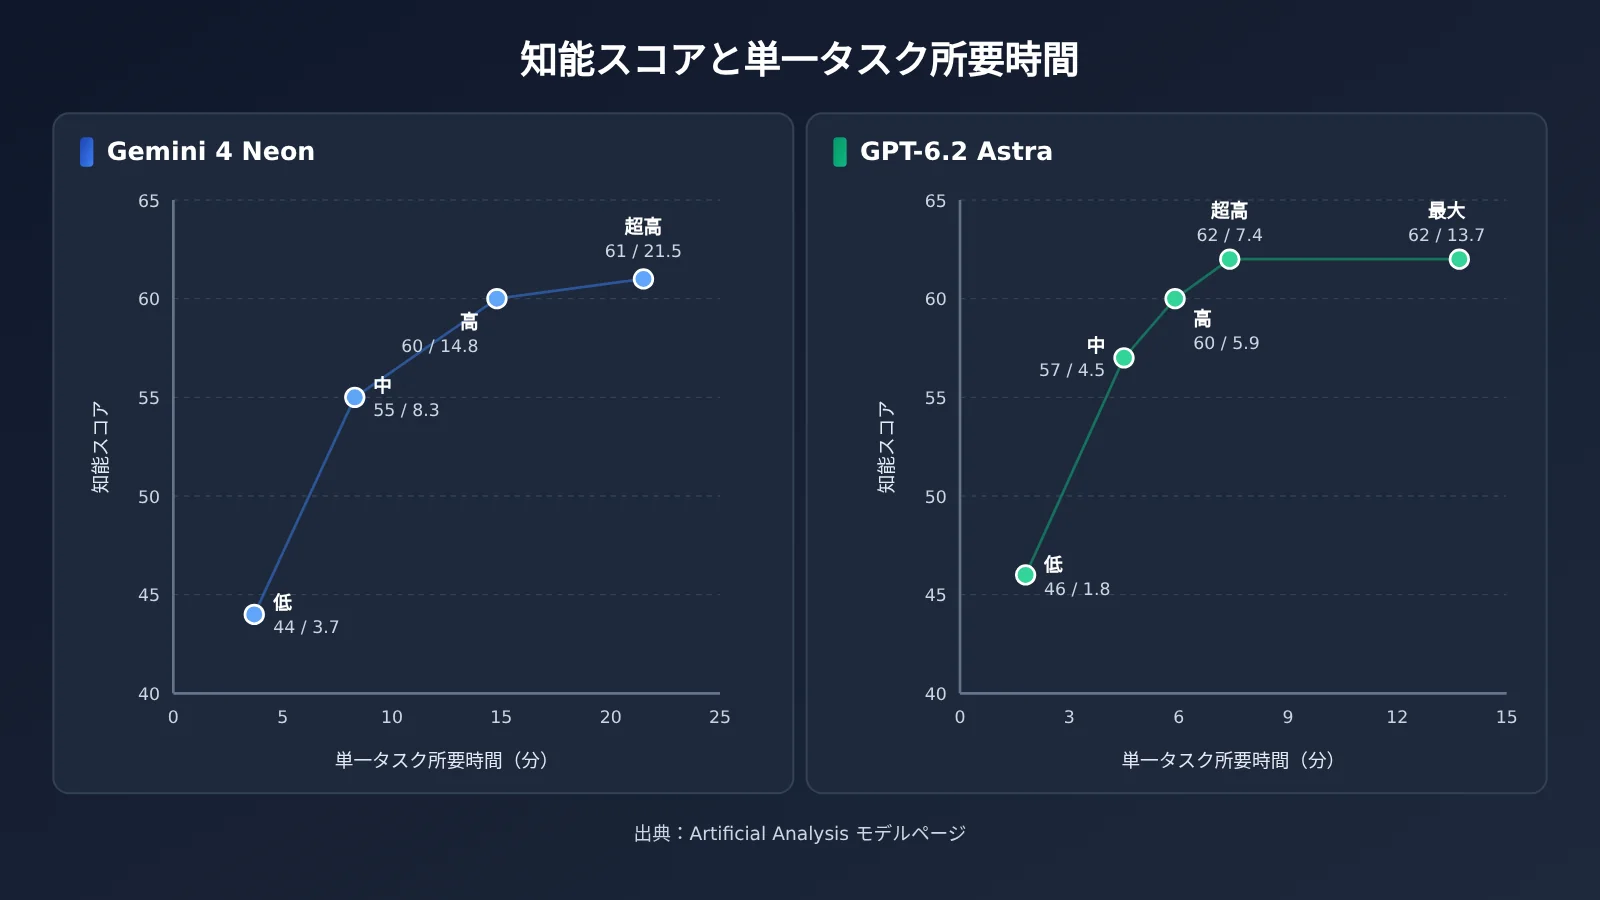
Neon はモデルページ上で毎秒約110トークンを出力し、Astra の毎秒50トークンの2倍以上です。最初の回答トークンまでの時間はわずか56.51秒で、Astra は197.65秒かかります。しかしタスク1件あたりの所要時間は Neon(xhigh)が21.5分、Astra(max)が13.7分、xhigh が7.4分です。理由はやはりトークン量に帰結します。出力が多いモデルは、毎秒どれだけ速く吐き出しても、書き終わるまでにはより長い時間がかかるのです。
Astra の xhigh と max は知能スコアが同じ62で、所要時間は一方が7.4分、もう一方が13.7分です。引用する際には必ず档位(ティア)を添えなければなりません。Neon 側については、Artificial Analysis のモデルページ FAQ が下位档位の最初の回答トークンまでの時間を別途示しています。high が40.64秒、medium が20.14秒、low が13.93秒です。この数値群は FAQ に由来し、集計表とは同じ欄にありません。
Gemini 4 Neon と GPT-6.2 Astra の档位別データ
| モデル | 档位 | 知能スコア | タスク1件の所要時間 | 出力速度 |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21.5分 | 110 token/秒 |
| Gemini 4 Neon | high(デフォルト) | 60 | 14.8分 | 101 token/秒 |
| Gemini 4 Neon | medium | 55 | 8.3分 | 101 token/秒 |
| Gemini 4 Neon | low | 44 | 3.7分 | 97 token/秒 |
| GPT-6.2 Astra | max | 62 | 13.7分 | 50 token/秒 |
| GPT-6.2 Astra | xhigh | 62 | 7.4分 | 50 token/秒 |
| GPT-6.2 Astra | high | 60 | 5.9分 | 50 token/秒 |
| GPT-6.2 Astra | medium | 57 | 4.5分 | 49 token/秒 |
| GPT-6.2 Astra | low | 46 | 1.8分 | 48 token/秒 |
データはいずれも Artificial Analysis のモデルページに由来し、Neon の high は Google の開発者ガイドに明記されたデフォルト档位です。Neon には max 档がなく、Astra の各档位の出力速度は48〜50 token/秒の範囲で安定しており、時間の差は主に各档位が書き出すトークン数から来ています。モデルページは最上位档位のタスク1件あたりの費用のみを提供しており、他の档位の費用はここでは補算しません。
比較の補足:上の図と表の数値はすべて Artificial Analysis のモデルページから取得しています。自分のタスクでトークン使用量を検証したい場合は、APIYI で同じ Key を使い、掲載済みのモデルを切り替えて比較できます。
Gemini 4 Neon の公式自己申告、モデルカード、第三者数値の対照
Neon 側には三種類の情報源があり、それぞれ基準が異なります。Google ブログの一連の記述は公式の自己申告に属し、Artificial Analysis Intelligence Index が xhigh で 61、総合 3 位、Vals Index 70.9%、Arena Agent Arena Index 1336 と記載されています。DeepMind のモデルカードも同様に AA Index v5.0.1 を 61 と記載し、評価の説明では Gemini 以外の結果はデフォルトで各社の自己申告に由来すると注記されており、これは公式の集約に当たります。Artificial Analysis の記事とモデルページは第三者の測定に属します。
| 指標 | 公式自己申告(Google ブログ) | モデルカード | Artificial Analysis 記事 |
|---|---|---|---|
| 知能指数(xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | 未記載 | 59(Antigravity CLI、xhigh) |
| MKA | 未記載 | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | 未記載 |
| SWE-sweep | mini-SWE 12.8%、Antigravity 39.0% | ベンダー harness 39.0%、mini-SWE 12.8% | 未記載 |
| 単一タスクコストの記述 | デフォルト high は Carbon より 32% 低い | 未記載 | 6.44 ドル、Carbon の非割引価格 7.76 ドルより約 17% 少ない |
一致しない数値も表の中にすべて残しています:Coding Agent Index は公式自己申告が 58.6、Artificial Analysis 記事が 59。MKA はモデルカードが 56.5%、Artificial Analysis 記事が 56%。SWE-sweep の 12.8% と 39.0% は二つの異なる harness に由来し、Google ブログではその差を harness による向上と位置づけています。
コストの算出基準も三つの異なる計算方法です。Google の「32% 低い」は自社のアルゴリズムで、ブログには Carbon が紹介価格を使っているのか標準価格を使っているのか書かれていません。Artificial Analysis 記事の「約 17% 少ない」は Carbon の標準価格 4/20 で算出した 7.76 ドルです。Artificial Analysis モデルページ上の Carbon high の 4.90 ドルは、ページの現在の紹介価格 2/10 で計算されています。これら三組の数値はそれぞれ成立しており、相互に換算することはできません。
ユースケース別の選び方:Gemini 4 Neon と GPT-6.2 Astra、どのコスト指標で見るか
GPT-6.2 Astra の数値を先に確認すべきケース
- タスク単位の予算で試算する場合:1問あたりいくらかかるかという前提で予算を立てるなら、まず Artificial Analysis のモデルページにあるタスク単価を見るとよいでしょう。Astra(max)は 4.00 ドルです。
- 全体の完了時間が気になる場合:Astra の xhigh 設定は 7.4 分・知能スコア 62、max 設定は 13.7 分で、同じスコアでもこの2つの設定では所要時間に明確な差があります。設定を選ぶときは別々に評価しましょう。
- バッチ処理で出力を短くしたい場合:Astra が指数ベンチマークを実行した際の出力は 6580 万トークンで、出力使用量の項目はコスト内訳に占める割合が低くなっています。
Gemini 4 Neon の数値を先に確認すべきケース
- 対話インターフェースで最初のトークンまでの待ち時間を重視する場合:Neon(xhigh)は最初の回答トークンまでが 56.51 秒、FAQ に記載されている low 設定では 13.93 秒です。
- マルチモーダル入力:DeepMind のモデルカードには、入力がテキスト・画像・音声・動画に対応し、統一ウィンドウは最大 100 万トークン、知識カットオフは 2026 年 3 月であると記載されています。
- オーケストレーションとサブタスク:Google の開発者ガイドでは、
gemini-4-neonをオーケストレーションモデルとして使い、previous_interaction_idをgemini-4-hydrogenに渡して、より高速なサブタスクを実行させる方法が紹介されています。 - トークン単価で試算する場合:Google AI Studio の料金ページには、Neon の入力 3.00 ドル、キャッシュ 0.15 ドル、出力 15.00 ドル(100万トークンあたり)と記載されています。出力には思考トークンが含まれ、無料枠はありません。
APIYIでGemini 4 NeonとGPT-6.2 Astraのモデルと価格を確認
APIYIの総合一覧ページには更新日時が2026-11-16 09:39(UTC+8)と記載されており、2026-11-19には価格API(バージョン shell-api-modelmak-v1、全285モデル)も再確認しました。apiyi.comのモデル一覧で項目ごとに照合できます。価格APIでは、model_ratio 1が入力100万トークンあたり2米ドルに対応し、completion_ratio 5は出力が入力の5倍であることを示しており、総合一覧表の最初の価格帯と一致しています。
| モデルID | 入力 | キャッシュ読込 | 出力 | エンドポイント | 説明 |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | 272000トークン超過の入力は16;価格APIの上位ティア出力は約60で、総合一覧表にはこの出力ティアの記載なし |
gpt-6.2-sol |
2 | 0.1 | 10 | responses(推奨)、chat | 272000トークン超過の入力は3;価格APIの上位ティア出力は約11.25 |
gemini-4-carbon |
2 | 0.1 | 10 | chat、gemini | Googleの2026-11-30までの導入価格に対応 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat、gemini | グループ Default、SVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat、messages | 別途 -thinking バージョンあり |
claude-fable-5-2 |
8 | 0.2 | 40 | chat、messages | 別途 -thinking バージョンあり |
gemini-4-neon |
— | — | — | — | 総合一覧表にも価格APIにも未収録 |
単位はすべて米ドル/100万トークンです。gemini-4-carbon の 2/0.1/10 はAPIYIの現在の提供価格で、Googleの導入価格と一致しており、Googleのその後の標準価格 4/20 とは別に扱います。グループ名は2か所で表記が多少異なります。たとえば総合一覧表では Default、SVIP、価格APIでは default、svip と記載されています。Claudeシリーズは総合一覧表では Claude_Reverse、Claude_Enterprise、価格APIでは ClaudeCodeReverse、ClaudeOfficial となっており、どちらの名称もプラットフォーム上の表示を優先します。
Gemini 4 Neonの公式価格はGoogle AI Studioの価格ページに基づき、入力3.00、キャッシュ0.15、出力15.00米ドル/100万トークンで、暗黙的キャッシュのみに対応しています。gemini-4-neon はAPIYIの総合一覧表にも価格APIにもなく、独立したモデルページもないため、現時点では未提供です。このモデルはできるだけ早く提供開始する予定です。モデルと価格はプラットフォームのモデル一覧を基準とします。
クイックスタート:APIYI 経由で GPT-6.2 Astra を呼び出す
gpt-6.2-astra は OpenAI 互換の responses エンドポイントを利用しており、以下の4ステップで動作確認できます。
- apiyi.com で登録し APIキーを作成して、環境変数
APIYI_API_KEYに設定します。コードでは環境変数からのみ読み取り、平文のキーは記述しないでください。 - OpenAI SDK でクライアントを初期化します:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")。 - responses エンドポイントを呼び出します:
resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别")。続いてresp.output_textを読み取ります。 - 課金を確認します。APIYI の料金一覧表の最初のティアでは、入力 8、キャッシュ読み取り 0.4、出力 40 USD/100万トークンです。1回の入力が 272000 トークンを超えると入力は 16 になり、料金APIではこのティアの
CompletionRatioが 3.75、出力は約 60 USD/100万トークンです。一覧表の本文にはこのティアの出力は記載されていません。
長いコンテキストを扱うタスクでは、第4ステップに特に注意してください。272000 トークンを超えると入力と出力が同時に上のティアへ切り替わり、1タスクあたりの費用は最初のティアでの見積もりから大きく外れます。典型的なリクエストのトークン数をあらかじめ集計してから予算を決めることをおすすめします。
提供中の Gemini モデルには2通りの接続方法があります。gemini-4-carbon、gemini-4-hydrogen は同じ OpenAI 互換アドレスから chat エンドポイントを利用できます。また、Gemini ネイティブのアドレス https://api.apiyi.com、API バージョン v1beta を使うこともできます。Neon のパラメータルールは、まず Google デベロッパーガイドで確認できます。思考レベルは low、medium、high、xhigh のみで、デフォルトは high です。thinking_budget または MINIMAL を渡すと HTTP 400 が返ります。明示的なコンテキストキャッシュはサポートされておらず、4096 トークン以上の共有プレフィックスは自動的に暗黙的キャッシュが適用されます。1セグメントあたりのデフォルト出力は最大 65536 トークンです。
🚀 クイックスタート:まず APIYI apiyi.com で新規ユーザー向けの無料テスト枠を受け取り、同じキーで
gpt-6.2-astra、gpt-6.2-sol、gemini-4-carbonを順に呼び出し、それぞれの入力・出力トークン数を記録してから、上記の料金表に当てはめて1タスクあたりの費用を計算することをおすすめします。
Gemini 4 Neon と GPT-6.2 Astra の選択ガイド
| 気になる論点 | まず見るべき列 | Gemini 4 Neon(xhigh) | GPT-6.2 Astra | 出典 |
|---|---|---|---|---|
| 知能スコア | 知能スコア | 61 | max 62、xhigh 62 | Artificial Analysis のモデルページ |
| 1問終えるまでの時間 | 1タスクの所要時間 | 21.5分 | max 13.7分、xhigh 7.4分 | Artificial Analysis のモデルページ |
| 最初のトークンまでの待ち時間 | 最初の回答トークン | 56.51秒 | max 197.65秒 | Artificial Analysis のモデルページ |
| 100万トークンあたりの料金 | 単価 | 3 / 15 | 8 / 40 | Artificial Analysis のモデルページ、APIYI 一覧表 |
| 指数ベンチマーク1回のコスト | 1タスクの費用 | 6.44ドル | max 4.00ドル | Artificial Analysis のモデルページ |
| 長い入力の課金方法 | 料金の段階設定 | 参考資料に段階設定の記載なし | 272000トークンを超える入力は16、出力は約60 | APIYI 一覧表、料金API |
判断するときは、まずどの行が自分の業務にとって最も重要かを決め、そのうえでその行の数字と出典を確認してください。知能スコアの差はわずか1点ですが、所要時間・最初のトークン・単価・1タスクあたりの費用といった各行は、差の向きがそれぞれ異なります。どの1行も、ほかの行の代わりにはなりません。
💡 選択のヒント:指数ベンチマークの出題セットと実際の業務では、トークンの構成がしばしば異なります。ご自身のサンプルを apiyi.com 上で公開済みのモデルに対して一巡比較し、トークン使用量と所要時間を記録したうえで、グレードとモデルを決めることをおすすめします。
Gemini 4 Neon と GPT-6.2 Astra よくある質問
Q1:Gemini 4 Neon とは何ですか?
Gemini 4 Neon は Google が 2026 年 11 月 18 日に発表したモデルで、モデル ID は `gemini-4-neon` です。DeepMind のモデルカードには、Gemini 4 Carbon を改変したもので、ファミリー内では Hydrogen(日常的な高速実行)と Carbon(複雑な長距離タスク)の間に位置し、コンテキストは 1048576 トークンで統一されていると記載されています。
Q2:Gemini 4 Neon と GPT-6.2 Astra の知能スコアの差はどれくらいですか?
Artificial Analysis のモデルページでは、Neon(xhigh)が 61、Astra(max)が 62、Astra(xhigh)も 62 です。Astra は 2 つの設定で同スコアですが、所要時間はそれぞれ 13.7 分と 7.4 分なので、引用する際は設定を明記する必要があります。
Q3:Gemini 4 Neon はいつから利用できますか?
Sundar Pichai は発表当日、Neon が 2026 年 11 月 18 日から Google AI Studio の Gemini API、Gemini for business、有料の Google AI Pro と Ultra の Google Antigravity、および Pro と Ultra の Gemini App で提供されると記しています。Google AI Studio の料金ページには、無料枠が用意されていないと明記されています。
Q4:GPT-6.2 Astra は単価が高いのに、1 タスクあたりの費用が 4.00 ドルなのはなぜですか?
1 タスクあたりの費用は、単価と使用量の両方で決まります。Artificial Analysis のモデルページには、Astra(max)が指数ベンチマークで 6580 万トークンを出力し、Neon(xhigh)は 2.83 億トークンと記録されています。Astra の出力単価は 40 対 15 と高いものの、使用量がはるかに少ないため、1 タスクあたりの費用は Astra が 4.00 ドル、Neon が 6.44 ドルになります。
Q5:API 経由で GPT-6.2 Astra をすばやく呼び出すには?
1. APIYI apiyi.com で登録し、APIキーと無料テスト枠を取得します;
2. OpenAI SDK の base_url を、前述のクイックスタートにある OpenAI 互換アドレスに設定します;
3. responses エンドポイントを使い、モデルには `gpt-6.2-astra` を指定します。
`gemini-4-neon` は現在、APIYI の総合表と料金 API のいずれにも存在せず、掲載後はプラットフォームのモデル一覧を基準としてください。
Q6:これらの数値を引用する際の注意点は?
– **基準**:公式の自己申告、モデルカード、Artificial Analysis の記事とモデルページでは出典が異なり、Coding Agent Index には 58.6 と 59 の 2 つの値、MKA には 56.5% と 56% の 2 つの値があります。
– **コスト**:Google の「32% 低い」、Artificial Analysis 記事の「約 17% 少ない」、モデルページの Carbon 4.90 ドルは 3 つの異なる算出根拠であり、合成することはできません。
– **移行**:指数の 1 タスクあたりの費用は固定のベンチマーク問題集に基づくもので、あなたのタスクのトークン構成が異なれば結果も変わります。
Gemini 4 Neon と GPT-6.2 Astra の要点 Key Takeaways
- 知能スコア:Artificial Analysis のモデルページでは、Astra(max)が 62、Astra(xhigh)が 62、Neon(xhigh)が 61 です。
- 所要時間:Neon(xhigh)は 21.5 分、Astra max は 13.7 分、xhigh は 7.4 分で、ティアごとに分けて引用する必要があります。
- 単価:Astra は 8/40、Neon は 3/15 ドル/100万トークンです。Neon の価格は Google AI Studio の料金ページに基づいています。
- タスクあたりの費用:Astra(max)は 4.00 ドル、Neon(xhigh)は 6.44 ドルで、その差は出力トークン量によるものです。
- 速度と最初のトークンまでの時間:Neon は 110 トークン/秒、最初のトークンまで 56.51 秒。Astra は 50 トークン/秒、最初のトークンまで 197.65 秒です。
- APIYI のラインナップ:
gpt-6.2-astraは最初のティアが 8/0.4/40、272000 トークンを超える入力は 16、料金インターフェースの出力は約 60 です。gemini-4-neonはまだ収録されていません。
Gemini 4 Neon と GPT-6.2 Astra の比較まとめ
Gemini 4 Neon と GPT-6.2 Astra を比べるときに大切なのは、指標ごとに分けて考えることです。
- 知能スコア:61 対 62。Astra は xhigh と max がともに 62 で、出典は Artificial Analysis のモデルページです。
- 所要時間:21.5 分 対 13.7 分(Astra の xhigh は 7.4 分)。出力速度と最初のトークンまでの時間は、また別の数値です。
- 価格:単価は 3/15 対 8/40、タスクあたりの費用は 6.44 対 4.00 ドルで、その間には 2.83 億 対 6580 万の出力トークンがあります。
モデルを選ぶときは、まずどの指標で判断するかを決めてから、自分のサンプルでトークン使用量を確認してください。APIYI apiyi.com を通じて 1 つのキーで、すでにラインナップされているモデルの比較テストを行うことをおすすめします。gemini-4-neon が収録されたら、同じワークフローにそのまま組み込めます。
📚 参考資料
-
Sundar Pichai の投稿:Gemini 4 Neon のリリースと提供チャネル
- リンク:
x.com/sundarpichai/status/2123167780988125621 - 説明:リリース日と提供開始の入り口
- リンク:
-
Google ブログ「Introducing Gemini 4 Neon」:公式が自ら公表したベンチマーク、価格、位置づけ
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 説明:Coding Agent Index 58.6、コスト32%低減などの公式見解
- リンク:
-
DeepMind「Gemini 4 Neon」モデルカード:比較表とモデル仕様
- リンク:
deepmind.google/models/model-cards/gemini-4-neon/ - 説明:比較表には Neon、Claude Opus 5.5、GPT-6.2 Sol の3列のみを収録
- リンク:
-
Google Cloud 開発者ガイド:
gemini-4-neonのパラメータとキャッシュルール- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 説明:思考レベル、
HTTP 400の条件、暗黙的キャッシュ
- リンク:
-
Google AI Studio 料金ページ:Gemini 4 ファミリーの公式価格
- リンク:
aistudio.google.com/docs/pricing - 説明:Neon は 3/0.15/15、Carbon は 2026-11-30 までの導入価格
- リンク:
-
Artificial Analysis の記事:Neon の知能スコアとコスト分析
- リンク:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 説明:第三者による測定。Carbon の標準価格より約17%低いという計算基準を含む
- リンク:
-
Artificial Analysis のモデルページ:Gemini 4 Neon と GPT-6.2 Astra
- リンク:
artificialanalysis.ai/models/gemini-4-neon、artificialanalysis.ai/models/gpt-6-2-astra - 説明:本文における3つの試算の主要データソース。2026-11-19 に取得
- リンク:
著者:APIYI 技術チーム
技術的なやり取り:APIYI 公式サイトのトップページからお問い合わせください。モデルと価格は、プラットフォームのモデル一覧およびドキュメントセンターの記載を基準としてください。