Nota do autor: No ranking geral do Artificial Analysis, o Claude Fable 5.2 fica à frente do Gemini 4 Neon. Este artigo separa a pontuação de inteligência e o custo por tarefa em duas contas distintas e alinha cada item por nível, para facilitar a identificação de onde exatamente está a diferença entre os dois.
O Gemini 4 Neon foi lançado em 2026-11-18. De acordo com a ordenação do artigo do Artificial Analysis, o Neon ocupa o 3º lugar geral no nível xhigh, com 61 pontos. À sua frente estão o GPT-6.2 Astra (max) e o Claude Fable 5.2 (max). Ao ver esse ranking, muitos desenvolvedores querem saber: a vantagem do Fable 5.2 vem da pontuação de inteligência ou do custo maior que estão dispostos a pagar?
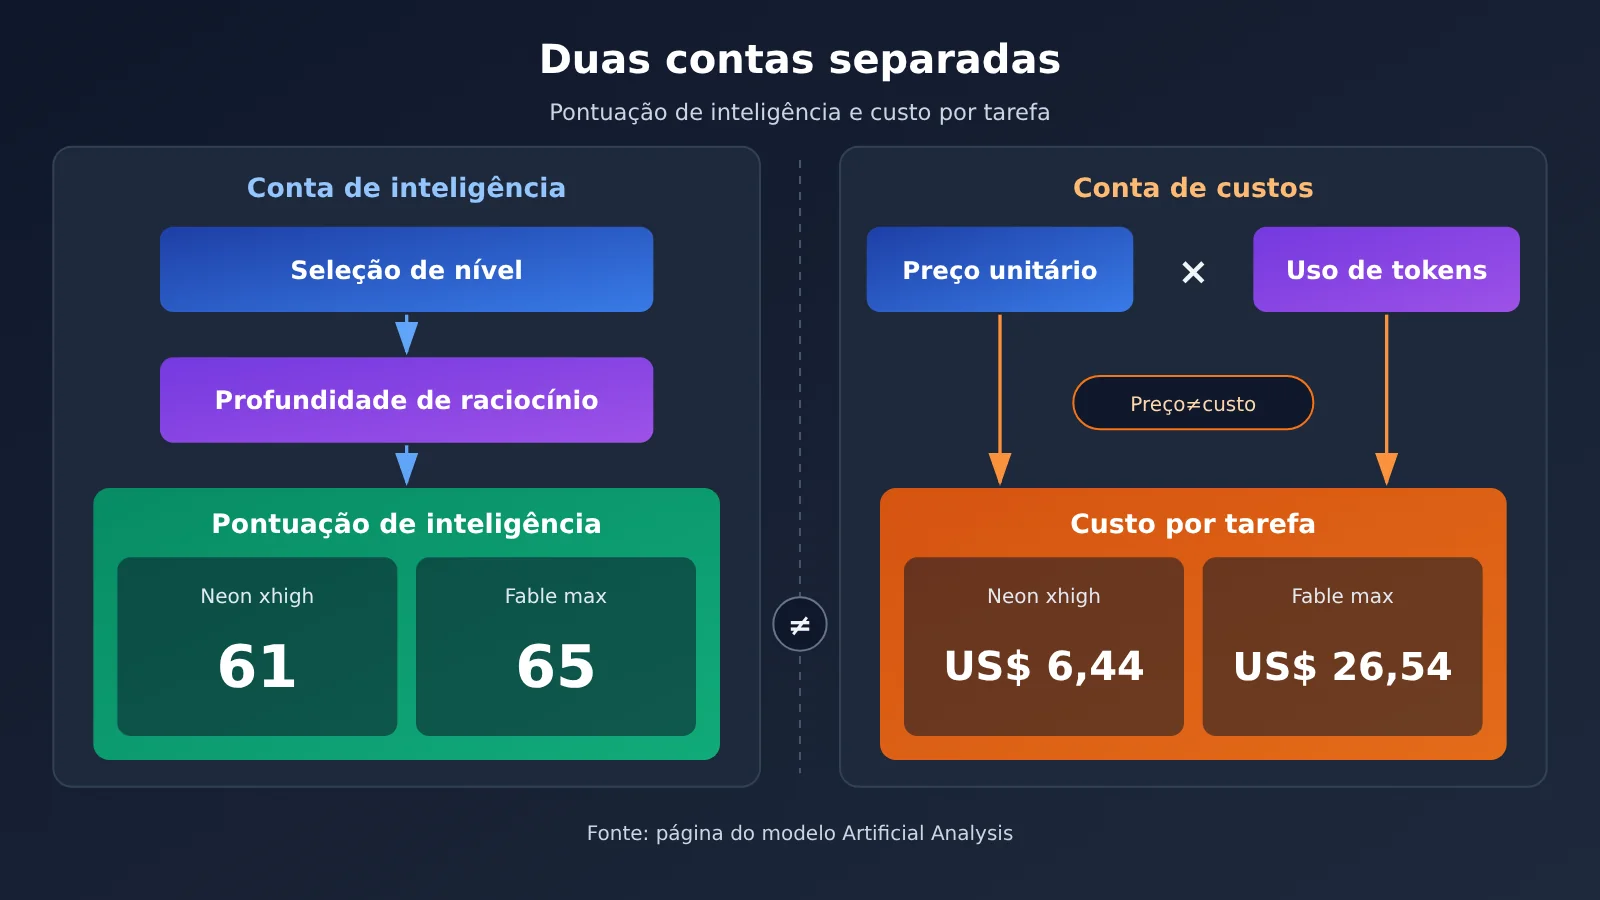
Essas duas contas precisam ser analisadas separadamente. A pontuação de inteligência corresponde ao nível max do Fable e ao nível xhigh do Neon; no índice de programação, o Fable usa o nível xhigh. O card de modelo do Google não tem sequer uma coluna para o Fable, então as métricas individuais do Fable não podem ser tomadas emprestadas de outro modelo. Este artigo usa apenas métricas que coincidem tanto no texto do Artificial Analysis quanto nas duas páginas de modelo do Artificial Analysis, e cada número indica sua fonte. Se precisar conferir modelos e preços, consulte diretamente a lista de modelos da APIYI em apiyi.com.
Valor central: depois de ler este artigo, você saberá quais são a pontuação de inteligência, o custo por tarefa, o tempo de execução, a velocidade de saída e o tempo até o primeiro token do Gemini 4 Neon e do Claude Fable 5.2, a qual nível cada um corresponde, e quais números não podem ser subtraídos ou combinados entre si. Data de verificação dos dados: 2026-11-19.
Pontos-chave de Gemini 4 Neon e Claude Fable 5.2: pontuação de inteligência e custos em duas contas separadas
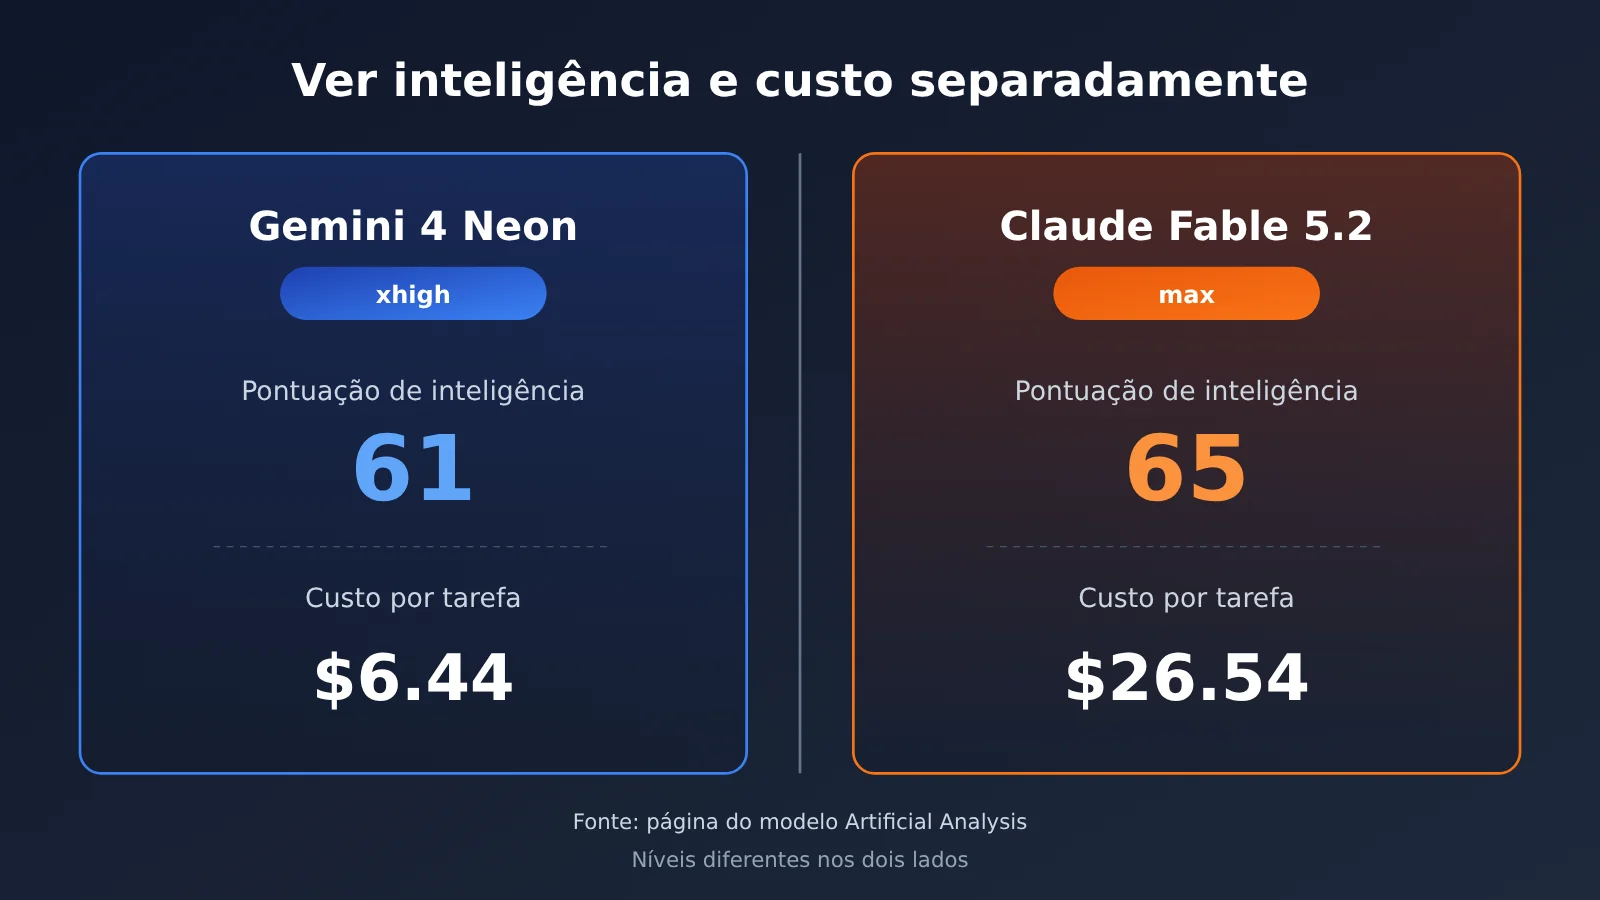
Todos os dados da tabela abaixo vêm da página do modelo no Artificial Analysis (consultada em 2026-11-19, índice v5.0.1). Vale notar que os níveis comparados não são os mesmos: a Fable usa max (que também é o Default Fallback da página), enquanto o Neon usa xhigh.
| Métrica | Gemini 4 Neon (xhigh) | Claude Fable 5.2 (max) | Fonte |
|---|---|---|---|
| Pontuação de inteligência | 61 | 65 | Página do modelo no Artificial Analysis |
| Custo por tarefa | US$ 6,44 | US$ 26,54 | Página do modelo no Artificial Analysis |
| Tempo por tarefa | 21,5 minutos | 41,6 minutos | Página do modelo no Artificial Analysis |
| Velocidade de saída | 110 tokens/segundo | 110 tokens/segundo | Página do modelo no Artificial Analysis |
| Tempo até o primeiro token | 56,51 segundos | 247,46 segundos | Página do modelo no Artificial Analysis |
| Preço de tabela (entrada/saída, por milhão de tokens) | US$ 3,00 / US$ 15,00 | US$ 8,00 / US$ 40,00 | Página do modelo no Artificial Analysis |
A conta da pontuação de inteligência de Gemini 4 Neon e Claude Fable 5.2
A coluna de pontuação de inteligência traz 61 contra 65, comparando Neon xhigh com Fable max. Segundo o artigo do Artificial Analysis, o Neon xhigh tem 1 ponto a mais que o Gemini 4 Carbon high e fica em 3º lugar no ranking geral; os dois primeiros são GPT-6.2 Astra (max) e Claude Fable 5.2 (max). O blog do Google também afirma que o Artificial Analysis Intelligence Index marca 61 em xhigh, mas esse número é autodeclarado; os 61 coincidem entre o blog do Google, a ficha do modelo e o Artificial Analysis.
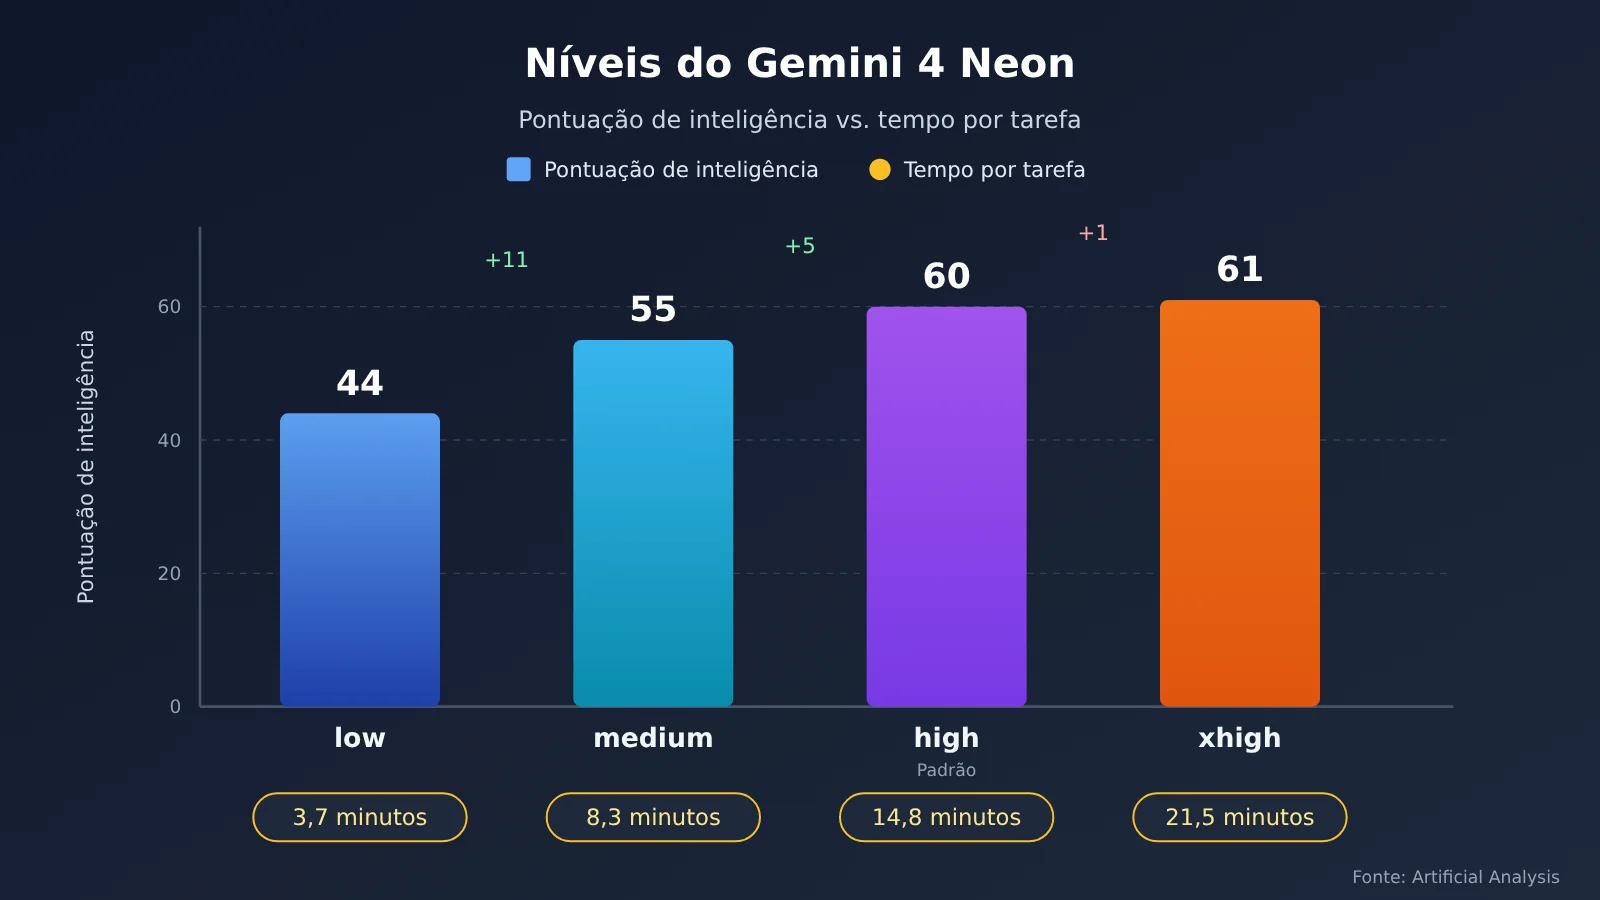
A Fable só divulgou dados do nível max na página do modelo, então, ao compará-la com outros níveis do Neon, não dá para fazer uma comparação no mesmo nível. O nível de raciocínio padrão do Neon é high, como mostram o guia para desenvolvedores do Google Cloud e a página de modelos mais recente do AI Studio. Na página do modelo no Artificial Analysis, o Neon high tem 60 pontos. Se a sua invocação não definir um nível extra, o que você recebe na prática é high, e não xhigh.
A conta de custo por tarefa de Gemini 4 Neon e Claude Fable 5.2
O custo por tarefa é US$ 6,44 contra US$ 26,54, e o tempo por tarefa é 21,5 minutos contra 41,6 minutos. O artigo do Artificial Analysis escreve o tempo do Neon como “cerca de 21 minutos”, enquanto a página do modelo traz 21,5 minutos; cada número foi mantido como aparece na respectiva fonte. A velocidade de saída dos dois é 110 tokens/segundo, mas o tempo até o primeiro token é bem diferente: Neon xhigh leva 56,51 segundos, e Fable max, 247,46 segundos.
Preço unitário e custo por tarefa não são a mesma coisa. Na página do modelo no Artificial Analysis, o GPT-6.2 Astra tem o mesmo preço de tabela de US$ 8,00/40,00, mas seu custo por tarefa no nível max é US$ 4,00, porque ele gera muito menos tokens ao rodar o índice. Portanto, para avaliar o custo por tarefa, é preciso olhar tanto o preço unitário quanto o uso de tokens, e não apenas o preço de tabela.
Índice de codificação do Gemini 4 Neon e do Claude Fable 5.2: níveis anotados à parte
Os dados desta parte sobre codificação vêm do artigo do Artificial Analysis, e tanto os níveis quanto o ambiente de execução precisam ser anotados separadamente. O Neon foi testado no Antigravity CLI, enquanto o Fable e o Opus 5.5 foram testados no Claude Code — ou seja, os dois lados não usam o mesmo harness.
| Modelo e nível | Coding Agent Index | Custo por tarefa de codificação | Ambiente de execução | Fonte |
|---|---|---|---|---|
| Gemini 4 Neon xhigh | 59 | US$ 6.86 | Antigravity CLI | Artigo do Artificial Analysis |
| Claude Fable 5.2 xhigh | 58 | US$ 15.47 | Claude Code | Artigo do Artificial Analysis |
| Claude Opus 5.5 max | 58 | US$ 12.61 | Claude Code | Artigo do Artificial Analysis |
| Gemini 4 Carbon high | 55 | não listado no artigo | Antigravity CLI | Artigo do Artificial Analysis |
Aqui o Fable aparece no nível xhigh, diferente do nível max da coluna de pontuação de inteligência — esses dois números não podem ser interpretados sob a mesma condição. Além disso, o blog do Google informa um Neon Coding Agent Index de 58.6, enquanto o artigo do Artificial Analysis traz 59. O primeiro é um número autoreportado pela própria empresa, o segundo é o número de um artigo de terceiros; este texto mantém os dois, sem escolher um nem tirar a média.
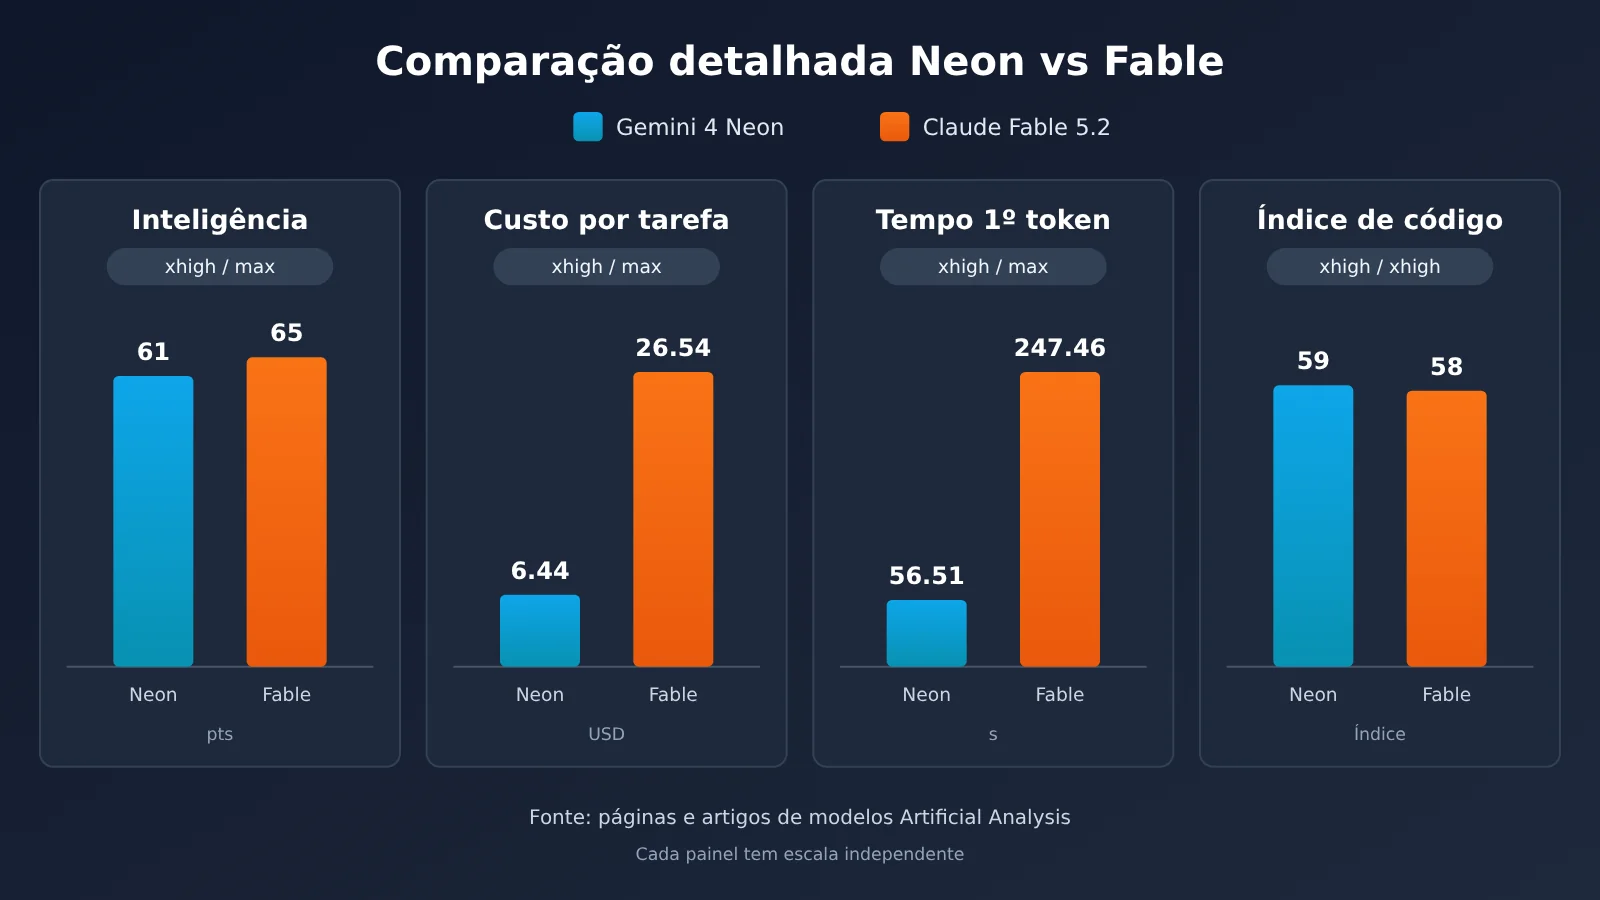
Nota sobre os dados: os números do gráfico acima vêm, respectivamente, da página do modelo no Artificial Analysis e do artigo do Artificial Analysis, e os níveis já estão indicados no gráfico. Para os preços de invocação dos dois modelos, veja a tabela de preços da APIYI mais adiante.
Por que o card do modelo Gemini 4 Neon não pode substituir as métricas individuais do Claude Fable 5.2
O quadro comparativo do card do modelo Gemini 4 Neon, do DeepMind, tem apenas três colunas: Gemini 4 Neon, Claude Opus 5.5 e GPT-6.2 Sol — não há Claude Fable 5.2. O PDF de notas de avaliação que acompanha o card deixa claro que os resultados de modelos que não são Gemini vêm, por padrão, de dados autodeclarados por cada fornecedor. Portanto, essa tabela é um resumo oficial de resultados; os modelos não foram retestados pelo mesmo laboratório, no mesmo dia.
Opus 5.5 e Fable 5.2 são dois modelos diferentes. Na página do modelo no Artificial Analysis, a pontuação de inteligência do Opus 5.5 max é 59, e a do Fable 5.2 max é 65; os preços também são diferentes (4.00/20.00 contra 8.00/40.00). Os percentuais da coluna do Opus no card do modelo representam apenas o Opus 5.5 e não podem ser usados como métricas individuais do Fable 5.2.
Alguns critérios que costumam gerar confusão estão organizados abaixo:
| Afirmação | Número | Origem e critério |
|---|---|---|
| Custo por tarefa do Neon high é menor que o do Carbon | 32% | Autodeclaração oficial (blog do Google); não especifica se o Carbon usa preço introdutório ou preço padrão |
| Custo por tarefa do Neon xhigh é menor que o do Carbon | cerca de 17% (6.44 contra 7.76 dólares) | Artigo do Artificial Analysis; Carbon calculado com preço sem desconto |
| Custo por tarefa do Carbon high | 4.90 dólares | Página do modelo no Artificial Analysis; calculado com preço introdutório |
| Neon Coding Agent Index | 58.6 / 59 | Autodeclaração oficial / artigo do Artificial Analysis |
| Neon MKA | 56.5% / 56% | Card do modelo / artigo do Artificial Analysis |
| Neon SWE-sweep | 12.8% / 39.0% | Autodeclaração oficial; referem-se, respectivamente, ao mini-SWE harness e ao Google Antigravity |
Os três números de custo da tabela acima vêm de três bases de cálculo diferentes; não podem ser subtraídos nem combinados em um único número. A diferença do SWE-sweep, de 12.8% para 39.0%, é explicada no blog do Google como um ganho proporcionado pelo harness, e não como um indicativo de que o modelo seja três vezes melhor.
Gemini 4 Neon e Claude Fable 5.2: recomendações por cenário — primeiro defina qual métrica observar
Os dados dos dois modelos estão na mesma tabela, mas leitores diferentes se importam com métricas diferentes. A seguir, agrupamos por “qual métrica você mais valoriza”; cada grupo apenas indica qual coluna observar, sem tirar conclusões por você.
Cenários em que a pontuação de inteligência vem primeiro
- Raciocínio de longo prazo e análise complexa: observe a coluna de pontuação de inteligência e anote também o nível (Fable max 65, Neon xhigh 61); ao avaliar, reproduza usando o mesmo nível.
- Necessidade de ranking horizontal: o artigo da Artificial Analysis apresenta uma ordenação geral, que pode ser citada, mas é preciso deixar claro em qual nível esse ranking se aplica.
Cenários em que o custo por tarefa e a latência vêm primeiro
- Chamadas de alta frequência e tarefas em lote: observe o custo por tarefa (6,44 vs 26,54 dólares) e o tempo por tarefa (21,5 vs 41,6 minutos).
- Produtos interativos: observe o tempo até o primeiro token da resposta (56,51 vs 247,46 segundos). A velocidade de saída é igual nos dois lados; a diferença de latência está no tempo até o primeiro token.
- Agentes de codificação: veja a tabela de codificação e note que Neon e Fable estão ambos no nível xhigh, mas os ambientes de execução são, respectivamente, Antigravity CLI e Claude Code.
O desempenho de cada nível do próprio Neon também precisa ser listado separadamente. Os dados abaixo vêm da tabela resumida da página do modelo no Artificial Analysis; para o tempo até o primeiro token, os números dos três últimos níveis foram retirados do FAQ da mesma página e não estão na mesma coluna da tabela resumida.
| Nível do Neon | Pontuação de inteligência | Tempo por tarefa | Velocidade de saída | Primeiro token da resposta |
|---|---|---|---|---|
| xhigh | 61 | 21,5 minutos | 110 tokens/s | 56,51 segundos |
| high (padrão) | 60 | 14,8 minutos | 101 tokens/s | 40,64 segundos (FAQ) |
| medium | 55 | 8,3 minutos | 101 tokens/s | 20,14 segundos (FAQ) |
| low | 44 | 3,7 minutos | 97 tokens/s | 13,93 segundos (FAQ) |
Além disso, os dados sobre o GDP.pdf no artigo da Artificial Analysis mostram: Neon high com 33,4% e Neon xhigh com 28,0%. Isso indica que, neste teste, um nível mais alto não significa necessariamente uma pontuação mais alta.
Preços e disponibilidade do Gemini 4 Neon e do Claude Fable 5.2
Em relação ao preço oficial, segundo a página de preços do Google AI Studio, o gemini-4-neon não tem nível gratuito. Os preços pagos são: entrada de 3.00 dólares por milhão de tokens, saída de 15.00 dólares por milhão de tokens (incluindo tokens de raciocínio), cache de 0.15 dólares por milhão de tokens, com suporte apenas a cache implícito. O preço de tabela do Fable 5.2 informado na página do modelo no Artificial Analysis é de 8.00/40.00 dólares, com desconto de cache de 98%.
Na tabela geral do APIYI apiyi.com (página marcada como atualizada em 2026-11-16 09:39, UTC+8) e na API de preços (consulta em 2026-11-19, versão shell-api-modelmak-v1, totalizando 285 modelos), as informações dos modelos relacionados são as seguintes. Conforme a convenção da API de preços, model_ratio igual a 1 corresponde a uma entrada de 2 dólares por milhão de tokens, e completion_ratio igual a 5 significa que o preço de saída é 5 vezes o da entrada.
| ID do modelo | Entrada | Leitura de cache | Saída (dólares/milhão de tokens) | Endpoint | Plataforma disponível |
|---|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | APIYI (já disponível) |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | APIYI (já disponível) |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | APIYI (já disponível) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | APIYI (já disponível) |
gemini-4-neon |
— | — | — | — | Google AI Studio oficial |
O gemini-4-neon não está incluído nem na tabela geral do APIYI nem na API de preços; ainda não está disponível, e vamos disponibilizar esse modelo o mais rápido possível; modelos e preços estão sujeitos à lista de modelos da plataforma. Na tabela, os 2/10 dólares do gemini-4-carbon são o preço de prateleira atual do APIYI, consistente com o preço introdutório do Google até 2026-11-30, e diferente do preço padrão posterior do Google, de 4/20 dólares.
O agrupamento do claude-fable-5-2 está escrito de forma diferente nos dois lugares, então listamos os dois conjuntos aqui: a tabela geral do APIYI lista ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP; os IDs de grupo na API de preços são ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip. Ao configurar o agrupamento, use como referência o retorno da interface que você realmente chama.
Como chamar Claude Fable 5.2 via APIYI: início rápido
O APIYI oferece uma interface compatível com OpenAI. Para chamar claude-fable-5-2, basta alterar o base_url e o nome do modelo. Siga os passos abaixo:
- Obtenha uma chave API no APIYI e defina-a em uma variável de ambiente, por exemplo
APIYI_API_KEY. Não coloque a chave em texto claro no código. - No SDK da OpenAI, defina o base_url como
https://api.apiyi.com/v1. A inicialização do cliente pode ser escrita assim:OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"]). - Faça a requisição:
client.chat.completions.create(model="claude-fable-5-2", messages=[{"role": "user", "content": "..."}]). Se precisar da versão de raciocínio, troque o nome do modelo paraclaude-fable-5-2-thinking. Os preços são iguais: entrada US$ 8, leitura de cache US$ 0.2 e saída US$ 40 por milhão de tokens. - Se o projeto usar o formato de requisição no estilo Anthropic, é possível usar o endpoint messages, sem mudança no modelo nem no preço.
- A série Gemini pode ser chamada de forma nativa: o endereço é
https://api.apiyi.com, a versão da API év1beta, e os modelos disponíveis incluemgemini-4-carbonegemini-4-hydrogen.
Depois de integrar, vale registrar nos logs de requisição os tokens de entrada, os tokens de saída e o tempo total de cada chamada. Assim você consegue calcular o custo por tarefa com base nas suas próprias tarefas e comparar com os US$ 26.54 do Artificial Analysis. Na comparação, lembre-se de que a composição das tarefas não é a mesma.
🚀 Início rápido: novos usuários ganham créditos gratuitos de teste ao se registrar no APIYI (apiyi.com). Comece executando algumas amostras reais do seu negócio com
claude-fable-5-2, anote o uso de tokens e o tempo de execução, e só então decida o nível e o orçamento.
Recomendação de decisão: escolha entre Gemini 4 Neon e Claude Fable 5.2 com base nos registros
💡 Sugestão de escolha: primeiro defina o que o seu negócio valoriza mais — pontuação de inteligência, custo por tarefa ou latência do primeiro token — e só depois procure a coluna correspondente na tabela e confira o nível (tier) utilizado.
- Confira o nível: a pontuação de inteligência corresponde aos níveis Fable max e Neon xhigh; o índice de programação corresponde a xhigh nos dois lados. Se você for colocar em produção usando outro nível, será preciso consultar de novo os dados daquele nível.
- Confira o critério de medição: dados autodeclarados oficialmente, model cards, artigos do Artificial Analysis e páginas de modelo do Artificial Analysis — cada fonte mantém a sua própria referência, então não faça conversão entre elas.
- Confira os parâmetros de invocação do modelo: segundo o guia do desenvolvedor do Google Cloud, o Neon tem apenas quatro níveis de raciocínio: low, medium, high e xhigh; passar
thinking_budgetouMINIMALretornaHTTP 400; o Neon não oferece suporte a cache de contexto explícito, e o cache implícito é aplicado automaticamente a prefixos compartilhados acima de 4096 tokens. - Reteste com as suas próprias tarefas: dados públicos servem apenas para reduzir o leque de opções; o custo e a latência finais ainda precisam ser medidos nas suas próprias amostras.
Perguntas frequentes (FAQ)
P1: O que é o Gemini 4 Neon?
O Gemini 4 Neon é um modelo lançado pelo Google em 2026-11-18. De acordo com a ficha do modelo, ele foi adaptado a partir do Gemini 4 Carbon, tem corte de conhecimento em março de 2026 e aceita entrada de texto, imagem, áudio e vídeo, com uma janela de contexto unificada de até 1 milhão de tokens. Na linha de produtos do Google, o Neon fica entre o Hydrogen (execução rápida para o dia a dia) e o Carbon (tarefas longas e complexas).
P2: Os dados do Opus 5.5 na ficha do Gemini 4 Neon podem representar o Claude Fable 5.2?
Não. A ficha do modelo tem apenas três colunas: Neon, Opus 5.5 e GPT-6.2 Sol. Não há Fable 5.2, e os resultados de modelos que não são Gemini vêm, por padrão, de dados autorreportados por cada fornecedor. Os dados que podem ser citados para o Fable 5.2 são a pontuação de inteligência, o custo, o tempo, a velocidade e o índice de programação fornecidos na página do modelo e no artigo da Artificial Analysis.
P3: Quando o Gemini 4 Neon estará disponível e em quais canais?
Segundo a postagem de Sundar Pichai (autorreporte oficial), o Neon começa a ser disponibilizado em 2026-11-18 nos seguintes canais: Gemini API do Google AI Studio, Gemini for business, Google Antigravity nas assinaturas pagas Google AI Pro e Ultra, e Gemini App nos planos Pro e Ultra. O guia para desenvolvedores do Google Cloud informa o ID do modelo: `gemini-4-neon`.
P4: Por que o tempo por tarefa é diferente se os dois lados têm velocidade de saída de 110 tokens por segundo?
A página do modelo da Artificial Analysis traz resultados agregados: os tempos são 21,5 minutos e 41,6 minutos, e os tempos até o primeiro token são 56,51 segundos e 247,46 segundos. A página não detalha os motivos da diferença. O que dá para afirmar é que velocidade de saída igual não significa tempo total igual; a espera pelo primeiro token também faz parte do tempo total.
P5: Como invocar rapidamente o Claude Fable 5.2 via API?
Depois de obter a chave no APIYI (apiyi.com), use como `base_url` o endereço compatível com OpenAI indicado acima e preencha o nome do modelo com `claude-fable-5-2` ou `claude-fable-5-2-thinking`; os endpoints `chat` e `messages` podem ser usados. Os preços são: entrada US$ 8, leitura de cache US$ 0,2 e saída US$ 40 por milhão de tokens. O nome do grupo deve seguir exatamente o que aparece na tabela geral e no endpoint de preços.
P6: Preço unitário baixo significa custo por tarefa baixo?
As duas coisas não são equivalentes. Na página do modelo da Artificial Analysis, o preço de tabela do GPT-6.2 Astra é 8,00/40,00 USD, mas o custo por tarefa na configuração max é de apenas US$ 4,00, porque ele gera muito menos tokens ao executar o índice. O custo por tarefa é determinado em conjunto pelo preço unitário e pelo uso de tokens.
P7: Quais são as limitações conhecidas do Gemini 4 Neon?
– **Preço**: não há nível gratuito no AI Studio; apenas cache implícito é suportado.
– **Parâmetros**: passar `thinking_budget` ou `MINIMAL` retorna `HTTP 400`, e não há suporte a cache de contexto explícito.
– **Comprimento da saída**: por padrão, uma única saída tem no máximo 65536 tokens; na decodificação longa, o máximo é 1048576 menos o comprimento da entrada.
– **Versão de segurança cibernética**: a versão de segurança cibernética só será disponibilizada, alguns dias depois, a defensores confiáveis do Fairwind Program; não há ID de modelo público (autorreporte oficial).
Principais pontos de Gemini 4 Neon e Claude Fable 5.2 — Key Takeaways
- A pontuação de inteligência depende da configuração: a página do modelo no Artificial Analysis mostra Neon xhigh com 61 e Fable max com 65.
- Custo por tarefa, considerado isoladamente: Neon xhigh é US$ 6,44, Fable max é US$ 26,54; os tempos são 21,5 e 41,6 minutos, respectivamente.
- Latência: observe o tempo até o primeiro token: a velocidade de saída dos dois é 110 tokens/s; os tempos até o primeiro token são 56,51 segundos e 247,46 segundos, respectivamente.
- Índice de programação com configuração anotada à parte: Neon xhigh é 59, Fable xhigh é 58; os custos por tarefa de programação são US$ 6,86 e US$ 15,47, respectivamente.
- O model card não inclui o Fable: os itens de Opus 5.5 no model card não podem ser tratados como dados do Fable 5.2.
- Critérios mantidos separadamente: 32%, cerca de 17%, US$ 4,90, 58,6 e 59 pertencem a contas diferentes.
- Ponto de entrada de chamadas:
claude-fable-5-2já está disponível na APIYI;gemini-4-neonainda não está disponível.
Resumo
Ao comparar Gemini 4 Neon e Claude Fable 5.2, há três pontos a observar:
- A conta da inteligência: na página do modelo no Artificial Analysis, é 61 contra 65, com as configurações Neon xhigh e Fable max, respectivamente.
- A conta de custo e latência: custo por tarefa de US$ 6,44 contra US$ 26,54, tempo por tarefa de 21,5 contra 41,6 minutos, tempo até o primeiro token de 56,51 contra 247,46 segundos; a velocidade de saída dos dois é 110 tokens/s.
- A conta de programação: ambos estão na configuração xhigh, com índice de 59 contra 58, custo por tarefa de US$ 6,86 contra US$ 15,47, e ambientes de execução Antigravity CLI e Claude Code, respectivamente.
Qual modelo escolher depende de qual conta importa mais para o seu negócio. A sugestão é primeiro restringir as opções com dados públicos e depois testar novamente custo e latência com seus próprios exemplos. Você pode usar a cota gratuita na APIYI apiyi.com para começar a testar claude-fable-5-2; quando gemini-4-neon estiver disponível, será possível alternar diretamente o nome do modelo na mesma interface para comparar.
📚 Referências
-
Post de Sundar Pichai: lançamento e canais de disponibilização do Gemini 4 Neon (dados declarados pela própria empresa)
- Link:
x.com/sundarpichai/status/2123167780988125621
- Link:
-
Blog do Google, “Introducing Gemini 4 Neon”: benchmarks, preços e posicionamento divulgados oficialmente
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon
- Link:
-
Model card do DeepMind: tabela comparativa em três colunas e especificações do modelo
- Link:
deepmind.google/models/model-cards/gemini-4-neon/
- Link:
-
Guia para desenvolvedores do Google Cloud: ID do modelo, níveis de raciocínio e regras de cache
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon
- Link:
-
Página de preços do Google AI Studio: preços pagos do gemini-4-neon
- Link:
aistudio.google.com/docs/pricing
- Link:
-
Artigo do Artificial Analysis: pontuação de inteligência, custo e índice de código do Neon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain
- Link:
-
Página do modelo no Artificial Analysis: dados por faixa de comparação entre Neon e Fable 5.2
- Link:
artificialanalysis.ai/models/gemini-4-neon - Link:
artificialanalysis.ai/models/claude-fable-5-2
- Link:
-
Tabela geral e endpoint de preços do APIYI: modelos já disponíveis, grupos e preços
- Link:
docs.apiyi.com/models.md - Link:
api.apiyi.com/api/pricing
- Link:
Autor: Equipe técnica do APIYI
Contato técnico: fale com a gente pela página inicial do site do APIYI. Mais materiais estão disponíveis na central de documentação em docs.apiyi.com