ملاحظة المؤلف: يفصل هذا المقال، بحسب مصدر كل رقم، ثلاثة دفاتر حساب منفصلة لمقارنة Gemini 4 Neon مع GPT-6.2 Astra: درجة الذكاء، وزمن المهمة الواحدة، وسعر الوحدة مقابل تكلفة المهمة الواحدة. كما يذكر الأسعار المعلنة للطرازات المتاحة على APIYI، والشرائح السعرية، وعناوين الاستدعاء.
في 18 نوفمبر 2026، أعلنت Google عن Gemini 4 Neon. وأعلن Sundar Pichai في اليوم نفسه بدء إطلاقه في Gemini API داخل Google AI Studio، وGemini for business، وGoogle Antigravity، وGemini App. وفي اليوم نفسه، صنّف مقال لـ Artificial Analysis طراز Neon xhigh في المرتبة الثالثة على مؤشر الذكاء العام، وجاء قبله GPT-6.2 Astra (max) وClaude Fable 5.2 (max). عند وضع Neon وAstra جنبًا إلى جنب، فإن أكثر ما يختلط على القارئ هو سعر الوحدة وتكلفة المهمة الواحدة: الأول هو السعر المعلن لكل مليون توكن، والثاني هو المال الذي يُنفق فعليًا لإكمال مسألة واحدة.
فيما يلي ثلاثة دفاتر حساب، كلها مأخوذة من صفحة النماذج في Artificial Analysis (قُرئت في 2026-11-19، المؤشر v5.0.1). الفئة مكتوبة بين قوسين، والفئات المختلفة مسرودة بشكل منفصل:
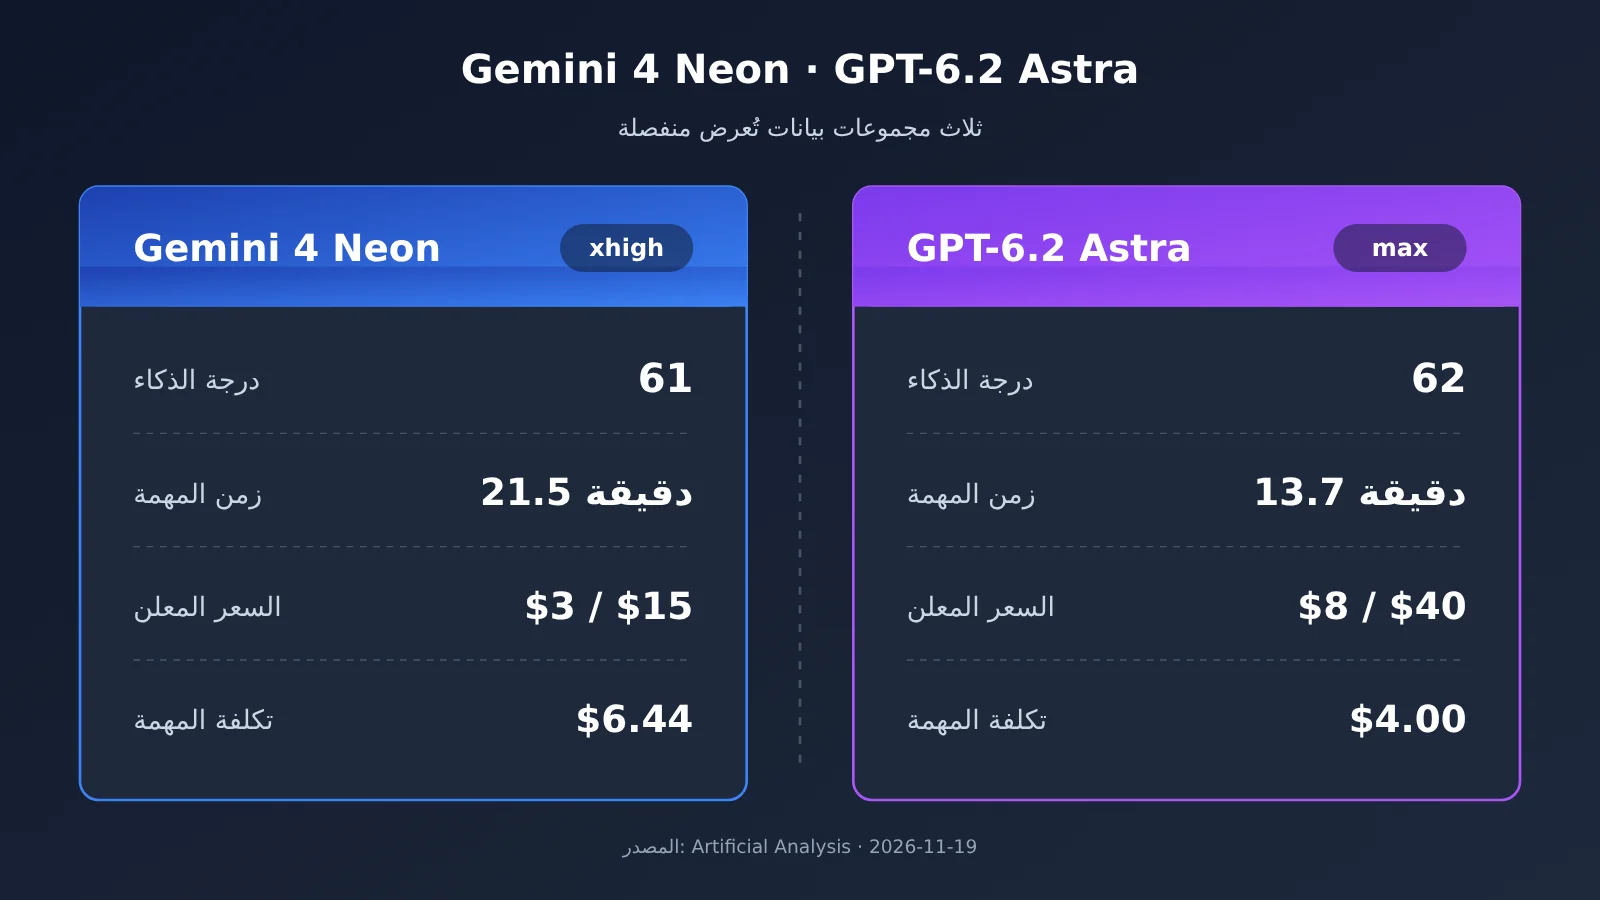
- درجة الذكاء: GPT-6.2 Astra (max) 62، وGemini 4 Neon (xhigh) 61. وفئة xhigh لدى Astra حصلت أيضًا على 62.
- زمن المهمة الواحدة: Astra (max) 13.7 دقيقة، وAstra (xhigh) 7.4 دقيقة، وNeon (xhigh) 21.5 دقيقة.
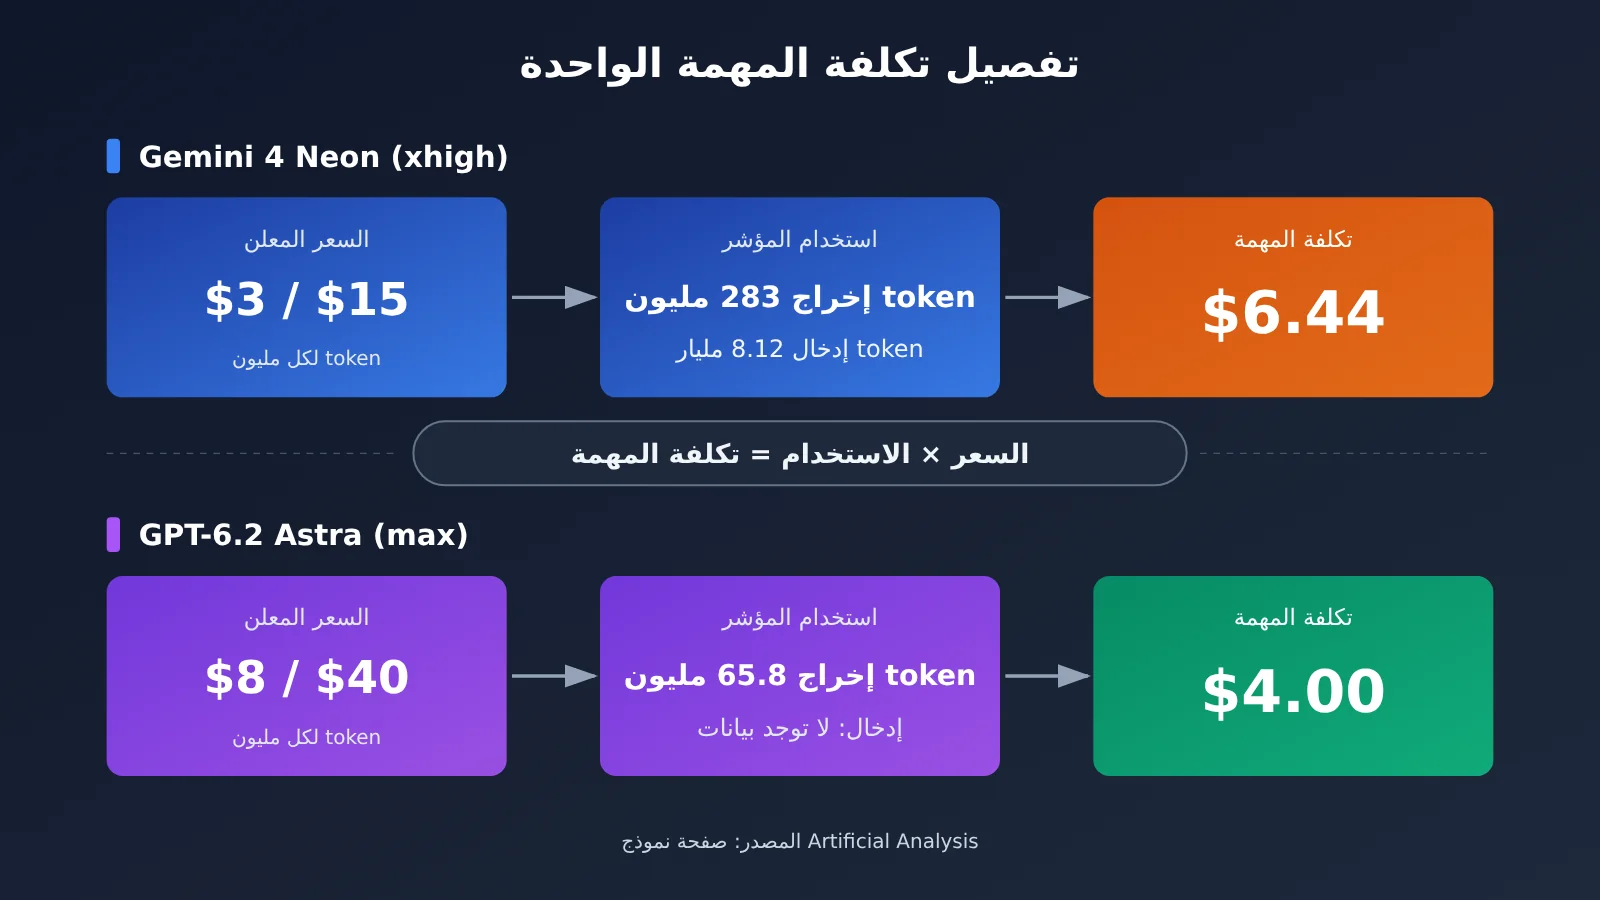
- سعر الوحدة وتكلفة المهمة الواحدة: السعر المعلن لـ Astra هو 8 دولارات للإدخال و40 دولارًا للإخراج لكل مليون توكن، أما Neon فهو 3/15؛ وتكلفة المهمة الواحدة لدى Astra (max) هي 4.00 دولارات، ولدى Neon (xhigh) هي 6.44 دولارات.
ما يجعل سعر الوحدة وتكلفة المهمة الواحدة يسيران في اتجاهين متعاكسين هو استهلاك التوكن. عند تشغيل المجموعة نفسها من الاختبارات، أنتج Astra (max) 65.8 مليون توكن، بينما أنتج Neon (xhigh) 283 مليون توكن؛ وعلى صعيد السرعة، يبلغ Neon نحو 110 توكن/ثانية، وزمن أول توكن في الإجابة 56.51 ثانية، بينما يبلغ Astra 50 توكن/ثانية، وزمن أول توكن في الإجابة 197.65 ثانية. هذا المقال مسؤول فقط عن ترتيب هذه الأرقام في أعمدة واضحة؛ وأي دفتر يهمك أكثر يعتمد على بنية مهامك.
القيمة الأساسية: بعد قراءة هذا المقال، ستتمكن من التمييز بين Gemini 4 Neon وGPT-6.2 Astra: من أي دفتر جاء كل رقم، وفي أي فئة، وستعرف أي الطرازات يمكن استدعاؤها مباشرة على APIYI، وأين تنتقل الأسعار إلى شريحة أخرى.
الفروق الجوهرية بين Gemini 4 Neon وGPT-6.2 Astra
جميع الأرقام في الجدول التالي مأخوذة من صفحات النماذج على Artificial Analysis، مع اختيار المستوى xhigh لـ Neon والمستوى max لـ Astra، وهما أعلى مستوى في كل من الصفحتين. أما جدول المقارنة في بطاقة نموذج DeepMind فيضم ثلاثة أعمدة فقط: Gemini 4 Neon وClaude Opus 5.5 وGPT-6.2 Sol، ولا يحتوي عمودًا لـ Astra، لذلك اعتمدنا في جانب Astra على أرقام صفحة النموذج في Artificial Analysis وحدها.
| محور المقارنة | Gemini 4 Neon (xhigh) | GPT-6.2 Astra (max) | المصدر |
|---|---|---|---|
| درجة الذكاء | 61 | 62 (وعند xhigh أيضًا 62) | صفحة النموذج في Artificial Analysis |
| زمن المهمة الواحدة | 21.5 دقيقة | 13.7 دقيقة (وعند xhigh: 7.4 دقيقة) | صفحة النموذج في Artificial Analysis |
| السعر المعلن (إدخال/إخراج، دولار لكل مليون رمز) | 3.00 / 15.00 | 8.00 / 40.00 | صفحة النموذج في Artificial Analysis |
| تكلفة المهمة الواحدة | 6.44 دولار | 4.00 دولار | صفحة النموذج في Artificial Analysis |
| رموز الإخراج أثناء تشغيل المؤشر | 283 مليون | 65.8 مليون | صفحة النموذج في Artificial Analysis |
| سرعة الإخراج | 110 رمز/ثانية | 50 رمز/ثانية | صفحة النموذج في Artificial Analysis |
| زمن أول رمز في الإجابة | 56.51 ثانية | 197.65 ثانية | صفحة النموذج في Artificial Analysis |
| خصم التخزين المؤقت / السعر المختلط | 95% / 2.21 | 95% / 5.88 | صفحة النموذج في Artificial Analysis |
أضمن طريقة لقراءة هذا الجدول هي قراءته صفًا بصف. فمجموعات درجة الذكاء والزمن والسعر مستقلة عن بعضها، ولا يوجد أي تناقض عندما تجتمع في العمود نفسه صفات مثل «درجة أعلى» و«زمن أقصر» و«سعر وحدة أعلى».
لماذا يكون سعر GPT-6.2 Astra للوحدة أعلى بينما تكلفة المهمة الواحدة أقل؟
يمكن فهم تكلفة المهمة الواحدة بشكل تقريبي على أنها «عدد الرموز المستهلكة × سعر كل رمز». السعر المعلن للإخراج لدى Astra هو 40 دولارًا لكل مليون رمز، أي أكثر من ضعف السعر المعلن لدى Neon البالغ 15 دولارًا؛ لكن حجم الإخراج في تشغيل المؤشر المسجل في صفحة نموذج Artificial Analysis يبلغ 65.8 مليون رمز لـ Astra، وهو أقل من ربع 283 مليون رمز لـ Neon. وبما أن جانب الاستخدام أقل بكثير، فإن تكلفة المهمة الواحدة لدى الطرف الأعلى سعرًا تستقر عند 4.00 دولارات، بينما تستقر لدى Neon عند 6.44 دولارات.
يجب توضيح جانب الإدخال على حدة. تذكر صفحة نموذج Neon أن إدخال تشغيل المؤشر بلغ 8.12 مليار رمز، ولا تتضمن المواد المرجعية عدد رموز الإدخال الخاصة بـ Astra، لذلك سنفصل جانب الإخراج فقط هنا ولن نستنتج الفاتورة الكاملة. السعر المختلط لدى Neon هو 2.21 ولدى Astra هو 5.88، وهو أيضًا يعكس مستوى السعر المعلن فقط؛ وعند تقدير فاتورتك الخاصة ستحتاج إلى ضربه في تركيبة الرموز لديك.
وعند الانتقال إلى أعمال محددة، تتغير تركيبة الرموز. في المهام ذات الإدخال الطويل والإخراج القصير، يصبح وزن سعر الإدخال 8 مقابل 3 أكبر؛ وفي المهام ذات الإخراج الطويل، يهيمن بند استخدام الإخراج على النتيجة. تكلفة المهمة الواحدة في المؤشر هي نتيجة مجموعة مسائل ثابتة، وقبل نقلها إلى سيناريوك، من الأفضل أن تجرّبها على عيناتك الخاصة.
حساب الوقت لدى Gemini 4 Neon: سرعة الإخراج وسرعة الإنجاز أمران منفصلان
يعرض Neon في صفحة النموذج سرعة إخراج تقارب 110 token في الثانية، أي أكثر من ضعف سرعة Astra البالغة 50 token/ثانية، ويكفي أول token من الإجابة 56.51 ثانية فقط، بينما يحتاج Astra إلى 197.65 ثانية. لكن زمن المهمة الواحدة هو 21.5 دقيقة لـ Neon (xhigh)، مقابل 13.7 دقيقة لـ Astra (max) و7.4 دقيقة لـ xhigh. والسبب يعود مجددًا إلى كمية الـ token: النموذج الذي يُخرج كمية أكبر، مهما بلغت سرعته في الثانية، سيحتاج وقتًا أطول حتى ينتهي من الكتابة.
درجة الذكاء في Astra متساوية عند 62 في المستويين xhigh وmax، لكن الزمن 7.4 دقيقة في الأول و13.7 دقيقة في الثاني، لذا يجب ذكر المستوى عند الاستشهاد. أما في جانب Neon، فقد قدّم قسم الأسئلة الشائعة في صفحة نموذج Artificial Analysis أرقامًا منفصلة لزمن أول token من الإجابة في المستويات الأدنى: high 40.64 ثانية، medium 20.14 ثانية، low 13.93 ثانية. هذه الأرقام مأخوذة من الأسئلة الشائعة، وليست في العمود نفسه مع الجدول الموجز.
بيانات Gemini 4 Neon وGPT-6.2 Astra حسب المستويات
| النموذج | المستوى | درجة الذكاء | زمن المهمة الواحدة | سرعة الإخراج |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21.5 دقيقة | 110 token/ثانية |
| Gemini 4 Neon | high (الافتراضي) | 60 | 14.8 دقيقة | 101 token/ثانية |
| Gemini 4 Neon | medium | 55 | 8.3 دقيقة | 101 token/ثانية |
| Gemini 4 Neon | low | 44 | 3.7 دقيقة | 97 token/ثانية |
| GPT-6.2 Astra | max | 62 | 13.7 دقيقة | 50 token/ثانية |
| GPT-6.2 Astra | xhigh | 62 | 7.4 دقيقة | 50 token/ثانية |
| GPT-6.2 Astra | high | 60 | 5.9 دقيقة | 50 token/ثانية |
| GPT-6.2 Astra | medium | 57 | 4.5 دقيقة | 49 token/ثانية |
| GPT-6.2 Astra | low | 46 | 1.8 دقيقة | 48 token/ثانية |
البيانات كلها مأخوذة من صفحة نموذج Artificial Analysis، ومستوى high في Neon هو المستوى الافتراضي المنصوص عليه في دليل مطوري Google. لا يوجد مستوى max في Neon، أما سرعة الإخراج في مستويات Astra فمستقرة بين 48 و50 token/ثانية، والفرق في الزمن يعود أساسًا إلى عدد الـ token المكتوبة في كل مستوى. صفحة النموذج تعطي تكلفة المهمة الواحدة للمستوى الأعلى فقط، ولا نعيد هنا حساب تكاليف المستويات الأخرى.
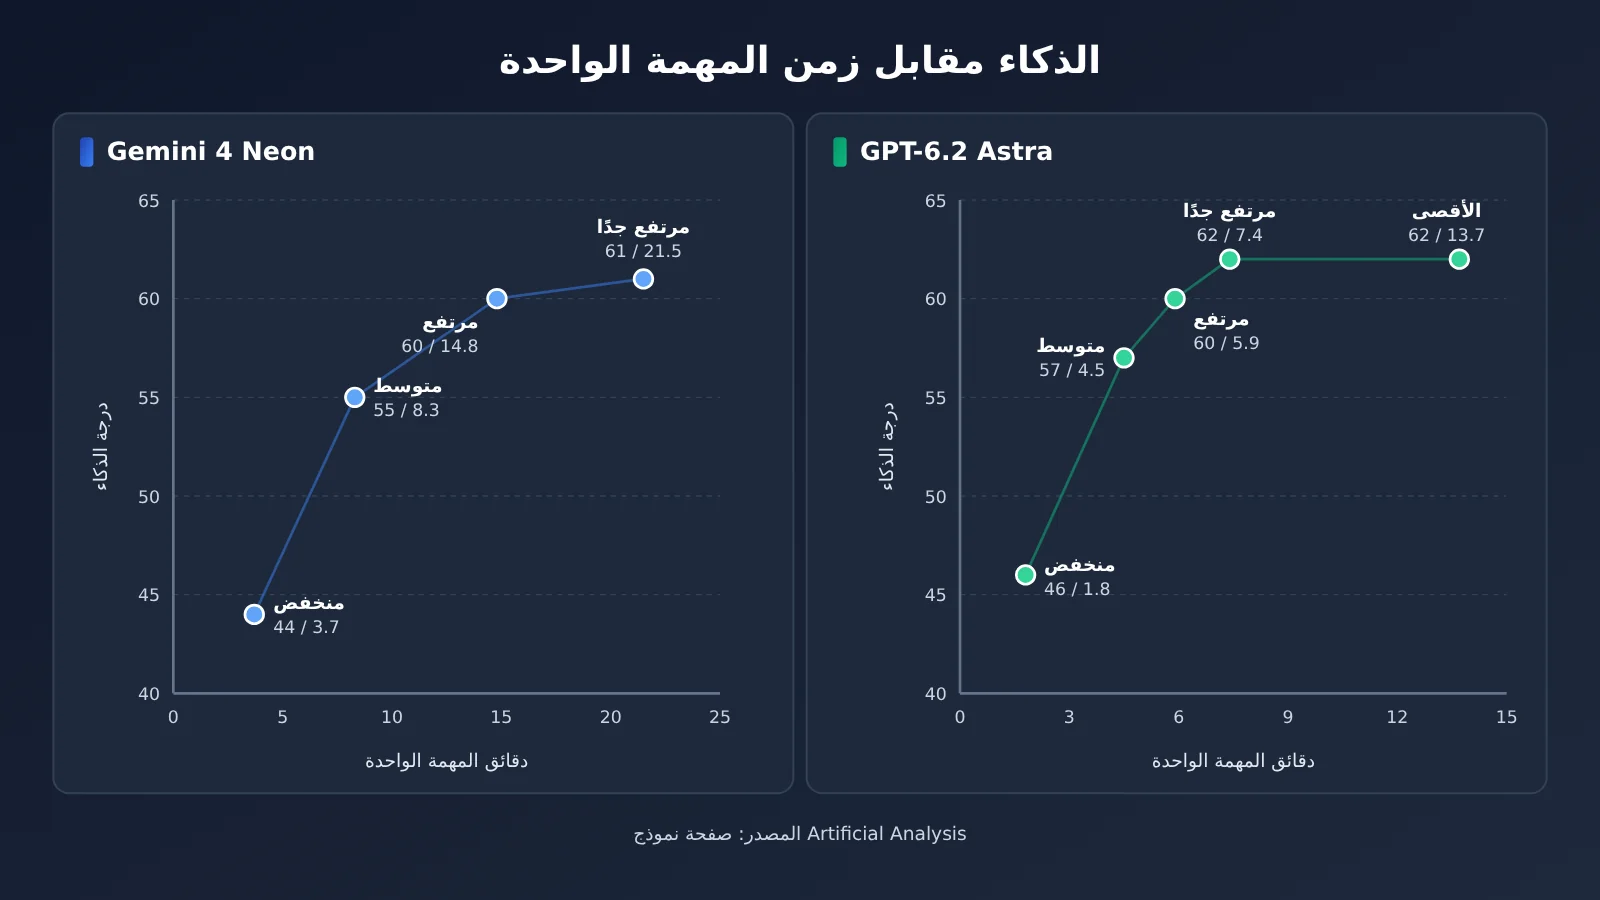
ملاحظة المقارنة: أرقام الرسم والجدول أعلاه مأخوذة من صفحة نموذج Artificial Analysis. وإذا أردت التحقق من استهلاك الـ token بمهامك الخاصة، يمكنك في APIYI استخدام المفتاح نفسه للتبديل بين الطُرز المتاحة والمقارنة.
Gemini 4 Neon: الأرقام المعلنة رسميًا وبطاقة النموذج والأرقام من طرف ثالث
لدى Neon ثلاثة أنواع من المصادر، ولكل منها طريقة مختلفة في حساب الأرقام. والفقرة الكاملة في مدونة Google تُعدّ إبلاغًا رسميًا ذاتيًا؛ إذ تذكر أن مؤشر Artificial Analysis Intelligence Index عند إعداد xhigh يساوي 61، وأن الترتيب العام هو الثالث، وأن Vals Index يبلغ 70.9%، وأن Arena Agent Arena Index يبلغ 1336. وبطاقة نموذج DeepMind تكتب أيضًا أن AA Index v5.0.1 يساوي 61، وتوضح ملاحظات التقييم أن النتائج غير الخاصة بـ Gemini تأتي افتراضيًا من الإبلاغ الذاتي لكل جهة، أي إنها تجميع رسمي. أما مقال Artificial Analysis وصفحة النموذج فهما قياس من طرف ثالث.
| المؤشر | إبلاغ رسمي ذاتي (مدونة Google) | بطاقة النموذج | مقال Artificial Analysis |
|---|---|---|---|
| مؤشر الذكاء (xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | غير مذكور | 59 (Antigravity CLI، xhigh) |
| MKA | غير مذكور | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | غير مذكور |
| SWE-sweep | mini-SWE 12.8%، وAntigravity 39.0% | harness الخاص بالمصنّع 39.0%، وmini-SWE 12.8% | غير مذكور |
| كلام تكلفة المهمة الواحدة | الإعداد الافتراضي high أقل بنسبة 32% من Carbon | غير مذكور | 6.44 دولارًا، أي أقل بنحو 17% من سعر Carbon غير المخفّض البالغ 7.76 دولارًا |
نحتفظ في الجدول بكل الأرقام غير المتطابقة: Coding Agent Index مذكور في الإبلاغ الرسمي بـ 58.6، وفي مقال Artificial Analysis بـ 59؛ وMKA في بطاقة النموذج 56.5% مقابل 56% في مقال Artificial Analysis. أما 12.8% و39.0% في SWE-sweep فهما ناتجان عن أداتَي harness مختلفتين، ومدونة Google تنسب الفرق إلى التحسّن الذي يحدثه harness.
حساب التكلفة أيضًا يسير في ثلاثة دفاتر منفصلة. عبارة Google «أقل بنسبة 32%» تأتي من طريقة حسابهم الخاصة، ولم تكتب المدونة ما إذا كانت Carbon محسوبة بسعر الإطلاق أم بالسعر القياسي؛ أما «أقل بنحو 17%» في مقال Artificial Analysis فقد حُسب من سعر Carbon القياسي 4/20 ليصل إلى 7.76 دولارًا؛ وفي صفحة نموذج Artificial Analysis حُسب سعر Carbon high البالغ 4.90 دولارًا وفق سعر الإطلاق الحالي في الصفحة 2/10. هذه المجموعات الثلاث من الأرقام صحيحة كل واحدة في سياقها، ولا يمكن تحويل إحداها إلى الأخرى.
توصيات حسب السيناريو: أي أساس حسابي تنظر به إلى Gemini 4 Neon أو GPT-6.2 Astra
الحالات التي يُفضّل فيها البدء بأرقام GPT-6.2 Astra
- الحساب على أساس تكلفة المهمة الواحدة: إذا كنت تضع ميزانيتك وفق مبدأ «كم تكلّف المسألة الواحدة»، فيمكنك البدء بصفحة نموذج Artificial Analysis الخاصة بتكلفة المهمة الواحدة، حيث تبلغ تكلفة Astra (max) نحو 4.00 دولارات.
- الاهتمام بإجمالي وقت الإنجاز: فئة Astra xhigh تستغرق 7.4 دقائق ودرجة الذكاء فيها 62، بينما تستغرق فئة max نحو 13.7 دقيقة. الفئتان تحصلان على الدرجة نفسها لكن وقتهما يختلف بوضوح، لذا قيّم كل فئة على حدة عند الاختيار.
- المهام بالدفعات مع إخراج قصير: عند تشغيل المؤشر، ينتج Astra نحو 65.8 مليون توكن، وتكون حصة استهلاك الإخراج منخفضة نسبيًا في فاتورته.
الحالات التي يُفضّل فيها البدء بأرقام Gemini 4 Neon
- الواجهات التفاعلية والاهتمام بانتظار أول توكن: يستغرق أول توكن من إجابة Neon (xhigh) نحو 56.51 ثانية، وتشير الأسئلة الشائعة إلى أن فئة low تبلغ 13.93 ثانية.
- المدخلات متعددة الوسائط: تنص بطاقة نموذج DeepMind على أن المدخلات يمكن أن تكون نصًا أو صورة أو صوتًا أو فيديو، وأن النافذة الموحدة تصل إلى مليون توكن كحد أقصى، مع توقف المعرفة عند مارس 2026.
- التنسيق مع مهام فرعية: تشير إرشادات مطوري Google إلى أنه يمكن استخدام
gemini-4-neonكنموذج تنسيق، وتمريرprevious_interaction_idإلىgemini-4-hydrogenلتنفيذ مهام فرعية أسرع. - الحساب وفق سعر كل توكن: تذكر صفحة التسعير في Google AI Studio أن Neon يسعّر الإدخال عند 3.00، والتخزين المؤقت عند 0.15، والإخراج عند 15.00 دولارًا/مليون توكن، ويشمل الإخراج توكنات التفكير، ولا توجد فئة مجانية.
البحث عن طرازات وأسعار Gemini 4 Neon وGPT-6.2 Astra في APIYI
تشير صفحة الجدول الرئيسي في APIYI إلى آخر تحديث بتاريخ 2026-11-16 09:39 (UTC+8)، وفي 2026-11-19 أعدنا التحقق من واجهة التسعير (الإصدار shell-api-modelmak-v1، بإجمالي 285 نموذجًا)، ويمكن مقارنة كل بند في قائمة الطرازات على apiyi.com. في واجهة التسعير، تعني قيمة model_ratio 1 أن سعر الإدخال 2 دولار لكل مليون token، بينما تعني completion_ratio 5 أن سعر الإخراج يساوي 5 أضعاف سعر الإدخال، وهو ما يطابق الفئة الأولى في الجدول الرئيسي.
| معرّف الطراز | الإدخال | قراءة الذاكرة المؤقتة | الإخراج | نقطة النهاية | ملاحظات |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | عند تجاوز إدخال 272000 token يصبح السعر 16؛ الإخراج في الفئة العليا بواجهة التسعير نحو 60، والجدول الرئيسي لا يذكر سعر الإخراج لهذه الفئة |
gpt-6.2-sol |
2 | 0.1 | 10 | responses (موصى به)، chat | عند تجاوز إدخال 272000 token يصبح السعر 3؛ الإخراج في الفئة العليا بواجهة التسعير نحو 11.25 |
gemini-4-carbon |
2 | 0.1 | 10 | chat، gemini | يطابق سعر Google التقديمي حتى 2026-11-30 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat، gemini | المجموعتان: Default وSVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat، messages | تتوفر أيضًا نسخة -thinking |
claude-fable-5-2 |
8 | 0.2 | 40 | chat، messages | تتوفر أيضًا نسخة -thinking |
gemini-4-neon |
— | — | — | — | غير مدرج في الجدول الرئيسي ولا في واجهة التسعير |
جميع الوحدات بالدولار لكل مليون token. القيم 2/0.1/10 لـ gemini-4-carbon هي السعر المعروض حاليًا في APIYI، وتطابق سعر Google التقديمي، وينبغي النظر إليها بشكل منفصل عن سعر Google المعياري اللاحق 4/20. تختلف كتابة أسماء المجموعات قليلًا بين الموضعين؛ فمثلًا يكتب الجدول الرئيسي Default وSVIP، بينما تكتب واجهة التسعير default وsvip؛ وفي سلسلة Claude يكتب الجدول الرئيسي Claude_Reverse وClaude_Enterprise، بينما تكتب واجهة التسعير ClaudeCodeReverse وClaudeOfficial، والأسماء في المجموعتين تُعتمد كما تظهر على المنصة.
يأتي السعر الرسمي المعلن لـ Gemini 4 Neon من صفحة التسعير في Google AI Studio: الإدخال 3.00، والذاكرة المؤقتة 0.15، والإخراج 15.00 دولار لكل مليون token، ويدعم التخزين المؤقت الضمني فقط. لا يظهر gemini-4-neon في الجدول الرئيسي في APIYI ولا في واجهة التسعير، ولا توجد له صفحة طراز مستقلة، وهو غير متاح حاليًا؛ وسنضيف هذا الطراز في أقرب وقت. تُعتمد الطرازات والأسعار وفق قائمة الطرازات المعروضة على المنصة.
البدء السريع: استدعاء GPT-6.2 Astra عبر APIYI
يعمل gpt-6.2-astra عبر نقطة نهاية responses المتوافقة مع OpenAI، ويمكن تشغيله في أربع خطوات كما يلي:
- سجّل في apiyi.com وأنشئ مفتاح API، ثم اكتبه في متغير البيئة
APIYI_API_KEY، واقرأه في الكود من متغير البيئة فقط، دون كتابة المفتاح صراحةً. - هيّئ العميل باستخدام OpenAI SDK:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). - استدعِ نقطة نهاية responses:
resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别")، ثم اقرأresp.output_text. - تحقّق من الفاتورة: الشريحة الأولى في جدول APIYI الإجمالي هي الإدخال 8، وقراءة التخزين المؤقت 0.4، والإخراج 40 دولارًا/مليون token؛ وعندما يتجاوز إدخال الطلب الواحد 272000 token يصبح الإدخال 16، وتكون
CompletionRatioفي واجهة التسعير لهذه الشريحة 3.75، والإخراج نحو 60 دولارًا/مليون token، لكن نص الجدول الإجمالي لا يذكر إخراج هذه الشريحة.
في مهام السياق الطويل، انتبه خصوصًا إلى الخطوة 4. بعد تجاوز 272000 token تنتقل الإدخالات والإخراجات معًا إلى شريحة أعلى، وستنحرف تكلفة المهمة الواحدة بوضوح عن تقدير الشريحة الأولى، لذا يُنصح بإحصاء عدد token في الطلبات النموذجية أولًا ثم تحديد الميزانية.
نماذج Gemini المتاحة حاليًا يمكن ربطها بطريقتين: gemini-4-carbon وgemini-4-hydrogen يمكن استخدامهما عبر نفس العنوان المتوافق مع OpenAI من خلال نقطة نهاية chat، أو عبر عنوان Gemini الأصلي https://api.apiyi.com مع إصدار API v1beta. ويمكن التعرف على قواعد معاملات Neon أولًا من دليل مطوري Google: مستويات التفكير هي فقط low وmedium وhigh وxhigh، والافتراضي high؛ وتمرير thinking_budget أو MINIMAL يعيد HTTP 400؛ والتخزين المؤقت الصريح للسياق غير مدعوم، والبادئات المشتركة التي تتجاوز 4096 token تستخدم التخزين المؤقت الضمني تلقائيًا؛ والحد الأقصى الافتراضي لإخراج المقطع الواحد هو 65536 token.
🚀 بدء سريع: يُنصح أولًا بالحصول على رصيد الاختبار المجاني للمستخدمين الجدد من APIYI apiyi.com، ثم استدعاء
gpt-6.2-astraوgpt-6.2-solوgemini-4-carbonبالترتيب باستخدام المفتاح نفسه، وتسجيل عدد token للإدخال والإخراج لكل منها، ثم إدخاله في جدول الأسعار أعلاه لحساب تكلفة المهمة الواحدة.
توصيات القرار بين Gemini 4 Neon وGPT-6.2 Astra
| السؤال الذي يهمك | أي عمود تنظر إليه أولاً | Gemini 4 Neon (xhigh) | GPT-6.2 Astra | المصدر |
|---|---|---|---|---|
| درجة الذكاء | درجة الذكاء | 61 | max 62، xhigh 62 | صفحة النموذج في Artificial Analysis |
| كم يستغرق إكمال مهمة واحدة | زمن المهمة الواحدة | 21.5 دقيقة | max 13.7 دقيقة، xhigh 7.4 دقيقة | صفحة النموذج في Artificial Analysis |
| كم تنتظر حتى يصل أول token | أول token للإجابة | 56.51 ثانية | max 197.65 ثانية | صفحة النموذج في Artificial Analysis |
| السعر المعلن لكل مليون token | سعر الوحدة | 3 / 15 | 8 / 40 | صفحة النموذج في Artificial Analysis، وجدول APIYI العام |
| كم تكلفة إكمال المؤشر | تكلفة المهمة الواحدة | 6.44 دولار | max 4.00 دولار | صفحة النموذج في Artificial Analysis |
| كيف يتم حساب المدخلات الطويلة | شرائح التسعير | المصدر المرجعي لا يذكر شرائح | عند تجاوز 272000 token في الإدخال: 16، وللإخراج نحو 60 | جدول APIYI العام، واجهة التسعير |
عند اتخاذ القرار، حدد أولاً أي صف يمثل الأهم بالنسبة لعملك، ثم انظر إلى الأرقام والمصدر في ذلك الصف. الفرق في درجة الذكاء نقطة واحدة فقط، بينما تختلف اتجاهات الفروق في الزمن المستغرق، وأول token، وسعر الوحدة، وتكلفة المهمة الواحدة من صف إلى آخر، ولا يمكن لأي صف أن يغني عن بقية الصفوف.
💡 توصية بالاختيار: غالبًا ما تختلف بنية token في مجموعة أسئلة المؤشر عن مهامك الواقعية. نقترح تشغيل عينات من مهامك على apiyi.com ومقارنتها بالنماذج المتاحة، ثم تسجيل استهلاك token والوقت المستغرق قبل تحديد المستوى والنموذج.
الأسئلة الشائعة حول Gemini 4 Neon وGPT-6.2 Astra
س1: ما هو Gemini 4 Neon؟
Gemini 4 Neon هو نموذج أطلقته Google في 18 نوفمبر 2026، ومعرّف النموذج هو `gemini-4-neon`. وتوضح بطاقة النموذج من DeepMind أنه مشتق من Gemini 4 Carbon، وأنه يقع في العائلة بين Hydrogen (التنفيذ السريع اليومي) وCarbon (المهام المعقدة الطويلة المدى)، مع نافذة سياق موحدة بسعة 1048576 توكن.
س2: كم يبلغ الفرق في درجة الذكاء بين Gemini 4 Neon وGPT-6.2 Astra؟
في صفحة النموذج على Artificial Analysis، حصل Neon (xhigh) على 61، وحصل Astra (max) على 62، كما حصل Astra (xhigh) على 62. حصل Astra على الدرجة نفسها في الإعدادين، وكان زمن التنفيذ 13.7 دقيقة و7.4 دقيقة على الترتيب، ويجب ذكر الإعداد عند الاقتباس.
س3: متى يتوفر Gemini 4 Neon؟
كتب سوندار بيتشاي في يوم الإطلاق أن Neon سيتوفر اعتبارًا من 18 نوفمبر 2026 عبر Gemini API في Google AI Studio، وGemini for business، وGoogle Antigravity لاشتراكي Google AI Pro وUltra المدفوعين، وتطبيق Gemini لاشتراكي Pro وUltra. وتوضح صفحة التسعير في Google AI Studio أنه لا توجد فئة مجانية له.
س4: سعر وحدة GPT-6.2 Astra أعلى، فلماذا تبلغ تكلفة المهمة الواحدة 4.00 دولارات؟
تتحدد تكلفة المهمة الواحدة بسعر الوحدة وكمية الاستخدام معًا. تسجل صفحة النموذج على Artificial Analysis أن Astra (max) أنتج 65.8 مليون توكن عند تشغيل المؤشر، بينما أنتج Neon (xhigh) 283 مليون توكن. ورغم أن سعر وحدة الإخراج لدى Astra هو 40 مقابل 15، فإن استخدامه أقل بكثير، لذلك تبلغ تكلفة المهمة الواحدة 4.00 دولارات، مقابل 6.44 دولارات لدى Neon.
س5: كيف يمكن استدعاء GPT-6.2 Astra بسرعة عبر API؟
1. سجّل في APIYI apiyi.com واحصل على مفتاح API وحصة تجريبية مجانية.
2. اضبط `base_url` في OpenAI SDK على عنوان OpenAI المتوافق المذكور في دليل البدء السريع أعلاه.
3. استخدم نقطة النهاية `responses`، واكتب اسم النموذج `gpt-6.2-astra`.
`gemini-4-neon` غير موجود حاليًا في الجدول الرئيسي أو واجهة التسعير لدى APIYI، وبعد توفره ستكون قائمة النماذج على المنصة هي المرجع.
س6: ما القيود التي يجب مراعاتها عند الاستشهاد بهذه الأرقام؟
– **منهجية القياس**: تختلف مصادر الأرقام بين البيانات المعلنة رسميًا وبطاقة النموذج ومقالات Artificial Analysis وصفحات النماذج. فمؤشر Coding Agent Index يرد بقيمتين هما 58.6 و59، وMKA يرد بقيمتين هما 56.5% و56%.
– **التكلفة**: رقم Google «أقل بنسبة 32%»، ورقم مقال Artificial Analysis «أقل بنحو 17%»، ورقم صفحة النموذج Carbon 4.90 دولارات، هي ثلاث حسابات منفصلة لا يمكن دمجها.
– **الانتقال إلى مهامك**: تكلفة المهمة الواحدة في المؤشر مأخوذة من مجموعة مهام ثابتة، وبنية التوكنات في مهمتك مختلفة، لذا ستختلف النتيجة أيضًا.
Gemini 4 Neon مقابل GPT-6.2 Astra: النقاط الأساسية
- درجة الذكاء: على صفحة نموذج Artificial Analysis، Astra (max) تسجل 62، وAstra (xhigh) تسجل 62، وNeon (xhigh) تسجل 61.
- زمن التنفيذ: Neon (xhigh) يستغرق 21.5 دقيقة، بينما Astra max يستغرق 13.7 دقيقة وxhigh يستغرق 7.4 دقيقة؛ لذلك يجب الاستشهاد بكل مستوى على حدة.
- سعر الوحدة: Astra بسعر 8/40، وNeon بسعر 3/15 دولار لكل مليون token؛ وسعر Neon مأخوذ من صفحة التسعير في Google AI Studio.
- تكلفة المهمة الواحدة: Astra (max) تبلغ 4.00 دولار، وNeon (xhigh) تبلغ 6.44 دولار، والفرق ناتج عن كمية tokens الإخراج المستهلكة.
- السرعة وزمن أول token: Neon بسرعة 110 token/ثانية وزمن أول token قدره 56.51 ثانية؛ أما Astra فبسرعة 50 token/ثانية وزمن أول token قدره 197.65 ثانية.
- ما هو متاح على APIYI: الطراز
gpt-6.2-astraيبدأ بفئة 8/0.4/40، وعند تجاوز إدخال 272000 token يصبح 16، ويقارب إخراج واجهة التسعير 60؛ أماgemini-4-neonفلم يُدرج بعد.
ملخص المقارنة بين Gemini 4 Neon وGPT-6.2 Astra
جوهر المقارنة بين Gemini 4 Neon وGPT-6.2 Astra هو حساب كل بند على حدة:
- حساب الذكاء: 61 مقابل 62، حيث يتساوى Astra في مستويي xhigh وmax عند 62، والمصدر هو صفحة نموذج Artificial Analysis.
- حساب الزمن: 21.5 دقيقة مقابل 13.7 دقيقة (Astra xhigh يسجل 7.4 دقيقة)، وسرعة الإخراج وزمن أول token هما مجموعة أرقام أخرى منفصلة.
- حساب السعر: سعر الوحدة 3/15 مقابل 8/40، وتكلفة المهمة الواحدة 6.44 مقابل 4.00 دولار، وبينهما فجوة تبلغ 283 مليون token إخراج مقابل 65.8 مليون token.
عند اختيار النموذج، حدد أولاً أي «دفتر حسابات» تعتمد عليه، ثم راجع استهلاك tokens باستخدام عيناتك الخاصة. نوصي بإجراء اختبار مقارن للنماذج المدرجة عبر APIYI على apiyi.com باستخدام مفتاح API واحد، وبعد إدراج gemini-4-neon يمكن إضافته مباشرة إلى نفس سير العمل.
📚 المراجع
-
منشور الإطلاق من Sundar Pichai: إطلاق Gemini 4 Neon وقنوات توفره
- الرابط:
x.com/sundarpichai/status/2123167780988125621 - الوصف: تاريخ الإطلاق ونقطة الدخول إلى الخدمة
- الرابط:
-
مدونة Google — Introducing Gemini 4 Neon: المعايير والأسعار والتموضع المعلنة رسميًا
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - الوصف: Coding Agent Index 58.6، وتكلفة أقل بنسبة 32%، وفق الأرقام الرسمية
- الرابط:
-
بطاقة نموذج Gemini 4 Neon من DeepMind: جدول المقارنة ومواصفات النموذج
- الرابط:
deepmind.google/models/model-cards/gemini-4-neon/ - الوصف: جدول المقارنة يضم ثلاثة أعمدة فقط: Neon وClaude Opus 5.5 وGPT-6.2 Sol
- الرابط:
-
دليل مطوّري Google Cloud: معاملات
gemini-4-neonوقواعد التخزين المؤقت- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - الوصف: مستويات التفكير، وشروط
HTTP 400، والتخزين المؤقت الضمني
- الرابط:
-
صفحة الأسعار في Google AI Studio: الأسعار الرسمية لعائلة Gemini 4
- الرابط:
aistudio.google.com/docs/pricing - الوصف: Neon بسعر 3/0.15/15، وسعر Carbon التقديمي حتى 2026-11-30
- الرابط:
-
مقال Artificial Analysis: تحليل درجة الذكاء والتكلفة لـ Neon
- الرابط:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - الوصف: قياس من طرف ثالث، يشير إلى أن السعر القياسي لـ Carbon أقل بنحو 17%
- الرابط:
-
صفحة النموذج على Artificial Analysis: Gemini 4 Neon وGPT-6.2 Astra
- الرابط:
artificialanalysis.ai/models/gemini-4-neonوartificialanalysis.ai/models/gpt-6-2-astra - الوصف: المصدر الرئيسي لبيانات الحسابات الثلاثة في هذا المقال، تمت قراءتها بتاريخ 2026-11-19
- الرابط:
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمعرفة الطُرز والأسعار يُرجى الاعتماد على قائمة الطُرز ومركز الوثائق في المنصة.