Anmerkung des Autors: Dieser Artikel schlüsselt anhand der Quellenlabels die drei Aufstellungen zu Gemini 4 Neon und GPT-6.2 Astra auf – Intelligenzwert, Zeit pro Aufgabe sowie Stückpreis und Kosten pro Aufgabe – und listet die Listenpreise, Preisstaffeln und Aufrufadressen der bei APIYI verfügbaren Modelle auf.
Am 18. November 2026 veröffentlichte Google Gemini 4 Neon. Sundar Pichai kündigte am selben Tag an, dass der Rollout in der Gemini API von Google AI Studio, in Gemini for business, in Google Antigravity und in der Gemini App beginnt. Am selben Tag setzte ein Artikel von Artificial Analysis Neon xhigh im Intelligenzindex insgesamt auf Platz 3; vor ihm lagen GPT-6.2 Astra (max) und Claude Fable 5.2 (max). Wenn man Neon und Astra nebeneinanderlegt, verwechselt man am leichtesten Stückpreis und Kosten pro Aufgabe: Der Stückpreis ist der Listenpreis pro Million Token, die Kosten pro Aufgabe sind das Geld, das ein einzelner Aufgabenlauf tatsächlich kostet.
Die folgenden drei Aufstellungen stammen vollständig von der Modellseite von Artificial Analysis (abgerufen am 19.11.2026, Index v5.0.1); die Stufe steht in Klammern, unterschiedliche Stufen sind getrennt aufgeführt:
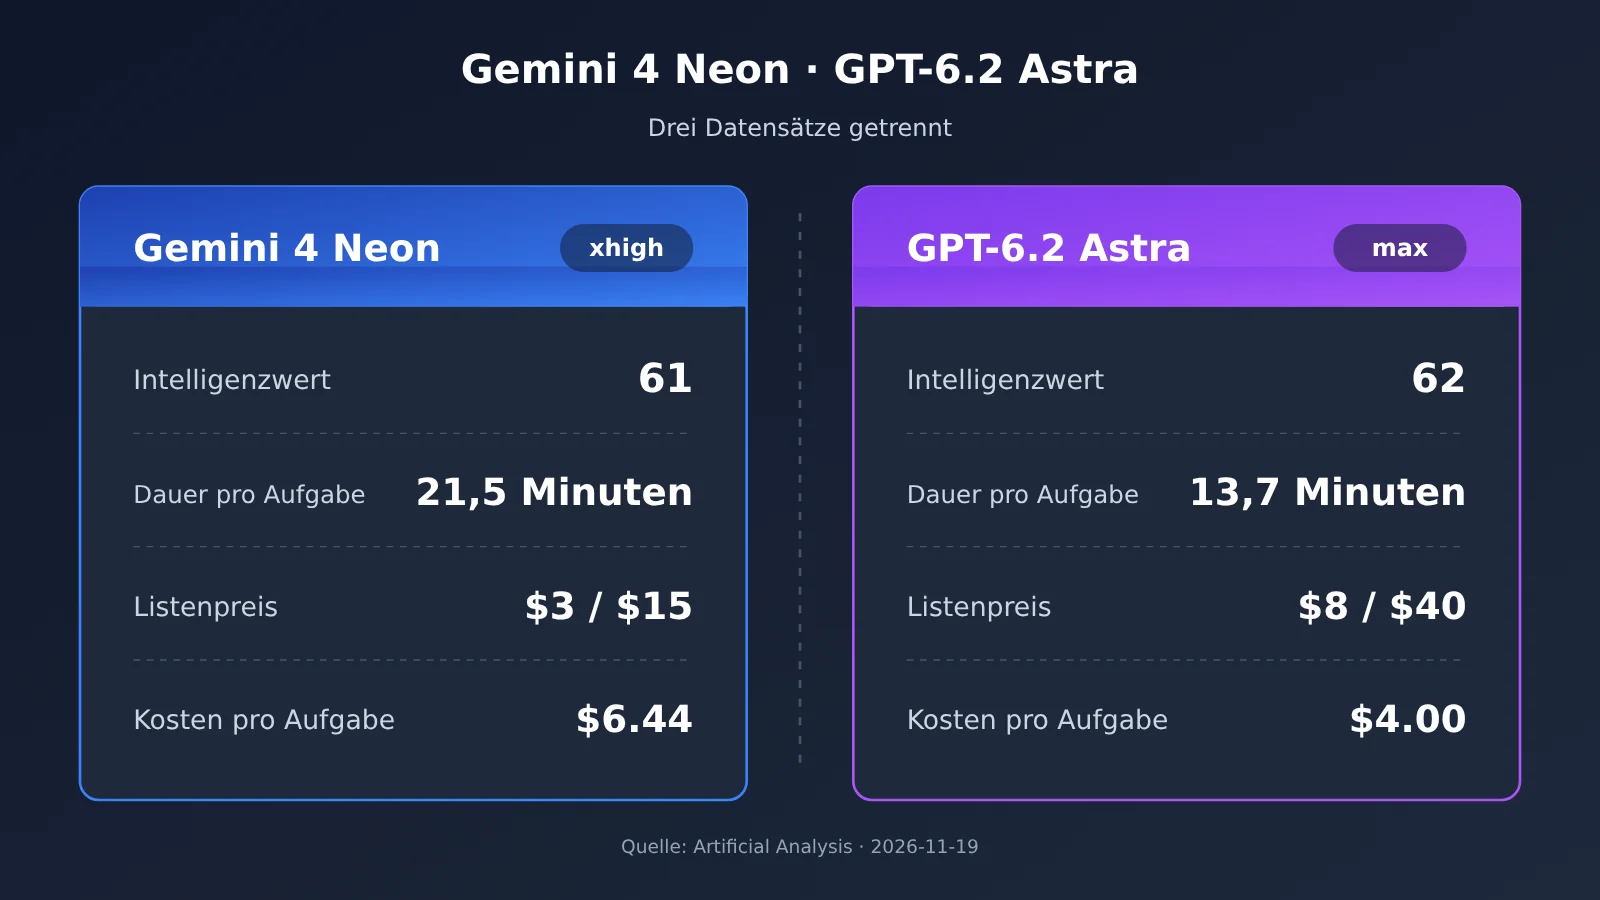
- Intelligenzwert: GPT-6.2 Astra (max) 62, Gemini 4 Neon (xhigh) 61. Astra erreicht in der xhigh-Stufe ebenfalls 62.
- Zeit pro Aufgabe: Astra (max) 13,7 Minuten, Astra (xhigh) 7,4 Minuten, Neon (xhigh) 21,5 Minuten.
- Stückpreis und Kosten pro Aufgabe: Astra hat einen Listenpreis von 8 US-Dollar für die Eingabe und 40 US-Dollar für die Ausgabe pro Million Token, Neon liegt bei 3/15; die Kosten pro Aufgabe betragen bei Astra (max) 4,00 US-Dollar und bei Neon (xhigh) 6,44 US-Dollar.
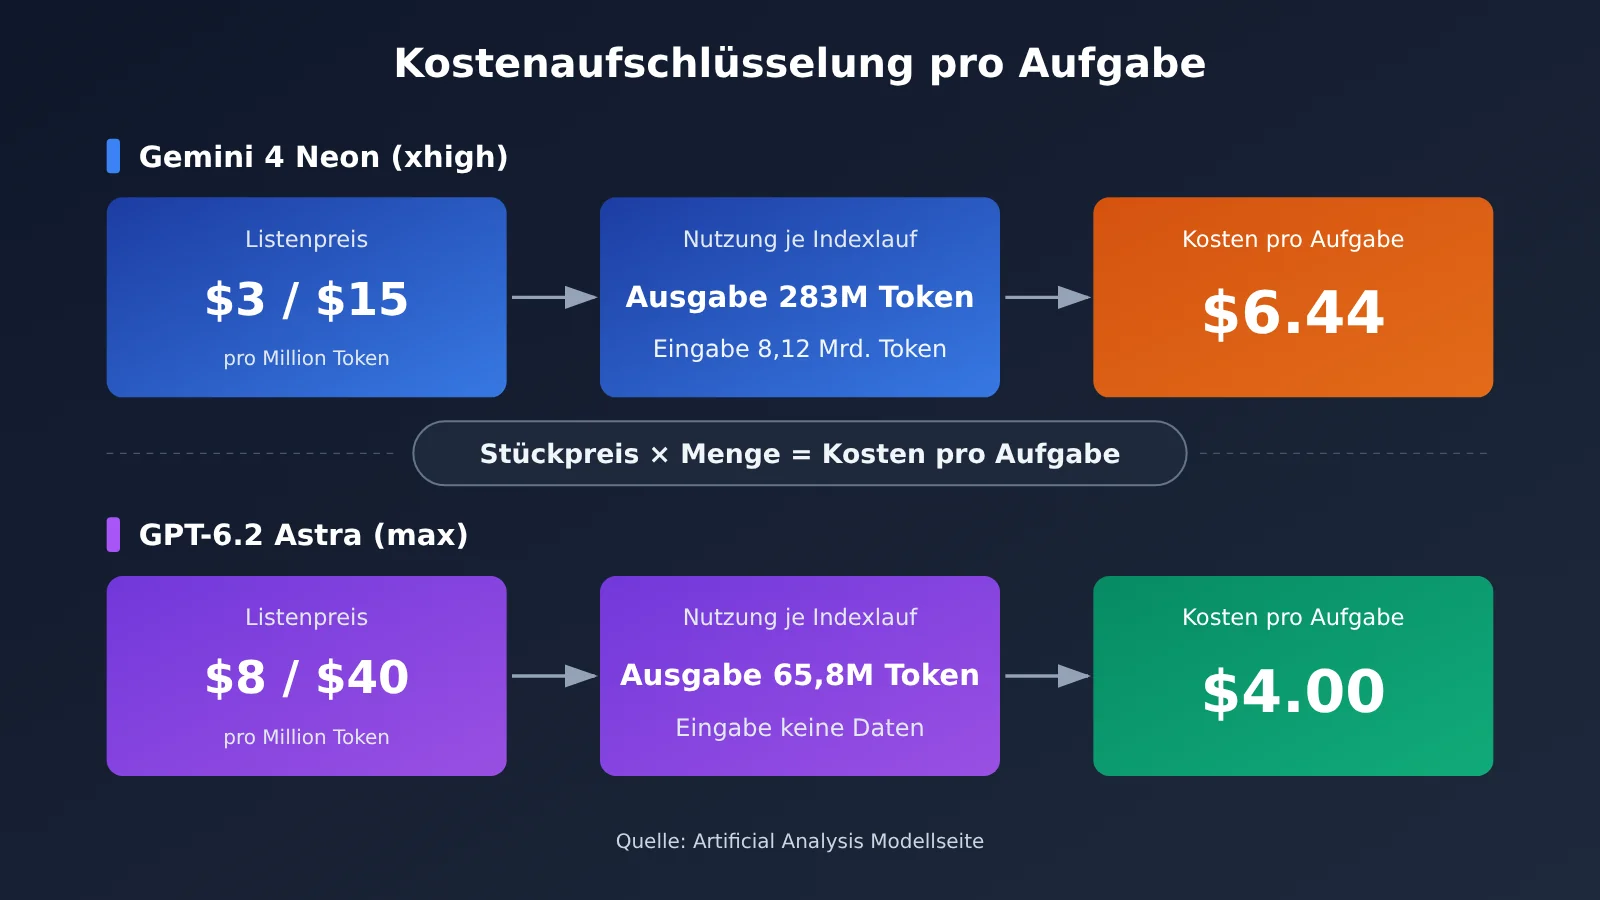
Dafür, dass Stückpreis und Kosten pro Aufgabe in entgegengesetzte Richtungen laufen, sorgt der Token-Verbrauch. Beim Durchlauf desselben Indexsatzes produziert Astra (max) 65,8 Millionen Token, Neon (xhigh) 283 Millionen Token; bei der Geschwindigkeit erreicht Neon etwa 110 Token pro Sekunde, das erste Antwort-Token kommt nach 56,51 Sekunden, Astra erreicht 50 Token pro Sekunde, das erste Antwort-Token kommt nach 197,65 Sekunden. Dieser Artikel stellt diese Zahlen nur sauber nebeneinander; welche Aufstellung für dich wichtiger ist, hängt von der Struktur deiner Aufgaben ab.
Kernnutzen: Nach dem Lesen dieses Artikels kannst du einordnen, aus welcher Aufstellung und welcher Stufe jede Zahl zu Gemini 4 Neon und GPT-6.2 Astra stammt, und weißt, welche Modelle bei APIYI direkt aufrufbar sind und an welcher Stelle der Preis in eine andere Preisstaffel springt.
Zentrale Unterschiede zwischen Gemini 4 Neon und GPT-6.2 Astra
Alle Werte in der folgenden Tabelle stammen aus den Modellseiten von Artificial Analysis. Bei Neon wird die Stufe xhigh verwendet, bei Astra die Stufe max – das sind jeweils die höchsten Stufen auf den beiden Seiten. Die Vergleichstabelle auf der DeepMind-Modellkarte enthält nur drei Spalten: Gemini 4 Neon, Claude Opus 5.5 und GPT-6.2 Sol. Astra fehlt dort, deshalb werden für die Astra-Seite ausschließlich die Zahlen der Artificial Analysis-Modellseite herangezogen.
| Vergleichsdimension | Gemini 4 Neon (xhigh) | GPT-6.2 Astra (max) | Quelle |
|---|---|---|---|
| Intelligenzwert | 61 | 62 (xhigh ebenfalls 62) | Artificial Analysis, Modellseite |
| Zeit pro Aufgabe | 21,5 Minuten | 13,7 Minuten (xhigh: 7,4 Minuten) | Artificial Analysis, Modellseite |
| Listenpreis (Input/Output, USD pro Million Token) | 3,00 / 15,00 | 8,00 / 40,00 | Artificial Analysis, Modellseite |
| Kosten pro Aufgabe | 6,44 USD | 4,00 USD | Artificial Analysis, Modellseite |
| Ausgabe-Token im Index-Lauf | 283 Millionen | 65,8 Millionen | Artificial Analysis, Modellseite |
| Ausgabegeschwindigkeit | 110 Token/s | 50 Token/s | Artificial Analysis, Modellseite |
| Erstes Antwort-Token | 56,51 Sekunden | 197,65 Sekunden | Artificial Analysis, Modellseite |
| Cache-Rabatt / Mischpreis | 95 % / 2,21 | 95 % / 5,88 | Artificial Analysis, Modellseite |
Diese Tabelle liest man am besten Zeile für Zeile. Intelligenzwert, Laufzeit und Preis sind drei voneinander unabhängige Größen – wenn in derselben Spalte „hoher Wert“, „kurze Laufzeit“ und „hoher Stückpreis“ nebeneinander stehen, ist das kein Widerspruch.
Warum GPT-6.2 Astra pro Token teurer, pro Aufgabe aber günstiger ist
Die Kosten pro Aufgabe lassen sich grob als „verbrauchte Token × Preis pro Token“ verstehen. Astra listet für die Ausgabe 40 US-Dollar pro Million Token – mehr als das Doppelte der 15 US-Dollar von Neon. Die auf der Modellseite von Artificial Analysis erfasste Ausgabemenge im Index-Lauf beträgt bei Astra jedoch 65,8 Millionen Token, also weniger als ein Viertel der 283 Millionen Token von Neon. Weil auf der Verbrauchsseite viel stärker gedrückt wird, landet der teurere Anbieter bei 4,00 US-Dollar pro Aufgabe, Neon bei 6,44 US-Dollar.
Die Eingabeseite verdient eine eigene Betrachtung. Auf der Neon-Modellseite sind für den Index-Lauf 8,12 Milliarden Eingabe-Token vermerkt; in den Referenzunterlagen fehlt die Eingabe-Token-Zahl für Astra. Deshalb wird hier nur die Ausgabeseite aufgeschlüsselt und nicht die komplette Abrechnung rückwärts gerechnet. Der gemischte Preis liegt bei Neon bei 2,21 und bei Astra bei 5,88 – auch das spiegelt nur die Listenpreisebene wider. Um deine eigene Rechnung zu schätzen, musst du zusätzlich deine Token-Struktur berücksichtigen.
Sobald man auf ein konkretes Geschäftsfeld wechselt, verändert sich die Token-Struktur. Bei Aufgaben mit sehr langen Eingaben und sehr kurzen Ausgaben bekommt der Eingabepreis mit 8 gegenüber 3 mehr Gewicht; bei Aufgaben mit sehr langen Ausgaben dominiert der Posten Ausgabemenge das Ergebnis. Die Kosten pro Aufgabe im Index sind das Resultat eines einmal festgelegten Fragensatzes – bevor du sie auf dein Szenario überträgst, solltest du einmal mit deinen eigenen Samples durchlaufen.
Die Zeitbilanz von Gemini 4 Neon: schnelle Ausgabe und schnelles Fertigwerden sind zweierlei
Auf der Modellseite gibt Neon rund 110 Token pro Sekunde aus – mehr als das Doppelte der 50 Token/Sekunde von Astra. Das erste Antwort-Token ist bei Neon schon nach 56,51 Sekunden da, bei Astra erst nach 197,65 Sekunden. Die Zeit pro Aufgabe sieht trotzdem anders aus: Neon (xhigh) braucht 21,5 Minuten, Astra (max) 13,7 Minuten und Astra (xhigh) 7,4 Minuten. Der Grund führt wieder zur Token-Menge: Ein Modell, das mehr ausgibt, braucht am Ende länger, egal wie schnell es pro Sekunde Token ausspuckt.
Bei Astra haben xhigh und max denselben Intelligenzwert von 62 – xhigh braucht 7,4 Minuten, max 13,7 Minuten. Wer diese Zahlen zitiert, muss deshalb unbedingt die Stufe mit angeben. Auf der Neon-Seite nennt die FAQ der Artificial-Analysis-Modellseite zusätzlich die Zeit bis zum ersten Antwort-Token für die niedrigeren Stufen: high 40,64 Sekunden, medium 20,14 Sekunden, low 13,93 Sekunden. Diese Zahlen stammen aus der FAQ und stehen nicht in derselben Spalte wie die Übersichtstabelle.
Daten nach Stufen für Gemini 4 Neon und GPT-6.2 Astra
| Modell | Stufe | Intelligenzwert | Zeit pro Aufgabe | Ausgabegeschwindigkeit |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21,5 Minuten | 110 Token/s |
| Gemini 4 Neon | high (Standard) | 60 | 14,8 Minuten | 101 Token/s |
| Gemini 4 Neon | medium | 55 | 8,3 Minuten | 101 Token/s |
| Gemini 4 Neon | low | 44 | 3,7 Minuten | 97 Token/s |
| GPT-6.2 Astra | max | 62 | 13,7 Minuten | 50 Token/s |
| GPT-6.2 Astra | xhigh | 62 | 7,4 Minuten | 50 Token/s |
| GPT-6.2 Astra | high | 60 | 5,9 Minuten | 50 Token/s |
| GPT-6.2 Astra | medium | 57 | 4,5 Minuten | 49 Token/s |
| GPT-6.2 Astra | low | 46 | 1,8 Minuten | 48 Token/s |
Die Daten stammen alle von der Artificial-Analysis-Modellseite. Bei Neon ist high die Standardstufe – das steht so im Google-Entwicklerhandbuch. Neon hat keine max-Stufe. Astras Ausgabegeschwindigkeit bleibt über alle Stufen hinweg stabil zwischen 48 und 50 Token/Sekunde, die Zeitunterschiede kommen also vor allem daher, wie viele Token die einzelne Stufe ausgibt. Die Modellseite nennt nur die Kosten pro Aufgabe für die höchste Stufe; die Kosten der übrigen Stufen rechne ich hier nicht nach.
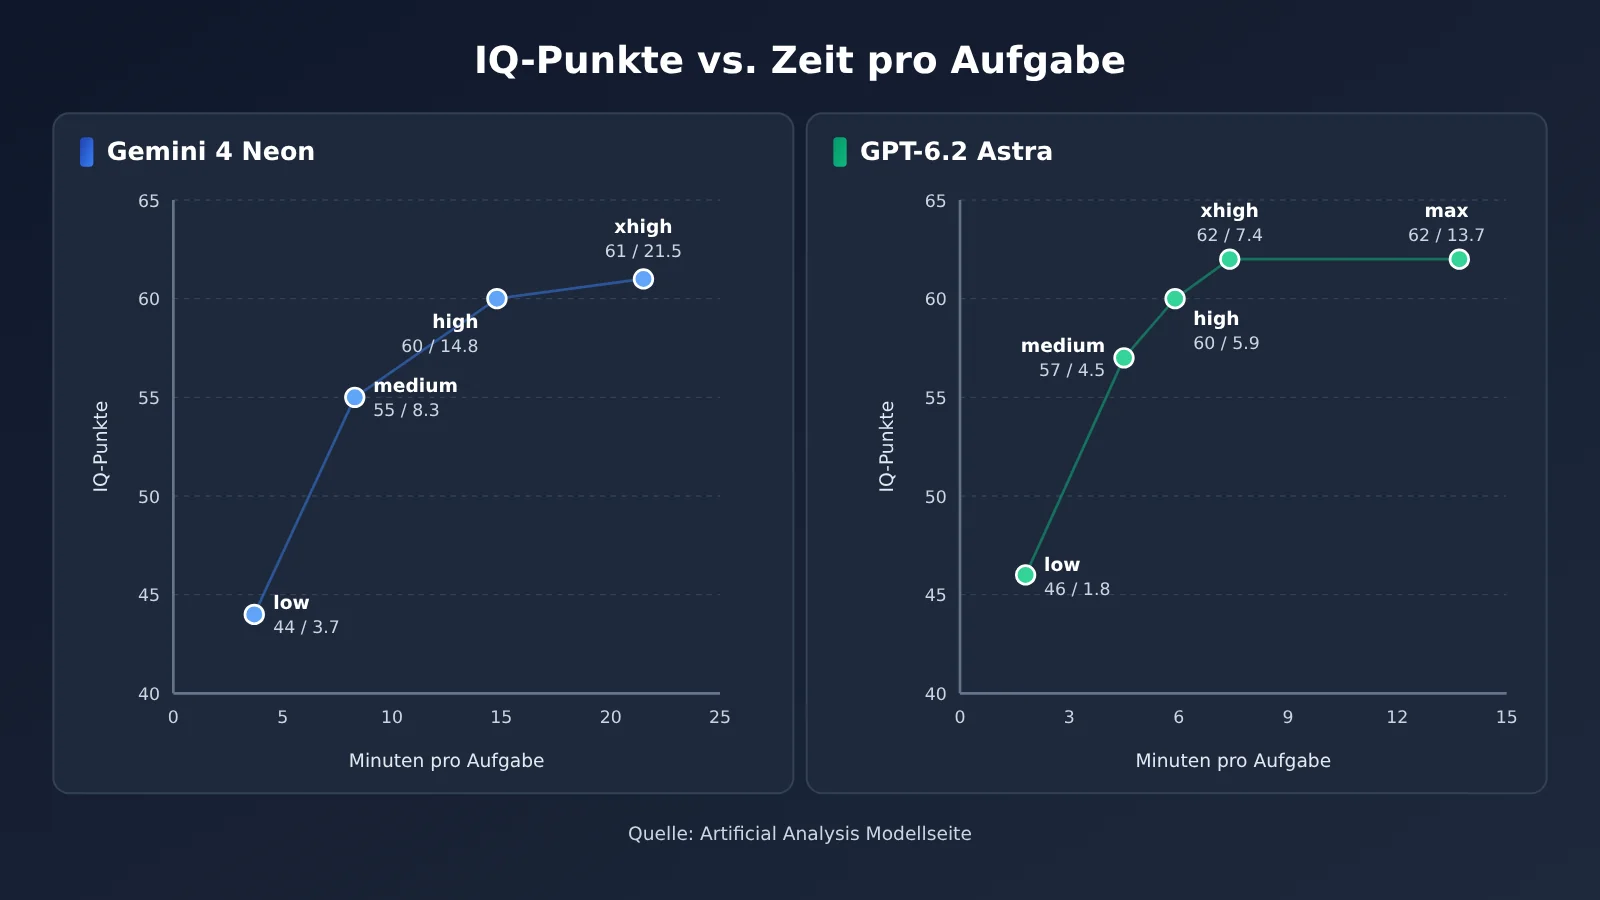
Hinweis zum Vergleich: Die Zahlen im obigen Diagramm und in der obigen Tabelle stammen alle von der Artificial-Analysis-Modellseite. Wer den Token-Verbrauch mit eigenen Aufgaben überprüfen möchte, kann bei APIYI mit demselben API-Schlüssel zwischen den verfügbaren Modellen wechseln und sie vergleichen.
Gemini 4 Neon: offizielle Herstellerangaben, Modellkarte und Abgleich mit Zahlen Dritter
Für Neon gibt es drei Arten von Quellen mit jeweils unterschiedlichem Bezugsrahmen. Der gesamte Abschnitt im Google-Blog ist eine offizielle Herstellerangabe. Dort heißt es, der Artificial Analysis Intelligence Index liege bei xhigh bei 61, der Gesamtrang sei 3, der Vals Index betrage 70.9% und der Arena Agent Arena Index 1336. Die Modellkarte von DeepMind gibt ebenfalls an, dass AA Index v5.0.1 den Wert 61 hat. In den Evaluierungshinweisen wird angemerkt, dass Ergebnisse, die nicht von Gemini stammen, standardmäßig aus den Herstellerangaben der jeweiligen Anbieter übernommen werden und eine offizielle Zusammenstellung sind. Der Artikel und die Modellseite von Artificial Analysis sind Messungen durch Dritte.
| Kennzahl | Offizielle Herstellerangaben (Google-Blog) | Modellkarte | Artikel von Artificial Analysis |
|---|---|---|---|
| Intelligenzindex (xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | nicht aufgeführt | 59 (Antigravity CLI, xhigh) |
| MKA | nicht aufgeführt | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | nicht aufgeführt |
| SWE-sweep | mini-SWE 12.8%, Antigravity 39.0% | Hersteller-Harness 39.0%, mini-SWE 12.8% | nicht aufgeführt |
| Kosten pro Aufgabe (Aussage) | standardmäßig high: 32% niedriger als Carbon | nicht aufgeführt | 6.44 USD, etwa 17% weniger als der nicht rabattierte Carbon-Preis von 7.76 USD |
Abweichende Zahlen bleiben in der Tabelle erhalten: Coding Agent Index – offizielle Herstellerangabe 58.6, Artikel von Artificial Analysis 59; MKA – Modellkarte 56.5%, Artikel von Artificial Analysis 56%. Die Werte 12.8% und 39.0% für SWE-sweep stammen aus zwei unterschiedlichen Harness-Konfigurationen; der Google-Blog führt die Differenz auf den durch das Harness erzielten Zugewinn zurück.
Bei den Kosten gibt es ebenfalls drei unterschiedliche Rechenwege. Googles „32% niedriger“ ist eine eigene Berechnung; im Blog wird nicht angegeben, ob für Carbon der Einführungspreis oder der Standardpreis verwendet wurde. Die im Artikel von Artificial Analysis genannten „etwa 17% weniger“ beruhen auf dem Carbon-Standardpreis 4/20 und ergeben 7.76 USD. Auf der Modellseite von Artificial Analysis wird der Wert von 4.90 USD für Carbon high anhand des aktuell auf der Seite angegebenen Einführungspreises 2/10 berechnet. Diese drei Zahlengruppen gelten jeweils für sich und lassen sich nicht ineinander umrechnen.
Szenarioempfehlungen: Nach welcher Abrechnung man Gemini 4 Neon oder GPT-6.2 Astra bewerten sollte
Wann Sie zuerst auf die Zahlen von GPT-6.2 Astra schauen
- Budget pro Einzelaufgabe: Wenn Sie planen, was „eine Aufgabe kostet“, lohnt zuerst ein Blick auf die Kosten pro Aufgabe auf der Modellseite von Artificial Analysis: Astra (max) liegt bei 4,00 USD.
- Gesamtdauer im Blick: Astra xhigh braucht 7,4 Minuten und erreicht einen Intelligenzscore von 62; die max-Stufe braucht 13,7 Minuten. Bei gleichem Score unterscheiden sich die beiden Stufen deutlich in der Laufzeit – bewerten Sie die Stufen bei der Auswahl getrennt.
- Batch-Aufgaben mit kurzer Ausgabe: Astra kommt im Index auf 65,8 Mio. Token Ausgabe; der Ausgabeanteil macht in seiner Abrechnung einen eher kleinen Teil aus.
Wann Sie zuerst auf die Zahlen von Gemini 4 Neon schauen
- Interaktive Oberfläche und Wartezeit auf das erste Token: Bei Neon (xhigh) vergehen bis zum ersten Antwort-Token 56,51 Sekunden; für die low-Stufe nennt das FAQ 13,93 Sekunden.
- Multimodale Eingabe: Die Modellkarte von DeepMind gibt als Eingabe Text, Bilder, Audio und Video an; das gemeinsame Kontextfenster umfasst bis zu 1 Mio. Token, Wissensstand: März 2026.
- Orchestrierung plus Unteraufgaben: Der Google-Entwicklerleitfaden erwähnt, dass man
gemini-4-neonals Orchestrierungsmodell nutzen undprevious_interaction_idangemini-4-hydrogenfür schnellere Unteraufgaben übergeben kann. - Abrechnung nach Token-Preisen: Auf der Preisliste von Google AI Studio steht für Neon: Eingabe 3,00, Cache 0,15, Ausgabe 15,00 USD pro Million Token; die Ausgabe enthält Denk-Token, eine kostenlose Stufe gibt es nicht.
Modellbezeichnungen und Preise für Gemini 4 Neon und GPT-6.2 Astra bei APIYI prüfen
Die Übersichtstabelle von APIYI trägt den Stand 2026-11-16 09:39 (UTC+8); am 2026-11-19 wurde zusätzlich die Preis-API geprüft (Version shell-api-modelmak-v1, insgesamt 285 Modelle), die sich in der Modellliste auf apiyi.com Punkt für Punkt vergleichen lässt. In der Preis-API entspricht model_ratio 1 einem Eingabepreis von 2 US-Dollar pro Million Token, und completion_ratio 5 bedeutet, dass die Ausgabe das Fünffache der Eingabe kostet – identisch mit der ersten Staffel der Übersichtstabelle.
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe | Endpunkt | Hinweis |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | bei mehr als 272000 Token Eingabe 16; die Preis-API nennt für die höhere Staffel eine Ausgabe von etwa 60, die Übersichtstabelle führt diese Ausgabestaffel nicht auf |
gpt-6.2-sol |
2 | 0.1 | 10 | responses (empfohlen), chat | bei mehr als 272000 Token Eingabe 3; die Preis-API nennt für die höhere Staffel eine Ausgabe von etwa 11.25 |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | entspricht dem Einführungspreis von Google bis 2026-11-30 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | Gruppen Default, SVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat, messages | zusätzlich gibt es eine -thinking-Version |
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | zusätzlich gibt es eine -thinking-Version |
gemini-4-neon |
— | — | — | — | weder in der Übersichtstabelle noch in der Preis-API enthalten |
Alle Einheiten sind US-Dollar pro Million Token. Die Werte 2/0.1/10 für gemini-4-carbon sind der aktuell im Shop gelistete Preis von APIYI und decken sich mit dem Einführungspreis von Google; getrennt davon zu betrachten ist Googles späterer Standardpreis von 4/20. Die Schreibweise der Gruppennamen weicht an den beiden Stellen leicht voneinander ab, zum Beispiel steht in der Übersichtstabelle Default, SVIP, in der Preis-API dagegen default, svip; für die Claude-Serie nennt die Übersichtstabelle Claude_Reverse, Claude_Enterprise, die Preis-API hingegen ClaudeCodeReverse, ClaudeOfficial. Maßgeblich ist in beiden Fällen die Anzeige auf der Plattform.
Der offizielle Listenpreis von Gemini 4 Neon stammt aus der Preisseite von Google AI Studio: Eingabe 3,00, Cache 0,15, Ausgabe 15,00 US-Dollar pro Million Token, und es wird ausschließlich implizites Caching unterstützt. gemini-4-neon ist weder in der APIYI-Übersichtstabelle noch in der Preis-API enthalten, es gibt auch keine eigene Modellseite – das Modell ist derzeit noch nicht verfügbar, wir werden es so schnell wie möglich anbieten. Maßgeblich für Modellbezeichnungen und Preise ist die Modellliste der Plattform.
Schnellstart: GPT-6.2 Astra über APIYI aufrufen
gpt-6.2-astra nutzt den OpenAI-kompatiblen responses-Endpunkt. Mit den folgenden vier Schritten ist das Modell schnell einsatzbereit:
- Registrieren Sie sich bei apiyi.com und erstellen Sie einen API-Schlüssel. Hinterlegen Sie ihn in der Umgebungsvariable
APIYI_API_KEYund lesen Sie ihn im Code ausschließlich aus dieser Variable – speichern Sie den Schlüssel nicht im Klartext. - Initialisieren Sie den Client mit dem OpenAI SDK:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). - Rufen Sie den responses-Endpunkt auf:
resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别"), und lesen Sie anschließendresp.output_textaus. - Prüfen Sie die Abrechnung: In der ersten Stufe der APIYI-Übersichtstabelle kostet die Eingabe 8, das Lesen aus dem Cache 0.4 und die Ausgabe 40 USD pro Million Token; überschreitet eine einzelne Eingabe 272000 Token, steigt die Eingabe auf 16, die
CompletionRatioder Preis-API beträgt in dieser Stufe 3.75, die Ausgabe liegt bei etwa 60 USD pro Million Token – der Fließtext der Übersichtstabelle nennt die Ausgabe für diese Stufe nicht.
Bei Aufgaben mit langem Kontext sollten Sie Schritt 4 besonders beachten. Sobald 272000 Token überschritten werden, springen Eingabe und Ausgabe gleichzeitig in eine höhere Preisstufe; die Kosten pro Aufgabe weichen dann deutlich von der Schätzung der ersten Stufe ab. Erfassen Sie daher am besten zuerst die Token-Zahlen typischer Anfragen, bevor Sie das Budget festlegen.
Für die bereits verfügbaren Gemini-Modelle gibt es zwei Anbindungswege: gemini-4-carbon und gemini-4-hydrogen können über dieselbe OpenAI-kompatible Adresse den chat-Endpunkt ansprechen oder alternativ die native Gemini-Adresse https://api.apiyi.com mit der API-Version v1beta nutzen. Die Parameterregeln für Neon können Sie zunächst im Google-Entwicklerleitfaden nachlesen: Für die Denkstufe gibt es nur low, medium, high, xhigh, Standard ist high; wird thinking_budget oder MINIMAL übergeben, gibt die API HTTP 400 zurück; explizites Kontext-Caching wird nicht unterstützt, gemeinsame Präfixe ab 4096 Token werden automatisch über implizites Caching verarbeitet; die Standardausgabe pro Segment beträgt maximal 65536 Token.
🚀 Schnellstart: Am besten holen Sie sich zuerst bei APIYI auf apiyi.com das kostenlose Testguthaben für neue Benutzer, rufen mit demselben API-Schlüssel nacheinander
gpt-6.2-astra,gpt-6.2-solundgemini-4-carbonauf, notieren die jeweiligen Token-Zahlen für Ein- und Ausgabe und setzen sie anschließend in die obige Preistabelle ein, um die Kosten pro Aufgabe zu berechnen.
Entscheidungsempfehlung: Gemini 4 Neon vs. GPT-6.2 Astra
| Worauf es Ihnen ankommt | Welche Spalte zuerst | Gemini 4 Neon (xhigh) | GPT-6.2 Astra | Quelle |
|---|---|---|---|---|
| Intelligenzwert | Intelligenzwert | 61 | max 62, xhigh 62 | Artificial Analysis – Modellseite |
| Wie lange eine Aufgabe dauert | Zeit pro Aufgabe | 21,5 Minuten | max 13,7 Minuten, xhigh 7,4 Minuten | Artificial Analysis – Modellseite |
| Wie lange es bis zum ersten Token dauert | Erstes Antwort-Token | 56,51 Sekunden | max 197,65 Sekunden | Artificial Analysis – Modellseite |
| Preis pro Million Token | Stückpreis | 3 / 15 | 8 / 40 | Artificial Analysis – Modellseite, APIYI-Übersichtstabelle |
| Was ein Lauf des Index kostet | Kosten pro Aufgabe | 6,44 US-Dollar | max 4,00 US-Dollar | Artificial Analysis – Modellseite |
| Wie lange Eingaben abgerechnet werden | Preisstaffel | In den Referenzdaten ist keine Staffel angegeben | Über 272000 Token Eingabe: 16, Ausgabe ca. 60 | APIYI-Übersichtstabelle, Preis-API |
Prüfen Sie bei der Entscheidung zuerst, welche Zeile für Ihr Geschäft am wichtigsten ist, und sehen Sie sich dann die Zahlen und Quellen dieser Zeile an. Beim Intelligenzwert beträgt der Unterschied nur 1 Punkt; bei Dauer, erstem Token, Stückpreis und Kosten pro Aufgabe fallen die Abstände in unterschiedliche Richtungen aus. Keine Zeile kann die anderen Zeilen ersetzen.
💡 Auswahlempfehlung: Benchmarks und Ihre echten Aufgaben unterscheiden sich in der Token-Struktur oft deutlich. Wir empfehlen, Ihre eigenen Beispiele auf apiyi.com einmal gegen die bereits verfügbaren Modelle laufen zu lassen, Token-Verbrauch und Laufzeit zu protokollieren und erst danach Stufe und Modell festzulegen.
Häufig gestellte Fragen zu Gemini 4 Neon und GPT-6.2 Astra
Q1: Was ist Gemini 4 Neon?
Gemini 4 Neon ist ein Modell, das Google am 18. November 2026 veröffentlicht hat, mit der Modell-ID `gemini-4-neon`. In der Modellkarte von DeepMind steht, dass es von Gemini 4 Carbon abgeleitet wurde und in der Familie zwischen Hydrogen (schnelle Ausführung im Alltag) und Carbon (komplexe Langstreckenaufgaben) angesiedelt ist, mit einem einheitlichen Kontextfenster von 1048576 Token.
Q2: Wie groß ist der Intelligenzunterschied zwischen Gemini 4 Neon und GPT-6.2 Astra?
Auf der Modellseite von Artificial Analysis steht Neon (xhigh) bei 61, Astra (max) bei 62, Astra (xhigh) ebenfalls bei 62. Astra erzielt in beiden Stufen denselben Wert, die Laufzeiten betragen 13,7 Minuten bzw. 7,4 Minuten. Beim Zitieren muss die Stufe mit angegeben werden.
Q3: Wann ist Gemini 4 Neon verfügbar?
Sundar Pichai hat am Veröffentlichungstag festgehalten, dass Neon ab dem 18. November 2026 in der Gemini API von Google AI Studio, in Gemini for Business, in Google Antigravity für die kostenpflichtigen Tarife Google AI Pro und Ultra sowie in der Gemini App für Pro und Ultra verfügbar ist. Auf der Preisseite von Google AI Studio steht, dass es keine kostenlose Stufe gibt.
Q4: GPT-6.2 Astra hat einen höheren Stückpreis – warum liegen die Kosten pro Aufgabe trotzdem bei 4,00 US-Dollar?
Die Kosten pro Aufgabe ergeben sich aus Stückpreis und Verbrauch. Auf der Modellseite von Artificial Analysis ist festgehalten, dass Astra (max) beim Indexlauf 65,8 Millionen Token ausgibt, Neon (xhigh) dagegen 283 Millionen Token. Zwar liegt der Ausgabepreis von Astra bei 40 gegenüber 15, doch der Verbrauch ist deutlich geringer – deshalb kostet eine Aufgabe bei Astra 4,00 US-Dollar und bei Neon 6,44 US-Dollar.
Q5: Wie ruft man GPT-6.2 Astra schnell über die API auf?
1. Bei APIYI apiyi.com registrieren und API-Schlüssel sowie kostenloses Testkontingent erhalten;
2. In der OpenAI-SDK die base_url auf die OpenAI-kompatible Adresse aus dem Schnellstart oben setzen;
3. Den Endpunkt `responses` verwenden und als Modell `gpt-6.2-astra` eintragen.
`gemini-4-neon` ist derzeit weder in der Übersichtstabelle noch in der Preis-API von APIYI enthalten. Sobald es verfügbar ist, gilt die Modellliste der Plattform.
Q6: Welche Einschränkungen gibt es beim Zitieren dieser Zahlen?
– **Messgrundlage**: Offizielle Eigenangaben, Modellkarte sowie Artikel und Modellseite von Artificial Analysis sind unterschiedliche Quellen. Der Coding Agent Index hat die zwei Werte 58,6 und 59, MKA die zwei Werte 56,5 % und 56 %.
– **Kosten**: Googles „32 % niedriger“, die „rund 17 % weniger“ aus dem Artificial Analysis-Artikel und die 4,90 US-Dollar für Carbon auf der Modellseite sind drei separate Rechnungen, die sich nicht zusammenfassen lassen.
– **Übertragbarkeit**: Die Kosten pro Aufgabe im Index stammen aus einem festen Fragensatz. Wenn die Token-Struktur Ihrer Aufgabe anders ist, fallen auch die Ergebnisse anders aus.
Gemini 4 Neon und GPT-6.2 Astra: Die wichtigsten Punkte (Key Takeaways)
- Intelligenzwert: Auf der Modellseite von Artificial Analysis erreicht Astra (max) 62, Astra (xhigh) 62 und Neon (xhigh) 61.
- Laufzeit: Neon (xhigh) 21,5 Minuten, Astra max 13,7 Minuten, xhigh 7,4 Minuten – die Stufen müssen getrennt zitiert werden.
- Stückpreis: Astra 8/40, Neon 3/15 US-Dollar pro Million Token; der Neon-Preis stammt von der Preisseite von Google AI Studio.
- Kosten pro Aufgabe: Astra (max) 4,00 US-Dollar, Neon (xhigh) 6,44 US-Dollar – der Unterschied kommt vom Verbrauch an Ausgabe-Token.
- Geschwindigkeit und erstes Token: Neon 110 Token/Sekunde, erstes Token nach 56,51 Sekunden; Astra 50 Token/Sekunde, erstes Token nach 197,65 Sekunden.
- APIYI-Regal:
gpt-6.2-astraerste Stufe 8/0.4/40, ab 272000 Token Eingabe 16, Ausgabe laut Preisschnittstelle etwa 60;gemini-4-neonist derzeit noch nicht gelistet.
Gemini 4 Neon und GPT-6.2 Astra: Vergleichszusammenfassung
Beim Vergleich von Gemini 4 Neon und GPT-6.2 Astra kommt es vor allem darauf an, die Rechnungen getrennt zu führen:
- Intelligenz-Rechnung: 61 gegen 62 – bei Astra sind xhigh und max beide 62; Quelle ist die Modellseite von Artificial Analysis.
- Zeit-Rechnung: 21,5 Minuten gegen 13,7 Minuten (Astra xhigh liegt bei 7,4 Minuten); Ausgabegeschwindigkeit und Zeit bis zum ersten Token sind wieder eine andere Zahlenreihe.
- Preis-Rechnung: Stückpreis 3/15 gegen 8/40, Kosten pro Aufgabe 6,44 gegen 4,00 US-Dollar – dazwischen liegen 283 Millionen gegenüber 65,8 Millionen Ausgabe-Token.
Bei der Auswahl sollten Sie zuerst festlegen, nach welcher Rechnung Sie abrechnen, und dann den Token-Verbrauch mit eigenen Stichproben überprüfen. Empfehlenswert ist, über APIYI apiyi.com mit einem einzigen Key Vergleichstests für bereits gelistete Modelle durchzuführen; sobald gemini-4-neon gelistet ist, lässt es sich direkt in denselben Ablauf einbinden.
📚 Referenzen
-
Sundar Pichais Ankündigungspost: Veröffentlichung von Gemini 4 Neon und die Vertriebskanäle
- Link:
x.com/sundarpichai/status/2123167780988125621 - Hinweis: Veröffentlichungsdatum und Einstiegspunkte
- Link:
-
Google-Blog „Introducing Gemini 4 Neon“: offiziell kommunizierte Benchmarks, Preise und Positionierung
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Hinweis: Coding Agent Index 58.6, 32 % niedrigere Kosten und weitere offizielle Angaben
- Link:
-
DeepMind-Modellkarte zu Gemini 4 Neon: Vergleichstabelle und Modellspezifikationen
- Link:
deepmind.google/models/model-cards/gemini-4-neon/ - Hinweis: Die Vergleichstabelle enthält nur drei Spalten – Neon, Claude Opus 5.5 und GPT-6.2 Sol
- Link:
-
Google Cloud Entwicklerhandbuch: Parameter und Caching-Regeln für
gemini-4-neon- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Hinweis: Thinking-Stufen, Bedingungen für
HTTP 400, implizites Caching
- Link:
-
Google AI Studio Preisseite: offizielle Listenpreise der Gemini-4-Familie
- Link:
aistudio.google.com/docs/pricing - Hinweis: Neon 3/0.15/15, Carbon-Einführungspreis bis 2026-11-30
- Link:
-
Artificial-Analysis-Artikel: Intelligenzwert und Kostenanalyse von Neon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Hinweis: Messung durch Dritte, inklusive der Angabe, dass der Carbon-Standardpreis rund 17 % niedriger liegt
- Link:
-
Artificial-Analysis-Modellseiten: Gemini 4 Neon und GPT-6.2 Astra
- Link:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-astra - Hinweis: Hauptdatenquelle für die drei Kostenrechnungen in diesem Artikel, abgerufen am 2026-11-19
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Für Modellbezeichnungen und Preise gelten die Modellliste und das Dokumentationszentrum der Plattform.