Note de l’auteur : cet article détaille, selon les étiquettes de source, les trois séries de chiffres de Gemini 4 Neon et GPT-6.2 Astra — score d’intelligence, temps par tâche, prix unitaire et coût par tâche — et liste les prix affichés, les paliers tarifaires et les adresses d’appel des modèles déjà disponibles sur APIYI.
Le 18 novembre 2026, Google a publié Gemini 4 Neon. Sundar Pichai a annoncé ce jour-là son déploiement dans la Gemini API de Google AI Studio, Gemini for business, Google Antigravity et Gemini App. Le même jour, un article d’Artificial Analysis a classé Neon xhigh à la 3e place de l’indice global d’intelligence, derrière GPT-6.2 Astra (max) et Claude Fable 5.2 (max). Quand on compare Neon et Astra, les deux notions les plus faciles à confondre sont le prix unitaire et le coût par tâche : le premier est le prix affiché par million de tokens, le second l’argent réellement dépensé pour venir à bout d’une tâche.
Les trois tableaux ci-dessous sont tous issus de la page de modèle d’Artificial Analysis (consultée le 19/11/2026, indice v5.0.1). Les niveaux sont indiqués entre parenthèses et présentés séparément :
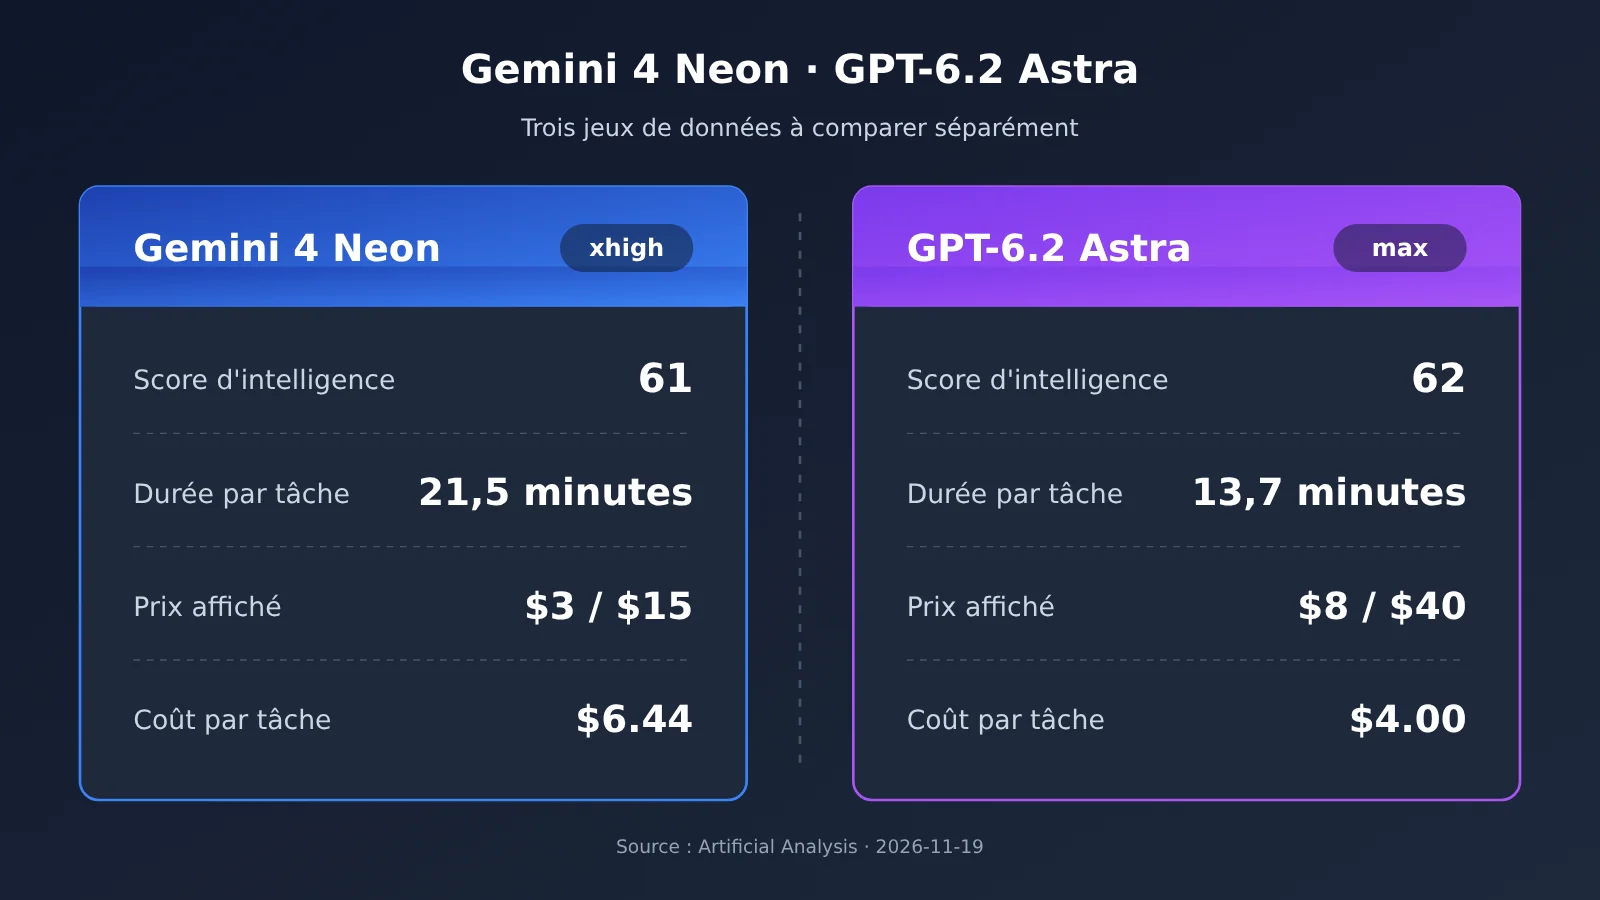
- Score d’intelligence : GPT-6.2 Astra (max) 62, Gemini 4 Neon (xhigh) 61. Le niveau xhigh d’Astra est lui aussi à 62.
- Temps par tâche : Astra (max) 13,7 minutes, Astra (xhigh) 7,4 minutes, Neon (xhigh) 21,5 minutes.
- Prix unitaire et coût par tâche : Astra affiche 8 dollars en entrée et 40 dollars en sortie par million de tokens, Neon 3/15 ; le coût par tâche est de 4,00 dollars pour Astra (max) et de 6,44 dollars pour Neon (xhigh).
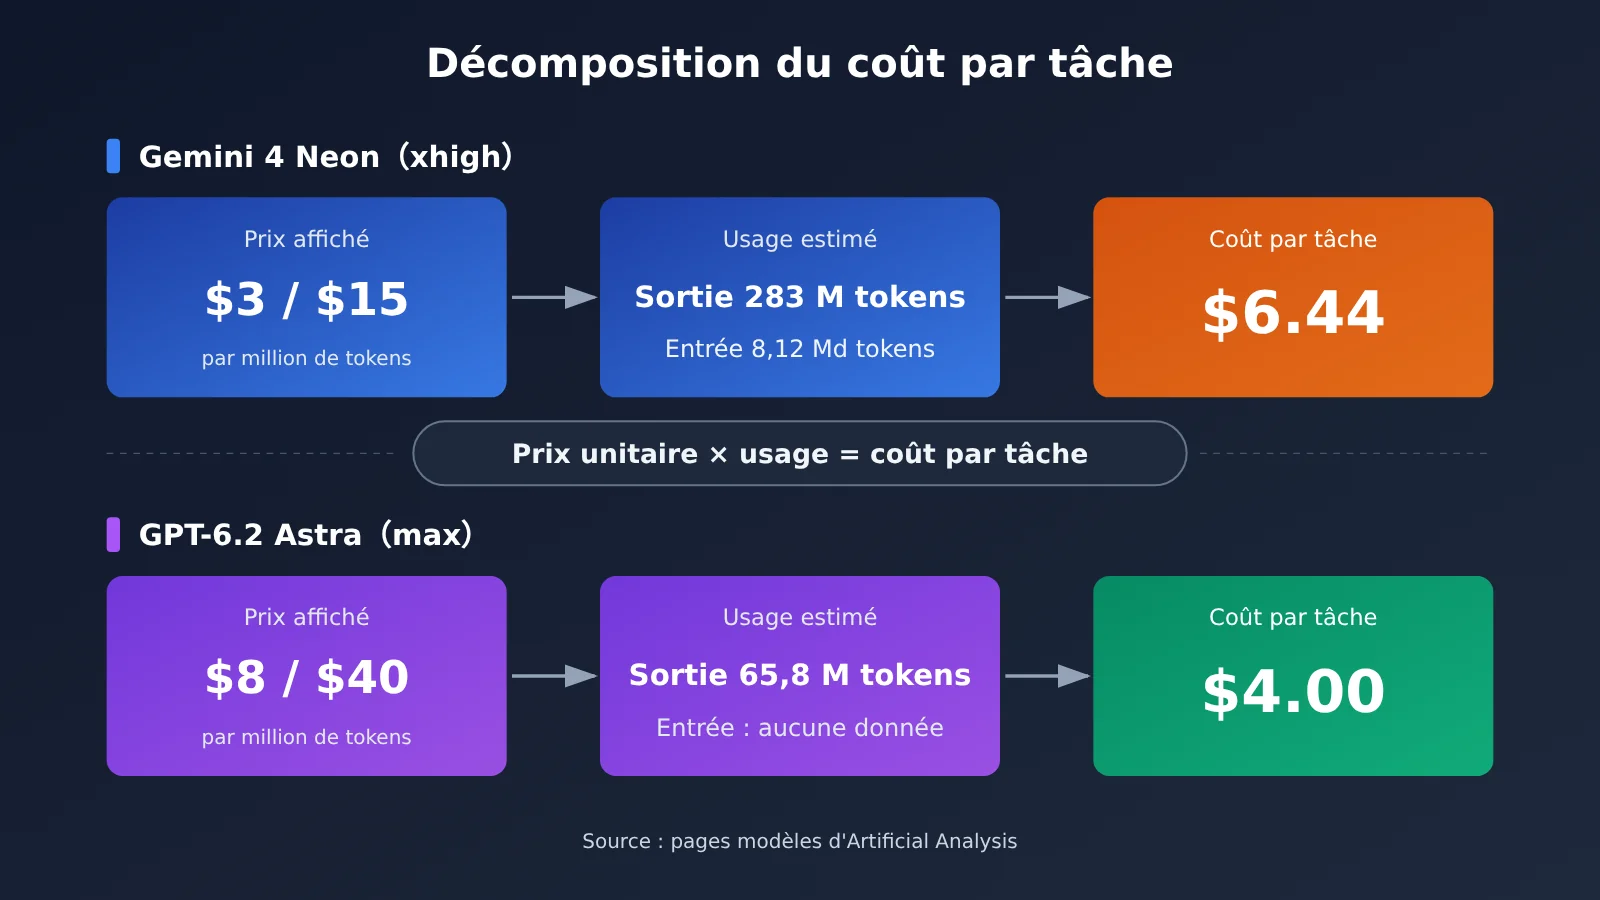
Ce qui explique que le prix unitaire et le coût par tâche évoluent en sens inverse, c’est le volume de tokens. Sur le même indice, Astra (max) produit 65,8 millions de tokens en sortie, contre 283 millions pour Neon (xhigh) ; côté vitesse, Neon génère environ 110 tokens par seconde et son premier token de réponse arrive à 56,51 secondes, tandis qu’Astra tourne à 50 tokens par seconde, avec un premier token de réponse à 197,65 secondes. Cet article se contente de ranger ces chiffres en colonnes : le tableau qui compte le plus pour vous dépend de la structure de vos tâches.
À retenir : à la fin de cet article, vous saurez distinguer, pour Gemini 4 Neon et GPT-6.2 Astra, à quel tableau et à quel niveau appartient chaque chiffre, et quels modèles peuvent être appelés directement sur APIYI, ainsi que les endroits où le prix change de palier.
Différences clés entre Gemini 4 Neon et GPT-6.2 Astra
Le tableau ci-dessous provient intégralement de la page du modèle sur Artificial Analysis. Pour Neon on utilise xhigh, pour Astra on utilise max — ce sont les niveaux les plus élevés affichés sur chacune des deux pages. Le tableau comparatif de la fiche modèle DeepMind ne comporte que trois colonnes, Gemini 4 Neon, Claude Opus 5.5 et GPT-6.2 Sol, sans Astra ; la colonne Astra s’appuie donc uniquement sur les chiffres de la page du modèle Artificial Analysis.
| Dimension | Gemini 4 Neon (xhigh) | GPT-6.2 Astra (max) | Source |
|---|---|---|---|
| Score d’intelligence | 61 | 62 (xhigh aussi à 62) | Page du modèle Artificial Analysis |
| Temps par tâche | 21.5 minutes | 13.7 minutes (7.4 minutes en xhigh) | Page du modèle Artificial Analysis |
| Prix catalogue (entrée/sortie, USD par million de tokens) | 3.00 / 15.00 | 8.00 / 40.00 | Page du modèle Artificial Analysis |
| Coût par tâche | 6.44 USD | 4.00 USD | Page du modèle Artificial Analysis |
| Tokens de sortie de l’indice | 283 millions | 65,8 millions | Page du modèle Artificial Analysis |
| Vitesse de sortie | 110 tokens/seconde | 50 tokens/seconde | Page du modèle Artificial Analysis |
| Premier token de réponse | 56.51 secondes | 197.65 secondes | Page du modèle Artificial Analysis |
| Remise de cache / prix mixte | 95 % / 2.21 | 95 % / 5.88 | Page du modèle Artificial Analysis |
La lecture ligne par ligne est la plus sûre. Les trois groupes — score d’intelligence, durée, prix — sont indépendants les uns des autres : voir apparaître dans une même colonne « score élevé », « temps court » et « prix unitaire élevé » n’a rien de contradictoire.
Pourquoi GPT-6.2 Astra coûte plus cher au token mais moins cher par tâche
Le coût par tâche peut se résumer grossièrement à « nombre de tokens consommés × prix par token ». Astra affiche un prix de sortie de 40 dollars par million de tokens, soit plus du double des 15 dollars de Neon. Mais la quantité de tokens de sortie enregistrée pour l’indice sur la page modèle d’Artificial Analysis est de 65,8 millions pour Astra, soit moins du quart des 283 millions de Neon. La consommation pèse donc davantage dans la balance : le modèle au prix unitaire plus élevé revient à 4,00 dollars par tâche, tandis que Neon reste à 6,44 dollars.
Il faut préciser un point pour l’entrée. La page modèle de Neon indique 8,12 milliards de tokens d’entrée pour l’indice ; les références ne donnent pas le nombre de tokens d’entrée d’Astra. On ne décompose donc ici que le côté sortie, sans reconstituer la facture complète. Les prix mixtes — 2,21 pour Neon et 5,88 pour Astra — ne reflètent eux aussi que les prix catalogue. Pour estimer votre propre facture, il faudra encore tenir compte de la répartition de vos tokens.
Dans un cas métier concret, la structure des tokens change. Pour une tâche avec une entrée très longue et une sortie très courte, le poids du prix d’entrée (8 contre 3) prend plus d’importance ; pour une tâche avec une sortie très longue, c’est le volume de sortie qui dominera le résultat. Le coût par tâche affiché sur l’indice provient d’un ensemble fixe de questions : avant de le transposer à votre situation, mieux vaut lancer un test avec vos propres échantillons.
Le bilan temporel de Gemini 4 Neon : distinguer la vitesse d’émission de la vitesse de finition
Sur sa page modèle, Neon produit environ 110 tokens par seconde, soit plus du double des 50 tokens/seconde d’Astra, et son premier token de réponse ne demande que 56.51 secondes, contre 197.65 secondes pour Astra. Pourtant, le temps par tâche est de 21.5 minutes pour Neon (xhigh), contre 13.7 minutes pour Astra (max) et 7.4 minutes en xhigh. L’explication revient une fois de plus au volume de tokens : un modèle qui produit davantage, aussi rapide soit-il à la seconde, mettra de toute façon plus longtemps à terminer.
Chez Astra, les niveaux xhigh et max obtiennent tous deux un score d’intelligence de 62, mais l’un prend 7.4 minutes et l’autre 13.7 minutes : impossible de citer ces chiffres sans préciser le niveau. Côté Neon, la FAQ de la page modèle d’Artificial Analysis donne en plus le temps jusqu’au premier token de réponse pour les niveaux inférieurs : 40.64 secondes en high, 20.14 secondes en medium et 13.93 secondes en low. Ces valeurs proviennent de la FAQ et ne se trouvent pas dans la même colonne que le tableau récapitulatif.
Données par niveau : Gemini 4 Neon et GPT-6.2 Astra
| Modèle | Niveau | Score d’intelligence | Temps par tâche | Vitesse d’émission |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21.5 minutes | 110 tokens/s |
| Gemini 4 Neon | high (par défaut) | 60 | 14.8 minutes | 101 tokens/s |
| Gemini 4 Neon | medium | 55 | 8.3 minutes | 101 tokens/s |
| Gemini 4 Neon | low | 44 | 3.7 minutes | 97 tokens/s |
| GPT-6.2 Astra | max | 62 | 13.7 minutes | 50 tokens/s |
| GPT-6.2 Astra | xhigh | 62 | 7.4 minutes | 50 tokens/s |
| GPT-6.2 Astra | high | 60 | 5.9 minutes | 50 tokens/s |
| GPT-6.2 Astra | medium | 57 | 4.5 minutes | 49 tokens/s |
| GPT-6.2 Astra | low | 46 | 1.8 minutes | 48 tokens/s |
Toutes les données proviennent de la page modèle d’Artificial Analysis. Le niveau high de Neon est celui que le guide développeur de Google désigne explicitement comme valeur par défaut. Neon n’a pas de niveau max. Chez Astra, la vitesse d’émission reste stable entre 48 et 50 tokens/seconde quel que soit le niveau : les écarts de temps viennent essentiellement du nombre de tokens produits par chaque niveau. La page modèle ne fournit le coût par tâche que pour le niveau le plus élevé ; les coûts des autres niveaux ne sont pas recalculés ici.
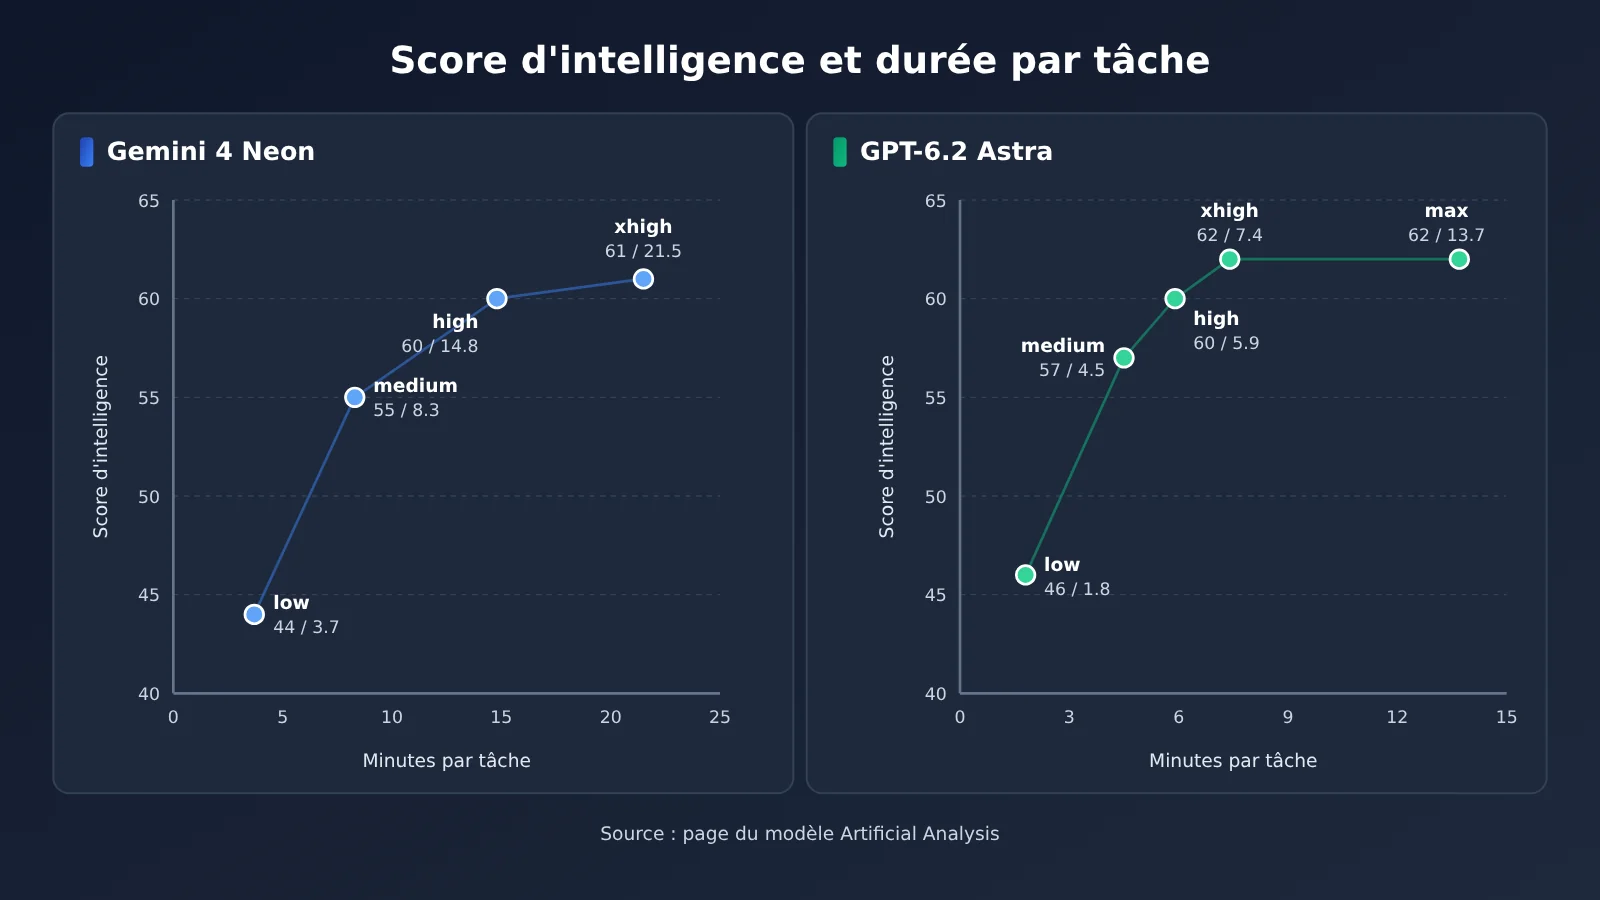
Note de comparaison : les chiffres du graphique et du tableau ci-dessus proviennent tous de la page modèle d’Artificial Analysis. Pour vérifier la consommation de tokens avec vos propres tâches, vous pouvez passer par APIYI, utiliser la même clé et basculer entre les modèles disponibles pour comparer.
Chiffres auto-déclarés de Gemini 4 Neon, fiche de modèle et comparaison avec les mesures de tierces parties
Côté Neon, on dispose de trois catégories de sources, qui ne reposent pas sur le même référentiel. Le billet de blog Google relève entièrement de l’auto-déclaration officielle : on y lit un Artificial Analysis Intelligence Index de 61 en xhigh, une 3e place au classement général, un Vals Index de 70.9% et un Arena Agent Arena Index de 1336. La fiche de modèle DeepMind annonce elle aussi un AA Index v5.0.1 de 61, et ses notes d’évaluation précisent que les résultats concernant des modèles autres que Gemini proviennent par défaut des auto-déclarations de chaque acteur : il s’agit donc d’un agrégat officiel. L’article et la page de modèle d’Artificial Analysis, eux, relèvent de la mesure par un tiers.
| Indicateur | Auto-déclaration officielle (blog Google) | Fiche de modèle | Article Artificial Analysis |
|---|---|---|---|
| Indice d’intelligence (xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | non listé | 59 (Antigravity CLI, xhigh) |
| MKA | non listé | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | non listé |
| SWE-sweep | mini-SWE 12.8%, Antigravity 39.0% | harness du fournisseur 39.0%, mini-SWE 12.8% | non listé |
| Coût par tâche annoncé | 32% de moins que Carbon en high par défaut | non listé | 6,44 dollars, soit environ 17% de moins que les 7,76 dollars de Carbon au prix non remisé |
Les chiffres qui ne concordent pas sont tous conservés dans le tableau : le Coding Agent Index est auto-déclaré à 58.6 par Google et à 59 dans l’article Artificial Analysis ; le MKA est à 56.5% sur la fiche de modèle et à 56% dans l’article Artificial Analysis. Les 12.8% et 39.0% du SWE-sweep proviennent de deux harness différents, et le blog Google attribue l’écart au gain apporté par le harness.
Le référentiel de coût, c’est aussi trois comptabilités distinctes. Le « 32% de moins » de Google vient de son propre algorithme, et le billet ne précise pas si Carbon est facturé au tarif de lancement ou au tarif standard ; le « environ 17% de moins » de l’article Artificial Analysis est calculé sur le prix standard de Carbon, 4/20, ce qui donne 7,76 dollars ; sur la page de modèle d’Artificial Analysis, les 4,90 dollars de Carbon en high sont calculés d’après le tarif de lancement actuellement affiché sur la page, 2/10. Ces trois séries de chiffres sont chacune valables dans leur propre cadre, mais on ne peut pas passer de l’une à l’autre.
Recommandations par scénario : quel budget regarder pour Gemini 4 Neon ou GPT-6.2 Astra
Les cas où commencer par les chiffres de GPT-6.2 Astra
- Budget calculé par tâche : si vous raisonnez en « combien coûte une question », commencez par le coût par tâche de la page du modèle sur Artificial Analysis : Astra (max), c’est 4.00 $.
- Vous vous souciez du temps total d’exécution : le palier xhigh d’Astra, c’est 7.4 minutes pour un score d’intelligence de 62 ; le palier max, 13.7 minutes. À score égal, l’écart de durée entre les deux paliers est net : il faut évaluer chaque palier séparément au moment de choisir.
- Tâches en lot, sorties courtes : sur le benchmark index, Astra génère 65,8 millions de tokens en sortie — le poste « volume de sortie » pèse donc peu dans sa facture.
Les cas où commencer par les chiffres de Gemini 4 Neon
- Interfaces interactives, attentif à l’attente du premier token : Neon (xhigh) produit son premier token de réponse en 56.51 secondes ; le palier low indiqué dans la FAQ est de 13.93 secondes.
- Entrées multimodales : la fiche modèle de DeepMind précise que l’entrée peut être du texte, des images, de l’audio ou de la vidéo, avec une fenêtre unifiée allant jusqu’à 1 million de tokens et des connaissances coupées en mars 2026.
- Orchestration et sous-tâches : le guide développeur de Google mentionne la possibilité d’utiliser
gemini-4-neoncomme modèle d’orchestration, puis de confier leprevious_interaction_idàgemini-4-hydrogenpour des sous-tâches plus rapides. - Calcul au tarif par token : la page de tarifs de Google AI Studio indique pour Neon une entrée à 3.00, un cache à 0.15 et une sortie à 15.00 $ par million de tokens ; la sortie inclut les tokens de réflexion, et il n’existe pas d’offre gratuite.
Consulter les modèles et les tarifs de Gemini 4 Neon et GPT-6.2 Astra sur APIYI
La page du tableau récapitulatif d’APIYI indique une mise à jour au 2026-11-16 09:39 (UTC+8) ; le 2026-11-19, l’API de tarification a de nouveau été vérifiée (version shell-api-modelmak-v1, 285 modèles au total). Il est possible de comparer chaque entrée dans la liste des modèles sur apiyi.com. Dans l’API de tarification, model_ratio 1 correspond à 2 USD par million de tokens en entrée, et completion_ratio 5 signifie que le prix de sortie est 5 fois celui de l’entrée, ce qui correspond au premier palier du tableau récapitulatif.
| ID du modèle | Entrée | Lecture du cache | Sortie | Endpoint | Remarques |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | Au-delà de 272000 tokens en entrée : 16 ; l’API de tarification indique une sortie d’environ 60 pour le palier supérieur, mais le tableau récapitulatif ne mentionne pas ce palier de sortie |
gpt-6.2-sol |
2 | 0.1 | 10 | responses (recommandé), chat | Au-delà de 272000 tokens en entrée : 3 ; l’API de tarification indique une sortie d’environ 11.25 pour le palier supérieur |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | Correspond au tarif de lancement de Google jusqu’au 2026-11-30 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | Groupes Default, SVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat, messages | Une version -thinking est également disponible |
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | Une version -thinking est également disponible |
gemini-4-neon |
— | — | — | — | Absent du tableau récapitulatif et de l’API de tarification |
Les unités sont toutes en USD par million de tokens. Le 2/0.1/10 de gemini-4-carbon est le prix actuellement pratiqué par APIYI ; il correspond au tarif de lancement de Google et doit être considéré séparément du tarif standard que Google appliquera ensuite, à savoir 4/20. Les noms des groupes présentent de légères différences entre les deux emplacements : par exemple, le tableau récapitulatif écrit Default, SVIP, tandis que l’API de tarification écrit default, svip ; pour la série Claude, le tableau récapitulatif écrit Claude_Reverse, Claude_Enterprise, et l’API de tarification écrit ClaudeCodeReverse, ClaudeOfficial. Dans les deux cas, c’est l’affichage de la plateforme qui fait référence.
Le tarif officiel de Gemini 4 Neon provient de la page de tarification de Google AI Studio : entrée 3.00, cache 0.15, sortie 15.00 USD par million de tokens, avec uniquement la mise en cache implicite prise en charge. gemini-4-neon n’apparaît ni dans le tableau récapitulatif d’APIYI ni dans l’API de tarification, et il n’a pas non plus de page de modèle dédiée. Il n’est donc pas encore proposé ; nous le mettrons en ligne dès que possible. Les modèles et les tarifs font foi selon la liste des modèles de la plateforme.
Démarrage rapide : appeler GPT-6.2 Astra via APIYI
gpt-6.2-astra passe par le point de terminaison responses compatible avec OpenAI. Quatre étapes suffisent pour le mettre en route :
- Créez un compte sur apiyi.com et générez une clé API, puis stockez-la dans la variable d’environnement
APIYI_API_KEY. Dans le code, lisez-la uniquement depuis cette variable, sans jamais écrire la clé en clair. - Initialisez le client avec le SDK OpenAI :
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). - Appelez le point de terminaison
responses:resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别"), puis lisezresp.output_text. - Vérifiez la facturation : au premier palier du tableau principal d’APIYI, les tarifs sont de 8 pour l’entrée, 0,4 pour la lecture du cache et 40 pour la sortie, en dollars par million de tokens. Au-delà de 272 000 tokens d’entrée pour une même requête, l’entrée passe à 16, le
CompletionRatiode l’API de tarification pour ce palier est de 3,75, et la sortie coûte environ 60 dollars par million de tokens. Le corps du tableau principal ne donne pas la sortie pour ce palier.
Pour les tâches à long contexte, faites particulièrement attention à l’étape 4. Au-delà de 272 000 tokens, l’entrée et la sortie changent en même temps de palier ; le coût par tâche s’écartera alors nettement de l’estimation du premier palier. Mieux vaut d’abord mesurer le nombre de tokens des requêtes typiques avant de fixer un budget.
Les modèles Gemini déjà disponibles ont deux modes de connexion : gemini-4-carbon et gemini-4-hydrogen peuvent utiliser la même adresse compatible avec OpenAI via le point de terminaison chat, ou l’adresse native Gemini https://api.apiyi.com, avec la version de l’API v1beta. Pour les règles de paramètres de Neon, commencez par consulter le guide développeur de Google : les niveaux de réflexion ne sont que low, medium, high et xhigh, avec high par défaut ; passer thinking_budget ou MINIMAL renvoie HTTP 400 ; le cache de contexte explicite n’est pas pris en charge, et les préfixes partagés d’au moins 4 096 tokens passent automatiquement par le cache implicite ; la sortie par défaut par segment est limitée à 65 536 tokens.
🚀 Démarrage rapide : commencez par récupérer votre crédit d’essai gratuit réservé aux nouveaux utilisateurs sur APIYI (apiyi.com), puis appelez successivement
gpt-6.2-astra,gpt-6.2-soletgemini-4-carbonavec la même clé, notez les nombres de tokens d’entrée et de sortie de chacun, puis appliquez le tableau de prix ci-dessus pour calculer le coût par tâche.
Conseils pour choisir entre Gemini 4 Neon et GPT-6.2 Astra
| Votre question | Colonne à consulter en premier | Gemini 4 Neon (xhigh) | GPT-6.2 Astra | Source |
|---|---|---|---|---|
| Score d’intelligence | Score d’intelligence | 61 | max 62, xhigh 62 | Page modèle d’Artificial Analysis |
| Temps pour traiter une question | Temps par tâche | 21.5 minutes | max 13.7 minutes, xhigh 7.4 minutes | Page modèle d’Artificial Analysis |
| Temps d’attente du premier token | Premier token de réponse | 56.51 secondes | max 197.65 secondes | Page modèle d’Artificial Analysis |
| Prix affiché par million de tokens | Prix unitaire | 3 / 15 | 8 / 40 | Page modèle d’Artificial Analysis, tableau récapitulatif APIYI |
| Combien coûte l’exécution complète de l’indice | Coût par tâche | 6.44 dollars | max 4.00 dollars | Page modèle d’Artificial Analysis |
| Comment sont facturées les entrées longues | Paliers tarifaires | La référence ne liste pas de paliers | Au-delà de 272000 tokens d’entrée : 16 ; sortie : environ 60 | Tableau récapitulatif APIYI, interface de tarification |
Pour décider, commencez par déterminer quelle ligne compte le plus pour votre activité, puis regardez les chiffres et la source de cette ligne. Le score d’intelligence ne diffère que d’un point ; les écarts de durée, de premier token, de prix unitaire et de coût par tâche vont dans des directions différentes, et aucune ligne ne peut remplacer les autres.
💡 Conseil de sélection : le jeu de questions de l’indice et vos tâches réelles ont souvent une structure de tokens différente. Nous vous conseillons de mettre vos propres échantillons sur apiyi.com et de les comparer aux modèles déjà disponibles, puis de noter la consommation de tokens et le temps d’exécution avant de fixer le niveau et le modèle.
Questions fréquentes sur Gemini 4 Neon et GPT-6.2 Astra
Q1 : Qu’est-ce que Gemini 4 Neon ?
Gemini 4 Neon est un modèle publié par Google le 18 novembre 2026, avec l’ID de modèle `gemini-4-neon`. La fiche modèle de DeepMind précise qu’il est dérivé de Gemini 4 Carbon, et qu’il se situe dans la famille entre Hydrogen (exécution rapide du quotidien) et Carbon (longue portée complexe), avec une fenêtre de contexte unifiée de 1048576 tokens.
Q2 : Quel est l’écart de score d’intelligence entre Gemini 4 Neon et GPT-6.2 Astra ?
Sur la page du modèle Artificial Analysis, Neon (xhigh) obtient 61, Astra (max) 62, et Astra (xhigh) également 62. Astra obtient le même score sur les deux niveaux, avec des durées respectives de 13,7 minutes et 7,4 minutes ; il faut donc préciser le niveau lors d’une citation.
Q3 : Quand Gemini 4 Neon sera-t-il disponible ?
Sundar Pichai a indiqué le jour du lancement que Neon serait disponible à partir du 18 novembre 2026 dans l’API Gemini de Google AI Studio, Gemini for business, Google Antigravity pour les abonnés payants Google AI Pro et Ultra, ainsi que dans l’application Gemini pour les offres Pro et Ultra. La page de tarification de Google AI Studio précise qu’il n’existe pas d’offre gratuite.
Q4 : Le prix unitaire de GPT-6.2 Astra est plus élevé, pourquoi le coût par tâche est-il de 4,00 dollars ?
Le coût par tâche dépend à la fois du prix unitaire et du volume d’utilisation. La page du modèle Artificial Analysis indique qu’Astra (max) génère 65,8 millions de tokens en sortie sur l’indice, contre 283 millions pour Neon (xhigh). Même si le prix de sortie d’Astra est de 40 contre 15, son volume d’utilisation est bien plus faible, ce qui donne un coût par tâche de 4,00 dollars pour Astra, contre 6,44 dollars pour Neon.
Q5 : Comment appeler rapidement GPT-6.2 Astra via l’API ?
1. S’inscrire sur APIYI apiyi.com et obtenir une clé API ainsi qu’un quota de test gratuit ;
2. Configurer le base_url du SDK OpenAI sur l’adresse compatible OpenAI indiquée dans la section démarrage rapide ci-dessus ;
3. Passer par l’endpoint responses, avec le modèle `gpt-6.2-astra`.
`gemini-4-neon` n’est actuellement présent ni dans le tableau général ni dans l’interface de tarification d’APIYI ; une fois mis en ligne, il faudra se référer à la liste des modèles de la plateforme.
Q6 : Quelles sont les limites lorsqu’on cite ces chiffres ?
– **Périmètre** : les sources diffèrent entre les données auto-déclarées officielles, les fiches modèles, les articles et pages de modèles d’Artificial Analysis. Le Coding Agent Index présente deux valeurs, 58,6 et 59, et le MKA deux valeurs, 56,5 % et 56 %.
– **Coût** : le « 32 % moins cher » de Google, le « environ 17 % de moins » de l’article Artificial Analysis et les 4,90 dollars de Carbon sur la page du modèle sont trois comptabilités distinctes qui ne peuvent pas être fusionnées.
– **Migration** : le coût par tâche de l’indice provient d’un ensemble fixe de questions ; la structure de tokens de vos tâches étant différente, les résultats le seront aussi.
Gemini 4 Neon vs GPT-6.2 Astra : points clés à retenir
- Score d’intelligence : sur la page modèle d’Artificial Analysis, Astra (max) 62, Astra (xhigh) 62, Neon (xhigh) 61.
- Durée : Neon (xhigh) 21.5 minutes, Astra max 13.7 minutes, xhigh 7.4 minutes — il faut citer chaque palier séparément.
- Prix unitaire : Astra 8/40, Neon 3/15 USD par million de tokens ; le prix de Neon vient de la page de tarification de Google AI Studio.
- Coût par tâche : Astra (max) 4.00 USD, Neon (xhigh) 6.44 USD, la différence venant du volume de tokens de sortie.
- Vitesse et premier token : Neon 110 tokens/seconde, premier token à 56.51 s ; Astra 50 tokens/seconde, premier token à 197.65 s.
- Catalogue APIYI :
gpt-6.2-astrapremier palier 8/0.4/40, au-delà de 272000 tokens d’entrée 16, sortie d’environ 60 via l’interface de tarification ;gemini-4-neonpas encore référencé.
Comparaison Gemini 4 Neon vs GPT-6.2 Astra : synthèse
Pour comparer Gemini 4 Neon et GPT-6.2 Astra, l’essentiel est de tenir des comptes séparés :
- Le compte intelligence : 61 contre 62 ; Astra affiche 62 aussi bien en xhigh qu’en max, source : la page modèle d’Artificial Analysis.
- Le compte durée : 21.5 minutes contre 13.7 minutes (Astra xhigh à 7.4 minutes), tandis que la vitesse de sortie et le temps jusqu’au premier token forment un autre jeu de chiffres.
- Le compte prix : prix unitaire 3/15 contre 8/40, coût par tâche 6.44 contre 4.00 USD, avec entre les deux 283 millions contre 65.8 millions de tokens de sortie.
Au moment de choisir, déterminez d’abord sur quel compte vous réglez, puis vérifiez votre consommation de tokens avec vos propres échantillons. Je recommande de passer par APIYI apiyi.com pour faire des tests comparatifs sur les modèles déjà référencés avec une seule clé API ; une fois gemini-4-neon référencé, vous pourrez l’ajouter directement au même workflow.
📚 Références
-
Publication de Sundar Pichai : annonce et canaux de disponibilité de Gemini 4 Neon
- Lien :
x.com/sundarpichai/status/2123167780988125621 - Détails : date de sortie et point d’accès
- Lien :
-
Blog Google « Introducing Gemini 4 Neon » : benchmarks, prix et positionnement revendiqués par Google
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Détails : Coding Agent Index 58.6, coût inférieur de 32 % et autres chiffres officiels
- Lien :
-
Fiche modèle Gemini 4 Neon de DeepMind : tableau comparatif et spécifications du modèle
- Lien :
deepmind.google/models/model-cards/gemini-4-neon/ - Détails : le tableau comparatif ne contient que trois colonnes : Neon, Claude Opus 5.5 et GPT-6.2 Sol
- Lien :
-
Guide développeur Google Cloud : paramètres et règles de cache de
gemini-4-neon- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Détails : niveaux de réflexion, conditions de
HTTP 400, cache implicite
- Lien :
-
Page de tarification de Google AI Studio : prix officiels de la famille Gemini 4
- Lien :
aistudio.google.com/docs/pricing - Détails : Neon 3/0.15/15 ; prix de lancement de Carbon jusqu’au 2026-11-30
- Lien :
-
Article d’Artificial Analysis : score d’intelligence et analyse de coût de Neon
- Lien :
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Détails : mesure tierce, avec un tarif standard Carbon inférieur d’environ 17 %
- Lien :
-
Pages modèles d’Artificial Analysis : Gemini 4 Neon et GPT-6.2 Astra
- Liens :
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-astra - Détails : principales sources de données pour les trois analyses de coûts de cet article, consultées le 2026-11-19
- Liens :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site officiel APIYI. Pour les modèles et les prix, référez-vous à la liste des modèles et au centre de documentation de la plateforme.