Nota del autor: este artículo desglosa por fuente las tres cuentas de Gemini 4 Neon y GPT-6.2 Astra —puntuación de inteligencia, tiempo por tarea, y precio unitario y coste por tarea—, y enumera los precios de lista, los tramos y las URL de invocación de los modelos ya disponibles en APIYI.
El 18 de noviembre de 2026, Google lanzó Gemini 4 Neon. Ese mismo día, Sundar Pichai anunció que comenzaba a desplegarse en la Gemini API de Google AI Studio, Gemini for business, Google Antigravity y Gemini App. El mismo día, un artículo de Artificial Analysis situó a Neon xhigh en el tercer puesto de la clasificación general del índice de inteligencia; por delante quedaron GPT-6.2 Astra (max) y Claude Fable 5.2 (max). Cuando se comparan Neon y Astra, lo que más se presta a confusión es el precio unitario y el coste por tarea: el primero es el precio de lista por millón de tokens; el segundo, el dinero que se gasta realmente al completar una tarea.
Las tres cuentas siguientes proceden de la página de modelos de Artificial Analysis (consultada el 2026-11-19, índice v5.0.1); el nivel se indica entre paréntesis y cada nivel aparece por separado:
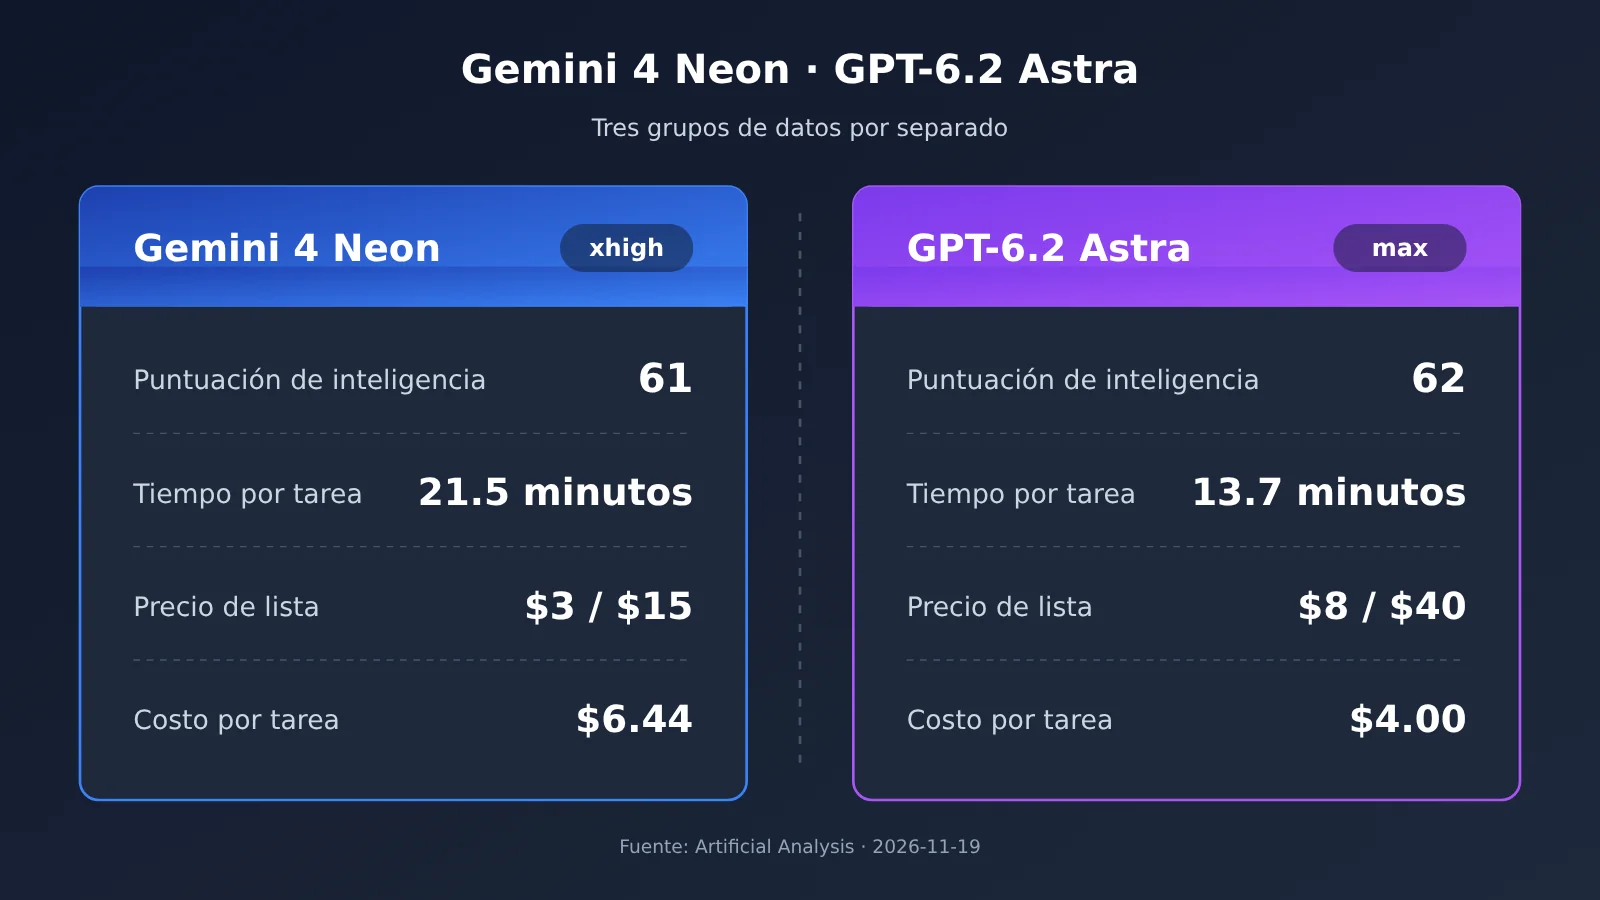
- Puntuación de inteligencia: GPT-6.2 Astra (max) 62, Gemini 4 Neon (xhigh) 61. El nivel xhigh de Astra también obtiene 62.
- Tiempo por tarea: Astra (max) 13,7 minutos, Astra (xhigh) 7,4 minutos, Neon (xhigh) 21,5 minutos.
- Precio unitario y coste por tarea: el precio de lista de Astra es de 8 dólares por millón de tokens de entrada y 40 dólares por millón de salida; el de Neon, 3/15. El coste por tarea es de 4,00 dólares para Astra (max) y 6,44 dólares para Neon (xhigh).
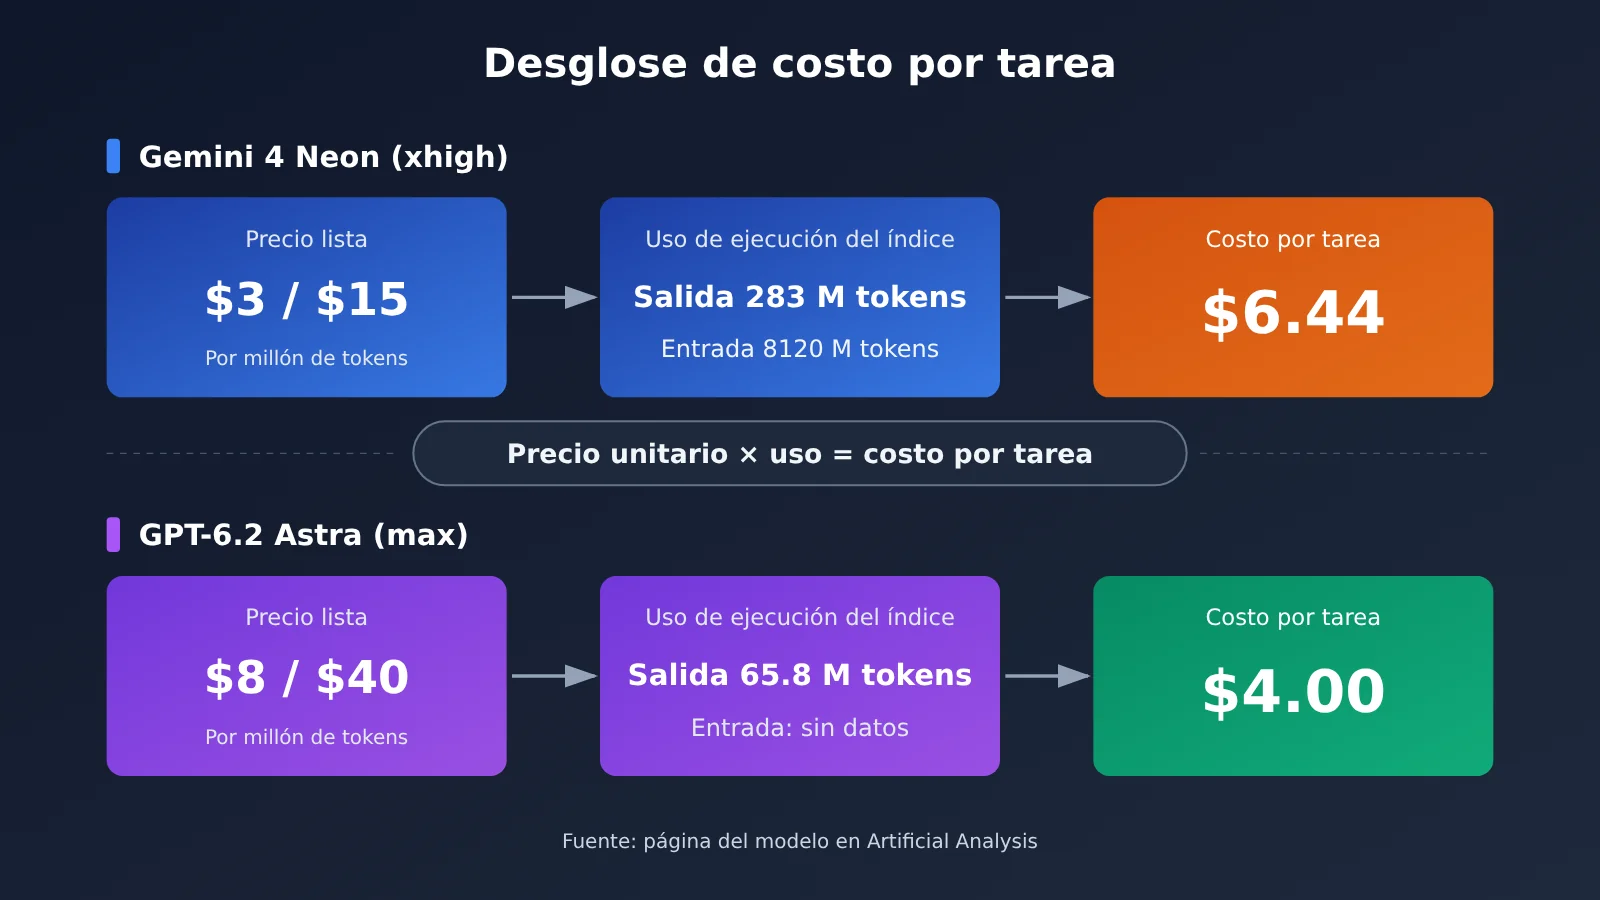
Lo que hace que el precio unitario y el coste por tarea vayan en direcciones opuestas es el consumo de tokens. Al ejecutar el mismo conjunto de pruebas del índice, Astra (max) genera 65,8 millones de tokens de salida y Neon (xhigh) genera 283 millones. En cuanto a velocidad, Neon produce unos 110 tokens por segundo, con 56,51 segundos hasta el primer token de respuesta; Astra produce 50 tokens por segundo, con 197,65 segundos hasta el primer token de respuesta. Este artículo se limita a presentar estas cifras ordenadas por columnas; qué cuenta te importa más dependerá de la estructura de tus tareas.
Valor clave: después de leer este artículo, podrás distinguir de qué cuenta y de qué nivel procede cada cifra de Gemini 4 Neon y GPT-6.2 Astra, y sabrás qué modelos de APIYI se pueden invocar directamente y en qué punto cambian los tramos de precios.
Diferencias clave entre Gemini 4 Neon y GPT-6.2 Astra
La siguiente tabla proviene por completo de la página del modelo en Artificial Analysis. Para Neon se toma xhigh y para Astra se toma max; estos son los niveles más altos de cada una de las dos páginas. La tabla comparativa de la ficha de DeepMind solo tiene tres columnas —Gemini 4 Neon, Claude Opus 5.5 y GPT-6.2 Sol— y no incluye Astra, así que para la columna de Astra solo se usan las cifras de la página del modelo en Artificial Analysis.
| Dimensión de comparación | Gemini 4 Neon (xhigh) | GPT-6.2 Astra (max) | Fuente |
|---|---|---|---|
| Puntuación de inteligencia | 61 | 62 (xhigh también es 62) | Página del modelo de Artificial Analysis |
| Tiempo por tarea | 21.5 minutos | 13.7 minutos (xhigh es 7.4 minutos) | Página del modelo de Artificial Analysis |
| Precio de lista (entrada/salida, USD/millón de tokens) | 3.00 / 15.00 | 8.00 / 40.00 | Página del modelo de Artificial Analysis |
| Costo por tarea | 6.44 dólares | 4.00 dólares | Página del modelo de Artificial Analysis |
| Tokens de salida de la ejecución del índice | 283 millones | 65.8 millones | Página del modelo de Artificial Analysis |
| Velocidad de salida | 110 tokens/segundo | 50 tokens/segundo | Página del modelo de Artificial Analysis |
| Tiempo hasta el primer token de respuesta | 56.51 segundos | 197.65 segundos | Página del modelo de Artificial Analysis |
| Descuento por caché / precio combinado | 95% / 2.21 | 95% / 5.88 | Página del modelo de Artificial Analysis |
Esta tabla se lee mejor por filas. La puntuación de inteligencia, el tiempo y el precio son tres grupos independientes; que en una misma columna aparezcan «puntuación alta», «tiempo corto» y «precio unitario alto» no es contradictorio.
Por qué GPT-6.2 Astra tiene un precio unitario más alto pero un costo por tarea más bajo
El costo por tarea puede entenderse, a grandes rasgos, como «cuántos tokens se consumen × el precio de cada token». El precio de salida de Astra es de 40 USD por millón de tokens, más del doble de los 15 USD de Neon; sin embargo, según el volumen de salida del índice de ejecución registrado en la página del modelo de Artificial Analysis, Astra consume 65,8 millones de tokens, menos de una cuarta parte de los 283 millones de Neon. El volumen de uso es mucho menor en el caso de Astra: el modelo con precio unitario más alto acaba con un costo por tarea de 4,00 USD, mientras que Neon queda en 6,44 USD.
El lado de la entrada merece una aclaración aparte. La página del modelo Neon indica 8.120 millones de tokens de entrada en el índice de ejecución; en los materiales de referencia no aparece el número de tokens de entrada de Astra, así que aquí solo desglosamos el lado de la salida y no reconstruimos la factura completa. El precio combinado, 2,21 para Neon y 5,88 para Astra, también refleja únicamente el nivel de precios de lista; para estimar tu propia factura aún tendrás que multiplicarlo por tu estructura de tokens.
Al pasar a un negocio concreto, la estructura de tokens cambia. En tareas con entradas muy largas y salidas muy cortas, gana peso la relación de precios de entrada de 8 frente a 3; en tareas con salidas muy largas, el término de consumo de salida domina el resultado. El costo por tarea del índice es el resultado de un conjunto fijo de preguntas; antes de trasladarlo a tu escenario, conviene hacer una prueba con tus propias muestras.
La cuenta de tiempo de Gemini 4 Neon: rápido en salida y rápido en terminar son dos cosas distintas
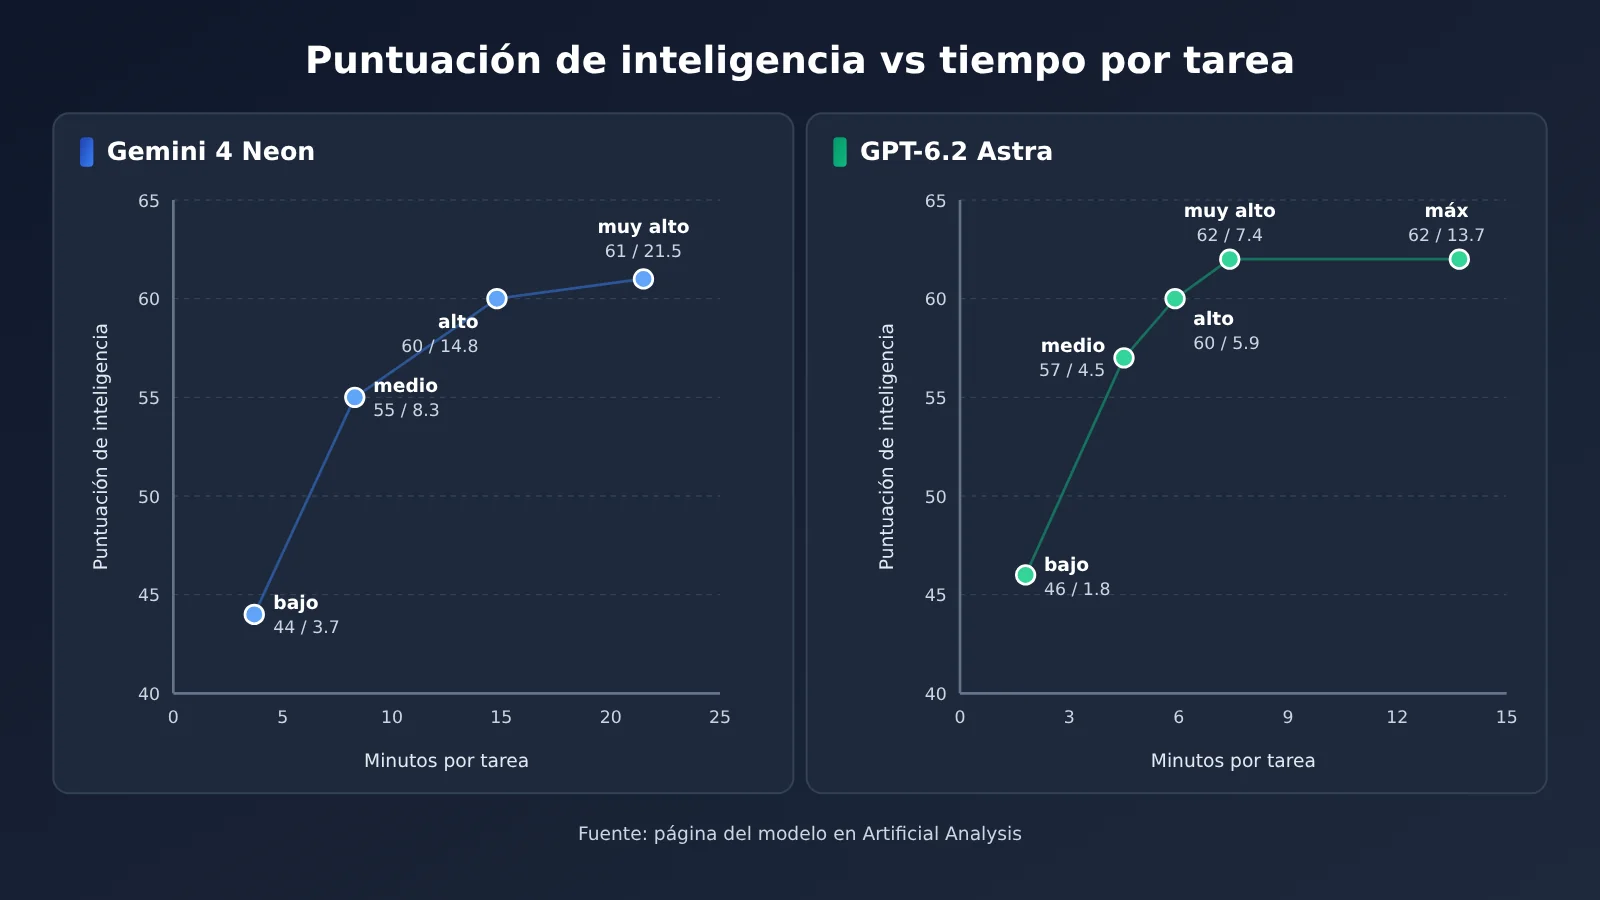
En la página del modelo, Neon produce unos 110 tokens por segundo, más del doble de los 50 tokens/s de Astra, y su primer token de respuesta tarda solo 56.51 segundos, frente a los 197.65 segundos de Astra. Pero el tiempo por tarea es de 21.5 minutos para Neon (xhigh), mientras que Astra (max) tarda 13.7 minutos y su xhigh 7.4 minutos. La razón vuelve a ser la cantidad de tokens: un modelo que genera más, por rápido que suelte cada segundo, también tarda más en terminar de escribir.
En Astra, xhigh y max tienen la misma puntuación de inteligencia, 62, con un tiempo de 7.4 minutos y 13.7 minutos respectivamente, así que al citarlos hay que indicar la configuración. En el lado de Neon, las FAQ de la página del modelo de Artificial Analysis dan además el primer token de respuesta para configuraciones más bajas: high 40.64 segundos, medium 20.14 segundos, low 13.93 segundos; estas cifras vienen de las FAQ y no están en la misma columna que la tabla resumen.
Datos por configuración de Gemini 4 Neon y GPT-6.2 Astra
| Modelo | Configuración | Puntuación de inteligencia | Tiempo por tarea | Velocidad de salida |
|---|---|---|---|---|
| Gemini 4 Neon | xhigh | 61 | 21.5 minutos | 110 tokens/s |
| Gemini 4 Neon | high (predeterminado) | 60 | 14.8 minutos | 101 tokens/s |
| Gemini 4 Neon | medium | 55 | 8.3 minutos | 101 tokens/s |
| Gemini 4 Neon | low | 44 | 3.7 minutos | 97 tokens/s |
| GPT-6.2 Astra | max | 62 | 13.7 minutos | 50 tokens/s |
| GPT-6.2 Astra | xhigh | 62 | 7.4 minutos | 50 tokens/s |
| GPT-6.2 Astra | high | 60 | 5.9 minutos | 50 tokens/s |
| GPT-6.2 Astra | medium | 57 | 4.5 minutos | 49 tokens/s |
| GPT-6.2 Astra | low | 46 | 1.8 minutos | 48 tokens/s |
Los datos provienen todos de la página del modelo de Artificial Analysis; el high de Neon es la configuración predeterminada que indica la guía para desarrolladores de Google. Neon no tiene nivel max; en Astra la velocidad de salida se mantiene estable entre 48 y 50 tokens/s en todas las configuraciones, y las diferencias de tiempo vienen principalmente del número de tokens que escribe cada nivel. La página del modelo solo ofrece el coste por tarea de la configuración tope; aquí no calculamos los costes de las demás configuraciones.
Nota sobre la comparación: las cifras de la gráfica y de la tabla anteriores están tomadas de la página del modelo de Artificial Analysis. Si quieres revisar el consumo de tokens con tus propias tareas, puedes cambiar entre los modelos ya disponibles en APIYI con la misma clave API y comparar.
Autodeclaraciones oficiales, ficha del modelo y comparación con cifras de terceros de Gemini 4 Neon
En el caso de Neon hay tres tipos de fuentes, con criterios metodológicos distintos. Todo el fragmento del blog de Google entra en la categoría de autodeclaración oficial: menciona que el Artificial Analysis Intelligence Index en xhigh es 61, que ocupa el tercer puesto en la clasificación general, Vals Index 70.9% y Arena Agent Arena Index 1336. La ficha del modelo de DeepMind también indica un AA Index v5.0.1 de 61; la nota de evaluación aclara que los resultados de modelos que no son Gemini provienen por defecto de autodeclaraciones de cada fabricante, por lo que se trata de un resumen oficial. El artículo y la página del modelo de Artificial Analysis corresponden a mediciones de terceros.
| Indicador | Autodeclaración oficial (blog de Google) | Ficha del modelo | Artículo de Artificial Analysis |
|---|---|---|---|
| Índice de inteligencia (xhigh) | 61 | 61 | 61 |
| Coding Agent Index | 58.6 | No indicado | 59 (Antigravity CLI, xhigh) |
| MKA | No indicado | 56.5% | 56% |
| WebExploitBench v1.2 | 51.26% | 51.3% | No indicado |
| SWE-sweep | mini-SWE 12.8%, Antigravity 39.0% | harness del fabricante 39.0%, mini-SWE 12.8% | No indicado |
| Afirmación sobre el costo por tarea | En high predeterminado, 32% menos que Carbon | No indicado | 6.44 USD, aproximadamente 17% menos que los 7.76 USD de Carbon sin descuento |
Las cifras que no coinciden se conservan todas en la tabla: Coding Agent Index, 58.6 según la autodeclaración oficial y 59 según el artículo de Artificial Analysis; MKA, 56.5% en la ficha del modelo y 56% en el artículo de Artificial Analysis. El 12.8% y el 39.0% de SWE-sweep provienen de dos harness distintos; el blog de Google atribuye la diferencia a la mejora que aporta el harness.
El criterio de costo también se lleva en tres cuentas separadas. El “32% menos” de Google es un cálculo propio; el blog no aclara si para Carbon se usó el precio introductorio o el precio estándar. El “aproximadamente 17% menos” del artículo de Artificial Analysis se calcula con el precio estándar de Carbon 4/20, que da 7.76 USD. Los 4.90 USD de Carbon en high en la página del modelo de Artificial Analysis se calculan según el precio introductorio actual de la página, 2/10. Estas tres cifras son válidas cada una en su propio contexto y no pueden convertirse entre sí.
Recomendación por escenario: con qué cuenta evaluar Gemini 4 Neon o GPT-6.2 Astra
Escenarios en los que conviene empezar por las cifras de GPT-6.2 Astra
- Presupuesto por tarea individual: si planificas en función de «cuánto cuesta resolver un problema», puedes empezar por el costo por tarea de la página del modelo en Artificial Analysis; para Astra (max) es de 4.00 USD.
- Si te importa el tiempo total de finalización: el nivel xhigh de Astra tarda 7.4 minutos con una puntuación de inteligencia de 62, mientras que el nivel max tarda 13.7 minutos. Con la misma puntuación, la diferencia de tiempo entre ambos niveles es evidente, así que conviene evaluarlos por separado al elegir.
- Tareas por lotes con salidas breves: Astra genera 65,8 millones de tokens de salida en el índice; el consumo de salida pesa relativamente poco en su factura.
Escenarios en los que conviene empezar por las cifras de Gemini 4 Neon
- Interfaces interactivas y espera del primer token: Neon (xhigh) tarda 56.51 segundos hasta el primer token de respuesta; según las FAQ, el nivel low tarda 13.93 segundos.
- Entrada multimodal: la ficha del modelo de DeepMind indica que la entrada puede ser texto, imagen, audio o vídeo, con una ventana unificada de hasta 1 millón de tokens y conocimiento con fecha de corte en marzo de 2026.
- Orquestación más subtareas: la guía para desarrolladores de Google menciona que puedes usar
gemini-4-neoncomo modelo orquestador y pasarprevious_interaction_idagemini-4-hydrogenpara subtareas más rápidas. - Cálculo según el precio por token: la página de precios de Google AI Studio indica para Neon 3.00 USD de entrada, 0.15 USD de caché y 15.00 USD de salida por millón de tokens; la salida incluye tokens de razonamiento y no hay nivel gratuito.
Consultar los modelos y precios de Gemini 4 Neon y GPT-6.2 Astra en APIYI
La página del listado general de APIYI indica una actualización a las 2026-11-16 09:39 (UTC+8); el 2026-11-19 volvimos a verificar la API de precios (versión shell-api-modelmak-v1, 285 modelos en total), que se puede comparar punto por punto en la lista de modelos de apiyi.com. En la API de precios, model_ratio 1 corresponde a 2 dólares por millón de tokens de entrada, y completion_ratio 5 significa que la salida es 5 veces la entrada, en línea con el primer tramo del listado general.
| ID del modelo | Entrada | Lectura de caché | Salida | Endpoint | Notas |
|---|---|---|---|---|---|
gpt-6.2-astra |
8 | 0.4 | 40 | responses | más de 272000 tokens de entrada: 16; la API de precios tiene un tramo alto de salida de unos 60, el listado general no incluye esa franja de salida |
gpt-6.2-sol |
2 | 0.1 | 10 | responses (recomendado), chat | más de 272000 tokens de entrada: 3; la API de precios tiene un tramo alto de salida de unos 11.25 |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | corresponde al precio introductorio de Google hasta 2026-11-30 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | grupos Default, SVIP |
claude-opus-5-5 |
4 | 0.2 | 20 | chat, messages | también hay una versión -thinking |
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | también hay una versión -thinking |
gemini-4-neon |
— | — | — | — | no aparece ni en el listado general ni en la API de precios |
Todas las unidades están en dólares por millón de tokens. Los valores 2/0.1/10 de gemini-4-carbon son el precio de vitrina actual de APIYI, coinciden con el precio introductorio de Google y conviene verlos por separado del precio estándar posterior de Google, 4/20. Los nombres de los grupos difieren ligeramente entre los dos lugares; por ejemplo, el listado general escribe Default y SVIP, mientras que la API de precios escribe default y svip; en la familia Claude, el listado general escribe Claude_Reverse y Claude_Enterprise, y la API de precios escribe ClaudeCodeReverse y ClaudeOfficial. En ambos casos, lo que muestre la plataforma es lo que vale.
El precio oficial de Gemini 4 Neon proviene de la página de precios de Google AI Studio: entrada 3.00, caché 0.15, salida 15.00 dólares por millón de tokens, y solo admite caché implícita. gemini-4-neon no aparece ni en el listado general ni en la API de precios de APIYI, tampoco tiene una página de modelo independiente y aún no está disponible; lo añadiremos lo antes posible. Los modelos y precios que cuentan son los de la lista de modelos de la plataforma.
Inicio rápido: invocar GPT-6.2 Astra a través de APIYI
gpt-6.2-astra usa el endpoint responses compatible con OpenAI. Con estos cuatro pasos puedes ponerlo en marcha:
- Regístrate en apiyi.com y crea una clave API. Guárdala en la variable de entorno
APIYI_API_KEY; en el código, lee únicamente desde la variable de entorno y no incluyas la clave en texto plano. - Inicializa el cliente con el SDK de OpenAI:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). - Llama al endpoint responses:
resp = client.responses.create(model="gpt-6.2-astra", input="用三句话说明单价和单任务费用的区别")y luego leeresp.output_text. - Verifica la facturación: en el primer tramo de la tabla general de APIYI, la entrada cuesta 8, la lectura de caché 0.4 y la salida 40 USD por millón de tokens. Cuando la entrada de una sola solicitud supera los 272000 tokens, la entrada pasa a 16; la interfaz de precios indica para este tramo un
CompletionRatiode 3.75, y la salida ronda los 60 USD por millón de tokens. El texto principal de la tabla general no indica la salida de este tramo.
Para las tareas de contexto largo, presta especial atención al paso 4. Después de superar los 272000 tokens, tanto la entrada como la salida saltan de tramo al mismo tiempo, y el coste por tarea se desvía notablemente de la estimación del primer tramo. Se recomienda calcular primero el número de tokens de las solicitudes típicas y, a partir de ahí, definir el presupuesto.
Los modelos Gemini ya disponibles tienen dos formas de conexión: gemini-4-carbon y gemini-4-hydrogen pueden usar la misma dirección compatible con OpenAI a través del endpoint chat, o la dirección nativa de Gemini https://api.apiyi.com con la versión de API v1beta. Las reglas de parámetros de Neon se pueden consultar primero en la guía para desarrolladores de Google: los niveles de pensamiento solo pueden ser low, medium, high, xhigh, y el valor predeterminado es high; si se pasa thinking_budget o MINIMAL, devuelve HTTP 400; la caché de contexto explícita no es compatible, los prefijos compartidos de más de 4096 tokens pasan automáticamente por la caché implícita; la salida predeterminada de un solo segmento es como máximo de 65536 tokens.
🚀 Inicio rápido: Te recomendamos obtener primero en APIYI apiyi.com el crédito de prueba gratuito para nuevos usuarios y, con la misma clave, llamar sucesivamente a
gpt-6.2-astra,gpt-6.2-solygemini-4-carbon, registrar sus respectivos tokens de entrada y salida, y luego aplicar la tabla de precios anterior para calcular el coste por tarea.
Recomendaciones de decisión entre Gemini 4 Neon y GPT-6.2 Astra
| Lo que te importa | Qué columna mirar primero | Gemini 4 Neon (xhigh) | GPT-6.2 Astra | Fuente |
|---|---|---|---|---|
| Puntuación de inteligencia | Puntuación de inteligencia | 61 | max 62, xhigh 62 | Página del modelo en Artificial Analysis |
| Cuánto tarda en resolver una tarea | Tiempo por tarea | 21,5 minutos | max 13,7 minutos, xhigh 7,4 minutos | Página del modelo en Artificial Analysis |
| Cuánto esperar para el primer token | Token de la primera respuesta | 56,51 segundos | max 197,65 segundos | Página del modelo en Artificial Analysis |
| Precio por millón de tokens | Precio unitario | 3 / 15 | 8 / 40 | Página del modelo en Artificial Analysis, tabla general de APIYI |
| Cuánto cuesta completar el índice | Costo por tarea | 6,44 dólares | max 4,00 dólares | Página del modelo en Artificial Analysis |
| Cómo se cobra la entrada larga | Tramos de precios | Los materiales de referencia no listan tramos | Entrada superior a 272000 tokens: 16; salida aprox. 60 | Tabla general de APIYI, interfaz de precios |
Al decidir, primero determina qué fila es la más importante para tu negocio y luego fíjate en las cifras y la fuente de esa fila. La puntuación de inteligencia difiere solo en 1 punto; las filas de tiempo, primer token, precio unitario y costo por tarea apuntan en direcciones distintas, y ninguna fila puede sustituir a las demás.
💡 Recomendación de selección: El conjunto de tareas del índice y tus tareas reales suelen diferir en la estructura de tokens. Te sugerimos poner tus propias muestras en apiyi.com y hacer una ronda comparativa entre los modelos ya disponibles, registrando el uso de tokens y el tiempo para luego decidir el nivel y el modelo.
Preguntas frecuentes sobre Gemini 4 Neon y GPT-6.2 Astra
Q1: ¿Qué es Gemini 4 Neon?
Gemini 4 Neon es un modelo que Google lanzó el 18 de noviembre de 2026, con ID de modelo `gemini-4-neon`. La ficha del modelo de DeepMind indica que fue adaptado a partir de Gemini 4 Carbon y que, dentro de la familia, se sitúa entre Hydrogen (ejecución diaria rápida) y Carbon (procesamiento complejo de largo alcance), con una ventana de contexto unificada de 1048576 tokens.
Q2: ¿Cuánta diferencia hay en la puntuación de inteligencia entre Gemini 4 Neon y GPT-6.2 Astra?
En la página del modelo de Artificial Analysis, Neon (xhigh) obtiene 61, Astra (max) 62 y Astra (xhigh) también 62. Astra logra la misma puntuación en las dos configuraciones, con tiempos de 13.7 minutos y 7.4 minutos, respectivamente; al citar estos datos hay que indicar la configuración.
Q3: ¿Cuándo estará disponible Gemini 4 Neon?
Sundar Pichai escribió el mismo día del lanzamiento que Neon está disponible desde el 18 de noviembre de 2026 en la API Gemini de Google AI Studio, en Gemini for business, en Google Antigravity para Google AI Pro y Ultra de pago, y en la app Gemini para Pro y Ultra. La página de precios de Google AI Studio indica que no tiene plan gratuito.
Q4: GPT-6.2 Astra tiene un precio unitario más alto; ¿por qué su costo por tarea es de 4.00 dólares?
El costo por tarea depende tanto del precio unitario como del volumen de uso. La página del modelo de Artificial Analysis registra que Astra (max), al ejecutar el índice, generó 65,8 millones de tokens de salida, mientras que Neon (xhigh) generó 283 millones. Aunque el precio unitario de salida de Astra es de 40 frente a 15, su uso es mucho menor, por lo que el costo por tarea es de 4.00 dólares, frente a 6.44 dólares para Neon.
Q5: ¿Cómo llamar rápidamente a GPT-6.2 Astra mediante API?
1. Regístrate en APIYI apiyi.com y obtén la clave API y el crédito de prueba gratuito.
2. Configura `base_url` del SDK de OpenAI con la dirección compatible con OpenAI que aparece en la guía de inicio rápido anterior.
3. Usa el endpoint `responses` y pon `gpt-6.2-astra` como modelo.
`gemini-4-neon` actualmente no aparece en la tabla general ni en la interfaz de precios de APIYI; cuando se publique, hay que guiarse por la lista de modelos de la plataforma.
Q6: ¿Qué limitaciones hay al citar estas cifras?
– **Criterio**: las fuentes —datos oficiales autodeclarados, fichas de modelo, artículos y páginas de modelo de Artificial Analysis— no coinciden; Coding Agent Index tiene dos valores, 58.6 y 59, y MKA tiene dos valores, 56.5 % y 56 %.
– **Costo**: el “32 % menos” de Google, el “alrededor de 17 % menos” del artículo de Artificial Analysis y los 4.90 dólares de Carbon en la página del modelo son tres cuentas distintas y no se pueden combinar.
– **Migración**: el costo por tarea del índice proviene de un conjunto fijo de tareas; la estructura de tokens de tus tareas es diferente, así que los resultados también variarán.
Gemini 4 Neon y GPT-6.2 Astra: puntos clave (Key Takeaways)
- Puntuación de inteligencia: en la página del modelo de Artificial Analysis, Astra (max) 62, Astra (xhigh) 62, Neon (xhigh) 61.
- Tiempo de ejecución: Neon (xhigh) 21.5 minutos; Astra max 13.7 minutos, xhigh 7.4 minutos; hay que citar cada nivel por separado.
- Precio unitario: Astra 8/40, Neon 3/15 USD por millón de tokens; el precio de Neon procede de la página de precios de Google AI Studio.
- Coste por tarea: Astra (max) 4.00 USD, Neon (xhigh) 6.44 USD; la diferencia viene del consumo de tokens de salida.
- Velocidad y primer token: Neon 110 tokens/segundo, primer token 56.51 segundos; Astra 50 tokens/segundo, primer token 197.65 segundos.
- Disponibilidad en APIYI:
gpt-6.2-astraprimer tramo 8/0.4/40, entrada de más de 272000 tokens 16, salida del endpoint de precios unos 60;gemini-4-neonaún no está en el catálogo.
Resumen comparativo: Gemini 4 Neon y GPT-6.2 Astra
Al comparar Gemini 4 Neon y GPT-6.2 Astra, la clave es llevar cuentas separadas:
- Cuenta de inteligencia: 61 frente a 62; xhigh y max de Astra comparten 62; la fuente es la página del modelo de Artificial Analysis.
- Cuenta de tiempo: 21.5 minutos frente a 13.7 minutos (Astra xhigh es 7.4 minutos); la velocidad de salida y el tiempo hasta el primer token son otra serie de números.
- Cuenta de precios: precio unitario 3/15 frente a 8/40, coste por tarea 6.44 frente a 4.00 USD, con 283 millones frente a 65.8 millones de tokens de salida de diferencia.
A la hora de elegir, primero define con qué libro de cuentas vas a liquidar y luego verifica el consumo de tokens con tus propias muestras. Recomendamos usar APIYI apiyi.com para hacer pruebas comparativas con una sola clave sobre los modelos ya disponibles; cuando gemini-4-neon esté disponible, podrás añadirlo directamente al mismo flujo de trabajo.
📚 Referencias
-
Publicación de Sundar Pichai: Anuncio y canales de disponibilidad de Gemini 4 Neon
- Enlace:
x.com/sundarpichai/status/2123167780988125621 - Descripción: Fecha de lanzamiento y punto de acceso
- Enlace:
-
Blog de Google «Introducing Gemini 4 Neon»: benchmarks, precios y posicionamiento según la propia Google
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descripción: Coding Agent Index 58.6, coste 32% menor y otros datos oficiales
- Enlace:
-
Ficha del modelo Gemini 4 Neon de DeepMind: tabla comparativa y especificaciones del modelo
- Enlace:
deepmind.google/models/model-cards/gemini-4-neon/ - Descripción: la tabla comparativa solo incluye tres columnas: Neon, Claude Opus 5.5 y GPT-6.2 Sol
- Enlace:
-
Guía para desarrolladores de Google Cloud: parámetros y reglas de caché de
gemini-4-neon- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descripción: niveles de razonamiento, condiciones de
HTTP 400, caché implícita
- Enlace:
-
Página de precios de Google AI Studio: precios oficiales de la familia Gemini 4
- Enlace:
aistudio.google.com/docs/pricing - Descripción: Neon 3/0.15/15, precio de introducción de Carbon vigente hasta 2026-11-30
- Enlace:
-
Artículo de Artificial Analysis: análisis de la puntuación de inteligencia y el coste de Neon
- Enlace:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Descripción: medición de terceros, que incluye el dato de un precio estándar de Carbon aproximadamente 17% menor
- Enlace:
-
Páginas de modelos de Artificial Analysis: Gemini 4 Neon y GPT-6.2 Astra
- Enlace:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-astra - Descripción: principal fuente de datos de los tres balances de este artículo, consultado el 2026-11-19
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: puedes escribirnos a través de la página de inicio del sitio oficial de APIYI. Para modelos y precios, toma como referencia la lista de modelos y el centro de documentación de la plataforma.