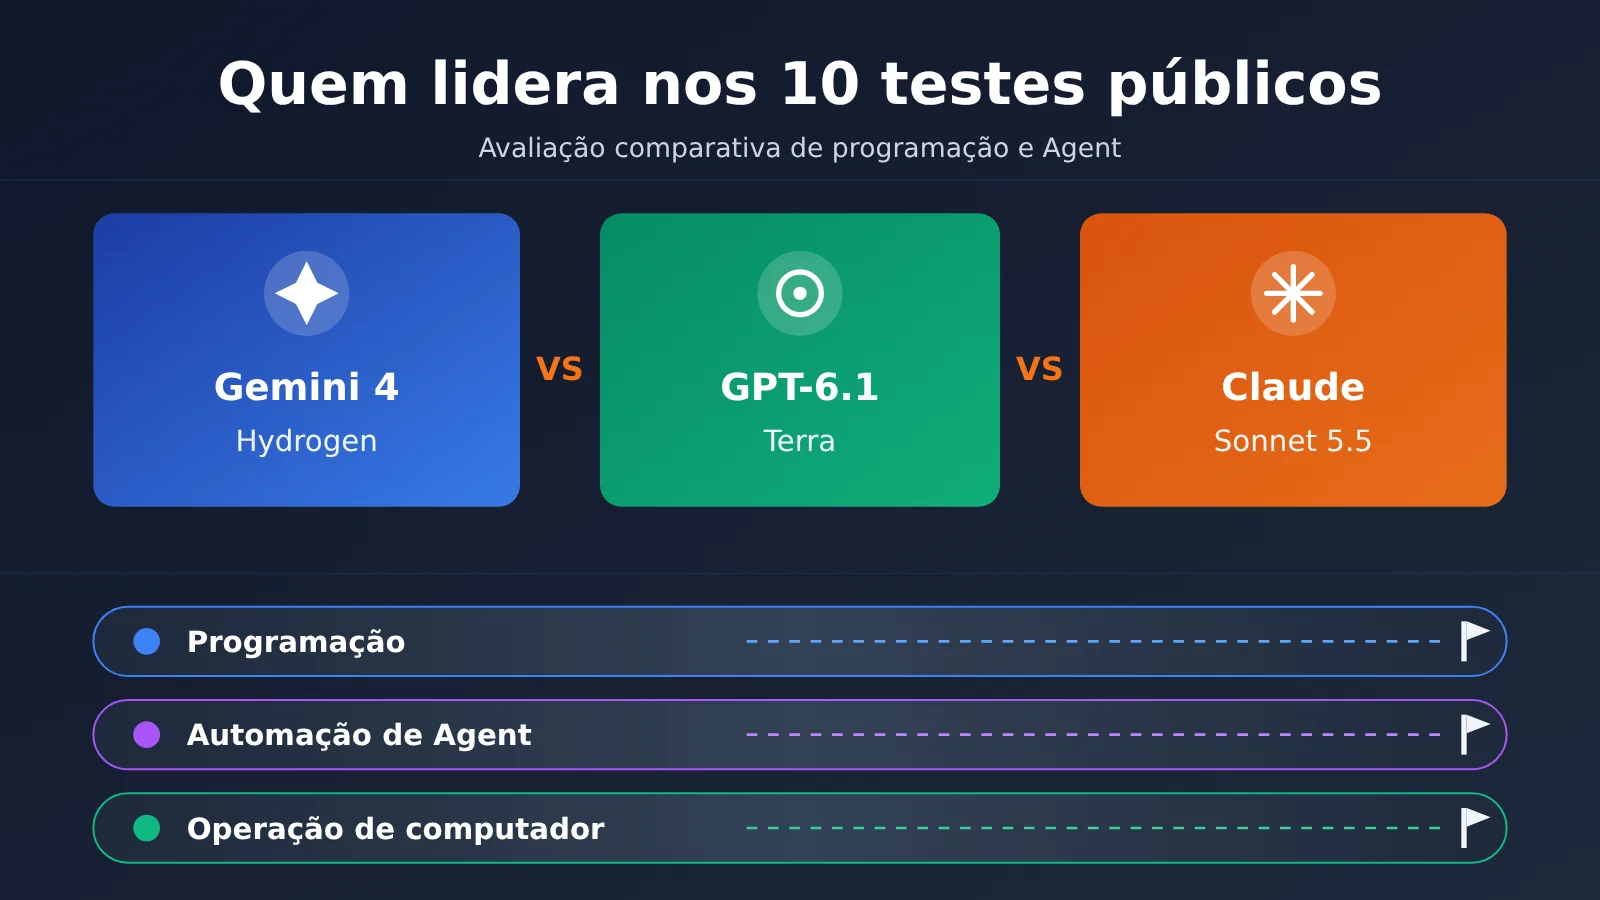
Nota do autor: com base nas 10 avaliações comparativas entre modelos publicadas pelo Google DeepMind, este texto analisa os pontos fortes e fracos de Gemini 4 Hydrogen, GPT-6.1 Terra e Claude Sonnet 5.5 em programação, automação com Agent e operação de computador, além de sugerir a escolha de modelo conforme a tarefa.
Resumo em uma frase: as avaliações comparativas divulgadas pelo Google mostram que Gemini 4 Hydrogen e Claude Sonnet 5.5 têm vantagens em diferentes tarefas de programação e Agent; GPT-6.1 Terra se destaca pelo custo e pelo posicionamento em operação visual. Na prática, a escolha deve considerar as condições do teste, o tipo de tarefa e o custo.
Para saber: 5 termos que você precisa conhecer antes de ler este artigo
- Harness: estrutura de teste que organiza as entradas do modelo, a execução de ferramentas e a pontuação das tarefas. O mesmo modelo pode apresentar resultados bem diferentes quando muda o Harness.
- Versão do benchmark: versão dos dados, das tarefas e das regras de uma avaliação. Por exemplo, Terminal-Bench 4.0 e 4.1 são versões diferentes, e os resultados precisam ser interpretados separadamente.
- Agent: sistema no qual o modelo e o ambiente de execução de ferramentas realizam em conjunto tarefas de várias etapas; o resultado reflete o desempenho do conjunto “modelo + cadeia de ferramentas”.
- Token: unidade usada pelo modelo para processar informações, como texto; os preços de API normalmente são cobrados por milhão de tokens.
- API: interface que permite a programas chamar serviços; por meio dela, desenvolvedores conectam o modelo aos próprios aplicativos ou Agents.
Em 12 de novembro de 2026, o Google lançou oficialmente o Gemini 4 Hydrogen e, no model card oficial, o colocou na mesma tabela de avaliação que GPT-6.1 Terra e Claude Sonnet 5.5. Essa tabela cobre programação, automação com Agent, operação de computador e trabalho de conhecimento multimodal. Hoje, ela é o conjunto público de dados comparativos mais consolidado entre os três modelos.
Não se trata de uma análise conciliatória do tipo “cada um tem seus pontos fortes”. Vamos destrinchar item por item o que cada teste mede e em que condições ele foi executado; depois, apresentaremos conclusões separadas para três áreas — programação, Agent e operação de computador — e, por fim, uma matriz de seleção de modelos pronta para aplicar.
Valor central: depois de ler este artigo, você saberá com clareza em quais tarefas o Gemini 4 Hydrogen lidera, em quais fica atrás do Sonnet 5.5 e onde o Terra se encaixa no fluxo de trabalho da equipe.
Por que comparar o Gemini 4 Hydrogen com Terra e Sonnet 5.5
Os três modelos foram lançados com menos de dois meses de diferença entre si, e o posicionamento deles se sobrepõe bastante: nenhum é o modelo de raciocínio mais pesado e emblemático de sua empresa, mas sim o “modelo cavalo de batalha” voltado para desenvolvedores, execução de agentes e tarefas profissionais de alta frequência. Para equipes que precisam fazer um grande volume de invocações todos os dias, é essa camada que realmente define custo e eficiência.
O Gemini 4 Hydrogen é a nova geração de modelos de alta eficiência do Google DeepMind, oficialmente posicionado para programação cotidiana e execução de agentes de IA, podendo operar de forma independente ou atuar como executor ou verificador em sistemas multimodelo. O GPT-6.1 Terra foi lançado pela OpenAI em 26 de outubro de 2026, com foco em raciocínio visual, operação de computadores e trabalho cotidiano de alta eficiência. O Claude Sonnet 5.5 foi lançado pela Anthropic em 28 de setembro de 2026, e a empresa destaca oficialmente programação cotidiana, correção de bugs, produção de documentos profissionais e design de interfaces complexas.
| Modelo | Fabricante | Data de lançamento | Posicionamento oficial | Preço padrão da API (por milhão de tokens, entrada/saída) | Fonte do preço |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | Programação cotidiana, invocação de múltiplas ferramentas, execução de agentes | $1,50 / $7,50 | Página de preços do Google AI Studio, verificada em 2026-11-13 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | Raciocínio visual, operação de computadores, trabalho cotidiano | $1 / $5 | Material de lançamento da OpenAI, 2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | Programação cotidiana, correção de bugs, documentos profissionais, design de interfaces | Não coberto pelos materiais de referência; consultar a página de preços oficial | Site oficial da Anthropic |
Vale esclarecer que os tokens de raciocínio do Hydrogen entram no preço de saída, então o custo real não pode ser estimado apenas com base no texto final visível. Além disso, os preços dos modos Batch e Flex do Hydrogen são de $0,75 / $3,75, o que é adequado para tarefas em lote offline.
A comparação quantitativa deste artigo tem como base principal o model card de novembro de 2026 do Google DeepMind e os documentos de metodologia de avaliação que o acompanham. Isso significa que os dados foram consolidados pelo Google, e parte dos resultados dos concorrentes vem de relatórios públicos dos fabricantes ou de rankings — vamos discutir especificamente o impacto disso nas conclusões na quinta seção.
Comparação das capacidades de programação do Gemini 4 Hydrogen: quem é melhor em corrigir problemas reais
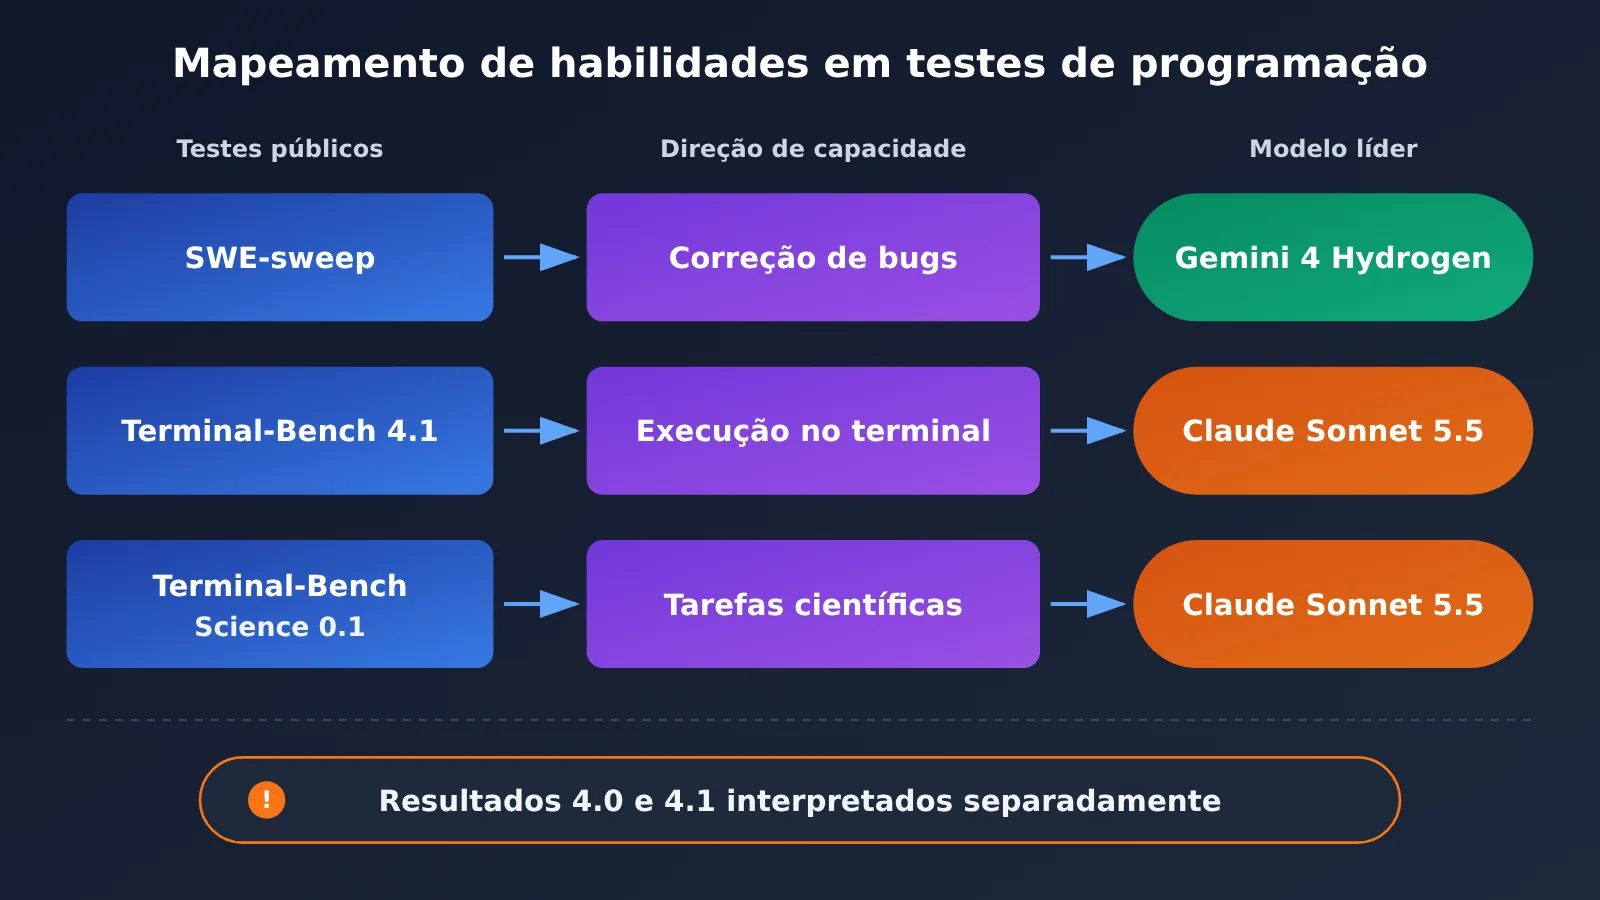
Os testes de programação podem ser divididos em duas capacidades: encontrar e corrigir problemas em bases de código reais, e executar comandos continuamente em um ambiente de terminal para concluir tarefas de engenharia. O SWE-sweep pende para a primeira, a série Terminal-Bench pende para a segunda, e o Terminal-Bench-Science avalia a capacidade de usar código para concluir tarefas de pesquisa científica.
| Avaliação (versão) | Métrica | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Líder |
|---|---|---|---|---|---|
| SWE-sweep | Recompensa ponderada por subtarefa | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1 | Recompensa média | 57.0% | 63.9% | — | Sonnet |
| Terminal-Bench-Science 0.1 | Pontuação da tarefa | 51.4% | 59.9% | 58.3% | Sonnet |
Fonte: Google DeepMind, “Gemini 4 Hydrogen Model Evaluation” e model card, novembro de 2026.
Interpretação dos resultados dos testes de programação
As pontuações absolutas do SWE-sweep são, no geral, baixas, o que mostra que é um teste de dificuldade elevada. Os 13.5% do Hydrogen são mais de duas vezes os do Terra e mais de quatro vezes os do Sonnet — é nesta métrica que a diferença é mais marcante. Vale notar, porém, que o Hydrogen executou essa avaliação usando o Antigravity-CLI 1.4.8, da própria Google, e as condições de execução dos concorrentes não são necessariamente as mesmas; parte da diferença pode vir da adaptação ao Harness.
No Terminal-Bench 4.1, o Sonnet 5.5 lidera com 63.9%, à frente dos 57.0% do Hydrogen, e o Terra não tem resultado nessa métrica na tabela da Google. O Hydrogen usou aqui o Harness mini-swe-agent vision, no nível de raciocínio High, com cada tarefa executada 5 vezes e recompensa média. Já no Terminal-Bench-Science 0.1, o Sonnet continua na frente, o Terra vem logo atrás com 58.3%, e o Hydrogen fica em terceiro.
Conclusão na área de programação: o Hydrogen tem vantagem clara em testes de correção de problemas em bases de código, como o SWE-sweep; o Sonnet 5.5 é mais consistente em tarefas de execução no terminal; o Terra se aproxima do Sonnet em tarefas de código científico. Nenhum modelo lidera de forma abrangente nos testes de programação.
Dados de contexto do Terminal-Bench 4.0 divulgados pelos fornecedores
OpenAI e Anthropic publicaram cada um seus resultados no Terminal-Bench 4.0. Como 4.0 e 4.1 são versões diferentes do benchmark, a tabela abaixo é apresentada separadamente e não pode ser comparada misturando com os resultados 4.1 da tabela acima.
| Avaliação (versão) | Modelo | Resultado | Condições de teste | Fonte |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70.6% | Teste do próprio fornecedor | Material de divulgação da Anthropic, 2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50.3% | Configuração máxima de raciocínio | Material de divulgação da OpenAI, 2026-10-26 |
O valor desses dados está em servir de referência: nas condições de teste de cada fornecedor, a capacidade do Sonnet 5.5 em tarefas de terminal é claramente superior à do Terra, o que vai na mesma direção da liderança do Sonnet nos testes de terminal na tabela da Google.
O Gemini 4 Hydrogen consegue realizar um trabalho completo em Agent e testes automatizados?
A maior diferença entre testes de Agent e perguntas e respostas de turno único é que o modelo precisa planejar os passos por conta própria, chamar ferramentas continuamente, ajustar a estratégia após falhas e, por fim, verificar os resultados. Esse tipo de teste se aproxima mais de fluxos de trabalho automatizados reais e também coloca à prova a “disciplina de execução” do modelo.
A tabela abaixo reúne todos os resultados entre modelos nas avaliações do Google sobre automação com Agent, operação de computador e trabalho de conhecimento multimodal; as seções três e quatro compartilham esta tabela.
| Avaliação (versão) | Direção de capacidade | Métrica | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents’ Last Exam v1.1 | Agent profissional de múltiplos passos | Pontuação da tarefa | 71,6% | 60,4% | 69,8% |
| AutomationBench-AA | Automação de fluxos de trabalho | Pontuação da tarefa | 76,1% | 71,8% | 60,2% |
| Vending-Bench 2 | Gestão simulada de longo prazo | Saldo final de capital | $14.549 | $11.165 | $9.107 |
| OSWorld-2.1 | Operação de computador/interface gráfica | Taxa de sucesso da tarefa | 77,6% | 83,9% | 74,2% |
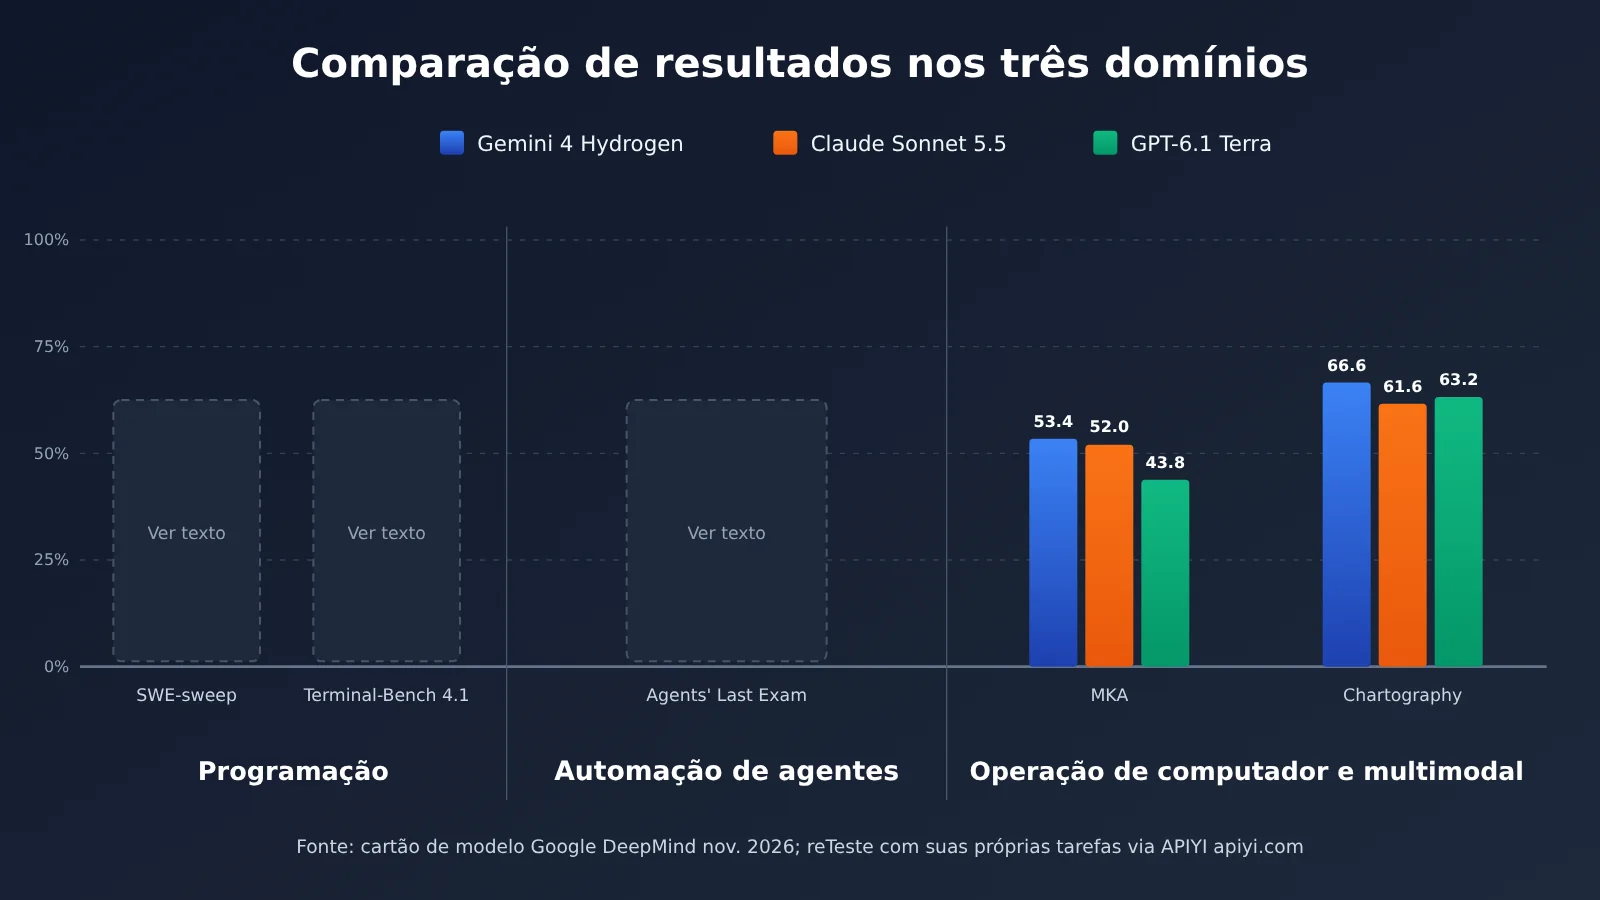
| MKA | Trabalho de conhecimento multimodal | Pontuação da tarefa | 53,4% | 52,0% | 43,8% |
| Chartography | Compreensão de gráficos (sem ferramentas) | Acurácia | 66,6% | 61,6% | 63,2% |
| HLE-Diamond | Raciocínio de conhecimento avançado | Acurácia | 58,8% | 53,3% | 47,3% |
Fonte: modelo de ficha do Google DeepMind e “Gemini 4 Hydrogen Model Evaluation”, novembro de 2026.
Interpretação dos resultados de Agent e automação
O Agents’ Last Exam v1.1 contém 122 tarefas, com janela de tempo de 5 horas, e o Hydrogen também é executado com o Antigravity-CLI 1.4.8. O Hydrogen lidera com 71,6%, mas vale notar que o Terra vem logo atrás com 69,8%, quase 10 pontos percentuais acima do Sonnet. Isso mostra que, em tarefas profissionais de múltiplos passos, o Terra não é fraco.
O cenário do AutomationBench-AA é diferente: Hydrogen 76,1%, Sonnet 71,8% e Terra 60,2%, claramente atrás. Se o seu negócio envolve grande volume de automação de processos entre sistemas, essa diferença merece atenção.
O Vending-Bench 2 é uma tarefa de gestão simulada de longo prazo, e a métrica é o saldo final de capital, não a acurácia. Os $14.549 do Hydrogen lideram com boa margem, o que pode servir como observação complementar sobre “estabilidade de decisão em ciclos longos”, mas é um ambiente de simulação único e não deve ser generalizado diretamente para todas as tarefas longas.
Conclusão na área de Agent: nas avaliações de Agent e automação listadas pelo Google, o Hydrogen lidera em todas; o Terra fica próximo do Hydrogen em tarefas profissionais de múltiplos passos, mas fica atrás na automação de processos; o Sonnet ocupa a posição intermediária.
🚀 Começando rápido: os resultados de Agent dependem fortemente do Harness e da definição das ferramentas, então as pontuações públicas servem apenas como ponto de partida. Recomendamos usar o APIYI apiyi.com para rodar os três modelos com a mesma cadeia de ferramentas e o mesmo lote de tarefas reais, alternando com uma única chave API, para obter dados comparativos próprios do seu cenário.
Gemini 4 Hydrogen e Sonnet 5.5: quem é mais forte em operação de computador e trabalho de conhecimento multimodal?
Testes de operação de computador exigem que o modelo “veja a tela, clique com o mouse e digite no teclado”, o que corresponde diretamente a cenários como operação de navegador e automação de software de escritório. Já o trabalho de conhecimento multimodal avalia leitura de arquivos complexos e compreensão de gráficos, com correspondência em tarefas como análise de relatórios financeiros e organização de relatórios de pesquisa.
OSWorld-2.1: Sonnet 5.5 lidera em operação de interface gráfica
O OSWorld 2.1, na avaliação do Google, usa 82 tarefas offline, resolução 1080p, até 500 etapas; o modelo observa por meio de capturas de tela e executa ações via PyAutoGUI. O Sonnet 5.5 lidera com 83.9%, seguido por Hydrogen com 77.6% e Terra com 74.2%.
Há uma questão de metodologia que precisa ser destacada: a própria Anthropic divulga 80.1% para o Sonnet 5.5 em parte dos testes do OSWorld 2.1, enquanto a tabela comparativa do Google usa 83.9%, resultado que o Google obteve testando sob condições especificadas e tomando o melhor resultado entre várias execuções. Ou seja, um teste com o mesmo nome pode render pontuações diferentes dependendo do fabricante; na comparação, é preciso fixar uma única fonte.
MKA e Chartography: Hydrogen tem ligeira vantagem
No MKA, que avalia trabalho de conhecimento multimodal, Hydrogen (53.4%) e Sonnet (52.0%) estão muito próximos, e o Terra (43.8%) fica cerca de 10 pontos percentuais atrás. O Chartography testa a compreensão de gráficos sem uso de ferramentas: Hydrogen lidera com 66.6% e, curiosamente, o Terra aparece em segundo com 63.2%, acima dos 61.6% do Sonnet, o que está alinhado com o posicionamento da OpenAI para o Terra como “raciocínio visual”.
Conclusão sobre operação de computador e multimodalidade: para operação de interface gráfica, dê prioridade ao Sonnet 5.5; em leitura de arquivos complexos e integração de conhecimento multimodal, Hydrogen e Sonnet ficam próximos, com ligeira vantagem para Hydrogen; em compreensão pura de gráficos, Hydrogen lidera, e o Terra também é competitivo.
Como ler corretamente os dados públicos de avaliação do Gemini 4 Hydrogen
O ponto mais fácil de interpretar errado em avaliações públicas é tratar uma tabela como um boletim de notas de “mesma prova, mesmas regras”. Na prática, o documento de metodologia de avaliação do Google deixa claros alguns pré-requisitos importantes:
- Nível de raciocínio: o Hydrogen normalmente é testado com a configuração máxima de raciocínio, mas alguns itens têm regras próprias; por exemplo, o Terminal-Bench 4.1 usa o nível High.
- Harness de execução: SWE-sweep e Agents’ Last Exam usam Antigravity-CLI 1.4.8; o Terminal-Bench 4.1 usa o Harness mini-swe-agent vision; o OSWorld 2.1 usa captura de tela mais PyAutoGUI.
- Número de execuções: o Terminal-Bench 4.1 roda cada tarefa 5 vezes e calcula a média da recompensa, enquanto as pontuações dos concorrentes no OSWorld usam o melhor resultado entre várias execuções — os dois métodos estatísticos já são diferentes.
- Origem dos resultados: os resultados dos concorrentes vêm principalmente de relatórios públicos e rankings de cada fabricante; não são todos os modelos que foram executados pelo mesmo time de forma unificada.
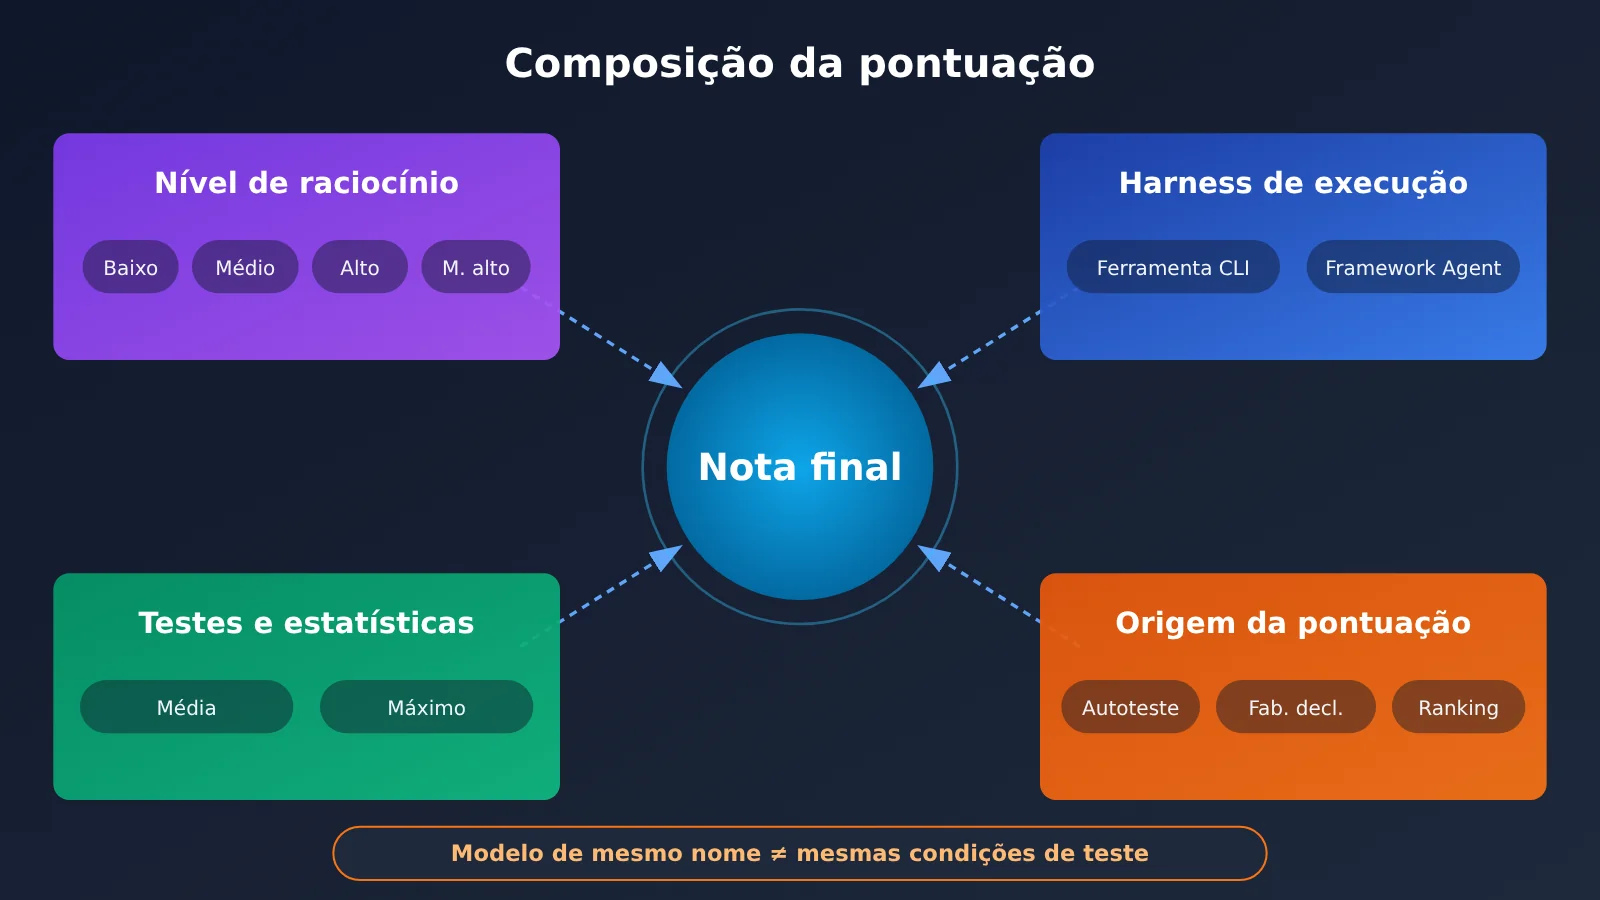
O impacto do nível de raciocínio é especialmente grande. Em 12 de novembro, a Artificial Analysis fez uma avaliação independente dos quatro níveis do Hydrogen: o índice de inteligência foi 27 no Low, 41 no Medium, 51 no High (padrão) e 54 no XHigh; o custo médio correspondente nas tarefas padronizadas de avaliação variou de $0.29 a $3.16. Esses são resultados das tarefas de benchmark dela, não o custo real de cada chamada feita por um usuário comum, mas bastam para mostrar que o mesmo modelo muda muito conforme o nível: o XHigh tem só 3 pontos a mais que o High, mas o custo sobe claramente.
Portanto, ao ler os resultados deste artigo, lembre-se de dois pontos: primeiro, as conclusões se aplicam apenas aos testes públicos listados; segundo, não monte um “ranking geral” juntando os dados mais favoráveis da tabela do Google, dos números autorreportados pela OpenAI e dos autorreportados pela Anthropic.
Primeiros passos com o Gemini 4 Hydrogen: compare três modelos com o mesmo código
A forma mais confiável de escolher um modelo é rodar os três com as suas próprias tarefas. O exemplo abaixo usa a interface compatível com OpenAI; basta alterar o parâmetro model para trocar de modelo.
Exemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "找出这段 Python 代码中的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Ver o código completo: script de comparação dos três modelos na mesma tarefa
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Os IDs dos modelos seguem a lista de modelos da plataforma; gemini-4-hydrogen é o ID oficial do Google
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # ID ilustrativo; confirme no console
    "claude-sonnet-5.5",   # ID ilustrativo; confirme no console
]

def compare(prompt: str, system: str = "你是资深工程师,只修改必要代码"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("修复:函数在空列表输入时抛出 IndexError ..."):
        print(r)
Ao migrar para o Hydrogen, alguns pontos merecem atenção: valores personalizados de temperature, top_p e top_k serão ignorados; thinking_budget e MINIMAL não são suportados; o nível de raciocínio padrão é High; chamadas de ferramentas em múltiplos turnos exigem o retorno correto das thought signatures. Se o seu agente dependia de temperature baixa para controlar a saída, será preciso usar saída estruturada ou instruções mais explícitas para restringir o resultado.
Recomendação: comece com 10 a 20 chamados ou tarefas reais como conjunto de avaliação, chame os três modelos no APIYI apiyi.com e registre taxa de sucesso, tempo e número de tokens de saída. Novos usuários têm cota gratuita para testes, então dá para fazer uma validação em pequena escala antes de uma compra definitiva.
Gemini 4 Hydrogen, Terra e Sonnet 5.5: cenários recomendados e matriz de seleção
Quando escolher o Gemini 4 Hydrogen
- Correção de problemas em bases de código e atualização de dependências: é onde a vantagem no SWE-sweep aparece com mais folga, além de o time oficial ter investido justamente em edição precisa.
- Agentes com múltiplas etapas e automação de fluxos: lidera em Agents’ Last Exam, AutomationBench-AA e Vending-Bench 2.
- Análise de documentos e gráficos complexos: sai na frente em MKA e Chartography, com suporte a entradas em vários formatos como PDF e documentos do Office.
Quando escolher o Claude Sonnet 5.5
- Tarefas de engenharia intensivas em terminal: lidera tanto no Terminal-Bench 4.1 quanto no Terminal-Bench-Science 0.1.
- Operação de desktop e interfaces gráficas: o OSWorld-2.1 é o mais alto na tabela do Google.
- Documentação técnica e design de interface: são as frentes que a Anthropic destaca oficialmente.
Quando escolher o GPT-6.1 Terra
- Tarefas em lote com sensibilidade a custo: preço padrão de $1 / $5, o mais baixo entre os preços conhecidos dos três.
- Raciocínio visual e automação do dia a dia: fica em segundo no Chartography e bem perto do Hydrogen no Agents’ Last Exam.
| Tipo de tarefa | Primeira opção | Alternativa | Sensibilidade a custo | Como executar | Canal de acesso |
|---|---|---|---|---|---|
| Manutenção de base de código, correção de bugs | Hydrogen | Sonnet 5.5 | Média | Hydrogen altera o código, Sonnet valida no terminal | Interface unificada do APIYI apiyi.com |
| Operação de terminal, código científico | Sonnet 5.5 | Terra | Média | Sessão longa com um único modelo | O mesmo acima |
| Fluxos de agentes com múltiplas etapas | Hydrogen | Terra | Média | Comece no nível High e suba para XHigh se falhar | O mesmo acima |
| Operação de GUI em desktop/navegador | Sonnet 5.5 | Hydrogen | Baixa | Observação por captura de tela + ferramentas de operação | O mesmo acima |
| Leitura de gráficos e documentos | Hydrogen | Terra | Média | Sem ferramentas ou com recuperação aumentada | O mesmo acima |
| Automação em lote do dia a dia | Terra | Hydrogen (Batch) | Alta | Processamento assíncrono em lote | O mesmo acima |
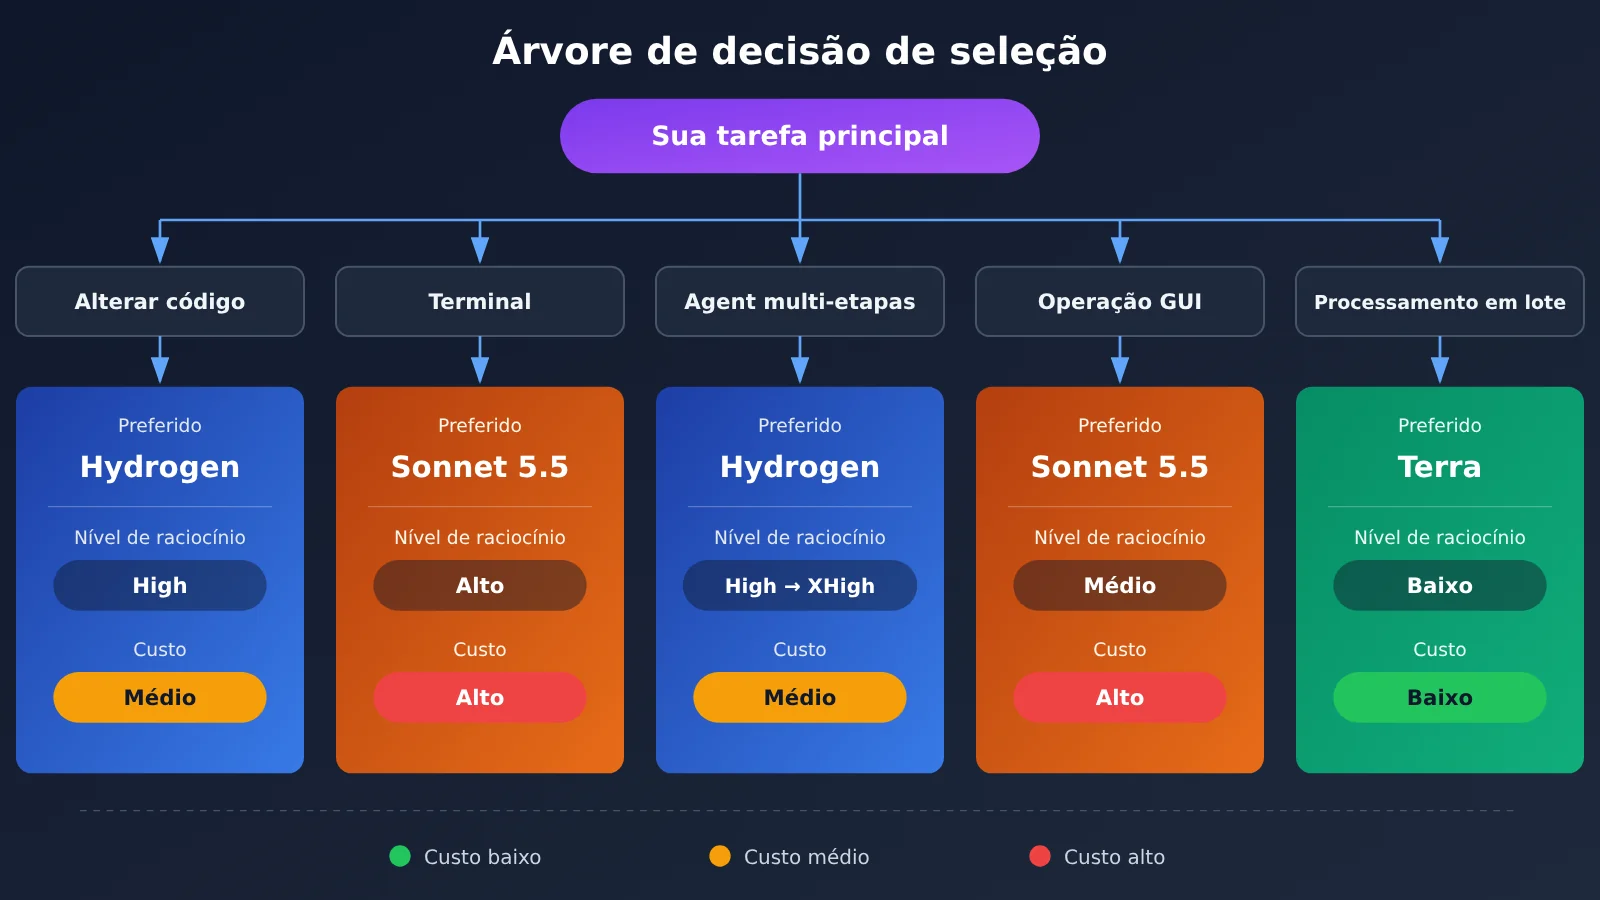
💡 Sugestão de escolha: se o time tem ao mesmo tempo demandas de programação e de automação de GUI, não é preciso apostar em um único modelo — dá para dividir o trabalho por etapa, seguindo a lógica do Google Antigravity Orchestrator. Com o APIYI apiyi.com você chama vários modelos usando a mesma chave, e trocar a rota leva só a alteração de um parâmetro.
Perguntas frequentes (FAQ)
Q1: O que é o Gemini 4 Hydrogen?
O Gemini 4 Hydrogen é um modelo de alta eficiência lançado pelo Google DeepMind em 12 de novembro de 2026, com ID de modelo na API `gemini-4-hydrogen`, posicionado para programação do dia a dia e execução por Agents. Ele suporta uma cota unificada de contexto de 1.048.576 tokens e oferece quatro níveis de raciocínio — Low, Medium, High e XHigh — com High como padrão.
Q2: Entre Gemini 4 Hydrogen e Claude Sonnet 5.5, qual é melhor para programar?
Depende do tipo de tarefa. O Hydrogen leva vantagem nos testes de correção de bases de código do SWE-sweep; o Sonnet 5.5 lidera em testes de execução no terminal, como o Terminal-Bench 4.1 e o Terminal-Bench-Science 0.1. Para mexer em código no dia a dia, a tendência é o Hydrogen; para engenharia intensiva em terminal, a tendência é o Sonnet.
Q3: O GPT-6.1 Terra não ficou em primeiro lugar em nada — ainda vale a pena usá-lo?
Vale considerar. Nos resultados de três modelos na mesma tabela divulgados pelo Google, o Terra realmente não obteve a maior nota em nenhum item, mas chega perto do Hydrogen no Agents’ Last Exam, fica em segundo no Chartography e tem o menor preço de API padrão. Para cenários sensíveis a custo, focados em operação visual e automação rotineira, ele é um candidato importante.
Q4: Por que o resultado do Sonnet 5.5 no OSWorld aparece em duas versões, 80,1% e 83,9%?
Os 80,1% são resultados parciais divulgados pela própria Anthropic; os 83,9% vêm de testes do Google sob condições específicas, considerando o melhor resultado entre várias execuções. Como as condições de teste são diferentes, na hora de comparar é preciso fixar uma única fonte — não dá para misturar as duas.
Q5: Como comparar rapidamente esses três modelos via API?
A recomendação é usar uma plataforma agregadora de API compatível com múltiplos modelos:
1. Acesse APIYI apiyi.com, crie uma conta e obtenha a chave API;
2. No console, confira na lista de modelos os IDs disponíveis dos três modelos;
3. Defina o `base_url` do código deste artigo como `https://api.apiyi.com/v1` e chame cada modelo com o mesmo lote de tarefas.
A APIYI oferece interface compatível com OpenAI e cobrança por uso, o que facilita fazer a comparação lado a lado em um único script.
Q6: Quais são as limitações conhecidas do Gemini 4 Hydrogen?
O cartão oficial do modelo aponta: ainda pode gerar alucinações; os níveis mais altos de raciocínio aumentam sensivelmente o tempo e o custo; o conhecimento tem corte em março de 2026; a métrica de recusas injustificadas piorou 5,57 pontos percentuais em relação ao 3.8 Flash; e o relatório de segurança completo ainda não havia sido publicado no momento da verificação. Além disso, desenvolvedores relataram execução excessiva em algumas tarefas de Agent. Por fim, o preço padrão por token é o dobro do preço atual do 3.8 Flash, então para tarefas em lote vale considerar o modo Batch.
Principais Pontos-Chave da Comparação Gemini 4 Hydrogen
- Não há campeão universal em programação: Hydrogen se destaca na correção de bases de código, enquanto Sonnet 5.5 se sai melhor em tarefas de execução no terminal.
- Hydrogen lidera em Agent e automação: Nos testes de Agent e automação listados pelo Google, Hydrogen ficou em primeiro lugar em todos.
- Operação de GUI fica com Sonnet 5.5: No OSWorld-2.1, Sonnet lidera com 83,9% — atenção às diferenças de critério de avaliação.
- Terra vence em custo e visão: Tem o menor preço padrão e não fica atrás na compreensão de gráficos nem em tarefas profissionais de Agent.
- Versões e fontes não podem ser misturadas: Terminal-Bench 4.0 e 4.1, além de resultados divulgados por fabricantes e auto-testes do Google, precisam ser tratados separadamente.
- O nível de pensamento faz muita diferença: Hydrogen High e XHigh diferem em apenas 3 pontos no índice de inteligência, mas o custo sobe visivelmente.
- O ideal é revalidar com suas próprias tarefas: É possível testar os três modelos de forma comparativa com uma única chave no APIYI apiyi.com.
Resumo
Pontos centrais da comparação entre Gemini 4 Hydrogen, GPT-6.1 Terra e Claude Sonnet 5.5:
- Área de programação: Hydrogen lidera no SWE-sweep; Sonnet 5.5 lidera em dois testes de terminal; Terra chega perto de Sonnet em tarefas de código científico.
- Área de Agent: Hydrogen lidera em todas as frentes — Agent de múltiplas etapas, automação de processos e simulação de gestão de longo prazo — com Terra logo em seguida em tarefas especializadas.
- Operação de computador e multimodal: Sonnet 5.5 domina a operação de interfaces gráficas, enquanto Hydrogen lidera por pouco em trabalho de conhecimento multimodal e compreensão de gráficos.
As avaliações públicas mostram “quem é mais forte sob determinado conjunto de condições”, e não “quem é mais adequado ao seu negócio”. A abordagem prática é usar a matriz de seleção acima para escolher um ou dois candidatos e, em seguida, fazer uma revalidação em pequena escala com suas próprias tarefas reais, um nível de pensamento fixo e sua cadeia de ferramentas.
Recomenda-se validar os resultados rapidamente pelo APIYI apiyi.com: a plataforma oferece cota gratuita de testes e uma interface unificada para múltiplos modelos, ideal para equipes realizarem uma avaliação comparativa antes da entrada em produção.
📚 Referências
- Blog oficial do Google – Introducing Gemini 4 Hydrogen: anúncio de lançamento e casos de parceiros
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descrição: posicionamento oficial, escopo de capacidades e dados de testes iniciais
-
Model card do Google DeepMind: tabela comparativa de avaliação entre modelos
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Descrição: principal fonte dos dados quantitativos deste artigo
-
PDF de avaliação de modelos do Google DeepMind: detalhes das condições de execução dos testes
- Link:
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
Descrição: Harness, níveis de raciocínio, número de execuções e resultados complementares como o Vending-Bench 2
-
Documentação técnica do Google Cloud: especificações e instruções de migração do Hydrogen
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Descrição: limites da janela de contexto, comportamento dos parâmetros e notas de compatibilidade
-
Página de preços do Google AI Studio: preços oficiais da API
- Link:
aistudio.google.com/docs/pricing -
Descrição: preços dos modos Standard, Batch, Flex e Priority
-
OpenAI – Introducing GPT-6.1 Terra: materiais de lançamento do Terra
- Link:
openai.com/index/introducing-gpt-6-1-terra/ -
Descrição: resultados auto-relatados no Terminal-Bench 4.0 e preços da API
-
Anthropic – Introducing Claude Sonnet 5.5: materiais de lançamento do Sonnet 5.5
- Link:
anthropic.com/claude-sonnet-5-5 -
Descrição: resultados auto-relatados no Terminal-Bench 4.0 e no OSWorld 2.1
-
Artificial Analysis – Gemini 4 Hydrogen: avaliação independente dos quatro níveis de raciocínio
- Link:
artificialanalysis.ai/models/gemini-4-hydrogen - Descrição: índices do Intelligence Index v5.0.1 em cada nível, tempo de execução e custo
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site APIYI; mais materiais sobre integração de modelos estão disponíveis no centro de documentação docs.apiyi.com