
Nota do autor: uma leitura dos dados de uso do ChatGPT em 165 categorias de atividades de trabalho, divulgados pelo OpenAI Signals v3.0, esclarecendo os critérios estatísticos e analisando o valor de referência para desenvolvedores e aplicações empresariais de IA.
Em 26 de outubro de 2026, a equipe de pesquisa econômica da OpenAI publicou o relatório “ChatGPT’s expanding world of work” (título oficial em chinês: “ChatGPT 不断拓展的工作版图”), divulgando dados de uso do ChatGPT que cobrem quase 100 países e regiões, 165 categorias de atividades de trabalho e 7 trimestres consecutivos. Esses dados fazem parte do programa OpenAI Signals v3.0 e estão disponíveis para download gratuito sob a licença CC BY 4.0, permitindo que pesquisadores usem os arquivos CSV diretamente para análises secundárias.
Não se trata do lançamento de um novo modelo nem de um novo recurso, mas de um conjunto de dados econômicos de uso voltado para pesquisadores. O anúncio oficial, o dicionário de dados e as verificações de veículos terceiros sobre os CSVs originais já apareceram ao mesmo tempo, e os critérios numéricos se confirmam mutuamente. Este artigo vai separar claramente as conclusões oficiais dos cálculos de terceiros, para evitar interpretar a “proporção de mensagens” como “substituição de postos de trabalho”.
Valor central: entenda em poucos minutos o que os dados de 165 categorias de atividades de trabalho da OpenAI realmente medem, o que descobriram e qual é o valor de referência prático para desenvolvedores de aplicações de IA.
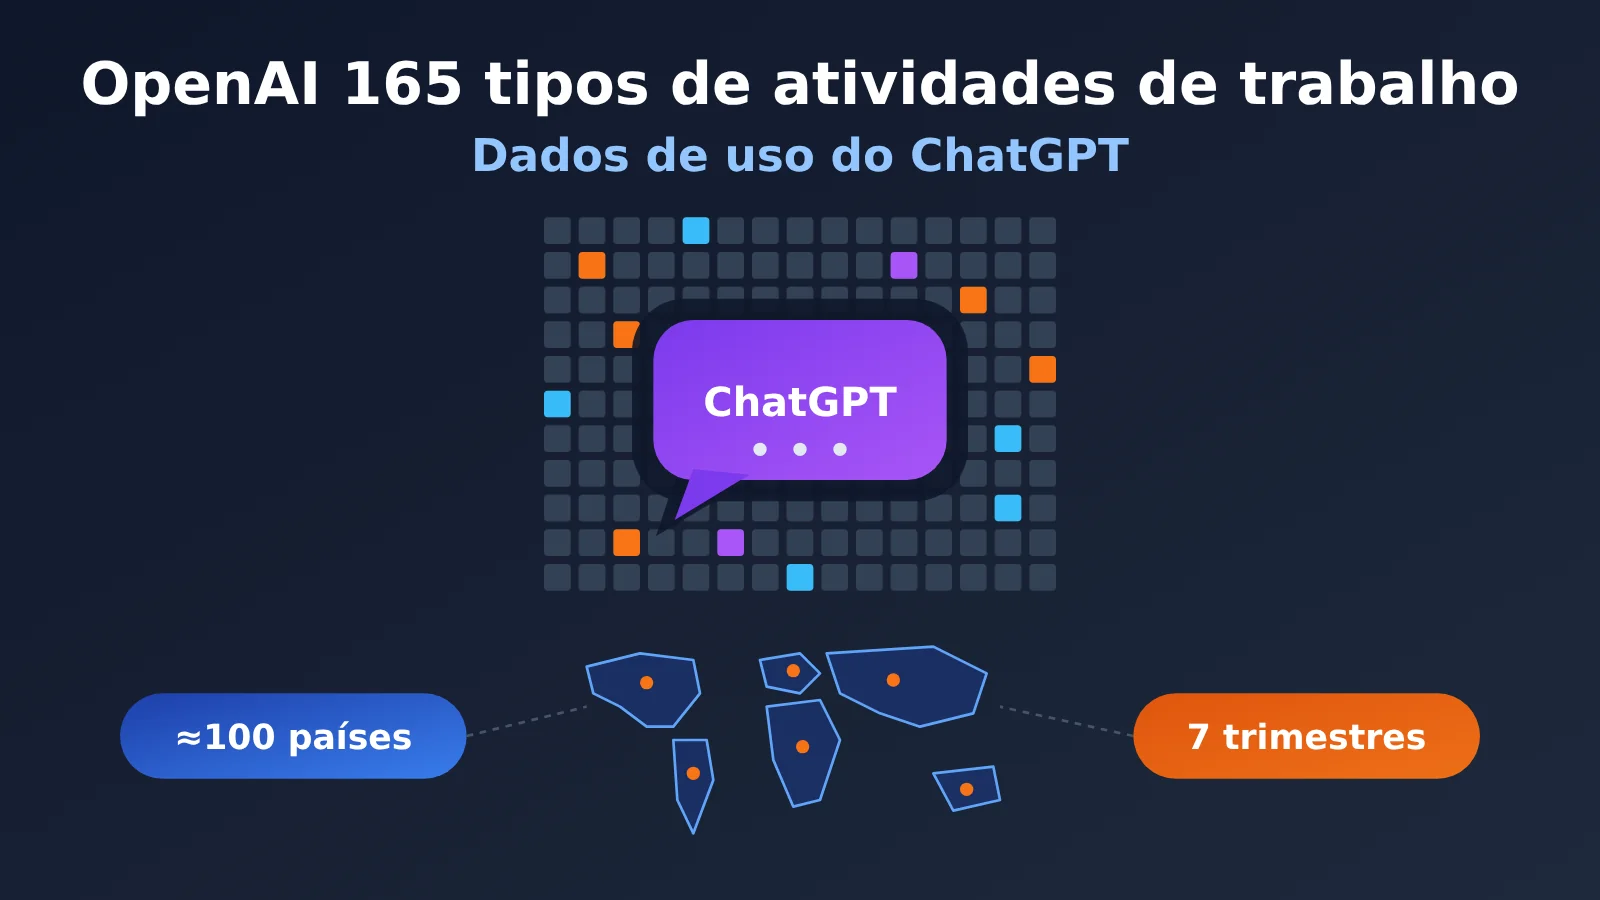
Visão geral das informações centrais dos dados das 165 categorias de atividades de trabalho da OpenAI
Primeiro, uma tabela para deixar claros os fatos básicos desta divulgação de dados de uso do ChatGPT:
| Item de informação | Detalhes |
|---|---|
| Data de publicação | 26 de outubro de 2026 |
| Publicado por | Equipe de Pesquisa Econômica da OpenAI (OpenAI Signals v3.0) |
| Sistema de classificação | Atividades de trabalho de nível intermediário (IWA) do O*NET dos EUA |
| Cobertura | Quase 100 países e regiões, 165 categorias de atividades de trabalho |
| Período | Do primeiro trimestre de 2025 ao terceiro trimestre de 2026, 7 trimestres no total |
| Fonte da amostra | Contas pessoais Free, Go, Plus e Pro, com idade declarada de 18 anos ou mais |
| Escopo excluído | ChatGPT Enterprise, Codex, contas excluídas e amostras não permitidas para treinamento |
| Licença dos dados | CC BY 4.0, visualização gratuita e download em CSV, com atribuição obrigatória |
165 categorias de atividades de trabalho não são 165 profissões
Esta é a parte em que é mais fácil errar ao interpretar os dados da OpenAI. O*NET é um banco de dados de informações ocupacionais apoiado oficialmente pelos Estados Unidos, que divide “profissões” em várias camadas de “atividades de trabalho”. Por exemplo, a atividade “editar materiais escritos” aparece tanto no trabalho de editores quanto no dia a dia de professores, advogados, engenheiros e profissionais de finanças.
Portanto, a OpenAI mede “o que as pessoas fazem com o ChatGPT”, e não “quais profissionais usam o ChatGPT”. IWA (Intermediate Work Activities, atividades de trabalho de nível intermediário) fica entre comportamentos de trabalho amplos e tarefas muito específicas; no sistema de referência do O*NET, há 332 entradas de IWA.
A OpenAI reportou separadamente apenas as atividades comuns que atendiam ao limite mínimo de amostra; atividades de baixa frequência foram agrupadas. Segundo a verificação do PPC Land no CSV original, a tabela pública na verdade contém 164 categorias nomeadas mais 1 categoria agregada “Other IWA”, totalizando 165 resultados de classificação. Portanto, não dá para dizer que a OpenAI contabilizou todas as 332 categorias de IWA.
Como os dados são coletados e classificados
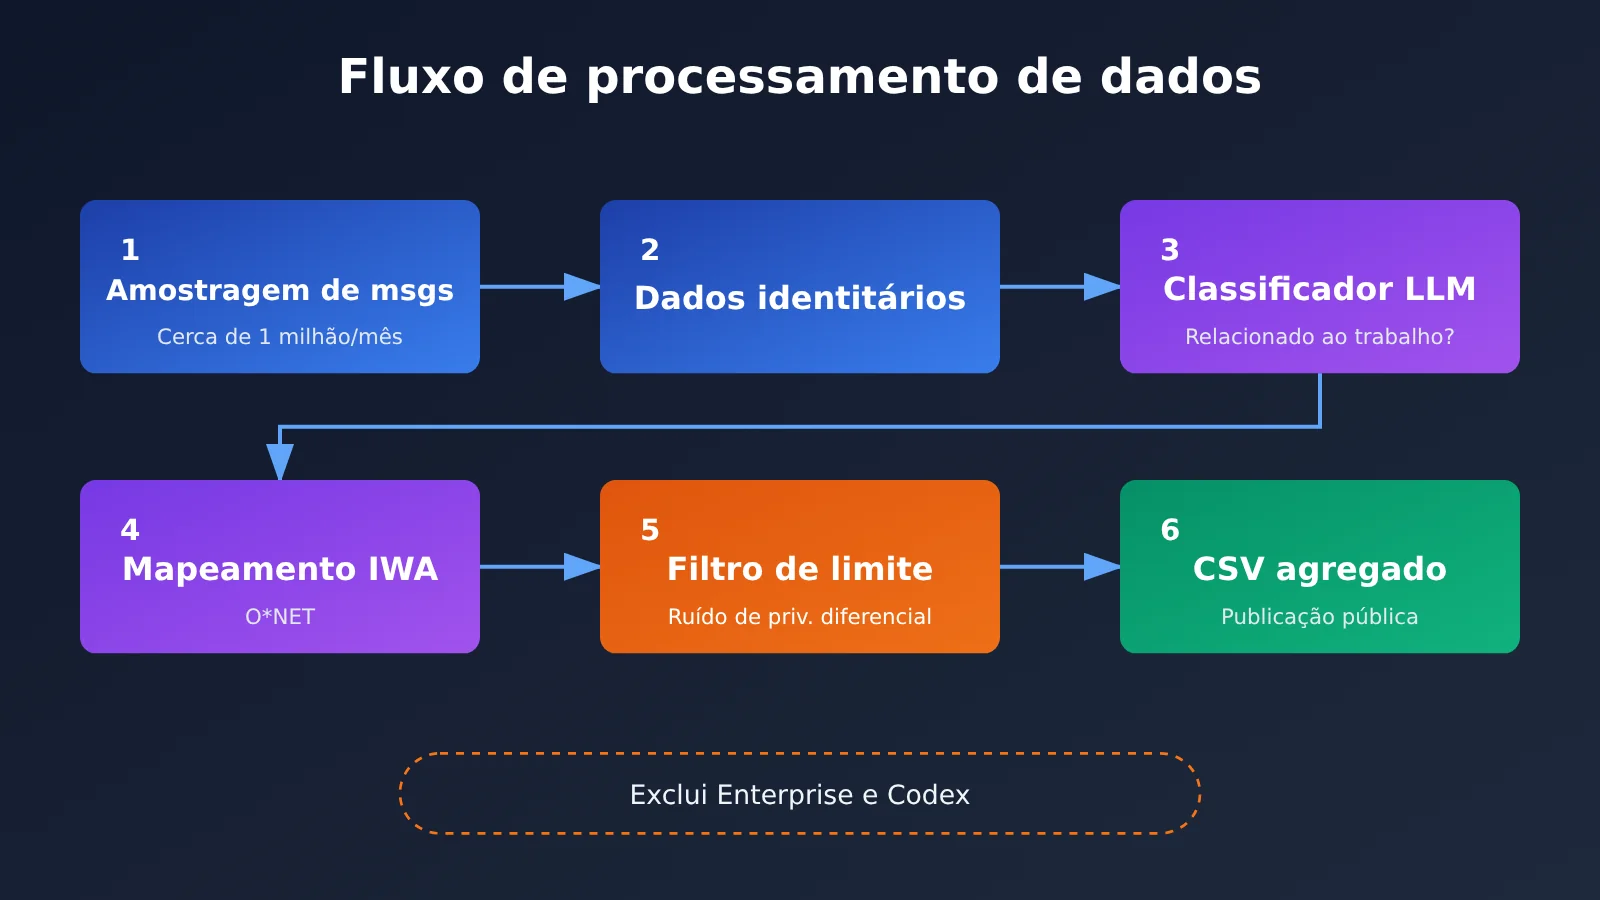
O Signals v3.0 faz uma amostragem mensal de cerca de 1 milhão de mensagens do ChatGPT; no total, cobre 27 meses, de julho de 2024 a setembro de 2026, somando cerca de 27 milhões de amostras classificadas. Vale notar que 27 milhões é a soma das amostras de cada mês; não é igual ao número de usuários únicos nem significa que todas sejam mensagens de trabalho.
A classificação é feita por um classificador automatizado baseado em modelo de linguagem: primeiro ele determina se a mensagem está relacionada ao trabalho; depois a mapeia para uma atividade de trabalho do O*NET, marcando também dimensões como tema, intenção, tempo e região. Em termos de privacidade, a OpenAI afirma que os pesquisadores não leem diretamente as conversas originais; as informações de identidade são tratadas antes da classificação; apenas resultados agregados são publicados; e amostras pequenas são ocultadas, com adição de ruído de privacidade diferencial. A distribuição de atividades de trabalho por país e trimestre só é publicada quando há pelo menos 1.000 mensagens válidas.
A descoberta mais importante dos dados de uso do ChatGPT: os usos profissionais estão mais diversificados
A principal conclusão divulgada oficialmente pela OpenAI é que os usuários individuais estão usando o ChatGPT para uma variedade cada vez maior de tipos de trabalho. Nos 74 países e regiões com registros completos em 7 trimestres, a participação média das dez atividades de trabalho mais comuns de cada país no total de mensagens de trabalho classificadas do próprio país caiu de forma significativa.
| Período | Participação média das dez atividades de trabalho mais comuns de cada país |
|---|---|
| Primeiro trimestre de 2025 | 56,0% |
| Terceiro trimestre de 2026 | 51,1% |
| Variação | -4,9 pontos percentuais |
É preciso deixar claros dois critérios aqui. Primeiro, os 51,1% não representam a participação de um ranking global único das dez atividades mais comuns, mas sim o resultado de calcular primeiro o top 10 de cada país e depois tirar a média entre os 74 países — os dez itens mais comuns podem ser diferentes em cada país. Segundo, a queda da participação não significa queda no volume de mensagens: se o uso geral está crescendo, o número absoluto de solicitações das atividades do topo ainda pode aumentar.
Em outras palavras, mais atividades de trabalho da “cauda longa” passaram a ocupar uma fatia maior. Vale notar também que os 74 países e os quase 100 países são dois escopos de amostra diferentes, e não podem ser misturados ao citar os dados.
Quais atividades de trabalho específicas são mais comuns
Em 27 de outubro de 2026, a PPC Land fez um cálculo independente com base em todos os CSVs públicos, com estatísticas separadas para 74 países e, depois, tirou a média. A seguir estão as seis atividades de trabalho nomeadas mais comuns no terceiro trimestre de 2026 (cálculo de terceiros, não listado diretamente no anúncio da OpenAI):
| Posição | Atividade de trabalho | Participação média das mensagens nos 74 países |
|---|---|---|
| 1 | Editar materiais escritos ou documentos | 15,0% |
| 2 | Criar designs visuais ou conteúdo de apresentação | 7,9% |
| 3 | Desenvolver materiais de marketing ou divulgação | 5,1% |
| 4 | Explicar informações linguísticas ou culturais | 4,0% |
| 5 | Preparar materiais informativos ou didáticos | 3,2% |
| 6 | Programar sistemas computacionais ou equipamentos de produção | 3,1% |
A edição de documentos continua sendo o uso profissional mais comum, e o design visual já subiu para o segundo lugar. Conteúdo de marketing, materiais didáticos e compreensão entre idiomas também têm demanda clara. Já a programação, embora importante, não ocupa a maior fatia nesta amostra de contas pessoais.
Design visual sobe, programação cai
Segundo o cálculo da PPC Land, a participação média de “Criar designs visuais ou conteúdo de apresentação” nos 74 países passou de 3,1% no primeiro trimestre de 2025 para 7,9% no terceiro trimestre de 2026, um aumento de 4,8 pontos percentuais — o maior crescimento entre 165 categorias de atividades específicas. Nos Estados Unidos, no mesmo período, subiu de 2,4% para 7,6%; no terceiro trimestre de 2026, o Brasil chegou a 11,2% e a Índia, a 8,7%.
Por outro lado, “Programar sistemas computacionais ou equipamentos de produção” caiu de 7,8% para 3,1%; nos Estados Unidos, de 6,7% para 2,4%; a Índia ainda registrava 5,8% no terceiro trimestre de 2026. Atividades relacionadas, como resolver problemas de computador e pesquisar design técnico, também caíram no mesmo período. Uma hipótese razoável é que desenvolvedores tenham migrado para agentes de programação dedicados, como o Codex, mas os dados em si não comprovam essa migração. A formulação mais segura é: neste conjunto de dados, que exclui Codex e contas corporativas, a participação de mensagens de trabalho de programação caiu de forma clara.
Marketing é outro sinal que vale acompanhar. A participação média de “Produzir materiais de marketing ou divulgação” foi de 5,2% para 5,1%, praticamente estável; Argentina, Paquistão, Nigéria e outros países chegaram a cerca de 9% no terceiro trimestre de 2026. Isso mostra que, embora a participação da escrita geral esteja caindo, a demanda por conteúdo de marketing específico continua estável.
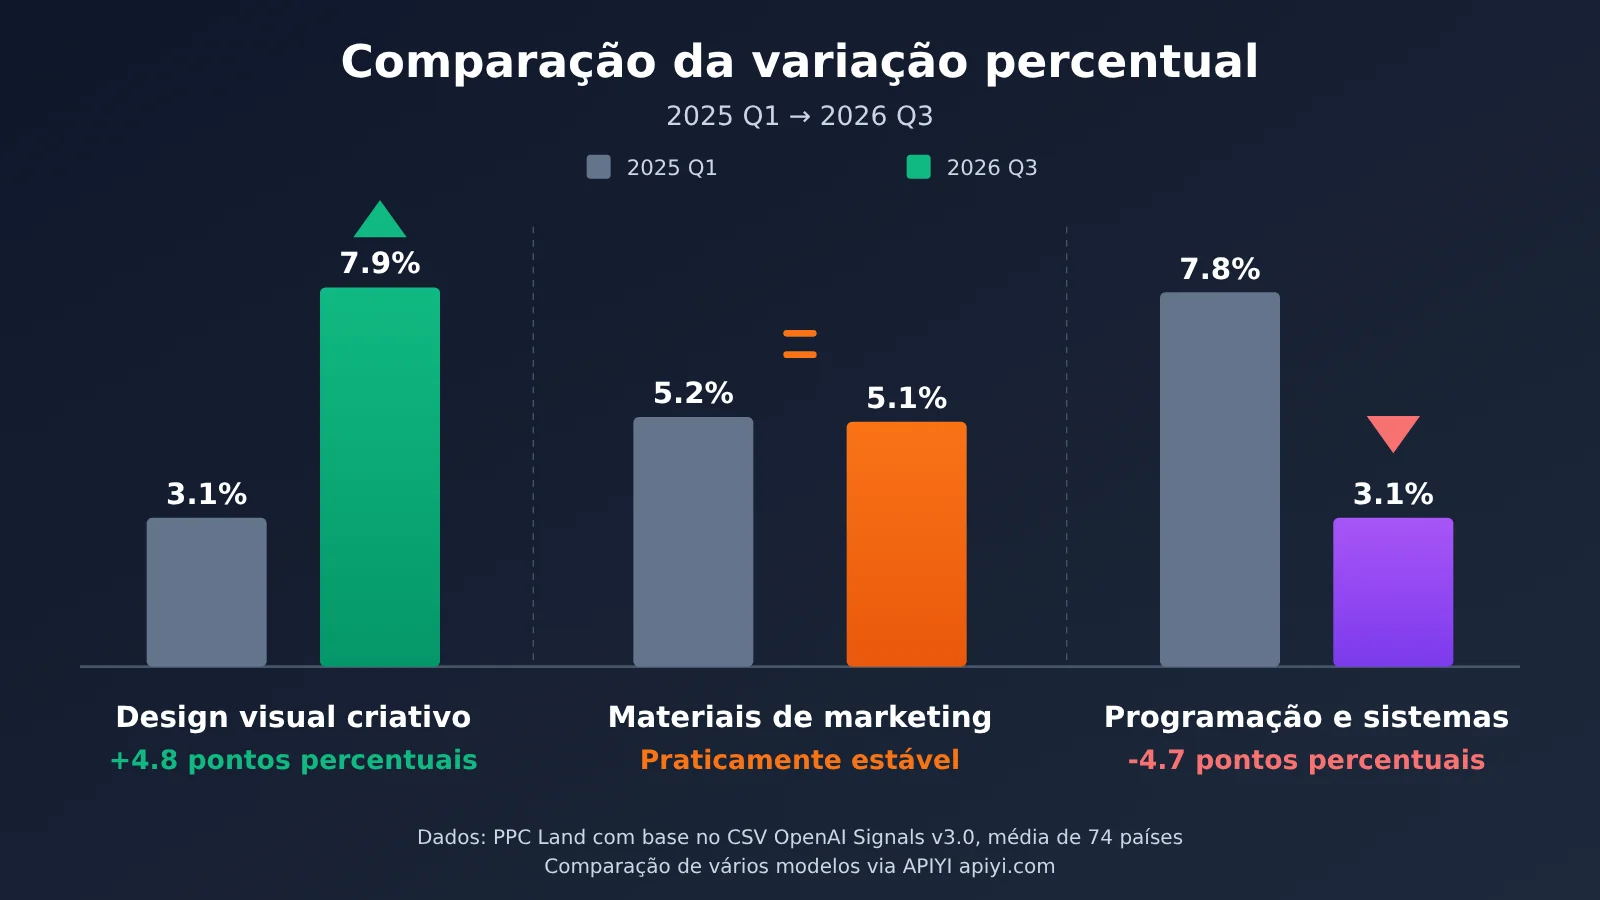
📊 Nota sobre o gráfico: os dados do gráfico acima vêm do recálculo da PPC Land sobre o CSV público da OpenAI. Se você quiser verificar, no seu próprio negócio, qual modelo se sai melhor para pedidos de “design”, “texto” e “programação”, pode usar o APIYI apiyi.com com a mesma chave API para alternar entre OpenAI, Claude, Gemini e outros modelos e fazer uma comparação em pequena escala.
Comparação da estrutura de trabalho do ChatGPT nos Estados Unidos e na Alemanha
O PPC Land também leu item por item as categorias mais amplas de Generalized Work Activities no gráfico interativo da OpenAI (atenção: não é o mesmo nível do IWA mencionado acima e não deve ser misturado com ele). O critério estatístico é a proporção de mensagens relacionadas ao trabalho em cada país:
| Atividade de trabalho generalizada | EUA T1 2025 | EUA T1 2026 | Alemanha T1 2025 | Alemanha T1 2026 |
|---|---|---|---|---|
| Tomada de decisões e resolução de problemas | 22,8% | 21,6% | 22,0% | 19,4% |
| Pensamento criativo | 11,8% | 15,6% | 11,3% | 13,1% |
| Registro de informações | 10,6% | 11,8% | 10,3% | 11,4% |
| Uso de computadores | 11,7% | 6,7% | 12,7% | 8,4% |
| Prestação de consultoria e recomendações | 5,5% | 9,0% | 7,1% | 11,7% |
| Explicação de informações para outras pessoas | 5,1% | 4,0% | 9,5% | 8,6% |
Os dois países mostram que “tomada de decisões e resolução de problemas” é um uso importante, e as proporções de “pensamento criativo” e “consultoria e recomendações” aumentaram de forma clara. Isso descreve os tipos de solicitação dos usuários; não significa que o ChatGPT já tome decisões de negócios de forma independente, nem que ofereça consultoria de nível especializado validada.
Entre países, o indicador de diferença na distribuição transnacional lido pelo PPC Land (distância de variação total) subiu ligeiramente de cerca de 22,2% para cerca de 23,0%. A OpenAI também reconhece que essa diferença pode vir da estrutura de trabalho, do idioma e da cultura, da disponibilidade de ferramentas e dos hábitos de uso, e que os dados desta vez não são suficientes para provar causalidade.
Análise do impacto dos dados de 165 tipos de atividades de trabalho para desenvolvedores
Impacto nos desenvolvedores de aplicações de IA
- A demanda está se ampliando: os usuários não usam mais o ChatGPT apenas para editar documentos — design visual, marketing, materiais didáticos e consultoria também têm uma fatia considerável. Ferramentas de IA de função única precisam considerar cenários multiuso.
- Multimodalidade fica mais importante: o design visual é a atividade com maior crescimento, e no mesmo período o tema “multimídia” em todas as mensagens pessoais subiu de 2,0% para 8,8% (cálculo da PPC Land). Vale a pena incluir capacidades de imagem no planejamento do produto.
- Cenários de programação caminham para a especialização: a proporção de mensagens de programação no chat genérico caiu, o que sugere que a demanda de desenvolvimento de comandos pode ocorrer mais em agentes especializados ou ambientes corporativos — ideal para ser atendida com modelos de código e fluxos de trabalho dedicados.
- Método de classificação reutilizável: a OpenAI usa um classificador de LLM para mapear mensagens a um sistema padrão de tarefas, e essa mesma abordagem pode ser aplicada na análise dos logs do seu próprio produto.
Impacto na implementação de IA nas empresas
Dados de contas individuais não representam o uso corporativo. Outro levantamento do Enterprise Signals da OpenAI mostra que, até junho de 2026, entre os clientes corporativos analisados, o Codex foi responsável por 64% dos Tokens de saída somados do ChatGPT e do Codex. Isso indica que a estrutura de uso do lado corporativo pode ser bem diferente da dos indivíduos. Por isso, ao avaliar soluções internas de IA, o ideal é se basear nos seus próprios logs de tarefas, em vez de simplesmente aplicar os dados individuais do Signals.
🚀 Início rápido: se você quiser marcar as solicitações do seu próprio negócio com o rótulo de “atividade de trabalho”, como a OpenAI fez, a recomendação é montar um protótipo rapidinho pelo APIYI apiyi.com. A plataforma oferece uma interface compatível com a OpenAI, novos usuários têm cota de teste gratuita e em poucos minutos você já consegue rodar o exemplo abaixo.
Reproduzindo a ideia de “classificação de atividade de trabalho” com a API
Abaixo está um exemplo bem enxuto, usando um Modelo de Linguagem Grande para classificar uma solicitação de usuário em um pequeno conjunto de rótulos de atividade de trabalho. O princípio é o mesmo do classificador da OpenAI (os rótulos são só uma simplificação, não é o sistema completo do O*NET):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI: interface compatível com OpenAI
)

labels = "edição de documentos, design visual, marketing e divulgação, interpretação de idiomas, materiais didáticos, programação, análise para decisão, outros"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"Escolha um rótulo de [{labels}] para descrever esta solicitação de trabalho, output apenas o rótulo: me ajude a escrever o texto de lançamento do novo produto para o WeChat oficial"}]
)
print(resp.choices[0].message.content)
Ver o código completo de classificação em lote e estatísticas de proporção
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # uma única Key permite alternar entre vários modelos
)

LABELS = ["edição de documentos", "design visual", "marketing e divulgação", "interpretação de idiomas",
          "materiais didáticos", "programação", "análise para decisão", "não trabalho", "outros"]

SYSTEM = (
    "Você é um classificador de atividades de trabalho. Primeiro julgue se a solicitação "
    f"está relacionada ao trabalho e depois escolha um rótulo entre: {', '.join(LABELS)}. "
    "Output apenas o rótulo em si."
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "outros"
    except Exception as e:
        print(f"Error: {e}")
        return "outros"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "não trabalho"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "me ajude a revisar este relatório trimestral",
        "sugira a composição de um conjunto de cartazes para o evento",
        "por que este código Python não consegue ler os dados",
        "onde é bom acampar no fim de semana",
    ]
    print(activity_share(logs))
Assim como no método da OpenAI, essa classificação automática também erra de vez em quando, e uma única tarefa pode ser dividida em várias mensagens. Por isso, a “proporção de mensagens” calculada não equivale diretamente à carga de trabalho nem ao valor de negócio.
Referência de seleção de modelos por tipo de atividade de trabalho
Cruzando com as atividades de maior peso nos dados, dá para fazer uma seleção inicial por tipo de tarefa. O desempenho real, porém, ainda precisa ser testado nos seus próprios dados:
| Atividade de trabalho | Foco de capacidade | Raciocínio de seleção | Plataformas disponíveis |
|---|---|---|---|
| Edição de materiais escritos | Compreensão e reescrita de texto | Modelo de conversação generalista com boa relação custo-benefício | APIYI apiyi.com, API oficial |
| Design visual e apresentação | Geração e compreensão de imagens | Modelos multimodais / de imagem | APIYI apiyi.com, API oficial |
| Materiais de marketing e divulgação | Criatividade e controle de estilo | Modelo flagship com estilo de escrita consistente | APIYI apiyi.com, API oficial |
| Programação e depuração | Raciocínio de código | Modelos com forte capacidade de código ou agentes dedicados | APIYI apiyi.com, API oficial |
| Decisão e consultoria | Raciocínio de contexto longo | Modelos de raciocínio, com revisão humana | APIYI apiyi.com, API oficial |
As limitações dos dados da OpenAI sobre 165 categorias de atividades de trabalho
Esses dados têm muito valor, mas os limites também são claros. Estes são os pontos que mais exigem atenção na hora de citá-los:
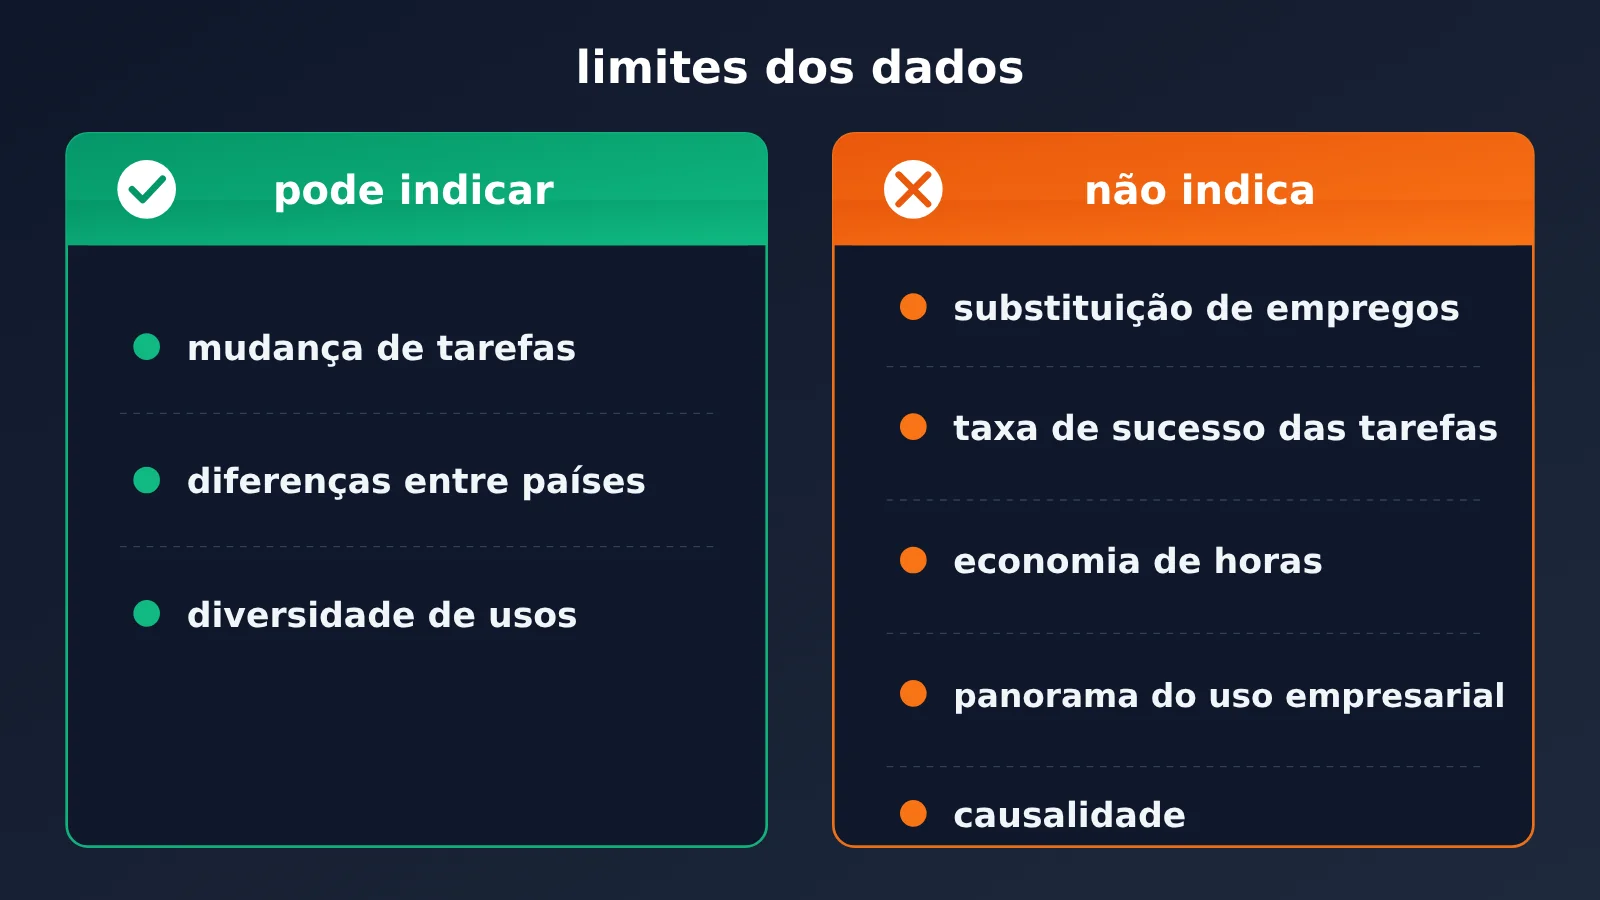
- A amostra inclui apenas contas pessoais de adultos: Enterprise e Codex ficaram de fora, então ela não representa todo o uso profissional dos produtos corporativos da OpenAI.
- A classificação é automática: o classificador baseado em LLM pode interpretar mal a intenção — por exemplo, “criar um plano de divulgação de evento” pode ser trabalho real de marketing ou apenas um interesse pessoal.
- A proporção de mensagens não é igual a produção: ela não representa quantidade de tarefas, horas trabalhadas, número de usuários, horas economizadas nem taxa de sucesso.
- Há ruído de privacidade e um limite mínimo de amostra: resultados de amostras pequenas são ocultados, e ainda é adicionado ruído de privacidade diferencial.
- Não há correspondência um a um com a economia real: ponderando pelo número de pessoas empregadas, cerca de 43% das atividades de trabalho reais nos EUA caem na categoria “Other IWA”. Isso não significa que 43% dos trabalhos não possam ser feitos por IA, nem que os outros 57% já estejam cobertos pelo ChatGPT.
Além disso, os cálculos da PPC Land mostram que a proporção de mensagens pessoais marcadas como relacionadas a trabalho caiu de cerca de 51,6% em julho de 2024 para cerca de 32,2% em setembro de 2026. Isso provavelmente tem mais a ver com a entrada massiva de usuários não profissionais e com a migração de parte do trabalho especializado para contas corporativas e agentes dedicados. Não dá para concluir, com base nisso, que o ChatGPT tenha se tornado menos relevante no ambiente de trabalho.
Perguntas Frequentes (FAQ)
Q1: O que são os dados das 165 categorias de atividades de trabalho divulgados pela OpenAI?
É um conjunto de dados agregados publicado pelo programa OpenAI Signals v3.0, que mapeia as mensagens relacionadas ao trabalho de usuários individuais do ChatGPT para as 165 categorias de atividades de trabalho de nível intermediário do O*NET, cobrindo quase 100 países e regiões, do primeiro trimestre de 2025 ao terceiro trimestre de 2026, num total de 7 trimestres. O download do CSV é gratuito.
Q2: Qual é a diferença entre as 165 categorias de atividades de trabalho e as 165 profissões?
Atividade de trabalho é “o que se faz”, profissão é “qual é o cargo”. Uma mesma atividade (como editar documentos) pode aparecer em várias profissões, então esses dados descrevem para que tipos de trabalho o ChatGPT está sendo usado, e não a taxa de uso por profissão. Menos ainda permitem inferir quais profissões serão substituídas.
Q3: Quando esses dados foram publicados e serão atualizados depois?
A OpenAI publicou em 26 de outubro de 2026, com dados até o terceiro trimestre de 2026. A empresa acompanha as mudanças por trimestre; se haverá atualizações contínuas, isso deve ser confirmado nos anúncios da página de dados do OpenAI Signals — este artigo não faz suposições.
Q4: A queda na proporção de mensagens de programação significa que a demanda por programação com IA está encolhendo?
Não dá para concluir isso. Esses dados excluem o Codex e as contas corporativas, enquanto o Enterprise Signals mostra uma participação alta de tokens de saída do Codex no lado empresarial. A demanda por programação pode ter migrado para agentes especializados, ou pode estar relacionada a mudanças na composição dos usuários — os dados por si só não permitem distinguir.
Q5: Como reproduzir uma análise de classificação de atividades de trabalho parecida usando a API?
Você pode usar o código de exemplo deste artigo para rotular as suas próprias requisições de usuário com um Modelo de Linguagem Grande e depois calcular as proporções:
1. Acesse APIYI apiyi.com, crie uma conta e obtenha uma chave API
2. Resgate o crédito gratuito de teste para novos usuários
3. Defina o `base_url` do código como `https://api.apiyi.com/v1` e pronto: você pode alternar entre modelos para comparar os resultados da classificação
Q6: Quero comparar o desempenho de diferentes modelos em tarefas de design, redação e programação. Existe um jeito simples?
O caminho mais prático é chamar vários modelos por uma interface unificada, rodar o mesmo lote de comandos e depois avaliar manualmente. Com APIYI apiyi.com, uma única chave permite chamar modelos como OpenAI, Claude e Gemini, com cobrança por uso — ideal para esse tipo de experimento comparativo em pequena escala.
Principais conclusões dos dados das 165 categorias de atividades de trabalho da OpenAI
- O objeto da estatística são atividades, não ocupações: as 165 categorias correspondem às atividades de trabalho do O*NET e incluem 1 categoria agregada de “outros”.
- Usos mais dispersos: a participação média das dez principais atividades nos 74 países caiu de 56,0% para 51,1%.
- Design visual foi o que mais cresceu: cálculos de terceiros mostram um salto de 3,1% para 7,9%.
- A fatia de programação caiu, mas a leitura exige cautela: a amostra exclui o Codex e contas corporativas.
- Demanda de marketing estável: os materiais de marketing e divulgação se mantiveram na casa dos 5%.
- Participação de mensagens não é o mesmo que produção: não dá para concluir substituição de postos de trabalho, economia de horas ou taxa de sucesso.
- O método de classificação é reaproveitável: com as interfaces multimodelo da APIYI apiyi.com, dá para montar rapidamente sua própria análise de classificação de tarefas.
Resumo
As informações centrais dos dados de uso do ChatGPT nas 165 categorias de atividades de trabalho da OpenAI:
- Natureza dos dados: um conjunto de dados de pesquisa aberto e gratuito, acompanhado trimestralmente, que mede “quais atividades de trabalho as pessoas realizam com o ChatGPT” em contas individuais.
- Principais descobertas: os usos profissionais estão se tornando mais dispersos, com alta em design visual, consultoria e pensamento criativo, e queda na participação de mensagens de programação genérica.
- Limites de interpretação: os dados não incluem contas corporativas nem o Codex, e a participação de mensagens não equivale a volume de trabalho, impacto sobre postos de trabalho ou valor econômico.
O que esses dados realmente revelam não é quais das 165 ocupações vão desaparecer, mas que a IA está entrando nos diferentes fluxos de trabalho de forma mais granular e variada — e isso varia conforme o país e o tipo de tarefa. Para quem desenvolve, em vez de perguntar “quem a IA vai substituir?”, vale mais a pena enxergar quais atividades os usuários de fato realizam com IA e, a partir daí, escolher o modelo e o fluxo de trabalho certos para cada uma delas.
Recomendamos validar rapidamente o desempenho de diferentes modelos no seu cenário de negócio usando a APIYI apiyi.com — a plataforma oferece cota de teste gratuita e uma interface unificada para múltiplos modelos.
📚 Referências
- Anúncio oficial da OpenAI: ChatGPT’s expanding world of work: fonte principal deste lançamento
- Link:
openai.com/index/chatgpt-expanding-world-of-work -
Descrição: conclusões oficiais sobre 165 tipos de atividades, quase 100 países, variação de 56,0% para 51,1%, entre outros dados
-
Download de dados e explicação metodológica do OpenAI Signals: entrada para o CSV original e o dicionário de dados
- Link:
openai.com/signals/data-download -
Descrição: escopo da amostra, tratamento de privacidade e licença CC BY 4.0
-
PPC Land: Writing drops from 34% to 21% of ChatGPT requests since July 2024: análise de CSV de terceiros
- Link:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
Descrição: ranking de atividades específicas e mudanças na proporção de design visual e programação
-
PPC Land: Americans use ChatGPT at work most to make decisions: leitura dos gráficos interativos EUA-Alemanha
- Link:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
Descrição: dados comparativos por país sobre atividades de trabalho em sentido amplo
-
Site oficial do O*NET: sistema de classificação de atividades de trabalho e ocupações
- Link:
onetcenter.org -
Descrição: para entender a definição de IWA e os 332 itens de referência
-
OpenAI Enterprise Signals: dados de uso de contas empresariais
- Link:
openai.com/signals/enterprise-data - Descrição: usado para distinguir os critérios de dados individuais e empresariais
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco na página inicial do site da APIYI; há mais materiais de integração no centro de documentação docs.apiyi.com




